Automatyczne profilowanie danych dla niezawodnych platform
|
7
min. czyt.

Dashboard nadal się ładuje. Nocne zadania zakończyły się, a nikt nie zgłosił błędu. Wtedy analityk biznesowy zauważa, że dobrze znana kategoria klientów niemal zniknęła z tabeli źródłowej. Kontrole świecą na zielono, bo sprawdzają, czy pipeline się wykonał, a nie czy dane nadal zachowują się zgodnie z oczekiwaniami.
Spis treści
Dlaczego ręczne profilowanie danych zawodzi na dużą skalę
Weźmy hurtownię danych instytucji ubezpieczeń społecznych, w której inżynierowie utrzymują dużą kolekcję ręcznie pisanych kontroli. Jedne walidują rekordy świadczeń, inne sprawdzają daty dostarczenia, a jeszcze inne wymuszają założenia odziedziczone po wycofanych systemach. To ilustracyjny wzorzec operacyjny, a nie udokumentowany przypadek klienta.
Każda kontrola mogła mieć sens w chwili, gdy ją napisano. Trudność polega na zachowaniu jej znaczenia, gdy zmieniają się systemy źródłowe, wymagania raportowe i odpowiedzialność w zespołach.
Inżynier odchodzi, ale jego SQL zostaje. Pojawia się nowy feed, a zespół kopiuje istniejący zestaw reguł, nie wiedząc, które założenia obowiązują. Analitycy dodają kontrole po incydentach, a przestarzałe kontrole nadal generują alerty.
Pokrycie regułami to nie zrozumienie danych
Statyczny zestaw reguł odpowiada na pytania, które ktoś już wcześniej umiał zadać. Nie musi ujawnić nieznanej kategorii, zmienionego rozkładu ani pola, którego faktyczne znaczenie odbiega od nazwy.
Objawy operacyjne łatwo rozpoznać:
Częściowe pokrycie: Ważne tabele mają kontrole, ale obejmują one wybrane scenariusze błędów, a nie obserwowane zachowanie tabeli.
Niejasna odpowiedzialność: Inżynierowie potrafią znaleźć regułę, ale nie osobę, która wyjaśni jej cel biznesowy.
Zmęczenie alertami: Osoby weryfikujące raz po raz trafiają na mało wartościowe powiadomienia i coraz rzadziej analizują kolejne.
To przydatne sposoby ujęcia operacyjnych problemów z danymi: nie jako błędnych wartości, lecz jako luk między tym, co mierzą zespoły, a tym, czego potrzebują odbiorcy danych.
Najpierw odkrywać, potem narzucać
Automatyczne profilowanie danych zaczyna od innego pytania: co faktycznie znajduje się w tym zbiorze danych? Zamienia nieznaną tabelę w mierzalny obiekt, zanim zaczną na niej polegać analitycy, narzędzia statystyczne czy modele.
Nie eliminuje to reguł biznesowych. Zmniejsza natomiast ilość eksploracyjnego SQL, który inżynierowie muszą napisać, zanim zdecydują, które reguły są uzasadnione.
Praktyczna zasada: Warto zachować jawne wymagania biznesowe, ale nie należy wymagać od inżynierów przewidzenia każdej obserwowalnej zmiany, zanim ruszy monitoring.
Znaczenie ma też wybór architektury. W przypadku wrażliwych danych firmowych zalecam uczenie się i utrzymywanie tych pomiarów w środowisku klienta. Odkrywanie danych nie powinno wymagać eksportu rekordów produkcyjnych do hostowanego skanera.
Przydatnym wynikiem nie jest większy katalog kontroli. Jest nim utrzymywana linia bazowa, odpowiedzialna osoba weryfikująca i dowody, które pomagają odróżnić istotną zmianę od rutynowej zmienności.
Co naprawdę mierzy automatyczne profilowanie danych
Punktem wyjścia jest nieznana tabela w hurtowni. Można odczytać jej schemat, ale zadeklarowane typy nie powiedzą, czy pola są wypełnione, czy identyfikatory się powtarzają ani czy wartości tekstowe mają spójne wzorce.
Fundamentalna publikacja Data Profiling Revisited, wydana w 2013 roku, opisuje profilowanie jako badanie cech danych, takich jak typy kolumn, liczba wartości null, liczba wartości unikalnych i częste wzorce. Wyjaśnia też, jak profilowanie wspiera sprawdzanie ograniczeń i konfigurację późniejszych narzędzi statystycznych lub data mining.
Poznać obserwowalny kształt danych
Profil można porównać do planu budynku połączonego z liczbą osób w środku. Opisuje pomieszczenia i to, gdzie przebywają ludzie, ale nie wyjaśnia, dlaczego weszli do budynku.
Podobnie profil może pokazać, że kolumna statusu zawiera nieznane wartości. Nie rozstrzygnie jednak, czy oznaczają one zatwierdzoną zmianę biznesową.

Wstępna inspekcja powinna ustalić:
Strukturę: Jakie kolumny istnieją i jakie typy danych obsługują ich wartości.
Wypełnienie: Gdzie brakuje wartości i ile pojawia się wartości unikalnych.
Kształt: Jakie zakresy, powtarzające się formaty i często występujące wartości charakteryzują tabelę.
Te pomiary dają inżynierom punkt wyjścia do odkrywania. Pole tekstowe przypominające datę może zasługiwać na dokładniejszą analizę; często powtarzający się identyfikator klienta może być oczekiwany w transakcjach, ale podejrzany w kartotece klientów.
Przechowywać dowody, nie tylko raport
Podstawowe pomiary - kompletność, unikalność, zgodność typów, częstość i rozkład - mają zastosowanie w relacyjnych bazach danych, hurtowniach, data lake'ach i plikach analitycznych. Technologia przechowywania zmienia sposób wykonania, a nie zadawane pytania.
Wynikowy profil warto zachować jako punkt odniesienia dla kolejnych obserwacji. Należy zapisać źródło i warunki, w jakich powstał, zamiast przechowywać jedynie wykres, którego nikt później nie odtworzy.
Zespołom, które formalizują taką identyfikowalność, przyda się uzupełniająco przewodnik Fetchin po pochodzeniu danych. Informacja o pochodzeniu powinna towarzyszyć wynikom statystycznym, bo osoby weryfikujące muszą wiedzieć, skąd pochodzą dowody.
Praktyczna granica jest ważna: obserwowane zachowanie nie jest automatycznie zachowaniem poprawnym. Profilowanie dostarcza dowodów do decyzji, a nie pozwolenia na zamianę każdego częstego wzorca w egzekwowane wymaganie.
Techniki profilowania i metryki jakości
Dojrzałe narzędzie do profilowania potrzebuje czegoś więcej niż licznika brakujących wartości. W systematycznej ocenie 13 narzędzi do jakości danych podstawowe profilowanie było szeroko wspierane, natomiast zaawansowane funkcje dotyczące zależności i wielu kolumn pojawiały się tylko w pojedynczych narzędziach, jak opisano w ocenie narzędzi do jakości danych opublikowanej w Frontiers.
Dopasować dowody do pytania
Zbieranie danych warto zorganizować wokół następujących klas dowodów:
Klasa dowodów | Przydatne obliczenia i interpretacja |
|---|---|
Kardynalności pojedynczych kolumn | Liczba wartości unikalnych i duplikatów ujawnia powtórzenia i możliwą unikalność. |
Rozkłady wartości | Kwantyle, histogramy częstości i odsetek wartości odstających opisują koncentrację i rozrzut. |
Typy danych i wzorce | Wywnioskowane typy semantyczne i regularności formatu odróżniają sposób przechowywania od prawdopodobnego znaczenia. |
Domeny | Obserwowane zbiory wartości sugerują kandydatów na wartości dozwolone do weryfikacji. |
Relacje między kolumnami i wielokolumnowe | Klucze kandydujące i zależności funkcyjne ujawniają możliwe ograniczenia integralności. |
Należy jawnie uwzględnić odsetek wartości null i pustych. Pusty ciąg znaków i null w bazie danych mogą wymagać innego traktowania, dlatego każdą decyzję o ich połączeniu trzeba udokumentować.

Równowaga między pokryciem a kosztem skanowania
Pomiary warto wersjonować według tabeli, kolumny, partycji i czasu obserwacji. W przeciwnym razie osoby weryfikujące nie odróżnią wiarygodnie trwałego przesunięcia rozkładu od problemu w pojedynczej partycji.
Dokładne zliczanie wartości unikalnych i wyczerpujące testy zależności par kolumn mogą być kosztowne przy dużych zbiorach danych. Przybliżone szkice (sketches), próby warstwowe i profile przyrostowe to rozsądne alternatywy, ale w krytycznych zbiorach przybliżenia należy walidować względem dokładnych obliczeń.
Wybór powinien wynikać z konsekwencji błędu. Eksploracyjne odkrywanie toleruje niepewność, której regulacyjna kontrola integralności nie może zaakceptować.
Polityka zarządzania danymi Queensland Health obejmuje w zakresie jakości dokładność, poprawność, wiarygodność, terminowość, adekwatność, kompletność i unikalność. Taka szerokość to przydatny korektor przy wyborze metryk jakości danych: łatwe do obliczenia statystyki nie powinny definiować całego programu.
Zamieniać ustalenia w kontrole
Zatwierdzona wywnioskowana domena może stać się regułą walidacyjną. Potwierdzony klucz kandydujący może stać się kontrolą integralności, a linia bazowa rozkładu może zasilać wykrywanie anomalii.
Uzgadnianie biznesowe nadal wymaga logiki dziedzinowej. Na przykład zespoły, które za pomocą Charter AI dopasowują operacje bankowe do zapisów księgowych, realizują zadanie dopasowania na poziomie biznesowym, a nie tylko zliczają unikalne referencje transakcji.
To rozróżnienie powinno pozostać jasne. Profilowanie pomaga ustalić, co zasługuje na kontrolę; właściciele biznesowi decydują, co ta kontrola ma oznaczać.
Gdy więcej profili oznacza więcej szumu
Zbieranie wszystkich dostępnych statystyk nie poprawia automatycznie decyzji. Jeśli nikt nie potrafi wyjaśnić, które odchylenia mają znaczenie, inżynierowie zautomatyzowali produkcję powiadomień zamiast niezawodnego monitoringu.
Normalne zachowanie może różnić się w zależności od dnia tygodnia, końca miesiąca, sezonu, cyklu wydań czy wydarzenia biznesowego. Porównywanie każdego ładowania z niezróżnicowaną średnią historyczną może sprawić, że oczekiwana zmiana wygląda na błąd.
Oddzielać brakujące dane od błędnych
Ramy jakości danych rządu Wielkiej Brytanii odróżniają kompletność od dokładności. Zbiór danych może zawierać wszystkie oczekiwane rekordy, a mimo to mieć niepoprawne wartości.
Obecność wierszy, braki na poziomie pól i poprawność wartości należy mierzyć osobno. Jeśli dostawa się nie zakończyła, pozorny problem z kompletnością może wymagać zbadania pipeline'u, a nie naprawy rekordów.
Zmiana metryki to obserwacja. Nazwanie jej błędem wymaga kontekstu.
Wyniki z 2025 roku zebrane w raporcie State of Enterprise Data and AI firmy Atlan ilustrują ten problem kontekstu: 97% organizacji zgłosiło luki dotyczące definicji, jakości i zaufania, a 52% wskazało obawy związane z bezpieczeństwem i dostępem do danych wrażliwych. To samo źródło podaje, że kadra zarządzająca oceniła dojrzałość danych w organizacji o 12% wyżej niż praktycy, a niemal 90% specjalistów od danych zmagało się ze skalą i złożonością.
Te wyniki przemawiają za ostrożną postawą operacyjną: nie należy zakładać, że dodatkowe pomiary rozstrzygną spory o znaczenie czy gotowość danych.

Uwzględnić czas i wpływ w triażu
Tam, gdzie oczekiwane zachowanie się zmienia, warto stosować linie bazowe uwzględniające czas i adaptacyjne progi. Fałszywe alarmy należy jawnie przeglądać i zapisywać, czy alert doprowadził do potwierdzonego błędu, zaakceptowanej zmiany biznesowej, czy dochodzenia bez wystarczających dowodów.
Modelowanie oczekiwanego czasu dostarczenia pomaga odróżnić niepełne okna obserwacji od zakończonych ładowań. Triaż uwzględniający lineage powinien łączyć odchylenie z opóźnieniami dostaw, zmianami schematu oraz zagrożonymi raportami i modelami po stronie odbiorców.
Te zależności warto pokazywać w dashboardach jakości danych, zamiast wyświetlać niewyjaśniony czerwony wskaźnik. Osoba weryfikująca powinna widzieć, co się zmieniło, kto za to odpowiada i jakie działanie jest możliwe.
Gotowość na AI wymaga czegoś więcej niż statystycznej normalności. Bez definicji semantycznych, właścicieli i ścieżki naprawczej nawet szczegółowy technicznie profil nie zapewnia wiarygodnych danych treningowych ani operacyjnych.
Jak wybrać profilowanie w bazie danych
Przy wrażliwych obciążeniach firmowych wykonanie kontrolowane przez klienta powinno być wymaganiem projektowym. Zanim porówna się funkcje interfejsu, trzeba ustalić, gdzie działają zapytania, jaka tożsamość je wykonuje i jakie dowody mogą opuścić środowisko.
Badanie z 2025 roku dotyczące AI w przedsiębiorstwach, opisane przez CIO Dive, objęło 1050 liderów biznesu i wskazało ograniczenia związane z prywatnością i zgodnością, duplikaty oraz nieefektywną integrację jako główne problemy z danymi. Mniej niż połowa uważała swoje cele w zakresie AI za osiągalne.
Gdzie powinno działać automatyczne profilowanie
Pytanie decyzyjne | W bazie danych, w środowisku klienta | Skanowanie hostowane zewnętrznie |
|---|---|---|
Gdzie analizowane są wartości? | Wewnątrz kontrolowanej granicy bazy danych. | W hostowanym środowisku skanowania, jeśli rekordy są tam przesyłane. |
Co może opuścić środowisko? | Zdefiniować jawną politykę dla obliczonych metryk i metadanych. | Ocenić eksportowane rekordy, przechowywane próbki i metadane pochodne. |
Czyje uprawnienia obowiązują? | Użyć dedykowanej tożsamości wykonawczej z minimalnymi uprawnieniami. | Przejrzeć uprawnienia konektora i model dostępu usługi hostowanej. |
Jak zarządzane jest obciążenie? | Planować zapytania z uwzględnieniem wydajności bazy danych. | Uwzględnić obciążenie ekstrakcją, transfer i przetwarzanie zewnętrzne. |
Co trzeba audytować? | Wykonanie w bazie danych oraz decyzje dotyczące profilowania. | Ekstrakcję, dostęp zewnętrzny, retencję i decyzje dotyczące profilowania. |
Hostowana warstwa sterująca (control plane) nie musi oznaczać hostowanego skanera. Warto zapytać wprost, gdzie przetwarzane są rekordy, zamiast polegać na etykiecie wdrożenia.
Przetestować autoryzowany widok
Czy praca może pozostać w środowisku banku, szpitala, operatora telekomunikacyjnego lub instytucji publicznej? Jakie metadane mogą je opuścić i kto zatwierdza tę decyzję?
Dane wejściowe zaszyfrowane, maskowane, tokenizowane i autoryzowane na poziomie wierszy należy testować osobno. Zmieniona polityka tokenizacji lub ograniczony widok wierszy nie może zostać błędnie uznany za wadę danych źródłowych; narzędzie do profilowania opisuje tylko taką reprezentację, jaką jego tożsamość ma prawo obserwować.
Należy wymagać dowodów audytowych obejmujących zakres, tożsamość, znacznik czasu, wersję reguły, decyzję o dostępie i historię napraw. Wykonanie w bazie danych nie znosi potrzeby kontroli dostępu ani zarządzania zasobami.
Opcja działająca we własnym środowisku
Przetwarzanie w bazie danych w digna to jedna z opcji dla tego wzorca wykonania. Kontrole i obliczanie metryk pozostają w bazie danych klienta, wdrożenie odbywa się w chmurze prywatnej lub on-premises, a dostawca nie ma dostępu do danych produkcyjnych.
Moduły obejmują wyuczone linie bazowe anomalii bez ręcznego budowania każdej kontroli, historyczne trendy metryk, oczekiwany czas dostarczenia, walidację na poziomie rekordów oraz dodane, usunięte lub zmienione typem kolumny. Moduł początkowy zawiera wspólny dashboard, harmonogram, katalog, integracje i funkcje współpracy.
Model handlowy to opłata bazowa plus opłata za każdą aktywną tabelę w każdym module, bez opłat za wywołania API, skanowania czy liczbę alertów. Wydawca deklaruje pierwsze wnioski w czasie poniżej dwóch godzin; warto traktować to jako obietnicę wdrożeniową do zweryfikowania podczas oceny pod kątem własnej łączności, uprawnień i obciążenia.
Procesy firmowe dla profilowania i monitoringu
Warto zacząć od profilu referencyjnego, a nie od pustego edytora reguł. W recenzowanym badaniu z 2022 roku dotyczącym monitoringu z profilami referencyjnymi badacze zaimplementowali DQ-MeeRKat i ocenili go na sześciu rzeczywistych strumieniach danych z urządzeń telematycznych.
Metoda automatycznie uczyła się zestawów statystyk profilowania, aby modelować docelową jakość. Umożliwiała inicjalizację poprzez ciągły monitoring, bez konieczności wcześniejszego pisania każdej reguły przez ekspertów dziedzinowych.
Kierować każdą obserwację do właściwej weryfikacji
Należy zainicjować profil referencyjny, poprosić eksperta dziedzinowego o ocenę jego przydatności i porównywać przychodzące ładowania z zatwierdzoną wersją. Porównanie i reakcja operacyjna powinny pozostać ze sobą powiązane.
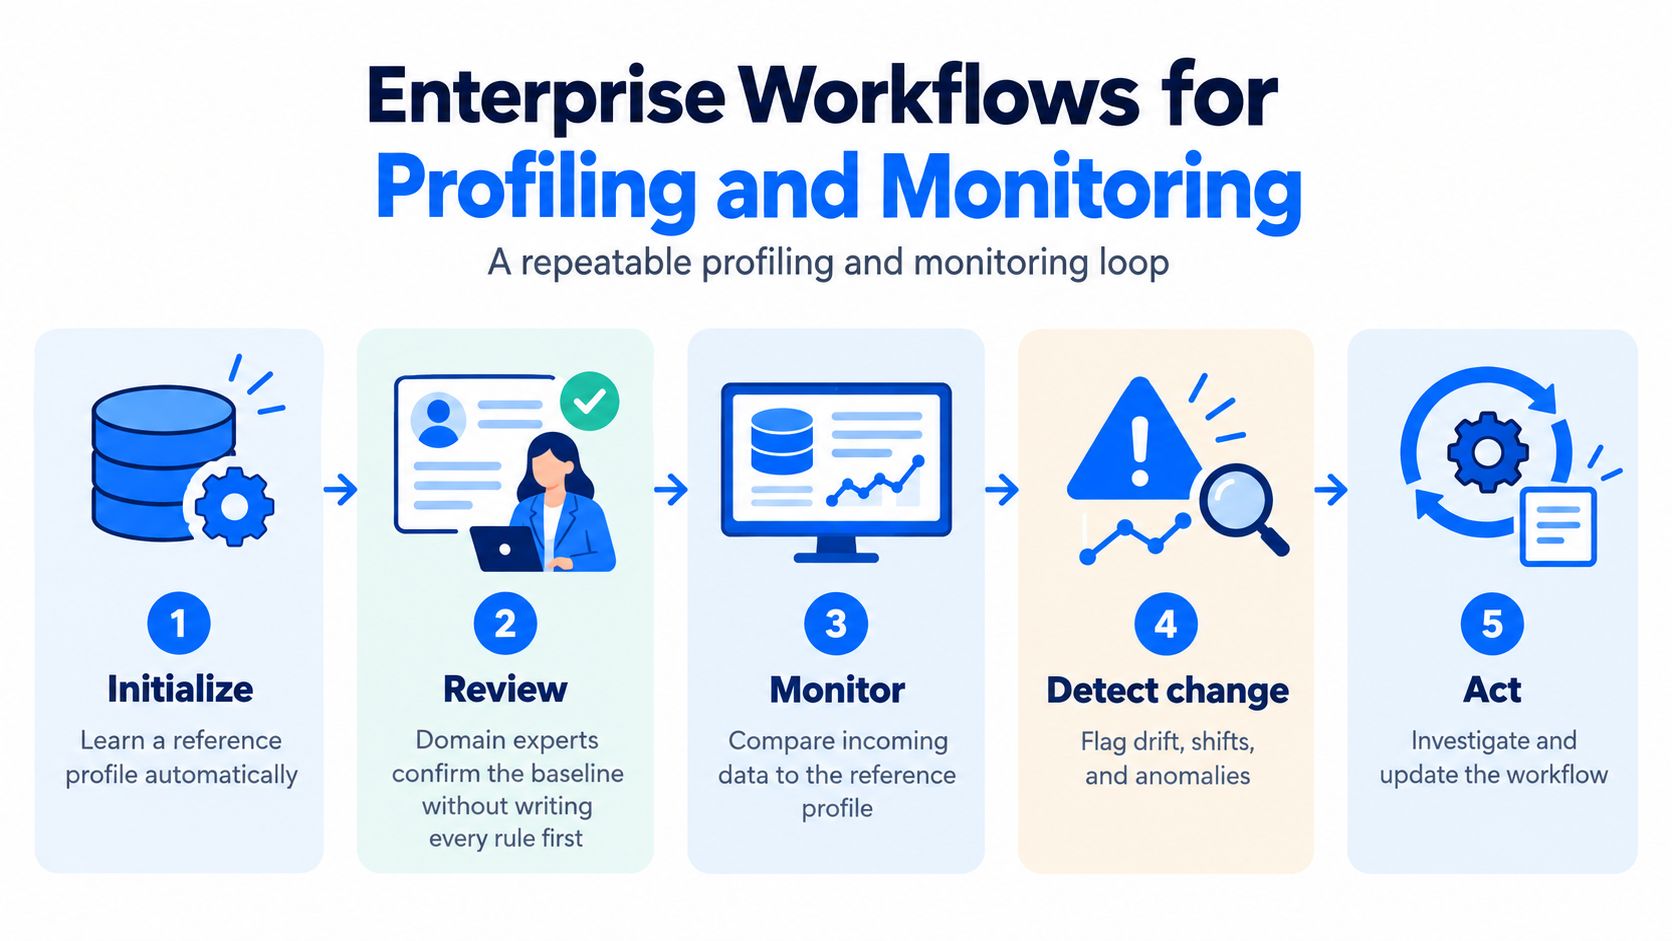
Zamiast wysyłać każdą obserwację do tej samej kolejki, lepiej stosować odrębne ścieżki przekazania:
Odchylenie rozkładu: Przekazać do przeglądu anomalii, aby ustalić, czy zmienił się biznes, czy pipeline wprowadził błąd.
Brakująca lub przedwczesna dostawa: Skierować do przeglądu terminowości wraz z oczekiwanym czasem dostarczenia i dowodem faktycznego przybycia danych.
Podejrzenie naruszenia reguły biznesowej: Uruchomić walidację na poziomie rekordów, aby zidentyfikować rekordy, których to dotyczy.
Dodane, usunięte lub zmienione typem kolumny: Otworzyć przegląd schematu, zanim ruszą zależne transformacje.
Wymagania branżowe decydują o eskalacji. W usługach finansowych priorytet przed raportowaniem mają feedy ryzyka i regulacyjne; w ochronie zdrowia trzeba odróżnić potrzeby kliniczne od operacyjnych.
Zespoły telekomunikacyjne powinny łączyć odchylenia w wielkowolumenowych danych klientów z opóźnieniami pipeline'u. Zespoły w sektorze publicznym powinny zachowywać identyfikowalne decyzje i dowody gotowe do audytu.
Utrzymywać niepewność na widoku
Brakujące wartości mogą tworzyć fałszywe zależności funkcyjne. Badania nad automatycznym wykrywaniem schematów i zależności opisują też ocenę, w której odsetek dokładnych i kompletnych wygenerowanych schematów wzrósł z 60% do 72%, gdy system zwracał pięciu najlepszych kandydatów zamiast jednego wyniku.
To przemawia za uszeregowanymi hipotezami, wskaźnikami pewności i zatwierdzaniem przez człowieka, a nie za automatycznym przyjmowaniem pierwszej odpowiedzi. Osoby weryfikujące muszą widzieć wiarygodne alternatywy, gdy nazwy, typy, klucze lub relacje są niepewne.
Granica zatwierdzania: Automatyzacja proponuje interpretację. Istotne ograniczenia zatwierdza odpowiedzialna osoba.
Zintegrowana platforma może obsługiwać ten przepływ, nie stając się właścicielem znaczenia biznesowego. Warto ustalić odpowiedzialności za monitoring i raportowanie, tak aby inżynierowie odpowiadali za wykonanie, właściciele dziedzinowi oceniali znaczenie, a osoby z obszaru governance mogły odtworzyć decyzje.
Incydent należy zamykać dopiero wtedy, gdy ktoś zapisze przyczynę, działanie i decyzję dotyczącą linii bazowej. Zaakceptowana zmiana biznesowa może uzasadniać aktualizację profilu referencyjnego; błąd pipeline'u nie powinien zostać wchłonięty jako normalne zachowanie.
Rozpocząć automatyczne profilowanie od krytycznych tabel
Warto wybrać krytyczną tabelę, której awaria zepsułaby raport, model lub wynik regulacyjny. Najlepiej taką, która ma wskazanego właściciela biznesowego i inżyniera znającego ścieżkę jej dostarczania.
Należy zapisać, jaką decyzję wspiera tabela i co oznaczałaby jej awaria. Daje to osobom weryfikującym konkretną podstawę do priorytetyzacji ustaleń zamiast traktowania każdego odchylenia jako równie pilnego.
Zdefiniować pierwszą granicę operacyjną
Tabelę należy profilować na miejscu i zachować dowody potrzebne do powtórzenia inspekcji. Snapshot, zapytanie źródłowe lub politykę próbkowania, wersję algorytmu, poziom pewności i decyzję o zatwierdzeniu trzeba przechowywać razem.
Klucza, typu ani zależności o niskiej pewności nie należy przenosić bezpośrednio do egzekwowania produkcyjnego. Właściciel powinien wyjaśnić, czy proponowane ograniczenie odzwierciedla wymaganie, czy tylko wzorzec w obserwowanej próbce.

Uczynić weryfikację powtarzalną
Pilotaż warto oprzeć na niewielkim, jawnym porozumieniu operacyjnym:
Wskazać osoby weryfikujące: Przypisać data engineera i właściciela biznesowego przed włączeniem powiadomień.
Określić reakcję: Ustalić, kto bada obserwację i kto może zatwierdzić zmianę linii bazowej.
Chronić dalsze wykorzystanie: Zdecydować, które zmiany schematu wymagają przeglądu, zanim zależne zadania zaczną korzystać z tabeli.
Zachować wynik: Zapisać, czy incydent był problemem z dostawą, wadliwymi danymi, czy zaakceptowaną zmianą.
Każde nowe ładowanie należy porównywać z zatwierdzonym profilem referencyjnym. Trzeba odróżniać spóźnione dostarczenie od rzeczywistej zmiany rozkładu i badać zmiany strukturalne, zanim uzna się je za nieszkodliwe.
Pierwszy wyjaśnialny incydent warto przeanalizować wspólnie. Inżynier powinien umieć pokazać, co wydarzyło się w pipeline, a właściciel biznesowy opisać konsekwencje dla procesu korzystającego z danych.
Rozszerzać zakres moduł po module można dopiero wtedy, gdy ta pętla działa. Większe pokrycie ma sens, gdy zespół potrafi badać i działać, a nie tylko generować więcej obserwacji.
Przy ograniczonym wdrożeniu platformę instaluje się w istniejącej chmurze, VPC lub centrum danych, wykonuje inspekcję wybranej tabeli i przegląda anomalie, terminowość oraz stan schematu we wspólnym dashboardzie. Przegląd powinien być na tyle wąski, by zespół mógł podjąć i udokumentować decyzję.
digna oferuje dla tego modelu operacyjnego uczenie linii bazowych we własnym środowisku, monitoring anomalii, kontrole terminowości, walidację rekordów i śledzenie schematów. Na stronie digna można ocenić platformę na krytycznej tabeli, a następnie omówić pierwsze wyniki z data engineerem i właścicielem biznesowym, zanim rozszerzy się pokrycie.
Gdy profil referencyjny już istnieje, kolejnym krokiem jest utrzymywanie go na bieżąco bez pisania reguły dla każdej kolumny: moduł Data Anomalies w digna uczy się normalnych wolumenów, rozkładów i odsetka wartości null dla każdej tabeli i sygnalizuje odchylenia, gdy napływają nowe ładowania, dzięki czemu linia bazowa staje się ciągłym wykrywaniem, a nie jednorazowym raportem.
Najczęściej zadawane pytania
Czym jest automatyczne profilowanie danych?
Automatyczne profilowanie danych to systematyczny pomiar tego, co faktycznie zawiera zbiór danych - typów kolumn, liczby wartości null, wartości unikalnych, częstych wzorców, zakresów i rozkładów - zanim oprą się na nim analitycy lub modele. Wynikiem jest zapisana linia bazowa, z którą porównuje się kolejne ładowania, a nie jednorazowy raport, którego nie da się odtworzyć.
Dlaczego ręcznie pisane reguły jakości danych przestają działać na dużą skalę?
Statyczne reguły odpowiadają tylko na pytania, które ktoś już wcześniej postawił. Gdy zmieniają się źródła, raporty i właściciele, pojawia się częściowe pokrycie, kod SQL, którego po odejściu autora nikt nie potrafi wyjaśnić, oraz zmęczenie alertami z przestarzałych kontroli, a nowe kategorie czy przesunięte rozkłady pozostają niezauważone.
Jakie metryki powinien zawierać profil danych?
Przydatny profil obejmuje kompletność, unikalność, zgodność typów, częstość i rozkład, a także jawne wskaźniki wartości null i pustych, ponieważ pusty ciąg znaków i null w bazie mogą wymagać innego traktowania. Dojrzałe narzędzia dodają domeny, klucze kandydujące i zależności funkcyjne, wersjonowane według tabeli, kolumny, partycji i czasu obserwacji.
Jak ograniczyć fałszywe alerty z profilowania danych?
Pomagają linie bazowe uwzględniające czas i adaptacyjne progi, bo normalne zachowanie różni się w zależności od dnia tygodnia, końca miesiąca, sezonu czy cyklu wydań. Warto oddzielić brakujące dane od błędnych, modelować oczekiwany czas dostarczenia i zapisywać, czy alert oznaczał potwierdzony błąd, zaakceptowaną zmianę, czy nierozstrzygnięte dochodzenie.
Czy profilowanie danych powinno działać w bazie danych, czy w hostowanym skanerze?
W przypadku wrażliwych danych firmowych bezpieczniejszym wyborem jest profilowanie w bazie danych, w środowisku klienta. Wartości pozostają w kontrolowanej granicy, zapytania wykonuje tożsamość o minimalnych uprawnieniach, a na zewnątrz trafiają tylko obliczone metryki zgodnie z jawną polityką; zewnętrzny skaner wymaga oceny eksportowanych rekordów, przechowywanych próbek i uprawnień konektora.


