Observability vs monitoring: praktyczny przewodnik decyzyjny
|
7
min. czyt.

Najgorsza rada w tej dyskusji jest prosta: wybierz observability i wycofaj monitoring. Brzmi nowocześnie, ale w realnych zespołach danych to błąd. Monitoring to warstwa kontroli, observability to warstwa diagnostyki, a właściwa odpowiedź zależy od tego, ile kosztuje pomyłka w przypadku danego obciążenia.
Kryterium decyzji | Monitoring | Observability |
|---|---|---|
Główne zadanie | Wykrywanie znanych stanów błędów | Wyjaśnianie nieznanych lub wieloczynnikowych awarii |
Najlepsze dowody | Progi, alerty, stabilne sygnały | Skorelowane metryki, logi, trace'y i kontekst |
Audytowalność | Wysoka, gdy kontrole są jawne | Słabsza, jeśli zastępuje jawne kontrole |
Profil kosztów | Niższy i węższy | Wyższy i szerszy |
Najlepsze zastosowanie | Stabilne, dobrze poznane tryby awarii | Złożone, rozproszone awarie lub awarie o dużym zasięgu skutków |
Spis treści
Dlaczego spór observability vs monitoring pomija właściwe pytanie
Gdzie wykrywanie anomalii przez AI i śledzenie schematów naprawdę się opłacają
Fragmentacja narzędzi i realne przeszkody na drodze do jednolitego pokrycia
Hybrydowy model operacyjny i konsekwencje dla poszczególnych branż
Dlaczego spór observability vs monitoring pomija właściwe pytanie
Dyskusję zwykle przedstawia się jak wyścig, w którym jedna dyscyplina ma zastąpić drugą. To uproszczenie na skróty. Monitoring i observability rozwiązują różne problemy, a błędne zastąpienie jednego drugim zamiast przejrzystości tworzy martwe pola.
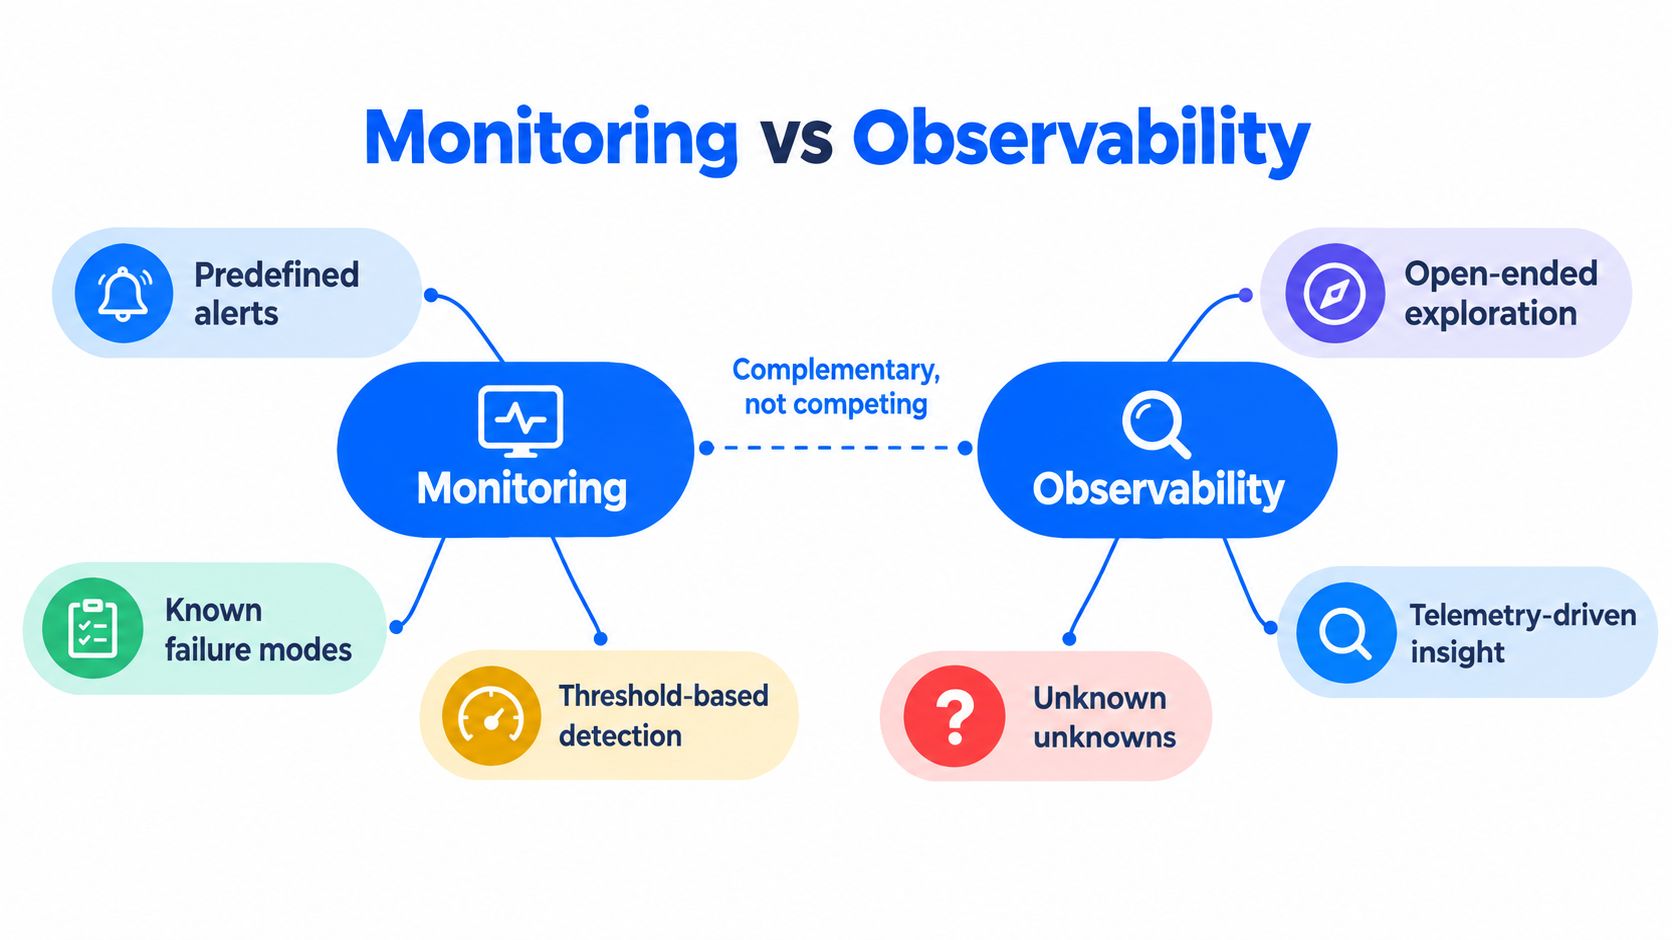
Monitoring to jawna kontrola. Definiuje się sygnał, ustala limit i wysyła alert, gdy rzeczywistość go przekroczy. Observability jest pojęciem szerszym: chodzi o to, by stan wewnętrzny systemu dało się wywnioskować z emitowanych danych, tak aby inżynierowie mogli wyjaśniać nieznane wcześniej awarie, a nie tylko potwierdzać te przewidziane. Praktyczne pytanie nie brzmi, który termin jest bardziej na czasie, lecz jaki poziom głębokości diagnostycznej uzasadnia dane obciążenie.
Ma to znaczenie, ponieważ zastąpienie monitorów szeroką observability może osłabić governance. Kontrole, które stają się niejawne, trudniej audytować. Dla platformy danych to zła wymiana. Brakujące ładowanie, uszkodzony schemat czy dryf KPI nie wymagają filozoficznej elegancji, tylko jasno wskazanego właściciela, alertu i śladu dowodowego.
Praktyczna zasada: jawne monitory warto utrzymać dla znanych trybów awarii, a observability dodawać tylko tam, gdzie potrzebna jest głęboka analiza przyczyn źródłowych, korelacja lub diagnoza eksploracyjna.
Książka Google Site Reliability Engineering sformalizowała cztery złote sygnały dla usług obsługujących użytkowników: opóźnienie (latency), ruch (traffic), błędy (errors) i nasycenie (saturation). Ten punkt odniesienia wciąż się sprawdza, bo daje zespołom zwartą warstwę monitoringu dla znanych problemów. Platformy danych potrzebują jednak czegoś więcej niż zdrowia usług: także aktualności danych, stabilności schematu, poprawności rekordów, zachowania metryk biznesowych i zużycia zasobów przez obciążenia.
Przy decyzji, w co inwestować, warto przestać pytać, czy observability jest lepsza od monitoringu. Lepiej zapytać, jakich dowodów potrzeba, gdy coś pójdzie nie tak ze zbiorem danych, pipeline'em lub raportem, i ile kosztuje reakcja spóźniona, nieprecyzyjna albo błędna.
Co naprawdę oznaczają monitoring i observability
Monitoring to z góry zdefiniowana funkcja wykrywania. Zespoły wybierają wskaźniki, takie jak liczba żądań, odsetek błędów, opóźnienie, wykorzystanie CPU czy status dostarczenia danych, a następnie alarmują, gdy wartości przekroczą próg lub wyjdą poza oczekiwany zakres. Monitoring odpowiada na wąskie, ale kluczowe pytanie: czy znany warunek wykracza poza swój limit?
Observability sięga dalej. Pyta, czy stan wewnętrzny systemu da się wywnioskować z danych, które ten system emituje. W praktyce oznacza to korelowanie metryk, logów i trace'ów, tak aby inżynierowie mogli badać awarię, której nie przewidzieli, pisząc alert.
Punkt wyjścia dla większości zespołów
Klasyczne spojrzenie na poziomie usług wciąż ma znaczenie. Model SRE Google wyznacza minimalną bazę monitoringu: opóźnienie, ruch, błędy i nasycenie. Te sygnały są użyteczne, bo wymuszają dyscyplinę. Alert opóźnienia mówi, że usługa działa wolno, ruch pokazuje zmianę popytu, błędy informują o nieudanych żądaniach, a nasycenie sygnalizuje, że ograniczony zasób jest bliski pełnego wykorzystania. Więcej teorii nie trzeba.
Na platformach danych to odwzorowanie jest bezpośrednie, choć nie identyczne. Opóźnienie usługi zastępuje aktualność danych i terminowość dostaw. Ruch zastępują wzorce obciążenia i konsumpcji. Błędy to nieudane zadania, niepoprawne rekordy lub uszkodzone transformacje. Nasycenie to obciążenie hurtowni, klastra lub pipeline'u.
Monitoring informuje, że coś przekroczyło granicę. Observability pomaga wyjaśnić, co się zmieniło, gdzie się zmieniło i na co jeszcze wpłynęło.
To rozróżnienie wyjaśnia, dlaczego zespoły danych się sparzają, gdy traktują zielony dashboard jako dowód poprawności. Dashboard może być dostępny, a mimo to analitycznie błędny, bo dane są nieaktualne, niekompletne, zduplikowane lub zmieniła się ich struktura. Jeśli biznes zależy od wyniku, potrzebna jest zarówno kontrola, jak i dowody.
Praktyczny punkt startowy opisuje podejście digna do data observability.
Cele, telemetria oraz wykrywanie a diagnoza
Najprościej rozdzielić te dyscypliny, porównując, do czego służą, z jakich dowodów korzystają i jak daleko prowadzą. Monitoring dotyczy celów kontrolnych. Observability dotyczy diagnozy. Pierwszy jest zbudowany wokół znanych limitów, druga służy do dochodzenia w warunkach niepewności.
Macierz decyzyjna
Kryterium | Monitoring | Observability |
|---|---|---|
Cel kontrolny | Egzekwowanie znanych limitów i oczekiwań wobec usług | Wyjaśnianie wewnętrznego zachowania i wyłaniających się wzorców awarii |
Typowy wyzwalacz | Przekroczenie progu, brakujące zadanie, niespełniona reguła, opóźniona dostawa | Nietypowa korelacja, zmiana zachowania, niewyjaśniona anomalia |
Zakres telemetrii | Zagregowane metryki i alerty | Skorelowane metryki, logi, trace'y i bogatszy kontekst |
Na jakie pytanie odpowiada | Co się stało i czy przekroczyło tolerancję? | Co się zmieniło, dlaczego i na co jeszcze może to wpływać? |
Model odpowiedzialności | Jasny właściciel operacyjny znanych kontroli | Wspólna diagnoza zespołów platformy, danych i aplikacji |
Ślad audytowy | Mocny, gdy kontrole są jawne | Mocniejszy w dochodzeniach niż jako formalny dowód kontroli |
Profil kosztów | Zwykle węższy i tańszy w utrzymaniu | Szerszy, droższy i łatwiej go przewymiarować |
Podstawowy podział OpenTelemetry jest tu przydatny. Metryki to pomiary w czasie działania, logi to zapisy zdarzeń, a trace'y to ścieżki żądań przez usługi. Cały sens leży w korelacji. Metryka pokazuje, że wzrosło opóźnienie, trace wskazuje, która ścieżka zwolniła, a logi wyjaśniają zdarzenie, które to spowodowało. Materiały IBM o observability ujmują to prostym językiem: metryki alarmują, trace'y pokazują ścieżki wykonania, a logi dostarczają kontekstu do rozwiązania problemu.
Dla zespołów danych oznacza to, że telemetrii nie wybiera się według mody, lecz według wartości diagnostycznej. Jeśli problemem jest nieudane zadanie wsadowe, monitor może wystarczyć. Jeśli błędny jest model, raport lub proces klienta w dalszej części łańcucha, potrzebny jest dodatkowy kontekst, który połączy objaw z przyczyną.
Właściwe dowody do właściwego zadania
Monitoring do kontroli: sprawdza się tam, gdzie tryb awarii jest znany, limit stabilny, a dowody muszą być jawne.
Observability do diagnozy: sprawdza się tam, gdzie przyczyna jest niepewna, graf zależności zagmatwany lub w grę może wchodzić wiele systemów.
Oba podejścia razem: warto je łączyć, gdy koszt pomyłki jest wysoki, a awaria może przebiegać po cichu.
Bardziej operacyjne ujęcie zawierają dobre praktyki observability dla zespołów danych. Nie chodzi o zbieranie wszystkiego. Chodzi o zebranie wystarczających dowodów, by kolejną decyzję dało się obronić.
Scenariusze wykrywania na platformie danych
Abstrakcyjne definicje nie poruszają zespołów. Incydenty tak. Najłatwiej odróżnić monitoring od observability, konfrontując je z awariami, które faktycznie zdarzają się na platformach danych.
Nieudane nocne ładowanie i opóźniona dostawa
Nieudane zadanie wsadowe to najprostszy przypadek. Monitoring powinien wychwycić przerwany przebieg, brakującą tabelę lub spóźnione dane. Alert powinien być bezpośredni i umożliwiać działanie. Observability wnosi wartość dopiero wtedy, gdy awaria nie jest oczywista, na przykład gdy zadanie się zakończyło, ale zatrzymała się zależność, nie dotarła partycja albo dane przyszły po zamknięciu okna biznesowego.
Właśnie tu liczy się śledzenie terminowości. Jeśli zasilenie regulacyjne, ekstrakt finansowy lub migawka operacyjna mają termin, alert powinien informować, że dane się spóźniają. Warstwa observability powinna pokazać, czy opóźnione było źródło, transfer, czy też rekord zatrzymał któryś z dalszych kroków.
Cicha zmiana schematu i awarie w systemach downstream
Dryf schematu to sytuacja, w której sam monitoring jest słaby. Pipeline może nadal działać, ale kontrakt danych jest zerwany. Monitoring wychwyci brakującą kolumnę, nieudane parsowanie lub naruszenie reguły, o ile odpowiednia kontrola została już napisana. Observability potrzebuje kontekstu schematu, lineage i listy dotkniętych odbiorców, aby pokazać, co się zmieniło i który raport lub model przestał być wiarygodny.
Spadek KPI i wpływ na biznes
Spadek w raportowaniu przychodów to inny problem. Dane mogą być technicznie poprawne, ale zmienił się wynik biznesowy. Monitoring może zasygnalizować odchylenie KPI, jeśli jest ono jawnie śledzone. Observability przydaje się, gdy trzeba powiązać tę zmianę z wolumenem, sezonowością, zachowaniem systemów upstream lub zmianą obciążenia w systemach źródłowych.
Wykonywanie i analiza wewnątrz bazy danych
Najlepsza ścieżka diagnostyczna często kończy się w samej hurtowni lub jeziorze danych. Obliczanie kontroli w miejscu ogranicza przenoszenie danych i utrzymuje dowody blisko nich. W środowiskach wrażliwych to lepsze rozwiązanie niż rozsyłanie kopii rekordów po dodatkowych narzędziach.

Przy zbiorach danych bogatych w anomalie kolejnym właściwym pytaniem są rodzaje wykrywania anomalii. Nie należy jednak komplikować statycznych tabel referencyjnych ani zasileń compliance typu append-only. Takie obciążenia zwykle potrzebują najpierw solidnego monitoringu, a nie wyszukanej eksploracji.
Stosy telemetryczne i ich rzeczywisty koszt
To przy narzędziach dobre intencje najczęściej umierają. Zespołom zwykle wydaje się, że kupują widoczność, a potem odkrywają, że kupiły pracę konfiguracyjną, uciążliwe integracje i kolejną kolejkę alertów.
Prawdziwym kosztem są tarcia operacyjne
W badaniu Grafana Labs z 2025 roku obejmującym 1255 respondentów główną obawą związaną z observability była złożoność, największą przeszkodą w szybszym reagowaniu na incydenty było zmęczenie alertami, a wydatki na observability wynosiły średnio 17% całkowitych wydatków na infrastrukturę obliczeniową. Wynikają z tego dwie rzeczy. Po pierwsze, observability nie jest darmowa. Po drugie, więcej telemetrii nie oznacza automatycznie szybszej diagnozy. Może oznaczać po prostu więcej pracy.
Otwarte standardy pomagają, ale nie usuwają tego ciężaru. OpenTelemetry i stosy klasy Prometheus ułatwiają przenoszenie danych i zachowanie przenośności instrumentacji. Nie redukują jednak w magiczny sposób szumu alertów, pracy przy konfiguracji pipeline'ów danych ani koordynacji potrzebnej, by zamienić sygnały w działania.
Dobór stosu według wartości dowodowej
Wzorzec stosu | Najlepsze zastosowanie | Główny kompromis |
|---|---|---|
Monitoring oparty na metrykach | Stabilne usługi, znane SLO, jawne alerty | Mniejsza głębokość diagnostyczna |
Metryki plus logi plus trace'y | Systemy rozproszone i wieloetapowe dochodzenia | Większy nakład na konfigurację i korelację |
Wykonywanie wewnątrz bazy danych | Dane wrażliwe, obciążenia skupione wokół hurtowni, mniejsze przenoszenie danych | Mniejsza elastyczność przy zbyt restrykcyjnym modelu |
Podejście in-database zmienia ekonomię. Dane zostają na miejscu, ich przenoszenie jest ograniczone, a rozwiązanie pasuje do środowisk, w których governance liczy się tak samo jak szybkość. Dla korporacyjnych platform danych to często właściwa odpowiedź, bo telemetria powinna znajdować się blisko danych, które opisuje. Jeśli trzeba skopiować pół hurtowni tylko po to, by ją zmierzyć, to zapewne robi się za dużo.

Jeśli miałaby paść jedna praktyczna rekomendacja: należy stosować najtańszy stos, który wciąż zapewnia możliwą do obrony diagnozę dla danego obciążenia. Wszystko ponad to jest dekoracją.
Gdzie wykrywanie anomalii przez AI i śledzenie schematów naprawdę się opłacają
Wykrywanie anomalii przez AI jest przydatne tam, gdzie statyczne progi zawodzą. Jeśli zbiór danych obejmuje zmienne przychody, nieregularne zachowania konsumentów, szum z czujników lub zdarzenia generowane maszynowo, stałe limity stają się topornym narzędziem. Uczenie się wartości bazowych i ciągłe porównywanie pozwalają wychwycić istotne odchylenia bez ręcznego strojenia każdej reguły.
Detekcja statystyczna tam, gdzie zachowanie danych się zmienia
Tu wykrywanie anomalii oparte na AI naprawdę się opłaca. Pomaga, gdy kształt danych zmienia się w czasie, a sygnał jest ważniejszy niż dokładna liczba. Próg powie, że coś jest wysokie. Wartość bazowa powie, że coś jest nietypowe.
Słabo sprawdza się natomiast przy statycznych tabelach referencyjnych, deterministycznych kluczach i zasileniach compliance typu append-only. Takie obciążenia nie potrzebują sprytu. Potrzebują niezawodnych kontroli i jasno określonej odpowiedzialności.
Dopasowanie kontroli do zbioru danych
Aktualność i terminowość: monitoring dostarczenia danych warto stosować tam, gdzie dla biznesu liczy się, kiedy dane docierają, a nie tylko czy docierają.
Śledzenie schematów: należy je stosować wszędzie tam, gdzie odbiorcy downstream zależą od stabilnej struktury.
Walidacja rekordów: służy do egzekwowania reguł biznesowych, zwłaszcza tam, gdzie liczą się dowody audytowe.
Wykonywanie wewnątrz bazy danych: warto je wybrać, gdy ograniczeniem jest bezpieczeństwo, governance lub przenoszenie danych.
Częstym praktycznym błędem jest traktowanie każdego zbioru danych jako równie dynamicznego. Tak nie jest. Wolno zmieniająca się tabela wymiarów nie zasługuje na taki sam rachunek za observability jak wysokowolumenowe zasilenie transakcyjne czy zmienny strumień przychodów.
Warto też w myśleniu oddzielać śledzenie schematów od wykrywania anomalii. Dryf schematu ma charakter strukturalny. Wykrywanie anomalii dotyczy zachowania. W poważnym środowisku danych potrzebne jest jedno i drugie, ale rozwiązują one różne problemy i nie powinno się ich uzasadniać tym samym argumentem.
Przy decyzji, w co inwestować, właściwą perspektywę daje tekst o tym, jak AI wykrywa anomalie danych w pipeline'ach. Inteligencję warto stosować tam, gdzie zmienność jest realna, a nie tam, gdzie reguła wykona zadanie czysto.
Fragmentacja narzędzi i realne przeszkody na drodze do jednolitego pokrycia
Gdyby observability była tylko aktualizacją narzędzi, jednolite pokrycie byłoby już normą. Nie jest. Badanie CNCF z 2026 roku obejmujące 407 praktyków wykazało, że 46,7% organizacji używało równolegle dwóch lub trzech narzędzi observability, a tylko 7,4% osiągnęło jedno, spójne środowisko observability. Największym wyzwaniem konfiguracyjnym była konfiguracja dashboardów i alertów, wskazana przez 54%.

Na tym polega sedno sprawy. Trudność nie leży w zakupie kolejnej platformy, tylko we wpięciu telemetrii w proces, który daje diagnozę umożliwiającą działanie, a nie kolejne zakładki. Złożoność integracji i konfiguracja pipeline'ów danych spowalniają zespoły, bo każdy dodatkowy sygnał oznacza pracę dla inżynierów, operatorów i analityków.
Zasada operacyjna: najgłębiej należy instrumentować jak najmniej zbiorów danych, a resztę pozostawić na jawnym monitoringu. Pełne pokrycie wszystkiego zwykle prowadzi jedynie do zmęczenia alertami i rozmytej odpowiedzialności.
Dlatego też dojrzałość observability jest najpierw problemem procesów, a dopiero potem narzędzi. Jeśli nikt nie odpowiada za monitor, alert staje się szumem. Jeśli nikt nie potrafi wyjaśnić sygnału, dane stają się ozdobą. Głębokość pokrycia należy dopasować do krytyczności, a nie do optymizmu.
Jako praktyczna ścieżka wdrożenia narzędzia digna do data observability wpisują się w model selektywnej głębokości. Właściwy stos to taki, który zespół jest w stanie obsługiwać.
Hybrydowy model operacyjny i konsekwencje dla poszczególnych branż
Model, którego da się bronić, jest hybrydowy. Monitoring odpowiada za cele kontrolne, dowody audytowe i stabilne oczekiwania co do poziomu usług. Observability odpowiada za diagnozę eksploracyjną, wyznaczanie wartości bazowych i wyłaniające się awarie. To nie kompromis, tylko dyscyplina.
Ma to największe znaczenie w środowiskach regulowanych lub tam, gdzie awarie mają duży zasięg skutków. W usługach finansowych potrzebne są jawne kontrole danych finansowych, ryzyka, regulacyjnych i transakcyjnych, bo dowody muszą się obronić przed audytorami i zespołami operacyjnymi. W ochronie zdrowia liczą się niezawodność i identyfikowalność, ponieważ dane kliniczne i operacyjne nie mogą dryfować niezauważone. W telekomunikacji zachowania przy dużych wolumenach zmieniają się szybko, dlatego potrzebny jest silny monitoring oraz wystarczająca observability, by wyjaśniać skoki, problemy z dostawami i zużycie platformy. W sektorze publicznym gotowe do audytu dowody i spójność są ważniejsze niż efektowne pokrycie.
Prosta polityka operacyjna
Monitorować to, co nie może zawieść bez ostrzeżenia. Jawne kontrole należy stosować dla brakujących ładowań, nieaktualnych danych, zmian schematu i naruszeń reguł biznesowych.
Obserwować to, czego nie da się przewidzieć. Głębszą telemetrię warto dodawać tam, gdzie ścieżka awarii jest niejednoznaczna, rozproszona lub kosztowna do rozwikłania.
Regularnie oceniać każde obciążenie na nowo. Jeśli dane zmieniają się szybciej niż progi, większą część tego obciążenia warto przenieść do observability.
Najgorszym błędem jest założenie, że jedna dyscyplina to dojrzała wersja drugiej. To partnerzy o różnych zadaniach. Monitoring dba o to, żeby światło się paliło. Observability wyjaśnia, dlaczego zamigotało.
Dla korporacyjnych zespołów danych to cała decyzja. Każde obciążenie należy przypisać do dyscypliny odpowiadającej kosztowi jego awarii, obciążeniom związanym z compliance i dojrzałości telemetrii, a następnie korygować ten podział wraz z rozwojem stosu. Platformę zbudowaną dokładnie wokół tej logiki można poznać na stronie digna, sprawdzając, jak obsługuje anomalie danych, terminowość, zmiany schematu, walidację i wykonywanie wewnątrz bazy danych we własnym środowisku.
Realizacja takiego hybrydowego podziału jest prostsza, gdy jawne kontrole i dowody diagnostyczne znajdują się w tym samym miejscu co dane. Observability platformy danych od digna uruchamia wykrywanie anomalii, walidację, kontrolę terminowości i śledzenie schematów wewnątrz własnej bazy danych, dzięki czemu każde obciążenie otrzymuje potrzebną głębokość bez kopiowania rekordów do kolejnego narzędzia.
Najczęściej zadawane pytania
Czym różni się observability od monitoringu?
Monitoring wykrywa znane stany błędów na podstawie zdefiniowanych progów i alertów, a observability wyjaśnia nieznane lub wieloczynnikowe awarie, korelując metryki, logi i trace'y. Monitoring to warstwa kontroli, observability to warstwa diagnostyki, dlatego większość zespołów danych potrzebuje obu, zamiast zastępować jedno drugim.
Czy observability powinno zastąpić monitoring?
Nie. Zamiana jawnych monitorów na szeroką observability sprawia, że kontrole stają się niejawne i trudniejsze do audytu, co jest złym wyborem dla platformy danych. Warto zachować jawne monitory dla znanych typów awarii, takich jak brakujące ładowania, uszkodzone schematy i dryf KPI, a observability dodawać tylko tam, gdzie potrzebna jest głęboka analiza przyczyn.
Jakie są cztery złote sygnały monitoringu?
Książka Google Site Reliability Engineering wymienia opóźnienie, ruch, błędy i nasycenie. Na platformie danych odpowiadają im świeżość i terminowość dostaw, wzorce obciążenia i zużycia, nieudane joby lub nieprawidłowe rekordy oraz obciążenie hurtowni, klastra lub pipeline'u, a do tego dochodzi stabilność schematu i zachowanie wskaźników biznesowych.
Ile kosztuje observability w porównaniu z monitoringiem?
Observability jest szersze i wyraźnie droższe. W badaniu Grafana Labs z 2025 roku obejmującym 1255 respondentów wydatki na observability wynosiły średnio 17% całkowitych kosztów infrastruktury obliczeniowej, a złożoność była główną obawą. Monitoring jest węższy i tańszy, dlatego praktyczna rada brzmi: najtańszy stack, który wciąż daje obronialną diagnozę.
Kiedy stosować wykrywanie anomalii z AI zamiast stałych progów?
Wykrywanie anomalii z AI opłaca się, gdy zachowanie danych się zmienia, na przykład przy niestabilnych przychodach, nieregularnych zachowaniach klientów, szumie z czujników lub zdarzeniach generowanych maszynowo, gdzie stałe limity stają się tępym narzędziem. Słabo pasuje do statycznych tabel referencyjnych, deterministycznych kluczy i feedów compliance typu append-only, które wymagają niezawodnych reguł.


