Wykrywanie anomalii w danych kategorycznych – wyjaśnienie
|
7
min. czyt.

Ten scenariusz awarii już znasz. Pulpit jest spokojny, kontrole liczbowe nie wykazują problemów, a model, który w zeszłym tygodniu działał bez zarzutu, zaczyna zwracać bezsensowne wyniki, bo jedno pole kategoryczne zmieniło się w sposób, którego nikt nie zauważył. Pojawia się nowy kod statusu, kategoria produktu zostaje przemapowana albo dostawca zaczyna przesyłać inną etykietę kraju, a usterka wychodzi na jaw dopiero wtedy, gdy system w dalszej części procesu podjął już błędne decyzje.
Dlatego wykrywanie anomalii w danych kategorycznych wymaga własnego podręcznika postępowania. W przestrzeniach kategorycznych sygnał zwykle kryje się w rzadkich wartościach, nieoczekiwanych kombinacjach i zmianach częstości łącznych, a nie w odległości od średniej czy dużym skoku liczbowym. Praktycznym zadaniem jest wychwycenie tych zmian na tyle wcześnie, by inżynierowie danych, analitycy i właściciele modeli mogli zareagować, zanim zaufanie zostanie nadszarpnięte.
Spis treści
Dlaczego standardowe algorytmy zawodzą przy cechach kategorycznych
Zarządzanie cechami o wysokiej kardynalności i dryfem schematu
Ukryte ryzyka zmian w danych kategorycznych
Najpoważniejsze incydenty rzadko zaczynają się od głośnej awarii. Potok nadal działa, liczba wierszy wygląda normalnie, a jedyną zmianą jest etykieta, której nikt nie pomyślał monitorować. Potem model zaczyna dziwnie klasyfikować klientów, ponieważ struktura kategorii, której się nauczył, nie odpowiada już rzeczywistości produkcyjnej.
Anomalie kategoryczne różnią się od wartości odstających w danych liczbowych. Anomalią liczbową może być wartość daleka od średniej, natomiast anomalią kategoryczną jest często poziom lub kombinacja poziomów w różnych polach, która występuje z nietypowo niską częstością w porównaniu z populacją bazową. Dlatego sama kategoria ma mniejsze znaczenie niż to, jak często występuje i jak współwystępuje z innymi polami, co stanowi podstawową logikę opisaną w literaturze na temat wykrywania anomalii kategorycznych w odniesieniu do rzadkich wzorców tabel kontyngencji i rzadkości wartości łącznych rozdział wydawnictwa Springer o wykrywaniu anomalii kategorycznych.
Awaria produkcyjna zwykle zaczyna się od drobnej zmiany etykiety
Zespół finansowy może widzieć ten sam wolumen transakcji, podczas gdy kod statusu płatności zmienia postać, a reguły w dalszej części procesu przestają odpowiadać faktycznemu procesowi. Zespół z sektora ochrony zdrowia może nadal otrzymywać poprawnie wyglądające roszczenia, podczas gdy jedno pole zaczyna zawierać nową wartość kodową, której stara logika walidacji nigdy nie poznała. W obu przypadkach liczby pozostają stabilne wystarczająco długo, by ukryć problem.
Dlatego zespoły muszą traktować zmiany kategoryczne jako sygnał pierwszej kategorii. Rozkład kategorii może dryfować, mimo że żadne pojedyncze pole nie wygląda na skrajne, a wzorzec łączny może być anomalny, nawet gdy każde pole z osobna wygląda normalnie. Praktyczne ryzyko polega na tym, że prosty pulpit daje fałszywe poczucie stabilności.
Jako praktyczny przykład szerszego problemu monitorowania, wzorce dryfu danych omówione w przeglądzie digna dotyczącym wykrywania dryfu danych bezpośrednio wpisują się w to spojrzenie na zmiany kategorii. Wniosek operacyjny jest prosty: jeśli zmienia się przestrzeń etykiet, zmienia się też świat modelu.
Praktyczna zasada: jeśli pole kategoryczne może zmienić znaczenie biznesowe bez zmiany liczby wierszy, powinno zostać objęte kontrolami anomalii.
Dlaczego standardowe algorytmy zawodzą przy cechach kategorycznych
Większość narzędzi do wykrywania anomalii liczbowych zakłada geometrię, której dane kategoryczne nie mają. Odległość euklidesowa sprawdza się dla punktów w przestrzeni ciągłej, ale kod kraju, typ transakcji czy status roszczenia nie są „blisko” ani „daleko” w żadnym sensownym porządkowym znaczeniu. Traktowanie etykiet jak współrzędnych zamienia problem dyskretny w pozornie liczbowy.
Ta niezgodność ma największe znaczenie przy wysokiej kardynalności. Gdy zmienne kategoryczne stają się coraz bardziej szczegółowe, tabele kontyngencji stają się rzadkie, a użyteczny sygnał przenosi się do rzadkich przecięć zamiast dużych wartości. Standardowa literatura przeglądowa zauważa, że klasyczne metody wykrywania anomalii często zakładają dane ciągłe, dlatego zmienne kategoryczne są często przekształcane w atrybuty ciągłe przed wykrywaniem, mimo że takie przekształcenie może zatrzeć właśnie tę strukturę, którą trzeba zbadać przegląd metod wykrywania anomalii w CEUR.
Przeoczenia zdarzają się w rzadkich wzorcach tabel kontyngencji
Sam kod kraju może wyglądać zwyczajnie. Sam typ płatności może wyglądać zwyczajnie. Sama klasa urządzenia może wyglądać zwyczajnie. Jednak kombinacja tych trzech pól może być na tyle rzadka, że zasługuje na uwagę, a metody oparte na odległości liczbowej często to pomijają, ponieważ skupiają się na wielkości, a nie na współwystępowaniu.
Dlatego zmienne kategoryczne o wysokiej kardynalności sprawiają problemy. Kodowanie one-hot może gwałtownie zwiększyć wymiarowość, progi oparte na odchyleniu standardowym tracą sens, a wartości Z nie mówią, czy nowy kod jest nietypowy, czy po prostu nowy. W praktyce zespoły potrzebują metod, które oceniają rzadkość, porównują rozkłady i uwzględniają dyskretny charakter danych.
Lepszy model myślowy zaczyna się od częstości, a nie odległości
Myśl w kategoriach wsparcia kategorii, częstości warunkowej oraz liczności obserwowanych w porównaniu z oczekiwanymi. Jeśli poziom kategorii jest powszechny w danych historycznych, ale nagle znika, może to mieć znaczenie. Jeśli rzadki poziom nagle staje się dominujący, również może to mieć znaczenie. Metoda powinna odzwierciedlać tę logikę, zamiast wtłaczać dane w kształt geometryczny, którego nigdy nie miały.
Statystyczne rozpoznawanie wzorców w polach kategorycznych to tutaj właściwa perspektywa, ponieważ traktuje etykiety jak etykiety, a nie jak zamaskowane liczby. Na tym polega różnica między potokiem, który sygnalizuje faktyczne zmiany kategorii, a takim, który generuje jedynie matematyczny szum.
Statystyczne punkty odniesienia i ocena częstości
Zacznij od punktu odniesienia, który odzwierciedla stan normalny dla każdego pola kategorycznego. W przypadku stabilnej kolumny jest to zwykle historyczny rozkład częstości każdego poziomu kategorii oraz częstości łączne istotne dla procesu biznesowego. Jeśli dane są sezonowe lub zależą od przebiegu procesów, porównuj podobne z podobnym, zamiast zakładać, że jeden globalny punkt odniesienia pasuje do wszystkiego.
Porównuj liczności obserwowane z oczekiwanymi
Test chi-kwadrat to standardowy sposób porównywania obserwowanych częstości kategorii z rozkładem bazowym w celu wykrycia dryfu kategorycznego, a przewodnik dotyczący dryfu danych w przetwarzaniu strumieniowym opisuje go jako odpowiedni do wykrywania zmian w polach takich jak kody statusu czy kategorie produktów przewodnik Conduktor dotyczący dryfu danych. PSI jest również przydatny do przekładania zmian rozkładu na operacyjny poziom istotności. Ten sam przewodnik podaje progi PSI: poniżej 0,1 oznacza minimalny dryf, od 0,1 do 0,25 umiarkowany dryf wymagający zbadania, a powyżej 0,25 istotny dryf wymagający natychmiastowego działania.
Wartość PSI | Istotność dryfu | Zalecane działanie |
|---|---|---|
Poniżej 0,1 | Minimalny dryf | Monitoruj i utrzymuj aktywny punkt odniesienia |
Od 0,1 do 0,25 | Umiarkowany dryf | Zbadaj źródło kategorii i wpływ na dalsze etapy |
Powyżej 0,25 | Istotny dryf | Traktuj jako pilne i przeanalizuj zmiany w potoku lub w biznesie |
Używaj entropii, aby szybko ocenić nieprzewidywalność
Entropia jest przydatna, ponieważ pokazuje, jak bardzo rozproszony jest rozkład kategorii. Niska entropia oznacza, że dane są skoncentrowane w kilku poziomach. Wyższa entropia oznacza bardziej zróżnicowany rozkład, co może sygnalizować nowe źródło, szerszą zmianę biznesową lub nieuporządkowaną integrację na wcześniejszym etapie.
Nie czyni to jednak z entropii samodzielnego detektora. To sygnał profilowania, a nie werdykt. Używaj jej, aby zauważyć, kiedy pole kategoryczne stało się bardziej lub mniej przewidywalne, a następnie potwierdzaj to kontrolami opartymi na licznościach lub oceną częstości łącznych.
Dla zespołów, które potrzebują uporządkowanego sposobu powiązania profilowania z wykrywaniem, właściwy kontekst zapewniają techniki profilowania danych. Jeśli z kolei potrzebujesz przejrzystego wyjaśnienia, jak istotność statystyczna pomaga zdecydować, czy dana zmiana wymaga działania, przydatną lekturą uzupełniającą jest przewodnik po istotności statystycznej dla liderów wzrostu.
Utrzymuj proces na tyle prosty, by dało się go obsługiwać
Najpierw sprofiluj kolumnę. Zbuduj liczności kategorii, odsetek wartości null oraz widok top-k najczęściej występujących poziomów.
Porównaj z punktem odniesienia. Użyj testu chi-kwadrat lub PSI, gdy pytanie dotyczy zmiany rozkładu.
Sprawdź wzorce łączne. Jeśli rozkład brzegowy wygląda dobrze, przeanalizuj kombinacje między polami.
Eskaluj w zależności od istotności. Niewielką zmianę można monitorować, ale silna zmiana wymaga przeglądu przez człowieka.
Nie chodzi o zastąpienie uczenia maszynowego. Chodzi o to, by nie przechodzić od razu do złożonych rozwiązań, zanim najprostsze testy statystyczne nie wykonają swojej pracy.
Adaptacje uczenia maszynowego dla złożonych rozkładów
Niektóre problemy kategoryczne są zbyt złożone, by wystarczyły same kontrole częstości. Obejmują wiele pól, zmieniające się reguły biznesowe i interakcje, które ujawniają się w kombinacjach kategorii, a nie w obrębie pojedynczej kolumny. W potokach produkcyjnych oznacza to zwykle potrzebę modeli, które potrafią uczyć się struktury z rzadkich danych o wysokiej kardynalności, nie ukrywając przy tym problemów operacyjnych.
Embeddingi pomagają, gdy kardynalność staje się trudna do opanowania
Embeddingi kategoryczne odwzorowują poziomy o wysokiej kardynalności na gęste reprezentacje, z których mogą korzystać inne detektory. Dzięki temu zespoły mogą przekazywać strukturę kategorii do autoenkoderów, lasów izolacji lub podobnych modeli po przekształceniu surowych etykiet w wyuczoną przestrzeń ukrytą. W badaniu dotyczącym ubezpieczeń zdrowotnych, cytowanym w najnowszej literaturze, wprost zastosowano embeddingi kategoryczne dla cech o wysokiej kardynalności, detektory nienadzorowane i SHAP w procesie, którego wcześniej nie stosowano w tym kontekście, co pokazuje, jak aktywnie wciąż rozwija się ten obszar badanie w PubMed dotyczące cech kategorycznych o wysokiej kardynalności.
Praktyczne pytanie nie brzmi, czy embeddingi wyglądają elegancko. Brzmi ono, czy zachowują sygnały kategorii, które kodowanie one-hot traci w rzadkich przestrzeniach cech.
Porównanie popularnych rodzin modeli
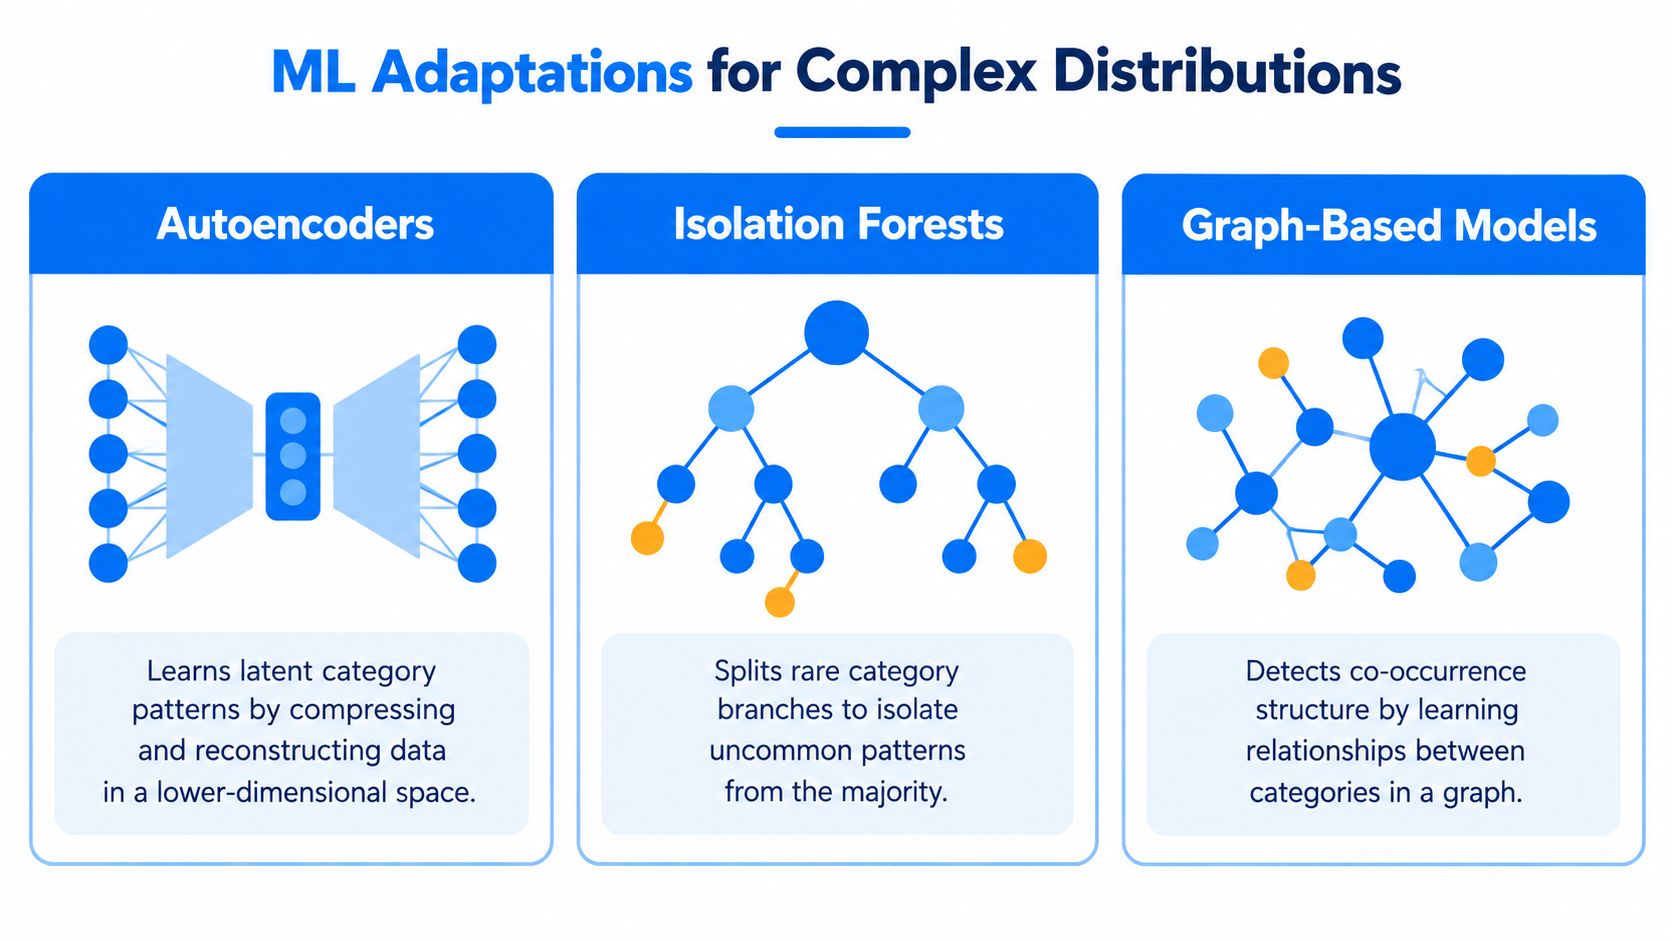
Autoenkodery sprawdzają się, gdy kategorie podlegają stabilnym wzorcom ukrytym, a błąd rekonstrukcji ma ujawniać anomalie.
Lasy izolacji (Isolation Forests) pomagają, gdy embeddingi lub haszowanie cech zapewniają im liczbową przestrzeń do podziałów.
Modele grafowe mają znaczenie, gdy struktura współwystępowania niesie więcej sygnału niż jakiekolwiek pojedyncze pole.
Rzeczywiste zbiory danych kategorycznych to nie przykłady z podręcznika. Repozytorium ADBenchmarks wymienia 14 powszechnie używanych zbiorów danych kategorycznych, w tym Census z 299 285 wierszami oraz CoverType z 581 012 wierszami, co przypomina, że metody muszą skalować się zarówno pod względem wymiarowości, jak i liczebności próby repozytorium zbiorów danych kategorycznych ADBenchmarks. Zestaw benchmarków pokazuje też, że wydajność może się gwałtownie zmieniać w przypadku złożonych zbiorów danych.
Dobieraj model do rodzaju awarii
Jeśli problemem jest kilka oczywistych zmian kategorii, zacznij od testów statystycznych. Jeśli chodzi o subtelną strukturę wartości łącznych, użyj modelu, który uczy się interakcji. Jeśli pole jest ogromne i rzadkie, embeddingi mogą połączyć surowe kategorie z użytecznym wykrywaniem. Jako praktyczny punkt wyjścia zapoznaj się z przewodnikiem po wykrywaniu anomalii w danych w Pythonie.
Zarządzanie cechami o wysokiej kardynalności i dryfem schematu
Tabela klientów może przez miesiące wyglądać stabilnie, a potem nowy kod regionu, kod produktu lub system źródłowy zaczyna wypełniać tę samą kolumnę wartościami, których punkt odniesienia nigdy nie widział. Właśnie wtedy monitorowanie cech o wysokiej kardynalności się komplikuje, ponieważ przestrzeń kategorii jest rzadka, a otaczający ją schemat często zmienia się w tym samym czasie.
Traktuj strukturę i rozkład jako osobne kontrole
Projekt referencyjny wykrywania dryfu schematu i atrybutów zaleca dwa punkty odniesienia dla każdej monitorowanej tabeli: odcisk strukturalny i profil statystyczny projekt wykrywania dryfu schematu i atrybutów. Odcisk strukturalny wychwytuje dodane lub usunięte kolumny oraz zmiany typów. Profil statystyczny obejmuje dla każdej kolumny odsetek wartości null, liczbę unikalnych wartości, granice liczbowe tam, gdzie mają zastosowanie, oraz histogram top-k kategorii dla pól kodowanych. Dokładniejsze omówienie tego, co psuje się przy zmianach struktury, znajdziesz w artykule dryf schematu – wyjaśnienie.
Ten podział ma znaczenie w środowisku produkcyjnym. Nowa wartość może być uzasadnioną zmianą biznesową, podczas gdy zmiana nazwy kolumny lub jej typu może unieważnić punkt odniesienia, zanim jakakolwiek kontrola rozkładu stanie się przydatna.
Ograniczaj szum, nie ukrywając rzadkich wartości
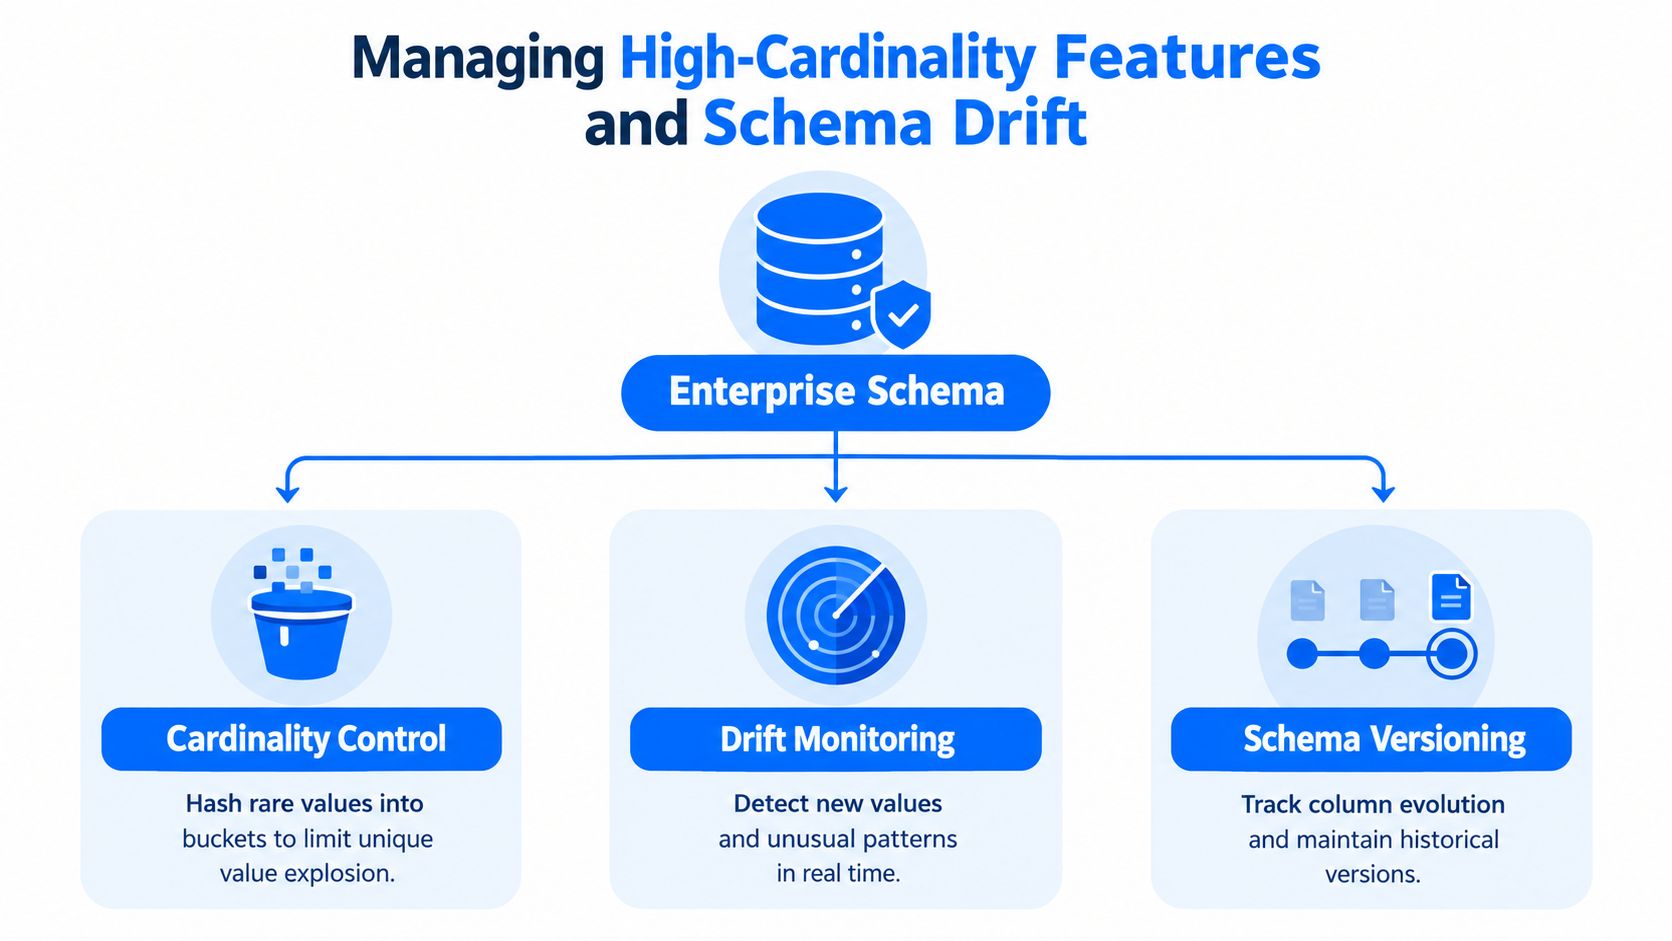
Rzadkie kategorie niosą sygnał, ale generują też szum alertów. Haszowanie, kubełkowanie i kontrolowane grupowanie mogą ustabilizować obszar monitorowania, o ile nie połączysz zbyt wcześnie odrębnych znaczeń biznesowych. Jeśli pojawi się rzadki kod produktu, potok powinien go najpierw zarejestrować, a dopiero potem zdecydować, czy należy on do istniejącej grupy.
Najpierw monitoruj zmianę schematu, a następnie zdecyduj, czy zmiana kategorii jest prawdziwą anomalią, czy nową normą.
W systemach regulowanych kluczowa jest identyfikowalność. Zespoły muszą pokazać, co się zmieniło, dlaczego zostało oznaczone i który punkt odniesienia doprowadził do tej decyzji. Łącz dryf schematu i dryf kategoryczny w tym samym procesie, aby analitycy nie otrzymywali osobnych zgłoszeń dotyczących jednej źródłowej awarii.
Utrzymuj prosty model operacyjny
Praktyczna konfiguracja składa się zwykle z trzech kroków. Wykryj nowe lub usunięte kategorie. Porównaj bieżący rozkład z wyuczonym punktem odniesienia. Wersjonuj schemat, aby historia zmian pozostała później możliwa do wyjaśnienia. To wystarczy, by wychwycić większość awarii związanych z kategoriami, nie zalewając zespołu fałszywymi alarmami.
Kompromisy wdrożeniowe i narzędzia klasy korporacyjnej
Własny potok w Pythonie do wykrywania anomalii kategorycznych jest jak najbardziej wykonalny. Trudniej jest zapewnić jego niezawodność, gdy rośnie liczba tabel, schematy ewoluują, a logika alertów musi jednocześnie spełniać wymogi ładu danych, bezpieczeństwa i audytu.
Własny kod daje kontrolę, ale też wymaga utrzymania
Samodzielnie zbudowany stos może wykorzystywać pandas, scikit-learn lub profilowanie oparte na SQL w warstwie statystycznej, co wystarcza przy niewielkiej skali. Problem pojawia się po kilku pierwszych tabelach. Musisz samodzielnie zarządzać punktami odniesienia, progami, harmonogramem, historią, odpowiedzialnością, kierowaniem incydentów i wyjaśnialnością, a każdy z tych elementów może stać się osobnym punktem awarii.
TensorFlow Data Validation to praktyczna opcja open source, gdy potrzebujesz kontroli dryfu między kolejnymi partiami danych oraz miar odległości dla danych kategorycznych, ponieważ wykrywa dryf między kolejnymi zakresami danych i mierzy dryf cech kategorycznych za pomocą odległości L-nieskończoność przewodnik po TensorFlow Data Validation. Sprawdza się to dobrze, gdy potok jest już ustandaryzowany, a zespół może sobie pozwolić na utrzymywanie otaczającej go orkiestracji.
Wybór platformy ma znaczenie, gdy bezpieczeństwo i ład danych nie podlegają negocjacjom
Wykonywanie w bazie danych ma znaczenie, ponieważ dane pozostają na miejscu, a ich zbędne przenoszenie między systemami jest ograniczone. Jest to szczególnie ważne w finansach, ochronie zdrowia, telekomunikacji i sektorze publicznym, gdzie suwerenność danych i kontrola dostępu kształtują architekturę. Badania IBM dotyczące semantycznej AI w Db2 wskazują ten sam kierunek, przedstawiając przeniesienie analizy bliżej bazy danych jako sposób na ograniczenie ryzyk związanych z prywatnością, zgodnością z przepisami i niespójnością przy jednoczesnym zachowaniu wspólnego obrazu danych ustrukturyzowanych i nieustrukturyzowanych IBM Research o SQL Data Insights Pro.
W tym miejscu platformy takie jak digna wpisują się w obraz operacyjny jako jedna z wielu opcji. digna działa we własnym środowisku klienta, wykonuje kontrole w bazie danych i łączy metody statystyczne z uczeniem maszynowym w celu wykrywania anomalii w polach kategorycznych, co czyni ją istotną opcją, gdy zespoły potrzebują ciągłego monitorowania bez budowania każdego komponentu od podstaw.
Wybieraj na podstawie obciążenia operacyjnego, a nie tylko jakości detektora
Najlepszy detektor jest bezużyteczny, jeśli otaczający go potok się załamie. Jeśli zespół potrzebuje przejrzystego sposobu monitorowania setek tabel, przechowywania historii schematów i unikania przenoszenia wrażliwych danych, decyzja o narzędziach dotyczy w równym stopniu modelu wykonywania, co wyboru algorytmu. Przejrzysty cennik, stabilny niezależnie od wykorzystania, ma również znaczenie, gdy próbujesz przewidzieć, jak program monitorowania będzie się skalował wraz z liczbą tabel i wykorzystaniem.
Budowa procesu monitorowania gotowego do produkcji
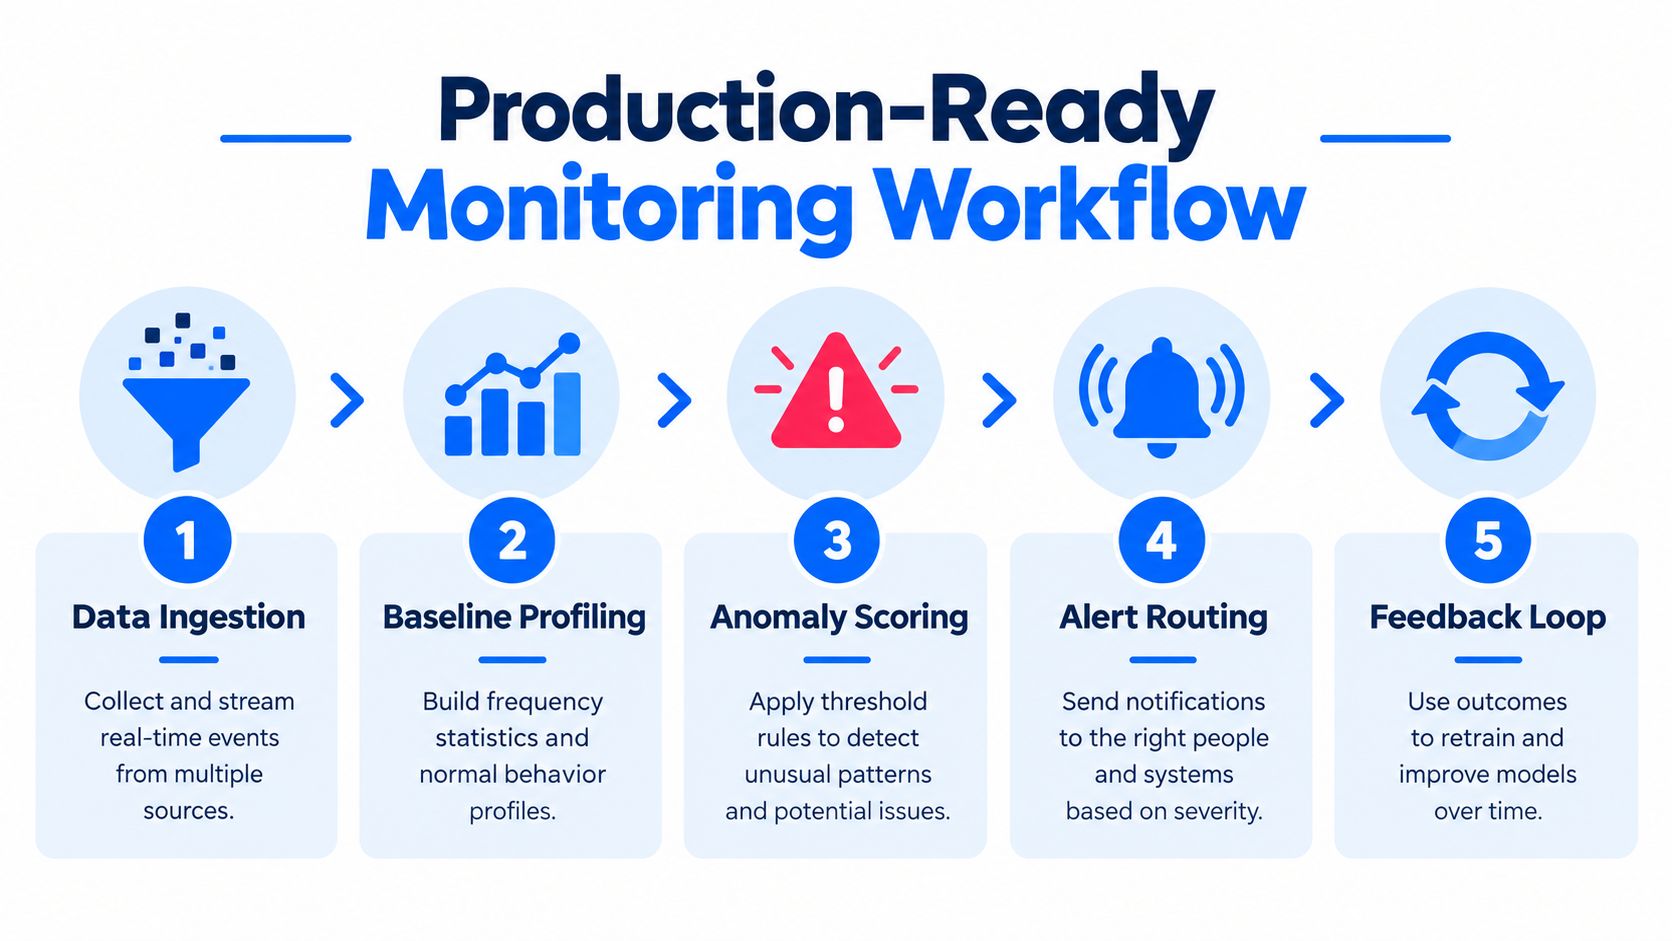
Produkcyjny proces wykrywania anomalii kategorycznych powinien być nudny w najlepszym tego słowa znaczeniu. Potok pobiera dane, profiluje rozkłady kategorii, ocenia anomalie, kieruje alerty do właściwego właściciela i przekazuje wynik z powrotem do punktu odniesienia, dzięki czemu system stale się uczy. Jeśli brakuje któregokolwiek z tych elementów, detektor staje się jednorazowym skryptem zamiast operacyjnym mechanizmem kontrolnym.
Zbuduj proces wokół odpowiedzialności
Zacznij od określenia, które tabele i pola kategoryczne są krytyczne dla biznesu. Następnie wyznacz właścicieli, którzy potrafią zinterpretować sygnał w kontekście, ponieważ właściwa reakcja na nową kategorię nie zawsze jest taka sama jak właściwa reakcja na uszkodzony schemat. Bez przypisanej odpowiedzialności alerty stają się szumem.
Przydatny alert mówi komuś dokładnie, co się zmieniło, gdzie to nastąpiło i jaki punkt odniesienia został naruszony.
Następnie utrzymuj punkt odniesienia lokalnie dla tabeli i pola, a nie globalnie dla całej hurtowni. Zachowanie danych kategorycznych jest często specyficzne dla domeny, więc pola w jednym systemie nie można oceniać według tych samych oczekiwań co pola o podobnej nazwie w innym miejscu. Dotyczy to zwłaszcza sytuacji, gdy kody, hierarchie produktów i wartości statusów różnią się w zależności od systemu źródłowego.
Uczyń pętlę informacji zwrotnej częścią detektora
Każdy przegląd powinien w jakiś sposób aktualizować system, nawet jeśli wynikiem jest stwierdzenie „to było oczekiwane”. Może to oznaczać dostosowanie progów, dodanie nowej dozwolonej kategorii lub zmianę logiki grupowania rzadkich poziomów. Jeśli punkt odniesienia nigdy się nie uczy, ten sam fałszywy alarm powróci jutro.
Ostatni krok jest prosty, ale łatwo go pominąć. Umieść kontrole kategoryczne w tej samej ścieżce operacyjnej co resztę stosu obserwowalności danych, aby nie były odizolowane od pochodzenia danych na wcześniejszych etapach, pulpitów w dalszych etapach ani danych wejściowych modeli. W ten sposób wykrywanie anomalii w danych kategorycznych staje się trwałym mechanizmem kontrolnym, a nie okresowym zadaniem porządkowym.
Jeśli potrzebujesz wykrywania anomalii kategorycznych, które pasuje do rzeczywistych potoków korporacyjnych, digna została stworzona do monitorowania zachowania danych, wykrywania zmian schematu i uruchamiania kontroli we własnym środowisku bez wyprowadzania danych na zewnątrz. Odwiedź digna, aby zobaczyć, jak to podejście przekłada się na Twoją hurtownię, jezioro danych lub stos potoków, zwłaszcza jeśli masz do czynienia z rzadkimi kategoriami, dryfem i alertami produkcyjnymi, które muszą szybko trafić do właściwego zespołu.
Jeśli wolisz nie budować samodzielnie opisanej powyżej pętli punktów odniesienia, oceny i alertów, digna Data Anomalies prowadzi takie monitorowanie w bazie danych, we własnym środowisku.
Najczęściej zadawane pytania
Czym jest anomalia kategoryczna?
Anomalia kategoryczna to poziom lub kombinacja poziomów w różnych polach, która występuje z nietypowo niską częstością w porównaniu z populacją bazową. W odróżnieniu od wartości odstającej w danych liczbowych chodzi o to, jak często kategoria występuje i współwystępuje, więc kraj, typ płatności i klasa urządzenia mogą być rzadkie łącznie, choć każde z osobna wygląda normalnie.
Dlaczego odległość euklidesowa nie sprawdza się w przypadku danych kategorycznych?
Etykiety, takie jak kody krajów czy statusy roszczeń, nie mają sensownej geometrii, więc odległość od średniej nic o nich nie mówi. Kodowanie one-hot pól o wysokiej kardynalności gwałtownie zwiększa wymiarowość i sprawia, że tabele kontyngencji stają się rzadkie, a wartości Z nie pozwalają stwierdzić, czy nowy kod jest nietypowy, czy po prostu nowy.
Jak wykryć dryf w kolumnie kategorycznej?
Porównaj obserwowane częstości kategorii z historycznym punktem odniesienia za pomocą testu chi-kwadrat lub określ wielkość zmiany za pomocą wskaźnika stabilności populacji (PSI). PSI poniżej 0,1 oznacza minimalny dryf, wartość od 0,1 do 0,25 wymaga zbadania, a wszystko powyżej 0,25 to istotny dryf wymagający natychmiastowego działania.
Jak postępować z cechami kategorycznymi o wysokiej kardynalności przy wykrywaniu anomalii?
Embeddingi kategoryczne odwzorowują wiele poziomów na gęste reprezentacje, z których mogą korzystać autoenkodery lub lasy izolacji. Na potrzeby monitorowania utrzymuj dwa punkty odniesienia dla każdej tabeli: odcisk strukturalny dla dodanych, usuniętych lub zmienionych pod względem typu kolumn oraz profil statystyczny z odsetkiem wartości null, liczbą unikalnych wartości i histogramem top-k kategorii.
Co powinien obejmować produkcyjny proces monitorowania anomalii kategorycznych?
Proces musi pobierać dane, profilować rozkłady kategorii, oceniać anomalie, kierować alerty do wskazanych właścicieli i przekazywać wyniki przeglądów z powrotem do punktu odniesienia. Utrzymuj punkty odniesienia lokalnie dla każdej tabeli i pola, a każdy przegląd niech dostosowuje progi lub dozwolone kategorie, aby ten sam fałszywy alarm nie powracał.


