7 list stop words do wyszukiwania i NLP
|
7
min. czyt.

Usuwanie popularnych słów nie zawsze się opłaca. Stop word może być szumem w jednym procesie i istotnym sygnałem w innym, dlatego właściwa konfiguracja listy stop words zależy od tego, co chcesz poprawić: trafność wyszukiwania, cechy NLP, przetwarzanie natywne w bazie danych czy zachowanie znaczenia tekstu dziedzinowego. Historyczne systemy wyszukiwania informacji traktowały listy stop words jako skrót przy indeksowaniu, a nie jako regułę ogólną, a nowoczesne potoki wciąż stoją przed tym samym kompromisem: usuwanie częstych terminów może zmniejszyć indeksy i przyspieszyć przetwarzanie, ale jednocześnie pogorszyć wyszukiwanie fraz i zapytania kluczowe dla biznesu (historia stop words i kompromisy w wyszukiwaniu). Praktyczna zasada jest prosta: zmierz trafność, jakość modelu i skutki dla jakości danych w dalszych etapach przed filtrowaniem i po nim, a następnie udokumentuj każde własne dodanie lub wykluczenie.
W tekstach angielskich stop words często stanowią dużą część zwykłego języka, przez co decyzja ma charakter operacyjny, a nie kosmetyczny. Wytyczne firmy NVIDIA podsumowują badania, z których wynika, że typowy tekst angielski zawiera około 30–40% stop words, co oznacza, że wybory dotyczące filtrowania mogą istotnie zmienić rozmiar indeksu, szybkość przetwarzania i zachowanie modelu (wytyczne NVIDIA dotyczące stop words). Dlatego siedem poniższych zasobów najlepiej oceniać według zadania, a nie marki. Niektóre powstały z myślą o ogólnym NLP, inne o wyszukiwarkach, uczeniu maszynowym lub natywnym przetwarzaniu tekstu w bazie danych, gdy dane powinny pozostać na miejscu.
Spis treści
1. Stop words języka angielskiego w NLTK
Stosuj, gdy tekst wspiera proces monitorowania
2. Natywne stop words w Snowflake
Przetwarzaj tekst w hurtowni blisko danych
3. Stop words w Apache Lucene
Wybierz Lucene, gdy zachowanie wyszukiwania jest ważniejsze niż ogólne NLP
4. Domyślne stop words w spaCy
Wybierz spaCy, gdy znaczenie zależy od gramatyki i kontekstu
5. Własne słowniki stop words w PostgreSQL i BigQuery
Projektuj słowniki z myślą o audycie i ponownym użyciu
6. Branżowe listy stop words
Traktuj słownictwo dziedzinowe jako element projektu mechanizmów kontrolnych
7. Stop words języka angielskiego w scikit-learn
Traktuj ją jako punkt wyjścia dla cech tekstowych
Porównanie 7 list stop words
Wybierz listę, która zachowuje znaczenie
1. Stop words języka angielskiego w NLTK
NLTK to solidny punkt wyjścia, gdy zadaniem jest ogólne NLP w Pythonie. Jego angielska lista stop words jest powszechnie stosowana w przetwarzaniu wstępnym, ponieważ pozwala zespołom szybko usunąć wyrazy wypełniające przed tokenizacją, analizą częstości lub klasyfikacją tekstu. Dla zespołów korzystających z digna jest to przydatne, gdy opisy reguł biznesowych w języku naturalnym, tagi metadanych lub notatki o incydentach wymagają oczyszczenia przed walidacją lub analizą anomalii. Nie chodzi o to, by na zawsze ufać ustawieniom domyślnym, lecz by szybko uzyskać czytelny punkt odniesienia.
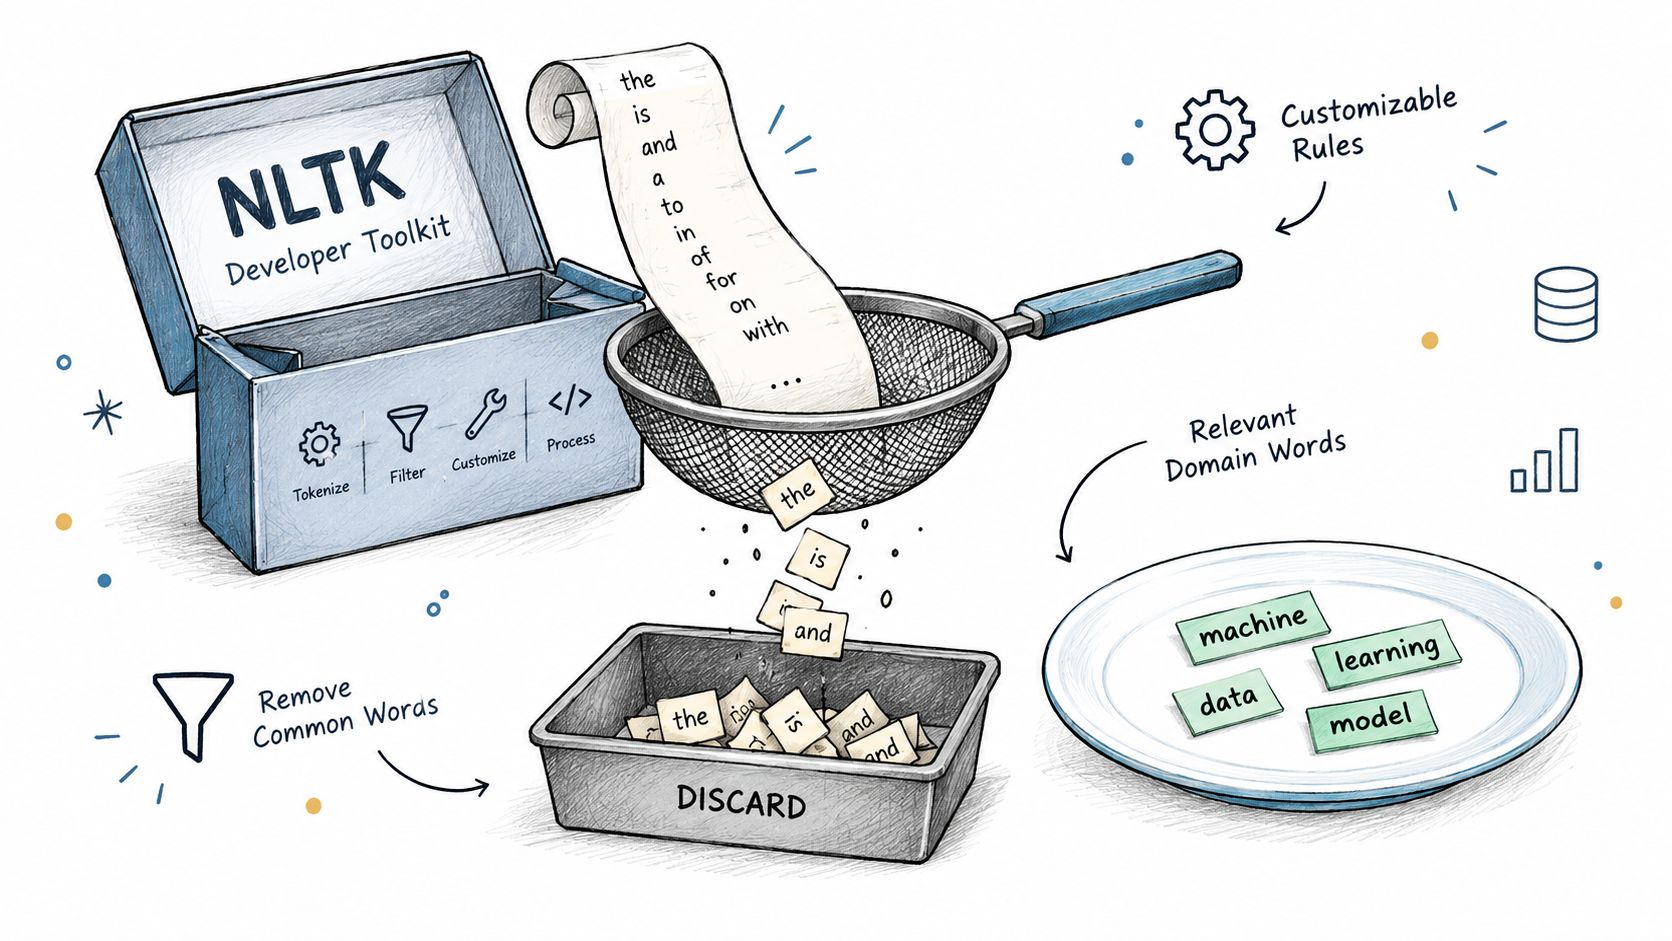
NLTK sprawdza się najlepiej, gdy traktujesz go jako wstępną wersję listy, a nie ostateczną politykę. Jeśli zespół ds. jakości danych widzi w powtarzających się tekstach reguł takie terminy jak credit, patient czy subscriber, słowa te mogą nieść więcej znaczenia, niż zakłada ogólna lista angielska. W usługach finansowych, ochronie zdrowia czy telekomunikacji bezpieczniejszym wyborem jest często własna lista, ponieważ język dziedzinowy może być ważniejszy niż gramatyczne wypełniacze.
Stosuj, gdy tekst wspiera proces monitorowania
Praktycznym zastosowaniem jest filtrowanie opisów reguł w języku naturalnym, zgodnie z wytycznymi digna dotyczącymi czyszczenia danych, gdzie celem jest oddzielenie składni od sygnału przed analizą. Ta sama lista może pomóc oczyścić notatki o pochodzeniu danych lub podsumowania incydentów przed ich klastrowaniem lub zliczaniem. Może też ograniczyć szum w polach tekstowych, z których analitycy korzystają przy segregacji problemów z danymi.
Praktyczna zasada: zacznij od listy domyślnej, a terminy dodawaj lub usuwaj dopiero po przetestowaniu jej na własnym słownictwie reguł biznesowych.
Zachowuj terminy dziedzinowe: pozostaw słowa, które zmieniają znaczenie w Twojej branży, nawet jeśli są powszechne w ogólnej angielszczyźnie.
Testuj przed wdrożeniem: porównaj tekst filtrowany i niefiltrowany na rzeczywistych próbkach incydentów i reguł.
Dokumentuj każdą zmianę: zapisuj każde własne dodanie, aby logika walidacji pozostawała spójna między zespołami.
2. Natywne stop words w Snowflake
Snowflake warto wziąć pod uwagę, gdy przetwarzanie tekstu musi pozostać wewnątrz hurtowni. Natywna obsługa stop words dobrze pasuje do pracy z danymi w chmurze, ponieważ nie wymaga przenoszenia tekstu do zewnętrznego stosu NLP tylko po to, by usunąć częste terminy. W przypadku wdrożeń digna w Snowflake jest to zgodne z wykonywaniem w bazie danych, ponieważ tekst pozostaje blisko rekordów, pochodzenia danych i analizowanych metadanych schematu.
Ma to znaczenie w procesach obserwowalności. Jeśli opis z katalogu danych lub notatka o incydencie są przetwarzane tam, gdzie już się znajdują, zespoły unikają dodatkowej orkiestracji i upraszczają ścieżkę audytu. W praktyce najmocniejszym zastosowaniem jest filtrowanie pisanych przez ludzi metadanych towarzyszących schematom, ponieważ otaczający kontekst często ma równie duże znaczenie jak sama lista tokenów.
Snowflake dobrze przypomina też, że stop words to nie tylko kwestia NLP. Mogą być częścią tej samej logiki hurtowni, która obsługuje wyszukiwanie tekstu, segregację incydentów i przegląd zmian schematu. Gdy to samo środowisko odpowiada zarówno za przechowywanie, jak i analizę, natywna lista stop words staje się częścią modelu operacyjnego, a nie krokiem przetwarzania wstępnego ukrytym w notatniku.
Przetwarzaj tekst w hurtowni blisko danych
Dla zespołów monitorujących zmiany w katalogu takie podejście jest zgodne z wytycznymi digna dotyczącymi Snowflake, zwłaszcza gdy pulpit musi pokazywać, co się zmieniło, bez eksportowania wrażliwego tekstu. Własna tabela słownikowa jest często właściwym uzupełnieniem, gdy tekst w hurtowni zawiera terminy biznesowe, które listy domyślne by usunęły. Takie podejście ułatwia też wersjonowanie w różnych środowiskach.
Najpierw używaj filtrowania natywnego: utrzymuj transformację wewnątrz Snowflake, jeśli dane już się tam znajdują.
Uzupełniaj o terminy biznesowe: dodaj warstwę dziedzinową dla słownictwa regulowanego lub technicznego.
Sprawdzaj zmiany w wydaniach: przeglądaj aktualizacje stop words, zanim wpłyną na istniejące reguły lub zapisane wyszukiwania.
3. Stop words w Apache Lucene
Lucene jest trafniejszym wyborem, gdy zadaniem jest indeksowanie na potrzeby wyszukiwania. Jego angielska lista stop words jest zwięzła i dostosowana do wyszukiwania informacji, dlatego dobrze sprawdza się w wyszukiwaniu w katalogu, przeglądaniu pochodzenia danych i wyszukiwaniu metadanych na dużą skalę. Taka lista jest zwykle lepsza, gdy celem jest szybkie, ukierunkowane wyszukiwanie, a nie szeroka analiza lingwistyczna.
Łatwo przeoczyć związany z tym kompromis. Krótsza lista może świetnie wpływać na wydajność, ale trafność wyszukiwania zależy od tego, jak ludzie odpytują Twoje dane. Termin, który w ogólnym korpusie wygląda na błahy, może mieć znaczenie w nazwie tabeli, opisie schematu lub tytule incydentu. Jeśli użytkownicy wyszukują dokładne frazy, usunięcie niewłaściwych terminów może sprawić, że system będzie wydawał się mniej trafny, nawet jeśli indeks się zmniejszy.
Wybierz Lucene, gdy zachowanie wyszukiwania jest ważniejsze niż ogólne NLP
Lucene pasuje do sytuacji, w których wiele osób przeszukuje tę samą warstwę metadanych, na przykład katalog danych z tysiącami tabel. We wdrożeniach digna jest to szczególnie istotne przy eksploracji schematów i pochodzenia danych, gdzie szybkość wyszukiwania i jakość rankingu są częścią doświadczenia użytkownika. Im czystszy indeks, tym łatwiej szybko znaleźć właściwy obiekt.
Lucene sprawdza się najlepiej, gdy traktujesz stop words jako narzędzie do dostrajania wyszukiwania, a nie jako ogólny krok porządkowania danych.
Dlatego wytyczne digna dotyczące wyszukiwania z symbolami wieloznacznymi należą do tego samego procesu. Wyszukiwanie z symbolami wieloznacznymi i filtrowanie stop words wpływają na różne etapy wyszukiwania, ale w praktyce oddziałują na siebie, gdy użytkownicy wpisują fragmenty nazw, frazy mieszane lub zaszumione etykiety metadanych. Jeśli wyszukiwanie ma znaczenie operacyjne, przetestuj je na rzeczywistych logach zapytań, zanim ustandaryzujesz listę.
4. Domyślne stop words w spaCy
spaCy lepiej się sprawdza, gdy potok wymaga szerszego pokrycia językowego i dokładniejszego przetwarzania lingwistycznego. Jego domyślny zestaw angielskich stop words jest większy niż listy nastawione na wyszukiwanie, a biblioteka udostępnia też zasoby stop words dla wielu języków. Ma to znaczenie, gdy tekst jest parsowany, lematyzowany i analizowany, a nie tylko tokenizowany.
Dla użytkowników digna praktycznym testem jest to, czy język nadal niesie sygnały ryzyka w regułach jakości danych, podsumowaniach incydentów i opisach schematów. Wyjaśnienie reguły może zależeć od sformułowania, na przykład od tego, czy pole jest wymagane tylko w określonych warunkach. W takim przypadku zbyt agresywne usuwanie popularnych słów może wymazać logikę, którą analitycy muszą sprawdzić.
Wybierz spaCy, gdy znaczenie zależy od gramatyki i kontekstu
spaCy dobrze sprawdza się w wyodrębnianiu kluczowych pojęć z opisów incydentów i wychwytywaniu powtarzających się wzorców w tekście reguł. Pasuje też do zespołów, które potrzebują spójnej obsługi wielu języków lub centralnej konfiguracji dla szerszych ram jakości danych. W środowiskach regulowanych taka spójność może mieć równie duże znaczenie jak sama jakość modelu.
Najlepszym podejściem jest rozszerzanie listy domyślnej dopiero po przetestowaniu jej na rzeczywistym tekście. W finansach terminy takie jak credit i debit mogą wymagać zachowania. W ochronie zdrowia patient i drug mogą być zbyt ważne, by je usuwać. W telekomunikacji subscriber może być kluczowym sygnałem, a nie wypełniaczem.
Dobra praktyka: używaj potoku językowego spaCy razem ze stop words, a następnie zdecyduj, czy słownictwo dziedzinowe wymaga osobnej warstwy wykluczeń.
Takie podejście jest zgodne z wytycznymi digna dotyczącymi danych historycznych, gdy tekst reguł biznesowych musi pozostać zrozumiały dla analityków i audytorów.
5. Własne słowniki stop words w PostgreSQL i BigQuery
Słowniki natywne dla bazy danych są właściwym wyborem, gdy przetwarzanie tekstu musi pozostać wewnątrz platformy. Wyszukiwanie pełnotekstowe w PostgreSQL i konfigurowalne funkcje tekstowe w BigQuery pozwalają zespołom umieścić reguły stop words bliżej danych, co ogranicza ich przenoszenie i ułatwia śledzenie nadzoru. Dla zespołów, które już pracują w tych systemach, takie umiejscowienie często przesądza o projekcie.
Kompromis jest prosty: obsługa stop words przestaje być ogólnym porządkowaniem języka, a staje się mechanizmem kontrolnym platformy. Zespół z sektora ochrony zdrowia może przechowywać terminy kliniczne w jednym słowniku, a ogólne słowa angielskie usuwać w innym. Zespół z sektora usług finansowych może dokumentować każdą zmianę na potrzeby zgodności z przepisami. Wartość polega nie tylko na filtrowaniu, lecz także na utrzymaniu polityki tekstowej zgodnej ze środowiskiem, w którym tekst jest odpytywany.
Projektuj słowniki z myślą o audycie i ponownym użyciu
We wdrożeniach digna listy natywne dla bazy danych dobrze pasują do modelu wykonywania w bazie danych. Wspierają też powtarzalne procesy dla opisów zmian schematu, tekstu reguł biznesowych i metadanych katalogu, które w przeciwnym razie trzeba by kopiować do osobnych narzędzi. Dzięki temu łatwiej je audytować i utrzymywać spójność między środowiskami. W przypadku procesów specyficznych dla BigQuery przydatnym punktem odniesienia jest strona digna poświęcona jakości danych w BigQuery, a zespoły PostgreSQL mogą skorzystać ze strony digna poświęconej jakości danych w PostgreSQL, aby utrzymać filtrowanie i walidację w tym samym przepływie operacyjnym.
Dziel według domen: używaj osobnych słowników dla tekstu operacyjnego, regulowanego i analitycznego.
Formalnie śledź zmiany: wersjonuj zmiany w słownikach, aby przeglądy i wycofywanie zmian były proste.
Testuj na reprezentatywnym tekście: weryfikuj na rzeczywistych opisach, a nie na uproszczonych przykładach.
Główną zaletą jest kontrola. Zespoły wiedzą, które reguły są aktywne, gdzie działają i jak wpływają na wyniki. Ma to znaczenie, ponieważ usunięcie niewłaściwego słowa może pogorszyć trafność wyszukiwania lub zatrzeć znaczenie biznesowe, zwłaszcza gdy ten sam termin ma różną wagę w procesach bazodanowych, analitycznych i związanych ze zgodnością.
6. Branżowe listy stop words
Listy ogólne najszybciej zawodzą w branżach regulowanych. Słowo, które w zwykłym angielskim wydaje się nieistotne, może mieć kluczowe znaczenie w sprawozdawczości finansowej, bezpieczeństwie pacjentów lub monitorowaniu KPI w telekomunikacji. Dlatego branżowe listy stop words służą nie tyle usuwaniu większej liczby słów, ile zachowaniu terminów niosących znaczenie biznesowe.
W usługach finansowych zwykle muszą pozostać widoczne takie terminy jak debit, credit, transaction i settlement. Zespoły z sektora ochrony zdrowia często potrzebują, by filtrowanie przetrwały słowa patient, diagnosis, treatment i medication. Zespoły telekomunikacyjne mogą polegać na słowach takich jak subscriber, churn, revenue i arpu, aby zapewnić dokładne monitorowanie. W każdym z tych przypadków niewłaściwa lista stop words może zatrzeć sygnał potrzebny operatorom.
Traktuj słownictwo dziedzinowe jako element projektu mechanizmów kontrolnych
Kluczowy jest tu nadzór. Zespoły ds. zgodności powinny przeglądać listę, ponieważ decyzja o zachowaniu lub usunięciu terminu może wpłynąć na ścieżki audytu, interpretację KPI i wykrywanie anomalii. Jeśli reguła biznesowa lub próg monitorowania zależy od sformułowań dziedzinowych, takiego słowa nie należy pochopnie pomijać w analizie.
Jeśli popularne słowo zmienia interpretację regulowanej metryki, w Twoim przypadku nie jest stop word.
Ta zasada naturalnie współgra z wytycznymi digna dotyczącymi ładu danych w finansach, ponieważ zespoły finansowe często potrzebują ścisłej kontroli nad terminologią, walidacją i możliwością przeglądu. Ta sama logika dotyczy danych z sektora ochrony zdrowia i sektora publicznego, gdzie identyfikowalność może być równie ważna jak wygoda.
7. Stop words języka angielskiego w scikit-learn
Scikit-learn należy do warstwy uczenia maszynowego, a nie warstwy wyszukiwania. Jego angielskie stop words zaprojektowano z myślą o ekstrakcji cech, dlatego stanowią rozsądny punkt wyjścia dla wektoryzacji, klasyfikacji i cech tekstowych związanych z anomaliami. Jeśli zadaniem jest przekształcenie notatek o incydentach lub opisów schematów w cechy, to właśnie ta lista pasuje do potoku.
Dużą zaletą jest kompatybilność. Stop words ze scikit-learn łatwo włączyć do procesów ML w Pythonie, zwłaszcza gdy zespoły tworzą cechy TF-IDF lub inne rzadkie reprezentacje. Dla użytkowników digna są więc przydatne w uczeniu punktów odniesienia, statystycznej analizie wzorców i opartej na modelach segregacji tekstu towarzyszącego zdarzeniom dotyczącym jakości danych.
Traktuj ją jako punkt wyjścia dla cech tekstowych
Kluczem jest myślenie jak twórca modeli, a nie inżynier wyszukiwania. Potok uczenia maszynowego często zyskuje na usunięciu częstych wypełniaczy, ale o wartości decyduje to, czy pozostałe terminy poprawiają predykcję, klastrowanie lub wykrywanie dryfu. Jeśli lista jest zbyt agresywna, model może utracić przydatne rozróżnienia. Jeśli jest zbyt luźna, cechy pozostają zaszumione.
Dlatego najlepszą praktyką jest rozpoczęcie od listy bazowej i dodawanie terminów dziedzinowych dopiero po sprawdzeniu zachowania modelu na rzeczywistych przykładach z Twojego środowiska. Notatka o zmianie schematu w jednej firmie może używać języka, który w innej jest ogólnikowy, a lista powinna odzwierciedlać tę różnicę.
Zacznij od punktu odniesienia: zachowaj listę domyślną, zanim wprowadzisz własne terminy.
Dopasuj do wektoryzacji: łącz ją z TF-IDF lub podobnymi metodami ekstrakcji cech.
Przeglądaj wyniki modelu: sprawdzaj, czy usunięte terminy zmieniły predykcje, a nie tylko liczbę tokenów.
Porównanie 7 list stop words
Pozycja | Złożoność wdrożenia 🔄 | Wymagane zasoby ⚡ | Oczekiwane rezultaty 📊 & jakość ⭐ | Idealne zastosowania 💡 | Kluczowe zalety ⭐ |
|---|---|---|---|---|---|
Stop words języka angielskiego w NLTK | Niska, prosta lista; łatwa do dostosowania | Niskie, lekki pakiet Pythona | Umiarkowany wpływ; ogranicza szum, ale wymaga dostrojenia, ⭐⭐⭐ | Ogólne przetwarzanie wstępne NLP, czyszczenie metadanych | Open source, powszechnie stosowana, łatwa do dostosowania |
Natywne stop words w Snowflake | Niska, natywna konfiguracja, minimalne ustawienia | Minimalne, w bazie danych, bez zewnętrznych zależności, wysoka przepustowość | Wysokie przy filtrowaniu w hurtowni; szybkie & sprzyjające nadzorowi, ⭐⭐⭐⭐ | digna na Snowflake; filtrowanie i tokenizacja tekstu w bazie danych | Brak przenoszenia danych, zoptymalizowana wydajność, dane pozostają na miejscu |
Stop words w Apache Lucene | Niska, łatwa integracja ze stosami wyszukiwania | Niskie, krótka lista, minimalny narzut | Wysokie pod względem trafności wyszukiwania i efektywności indeksowania, ⭐⭐⭐⭐ | Wyszukiwanie pełnotekstowe, optymalizacja dużych indeksów (ES/Solr) | Bardzo zwięzła lista, przyspiesza wyszukiwanie i zmniejsza rozmiar indeksu |
Domyślne stop words w spaCy | Średnia, wymaga instalacji spaCy i modeli | Średnie, Python + modele NLP; więcej mocy obliczeniowej | Wysokie w zadaniach lingwistycznych i filtrowaniu uwzględniającym encje, ⭐⭐⭐⭐ | Zaawansowane NLP, analiza złożoności reguł biznesowych, parsowanie semantyczne | Starannie dobrana, zintegrowana z potokiem NLP, konfigurowalna w czasie działania |
Własne słowniki PostgreSQL & BigQuery | Średnia–wysoka, konfiguracja specyficzna dla bazy danych i uprawnienia administratora | Zasoby w bazie danych; wymaga wiedzy administratora baz danych | Wysokie przy zgodnym z przepisami, skalowalnym przetwarzaniu w hurtowni, ⭐⭐⭐⭐ | Środowiska regulowane, własne słowniki dla poszczególnych tabel/schematów | W pełni konfigurowalne w bazie danych, bez zewnętrznych zależności, ułatwiają audyt |
Branżowe listy stop words (finanse, ochrona zdrowia, telekomunikacja) | Wysoka, wymaga wiedzy dziedzinowej i stałego utrzymania | Średnie, zespoły, możliwe koszty dostawcy/licencji | Bardzo wysoka dokładność dziedzinowa; mniej fałszywych alarmów, ⭐⭐⭐⭐⭐ | Wykrywanie anomalii w branżach regulowanych, walidacja reguł, monitorowanie KPI | Zachowują kluczowe terminy, poprawiają dokładność wykrywania i zgodność z przepisami |
Stop words języka angielskiego w scikit-learn | Średnia, zintegrowana z potokami ML | Średnie, stos ML w Pythonie (TF-IDF, modele) | Wysokie przy ekstrakcji cech ML i przygotowaniu modeli, ⭐⭐⭐⭐ | Wykrywanie anomalii oparte na ML, inżynieria cech, procesy TF-IDF | Zoptymalizowana pod ML, powtarzalna, współpracuje z narzędziami scikit-learn |
Wybierz listę, która zachowuje znaczenie
Najlepszy wybór listy stop words zależy od zadania, przed którym stoisz. Wybierz Lucene, gdy priorytetem jest ukierunkowane indeksowanie na potrzeby wyszukiwania. Wybierz NLTK lub spaCy do ogólnego NLP w Pythonie, zwłaszcza gdy oczyszczasz metadane, teksty incydentów lub opisy reguł. Wybierz scikit-learn, gdy tekst zasila model, a nie pole wyszukiwania. Wybierz słowniki natywne dla bazy danych, gdy przetwarzanie musi pozostać na miejscu. Dodawaj rozszerzenia branżowe zawsze wtedy, gdy terminy biznesowe niosą sygnał, a listy ogólne by go usunęły.
Proces wyboru powinien pozostać praktyczny. Zanim cokolwiek ustandaryzujesz, przetestuj precyzję, czułość, trafność wyszukiwania, zachowanie modelu i skutki dla jakości danych w dalszych etapach. Następnie wersjonuj listę, przeglądaj zmiany i nie umieszczaj w zbiorze stop words słów kluczowych dla domeny, dopóki nie udowodnisz, że nie mają znaczenia w Twoich danych.
Właśnie z powodu tej dyscypliny zarządzanie stop words należy omawiać razem z obserwowalnością i walidacją. Jeśli słowo zmienia ranking wyszukiwania, wynik modelu lub interpretację incydentu, jego miejsce jest w ładzie danych, a nie na liście domyślnej. Utrzymuj politykę blisko osób, które są właścicielami danych, i aktualizuj ją, gdy zmienia się słownictwo biznesowe.
digna pomaga zespołom zachować tę dyscyplinę w tym samym środowisku, w którym już znajdują się dane. Moduły do jakości danych, śledzenia schematów, monitorowania terminowości i wykrywania anomalii ułatwiają testowanie reguł tekstowych na rzeczywistych danych operacyjnych zamiast zgadywania. Odwiedź digna, jeśli chcesz powiązać wybór stop words z monitorowaniem, walidacją i obserwowalnością w bazie danych na jednej platformie.
Jeśli filtrowanie stop words działa wewnątrz hurtowni, jak zaleca powyższa sekcja o Snowflake, monitorowanie jakości danych w Snowflake może działać w tym samym miejscu, dzięki czemu reguły tekstowe i opisywane przez nie tabele są sprawdzane bez eksportowania danych.
Najczęściej zadawane pytania
Do czego służy lista stop words?
Lista stop words wskazuje wyszukiwarce lub potokowi NLP, które popularne słowa należy pominąć przed indeksowaniem lub analizą. Typowy tekst angielski składa się w około 30–40% ze stop words, więc wybrana lista może istotnie zmienić rozmiar indeksu, szybkość przetwarzania i zachowanie modelu.
Której listy stop words użyć do indeksowania na potrzeby wyszukiwania?
Apache Lucene lepiej się sprawdza, gdy zadaniem jest indeksowanie na potrzeby wyszukiwania. Jego angielska lista jest zwięzła i dostosowana do wyszukiwania informacji, co pasuje do wyszukiwania w katalogu i metadanych. Najpierw przetestuj ją na rzeczywistych logach zapytań, ponieważ usunięcie niewłaściwych terminów może pogorszyć wyszukiwanie dokładnych fraz.
Czym różnią się stop words w NLTK, spaCy i scikit-learn?
Każda biblioteka służy innemu zadaniu. NLTK to szybki punkt wyjścia dla ogólnego NLP w Pythonie, spaCy oferuje większy zestaw domyślny i wiele języków dla potoków uwzględniających gramatykę, a lista scikit-learn powstała z myślą o ekstrakcji cech, takiej jak wektoryzacja TF-IDF, gdy tekst zasila model, a nie pole wyszukiwania.
Czy słowa dziedzinowe, takie jak credit lub patient, należy usuwać jako stop words?
Zazwyczaj nie. Listy ogólne mogą usuwać terminy niosące znaczenie biznesowe, takie jak debit, credit i settlement w finansach, patient i diagnosis w ochronie zdrowia czy subscriber, churn i ARPU w telekomunikacji. Jeśli popularne słowo zmienia interpretację regulowanej metryki, w Twoim przypadku nie jest stop word.
Jak bezpiecznie dostosować listę stop words?
Zacznij od listy domyślnej, a terminy dodawaj lub usuwaj dopiero po przetestowaniu tekstu filtrowanego i niefiltrowanego na rzeczywistych próbkach. Mierz trafność, jakość modelu i skutki w dalszych etapach, dokumentuj każdą własną zmianę i wersjonuj słowniki, na przykład w PostgreSQL lub BigQuery, aby przeglądy i wycofywanie zmian pozostały proste.


