10 typowych problemów z danymi i jak je wykryć w 2026 roku
|
9
min. czyt.

Dashboard wygląda spokojnie, logi zadań świecą na zielono, a w hurtowni nic nie jest widocznie zepsute. To właśnie wtedy problemy z danymi wyrządzają największe szkody. Liczby mogą dryfować, definicje mogą się zmieniać, a model może dalej generować wyniki, podczas gdy firma podejmuje decyzje na podstawie nieaktualnych, niekompletnych lub niespójnych danych wejściowych.
Większość awarii danych nie daje o sobie znać. Ukrywają się w statusach „sukces”, pustych kolumnach, zduplikowanych wierszach, opóźnionych zasileniach i logice metryk, której nikt nie udokumentował wystarczająco dobrze. Sednem problemu rzadko jest to, że „pipeline nie działa”. Chodzi raczej o to, że pipeline zgłasza, że wszystko jest w porządku, a raport, model lub sprawozdanie regulacyjne stopniowo traci wiarygodność.
Poniższa lista porządkuje dziesięć typowych problemów z danymi według tego, jak cicho zawodzą, a nie według tego, jak często się o nich mówi. Przy każdym opisujemy, jak wygląda w praktyce, jak wykryć go wcześnie i które moduły digna pomagają w jego wykrywaniu lub ograniczaniu.
Spis treści
7. Naruszenia reguł biznesowych i luki w integralności referencyjnej
Jak zamienić te dziesięć kontroli w stałą rutynę jakości danych
1. Terminowość, nieaktualne dane i zepsute dashboardy
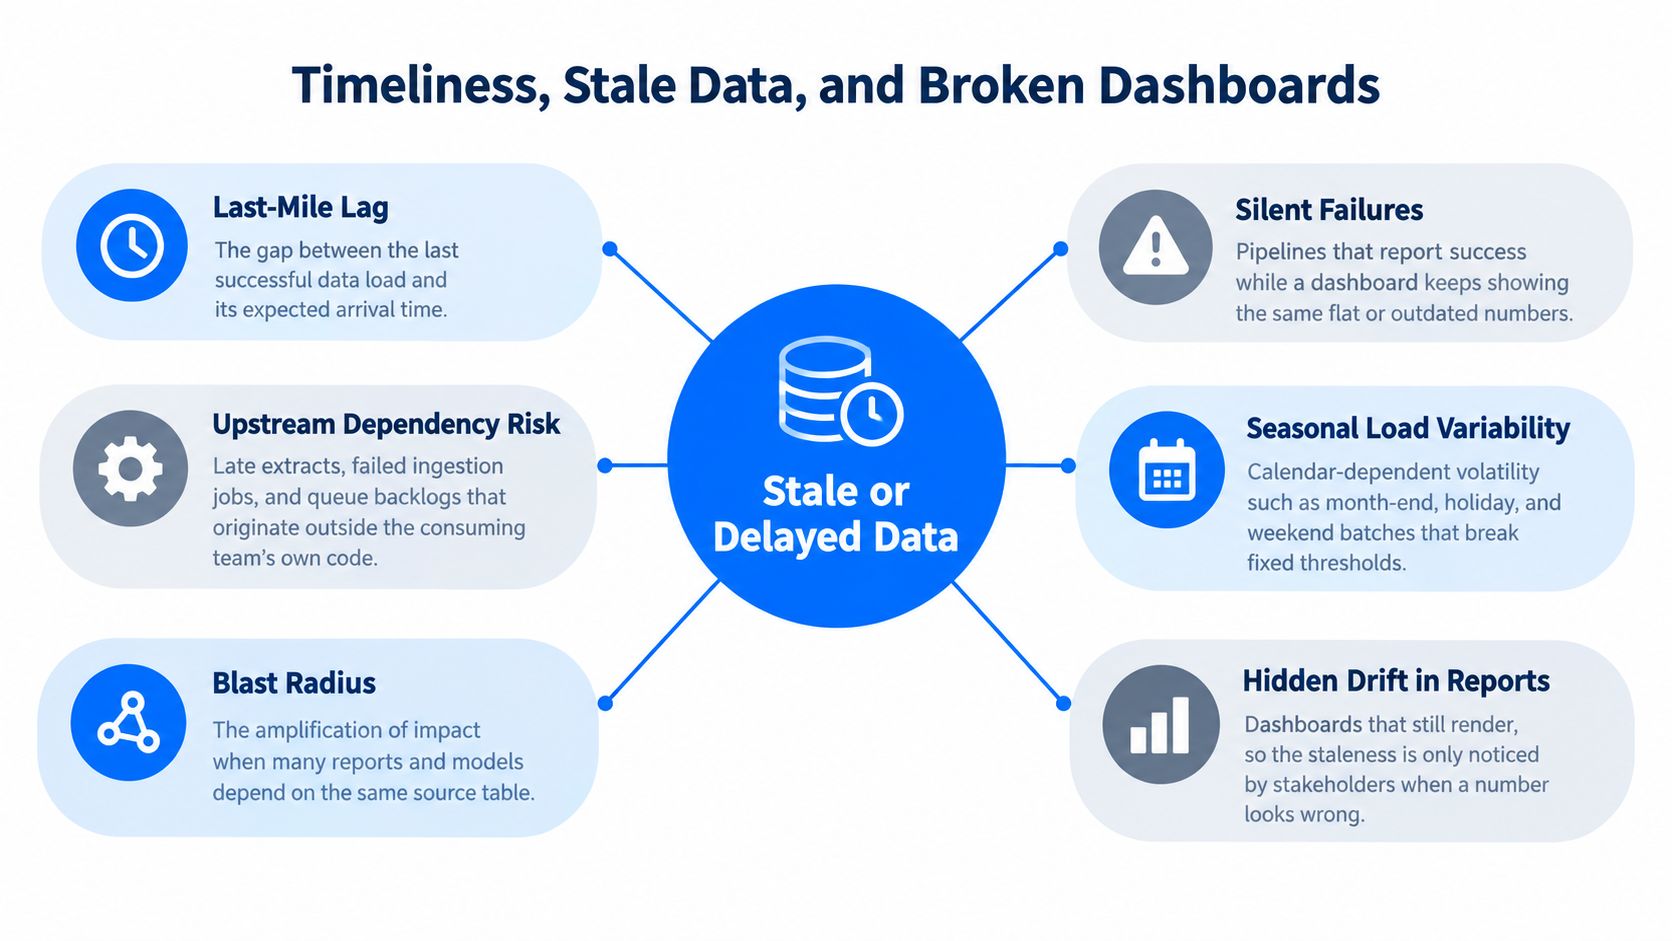
Dashboard może ładować się bez zarzutu, choć liczby w nim są już nieaktualne. Dział finansów widzi raport, dział sprzedaży widzi raport, zarząd widzi raport, a przestarzała wartość pozostaje niezauważona, dopóki ktoś ze znajomością dziedziny nie dostrzeże rozbieżności.
W ten sposób problemy z terminowością prześlizgują się niezauważone. Źródłowe zasilenie może utknąć po spóźnionym ekstrakcie lub zatorze w kolejce, a tabela wymiarów odświeża się zgodnie z harmonogramem, ale z błędnym mapowaniem kategorii. Dashboard nadal się renderuje, ale znaczenie liczb się rozmywa. Późne wykrycie jest w praktyce kosztowne, a badanie IBM dotyczące naruszeń bezpieczeństwa pokazuje, ile czasu może minąć, zanim problem zostanie zidentyfikowany i opanowany: identyfikacja i powstrzymanie naruszenia trwa średnio 241 dni, a wykrycie wraz z eskalacją kosztuje średnio 1,47 mln USD (badanie IBM Cost of a Data Breach).
Praktyczna zasada: raport jest tylko tak świeży jak tabele, które go zasilają.
Na co zwracać uwagę
Oczekiwane okna dostarczenia: na podstawie historii warto poznać typowe czasy dostaw danych, a następnie alarmować o zasileniach spóźnionych, brakujących i nieoczekiwanie wczesnych.
Mapowanie zależności: należy śledzić, które dashboardy zależą od których tabel, aby awarie po stronie źródeł wychodziły na jaw przed rozpoczęciem spotkania.
Schemat i czas razem: zasilenie, które dociera na czas, ale zmienia strukturę, to nadal awaria.
Moduł digna Timeliness uczy się wzorców dostaw i wylicza oczekiwane czasy dostarczenia danych. Warto połączyć go z digna Data Quality Management, który zapewnia wykrywanie anomalii, walidację i śledzenie schematu w tabelach zasilających kluczowe dashboardy. Więcej o modelu działania znajdą Państwo w przewodniku digna po monitorowaniu terminowości danych.
2. Brakujące lub niekompletne zasilenia
Zasilenie może zakończyć się poprawnie, a mimo to być błędne. Pliki docierają, schemat się zgadza, a liczba wierszy wygląda na tyle przyzwoicie, że przechodzi szybką kontrolę. Brakuje natomiast regionu, systemu źródłowego lub przedziału czasu, który nigdy nie dotarł do celu.
Tak właśnie sumy rozjeżdżają się bez wyraźnego alarmu. Wyraźnym przykładem jest incydent z raportowaniem COVID-19 w Public Health England, kiedy przez kilka dni pominięto około 16 000 pozytywnych wyników testów, ponieważ arkusz przekroczył limit wierszy starszego formatu Excela używanego do konsolidacji danych (How Public Health England's COVID-19 data collection went wrong). Awaria wyglądała na zwykłą zmienność, dopóki ktoś nie sprawdził źródła.
Wykrywanie musi odbywać się na poziomie segmentów. Łączna liczba wierszy nie wystarczy, ponieważ częściowa awaria w jednym regionie lub linii produktów może sprawić, że ogólna wartość nadal będzie wyglądać normalnie. O stronie pomiarowej piszemy w przewodniku digna o tym, jak mierzyć kompletność danych. digna Anomalies uczy się typowych wzorców wolumenu dla każdej tabeli i oznacza częściowe zasilenia nawet wtedy, gdy zadanie pipeline'u raportuje sukces.
Ograniczanie ryzyka to praca powtarzalna i właśnie o to chodzi. Należy porównywać liczby rekordów w źródle i w celu na każdym etapie, rejestrować oczekiwaną i faktyczną liczbę wierszy oraz przechowywać ślad audytowy tam, gdzie ktoś może go później przejrzeć. Jeśli zasilenie ma zawierać każdy sklep każdego dnia, brak jednego sklepu w danym dniu powinien zostać zauważony, zanim trafi do dashboardu lub prognozy.
3. Dryf schematu
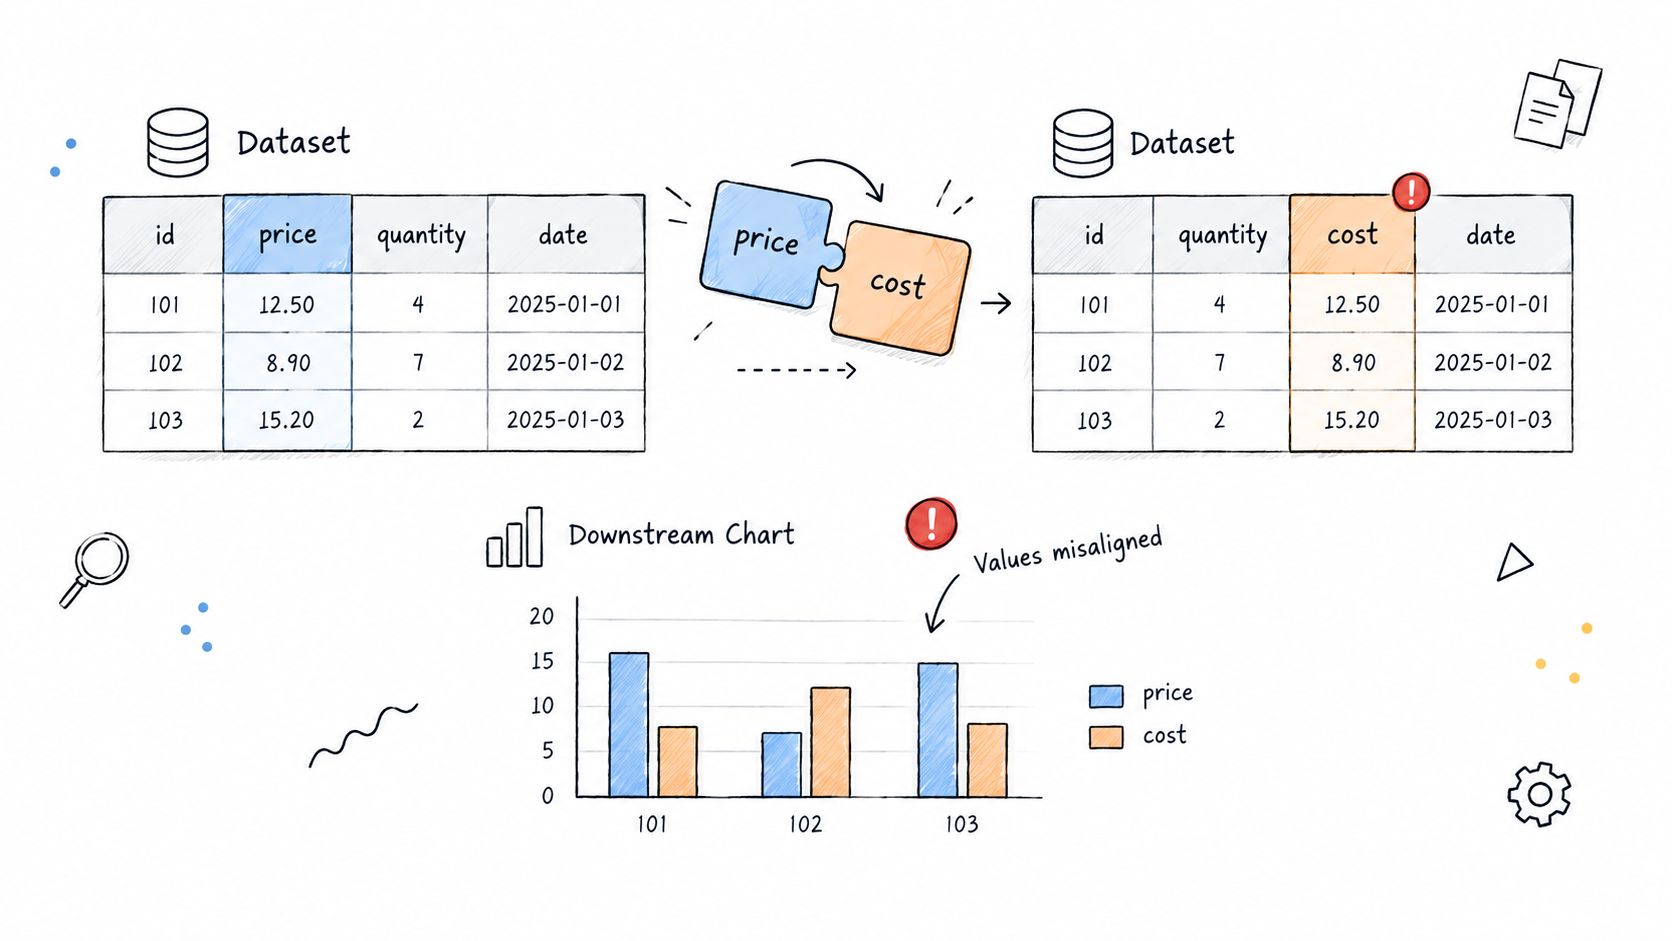
Pole może zmienić strukturę, a pipeline nadal raportuje sukces. Kolumna zostaje przemianowana, zmienia się jej typ albo źródło po wdrożeniu nowej wersji usuwa pole, a logika na dalszych etapach działa dalej na błędnych założeniach. Zwykle wychodzi to na jaw później w postaci wartości null, przesuniętych wartości, zepsutych obliczeń lub modelu, który ocenia dane wejściowe, których już nie rozumie.
Najgorsze są awarie ciche. Pole kwotowe, które zmienia typ z dziesiętnego na tekstowy, może zepsuć agregację w warstwie BI, podczas gdy zadanie źródłowe nadal wygląda na zdrowe. Usunięta kolumna może też zostać zastąpiona wartością domyślną, co utrzymuje zasilenie przy życiu, ale sprawia, że liczby są mniej prawdziwe, nie generując przy tym żadnego oczywistego błędu.
Jak wykryć to wcześnie
Dodane, usunięte i zmienione typem kolumny należy monitorować w sposób ciągły, a nie tylko podczas wdrożeń.
Zmiany warto klasyfikować według wpływu, aby zmiany łamiące zgodność nie trafiały do tej samej kolejki co nieszkodliwe dodatki.
Każdą zmianę należy powiązać ze źródłem oraz z każdym zależnym od niego zasobem na dalszych etapach.
digna Schema Tracker wychwytuje zmiany strukturalne w chwili ich wystąpienia i przypisuje je do zasobów, których dotyczą. Przegląd typów schematów od digna podpowiada praktyczny sposób grupowania tych zmian, zanim rozprzestrzenią się na logikę raportowania lub scoringu. Kontrakt schematu nie zatrzyma każdej zmiany, ale zatrzyma tę odmianę dryfu schematu, która wychodzi na jaw dopiero wtedy, gdy raport jest już błędny.
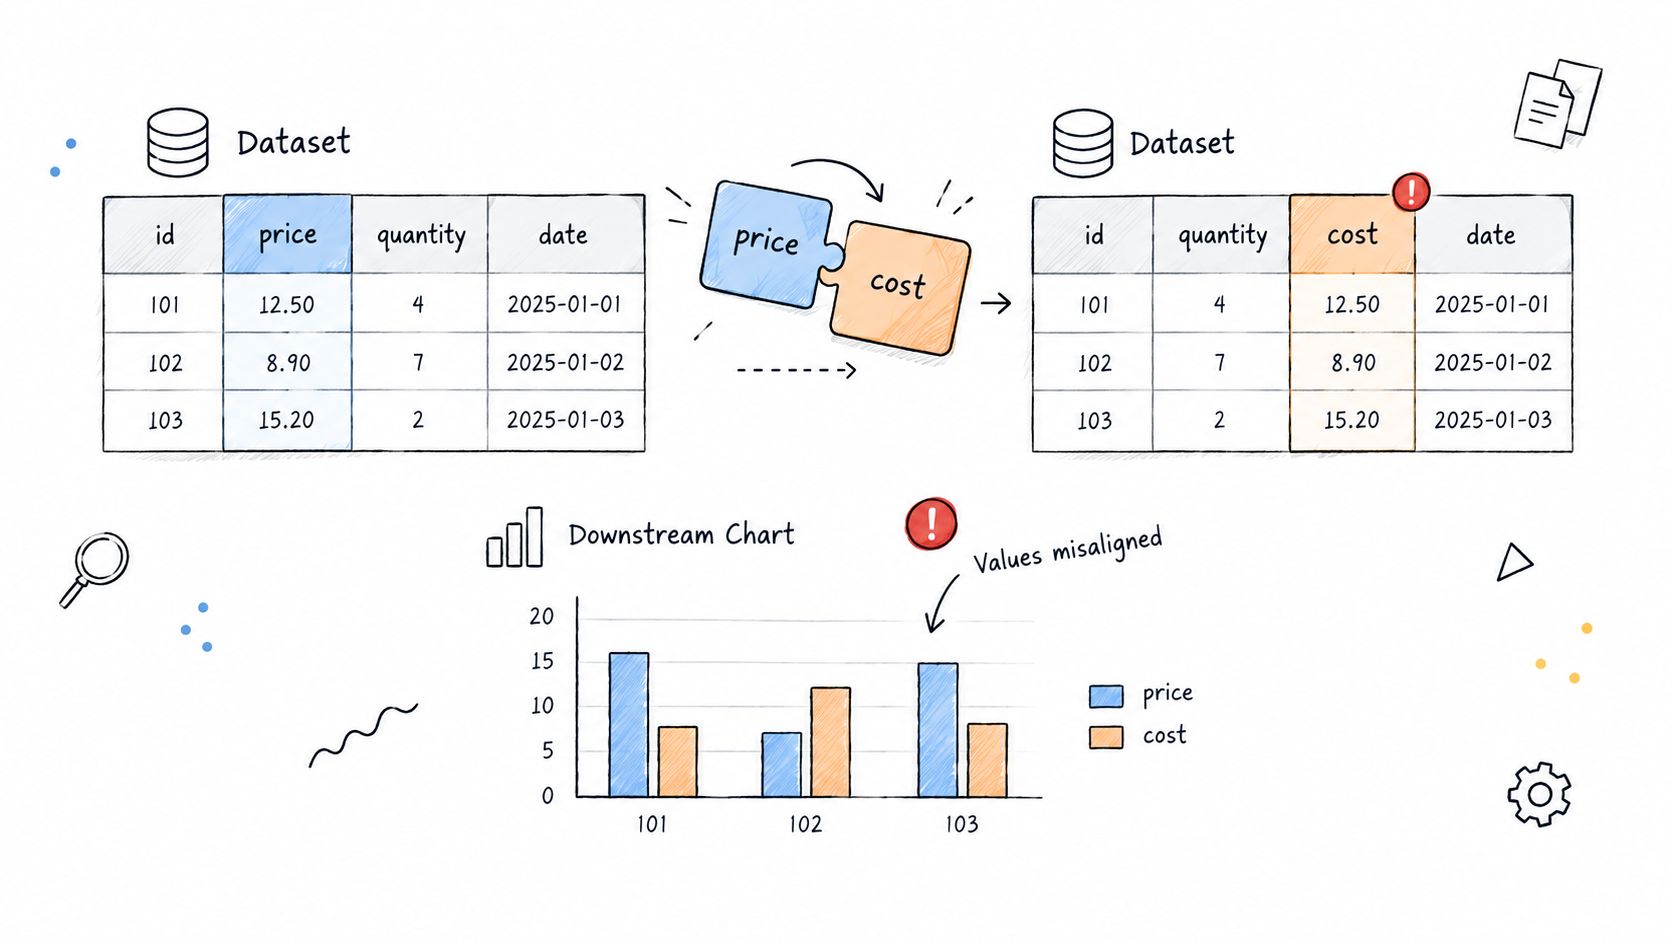
Przejrzysty przykład wizualny pomaga zespołom zobaczyć, jak pole może zostać przemianowane bez niczyjej wiedzy. Diagram ilustrujący niedopasowanie danych, w którym cena zostaje błędnie oznaczona jako koszt, co prowadzi do błędnych wykresów na dalszych etapach.
4. Zduplikowane rekordy
Duplikaty są podstępne, ponieważ każdy pojedynczy wiersz wygląda na prawidłowy. Ten sam klient, transakcja lub polisa pojawia się dwukrotnie, czasem w wyniku ponowień, czasem z powodu nakładających się systemów źródłowych, a czasem przez logikę scalania, która przeoczyła dopasowanie klucza. Nic się nie zawiesza, ale sumy są już błędne.
Szkody operacyjne stają się oczywiste, gdy prześledzi się ich źródło. Fakturowanie jest zawyżone, liczba klientów przekracza rzeczywistość, a raporty compliance zaczynają opisywać organizację, która nigdy nie istniała. Podczas migracji zduplikowane konta mogą sprawić, że raportowanie zarządcze pokazuje firmę w lepszej kondycji lub większą, niż jest w rzeczywistości. W systemach strumieniowych logika ponowień może podczas problemu z siecią zapisać tę samą transakcję wielokrotnie, a efektem są zawyżone przychody, wolumeny lub aktywność.
Dobry wzorzec kontroli zaczyna się od jawnie zdefiniowanych kluczy biznesowych. Jeśli nie określi się unikalności encji, reguła deduplikacji zostaje pozostawiona przypadkowi. digna Data Validation pozwala egzekwować unikalność kluczy i wychwytywać naruszenia na poziomie rekordów, a ingestię należy uczynić idempotentną, aby ponowienia nie tworzyły kolejnych wierszy. W przypadku rozmytych nakładań, gdy dokładne dopasowanie nie wystarcza, przewodnik digna po dopasowaniu rozmytym pokazuje praktyczną drogę do wychwytywania rekordów na tyle podobnych, że warto je przejrzeć.
Bezwzględna liczba duplikatów ma mniejsze znaczenie niż trend. Nagły wzrost zwykle mówi więcej niż stabilny poziom bazowy.
5. Wartości null i brakujące wartości
Wartości null łatwo zbagatelizować, ponieważ nie każda brakująca wartość jest problemem. Kłopoty zaczynają się, gdy odsetek wartości null zmienia się bez wyjaśnienia albo gdy pole, które powinno być wypełnione, zaczyna przychodzić puste w istotnej części rekordów. Często wskazuje to na nieudane złączenie, problem z parsowaniem lub zmianę w źródle, której nikt nie zauważył.
Niezgodność formatu w kluczu złączenia może sprawić, że rekordy przestaną się dopasowywać, a wtedy kluczowy atrybut klienta znika na dalszych etapach. Nowa wersja aplikacji mobilnej może całkowicie przestać rejestrować pole, przez co odsetek wartości null gwałtownie rośnie, podczas gdy pipeline nadal wygląda na zdrowy. Ryzyko nie jest wyłącznie analityczne: brak krytycznych pól może zniekształcać modele i decyzje operacyjne.
Właściwa kontrola opiera się tu na odsetkach, a nie na wartościach bezwzględnych. Ogólna reguła „żadnych wartości null” generuje szum, natomiast zmierzony poziom bazowy wychwytuje istotne przesunięcia. Pola opcjonalne i obowiązkowe należy śledzić osobno oraz sprawdzać zamaskowane brakujące wartości, takie jak ciągi-wartownicy czy liczby zastępcze. digna Anomalies uczy się typowego odsetka wartości null dla każdej kolumny i alarmuje o istotnych odchyleniach, zamiast zmuszać do sporów o ręcznie ustawiane progi. Artykuł digna o kompletności jako wymiarze jakości danych przydaje się, gdy zespoły muszą oddzielić rzeczywistą kompletność od założeń.
6. Nieprawidłowe formaty i wartości spoza zakresu
Nieprawidłowe wartości często przechodzą walidację techniczną, ponieważ typ jest poprawny, ale treść jest błędna. Data może zostać poprawnie sparsowana, a mimo to być niemożliwa. Cena może być liczbą, ale w złej jednostce. Kod pocztowy może mieć oczekiwaną długość, a jednocześnie nie spełniać żadnego rzeczywistego ograniczenia, na którym opiera się biznes.
Wiele zespołów myli udaną ingestię z poprawnością danych. Rekord medyczny z datą urodzenia w przyszłości może wynikać z zamiany dnia z miesiącem między systemami. Sprzedawca detaliczny może pobierać ceny w centach z jednego źródła i w jednostkach waluty z innego, przez co ten sam produkt wydaje się 100 razy za drogi lub za tani. Pipeline się nie zepsuł, zepsuła się logika biznesowa.
Odpowiedzią jest jawna kontrola domen wartości. Należy udokumentować dopuszczalne zakresy i listy kodów dla krytycznych pól, a następnie walidować je na poziomie rekordów i zachowywać błędne wiersze wraz z przyczynami. digna Data Validation pozwala egzekwować te reguły w najważniejszych kolumnach, a kontrole regułowe warto łączyć z wykrywaniem statystycznym, gdy błędne wartości są widoczne dopiero na tle historii. Pomocne są tu także wytyczne NIST dotyczące jakości, które ujmują jakość informacji w kategoriach użyteczności, integralności i obiektywności, przy czym akceptowalny błąd zależy od przypadku użycia (standardy jakości informacji NIST).
7. Naruszenia reguł biznesowych i luki w integralności referencyjnej
Wysyłka przed datą zamówienia, kredyt bez zapisu o zatwierdzeniu czy polisa wskazująca na nieistniejącego klienta rzadko psują pipeline. Psują za to zaufanie do liczb. Takie błędy prześlizgują się przez podstawową walidację, ponieważ pola są obecne, ale logika biznesowa jest błędna.
Najcichsze awarie zwykle kryją się w relacjach. Zamknięty kontrahent może nadal pojawiać się w raportach ekspozycji, jeśli aktualizacje statusu nie docierają do każdej tabeli na dalszych etapach. Szkody mogą nadal odwoływać się do numerów polis, które już nie istnieją w rekordzie głównym. Dział finansów zauważa to późno, często po tym, jak ktoś już zatwierdził raport.
Warto uszeregować je według sposobu, w jaki zawodzą. Brakujący klucz obcy jest głośny. Nieaktualna flaga statusu nie.
1. Brakujące rekordy nadrzędne Rekord podrzędny nie wskazuje na nic, a mimo to wiersz trafia do raportowania. Wykrywa się to, sprawdzając każdy klucz obcy względem tabeli głównej, a następnie codziennie przeglądając odrzucone rekordy. Dzięki digna Data Validation błędne wiersze są zachowywane wraz z przyczyną, aby zespoły operacyjne i audytorzy mogli prześledzić usterkę.
2. Daty biznesowe w niewłaściwej kolejności Zdarzenie przychodzi z datami, których sekwencja nie ma sensu. Wychwytuje się to jawnymi regułami kolejności, na przykład zatwierdzenie przed wypłatą lub początek polisy przed datą szkody.
3. Niezgodne statusy w różnych systemach Jedna tabela mówi „zamknięty”, inna nadal „aktywny”. Należy porównywać pola cyklu życia między źródłami i oznaczać rekordy, które nie zgadzają się co do bieżącego stanu.
4. Osierocone odwołania operacyjne Faktura, szkoda lub ekspozycja pozostaje powiązana z usuniętym rekordem głównym. Kontrole referencyjne należy uruchamiać tam, gdzie dane są przechowywane, a nie tylko po agregacji.
5. Reguły istniejące tylko w czyjejś głowie Należy udokumentować regułę, wskazać jej właściciela i zapisać warunek testu w czytelny sposób. Reguła, której nikt nie potrafi wyjaśnić, nie przetrwa przeglądu.
Kontrole powinny być blisko danych, dowody należy zachowywać, a awarie kierować do osób, które mogą naprawić źródło.
8. Cichy dryf danych i przesunięcia rozkładów
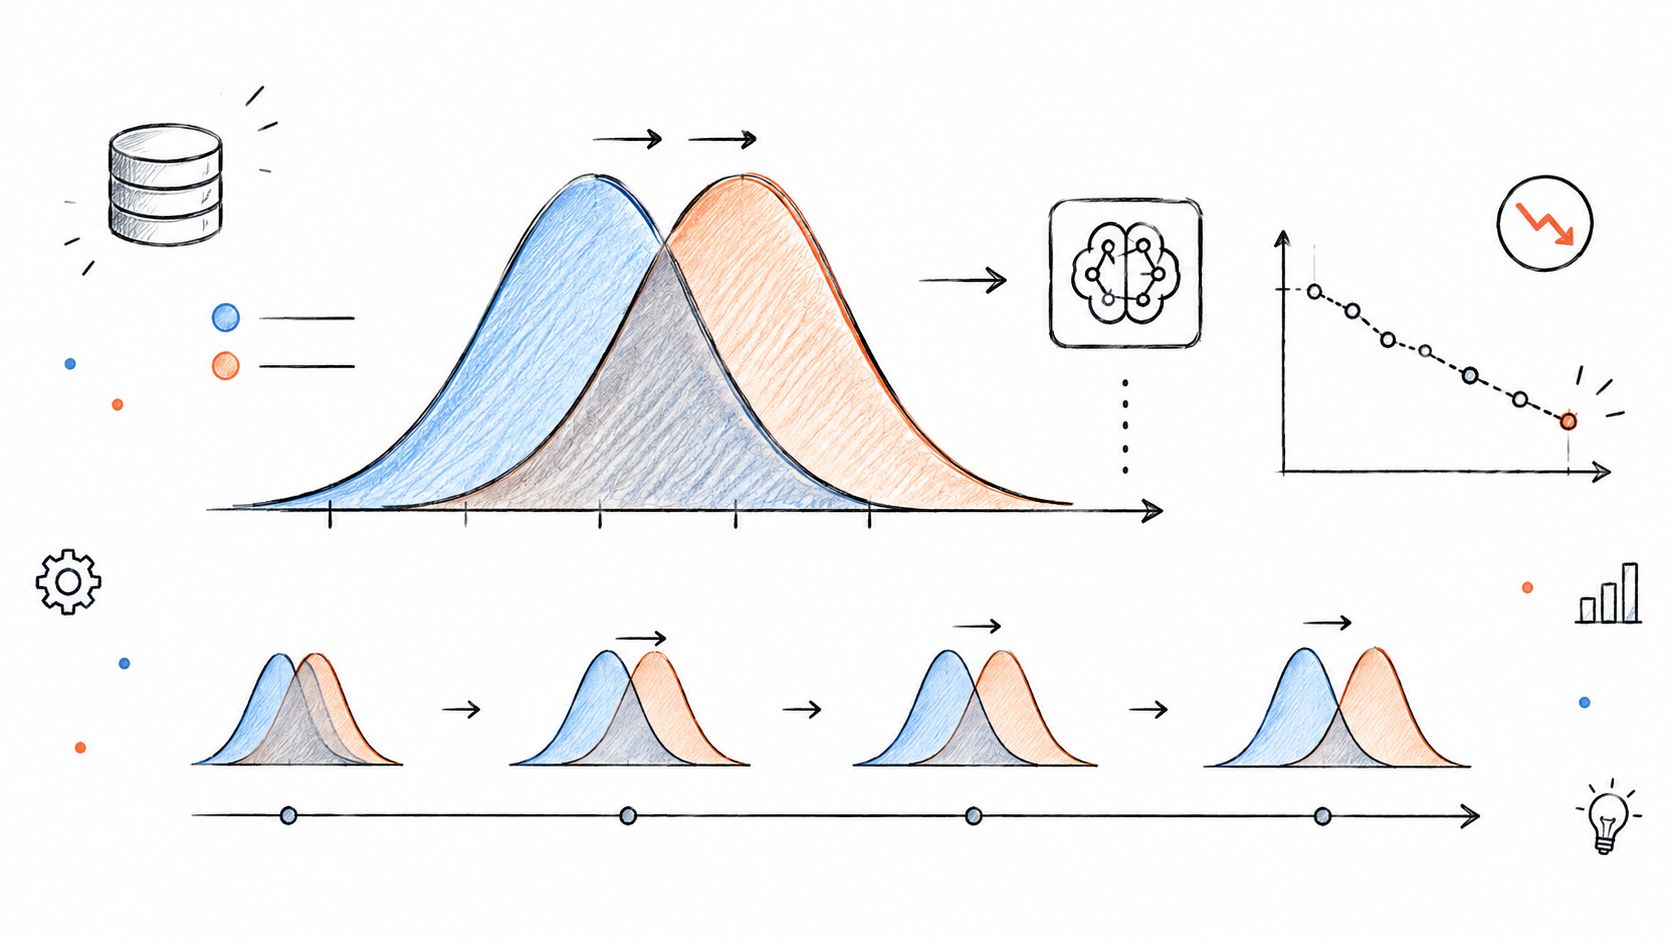
Pipeline może pozostawać zdrowy, podczas gdy dane powoli przestają znaczyć to samo. Średnie się przesuwają, struktura się zmienia, korelacje słabną, a raporty lub modele stają się mniej wiarygodne bez nieudanego zadania czy zepsutego schematu. Dlatego dryf łatwo przeoczyć i trudno zbagatelizować.
Te problemy warto uszeregować według tego, jak cicho zawodzą. Głośna awaria przyciąga uwagę. Cicha zmiana zachowania zwykle nie.
1. Dryf rozkładu cech Karta scoringowa nadal działa, ale jedno z wejść pochodzi teraz z innego segmentu klientów niż wcześniej. Należy porównywać rozkłady kroczące ze znanym poziomem bazowym, a następnie zestawiać je z ostatnimi wdrożeniami w źródłach i zmianami mapowań. W digna Anomalies można ustawić oczekiwane zakresy dla każdego zbioru danych, a digna Data Analytics pozwala sprawdzić, czy zmiana jest odosobniona, czy stanowi część szerszego trendu.
2. Dryf etykiet lub wyników Sama zmienna docelowa zmienia się po zmianach w polityce, produkcie lub routingu. Model może wyglądać gorzej, choć pipeline jest nienaruszony. Należy śledzić wskaźniki wyników w czasie i zestawiać je ze zdarzeniami biznesowymi, zanim uzna się przesunięcie za degradację modelu.
3. Ciche zmiany jednostek lub kodowania Waluta, kod statusu lub mapowanie kategorii zmienia się w źródle, ale zasilenie nadal przechodzi walidację. Dashboard pozostaje zielony, a liczby przestają być porównywalne. Należy porównywać wdrożenia w źródłach i logi transformacji, a następnie potwierdzić, że wartości nadal mają znaczenie, którego oczekują użytkownicy na dalszych etapach.
4. Zmiany struktury segmentów W raporcie zaczyna dominować nowy region, kanał lub grupa urządzeń, a ogólna średnia przesuwa się razem z nim. Zanim uzna się to za trend, należy rozbić metryki na segmenty. Jeśli jeden segment wyjaśnia większość przesunięcia, problemem jest struktura, a nie wyniki.
5. Stopniowa utrata korelacji Dwa pola, które kiedyś zmieniały się razem, już tego nie robią. Często pojawia się to po zmianie źródła danych, opóźnionym zasileniu lub nowej regule biznesowej. Należy obserwować zależności między parami pól i alarmować o trwałych odchyleniach, a nie tylko o pojedynczych skokach.
Przydatny nawyk jest prosty: monitorować rozkłady, wiązać alerty ze zdarzeniami w źródłach i utrzymywać widoczność błędnych wierszy oraz kontekstu, aby analitycy mogli odróżnić dryf od rzeczywistej zmiany.
9. Niespójne definicje, jednostki i logika metryk
Dwa dashboardy mogą być jednocześnie „poprawne” i wzajemnie sprzeczne, dlatego ta kategoria tak mocno podważa zaufanie. Jeden zespół liczy konta, drugi unikalnych klientów, trzeci raportuje przychody w tysiącach, a czwarty inaczej przelicza strefy czasowe. Liczby są wewnętrznie spójne, ale bezużyteczne przy porównaniu.
Taka rozbieżność pozostaje ukryta, dopóki kierownictwo nie zapyta, dlaczego ten sam kwartał wygląda inaczej w dwóch systemach. Awaria sondy Mars Climate Orbiter to klasyczny przykład niezgodności jednostek i wciąż ma znaczenie, ponieważ nowoczesna analityka ma tę samą słabość, tylko działa szybciej. Jeśli finanse, operacje i dział produktu definiują „aktywnego klienta” każdy po swojemu, każde spotkanie zamienia się w ćwiczenie z uzgadniania danych.
Glosariusz pomaga, ale tylko wtedy, gdy każda metryka ma przypisanego właściciela, logikę obliczeń i jednostki. Przeliczenia należy standaryzować jak najwcześniej, a następnie regularnie uzgadniać krytyczne metryki i badać różnice przekraczające uzgodnione tolerancje. digna Business Monitoring śledzi KPI na danych źródłowych, dzięki czemu nieoczekiwane zmiany wychodzą na jaw jeszcze przed pełnym ujednoliceniem definicji. Zespołom, które lubią patrzeć na zachowanie metryk przez pryzmat niezawodności, przyda się pokrewny materiał MTBF, MTTR, and OEE metrics explained.
Jeśli dwa zespoły używają tej samej etykiety dla różnej logiki, problemem jest etykieta.
10. Niekontrolowane obciążenie i skoki zużycia platformy
Wdrożenie nowego dashboardu, backfill lub nowy samoobsługowy proces może wypchnąć platformę poza normalne obciążenie, zanim ktokolwiek to zauważy. Hurtownia nadal odpowiada, ale opóźnienia zapytań rosną, koszty idą w górę, a zaplanowane zadania zaczynają nie mieścić się w swoich oknach.
Zespoły często zaliczają takie skoki do kwestii infrastruktury, tymczasem wolumen zapytań, przyrost danych i wydłużający się czas przetwarzania to także problemy niezawodności danych. Zwykle pojawiają się bez ostrzeżenia. Pierwszym objawem rzadko jest awaria. Jest nim wolniejsze odświeżanie modelu, opóźniony raport albo rachunek, którego nikt nie uwzględnił w budżecie. Badania wykorzystania chmury wciąż wskazują ten sam wzorzec: niewykorzystana lub źle zarządzana pojemność zamienia się w marnotrawstwo i obciążenie operacyjne, dlatego wzrost obciążenia powinien być uwzględniany w kontrolach danych w tym samym stopniu co w przeglądach infrastruktury.
Zachowanie platformy pod kontrolą
Śledzenie według właściciela obciążenia: skoki należy przypisywać do zespołu, pipeline'u lub dashboardu, zanim wzorzec się rozprzestrzeni.
Poziom bazowy według wzorca czasowego: przed wysłaniem alertu warto porównać zachowanie w dni robocze, w weekendy i w oknach wdrożeniowych.
Przegląd z działem finansów: kontrola kosztów działa lepiej, gdy inżynierowie i finanse analizują te same trendy.
digna Data Platform Observability monitoruje obciążenia, zużycie, dostępność i wskaźniki wydajności w jednym miejscu. Ułatwia to wychwycenie cichego trybu awarii, w którym system nadal działa, ale koszty i opóźnienia wychodzą poza tolerancję. Dla zespołów platformowych taka widoczność często oznacza różnicę między kontrolowanym wzrostem a kosztowną niespodzianką.
Porównanie 10 najczęstszych problemów z danymi
Problem | 🔄 Złożoność wdrożenia | 💡 Wymagane zasoby | ⚡ Oczekiwana szybkość wykrycia | 📊 Oczekiwane rezultaty / wpływ | ⭐ Idealne zastosowania / kluczowa zaleta |
|---|---|---|---|---|---|
Terminowość, nieaktualne dane i zepsute dashboardy | Średnia do wysokiej; wymaga okien SLA i mapowania zależności | Umiarkowane: monitoring, lineage, alerty | Wolna, jeśli patrzy się tylko na dashboardy; ⚡ szybka dzięki uczeniu się okien dostarczenia | Duży wpływ na wiele raportów; podważa zaufanie interesariuszy | Krytyczne dashboardy i egzekwowanie SLA; szybka komunikacja ze źródłami |
Brakujące lub niekompletne zasilenia | Średnia; wymaga segmentowych poziomów bazowych wolumenu i uzgadniania | Umiarkowane: logi liczby wierszy, kontrole per partycja | Średnia; częściowe zasilenia mogą pozostać niezauważone bez kontroli segmentowych | Duże ryzyko dla agregatów i trendów; może zniekształcać wolumeny | Pipeline'y wsadowe/ETL i metryki zagregowane; wykrywanie brakujących segmentów |
Dryf schematu | Średnia; wymaga ciągłego śledzenia schematów i kontraktów | Niskie do umiarkowanych: rejestr schematów lub narzędzia do ich śledzenia | Średnia do szybkiej dzięki automatycznemu porównywaniu schematów | Psuje transformacje, generuje wartości null lub błędy na dalszych etapach | Systemy z wieloma producentami danych; egzekwowanie kontraktów schematu |
Zduplikowane rekordy | Średnia; wymaga zaprojektowania kluczy biznesowych i idempotentności | Niskie do umiarkowanych: logika deduplikacji, narzędzia do dopasowywania | Średnia; często widoczne dopiero po agregacji, jeśli nie są monitorowane | Zawyżone liczebności i sumy oraz błędy w fakturowaniu lub analityce klientów | Pipeline'y ingestii, rozpoznawanie tożsamości klientów, fakturowanie |
Wartości null i brakujące wartości | Niska do średniej; monitoring na poziomie kolumn i bazowe poziomy oczekiwanych wartości null | Niskie: kontrole i alerty per kolumna | Szybka dzięki monitorowaniu odsetka wartości null | Obciążenie analityki i ML oraz brakujące atrybuty do złączeń | Cechy ML i pola obowiązkowe; wychwytywanie nagłych skoków wartości null |
Nieprawidłowe formaty i wartości spoza zakresu | Niska do średniej; zdefiniowanie reguł składni, semantyki i zakresu | Niskie: reguły walidacji i listy słownikowe | Szybka dzięki kontrolom deterministycznym | Nieprawdopodobne lub niezgodne z wymogami wartości, które zniekształcają metryki | Pola o znanych domenach (daty, kody, ceny); kontrole regulacyjne |
Naruszenia reguł biznesowych i luki referencyjne | Wysoka; wymaga logiki międzytabelowej i przypisania odpowiedzialności | Wysokie: kontrole integralności, właściciele, ślady audytowe | Średnia; bywa kosztowne, więc często stosuje się próbkowanie | Niezgodności z regulacjami, problemy z uzgadnianiem, ryzyko audytowe | Regulowane procesy finansowe, zarządzania ryzykiem i uzgadniania |
Cichy dryf danych i przesunięcia rozkładów | Średnia do wysokiej; statystyczne poziomy bazowe i monitorowanie zależności | Umiarkowane do wysokich: narzędzia do wykrywania dryfu, długoterminowe poziomy bazowe | Z natury wolna; ⚡ szybsza dzięki ciągłym detektorom dryfu | Stopniowa degradacja modeli i mylące trendy | Produkcyjne modele ML i długoterminowe analityczne poziomy bazowe |
Niespójne definicje, jednostki i logika metryk | Wysoka; governance, glosariusz i uzgodnienia między zespołami | Wysokie: dokumentacja, uzgadnianie, warstwy przeliczeń | Wolna, często wykrywane podczas przeglądów lub audytów | Sprzeczne dashboardy i utrata zaufania do KPI | KPI międzydziałowe, raportowanie dla zarządu, skonsolidowane metryki |
Niekontrolowane obciążenie i skoki zużycia platformy | Średnia; poziomy bazowe per obciążenie i przypisanie odpowiedzialności | Wysokie: telemetria platformy, kontrola kosztów, playbooki naprawcze | Średnia do szybkiej dzięki metrykom platformy i alertom | Przekroczenia kosztów, opóźnione zadania, spadek wydajności | Współdzielone hurtownie danych, FinOps, harmonogramowanie produkcji i backfille |
Jak zamienić te dziesięć kontroli w stałą rutynę jakości danych
Warto zacząć od problemów, które dotyczą najczęściej używanych dashboardów i raportów regulacyjnych. Każdemu z nich należy przypisać właściciela, metodę wykrywania i ścieżkę alertowania, ponieważ „ktoś powinien na to spojrzeć” to nie jest kontrola. Jeśli dane wspierają finanse, ochronę zdrowia, raportowanie publiczne, obsługę klientów lub pipeline'y AI, pierwszym zadaniem jest uwidocznienie awarii, zanim trafi ona na spotkanie, do sprawozdania lub do modelu.
Tę listę warto przeglądać co kwartał. Pojawiają się nowe źródła, schematy się zmieniają, zespoły budują nowe dashboardy, a wykorzystanie platformy rośnie w sposób, który wymaga kontroli niepotrzebnych jeszcze pół roku temu. Dobrze starzeją się te systemy, w których terminowość, kompletność, zmiany schematu, walidacja i wykrywanie anomalii są monitorowane rutynowo, a nie w trybie reagowania na kryzys.
Najpraktyczniej jest zacząć od trzech problemów, które w tym miesiącu najprawdopodobniej zakłócą krytyczne raporty. Najpierw należy ustalić dla nich poziomy bazowe, a gdy alertowanie stanie się wiarygodne, rozszerzyć kontrolę na pokrewne tryby awarii. Tu dobrze sprawdza się digna, ponieważ jej moduły obejmują terminowość, zmiany wolumenu, wartości null, zmiany schematu, reguły na poziomie rekordów, monitorowanie biznesowych KPI i obserwowalność platformy w jednym modelu działania.
Najważniejsza jest konsekwencja. Jeśli potrafią Państwo wcześnie wykrywać nieaktualne dane, brakujące zasilenia i zmiany strukturalne, eliminuje to już dużą część cichych awarii, przez które zespoły danych tracą zaufanie do własnych wyników. Jeśli da się udowodnić regułę biznesową, okno świeżości i źródło zmiany, z resztą można sobie poradzić.
digna daje zespołom praktyczny sposób monitorowania danych, na których opierają się raportowanie, operacje i AI. Jeśli zmagają się Państwo z nieaktualnymi zasileniami, dryfem, brakującymi rekordami lub zmianami schematu, zapraszamy na stronę digna, aby zobaczyć, jak jej moduły wspierają terminowość, walidację, wykrywanie anomalii, śledzenie schematu i obserwowalność platformy we własnym środowisku.
Gdy alert zostanie wywołany, kolejne pytanie brzmi: kto go przeanalizuje i jak szybko problem zostanie naprawiony. Proces zarządzania problemami jakości danych opisuje te kroki od wykrycia do zamkniętej poprawki.
Najczęściej zadawane pytania
Jakie są najczęstsze problemy z danymi?
Dziesięć najczęstszych to nieaktualne dane, brakujące lub niekompletne zasilenia, dryf schematu, zduplikowane rekordy, wartości null, nieprawidłowe formaty, naruszenia reguł biznesowych, cichy dryf rozkładów, niespójne definicje metryk oraz skoki zużycia platformy. Lista porządkuje je według tego, jak cicho zawodzą, a nie według tego, jak często się o nich mówi.
Jak wykryć częściowe zasilenie, gdy zadanie raportuje sukces?
Wolumen należy sprawdzać na poziomie segmentów, a nie jako jedną sumę. Brak jednego regionu lub linii produktów może pozostawić łączną liczbę wierszy na normalnym poziomie, dlatego warto porównywać liczby rekordów w źródle i celu na każdym etapie i dla każdego segmentu oraz alarmować, gdy wypadnie pojedynczy sklep lub dzień.
Dlaczego dryf schematu jest groźny, skoro pipeline nadal działa?
Ponieważ logika na dalszych etapach nadal działa na błędnych założeniach. Przemianowana kolumna, pole dziesiętne zamienione na tekst lub usunięte pole zastąpione wartością domyślną mogą generować wartości null, błędne agregacje i mylące liczby bez widocznego błędu. Ciągłe śledzenie dodanych, usuniętych i zmienionych typem kolumn wychwytuje to, zanim raporty staną się błędne.
Czy reguły jakości danych powinny całkowicie zakazywać wartości null?
Nie. Ogólny zakaz wartości null generuje szum, ponieważ niektóre pola są z założenia opcjonalne. Zamiast tego warto monitorować odsetek wartości null względem wyuczonego poziomu bazowego dla każdej kolumny, śledzić osobno pola opcjonalne i obowiązkowe oraz wychwytywać zamaskowane braki, takie jak ciągi-wartownicy czy liczby zastępcze.
Od czego zespół powinien zacząć budowę rutyny jakości danych?
Od trzech problemów, które w tym miesiącu najprawdopodobniej zakłócą krytyczne raporty. Każdemu należy przypisać właściciela, metodę wykrywania i ścieżkę alertowania, ustalić poziomy bazowe, a gdy alerty staną się wiarygodne, rozszerzyć kontrolę na pokrewne tryby awarii. Listę warto przeglądać co kwartał, bo źródła, schematy i dashboardy się zmieniają.