Dane zagregowane: definicja, metody, przykłady i pułapki
|
7
min. czyt.

Dane zagregowane to informacje powstające przez grupowanie pojedynczych rekordów w kategorie i łączenie ich wartości w miary podsumowujące, takie jak liczności, sumy, średnie czy wskaźniki. Brzmi to prosto, ale rada „wystarczy zbudować dashboard” sprawia najwięcej kłopotów, ponieważ agregacja zmienia zarówno znaczenie, jak i profil ryzyka danych źródłowych.
Spis treści
Dlaczego dane zagregowane są ważne dla analityki i observability
Ryzyko dla prywatności i ryzyko ujawnienia w wynikach zagregowanych
Przykład krok po kroku: od surowych rekordów do wiarygodnego agregatu
Czym naprawdę są dane zagregowane
Dane zagregowane to informacje podsumowujące wyprowadzone z rekordów niższego poziomu, a nie odrębny rodzaj danych, który powstaje sam z siebie. Model myślowy ma dwie strony: po jednej znajdują się pojedyncze zdarzenia, transakcje lub obserwacje, po drugiej sumy, średnie lub wskaźniki na poziomie grupy, które sprowadzają wiele wierszy do mniejszej liczby wyników.
Dobrym przykładem jest baza danych z 1 milionem pojedynczych transakcji klientów, podsumowana do 12 sum miesięcznych dla każdego rynku. Nie widać już poszczególnych zakupów, ale można porównywać rynki, śledzić sezonowość i znacznie szybciej dostrzegać ogólne wzorce. Australijski urząd statystyczny (Australian Bureau of Statistics) opisuje agregację jako grupowanie informacji w kategorie i łączenie wartości w ich obrębie, często w postaci tabel, dlatego mówi się także o danych tabelarycznych lub makrodanych ABS glossary.

Robocza definicja, która sprawdza się w praktyce
Agregację warto traktować jako transformację stosowaną do surowych obserwacji. Transakcja klienta staje się miesięczną sumą przychodów, strumień zdarzeń telemetrycznych godzinową liczbą błędów, a spis gospodarstw domowych zestawieniem cech populacji. Na tym polega podstawowy ruch: sprowadzenie wielu rekordów do mniejszej liczby podsumowań.
Praktyczna zasada: jeśli wynik odpowiada na pytanie o grupę, ale nie o osobę, jest zagregowany. Jeśli bez dodatkowego kontekstu nadal da się powiązać wynik z pojedynczym rekordem, należy traktować go jako ryzyko dla prywatności i ryzyko ujawnienia.
To rozróżnienie ma znaczenie, bo ten sam wynik może być przydatny w raportowaniu, a jednocześnie na tyle wrażliwy, że wymaga kontroli. Jeśli potrzebne jest drugie źródło terminologii przy analizie, jak dostawcy opisują ten obszar, zbiór pricing data research od Wine Labs stanowi przydatny punkt odniesienia pokazujący, jak w badaniach rynku prezentuje się ustrukturyzowane podsumowania.
Podstawowe metody agregacji
Agregacja staje się prostsza, gdy przestaje się ją traktować jako jedną czynność. W praktyce zespoły sięgają po niewielki zestaw funkcji, a każda z nich odpowiada na inne pytanie o te same wiersze źródłowe.
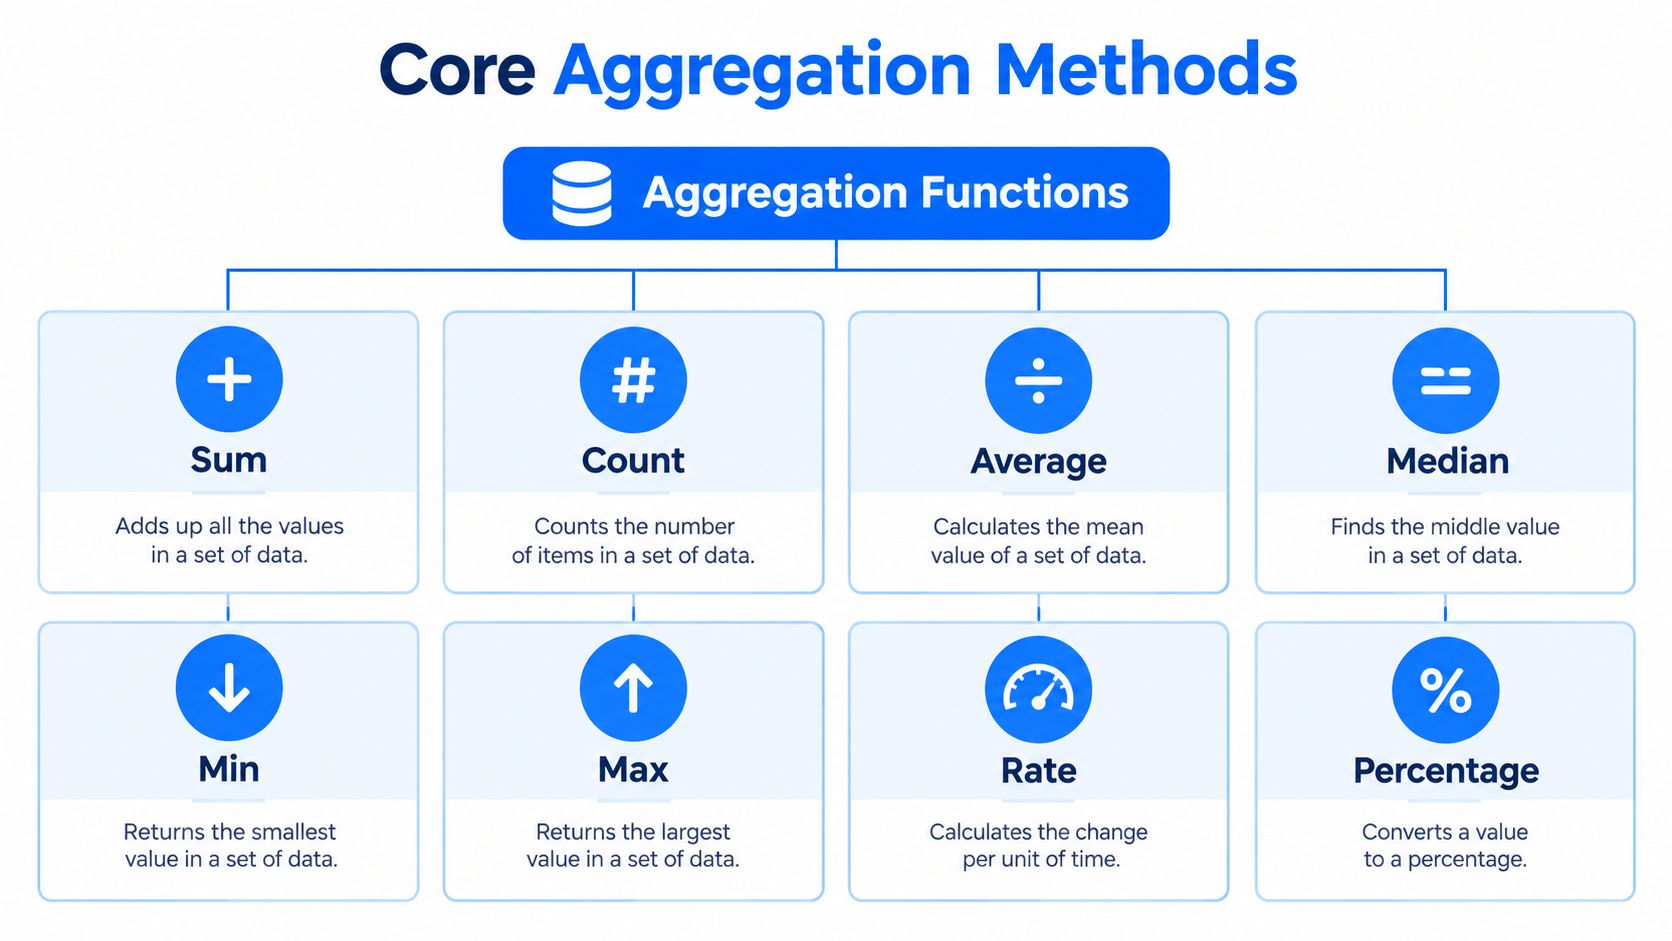
Główne funkcje i to, co zachowują
Suma dodaje wartości. Jeśli pięć zamówień ma wartość 20, 30, 10, 40 i 50, suma wynosi 150. To właściwy wybór, gdy liczy się wolumen, przychód, liczba sprzedanych sztuk lub łączny czas.
Liczność mówi, ile rekordów znajduje się w grupie. Zachowuje wolumen aktywności, ale nie wielkość wartości, więc sprawdza się dla transakcji, zgłoszeń, użytkowników lub zdarzeń, gdy pytanie brzmi „ile?”.
Średnia daje średnią arytmetyczną. Pomaga, gdy potrzebna jest typowa wartość, ale może wprowadzać w błąd, jeśli kilka dużych wartości odstających odciąga wynik od tego, jak wygląda większość wierszy.
Mediana daje wartość środkową po posortowaniu. Warto jej używać przy rozkładach skośnych, ponieważ jest odporniejsza na wartości skrajne niż średnia.
Minimum i maksimum zachowują najmniejszą i największą wartość. Przydają się do sprawdzania zakresów, ale pomijają wszystko, co leży pomiędzy.
Wskaźniki i odsetki wymagają dyscypliny w doborze mianownika
Wskaźnik to stosunek, na przykład liczba konwersji podzielona przez liczbę odwiedzających. Odsetek to ta sama idea wyrażona w skali 100. Oba mają sens tylko wtedy, gdy mianownik jest stabilny i jasno zdefiniowany.
Częstym błędem jest uśrednianie odsetków z grup o nierównych mianownikach. Mała grupa liczy się wtedy tyle samo co duża, co zniekształca wynik. Jeśli pytanie brzmi „jaka część całego ruchu dokonała konwersji?”, mianownikiem musi być cały ruch, a nie średnia z miesięcznych współczynników konwersji.
Zasada ogólna: należy stosować najprostszą funkcję, która zachowuje informację potrzebną do podjęcia decyzji, i nic ponadto. Jeśli pytanie biznesowe dotyczy skali, wystarczy suma lub liczność. Jeśli dotyczy typowego zachowania, przy danych skośnych lepiej sięgnąć po medianę niż po średnią.
Rollupy, okna i agregacje czasowe
Czas sprawia, że agregacja staje się decyzją podlegającą zasadom, a nie tylko obliczeniem. Ta sama tabela zakupów może dać przychód dzienny, sumy tygodniowe, wyniki zamknięcia miesiąca lub kroczącą linię trendu, a każda wersja odpowiada na inne pytanie operacyjne.
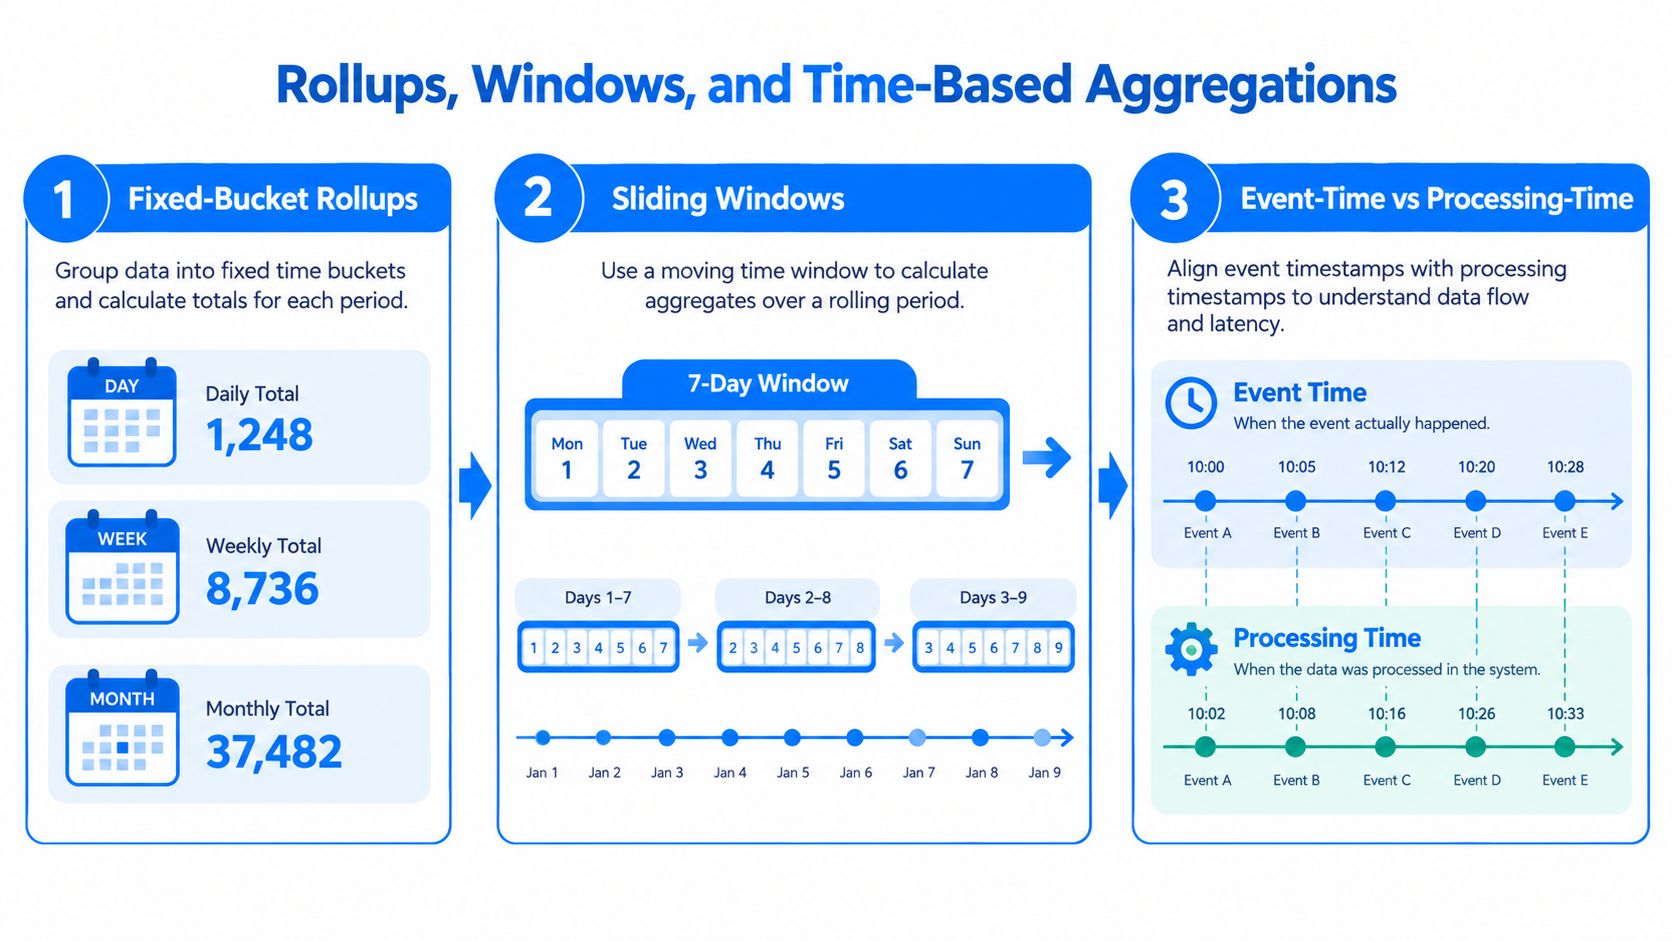
Stałe przedziały i widoki kroczące
Rollup w stałych przedziałach grupuje rekordy w okresy kalendarzowe, takie jak dzień, tydzień lub miesiąc. Jeśli zespół sprzedaży chce znać miesięczny przychód według regionów, granicą przedziału jest miesiąc, a każde zamówienie trafia do jednego z przedziałów na podstawie swojej daty. Ułatwia to porównywanie cyklicznych raportów, ale oznacza też, że reguła odcięcia musi być jednoznaczna.
Okno przesuwne stale przesuwa przedział. Krocząca średnia 7-dniowa wygładza codzienny szum i pokazuje trend, który ukryłaby pojedyncza suma dzienna. Ceną jest to, że każdy nowy dzień zmienia wynik, więc wczorajsza wartość może się przesunąć, gdy dotrą spóźnione rekordy.
Czas zdarzenia i czas przetwarzania to nie to samo
Czas zdarzenia to moment, w którym nastąpiła sprzedaż, kliknięcie lub odczyt czujnika. Czas przetwarzania to moment, w którym system je otrzymał. Jeśli przesyłki docierają z opóźnieniem, dashboard oparty na czasie zdarzenia pozostaje wierny rzeczywistości, a dashboard oparty na czasie przetwarzania może zbyt wcześnie wyglądać na kompletny i zmienić się później.
Dlatego spóźnione dane psują naiwne dashboardy i dlatego zespoły łączą rollupy z types of anomaly detection, aby wychwytywać agregaty odbiegające od swojej linii bazowej. Surowe rekordy mogą być poprawne, a agregat mimo to błędny dla wybranego okna raportowego.
Dla zespołów inżynierskich obsługujących takie rollupy w silnikach SQL i zadaniach pipeline'ów in-database processing utrzymuje logikę blisko danych i ogranicza zbędne przenoszenie danych.
Gdzie odbywa się agregacja w nowoczesnych systemach danych
Agregacja pojawia się wszędzie tam, gdzie odbiorca dalej w łańcuchu potrzebuje szybszych lub prostszych odpowiedzi, niż mogą dać surowe rekordy. Warstwa przechowywania się zmienia, ale wzorzec pozostaje ten sam: pogrupować rekordy, podsumować je i udostępnić w użytecznej formie.

Typowe miejsca dla rollupów
Operacyjne bazy danych często zasilają dashboardy czasu rzeczywistego, zwłaszcza gdy zespół chce widzieć poziom usług na podstawie bieżących transakcji. Słabym punktem jest presja na aktualność, ponieważ ciężkie rollupy mogą spowalniać ten sam system, który obsługuje ruch aplikacji.
Hurtownie danych zwykle przechowują modele wymiarowe i wstępnie obliczone tabele faktów. Tam często znajduje się raportowanie finansowe, sprzedażowe i zarządcze, ale rollupy w hurtowni mogą rozjechać się z tabelami źródłowymi, jeśli logika odświeżania jest niekompletna lub partycjonowanie niespójne.
Data lake i lakehouse obsługują pipeline'y wsadowe i strumieniowe, co czyni je elastycznymi przy mieszanych obciążeniach. Ceną jest złożoność, ponieważ okna strumieniowe mogą gubić spóźnione zdarzenia, a zadania wsadowe ukrywać problemy aż do następnego uruchomienia.
Wybór miejsca w zależności od pytania
Platformy observability wykorzystują rollupy metryk do alertowania i analizy trendów, ponieważ alerty potrzebują szybkich podsumowań, a nie surowych logów. Jeśli potrzebne są wskazówki architektoniczne dotyczące projektowania nowoczesnego stosu, przegląd modern data architecture approaches od Ekipa jest przydatnym odniesieniem pokazującym, jak te warstwy zwykle do siebie pasują.
Gdy agregacja działa blisko systemów produkcyjnych, kształt zapytania ma takie samo znaczenie jak matematyka. Szybki dashboard zbudowany na błędnym grupowaniu może być groźniejszy niż wolny, który jest wyraźnie niekompletny.
Dlaczego dane zagregowane są ważne dla analityki i observability
Dashboardy, raportowanie dla zarządu, sprawozdania regulacyjne i cechy modeli uczenia maszynowego zależą od widoków zagregowanych. Oznacza to, że jeden słaby agregat może przenosić błędy do wszystkich dalszych systemów, nawet jeśli surowe dane źródłowe pozostają nienaruszone.
Perspektywa observability jest równie ważna. Nietypowa suma lub wskaźnik to często pierwsza wskazówka, że coś zmieniło się wcześniej w łańcuchu, czy to zepsuty join, pominięta partycja, opóźniony feed, czy zmiana schematu. Metryki zagregowane szybko ujawniają takie sygnały, dlatego zespoły monitorują je w pierwszej kolejności.
Co ukrywa agregacja, jeśli nie przenosi kontekstu
Suma może ukryć kurczącą się populację. Średnia może zamaskować długi ogon. Wskaźnik może wyglądać stabilnie, podczas gdy zmienia się mianownik. Dlatego dobre agregaty niosą obok liczby metadane, w tym liczbę rekordów, pokrycie oraz wymiary grupowania, które ukształtowały wynik.
Dla zespołów budujących widoki monitoringu pytanie nie brzmi tylko „jaka jest wartość metryki?”, ale także „jakie rekordy ją zasiliły, co zostało wykluczone i co zmieniło się od ostatniego razu?”. Od odpowiedzi zależy, czy liczba jest wiarygodna, czy tylko schludna.
Osobom, które już pracują ze stosami monitoringu, strona what is data observability posłuży jako praktyczne uzupełnienie tej myśli, bo przedstawia metryki jako coś, co się analizuje, a nie tylko wyświetla.
Ryzyko dla prywatności i ryzyko ujawnienia w wynikach zagregowanych
Agregacja w wielu przypadkach poprawia ochronę prywatności, ale nie jest równoznaczna z anonimowością. NIST definiuje informacje zagregowane jako dane zebrane od wielu osób w celu dokonywania porównań lub identyfikowania wzorców, a jednocześnie ostrzega, że zestawianie danych może tworzyć dodatkowe ryzyko, ponieważ całość danych może ujawnić pełniejszy obraz lub umożliwić deanonimizację NIST aggregated information.
Dlaczego małe grupy nadal stwarzają ryzyko
Zasady kontroli ujawniania istnieją, ponieważ małe komórki nadal mogą wskazywać na konkretne osoby lub organizacje. Wytyczne tureckiej statystyki publicznej uznają komórkę tabeli zagregowanej za poufną, gdy zawiera mniej niż 3 jednostki statystyczne, i wskazują też przypadki dominacji, w których jedna jednostka odpowiada za ponad 80% wartości komórki lub dwie jednostki za ponad 90% NIST data aggregation. Brytyjska Care Quality Commission przytacza ponadto praktyczną regułę unikania grup liczących 10 lub mniej osób, a grupy liczące 5 lub mniej dopuszcza tylko w sytuacjach szczególnie niskiego ryzyka CQC anonymisation guidance.
Nie są to uniwersalne bezpieczne progi. Ryzyko nadal zależy od geografii, szczegółowości czasowej, wiedzy z zewnątrz oraz tego, co zdeterminowany odbiorca może wywnioskować, łącząc różne widoki.
Kontrole, które powinny być częścią procesu publikacji
Generalizacja poszerza wąską kategorię do szerszej, na przykład województwo zamiast powiatu. Supresja całkowicie ukrywa wartość, gdy komórka jest zbyt mała. Perturbacja zmienia publikowaną wartość, aby zmniejszyć ryzyko ujawnienia bez odrzucania całej metryki. W praktyce te mechanizmy działają razem, a nie w oderwaniu od siebie.
Częstym błędem jest założenie, że dashboard jest bezpieczny, bo nie pokazuje już nazwisk. Wąskie filtry mogą bardzo szybko odtworzyć ryzyko identyfikacji, zwłaszcza według geografii, zakresu dat lub segmentu klientów. Jeśli użytkownicy mogą zagłębiać się zbyt daleko, agregat przestaje zachowywać się jak grupa i zaczyna zachowywać się jak pojedynczy, zakamuflowany wiersz.
Customer data protection guidance ma tu znaczenie, ponieważ kontrole prywatności działają tylko wtedy, gdy ocenia się je w odniesieniu do konkretnego kontekstu publikacji, a nie wyłącznie do etykiety „zagregowane”.
Walidacja i jakość danych
Agregat może być poprawny matematycznie, a mimo to wprowadzać w błąd. Dlatego wyniki zagregowane potrzebują własnych kontroli jakości, a nie tylko oceny „zaliczone” lub „niezaliczone” dla wierszy źródłowych.
Kontrole, które wychwytują najczęstsze błędy
Średnie mogą ukrywać paradoks Simpsona, w którym trend odwraca się po rozbiciu danych według istotnego wymiaru. KPI może wyglądać dobrze w rollupie, podczas gdy jeden region lub segment pogarsza się pod spodem. To nie błąd obliczeniowy, lecz błąd grupowania.
Praktyczne zabezpieczenia są proste:
Minimalna wielkość grupy: należy upewnić się, że każda publikowana grupa jest wystarczająco duża, aby ograniczyć zarówno ryzyko ujawnienia, jak i wnioski obarczone szumem.
Stabilność mianownika: warto sprawdzić, czy populacja stojąca za wskaźnikiem zmieniła się w sposób, który zaburza porównania.
Obsługa wartości null: przed uruchomieniem rollupu trzeba zdecydować, czy brakujące wartości są wykluczane, imputowane, czy traktowane jako zero.
Obsługa duplikatów: powtórzone rekordy należy usunąć lub oznaczyć, zanim zawyżą sumy.
Spóźnione dane: czas zdarzenia trzeba uzgadniać z czasem przetwarzania, aby dashboard nie udawał zbyt wcześnie, że jest ostateczny.
Lineage: należy zachować ścieżkę od agregatu do rekordów źródłowych i logiki grupowania.
Sygnały, które powinny uruchomić analizę
Jeśli zagregowana populacja nagle się kurczy, staje się silnie skoncentrowana lub zmienia wymiary w sposób zwiększający ryzyko ujawnienia, ktoś powinien natychmiast przejrzeć pipeline. To nie są zmiany kosmetyczne. Zwykle oznaczają, że zmieniła się definicja, feed źródłowy lub kontekst publikacji.
W pracy nad jakością i egzekwowaniem reguł pomocny jest temat data validation rules, checks, and continuous data quality, ponieważ celem walidacji jest to, by agregat był wiarygodny, a nie tylko policzony.
Praktyczna zasada: nie warto pytać, czy metryka jest „prawidłowa”, dopóki nie sprawdzi się, czy grupa, mianownik i lineage nadal znaczą to, co się zakłada.
Przykład krok po kroku: od surowych rekordów do wiarygodnego agregatu
Punktem wyjścia jest strumień zdarzeń zakupowych klientów. Każdy rekord zawiera znacznik czasu, region, wartość zamówienia i status wysyłki. Pierwszy agregat jest prosty: sumujemy wartości zamówień i zliczamy zamówienia według dnia i regionu, aby uzyskać dzienny przychód i wolumen zamówień.
Budowanie trendu bez utraty kontekstu decyzji
Następnie na sumy dzienne nakłada się kroczącą średnią 7-dniową. Wygładza ona wahania weekendowe i daje zespołowi stabilniejszą linię trendu do przeglądów operacyjnych. Jeśli spóźniona przesyłka dotrze po dziennym zamknięciu, wersję agregatu opartą na czasie zdarzenia należy przeliczyć, a widok oparty na czasie przetwarzania może pozostać jako ślad audytowy pokazujący, kiedy system się o niej dowiedział.
Potem przychodzi decyzja dotycząca prywatności. Jeśli w jakimś regionie jest zbyt mało zamówień albo jeden sprzedawca odpowiada za niemal wszystko w tym regionie, zespół powinien połączyć obszary geograficzne lub ukryć komórkę, zamiast publikować kruchą liczbę. Dzięki temu dashboard pozostaje użyteczny, a zidentyfikowanie osoby lub dostawcy nie staje się łatwiejsze.
Agregat jako monitorowany zasób
Gdy metryka trafia na produkcję, staje się częścią observability. Jeśli dzienna suma przychodów gwałtownie spada, a liczba zamówień nie, to sygnał, by sprawdzić ceny, zwroty lub brakujące wartości. Jeśli populacja stojąca za metryką nagle się zmienia, zespół powinien przeanalizować logikę filtrów, zanim ktokolwiek zaufa wykresowi.
Wniosek z przykładu jest prosty. Agregacja nie jest ostatnim krokiem. To punkt, w którym spotykają się poprawność, prywatność i zaufanie operacyjne.
Ściągawka: praca z danymi zagregowanymi
Definicja: dane zagregowane to informacje na poziomie grupy, tworzone przez łączenie pojedynczych rekordów w podsumowania, takie jak liczności, sumy, średnie, wskaźniki lub rozkłady.
Typowe funkcje:
Suma dla wolumenu. Liczność dla częstotliwości rekordów. Średnia dla wartości typowej. Mediana dla rozkładów skośnych. Minimum i maksimum do sprawdzania zakresów. Wskaźnik i odsetek dla proporcji, ze starannie zdefiniowanym mianownikiem.
Progi prywatności, o których warto pamiętać:
Małe grupy nadal mogą ujawniać informacje. Przy ocenie ryzyka publikacji należy zwracać uwagę na komórki z mniej niż 3 jednostkami, wzorce dominacji powyżej 80% lub 90% oraz grupy o małej liczebności, rzędu 10 lub mniej.
Kontrole walidacyjne, które warto utrzymywać:
Minimalna wielkość grupy, stabilność mianownika, obsługa wartości null, obsługa duplikatów, obsługa spóźnionych danych i lineage aż do rekordów źródłowych.
Podejście operacyjne:
Agregacja to transformacja podlegająca zasadom, a nie gwarancja prywatności ani gwarancja jakości.
digna pomaga zespołom monitorować dane stojące za tymi agregatami, a nie tylko dashboard zbudowany na ich podstawie. Jeśli potrzebne są wykrywanie anomalii, walidacja, śledzenie terminowości danych, monitoring schematów i wykonywanie in-database we własnym środowisku, warto odwiedzić digna i sprawdzić, jak rozwiązanie wpisuje się w Państwa stos danych.
Katalog metryk wolumenu, aktualności i rozkładu, które pozwalają utrzymać wiarygodność takich agregatów w czasie, zawiera artykuł o metrykach data observability.
Najczęściej zadawane pytania
Czym są dane zagregowane?
Dane zagregowane to podsumowujące informacje na poziomie grupy, powstające przez łączenie pojedynczych rekordów w liczności, sumy, średnie, wskaźniki lub rozkłady. Na przykład 1 milion transakcji klientów można sprowadzić do 12 sum miesięcznych dla każdego rynku, co pozwala porównywać rynki i dostrzegać sezonowość bez przeglądania każdego zakupu.
Jakie funkcje agregujące są najczęściej używane?
Suma, liczność, średnia, mediana, minimum, maksimum, wskaźnik i odsetek wystarczają do większości raportów. Każda zachowuje coś innego: suma wolumen, liczność aktywność, mediana jest odporna na wartości odstające w danych skośnych, a minimum i maksimum służą do sprawdzania zakresów. Wskaźniki i odsetki mają sens tylko przy stabilnym, jasno zdefiniowanym mianowniku.
Czy dane zagregowane są anonimowe?
Nie automatycznie. Agregacja zmniejsza ryzyko dla prywatności, ale małe grupy lub grupy zdominowane przez jedną jednostkę nadal mogą wskazywać na osoby albo organizacje. Niektóre wytyczne statystyki publicznej uznają komórkę za poufną, gdy zawiera mniej niż 3 jednostki lub gdy jedna jednostka odpowiada za ponad 80% jej wartości, więc może być potrzebna supresja lub generalizacja.
Dlaczego nie należy uśredniać odsetków między grupami?
Uśrednianie odsetków z grup o różnej wielkości sprawia, że mała grupa waży tyle samo co duża, co zniekształca wynik. Aby ustalić, jaka część całego ruchu dokonała konwersji, należy podzielić łączną liczbę konwersji przez cały ruch, zamiast uśredniać miesięczne współczynniki konwersji.
Jak walidować dane zagregowane?
Sprawdzając sam agregat, a nie tylko wiersze źródłowe: minimalną wielkość grupy, stabilność mianownika, obsługę wartości null i duplikatów, spóźnione dane oraz lineage do rekordów źródłowych. Potem trzeba go stale monitorować. Jeśli dzienny przychód gwałtownie spada, a liczba zamówień pozostaje stabilna, warto sprawdzić ceny, zwroty lub brakujące wartości.


