Zarządzanie problemami jakości danych: szybsza naprawa
|
10
min. czyt.

Pulpit mówi, że przychód spadł. CFO pyta, czy spadł popyt, zmieniły się ceny, czy finanse znów wczytały niewłaściwą tabelę. Na Slacku analityczka wrzuciła już zrzut z trzema różnymi liczbami dla tego samego wskaźnika. Ktoś łata model SQL, przepuszcza potok jeszcze raz i ogłasza, że naprawione.
Dwa dni później ten sam problem wraca z innego źródła powyżej w łańcuchu.
To wzorzec, z którym żyje wiele zespołów danych. Nie pojedyncze zepsute pole, lecz powtarzalna pętla nieświeżych ładowań, cichego dryfu schematu, zdublowanych alertów i niejasnej własności. Doraźne poprawki wydają się w danej chwili szybkie, ale zwykle kończą się na uśmierzeniu objawu. Nie określają, kto odpowiada za usterkę, jaki czas reakcji jest akceptowalny ani jak zespół zapobiega ponownemu otwarciu tej samej klasy problemu.
Spis treści
Dlaczego problemy jakości danych wymagają zarządzanego procesu
Przepływ zarządzania problemami jakości danych, od wykrycia do zapobiegania
Jak triażować, priorytetyzować i przypisywać własność przy SLA
Osadzenie procesu w narzędziach, rolach i codziennej eksploatacji
Dlaczego problemy jakości danych wymagają zarządzanego procesu
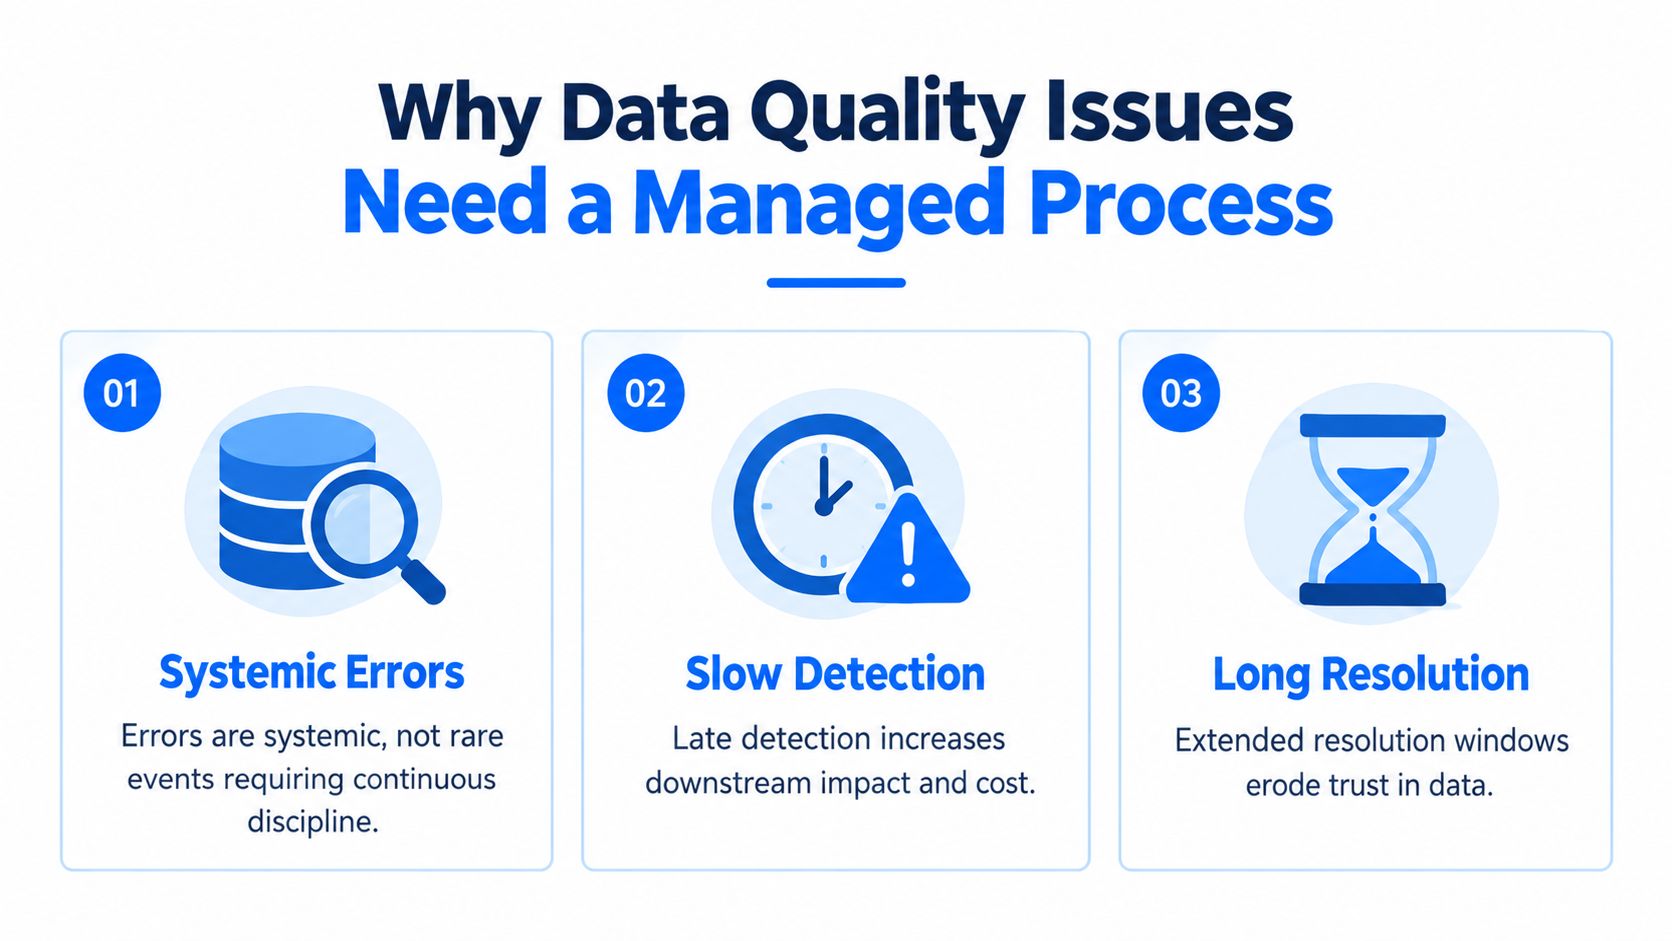
Wadliwe ładowanie ląduje o 6:10. O 8:00 finanse kwestionują przychód, analityczka wyciszyła trzy hałaśliwe alerty, a inżynier przepuszcza zadanie ponownie, nie wiedząc, czy usterka zaczęła się w ingestii ze źródła, w zmianie transformacji, czy w zepsutej tabeli referencyjnej. Zespoły często nazywają to triażem. W praktyce to praca w kolejce bez modelu operacyjnego.
To rozróżnienie ma znaczenie. Zarządzany proces zarządzania problemami jakości danych to nie tylko sposób na szybsze łapanie złych rekordów. Ustala własność, istotność, SLA, ścieżki eskalacji i pracę zapobiegawczą, żeby ta sama klasa usterki nie wracała pod nowym numerem zgłoszenia.
Badania nad wpływem na przedsiębiorstwa pokazują, dlaczego doraźne podejście zawodzi przy skali. Złą jakość danych wyceniono na średni roczny koszt 12,9 miliona dolarów na organizację, a badania MIT Sloan raportowały w niektórych kontekstach od 15% do 25% rocznego spadku przychodów z powodu złej jakości danych, jak podsumowują te statystyki poprawy jakości danych. To samo podsumowanie przytacza szeroko cytowany wynik Harvard Business Review, według którego jedynie 3% danych firmowych spełniało podstawowe standardy jakości, oraz ustalenie MIT Sloan i Thomasa Redmana, że 47% nowo utworzonych rekordów zawierało co najmniej jeden błąd krytyczny.
Doraźne poprawki zawodzą na granicy własności
Pierwsza poprawka bywa łatwą częścią. Trudne jest rozstrzygnięcie, kto odpowiada za przyczynę źródłową, kto za komunikację w dół, jakiego czasu reakcji może oczekiwać biznes i jaka zmiana zapobiegnie powtórce.
Bez tych reguł zespoły optymalizują zamykanie zamiast rozwiązywania. Jedna osoba łata model. Druga wycisza alert. Nikt nie aktualizuje progu, nie dodaje testu kontraktu ani nie wskazuje trwałego właściciela systemu źródłowego. Sprawa znika z kolejki i zostaje w systemie.
Reguła praktyczna: jeśli usterka może się powtórzyć, wskaż właściciela, określ cel reakcji i zdecyduj, jaka kontrola wyłapałaby ją wcześniej.
Dlatego zarządzanie problemami powinno być traktowane jak model operacyjny. Wykrywanie to jego część. Reszta to dyscyplina procesu: jeden rekord na jedną usterkę źródłową, jasne kryteria istotności, zegary SLA, przekazania, które nie grzęzną na Slacku, i pętla zapobiegania, która daje zmiany w kodzie, testach, metadanych albo zachowaniu systemu źródłowego.
Widziałem zespoły spędzające więcej czasu na sporze, czy problem jest „naprawdę jakością danych”, niż na decyzji, kto ma go naprawić. Zwykle znaczy to, że procesowi brakuje wspólnej jednostki pracy i oczekiwania serwisowego. Efekt jest znajomy. Rośnie zmęczenie alertami, własność się rozmywa, a użytkownicy biznesowi zaczynają prowadzić własne arkusze, bo ufają swoim ręcznym kontrolom bardziej niż platformie.
Zarządzany proces znaczy mierzalny proces
Zespół nie poprawi tego, czego nie liczy spójnie. Jeśli każda nieudana kontrola staje się osobnym incydentem, kolejka wygląda gorzej, niż jest. Jeśli rejestruje się tylko problemy widoczne dla zarządu, wygląda zdrowiej niż rzeczywistość. Jedno i drugie zniekształca priorytetyzację.
Użyteczny jest widok operacyjny. Mierz wskaźnik spraw wobec zdefiniowanej jednostki, a potem śledź realizację SLA według istotności, domeny źródłowej i klasy spraw powtarzalnych. To pokazuje, czy problemem jest pokrycie wykrywania, dyscyplina triażu, słaba własność czy powtarzalne usterki powyżej w łańcuchu. Daje też liderom danych lepsze argumenty inwestycyjne niż stwierdzenie, że jakość danych „wydaje się zła”.
Ten argument zaczyna się często od szerszego wyjaśnienia, dlaczego jakość danych jest ważna dla organizacji, ale codzienna wygrana jest prostsza. Mniej zdublowanych zgłoszeń. Krótszy czas do potwierdzenia. Szybsze kierowanie do właściciela. Więcej napraw, które usuwają tryb awarii, zamiast sprzątać jego objawy.
To, co działa, rzadko bywa efektowne. Jasne progi. Wskazani właściciele. Cele reakcji poparte SLA. Reguły eskalacji uruchamiane, zanim zauważy to zarząd. Działania po incydencie, które zmieniają system.
Co liczy się jako problem jakości danych i jak go mierzyć
Zespoły zaczynają za późno. Rzucają się w triaż, zanim uzgodnią, czym jest sprawa.
To błąd, bo twoje metryki rozsypią się w chwili, gdy różne zespoły będą liczyć co innego. Jedna drużyna traktuje każdą nieudaną kontrolę jako sprawę. Druga rejestruje tylko incydenty widoczne biznesowo. Trzecia otwiera pięć zgłoszeń dla jednej usterki powyżej, bo zawiodło pięć modeli niżej. Tą kolejką trudno zarządzać, bo nie mierzysz tej samej jednostki awarii.
Zdefiniuj problem, zanim zdefiniujesz przepływ
Praktyczna metodyka liczy problem jakości danych jako jedno z trzech: nieudaną kontrolę jakości powyżej progu, naruszenie świeżości lub SLA albo potwierdzony incydent. Powinna wykluczać fałszywe alarmy i awarie zadań niezwiązane z jakością danych, zgodnie z tą metodyką wskaźnika spraw.
Element progu ma znaczenie. Krajowe wytyczne zarządzania jakością danych mówią, że każda metryka powinna mieć próg akceptacji wyrażony jako odsetek albo liczba rekordów, i ujmują zarządzanie problemami jako ciągły proces identyfikowania, śledzenia i rozwiązywania w całej organizacji. W praktyce oznacza to, że „istnieją puste adresy e-mail” jest opisowe, ale „puste adresy e-mail przekroczyły przyjęty próg” jest operacyjne.
Wybierz mianownik pasujący do twojej dojrzałości
Mianownik decyduje, czy zespoły tworzą użyteczny wskaźnik, czy metrykę na pokaz. Jeśli monitorujesz wiele kontroli, „nieudane kontrole na wykonane kontrole” może zadziałać. Jeśli obserwujesz tylko zestaw krytycznych zasobów, „sprawy na monitorowany zbiór” bywa czystsze. Jeśli twoje środowisko jest mocno wsadowe i wolumenowe, gęstość spraw na przetworzone rekordy może mieć więcej sensu.
Podstawa pomiaru | Kiedy jej użyć | Przykładowy wskaźnik |
|---|---|---|
Oparta na kontrolach | Uruchamiasz wiele automatycznych kontroli w potokach i tabelach | Odsetek nieudanych kontroli |
Oparta na zbiorach | Monitorujesz wyselekcjonowaną listę krytycznych zbiorów | Sprawy na monitorowany krytyczny zbiór |
Oparta na wolumenie | Przetwarzasz duże wolumeny rekordów i chcesz śledzić gęstość | Sprawy na milion przetworzonych rekordów |
Nie chodzi o znalezienie uniwersalnie najlepszego mianownika. Chodzi o wybranie takiego, który oddaje sposób działania twojej platformy, i utrzymanie go dość długo, by porównywać trendy.
Oczyść dane wejściowe, zanim zaufasz wynikom
Zanim policzysz wskaźniki spraw, zbierz dane operacyjne, które dowodzą, co się wydarzyło. Zwykle obejmują:
Wyniki kontroli: naruszenia walidacji, wyniki anomalii, naruszenia świeżości.
Logi potoków: status wykonania, ponowienia, awarie zależności powyżej.
Dane zgłoszeń: otwarte, potwierdzone, złagodzone, rozwiązane, otwarte ponownie.
Metadane pochodzenia: co zepsuło się powyżej i którzy odbiorcy to odziedziczyli.
Potem nieefektowna robota:
Odduplikuj powiązane alerty, żeby pięć awarii niżej powiązanych z jedną usterką źródłową stało się jedną sprawą.
Ujednolić kategorie przyczyn źródłowych, żeby „dryf schematu”, „spóźniony ekstrakt źródłowy” i „błędne mapowanie referencyjne” za każdym razem znaczyły to samo.
Oddziel tworzenie sprawy od jej potwierdzenia, jeśli twoja warstwa alertów jest hałaśliwa.
Śledź wyniki SLA dopiero, gdy taksonomia spraw jest stabilna.
Metryka, której nie da się porównać miesiąc do miesiąca, nie jest metryką zarządczą. To migawka.
Zespołom dopracowującym wymiary i progi pomaga zestrojenie definicji spraw z podstawowymi wymiarami jakości danych, a potem przypięcie do każdego jasnych kryteriów akceptacji. To daje inżynierii, analityce i biznesowi ten sam język, zanim kolejka incydentów ruszy.
Przepływ zarządzania problemami jakości danych, od wykrycia do zapobiegania
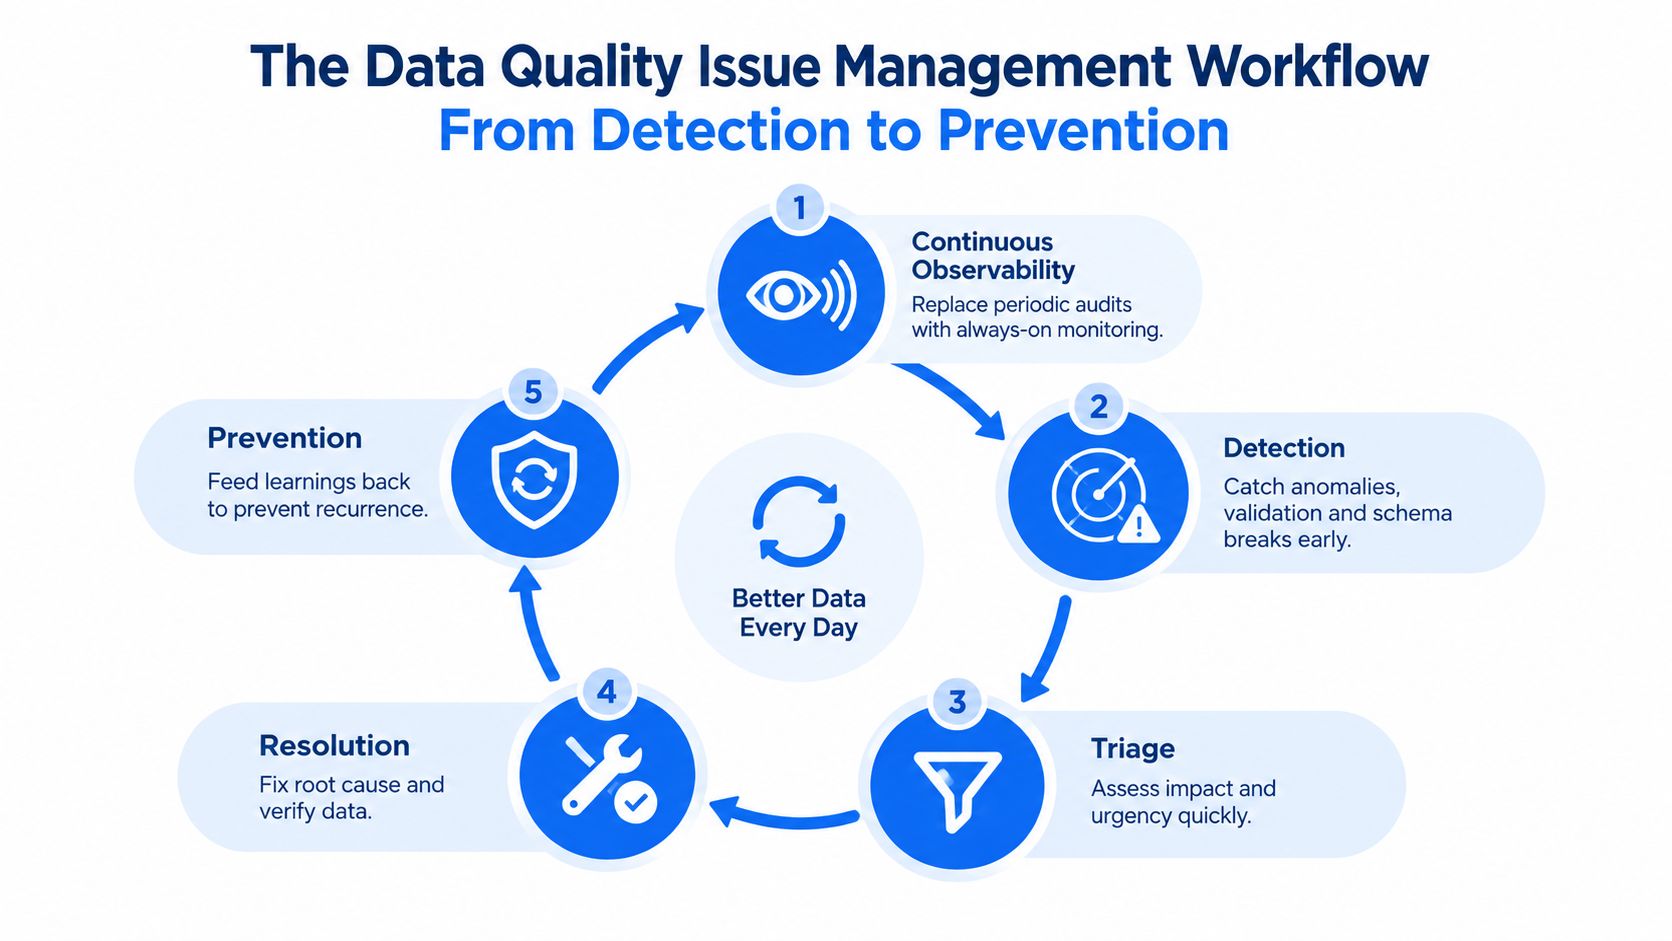
O 8:15 finanse otwierają pulpit przed zamknięciem miesiąca i brakuje wczorajszych liczb. Zadanie ingestii technicznie się powiodło. Hurtownia działa. Warstwa BI serwuje nieświeże dane, bo ekstrakt powyżej przyszedł trzy godziny za późno i nikt nie odpowiadał za kontrolę świeżości. Tak wygląda słaby przepływ na produkcji. Awarią nie jest samo wykrywanie. Jest nią brak modelu operacyjnego łączącego monitorowanie, własność, cele reakcji i zapobieganie.
Zacznij od obserwowalności, która tworzy sprawy do działania
Zarządzanie problemami zaczyna się, zanim powstanie zgłoszenie. Zespoły potrzebują sygnałów mówiących, co zawiodło, kiedy, co się zmieniło i kto jest narażony.
Okresowe przeglądy tego nie udźwigną. Usterki produkcyjne pojawiają się między cyklami przeglądu i zanim ktoś zauważy, tabele, pulpity albo modele niżej w łańcuchu już skonsumowały złe dane. Dobre monitorowanie i raportowanie dla operacji jakości danych skraca odstęp między powstaniem usterki a reakcją człowieka.
Użyteczne sygnały zwykle dzielą się na cztery grupy:
Świeżość i Timeliness: brakujące ładowania, spóźnione dostawy, częściowy napływ partii
Naruszenia walidacji: pola wymagane, dozwolone wartości, unikalność, reguły uzgodnień
Zmiany strukturalne: dodane kolumny, usunięte kolumny, zmiany typów, naruszenia kontraktów
Przesunięcia zachowania: skoki wolumenu, zmiany odsetka wartości pustych, dryf rozkładu, nieoczekiwany ruch metryki
Kompromis jest prosty. Więcej kontroli łapie więcej usterek, ale tworzy też więcej szumu. Zespoły monitorujące wszystko z tą samą czułością zwykle uczą reagujących ignorowania alertów. Celem jest tworzenie spraw, które zasługują na obsługę, a nie kolejki pełnej fałszywych alarmów.
Oddziel wykrywanie od potwierdzania
Nieudana kontrola to zdarzenie. Sprawa to potwierdzone zdarzenie z zakresem, wpływem i właścicielem.
To rozróżnienie ma znaczenie, bo strumienie alertów są hałaśliwe. Zmiana schematu w tabeli piaskownicy nie powinna konkurować z zepsutym strumieniem przychodów. Jeśli proces otwiera zgłoszenie dla każdej anomalii bez potwierdzenia, zespół spędza dzień na zamykaniu szumu i przegapia incydent uderzający w terminy raportowe albo produkty dla klientów.
GitLab dokumentuje praktyczną sekwencję w swoim podręczniku programu jakości danych: Wykrycie → Triaż i potwierdzenie → Dochodzenie → Naprawa → Zapobieganie → Zamknięte. Wartością tego przepływu jest bramka decyzyjna. Zanim sprawa wejdzie do głównej kolejki, ktoś potwierdza, że jest realna, sprawdza, czy dotknięci są odbiorcy, i decyduje, czy trafia na ścieżkę incydentu, czy do zwykłego backlogu.
Ten krok poprawia też pomiar. Wolumen wykryć mówi, jak hałaśliwy jest system. Wolumen potwierdzonych spraw mówi, co muszą obsłużyć eksploatujący. Śledzenie obu to sposób, w jaki zespoły wyłapują słabe progi i zawyżone wskaźniki.
Dochodzenie powinno prześledzić usterkę do punktu kontrolnego
Naprawa zwalnia, gdy zespoły gonią widoczny objaw zamiast źródła. Widzę to często przy awariach niżej w łańcuchu. Pulpit pada, więc ludzie zaczynają łatać logikę BI, choć rzeczywista wina siedzi w ekstrakcie powyżej, zmianie kodu w systemie źródłowym albo zależności harmonogramu.
Kilka wzorców powtarza się regularnie:
Spóźnione dane: nieświeży pulpit to objaw. Przyczyną źródłową bywa opóźnienie powyżej, burza ponowień albo awaria zależności.
Dryf schematu: model w hurtowni pęka po tym, jak źródło zmienia typ albo usuwa pole.
Naruszenie reguły biznesowej: tabela mapowań albo strumień referencyjny przyjmuje nową wartość, której nie spodziewa się żadna reguła niżej.
Australijskie Biuro Statystyczne przedstawia proces etapowy w swoim podręczniku zarządzania i raportowania incydentów jakości: monitoruj jakość, rozpoznaj problem, oceń go, uruchom właściwą ścieżkę raportowania, a potem oceń i wdroż działanie korygujące. Ta kolejność broni się w praktyce, bo ocena jest jawna. Zespoły, które ją pomijają, albo nadmiernie eskalują nieszkodliwe anomalie, albo bagatelizują usterki rozlewające się na wielu odbiorców.
Naprawa nie jest zakończona, dopóki nie wróci zaufanie
Zamknięcie usterki technicznej to tylko część pracy. Pytanie brzmi, czy odbiorcy mogą znów zaufać danym.
Działający przepływ naprawy zwykle obejmuje cztery działania:
Ograniczenie. Wstrzymać odbiorcę, wyciszyć zepsuty pulpit, wycofać transformację albo odizolować wadliwe rekordy.
Korekta. Naprawić awarię w warstwie, która wprowadziła usterkę.
Weryfikacja. Ponownie uruchomić kontrole, uzgodnić kluczowe wyniki i potwierdzić, że dane niżej w łańcuchu się odbudowały.
Komunikacja. Powiedzieć dotkniętym, co było nie tak, co poprawiono i od jakiego znacznika czasu dane są bezpieczne.
Podręcznik zarządzania incydentami GitLaba jest tu przydatny, bo traktuje incydenty danych jak zdarzenia operacyjne wymagające ustrukturyzowanego przypisania, dokumentacji i komunikacji. To lepszy wzorzec niż poleganie na długim wątku na Slacku, którego później nikt nie zaudytuje.
Zapobieganie domyka pętlę i dowodzi, że proces działa
Zapobieganie należy do przepływu, a nie jest jego dodatkiem. Jeśli ta sama klasa usterki wciąż wraca, zespół nie ma problemu z wykrywaniem. Ma problem z projektem kontroli.
Rozwiązaniem może być ostrzejsza reguła walidacji przy ingestii, kontrakt danych dla zmiennego źródła, SLO świeżości z jawnym właścicielem albo aktualizacja runbooka usuwająca niejasność przy przekazaniu. Właściwy wybór zależy od tego, gdzie sprawa weszła do systemu i jak kosztowne jest złapanie jej wcześniej.
Tu zarządzanie problemami staje się też modelem operacyjnym. Mierz wskaźnik powtórek według kategorii przyczyny źródłowej. Mierz, ile spraw mieści się w SLA potwierdzenia, złagodzenia i naprawy. Mierz wskaźnik ponownego otwarcia po zamknięciu. Te liczby mówią, gdzie inwestować. Kolejka z szybkimi zamknięciami, ale wysoką powtarzalnością zwykle potrzebuje mocniejszych kontroli zapobiegawczych. Kolejka z niską powtarzalnością, lecz słabym SLA zwykle ma problem z własnością albo kierowaniem.
Jak triażować, priorytetyzować i przypisywać własność przy SLA
O 9:07 finanse zgłaszają, że wczorajszy pulpit przychodów spadł o 18 procent. Osoba odpowiadająca za pulpit widzi objaw, ale usterka siedzi trzy przeskoki wyżej, w spóźnionym ekstrakcie źródłowym, a reguła wykluczania transakcji testowych wciąż nie jest udokumentowana. Bez modelu triażu trzy zespoły zaczynają dochodzenie, nikt nie odpowiada za zegar, a biznes dostaje aktualizacje bez czasu przywrócenia.
To zadanie tego etapu. Ustal istotność szybko, wskaż bezpośrednio odpowiedzialną osobę i przypnij do sprawy cele reakcji i naprawy, żeby nie dryfowała we wspólnej kolejce.
Użyj istotności, by uczynić kompromisy jawnymi
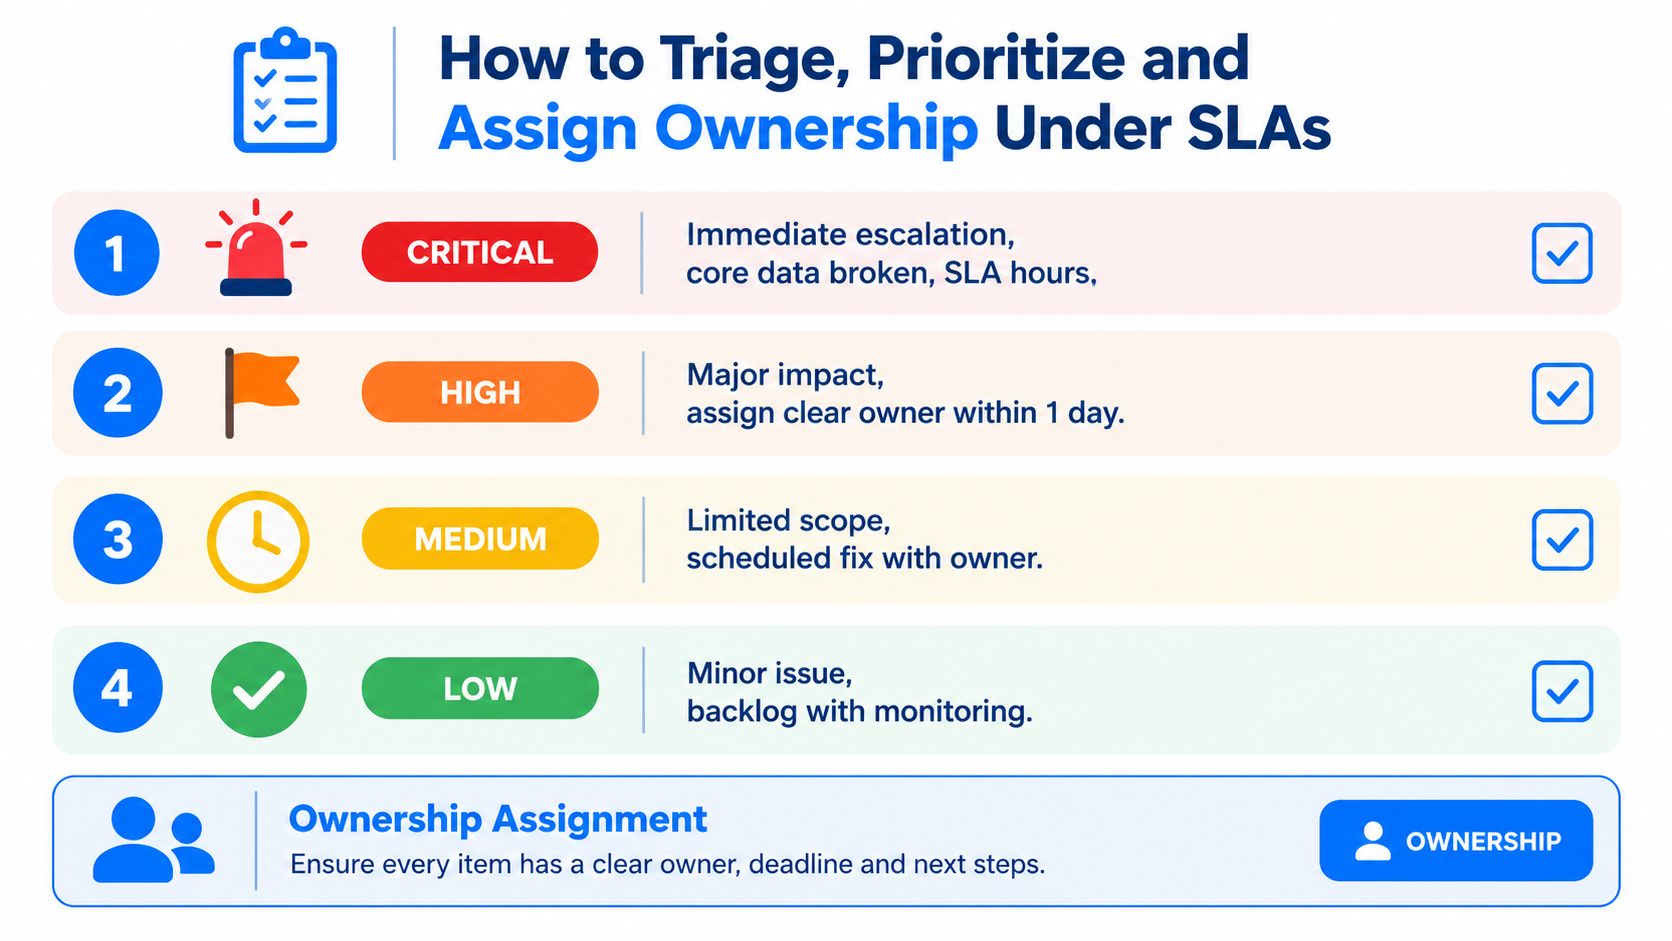
Istotność powinna odpowiadać na jedno pytanie: ile ryzyka biznesowego jesteśmy gotowi nieść, zanim to naprawimy?
Praktyczny model używa osobnych celów dla potwierdzenia, złagodzenia i ostatecznej naprawy. Zespoły często pracują z oknami reakcji liczonymi w godzinach przy wyższej istotności, złagodzeniem w dniach i pełną naprawą na dłuższym zegarze, gdy trwałe rozwiązanie wymaga zmian w kodzie, koordynacji z zespołem źródłowym albo ponownych ładowań. Dokładne cele liczą się mniej niż spójność. Jeśli „wysoki priorytet” dla jednego zespołu znaczy ten sam dzień, a dla drugiego następny sprint, SLA jest szumem.
Ustal istotność na podstawie trzech czynników:
Wpływ biznesowy: które decyzje, raporty, modele albo procesy klienckie są dotknięte?
Zasięg rażenia: jak daleko sprawa rozeszła się po tabelach i pulpitach niżej w łańcuchu?
Ryzyko kontrolne: czy dotyczy wyników regulowanych, raportowania zarządczego, rozliczeń albo metryk widocznych na zewnątrz?
Trzymaj model mały. Cztery poziomy zwykle wystarczą. Więcej rodzi dyskusje bez poprawy kierowania.
Przypisz własność domenie, która naprawia
Zespół, który pierwszy zauważy sprawę, rzadko jest właściwym właścicielem. Właściwy jest ten, który może zmienić zawodzącą kontrolę, ścieżkę kodu albo zachowanie źródła.
Użyj modelu kierowania takiego jak ten:
Poziom istotności | Typowy warunek | Właściciel główny | Ścieżka eskalacji |
|---|---|---|---|
Krytyczny | Kluczowy produkt danych zepsuty albo natychmiastowy wpływ biznesowy | Platforma danych albo osoba odpowiedzialna w inżynierii domeny | Kanał incydentów i powiadomienie kierownictwa |
Wysoki | Duży wpływ niżej w łańcuchu, ale ograniczony zasięg rażenia | Właściciel zbioru ze wsparciem inżynierii | Formalny przegląd incydentu, jeśli złagodzenie utknie |
Średni | Ograniczona sprawa z dostępnym obejściem | Inżynieria analityczna albo opiekun danych | Zaplanowana naprawa ze śledzeniem |
Niski | Usterka kosmetyczna, o niskim wpływie albo odosobniona | Właściciel backlogu | Obserwować trend i wrócić przy powtórce |
To usuwa częstą lukę własności. Zespoły platformowe odpowiadają za potoki i kontrole. Zespoły aplikacyjne odpowiadają za zachowanie systemu źródłowego. Właściciele biznesowi odpowiadają za intencję reguł i kryteria akceptacji. Wszystkie trzy mogą być zaangażowane, ale jedna osoba musi odpowiadać za zegar SLA, aktualizacje statusu i następny krok.
Jeśli intencja reguły nie ma właściciela, inżynierowie wymyślą go pod presją.
Priorytetyzuj z myślą o przepustowości
Kolejki incydentów zawodzą, gdy każdy czerwony alert traktuje się jako równie pilny. Przepustowość jest ograniczona. Niektóre usterki zasługują na natychmiastowe przerwanie pracy. Inne taniej jest ograniczyć, udokumentować i naprawić w pracy planowanej.
Badania nad praktyką jakości danych wskazały rozproszoną odpowiedzialność i niespójne zarządzanie jako powracające przyczyny słabych wyników w tym opracowaniu o problemach systemowych. Badania w ochronie zdrowia wskazały też niejasne plany działania, ograniczone zasoby i słabe szkolenia jako bariery w opublikowanej dyskusji ankietowej. Te ustalenia pokrywają się z tym, co widać w kolejkach produkcyjnych. Zespołom zwykle nie brakuje alertów. Brakuje im spójnego sposobu decydowania, co przerywa bieżącą pracę.
Użyj czterech pytań triażowych:
Co pęknie, jeśli to poczeka do jutra albo do przyszłego tygodnia?
Kto skonsumuje dotknięte dane jako następny i jaką decyzję na ich podstawie podejmie?
Czy możemy ograniczyć sprawę wycofaniem, kwarantanną, adnotacją albo tymczasowym filtrem?
Czy powtarzalność jest na tyle wysoka, że praca zapobiegawcza powinna wygrać z kolejną jednorazową poprawką?
To ostatnie pytanie ma znaczenie. Sprawa o średniej istotności, która wraca co tydzień, zwykle zasługuje na więcej uwagi niż pojedyncza, dobrze widoczna usterka, która raczej się nie powtórzy.
Prowadź kolejkę wobec mierzalnych SLA
Jedna ścieżka wejścia pomaga, ale higiena kolejki to tylko część modelu operacyjnego. Śledź, czy zespół dotrzymuje celów potwierdzenia, złagodzenia i naprawy według istotności. Śledź wskaźnik ponownych otwarć. Śledź wskaźnik spraw według zbioru, domeny i kategorii przyczyny źródłowej. Te metryki pokazują, czy problemem jest złe kierowanie, słabe kontrole, czy chroniczne niedoinwestowanie obszaru źródłowego.
Użyj tych liczb, by korygować priorytety. Kolejka z przyzwoitymi czasami naprawy, ale słabym potwierdzaniem zwykle ma problem z alertowaniem albo pokryciem dyżurów. Kolejka spełniająca SLA reakcji, lecz chybiająca ostatecznej naprawy, często ma tarcia własnościowe między zespołami. Zespoły, które chcą jaśniej ustalać i przeglądać te cele serwisowe, powinny definiować je obok praktyk pomiaru niezawodności, by wskaźnik spraw i realizację SLA przeglądać razem, a nie w osobnych pulpitach.
Jedna kolejka. Jedna decyzja o istotności. Jedna odpowiedzialna osoba na zegarze. To zamienia zarządzanie problemami jakości danych w model operacyjny zamiast reaktywnego triażu.
Osadzenie procesu w narzędziach, rolach i codziennej eksploatacji
Udokumentowany przepływ nie przetrwa zderzenia z produkcją, o ile nie jest osadzony w narzędziach, których ludzie już używają.
To znaczy, że twój proces jakości musi żyć tam, gdzie działają zadania hurtowni, gdzie analitycy weryfikują wyniki i gdzie nadzór widzi trend oraz historię incydentów. Jeśli przykręcisz osobne silo jakości z własnymi pulpitami, taksonomiami i listą użytkowników, własność zwykle rozpada się w ciągu kwartału.
Buduj wokół jednego widoku operacyjnego
Praktyczny wzorzec jest prosty. Uruchom wykrywanie anomalii, walidację, monitorowanie Timeliness i śledzenie schematu wobec tych samych krytycznych zbiorów. Kieruj te sygnały do wspólnego pulpitu. Połącz pulpit z kontekstem harmonogramu, metadanymi, pochodzeniem i systemem zgłoszeń, żeby reagujący przechodzili od alertu do działania bez ręcznego zszywania dowodów.
Kluczową decyzją projektową jest model wykonania. Kontrole w bazie zmniejszają ruch danych i ułatwiają przegląd bezpieczeństwa, zwłaszcza w środowiskach regulowanych. Trzymają też logikę monitorowania bliżej tabel i transformacji, które trzeba zweryfikować.
Role potrzebują wspólnego kontekstu, nie osobnych narzędzi
Różne role interesują różne sygnały awarii:
Inżynierowie danych chcą stanu potoków, świeżości, ponowień i pęknięć schematu.
Inżynierowie analityczni i deweloperzy BI patrzą na naruszenia reguł biznesowych, objawy dryfu modeli i zepsute wyniki semantyczne.
Odpowiedzialni za nadzór i jakość danych potrzebują progów, trendów, statusu akceptacji i dowodów gotowych na audyt.
Jeśli każda z tych grup pracuje z innego systemu, triaż zwalnia, bo każda sprawa zaczyna się od uzgadniania. Lepszy wzorzec to wspólna widoczność z widokami zależnymi od roli. Platforma może pokazać ten sam incydent przez logi techniczne dla inżynierii i przez podsumowania wpływu biznesowego dla właścicieli nietechnicznych.
Wdrożenie modułowe bije wdrożenia na raz
Większość organizacji nie musi wdrażać wszystkich możliwości monitorowania pierwszego dnia. Zwykle muszą zacząć od trybu awarii, który boli najbardziej, a potem dołożyć pokrycie wokół niego.
Tu liczą się decyzje narzędziowe. Niektóre zespoły zaczynają od monitorowania świeżości i schematu, bo te usterki najłatwiej wykryć i skierować. Inne startują od walidacji deterministycznej, bo zgodność albo finanse potrzebują jawnych dowodów kontroli. W środowiskach mieszanych pomaga opcja modułowa. Na przykład wzorce wdrażania jakości danych działają zwykle najlepiej, gdy stos może rosnąć z jednej monitorowanej domeny na kilka bez wymuszania nowego modelu operacyjnego.
Jedną z opcji w tej kategorii jest digna, która działa wewnątrz środowiska klienta i łączy wykrywanie anomalii, walidację, monitorowanie Timeliness, śledzenie schematu, wsparcie harmonogramu, funkcje katalogowe, integracje i wspólny pulpit. Taki układ przydaje się, gdy zespoły chcą wykonania w bazie i nie chcą wynosić danych produkcyjnych poza własną infrastrukturę.
To, co utrzymuje się operacyjnie, rzadko jest najbardziej wymyślnym detektorem. To układ, który trzyma proces widocznym, własność przypiętą i pasuje do środowiska, które zespoły już mają.
Zapobieganie powtórkom i dowodzenie, że proces działa
Kolejka, która zamyka zgłoszenia, ale wciąż otwiera te same wzorce awarii, nie jest dojrzała. Jest zajęta.
Dowód, że twój proces działa, jest prosty. Wykrywanie przyspiesza. Naprawa robi się czystsza. Powtarzalne usterki maleją. Interesariusze przestają spierać się, czy mogą ufać raportowi, bo historia incydentów, zapis napraw i progi akceptacji są widoczne.
Zapobieganie wymaga zmian po incydencie
Każdy istotny incydent powinien zostawić po sobie jedno trwałe usprawnienie. Może to być nowy próg, brakująca reguła walidacji, kontrakt schematu albo ściślejsze przekazanie własności. Jeśli zamknięcie zapisuje tylko, co pękło, system niczego się nie nauczył.
Najbardziej użyteczne przeglądy po incydencie skupiają się na rozpoznaniu przyczyn źródłowych z precyzją wystarczającą do zmiany kontroli, a nie tylko do opisania objawów. Jeśli twój zespół potrzebuje praktycznej referencji dla tej dyscypliny, ten zbiór o rozpoznawaniu przyczyn źródłowych warto trzymać w runbooku.
Właściwe pytanie po naprawie nie brzmi „kto to naprawił?”. Brzmi „co się zmieniło, żebyśmy nie spotkali tego problemu w przyszłym tygodniu?”.
Śledź metryki, które zmieniają zachowanie
Metryki warte trzymania przed oczami zespołów to te, które wpływają na jakość reakcji:
Czas wykrycia: jak długo usterka istniała, zanim zespół się dowiedział.
Czas naprawy: jak długo biznes był narażony.
Realizacja SLA: czy reakcja, złagodzenie i zamknięcie trafiły w cel.
Wskaźnik spraw powtarzalnych: czy ta sama kategoria przyczyny źródłowej wciąż wraca.
Ekspozycja biznesowa: które krytyczne raporty, procesy albo decyzje zostały dotknięte.
Nie potrzebujesz ogromnej karty wyników. Potrzebujesz stabilnej. Jeśli zespoły widzą, że jedna domena raz po raz chybia celów świeżości albo że pewna klasa zmian schematu często wraca, pracę zapobiegawczą łatwiej uzasadnić.
Krótki test dojrzałości
Użyj tego jako szorstkiego autotestu:
Definicja sprawy istnieje: zespoły zgadzają się, co liczy się jako sprawa, a co nie.
Progi są udokumentowane: metryki stają się wykonalne dopiero, gdy przekroczą przyjęte granice.
Istotność jest ustandaryzowana: priorytet nie zależy od tego, kto ma dyżur.
Własność jest jawna: każda sprawa ma odpowiedzialną osobę i ścieżkę eskalacji.
Zamknięcie obejmuje zapobieganie: poprawki aktualizują reguły, linie bazowe, kontrakty albo runbooki.
Dowody są zachowane: możesz pokazać, co się stało, kto reagował, co się zmieniło i czy SLA zostały dotrzymane.
Jeśli choć dwa z tych punktów są słabe, proces wciąż jest kruchy. To normalne. Zespoły nie potrzebują nowej filozofii. Potrzebują mniej niejednoznacznych przekazań i lepszej dyscypliny operacyjnej wokół usterek, które i tak znają.
Jeśli twój zespół próbuje zamienić rozproszone kontrole w prawdziwy model operacyjny, digna jest zbudowana do takiej pracy. Pomaga zespołom monitorować anomalie, Timeliness, walidację i zmiany schematu we własnym środowisku, żeby wykrywanie, własność i zapobieganie działały jako jeden proces, a nie cztery rozłączne narzędzia.
Proces jest tak mierzalny, jak liczby, które za nim stoją — połącz ten przepływ z działającym zestawem metryk jakości danych, żeby zamknięcie coś znaczyło.
Najczęściej zadawane pytania
Dlaczego doraźne poprawki zawodzą?
Zawodzą na granicy własności. Ktoś łata model SQL, przepuszcza potok i ogłasza naprawę, ale nikt nie odpowiada za to, czy zaufanie wróciło ani czy ta sama usterka się powtórzy. Zarządzany proces da się zmierzyć; doraźny nie.
Co liczy się jako problem jakości danych?
Zdefiniuj sprawę przed przepływem. Nie każda nieudana kontrola jest sprawą i nie każda sprawa zaczyna się od nieudanej kontroli — niewyjaśniony ruch wskaźnika też się liczy. Wybierz mianownik pasujący do twojej dojrzałości i oczyść dane wejściowe, zanim zaufasz jakiemukolwiek wskaźnikowi z nich liczonemu.
Jak wygląda przepływ od początku do końca?
Wykrycie, potwierdzenie, dochodzenie, naprawa i zapobieganie. Wykrycie i potwierdzenie są rozdzielone celowo, bo alert to jeszcze nie incydent. Dochodzenie prowadzi usterkę do jej punktu kontrolnego, a naprawa jest niepełna, dopóki nie wróci zaufanie, a nie tylko dopóki dane się nie zmienią.
Jak triażować i przypisywać sprawy?
Użyj istotności, by uczynić kompromisy jawnymi, zamiast traktować każdą sprawę jako pilną. Przypisz własność domenie, która naprawia — zespołowi, który naprawdę może zmienić kontrolę — a nie temu, kto zauważył. Potem priorytetyzuj z myślą o przepustowości i prowadź kolejkę wobec mierzalnych SLA.
Jak powstrzymać powtarzanie się tych samych problemów?
Zapobieganie wymaga zmian w kontrolach po incydencie, a nie tylko zamkniętego zgłoszenia. Śledź metryki zmieniające zachowanie, takie jak wskaźnik powtórek i czas do przywrócenia zaufania, a nie surowe liczby spraw, które spadają, gdy tylko ludzie przestają zgłaszać.