Monitoring w zarządzaniu: praktyczny przewodnik
|
6
min. czyt.

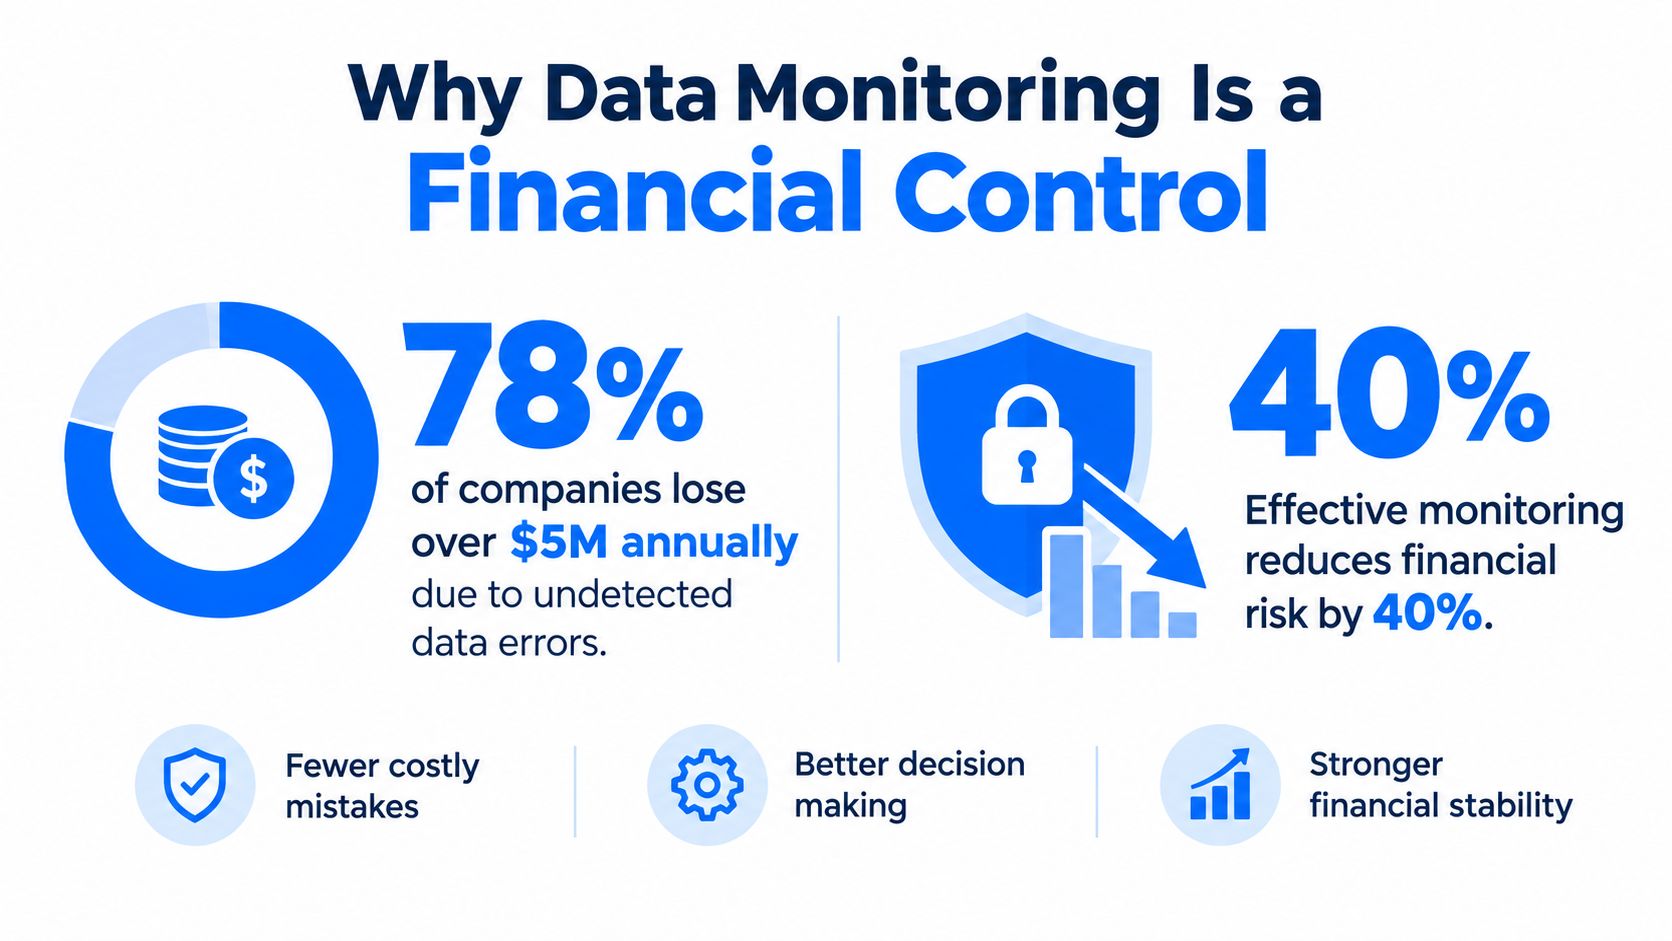
Ponad jedna czwarta organizacji szacuje roczne straty wynikające ze złej jakości danych na ponad 5 mln USD, a 7% zgłasza straty w wysokości co najmniej 25 mln USD. Monitoring w zarządzaniu ogranicza to ryzyko, łącząc sygnały z danych z odpowiedzialnymi właścicielami, wpływem na biznes i działaniami naprawczymi.
To rozróżnienie ma znaczenie, ponieważ dashboard może pokazać awarię, nie czyniąc nikogo odpowiedzialnym za jej usunięcie. Skuteczny monitoring to system kontroli zarządczej: zespoły definiują oczekiwane warunki, obserwują rzeczywiste zachowanie, porównują jedno z drugim i działają, gdy odchylenie ma znaczenie.
Spis treści
Dlaczego monitoring danych jest kontrolą finansową
Zła jakość danych to nie tylko techniczna niedogodność. Może zniekształcać prognozy, przerywać procesy operacyjne, podważać raportowanie regulacyjne i kierować zautomatyzowane decyzje w złą stronę. Analiza IBM dotycząca kosztów złej jakości danych wskazuje, że ponad jedna czwarta organizacji szacuje roczne straty na ponad 5 mln USD, a 7% zgłasza straty w wysokości co najmniej 25 mln USD.
Monitoring w zarządzaniu to coś więcej niż wyświetlanie bieżącej wartości. Oznacza zdefiniowanie oczekiwanego zakresu lub stanu, obserwowanie procesu danych lub procesu biznesowego, wykrycie istotnego odchylenia, przypisanie odpowiedzialności, zabezpieczenie dowodów i sprawdzenie, czy naprawa zadziałała. Dashboard wspiera ten proces, ale go nie zastępuje.
Widoczność na dashboardzie a kontrola zarządcza
Dashboard odpowiada na pytanie „Co się dzieje?”. Kontrola zarządcza odpowiada na szerszy zestaw pytań:
Oczekiwanie: Co powinno się dziać i jaki standard to określa?
Istotność: Jakie skutki biznesowe, finansowe, operacyjne lub regulacyjne pojawią się, jeśli warunki się zmienią?
Odpowiedzialność: Która osoba lub który zespół musi to zbadać?
Dowody: Jakie zapisy pokazują, kiedy zaczęło się odchylenie i co się zmieniło?
Reakcja: Jakie działanie jest wymagane i kiedy można zamknąć sprawę?
W banku opóźniony zbiór danych o ryzyku może wpłynąć na raportowanie lub procesy decyzyjne. Zespoły zajmujące się zarządzaniem danymi w bankach potrzebują czegoś więcej niż statusu pipeline'u. Potrzebują sygnałów dotyczących terminowości, walidacji, schematu i reguł biznesowych, powiązanych z procesami, które te dane wspierają.
Praktyczny kompromis jest prosty. Szeroki monitoring daje widoczność, ale zbieranie wszystkiego bez wyboru generuje szum i koszty. Skupienie się na tabelach istotnych finansowo, zbiorach regulacyjnych, danych klientów i pipeline'ach krytycznych dla decyzji daje mniejszy zestaw dowodów, z którego kierownictwo może realnie korzystać.
Ewolucja teorii kontroli zarządczej
Nowoczesna obserwowalność może wyglądać na zerwanie z tradycyjnym zarządzaniem, zwłaszcza gdy uczenie maszynowe wykrywa nietypowe zachowanie bez ręcznie napisanej reguły. Leżąca u podstaw logika jest jednak starsza i stabilniejsza niż technologia. Zespoły nadal porównują rzeczywiste warunki z oczekiwanymi i decydują, czy odchylenie wymaga działania.
Henri Fayol sformułował wczesną definicję kontroli zarządczej w 1916 roku, opisując kontrolę jako sprawdzanie, czy działania przebiegają zgodnie z przyjętym planem, wydanymi poleceniami i ustalonymi zasadami, co dokumentuje ten przegląd teorii kontroli zarządczej. Ta definicja uczyniła z kontroli powtarzalny obowiązek kierowniczy, a nie jednorazową inspekcję.
Wcześniejsze prace z zakresu naukowego zarządzania wzmacniały ten sam wzorzec. Frederick Taylor traktował kontrolę jako cel w eksperymentach prowadzonych w 1906 roku, a Copley opisał kontrolę jako centralną ideę naukowego zarządzania w 1923 roku. Późniejsze opracowania wymieniają pięć zasad zaproponowanych przez Urwicka w 1929 roku: odpowiedzialność, dowody, standaryzację, porównanie i użyteczność.
Cykl kontroli w platformie danych
Te zasady dobrze przekładają się na operacje na danych w przedsiębiorstwie:
Ustal standard. Zdefiniuj akceptowalną aktualność, poprawne rekordy, oczekiwany schemat, sposób dostarczania danych lub zmiany KPI.
Mierz wyniki. Zbieraj obserwacje z tabel, pipeline'ów, obciążeń i procesów biznesowych.
Porównuj rezultaty. Oceniaj bieżące zachowanie względem linii bazowej, reguły, celu lub wzorca historycznego.
Oceń znaczenie. Oddziel nieszkodliwe wahania od odchyleń, które mogą wpłynąć na decyzje.
Podejmij działania naprawcze. Przekaż ustalenie właścicielowi, udokumentuj reakcję i sprawdź, czy warunki wróciły do akceptowalnego stanu.
Wykrywanie anomalii oparte na AI zmienia sposób, w jaki zespoły ustalają linie bazowe i identyfikują odchylenia. Nie eliminuje cyklu kontroli. Automatyzuje część obserwacji i porównań, a ludzie nadal decydują, co oznacza sygnał i jaka reakcja jest akceptowalna.
Synteza naukowa z 2024 roku przeanalizowała badania nad kontrolą organizacyjną za pomocą analizy współcytowań 1148 artykułów opublikowanych w latach 1938-2022. Jej multidyscyplinarna metaanaliza objęła 293 artykuły, 310 niezależnych prób i łącznie 110 585 obserwacji, jak podaje wprowadzenie Cambridge do kontroli organizacyjnej. Ta tradycja badawcza wykracza dziś poza rachunkowość finansową i obejmuje wskaźniki niefinansowe, systemy informacyjne, zachowania organizacyjne oraz wyniki strategiczne.
Ta ewolucja wyjaśnia, dlaczego platforma taka jak digna może łączyć wykrywanie anomalii, śledzenie terminowości, walidację, monitoring schematów i obserwację KPI. To nie są oderwane od siebie funkcje, lecz nowoczesne wdrożenia od dawna ugruntowanej dyscypliny zarządczej.
Podstawowe rodzaje monitoringu
Monitoring zawodzi, gdy zespoły traktują każdy sygnał jak ten sam rodzaj problemu. Opóźnienie pipeline'u, nieoczekiwana zmiana przychodów i nieudana walidacja dotycząca prywatności mogą wywołać alerty, ale wymagają innych standardów, właścicieli, czasów reakcji i dowodów.

Monitoring operacyjny
Monitoring operacyjny sprawdza, czy środowisko danych działa zgodnie z założeniami. Obejmuje dostępność, zachowanie obciążeń, wydajność, przepustowość, aktualność danych, poprawność, jakość i pokrycie. Zakończony job nie musi oznaczać udanego joba. Wynik może być spóźniony, niekompletny, zmieniony strukturalnie lub nieprzydatny dla dalszych odbiorców.
Przydatne sygnały to między innymi:
Terminowość: Czy oczekiwana tabela lub partycja dotarła w uzgodnionym oknie czasowym?
Zachowanie schematu: Czy kolumny zostały dodane, usunięte lub zmienione w sposób, który wpływa na odbiorców?
Kondycja pipeline'u: Czy proces zakończył się błędem, był nietypowo często ponawiany lub wygenerował mniej rekordów niż oczekiwano?
Zachowanie platformy: Czy zużycie zasobów lub wydajność obciążeń wyszły poza normalny wzorzec?
Monitoring KPI
Monitoring KPI ocenia biznesowe znaczenie danych. Śledzi przychody, sprzedaż, transakcje, aktywność klientów, wolumeny operacyjne lub inne miary w odniesieniu do oczekiwań biznesowych. Kluczową decyzją projektową jest odróżnienie uzasadnionej zmiany biznesowej od defektu danych.
Alert KPI powinien więc nieść kontekst. Które tabele źródłowe zasilają wskaźnik? Czy wcześniej nastąpiła zmiana schematu? Czy zmieniły się liczby rekordów, rozkłady lub wyniki walidacji? Czy właściciel biznesowy może potwierdzić, że zmiana odzwierciedla rzeczywistość?
Monitoring oparty na ryzyku
Monitoring oparty na ryzyku określa, jak dokładnie należy obserwować każdą kontrolę. Wytyczne NIST dotyczące ciągłego monitoringu zalecają strategię, w której częstotliwość zależy od zmienności kontroli, tolerancji ryzyka systemu, zagrożeń i podatności, poziomu wpływu, znanych słabości oraz krytyczności monitorowanej funkcji. Zalecają też łączenie wskaźników wyprzedzających, takich jak zmiany schematu, ze wskaźnikami opóźnionymi, takimi jak nawracające incydenty.
Rodzaj monitoringu | Kluczowe pytanie | Typowa reakcja |
|---|---|---|
Operacyjny | Czy usługa danych działa poprawnie? | Zbadać dostarczanie danych, infrastrukturę lub stan pipeline'u |
KPI | Czy wyniki biznesowe zmieniają się zgodnie z oczekiwaniami? | Zweryfikować wskaźnik i zaangażować właściciela biznesowego |
Oparty na ryzyku | Ile uwagi wymaga ta kontrola? | Dostosować częstotliwość, progi, eskalację lub akceptację |
Program monitoringu potrzebuje wszystkich trzech. Obserwowalność jakości danych może ujawnić niespełnioną regułę dla rekordów, ale kierownictwo nadal musi określić konsekwencje, przypisać właściciela i udokumentować decyzję.
Luka odpowiedzialności we współczesnym monitoringu
Wiele organizacji inwestowało w dashboardy szybciej, niż budowało modele odpowiedzialności. Efekt jest dobrze znany: zespół widzi czerwony wskaźnik, zakłada, że zajmuje się tym inny zespół, a później okazuje się, że nikt nie zabezpieczył dowodów ani nie przetestował poprawki.
Badanie dotyczące ładu danych z 2025 roku wskazało stewardship i odpowiedzialność za dane jako najwyższe priorytety, a niezależne omówienia tego samego badania wykazały, że części organizacji wciąż brakuje programów obserwowalności modeli oraz podstawowych kompetencji w zakresie jakości danych lub zarządzania dostępem, co dokumentuje raport 2025 State of Enterprise Data Governance.
Ten wniosek ujawnia częsty rozdźwięk. Zespoły mogą traktować obserwowalność jako możliwość techniczną, podczas gdy osoby odpowiedzialne za ład danych zadają bardziej operacyjne pytanie: kto odpowiada za sygnał, jego interpretację i zamknięcie?
Każdy alert musi prowadzić do działania
Użyteczny wpis monitoringu powinien łączyć pięć elementów:
Wskazany właściciel: Zespół lub rola odpowiedzialna za zbadanie sprawy.
Wpływ na biznes: Zagrożona decyzja, proces, klient lub zobowiązanie.
Próg działania: Warunek, który zmienia ustalenie z obserwacji w eskalację.
Ślad dowodowy: Historia wskaźnika, błędne rekordy, zdarzenie w schemacie lub wynik walidacji potwierdzające ustalenie.
Test zamknięcia: Dowód potrzebny, by wykazać, że naprawa zadziałała.
Zasada praktyczna: alert bez właściciela to telemetria, a nie kontrola.
Dodawanie alertów może zwiększyć liczbę powiadomień bez poprawy niezawodności. Mniejszy zestaw wiarygodnych sygnałów, kierowanych zgodnie z rolami w ładzie danych, często daje lepsze wyniki zarządcze niż obszerny katalog technicznie ciekawych zdarzeń.
Kompromis dotyczy pokrycia i uwagi. Szerokie pokrycie pomaga odkrywać nieznane rodzaje awarii, ale każdy alert pochłania czas na analizę. Progi oparte na ryzyku, jasne ścieżki eskalacji i kontekst historyczny pozwalają liderom zachować uwagę dla odchyleń, które mogą zmienić decyzję biznesową.
Wdrażanie praktycznej strategii monitoringu
Zacznij od decyzji, których Twoja organizacja nie może sobie pozwolić podejmować na podstawie złych danych. Ta lista zwykle obejmuje raportowanie regulacyjne, kontrole finansowe, kwalifikowalność klientów, zdolności operacyjne oraz wyniki AI lub analityki wpływające na istotne wybory. Zmapuj zbiory danych i pipeline'y stojące za tymi decyzjami, zanim wybierzesz wskaźniki.
Wybierz wskaźniki ujawniające różne rodzaje awarii
Używaj wskaźników wyprzedzających, aby wykrywać problemy, zanim incydent stanie się widoczny dla użytkowników. Zmiany schematu, spóźnione partycje, odchylenia aktualności, zmiany odsetka wartości pustych, nietypowe zużycie zasobów i zmiany rozkładów mogą wcześnie sygnalizować pogorszenie.
Wskaźniki opóźnione pokazują, czy system kontroli działa po wystąpieniu problemu. Nawracające incydenty, nieudane uzgodnienia, korekty raportów i powtarzające się wyjątki kontrolne pokazują kierownictwu, gdzie naprawa lub projekt kontroli wciąż są słabe.
W przypadku terminowości zdefiniuj cel poziomu usług (SLO), zamiast mówić, że dane mają być dostępne „prawie w czasie rzeczywistym”. Wytyczne Google SRE dotyczące celów poziomu usług zauważają, że dane starsze niż cztery do pięciu minut mogą znacząco opóźnić reakcję na incydenty w systemach monitoringu. Właściwy próg zależy od procesu, ale zasada jest stała: mierz odsetek danych lub uruchomień pipeline'u spełniających uzgodniony warunek aktualności w określonym oknie czasowym.
Ustal częstotliwość według ryzyka
Nie sprawdzaj każdej tabeli w tym samym rytmie. Zbiór danych istotny finansowo, tabela związana z tożsamością lub feed regulacyjny zasługują na ściślejszą obserwację niż mało istotna tabela eksploracyjna. Dostosuj częstotliwość, gdy zmieniają się zmienność, ekspozycja, znane słabości lub krytyczność biznesowa.
Unikaj też średnich, które ukrywają ogon rozkładu zachowania operacyjnego. Materiały Google SRE wskazują pomiary percentylowe, takie jak 50., 95. i 99. percentyl, jako przydatne, ponieważ średnie mogą maskować niewielką, ale istotną grupę wolnych żądań. To samo rozumowanie dotyczy opóźnień pipeline'ów i wydajności obciążeń.
Zdefiniuj ścieżkę reakcji, zanim włączysz alerty
Dla każdego wskaźnika zapisz linię bazową, właściciela, próg, ścieżkę eskalacji, miejsce przechowywania dowodów i test przywrócenia. Monitoring powinien mierzyć nie tylko czas od odchylenia do wykrycia, ale także czas do potwierdzenia i do przywrócenia.
Platforma taka jak digna może wspierać ten model operacyjny, monitorując zachowanie danych, walidując rekordy, śledząc terminowość, wykrywając zmiany schematu oraz obserwując wskaźniki biznesowe i platformowe w środowisku klienta. Zespoły powinny jednak zweryfikować wdrożenie, odpowiedzialność i progi pod kątem własnej architektury i polityki ryzyka. Funkcja monitoringu i raportowania należy do tego szerszego procesu zarządczego, a nie funkcjonuje obok niego.
Praktyczne zastosowania w branżach regulowanych
Zespół w sektorze finansowym może monitorować tabelę ryzyka pod kątem nieoczekiwanych zmian schematu przed cyklem raportowym. Usunięta kolumna lub zmieniony typ danych mogą bez ostrzeżenia zepsuć dalszą logikę, więc użyteczna kontrola to nie tylko alert o nieudanym jobie. Łączy ona monitoring strukturalny, wiedzę o zależnościach, wyniki walidacji i odpowiedzialnego właściciela, który oceni, czy dany raport pozostaje wiarygodny.
Zespoły w ochronie zdrowia mierzą się z inną wersją tego samego problemu. Rekord pacjenta może dotrzeć na czas i przejść kontrole techniczne, a mimo to naruszać regułę biznesową lub prawną. Walidacja na poziomie rekordów pozwala zidentyfikować błędny rekord, zachować ocenianą regułę, przekazać sprawę do weryfikacji i przechować dowód jej rozwiązania.
Artykuł 5 unijnego ogólnego rozporządzenia o ochronie danych (RODO) wymaga, aby dane osobowe były prawidłowe i w razie potrzeby uaktualniane. Wymaga też odpowiedniego bezpieczeństwa, w tym ochrony przed niedozwolonym lub niezgodnym z prawem przetwarzaniem oraz przypadkową utratą, zniszczeniem lub uszkodzeniem. Ciągły monitoring pomaga przełożyć te obowiązki na dowody operacyjne zamiast polegać na okresowych ręcznych przeglądach.
Kontrole w poszczególnych branżach
Usługi finansowe: Waliduj dane transakcyjne i regulacyjne, monitoruj terminowość dostaw danych, wykrywaj zmiany strukturalne i łącz wyjątki z właścicielami raportowania i ryzyka.
Ochrona zdrowia: Sprawdzaj rekordy kliniczne i operacyjne pod kątem reguł biznesowych, identyfikuj niedokładne lub niespójne wartości i zachowuj dowody weryfikacji.
Telekomunikacja: Obserwuj duże wolumeny danych klientów i sieci, odróżniaj rzeczywiste zmiany w użyciu od defektów pipeline'ów i eskaluj awarie, zanim zniekształcą raportowanie operacyjne.
Sektor publiczny: Utrzymuj identyfikowalne dowody dla krytycznych zbiorów danych, w tym ocenianą regułę, objęte rekordy, podjętą decyzję i działanie naprawcze.
Organizacje ze złożonymi kontrolami finansowymi mogą też sięgnąć po materiały o automatycznym egzekwowaniu polityk w FinTech, gdy muszą połączyć wymagania polityk z powtarzalnymi kontrolami operacyjnymi. Kluczowa zasada projektowa pozostaje ta sama: monitoring powinien dostarczać dowodów, które odpowiedzialny zespół potrafi zinterpretować i wykorzystać do działania.
W organizacjach ochrony zdrowia zgodność danych medycznych z przepisami wymaga tej samej dyscypliny w zakresie jakości, terminowości, walidacji i zmian strukturalnych. Zgodności nie potwierdza sam wynik punktowy. Zależy ona od tego, czy zespoły potrafią pokazać, co sprawdziły, co zawiodło, kto zareagował i czy wynik został poprawiony.
Przyszłość ładu opartego na dowodach
Kolejnym etapem monitoringu nie jest większa ściana wykresów. To ściślejszy związek między obserwacją, osądem kierownictwa i dowodami. AI może uczyć się specyficznego zachowania zbiorów danych, korelować sygnały, priorytetyzować anomalie i ograniczać ręczne utrzymanie reguł. Nie może jednak zdecydować, czy wyjątek biznesowy jest akceptowalny, bez zdefiniowanej polityki i odpowiedzialnego decydenta.
Najtrwalsza pętla operacyjna składa się z czterech części:
Obserwuj rzeczywiste warunki w danych, platformach, wskaźnikach biznesowych i kontrolach.
Porównuj warunki z oczekiwaniami za pomocą reguł, linii bazowych, celów usług lub progów ryzyka.
Przypisz i wykonaj działania naprawcze z udokumentowanym właścicielem i ścieżką eskalacji.
Zweryfikuj wynik kolejnymi pomiarami i zachowanymi dowodami.
Takie podejście pomaga też oddzielić problemy z danymi od problemów z modelami. Nieoczekiwany wynik modelu może wynikać ze zmienionego schematu na wcześniejszym etapie, spóźnionych danych, przesuniętego rozkładu, niespełnionej reguły walidacji lub uzasadnionego zdarzenia biznesowego. Podążanie za łańcuchem przyczynowym chroni przed traktowaniem monitoringu modeli jako odosobnionego rozwiązania każdego problemu z niezawodnością AI.
Monitoring ma wartość zarządczą wtedy, gdy dowody zmieniają decyzję.
Praktyczna zmiana polega na przejściu od biernej widoczności do ładu opartego na dowodach. Inżynierowie danych odpowiadają już nie tylko za dostępność pipeline'ów, ale też za integralność, terminowość i identyfikowalność informacji, z których korzystają analitycy, kadra zarządzająca, regulatorzy i systemy AI. Właściciele biznesowi zyskują jaśniejszą rolę, bo to oni definiują istotność i akceptowalne wyniki. Zespoły ładu danych otrzymują dowody powstające w ramach normalnej działalności, zamiast odtwarzać je pod presją.
Na tym polega użyteczne znaczenie monitoringu w zarządzaniu. Zespoły nie monitorują po to, by gromadzić więcej telemetrii. Monitorują, by wcześnie wykrywać istotne zmiany, jasno określać odpowiedzialność i chronić decyzje przed niewiarygodnymi danymi.
digna to korporacyjna platforma jakości i obserwowalności danych działająca we własnym środowisku klienta, z modułami do wykrywania anomalii, terminowości, walidacji na poziomie rekordów, śledzenia schematów oraz monitoringu biznesowego i platformowego. Odwiedź digna, aby zobaczyć, jak Twój zespół może połączyć sygnały monitoringu z odpowiedzialną naprawą i wiarygodnymi dowodami.
Jeśli największa luka odpowiedzialności dotyczy u Ciebie monitoringu KPI, zobacz, jak monitoring biznesowy w digna odróżnia rzeczywiste zmiany przychodów, transakcji i wolumenów od defektów danych w zasilających je tabelach.
Najczęściej zadawane pytania
Co oznacza monitoring w zarządzaniu?
Monitoring w zarządzaniu to proces kontroli, a nie tylko dashboard. Zespoły definiują oczekiwany zakres, obserwują proces danych lub proces biznesowy, wykrywają istotne odchylenia, przypisują właściciela, zabezpieczają dowody i sprawdzają, czy naprawa zadziałała. Dashboard wspiera ten cykl, ale go nie zastępuje.
Czym dashboard różni się od kontroli zarządczej?
Dashboard pokazuje tylko to, co dzieje się w tej chwili. Kontrola zarządcza obejmuje też oczekiwanie, istotność, odpowiedzialność, dowody i reakcję: jaki standard obowiązuje, jakie są skutki biznesowe, kto musi to zbadać, jakie zapisy pokazują zmianę i kiedy można zamknąć sprawę.
Jakie są główne rodzaje monitoringu w zarządzaniu?
Artykuł wyróżnia trzy rodzaje. Monitoring operacyjny sprawdza aktualność danych, schemat, kondycję pipeline'ów i zachowanie platformy. Monitoring KPI śledzi przychody, transakcje lub wolumeny względem oczekiwań biznesowych. Monitoring oparty na ryzyku określa, jak często i jak dokładnie obserwować każdą kontrolę, zależnie od wpływu i zmienności.
Dlaczego każdy alert monitoringu potrzebuje właściciela?
Bez wskazanego właściciela alert jest telemetrią, a nie kontrolą. Zespół widzi czerwony wskaźnik, zakłada, że zajmuje się tym ktoś inny, a później okazuje się, że nikt nie zabezpieczył dowodów ani nie przetestował poprawki. Dobry alert łączy właściciela, wpływ na biznes, próg działania, ślad dowodowy i test zamknięcia.
Jak często należy monitorować dane?
Częstotliwość monitoringu powinna wynikać z ryzyka, a nie z jednego rytmu dla wszystkich tabel. Dane istotne finansowo, tabele tożsamości i feedy regulacyjne wymagają ściślejszej obserwacji niż tabele eksploracyjne. NIST zaleca dostosowanie częstotliwości do zmienności kontroli, poziomu wpływu, znanych słabości i krytyczności monitorowanej funkcji.



