Algorytmy dopasowania rozmytego: praktyczny przewodnik
|
7
min. czyt.

Przy poziomie ufności 0,95 lub wyższym zespołowe podejście z udziałem człowieka (human-in-the-loop) osiągnęło precyzję 88,0%, a podobieństwo Jaccarda 85,0% w tym samym zakresie wysokich wyników. Praktyczna odpowiedź brzmi: nie ma algorytmu dopasowania rozmytego, który byłby najlepszy w każdej sytuacji, ponieważ niezawodne rozpoznawanie tożsamości zależy od normalizacji, generowania kandydatów, dowodów z poszczególnych pól, progów i weryfikacji.
Prawdopodobnie już się z tym mierzysz. Klient występuje pod nieco innymi nazwami w systemach rozliczeniowych, wsparcia i produktowych. Adres dostawcy zmienia format w zależności od spółki zależnej. Rekord pacjenta w jednym systemie zapisany jest w jednym alfabecie, a w innym w wersji transliterowanej. Dokładne złączenia pomijają uzasadnione powiązania, a zbyt liberalna reguła rozmyta może połączyć osoby, które są do siebie tylko podobne.
Trudność nie polega na wyliczeniu wyniku podobieństwa. Polega na tym, by zdecydować, co ten wynik oznacza, udowodnić, dlaczego dopasowanie zostało zatwierdzone, i wykryć moment, w którym proces dopasowywania zaczyna bez ostrzeżenia zawodzić.
Spis treści
Podstawy: od odległości edycyjnej do łączenia probabilistycznego
Porównanie głównych rodzin algorytmów i kompromisów wydajnościowych
Ukryty koszt nieprecyzyjnego dopasowywania danych
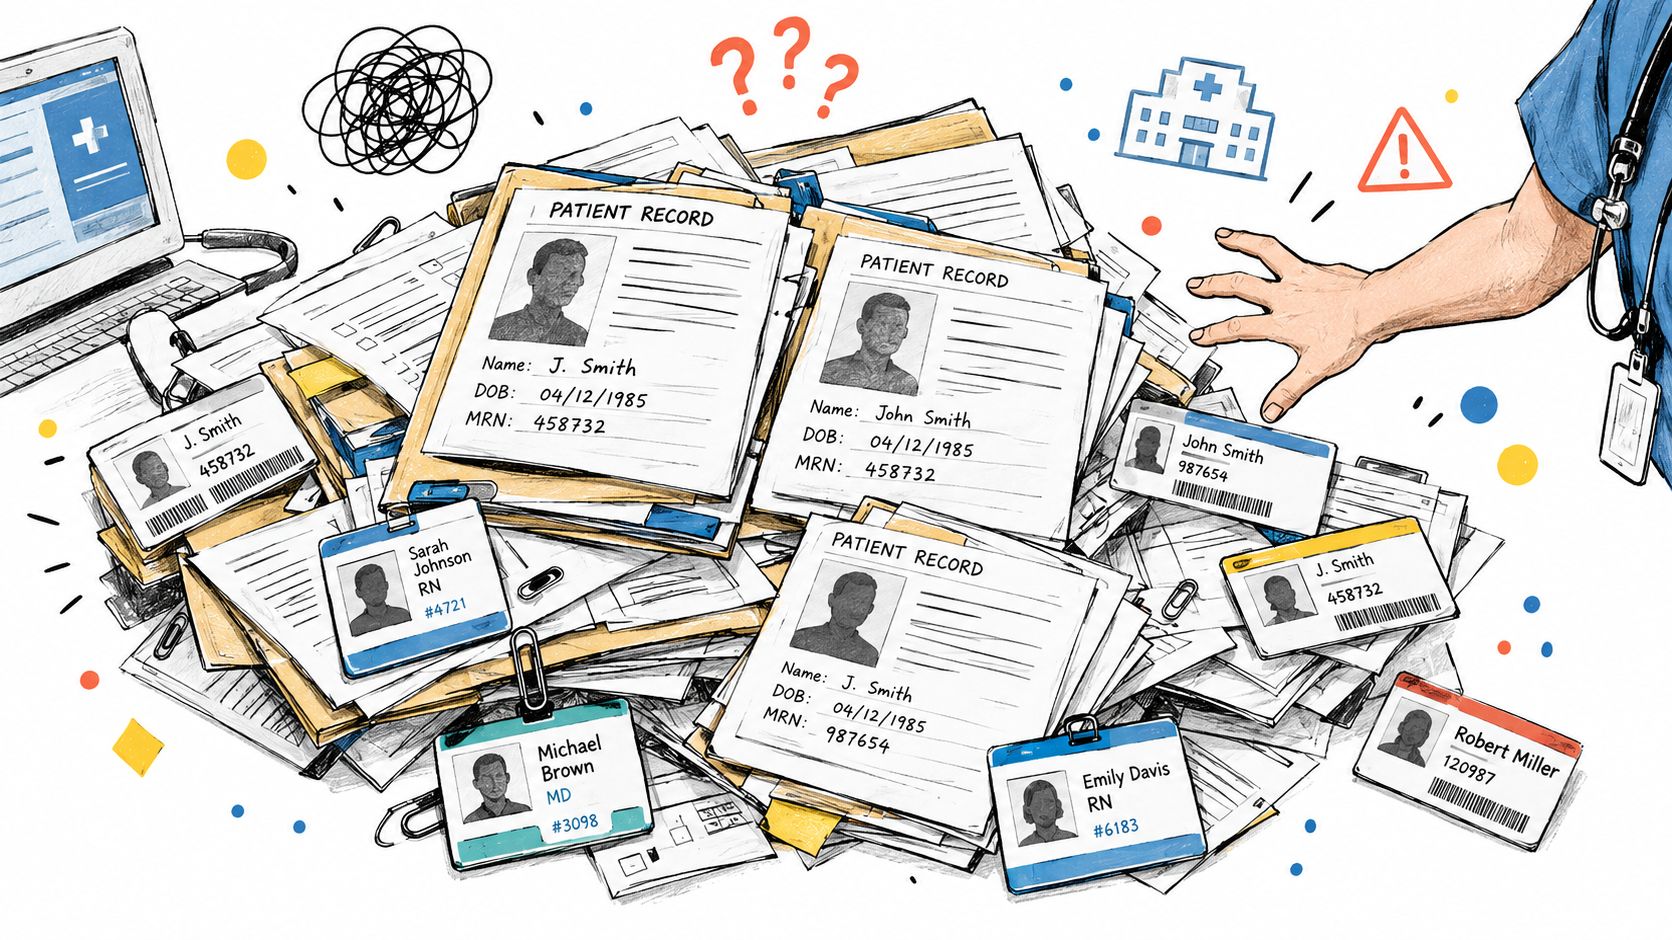
Globalny dostawca usług medycznych może budować widok pacjenta z systemów rejestracji, laboratorium, rozliczeń i systemów klinicznych. Jedno źródło zapisuje „Muller”, drugie „Miller”, a trzecie zawiera drugie imię lub inny format adresu. Złączenie oparte na równości traktuje je jako osobne rekordy, nawet jeśli pracownicy od razu dostrzegają prawdopodobny związek.
Odwrotny błąd jest groźniejszy. Dwoje pacjentów może mieć to samo nazwisko, adres lub podobne imię, a mimo to nie być tą samą osobą. Błędne scalenie może przypisać wyniki badań laboratoryjnych lub historię leczenia do niewłaściwego profilu. Nierozwiązany duplikat może rozproszyć informacje o opiece, generować powtarzalną pracę administracyjną i osłabiać raportowanie.
Dlaczego dokładne złączenia zawodzą
Dokładne dopasowanie zakłada, że wartości zostały wprowadzone spójnie i przesłane bez istotnych zmian. Dane w przedsiębiorstwach rzadko spełniają to założenie. Nazwiska mają różne warianty pisowni, adresy zawierają skróty i przestawione elementy, a identyfikatory bywają niekompletne lub skopiowane z szumem formatowania.
Algorytmy dopasowania rozmytego pomagają, mierząc podobieństwo zamiast wymagać zgodności znak po znaku. Podobieństwo jest jednak tylko przesłanką. Wynik dla nazwiska może wskazać parę kandydatów, ale nie potwierdzi tożsamości bez kontekstu z innych pól i bez uwzględnienia biznesowych skutków pomyłki.
Zasada produkcyjna: traktuj dopasowanie rozmyte jako proces decyzyjny, a nie sprytniejszą wersję złączenia opartego na równości.
To rozróżnienie ma znaczenie w finansach, ochronie zdrowia, usługach publicznych i obsłudze klienta. Fałszywe dopasowanie łączy niepowiązane rekordy. Fałszywy brak dopasowania pozostawia tę samą encję rozbitą na części. Koszt każdego błędu zależy od dziedziny, pola i tego, co systemy niższego rzędu robią z otrzymaną tożsamością.
Zespoły powinny więc łączyć projekt dopasowywania z szerszym podejmowaniem decyzji opartym na jakości danych. Właściwe pytanie nie brzmi „Które ciągi znaków wyglądają podobnie?”, lecz „Jakie dowody wspierają to powiązanie tożsamości, jakie ryzyko niesie błędne scalenie i czy ktoś inny będzie mógł później skontrolować tę decyzję?”.
Podstawy: od odległości edycyjnej do łączenia probabilistycznego
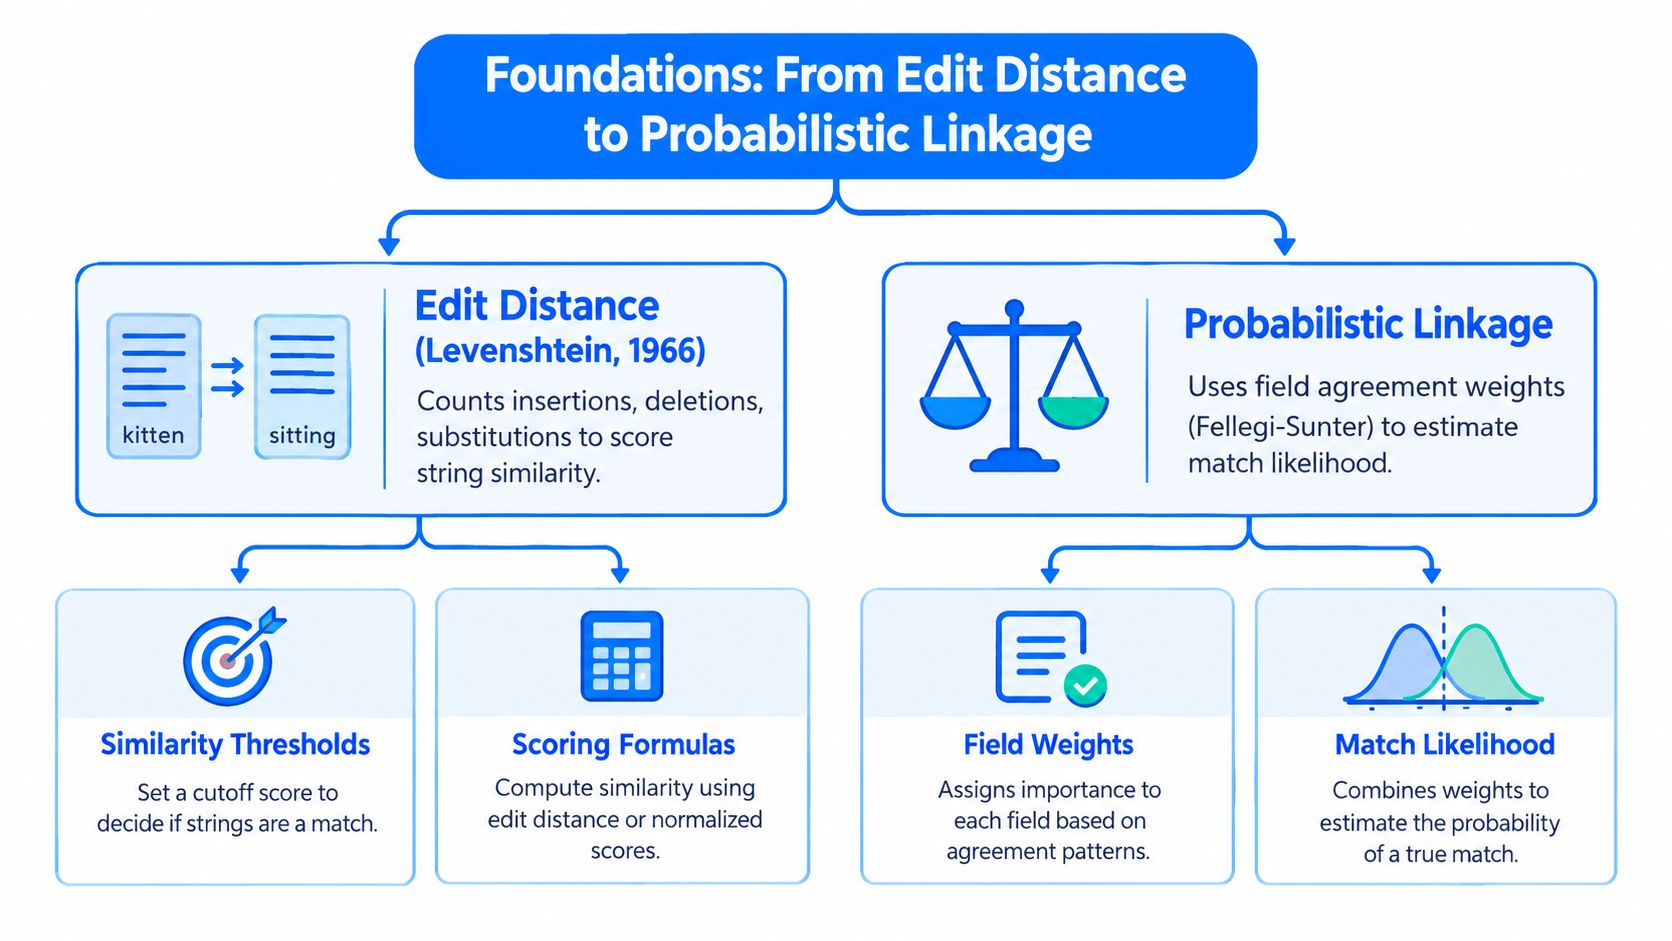
Dopasowanie rozmyte wyewoluowało od metod odległości edycyjnej do formalnego probabilistycznego łączenia rekordów. W 1966 roku Vladimir Levenshtein wprowadził odległość nazywaną dziś jego imieniem, czyli minimalną liczbę wstawień, usunięć lub zamian pojedynczych znaków potrzebnych do przekształcenia jednego ciągu w drugi, co opisuje fundamentalna literatura o łączeniu rekordów opublikowana przez Fellegiego i Suntera.
Literówka w jednym znaku ma odległość 1. Ciągi wymagające większej liczby edycji otrzymują większe odległości. Ponieważ operacja nie zależy od języka, okazała się przydatna w sprawdzaniu pisowni, deduplikacji, normalizacji adresów i rozpoznawaniu encji.
Odległość mierzy różnicę
Odległość Levenshteina odpowiada na wąskie, ale cenne pytanie: ile tekstu trzeba zmienić, aby uzyskać drugą wartość? Nie wie, czy wartości należą do tej samej osoby, firmy, konta czy adresu.
Dzięki temu jest użyteczną warstwą porównawczą. Wychwyci literówkę w nazwisku albo drobną zmianę w identyfikatorze, ale nie powinna samodzielnie przesądzać o nieodwracalnym scaleniu. Ta sama odległość może znaczyć coś innego dla krótkiego imienia, długiego adresu czy identyfikatora wysokiego ryzyka.
Łączenie podejmuje decyzję
W 1969 roku Ivan Fellegi i Alan Sunter opublikowali pracę „A Theory for Record Linkage”. Ich model traktował dopasowywanie jako problem decyzji statystycznej, a nie pojedynczy próg podobieństwa. Łączy dowody z pól takich jak nazwiska, adresy, daty urodzenia i identyfikatory, a następnie klasyfikuje pary kandydatów jako dopasowania, brak dopasowania lub przypadki niepewne do weryfikacji.
Model wyraźnie oddziela fałszywe dopasowania od fałszywych braków dopasowania i ustala progi w oparciu o pożądane górne granice tych typów błędów. To rozdzielenie pozostaje kluczowe w dopasowywaniu w przedsiębiorstwach, ponieważ automatyzacja i ręczna weryfikacja wiążą się z mierzalnym kompromisem.
Warstwa | Główne pytanie | Typowy wynik |
|---|---|---|
Odległość edycyjna | Jak bardzo różnią się te wartości? | Odległość lub podobieństwo |
Porównanie pól | Które atrybuty się zgadzają? | Dowody dla każdego pola |
Łączenie probabilistyczne | Jak interpretować dowody? | Dopasowanie, brak dopasowania lub weryfikacja |
Ład danych | Czy decyzję da się później obronić? | Wersjonowane dowody i ślad audytowy |
Praktyczny wniosek jest prosty: używaj odległości do pomiaru różnic w tekście, a decyzję o tożsamości podejmuj na podstawie dowodów z wielu pól i kontrolowanych progów. To pomost między statystycznym rozpoznawaniem wzorców a produkcyjną pracą z danymi.
Porównanie głównych rodzin algorytmów i kompromisów wydajnościowych
W środowisku produkcyjnym rzadko istnieje jeden najlepszy algorytm. Właściwy wybór zależy od pola, typowych w nim błędów, liczby kandydatów i kosztu błędnej decyzji. Badanie porównawcze oceniło siedem podejść, czyli podobieństwo Jaccarda, Jaro-Winklera, najdłuższy wspólny podciąg, odległość Levenshteina, podobieństwo cosinusowe, dopasowanie n-gramowe i Damerau-Levenshteina, pod kątem precyzji, czułości (recall), miary F, dokładności i wydajności obliczeniowej w opublikowanym porównaniu.
Eksperyment wykazał, że dopasowanie n-gramowe zapewniło najlepszą precyzję, miarę F i dokładność, a podobieństwo cosinusowe było najszybsze. N-gramy i Damerau-Levenshtein okazały się w tym porównaniu najwolniejsze. Te wyniki są dowodem z benchmarku, a nie regułą wdrożeniową. Pokazują praktyczny kompromis: zachowanie większej ilości lokalnych szczegółów znakowych może poprawić jakość dopasowania, ale zwiększa też koszt przetwarzania.
Dobierz rodzinę algorytmów do danych
Levenshtein sprawdza się przy krótkich ciągach dotkniętych błędami wstawienia, usunięcia lub zamiany. Damerau-Levenshtein uwzględnia dodatkowo przestawienia sąsiednich znaków, dlatego przydaje się, gdy często zdarzają się literówki polegające na zamianie znaków miejscami.
Jaro-Winkler często dobrze działa dla nazwisk i krótkich identyfikatorów, ponieważ zgodne prefiksy mogą nieść użyteczny sygnał. Jaccard mierzy nakładanie się tokenów, co pasuje do nazw firm i elementów adresu, gdy kolejność słów ma mniejsze znaczenie. Podobieństwo cosinusowe przedstawia tekst jako wektory i potrafi wydajnie przetwarzać dłuższe pola.
Rodzina algorytmów | Mocne strony | Najlepsze zastosowanie | Koszt obliczeniowy |
|---|---|---|---|
Levenshtein | Przejrzyste porównanie oparte na edycjach | Literówki i krótkie identyfikatory | Umiarkowany |
Damerau-Levenshtein | Obsługuje przestawienia sąsiednich znaków | Błędy pisowni w nazwiskach i kodach | Wysoki |
Jaro-Winkler | Premiuje zgodne prefiksy | Imiona i nazwiska oraz krótkie pola | Umiarkowany |
Jaccard | Mierzy nakładanie się zbiorów tokenów | Adresy i nazwy firm | Umiarkowany |
Podobieństwo cosinusowe | Szybkie porównanie wektorowe | Dłuższe pola tekstowe | Niski w cytowanym porównaniu |
Dopasowanie n-gramowe | Wychwytuje lokalną strukturę znaków | Zaszumiony tekst i częściowe nakładanie się | Wysoki w cytowanym porównaniu |
Najdłuższy wspólny podciąg | Zachowuje wspólną strukturę sekwencji | Uporządkowane różnice tekstowe | Zależny od danych |
Dlaczego punktacja hybrydowa zwykle wygrywa
Rekordy łączą pola o różnych sposobach zawodzenia. Nazwisko może wymagać podobieństwa znakowego, adres może zyskać na porównaniu tokenów, a identyfikator może wymagać deterministycznej walidacji. Stosowanie jednej miary wszędzie powoduje błędy, których można uniknąć, i marnuje moc obliczeniową na pola wymagające innego podejścia.
Przypisz algorytmy do poszczególnych pól, a następnie łącz ich dowody według reguł powiązanych z ryzykiem tożsamości. Kosztowne porównania uruchamiaj dopiero wtedy, gdy blokowanie zawęzi zbiór kandydatów. Wyniki benchmarków mogą ukierunkować początkowy projekt, ale to oznaczone pary z Twoich własnych danych powinny przesądzić, czy dodatkowe obliczenia poprawiają decyzje na tyle, by uzasadnić koszt operacyjny. Zapisuj wybrane algorytmy, ich wersje, progi i wyniki weryfikacji w śladzie audytowym, aby późniejsze zmiany dało się wyjaśnić.
Dlaczego wyniki podobieństwa nie są prawdopodobieństwami
Produkcyjny system dopasowujący może przypisać dwóm rekordom klientów wynik podobieństwa 0,87, a mimo to nie dać żadnej bezpośredniej odpowiedzi co do tożsamości. Wynik mierzy podobieństwo według wybranej miary. Nie określa prawdopodobieństwa, że rekordy należą do tej samej encji, nie wskazuje, które pola dały taki rezultat, ani nie wycenia kosztu błędnego scalenia.
Progi obnażają lukę między pomiarem a decyzją. Przy wyniku 0,95 lub wyższym zespołowe podejście z udziałem człowieka osiągnęło precyzję 88,0%, wobec 85,0% dla podobieństwa Jaccarda w tym zakresie wysokich wyników. Precyzja Jaccarda spadła do 53,0% dla wyników między 0,90 a 0,95, jak podaje opublikowane badanie dopasowania rozmytego. Jak pokazał benchmark, wysoki wynik wciąż może dawać niebezpieczne dopasowania.
Próg należy do populacji
Próg dostrojony do nazw klientów może być ryzykowny dla adresów dostawców. Transliteracja może zmieniać zachowanie wyników w różnych krajach, a błędne scalenie tożsamości pacjentów ma inne konsekwencje niż w przypadku kontaktów marketingowych.
Dostrajaj progi na oznaczonych parach z populacji, którą system będzie przetwarzał. Mierz precyzję i czułość przy progach stosowanych w praktyce, a następnie rozbijaj wyniki według pola, typu encji, regionu, języka i systemu źródłowego. Wynik zagregowany może ukryć poważną awarię dotyczącą jednego języka lub jednego źródła.
Świadomie stosuj wstrzymanie decyzji
Produkcyjny system dopasowujący potrzebuje kontrolowanej ścieżki dla niepewności. Wyznacz pasmo wstrzymania, które kieruje niejednoznaczne pary do uprawnionego weryfikatora, zamiast wymuszać automatyczną decyzję.
Automatyczne powiązanie: wymagaj dowodów, które przeszły obowiązujące kontrole ryzyka.
Weryfikacja: pokazuj wartości kandydatów, dowody dla każdego pola, próg i wersję reguły.
Odrzucenie: zachowaj rekordy osobno, gdy dostępne dowody nie uzasadniają powiązania.
Decyzje weryfikatorów powinny stawać się danymi z zakresu ładu danych, a nie znikać w kolejce. Przechowuj wartości kandydatów i wartości znormalizowane, wyniki dla pól, próg decyzyjny, wersję algorytmu, wynik weryfikacji i znacznik czasu. Taki ślad audytowy wspiera dochodzenia, zmiany progów i powtarzalność decyzji.
Wysoki wynik to pomiar. Zatwierdzone powiązanie tożsamości to kontrolowana decyzja.
Tu koszty wyników fałszywie dodatnich i fałszywie ujemnych stają się namacalne operacyjnie. W dziedzinie wysokiego ryzyka pozostawienie potencjalnego duplikatu bez rozstrzygnięcia może być bezpieczniejsze niż błędne scalenie. Gdzie indziej szerokie generowanie kandydatów połączone z weryfikacją przez człowieka może zapewnić lepszą kontrolę. Właściwa polityka zależy od encji, dowodów i skutków błędu.
Dopasowywanie wielojęzyczne i wąskie gardło blokowania
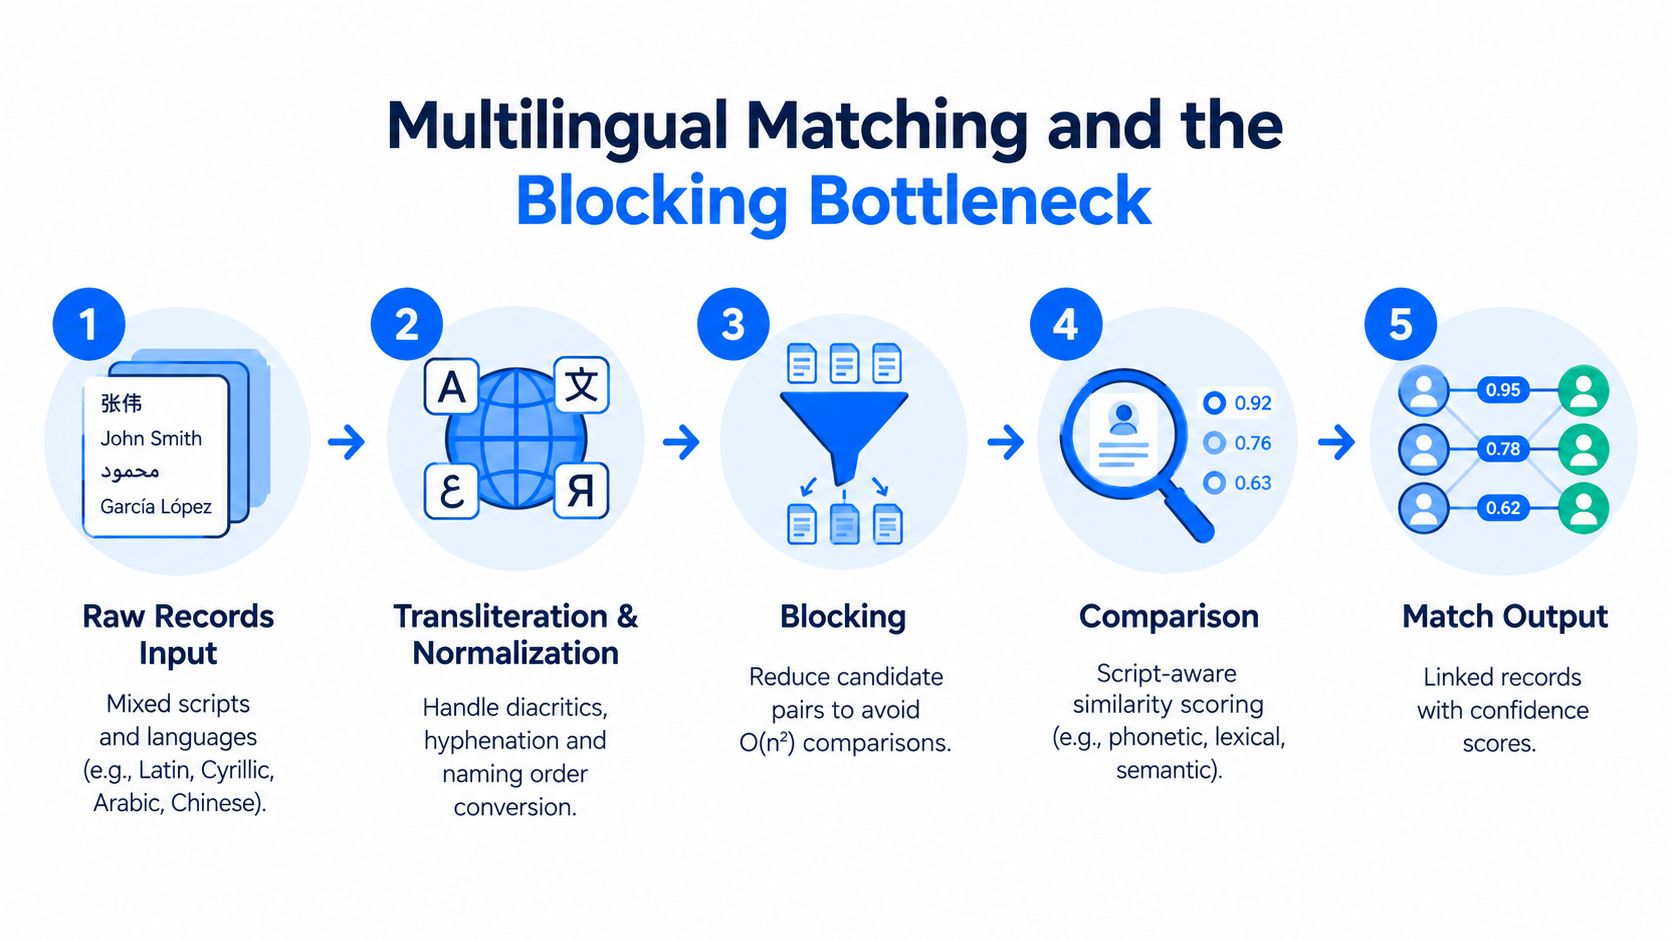
Literówki w stylu angielskim to łatwa demonstracja. Dane produkcyjne wnoszą transliterację, wiele alfabetów, zmiany kolejności imion i nazwisk, znaki diakrytyczne, łączniki i identyfikatory specyficzne dla poszczególnych krajów. Te różnice wpływają zarówno na czułość, jak i na ryzyko wyników fałszywie dodatnich, zanim algorytm punktujący w ogóle oceni parę.
Generowanie kandydatów to ukryte wąskie gardło. Jeśli strategia blokowania umieści dwa rzeczywiście powiązane rekordy w różnych koszykach, żaden dalszy algorytm dopasowania rozmytego nie odtworzy tej relacji.
Normalizuj, nie niszcząc dowodów
Zachowuj wartości oryginalne i twórz obok nich reprezentacje znormalizowane. Transliteracja może ułatwić porównania między alfabetami, a oryginalny zapis pozostaje niezbędny do weryfikacji i audytu. Normalizuj znaki diakrytyczne, interpunkcję, łączniki i kolejność imion oraz nazwisk regułami dopasowanymi do języka i typu encji.
Kraj lub jurysdykcja mogą dostarczyć użytecznego kontekstu, ale nie powinny stać się bezwzględną regułą tożsamości. Dopasowanie transgraniczne może być prawidłowe, a pozornie lokalne nadal może być błędne. Pary z różnych alfabetów o niskiej pewności zasługują na wyraźną weryfikację zamiast cichego odrzucenia lub automatycznego zatwierdzenia.
Najnowsze prace o łączeniu rekordów wskazują, że blokowanie hierarchiczne daje największą poprawę w wielojęzycznym dopasowywaniu podmiotów, a blokowanie według kraju może ograniczać fałszywe dopasowania między krajami, jak pokazuje opisane badanie.
Blokowanie wymienia szybkość na czułość
Naiwne porównywanie wszystkich par rośnie kwadratowo wraz z liczbą rekordów. Blokowanie i indeksowanie zawężają zbiór kandydatów, ale wprowadzają nowy sposób zawodzenia: prawdziwa para może zostać wykluczona jeszcze przed punktacją.
Stosuj warstwowe generowanie kandydatów zamiast jednego kruchego klucza:
Blok główny: korzystaj z wiarygodnych sygnałów kontekstowych, takich jak jurysdykcja, typ encji lub znormalizowane fragmenty identyfikatorów.
Blok zapasowy: dopuszczaj szersze kombinacje dla brakujących lub niepewnych wartości.
Ścieżka międzyalfabetowa: porównuj reprezentacje transliterowane, gdy alfabety się różnią.
Ścieżka weryfikacji: zachowuj kandydatów o niskiej pewności, którzy przekraczają istotne granice.
Mierz czułość blokowania oddzielnie od jakości punktacji. Model punktujący może wyglądać świetnie na kandydatach, których dostaje, podczas gdy warstwa blokowania już odrzuciła prawidłowe dopasowania. Testy według języka, alfabetu, kraju i źródła ujawnią te ciche straty.
Podczas przetwarzania wstępnego nawet pozornie drobne tokeny mogą zniekształcić porównanie, dlatego zespoły powinny definiować reguły czyszczenia dla konkretnych pól, zamiast bezrefleksyjnie stosować uniwersalną listę słów nieistotnych (stop words). Praktycznym punktem odniesienia jest ten zasób o słowach nieistotnych, wykorzystany jednorazowo w projekcie normalizacji, a nie jako zamiennik reguł uwzględniających język.
Strategie wdrożenia w środowiskach produkcyjnych
Produkcyjne dopasowywanie odnosi sukces dzięki kontroli, a nie samemu wyborowi algorytmu. Zacznij od wąsko zdefiniowanego procesu, przygotuj oznaczone przykłady i określ, co system może łączyć automatycznie, co wymaga weryfikacji, a co musi pozostać osobno.
Zbuduj potok decyzyjny
Najpierw profiluj źródła. Zidentyfikuj brakujące pola, częste warianty, wzorce duplikatów i szum charakterystyczny dla źródła.
Normalizuj do równoległych pól. Zachowaj surowe wartości na potrzeby audytu i twórz wartości znormalizowane do porównań.
Blokuj ostrożnie. Mierz, ile znanych prawdziwych par przetrwa generowanie kandydatów.
Punktuj według pól. Dobieraj miary do zachowania pola zamiast stosować jedną uniwersalną funkcję.
Klasyfikuj z możliwością wstrzymania. Oddziel powiązania automatyczne, kandydatów do weryfikacji i braki dopasowania.
Rejestruj decyzje. Przechowuj dowody, wersje reguł, progi i wyniki weryfikacji.
Dopasowanie kandydujące nie jest zatwierdzonym powiązaniem tożsamości. To rozróżnienie powinno istnieć w modelu danych, w interfejsie użytkownika i w API systemów niższego rzędu. Zapobiega temu, by wstępne rekomendacje były wykorzystywane jako wiążące dane podstawowe.
Monitoruj błędy, które mają znaczenie
Raportuj precyzję i czułość przy progach operacyjnych, a następnie rozbijaj wyniki według regionu, źródła, typu encji i języka. Mierz osobno fałszywe dopasowania i fałszywe braki dopasowania. Weryfikatorzy powinni widzieć pola i reguły, które wpłynęły na każdą rekomendację, a nie tylko jeden nieprzejrzysty wynik.
Wykonywanie w bazie danych może ograniczyć przenoszenie danych i dostosować dopasowywanie do wymogów bezpieczeństwa oraz ładu danych. Wdrożenie w chmurze prywatnej lub lokalnie (on-premises) może też utrzymać proces w środowisku klienta, gdy wymogi zgodności wykluczają przetwarzanie zewnętrzne.
Podejście modułowe jest łatwiejsze w utrzymaniu niż rozrośnięty silnik reguł. Dodaj jedną funkcję monitorowania, sprawdź jej przydatność i rozbudowuj wraz z dojrzewaniem wymagań. Wzorzec ładu danych powinien być wersjonowany, możliwy do przejrzenia i odwracalny, gdy nowe źródło zmienia zachowanie systemu dopasowującego.
Zespoły oceniające zarządzanie danymi podstawowymi klientów powinny zwrócić szczególną uwagę na zasady przetrwania wartości (survivorship) i projekt audytu. Dopasowywanie określa, które rekordy zostaną powiązane, ale procesy danych podstawowych muszą też jasno ustalać, które wartości stają się wiążące i jak propagują się późniejsze korekty.
Integracja dopasowania rozmytego z obserwowalnością danych
System dopasowujący może kończyć każde zaplanowane zadanie, a mimo to działać coraz gorzej. Nowe formaty źródeł, zmieniony skład populacji, inne konwencje nazewnictwa i zmiany schematu mogą przesunąć rozkłady wyników bez widocznej awarii potoku.
Dlatego monitorowanie powinno obejmować zachowanie, a nie tylko dostępność. Śledź wskaźniki dopasowań, rozkłady wyników, liczbę weryfikacji, przekroczenia progów, wykluczenia na etapie blokowania i potwierdzone wzorce fałszywych dopasowań. Nagła zmiana któregokolwiek z tych sygnałów może wskazywać na dryf w systemach źródłowych lub założenie, które przestało obowiązywać.
Powiąż decyzje o tożsamości z zachowaniem danych
Zmiany schematu wymagają szczególnej uwagi. Dodane kolumny, zmienione typy danych lub nowe kategorie encji mogą zmienić dostępność i wagę pól. Jeśli logika dopasowywania nie wykryje tych zmian, może dalej działać, tworząc mniej wiarygodne powiązania.
Szersza praktyka obserwowalności danych może łączyć wyniki dopasowywania z terminowością, walidacją, wykrywaniem anomalii i monitorowaniem schematów. Dzięki temu inżynierowie danych mają wspólny obraz tego, czy problem z dopasowaniem zaczął się w algorytmie, danych źródłowych, potoku czy polityce decyzyjnej.
Dla zespołów działających w branżach regulowanych przydatna podstawa obejmuje:
Dowody decyzji: jakie wartości i pola uzasadniły każde powiązanie?
Historia polityk: który próg i która wersja algorytmu były aktywne?
Przekroje populacji: czy skuteczność zmieniła się w zależności od regionu, języka lub źródła?
Informacja zwrotna od ludzi: których kandydatów weryfikatorzy zaakceptowali, a których odrzucili?
Dryf operacyjny: czy zmieniły się dostawy danych, schematy lub rozkłady?
Najlepsze wdrożenie traktuje dopasowanie rozmyte jako jeden kontrolowany produkt danych. Nie kończy się na łączeniu rekordów. Obserwuje, jak te powiązania zachowują się w czasie, i daje zespołom wystarczająco dużo dowodów, by zbadać, poprawić i wyjaśnić wynik.
digna pomaga zespołom danych monitorować sygnały jakości wokół dopasowania rozmytego, w tym walidację rekordów, anomalie, terminowość i zmiany schematu, a wszystko to przy wykonywaniu w środowisku klienta. Odwiedź digna i zobacz, jak połączyć ład decyzji o dopasowaniach z szerszą obserwowalnością danych.
Ponieważ zmiana nazwy kolumny lub typu danych może po cichu zmienić to, które pola trafiają do systemu dopasowującego, warto obserwować struktury źródłowe równie uważnie jak wskaźniki dopasowań. Zobacz, jak śledzenie zmian schematu sygnalizuje takie zmiany, zanim zniekształcą decyzje o tożsamości.
Najczęściej zadawane pytania
Który algorytm dopasowania rozmytego jest najlepszy?
Żaden nie jest najlepszy w każdej sytuacji. W opublikowanym porównaniu siedmiu podejść dopasowanie n-gramowe dało najlepszą precyzję, miarę F i dokładność, a podobieństwo cosinusowe okazało się najszybsze. Systemy produkcyjne zwykle przypisują miarę do każdego pola, na przykład Jaro-Winklera do nazwisk i Jaccarda do adresów, a potem łączą dowody.
Czym różni się odległość Levenshteina od odległości Jaro-Winklera?
Levenshtein liczy minimalną liczbę wstawień, usunięć lub zamian pojedynczych znaków potrzebnych do przekształcenia jednego ciągu w drugi, więc sprawdza się przy literówkach i krótkich identyfikatorach. Jaro-Winkler premiuje zgodne prefiksy, dlatego dobrze działa dla imion, nazwisk i innych krótkich pól, w których pierwsze znaki niosą większość sygnału.
Czy wynik podobieństwa w dopasowaniu rozmytym to prawdopodobieństwo dopasowania?
Nie. Wynik taki jak 0,87 mierzy jedynie podobieństwo według jednej miary. Nie mówi, które pola zdecydowały o rezultacie ani ile kosztuje błędne scalenie. W cytowanym badaniu precyzja Jaccarda spadła do 53% dla wyników między 0,90 a 0,95, więc nawet wysokie wartości mogą być niebezpieczne.
Na czym polega blokowanie w łączeniu rekordów?
Blokowanie ogranicza porównania do par kandydatów o wspólnym kluczu, takim jak jurysdykcja czy znormalizowany fragment identyfikatora, bo naiwne porównywanie wszystkich par rośnie kwadratowo. Ceną jest czułość: jeśli dwa prawdziwie powiązane rekordy trafią do różnych bloków, żaden dalszy algorytm nie odtworzy powiązania, dlatego czułość blokowania warto mierzyć osobno.
Jak ustalić próg dla dopasowania rozmytego?
Dostrój go na oznaczonych parach z populacji, którą system faktycznie będzie przetwarzał, a potem sprawdź precyzję i czułość według języka, regionu, źródła i typu encji. Zamiast jednego progu zastosuj pasmo wstrzymania, które kieruje niejednoznaczne pary do weryfikatora i zapisuje dowody, próg oraz wersję reguły na potrzeby audytu.



