Kontrola jakości KPI: praktyczny przewodnik po ładzie danych
|
8
min. czyt.

Dashboard może ładować się bez zarzutu, a mimo to opowiadać niewłaściwą historię. To niewygodna słabość większości programów kontroli jakości KPI: zespoły sprawdzają, czy dane dotarły, czy kolumny zgadzają się ze schematem i czy raporty się odświeżyły, a potem traktują te techniczne sukcesy jako dowód, że wskaźnikiem można się bezpiecznie posługiwać.
Tak nie jest. KPI może być kompletny, aktualny i poprawnie typowany, a jednocześnie stać się strategicznie mylący po przejęciu, zmianie cen, wahaniach kursów walut, zmianie struktury klientów lub zmianie mianownika. Wiarygodny monitoring musi sprawdzać przydatność do decyzji, a nie tylko kondycję pipeline'u. Oznacza to pytanie, czy wskaźnik nadal znaczy to, co sądzi kierownictwo, czy pozostaje porównywalny z wcześniejszymi okresami i czy wspiera decyzję, z którą jest powiązany.
Spis treści
Kontrola jakości KPI w nowoczesnych platformach danych
Większość zespołów danych zaczyna od pytań operacyjnych: czy job się wykonał? Czy tabela została zaktualizowana? Czy zapytanie dashboardu się powiodło? Te kontrole są ważne, ale opisują stan platformy danych, a nie wiarygodność wniosku biznesowego.
Technicznie poprawne wyliczenie wzrostu przychodów może wprowadzać w błąd, jeśli przejęcie zmienia populację, jeśli ruch wynika z podwyżek cen albo jeśli mianownik pomija kohortę, która właśnie stała się istotna. KPI retencji klientów również może wyglądać stabilnie, choć zmieniła się bazowa definicja klienta. Na poziomie schematu nic nie musi się zepsuć. Błąd tkwi w relacji między wskaźnikiem a decyzją, którą ma wspierać.
Techniczna poprawność to dopiero pierwszy próg
Użyteczny system kontroli KPI rozdziela trzy pytania:
Czy pipeline potrafi wytworzyć wartość? Sprawdź dostarczenie, schemat, typy, wartości null, wolumen i status przetwarzania.
Czy wartość oznacza to, co mówi definicja? Sprawdź filtry, kohorty, joiny, mianowniki, okna czasowe, dane referencyjne i uzgodnienie z systemem źródłowym.
Czy wskaźnik nadal jest przydatny dla zamierzonej decyzji? Sprawdź porównywalność, istotność, kontekst biznesowy i założenia, którymi kierownictwo posługuje się przy interpretacji zmian.
Na trzecim pytaniu wiele programów się zatrzymuje. Zespoły mogą alarmować przy nietypowych wartościach, nie rozstrzygając, czy ruch oznacza błąd, czy uzasadnione zdarzenie operacyjne. Powstają wtedy dwa przeciwstawne ryzyka. Cichy, ale zniekształcony KPI przechodzi niezauważony, a uzasadniona zmiana sezonowa lub strategiczna generuje szum, który użytkownicy uczą się ignorować.
Praktyczne podejście do data observability powinno więc łączyć sygnały techniczne z odpowiedzialnością semantyczną. Każdy krytyczny KPI potrzebuje zatwierdzonej definicji, wskazanego z imienia właściciela biznesowego, powiązania z systemem źródłowym i wyjaśnienia, które decyzje od niego zależą.
Praktyczna zasada: Udany przebieg pipeline'u dowodzi, że dane zostały przesłane. Nie dowodzi, że wskaźnik biznesowy nadal nadaje się do podejmowania decyzji.
Porównywalność jako jawna kontrola
Zacznij od udokumentowania populacji wskaźnika, licznika, mianownika, filtrów, ziarnistości, okna czasowego, sposobu traktowania walut i wyłączeń. Następnie zapisz zdarzenia, które mogą zmienić interpretację, w tym wprowadzenie produktów, przejęcia, zmiany cen, reorganizacje regionów i aktualizacje polityk.
Kontrola powinna odróżniać zmianę obliczeń od zmiany w biznesie. Jeśli zmieniła się formuła, właściciel musi ocenić porównywalność historyczną i wersjonować definicję. Jeśli zmienił się biznes, właściciel może zatwierdzić anomalię, dokumentując, dlaczego KPI pozostaje przydatny, albo wyjaśnić, dlaczego potrzebny jest przeliczony szereg, nowa kohorta lub wskaźnik zastępczy.
W ten sposób kontrola jakości KPI zmienia się ze zbioru testów danych w system chroniący decyzje. Inżynierowie nadal monitorują maszynerię, ale to właściciele biznesowi walidują znaczenie.
Prawdziwy koszt ignorowania jakości danych KPI
Słaba walidacja wskaźników rzadko powoduje spektakularną awarię. Częściej błędna wartość trafia do prezentacji planistycznej, oceny wyników, prognozy, raportu zgodności lub workflow AI. Organizacja traci wtedy czas na spory o wynik, poprawianie materiałów w dalszych etapach, ponowne analizy i odbudowę zaufania do procesu raportowania.
Według Gartnera niska jakość danych kosztuje organizacje średnio co najmniej 12,9 mln USD rocznie, na podstawie badań z 2020 roku, a 59% organizacji w ogóle nie mierzy jakości danych, jak podsumowuje przegląd kosztów złych danych przygotowany przez Docsumo. Szacunek pochodzi z ankiety wśród 154 klientów referencyjnych 16 dostawców rozwiązań do jakości danych, więc nie należy traktować go jako uniwersalnego kosztu każdej firmy. Pokazuje jednak, dlaczego organizacje muszą łączyć błędy z ich skutkami biznesowymi, zamiast traktować jakość jako abstrakcyjny wynik inżynierski.
Łańcuch dowodów od błędu do decyzji
Dojrzały program kontroli zapisuje coś więcej niż alert. Powinien zachować:
Błąd, na przykład brakujące ładowanie, nieprawidłową wartość, zmieniony join, nieaktualny rekord lub niezgodność definicji.
Dotknięty KPI, wraz z właścicielem, odbiorcami, miejscami raportowania i zależnymi modelami.
Wpływ na biznes, na przykład zniekształconą prognozę, opóźnione działanie, niedokładny raport lub niepotrzebne dochodzenie.
Naprawę, w tym zmianę techniczną, zatwierdzenie biznesowe, dowody walidacji i datę zamknięcia.
Działanie zapobiegawcze, na przykład nową regułę, zmienioną definicję, aktualizację lineage lub korektę progu.
Taki łańcuch daje działowi finansów i zarządowi uzasadniony powód, by finansować kontrole. Pomaga też inżynierii ustalać priorytety. Błąd w rzadko używanej tabeli eksploracyjnej nie powinien wywoływać takiej samej reakcji jak błąd wpływający na raportowanie regulacyjne, zarządzanie przychodami lub KPI zarządu.
Argument finansowy wykracza poza zespoły danych. Raport IBM Institute for Business Value z 2025 roku wykazał, że 43% dyrektorów operacyjnych wskazało problemy z jakością danych jako swój najważniejszy priorytet w obszarze danych, a ponad jedna czwarta organizacji szacuje roczne straty z powodu niskiej jakości danych na ponad 5 mln USD. Dane te przedstawia analiza IBM dotycząca niskiej jakości danych, która ujmuje ten problem jako kwestię operacyjną, a nie wąsko platformową.
Zespoły oceniające wpływ komercyjny mogą też skorzystać z materiału naprawa złych danych dla przychodów jako praktycznego punktu odniesienia przy łączeniu niewiarygodnych danych z procesami przychodowymi. Użyteczne pytanie nie brzmi: „Ile rekordów nie przeszło kontroli?”. Brzmi ono: „Na jakie decyzje wpłynęły te rekordy i co zrobiła organizacja, ponieważ KPI był błędny?”.
Mierz jakość i skutki jednocześnie
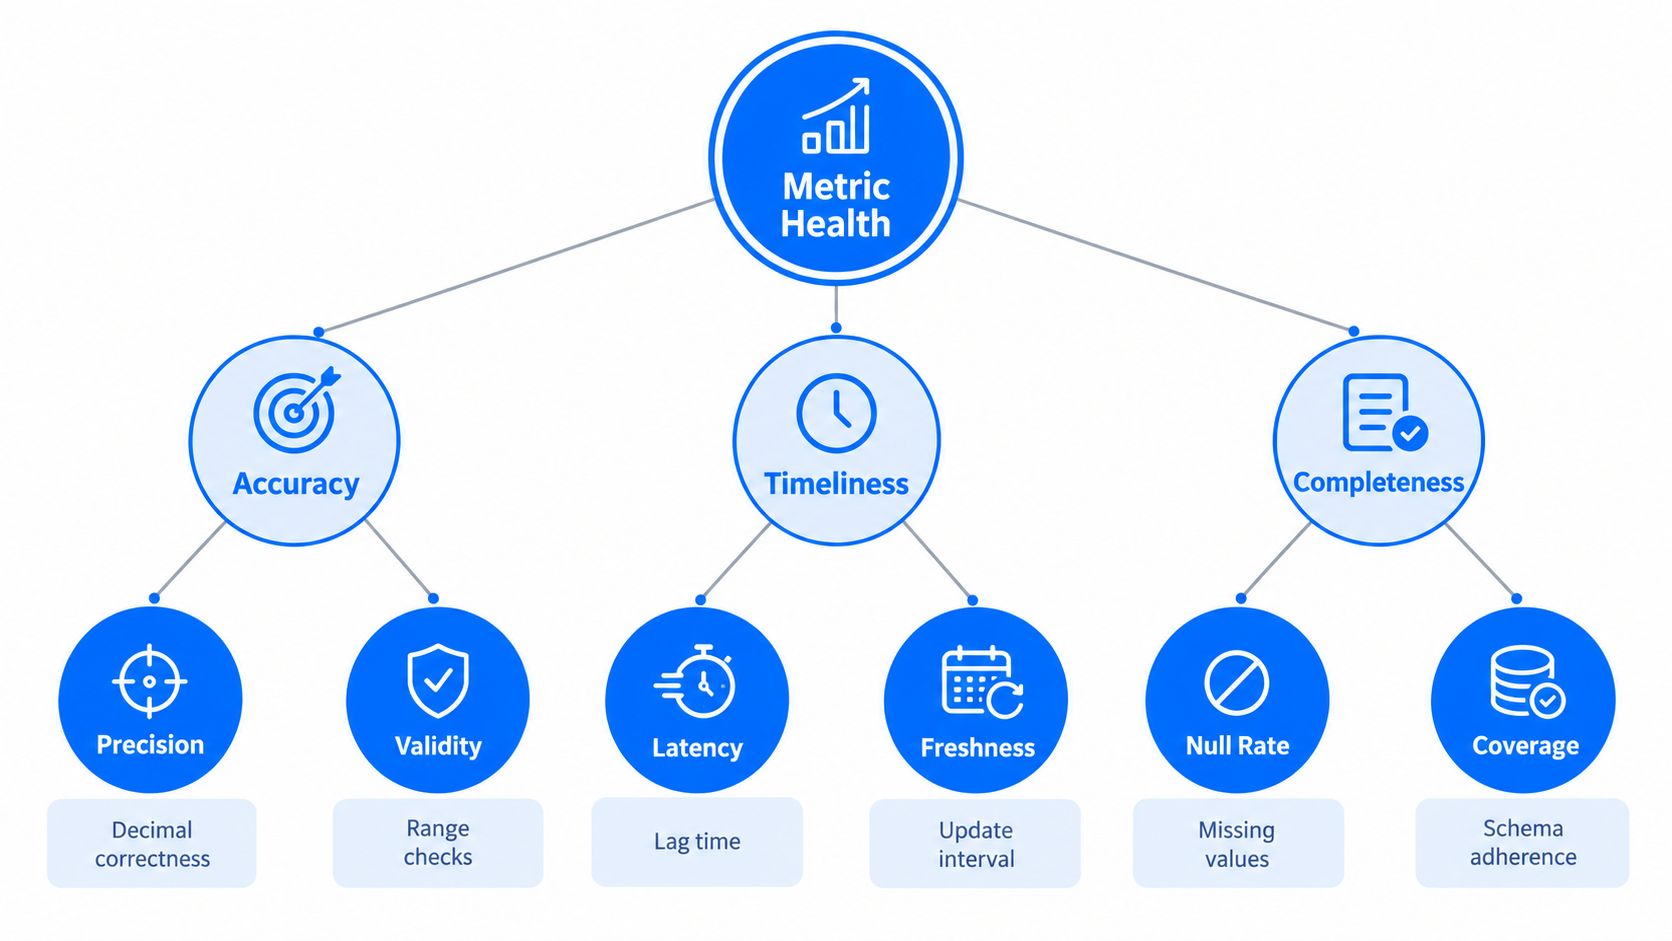
Śledź wymiary takie jak dokładność, kompletność, spójność, poprawność, terminowość, unikalność i adekwatność. Następnie zestaw je z miarami operacyjnymi, takimi jak waga incydentów, dotknięte raporty, czas naprawy, powtarzalność oraz stosunek anomalii zaakceptowanych do uznanych za błędy.
Jeden zbiorczy wynik ukrywa kompromisy. Wysoka kompletność może współistnieć z niską dokładnością. Doskonała aktualność może współistnieć z wadliwą definicją biznesową. Oddzielne wymiary pozwalają zdiagnozować problem i umożliwiają właścicielom dobór kontroli według istotności.
Kadrze zarządzającej, która potrzebuje zwięzłego business case'u, rozmowę może ułatwić poradnik digna dotyczący business case'u dla jakości danych. Najmocniejszym argumentem jest zwykle audytowalne powiązanie między błędem w danych, zniekształconym KPI, opóźnioną lub błędną decyzją oraz kontrolą, która zmniejsza ryzyko powtórki.
Kluczowe wymiary wiarygodnych wskaźników biznesowych
KPI nie powinien dostawać jednej etykiety „zaliczony” lub „niezaliczony”, a potem znikać w dashboardzie. Jakość jest wielowymiarowa, a każdy wymiar wymaga innego testu. Kolumna może być zgodna z zadeklarowanym typem, a mimo to nieść błędne znaczenie biznesowe. Kompletny zbiór danych może nadal zawierać nieprawidłowe wartości.
Oddziel składnię, znaczenie i użyteczność
Norma ISO 8000-1:2022 definiuje pojęcia jakości, które można przełożyć na kontrole: jakość syntaktyczna dotyczy zgodności z zatwierdzonym formatem, jakość semantyczna tego, czy wartości oddają zamierzone znaczenie, a jakość pragmatyczna tego, czy dane są odpowiednie dla zamierzonych użytkowników i decyzji. Ramy te podsumowuje omówienie normy ISO 8000.
Zastosuj te pojęcia bezpośrednio:
Warstwa jakości | Co sprawdza | Praktyczna kontrola KPI |
|---|---|---|
Syntaktyczna | Czy dane mają zatwierdzoną strukturę | Kontrole schematu, typu, formatu i dozwolonych wartości |
Semantyczna | Czy wartości oddają zamierzone pojęcie | Walidacja definicji, joinów, kohort, mianownika i danych referencyjnych |
Pragmatyczna | Czy KPI wspiera zamierzoną decyzję | Akceptacja właściciela, przegląd porównywalności, istotność i testy wykorzystania w decyzjach |
Kontrole syntaktyczne zwykle najłatwiej zautomatyzować. Sprawdzaj, czy daty są datami, identyfikatory mają oczekiwany wzorzec, pola liczbowe pozostają w akceptowalnych formatach, a wymagane kolumny istnieją. Takie kontrole wcześnie wychwytują błędy strukturalne, ale nie rozstrzygną, czy „aktywny klient” nadal odpowiada zatwierdzonej definicji biznesowej.
Kontrole semantyczne wymagają lepszej dokumentacji. Uzgadniaj sumy KPI z odpowiednim systemem źródłowym, testuj populacje licznika i mianownika niezależnie od siebie i porównuj wyniki między zatwierdzonymi kohortami i oknami czasowymi. Jeśli wskaźnik korzysta z danych referencyjnych, monitoruj ich zmiany równie starannie jak zmiany w tabeli faktów.
Kontrole pragmatyczne należą do osób, które korzystają ze wskaźnika. Właściciel biznesowy powinien potwierdzić, czy KPI nadal nadaje się do decyzji planistycznych, cenowych, ryzykowych, operacyjnych lub związanych ze zgodnością. To także miejsce, w którym uzasadnione anomalie otrzymują kontekst, zamiast być automatycznie wyciszane.
Kompletność i poprawność jako osobne kontrole
Ramy jakości danych rządu Wielkiej Brytanii odróżniają kompletność od poprawności. Kompletność pyta, czy wymagane rekordy i kluczowe pola są obecne. Poprawność pyta, czy wartości mieszczą się w oczekiwanych zakresach i formatach. Ramy wyraźnie ostrzegają, że kompletne dane nie muszą być dokładne.
To rozróżnienie zmienia sposób, w jaki zespoły projektują testy:
Kontrole pokrycia wykrywają brakujące rekordy, okresy, encje lub źródła danych.
Kontrole pól wymaganych wykrywają brakujące wartości w polach potrzebnych do obliczeń.
Kontrole poprawności egzekwują formaty, zakresy, dozwolone wartości i oczekiwane typy.
Kontrole dokładności uzgadniają wartości z zaufanym źródłem lub procesem biznesowym.
Kontrole spójności porównują to samo pojęcie między systemami, produktami i warstwami raportowania.
Kontrole terminowości porównują przybycie danych z oczekiwanym wzorcem dostaw, a nie tylko ze stałą godziną.
Wykorzystaj wymiary jakości danych opisane przez digna jako punkt odniesienia przy przekładaniu tych kategorii na inwentarz monitoringu. Kluczową decyzją projektową jest utrzymanie wymiarów na widoku. Jedna plakietka „w porządku” może ukryć dokładnie tę słabość, która unieważnia decyzję.
Ład danych i jasna odpowiedzialność
Najtrudniejszą częścią kontroli jakości KPI nie jest napisanie reguły walidacyjnej. Jest nią ustalenie, kto działa, gdy reguła się uruchomi, kto może uznać anomalię za uzasadnioną i kto musi wykazać, że wskaźnik można znów bezpiecznie publikować.
Badanie Actian z 2025 roku, obejmujące ponad 600 specjalistów ds. danych w przedsiębiorstwach, wykazało, że 83% zmagało się z wyzwaniami w zakresie ładu danych i zgodności, choć organizacje oceniały swoją dojrzałość w tym obszarze na 4,13 na 5, a kadra kierownicza oceniała dojrzałość danych o 12% wyżej niż praktycy. Wyniki te przedstawia badanie Actian dotyczące dojrzałości ładu danych. Ta luka wskazuje na praktyczny problem: pewność siebie kierownictwa może rosnąć szybciej niż przejrzystość operacyjna.
Odpowiedzialność wpisana w kontrakt wskaźnika
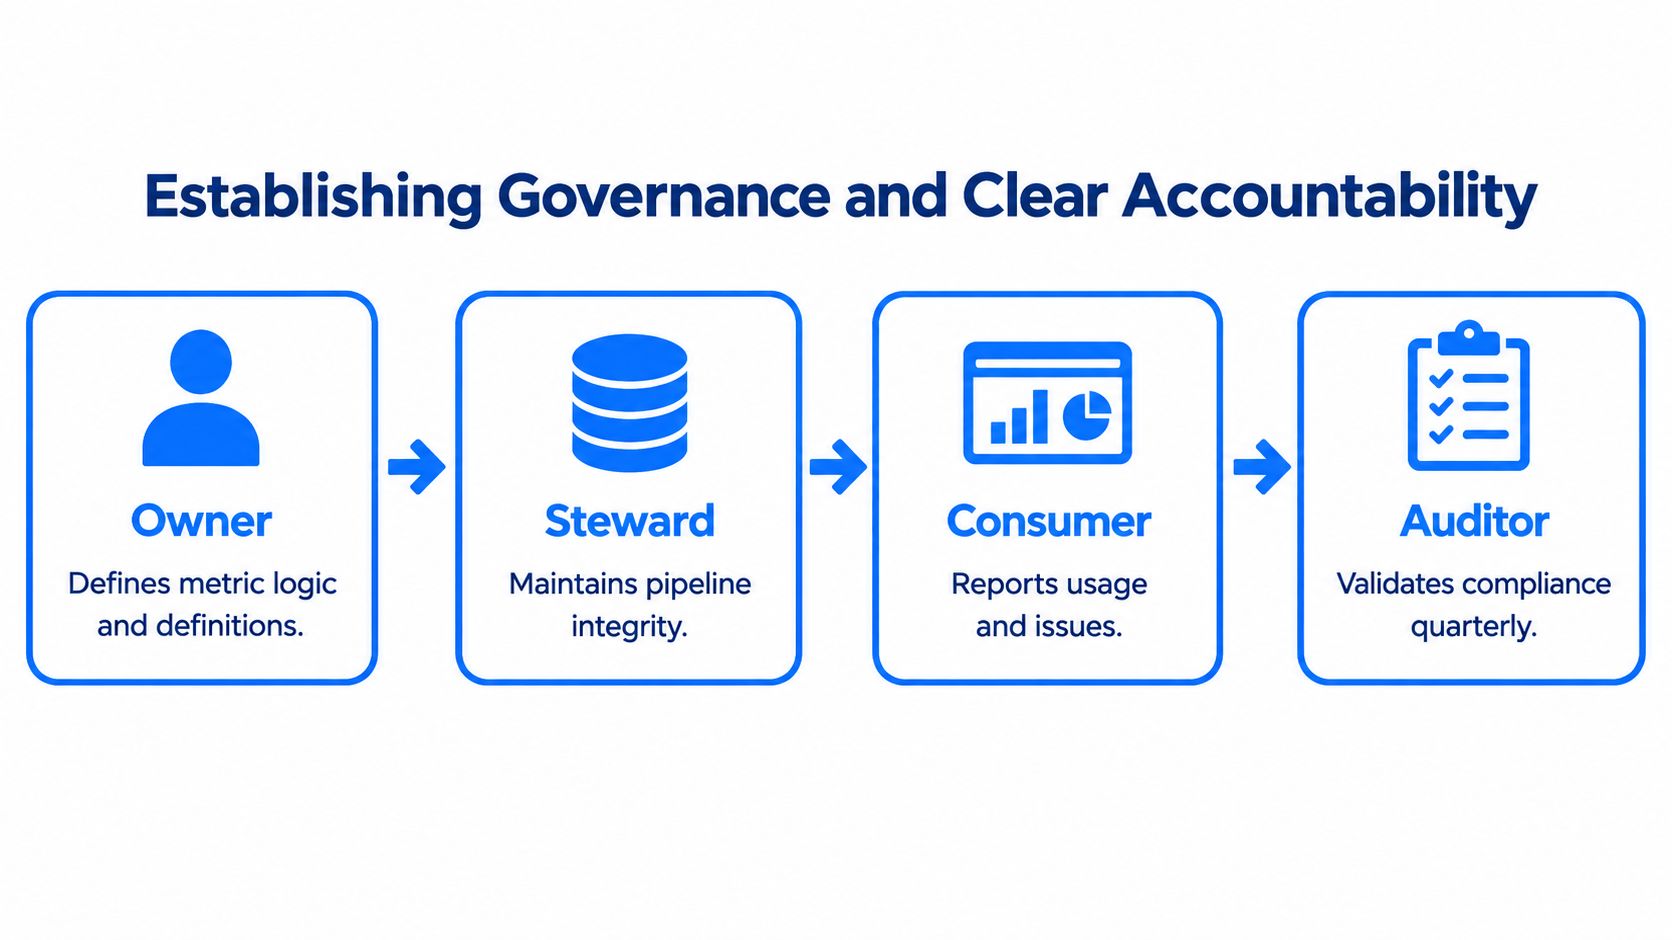
Dla każdego krytycznego KPI zapisz:
Właściciel biznesowy: Określa, co oznacza wskaźnik, zatwierdza jego interpretację i decyduje, czy nadal spełnia swój cel.
Właściciel techniczny: Utrzymuje pipeline'y, transformacje, testy i zależności.
Data steward: Utrzymuje definicje, dane referencyjne, lineage i dokumentację.
Odbiorca: Zgłasza nieoczekiwane zachowanie i wyjaśnia, jak używa KPI.
Audytor lub recenzent kontroli: Weryfikuje dowody, zatwierdzenia i historię napraw.
Właściciel musi też zatwierdzić próg istotności. Niewielkie odchylenie może wymagać jedynie obserwacji, natomiast gwałtowny ruch regulacyjnego, finansowego lub operacyjnego KPI może wymagać wstrzymania publikacji i eskalacji do zarządu. Progi powinny odzwierciedlać wpływ na decyzje, a nie tylko statystyczną nietypowość.
Zaprojektuj rejestr incydentu przed incydentem
Użyteczny rejestr incydentu zawiera wykryty stan, okres, którego dotyczy, aktualną wersję definicji, zmiany w źródłach, wagę, właściciela, wpływ na decyzje, rozstrzygnięcie, naprawę i dowody ponownej walidacji. Powinien rozróżniać trzy wyniki:
Błąd techniczny, gdy źródło lub transformacja są nieprawidłowe.
Błąd semantyczny, gdy obliczenie nie odpowiada już zatwierdzonemu znaczeniu.
Uzasadnione zdarzenie, gdy zmienił się biznes, a KPI poprawnie tę zmianę odzwierciedla.
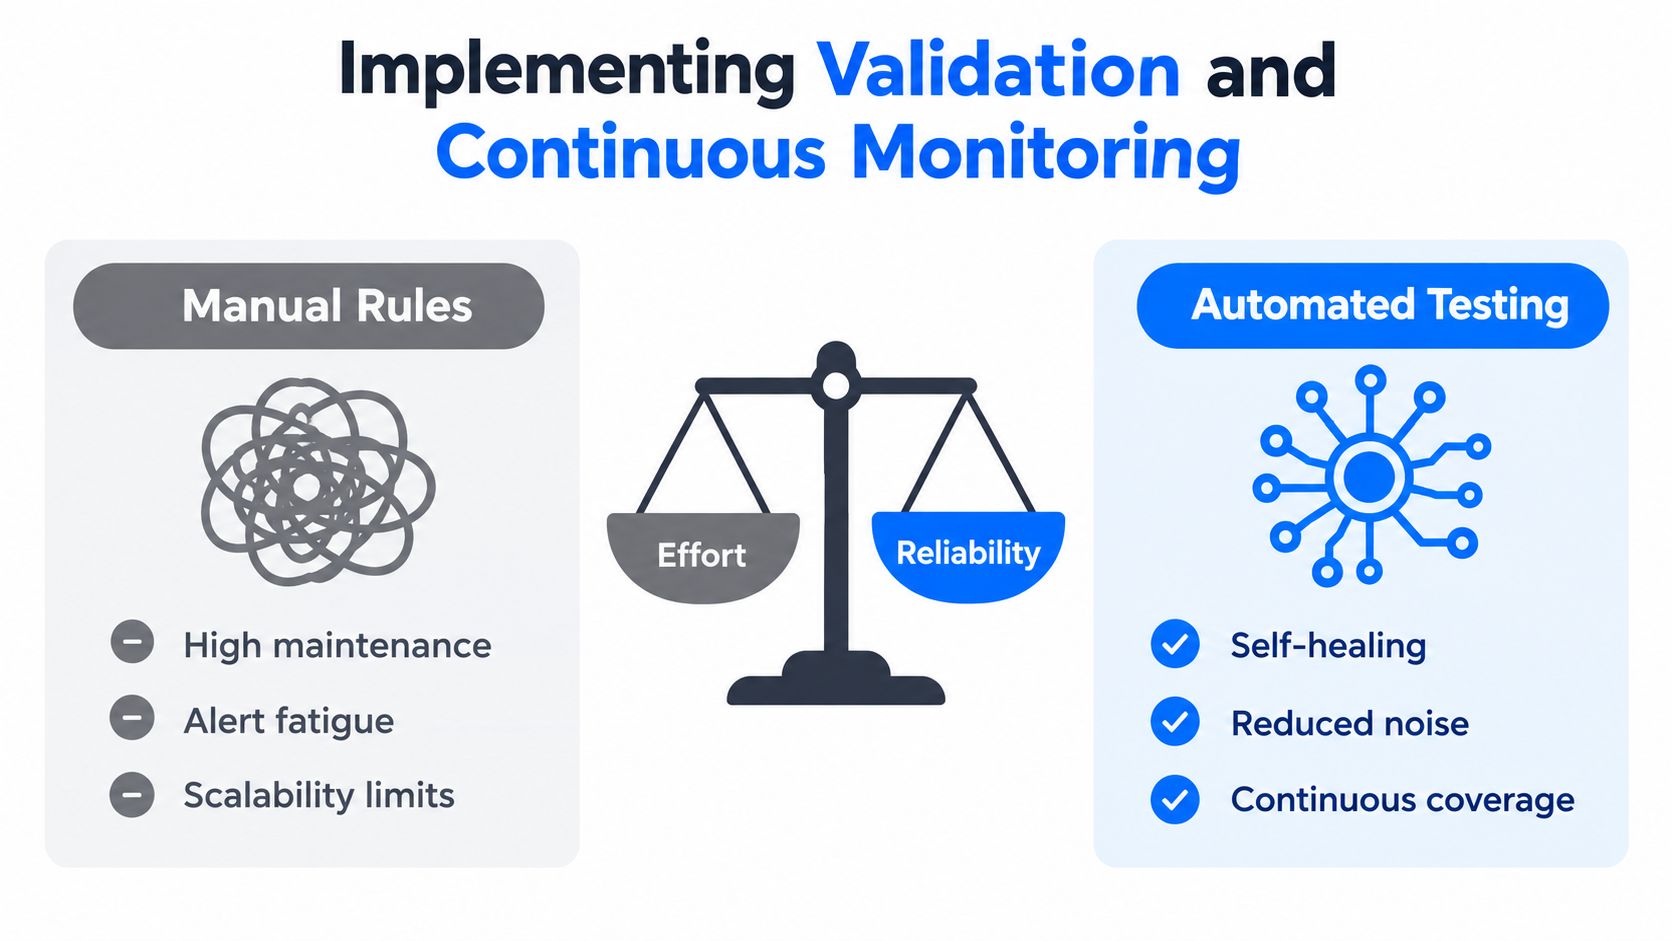
Reguły ręczne pozostają cenne dla stabilnych twierdzeń o wysokiej stawce. Stają się kosztowne, gdy zespoły piszą osobne progi dla każdej tabeli, kohorty i kontekstu raportowania, a potem korygują je po każdej zwykłej zmianie w biznesie. Automatyczne linie bazowe mogą zmniejszyć nakład utrzymania i ujawnić nieznany dryf, ale nie zastępują zatwierdzenia biznesowego. Detektor anomalii może powiedzieć „nietypowe”. Nie rozstrzygnie, czy nowa polityka cenowa sprawia, że ruch jest prawidłowy.
Skorzystaj z materiałów digna na temat ładu jakości danych, projektując model operacyjny. Najważniejszym rezultatem jest mierzalna odpowiedzialność, w tym czas do triażu, czas do naprawy, dowody zamknięcia, powtarzalność i odsetek alertów, które właściciele klasyfikują jako uzasadnione zdarzenia biznesowe.
Skuteczny program ładu danych ujawnia rozbieżności. Jeśli kadra kierownicza widzi dojrzałość w wyniku punktowym, a praktykom brakuje właścicieli i ścieżek eskalacji, środowisko kontroli nie jest jeszcze dojrzałe. Jest udokumentowane, ale nie działa w praktyce.
Wdrażanie walidacji i ciągłego monitoringu
Ręcznie pisane reguły są precyzyjne, ale nie skalują się w nieskończoność. Sprawdzają się przy warunkach umownych, wymogach regulacyjnych i znanej logice biznesowej. Słabo sprawdzają się jako jedyna metoda wykrywania nieoczekiwanych zachowań w dużym, zmieniającym się środowisku pipeline'ów.
Łącz kontrole deterministyczne i behawioralne
Walidacja deterministyczna sprawdza, czy wartość lub rekord spełnia jawny warunek. Przykłady:
Zamówienie musi odwoływać się do istniejącego klienta.
Data transakcji musi mieścić się w dozwolonym okresie raportowym.
Mianownik KPI nie może wynosić zero.
Pole regulowane musi używać zatwierdzonego kodu.
Wymagane zdarzenie biznesowe musi nadejść, zanim uruchomi się zależna agregacja.
Takie reguły są wytłumaczalne i audytowalne. Wymagają jednak utrzymania. Definicje biznesowe się zmieniają, systemy źródłowe ewoluują, a wyjątków przybywa. Bez właścicieli zbiory reguł stają się kruche, a liczba alertów rośnie, aż inżynierowie przestają im ufać.
Monitoring behawioralny działa inaczej. Uczy się normalnego wzorca zbioru danych, harmonogramu dostaw, profilu wolumenu lub biznesowego KPI, a następnie wskazuje nietypowe ruchy. Przydaje się przy nieznanych awariach, stopniowym dryfie, nietypowej zmienności, brakujących ładowaniach i zmianach, których nikt nie przewidział, pisząc pierwotne reguły.
Ceną jest interpretowalność. Stała reguła może dokładnie wyjaśnić, dlaczego wiersz nie przeszedł kontroli. Alert behawioralny może wskazać istotne odchylenie, nie wskazując jego przyczyny. Dlatego najmocniejsza architektura łączy obie metody, zamiast traktować je jak konkurentów.
Dane wrażliwe zostają na miejscu
W środowiskach korporacyjnych architektura monitoringu jest równie ważna jak logika wykrywania. Wykonywanie obliczeń wskaźników i kontroli na poziomie rekordów we własnych bazach danych klienta może ograniczyć przesyłanie danych i ułatwić spełnienie wymogów bezpieczeństwa. Pozwala też walidować dane w hurtowni i data lake tam, gdzie już się znajdują, zamiast budować dodatkowe ścieżki ekstrakcji na potrzeby observability.
Praktyczna kolejność wdrożenia wygląda tak:
Zacznij od krytycznych KPI, ich tabel źródłowych, definicji, właścicieli i decyzji biznesowych.
Dodaj kontrole deterministyczne dla znanych warunków poprawności, zgodności i uzgodnień.
Ustal behawioralne linie bazowe dla wolumenu, aktualności, rozkładów i ruchów KPI.
Kieruj alerty według odpowiedzialności, a nie na wspólny kanał bez osoby odpowiedzialnej za reakcję.
Analizuj wyniki alertów, a potem dostrajaj progi, definicje i wagi na podstawie faktycznych decyzji.
Poradnik dotyczący walidacji danych, reguł, kontroli i ciągłej jakości pomaga uporządkować to połączenie walidacji na poziomie rekordów z ciągłym monitoringiem. Wybór platformy ma mniejsze znaczenie niż dyscyplina operacyjna. Każdy alert potrzebuje odbiorcy, ścieżki decyzyjnej i zapisu tego, co wydarzyło się później.
Czułość alertów jako budżet operacyjny
Wysoka czułość wychwytuje więcej potencjalnych awarii, ale generuje też więcej szumu. Niska czułość chroni uwagę, ale może przeoczyć stopniowe błędy lub błędy przy małym wolumenie. Ustalaj wagę według wpływu na biznes, a fałszywe alarmy i przeoczone incydenty przeglądaj w ramach programu kontroli.
Nie wyciszaj automatycznie nietypowych ruchów. Najpierw zapytaj, czy zdarzenie jest rzeczywiste, czy definicja nadal obowiązuje i czy dotknięta decyzja wymaga przeliczonego wskaźnika. Wykrywanie statystyczne powinno uruchamiać dochodzenie, a nie zastępować odpowiedzialność.
Projektowanie skutecznych procesów naprawczych
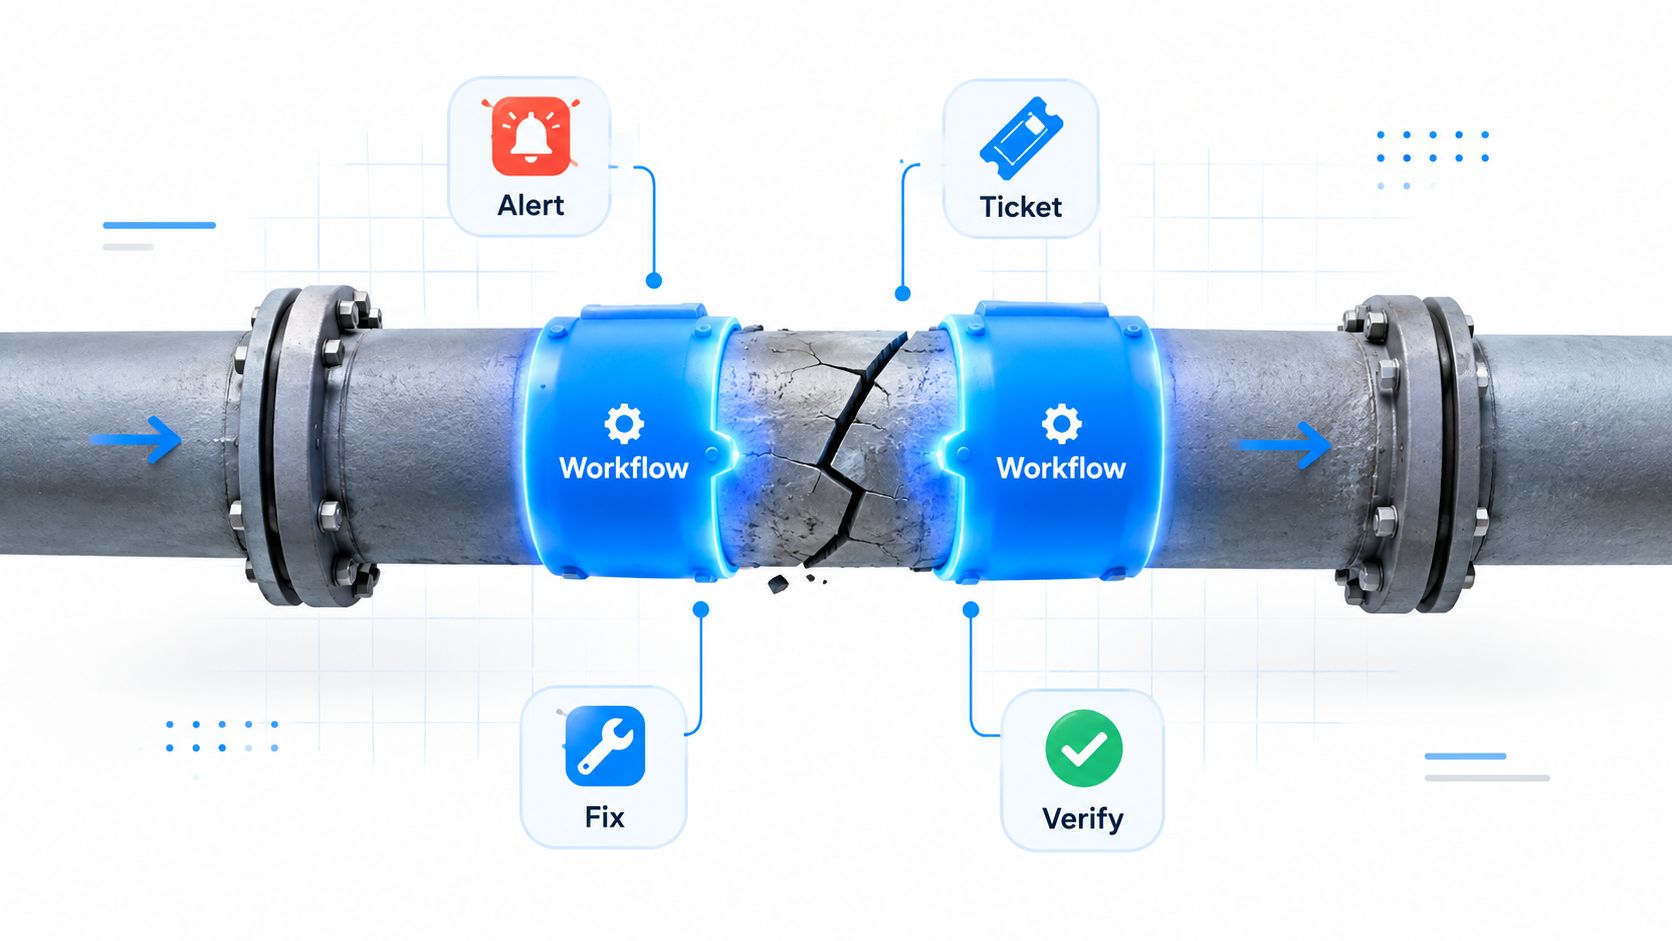
Wykrywanie bez reakcji to kosztowna telemetria. Użyteczny workflow zamienia nieudaną kontrolę w decyzję z przypisaną odpowiedzialnością, z dowodami wystarczającymi, by inna osoba zrozumiała, co się stało, bez odtwarzania całego dochodzenia.
Oddziel naprawę techniczną od przeglądu semantycznego
Zepsuty pipeline i zmienione znaczenie biznesowe wymagają innych osób reagujących. Inżynier może naprawić nieudaną transformację, ale to właściciel biznesowy musi zdecydować, czy nowy segment klientów należy do populacji KPI. Kierowanie obu incydentów do tej samej kolejki spowalnia przywracanie działania i rozmywa odpowiedzialność.
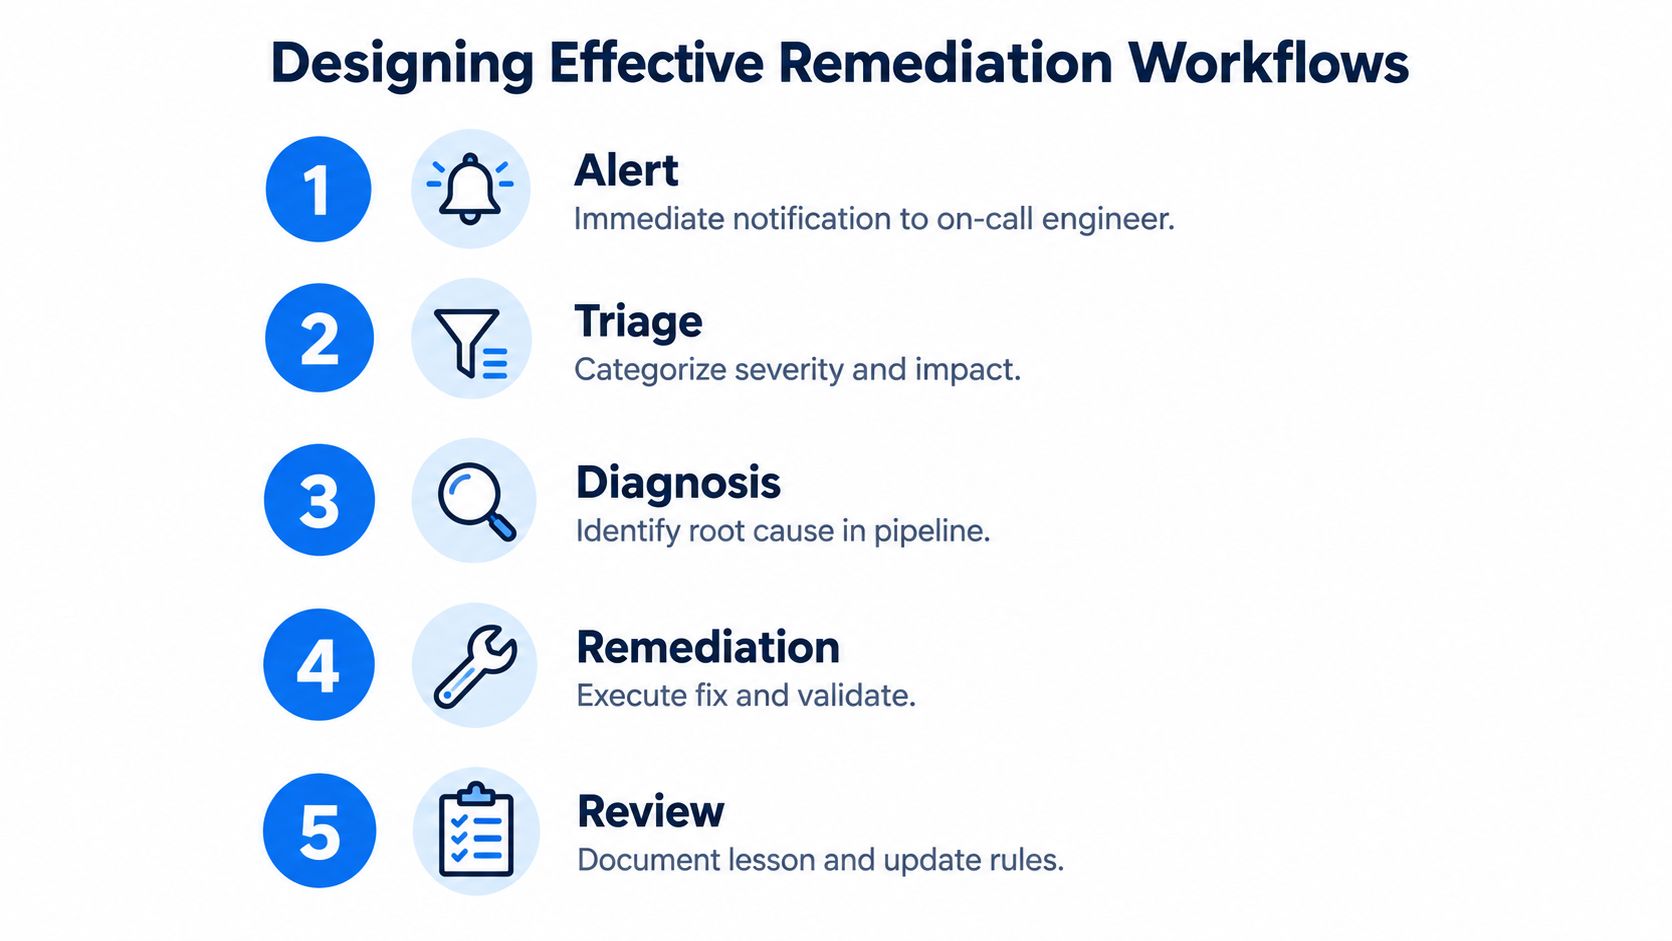
Stosuj wspólny workflow z różnymi ścieżkami decyzyjnymi:
Alert: Zapisz nieudaną kontrolę, dotknięty KPI, przedział danych i kontekst wykrycia.
Triaż: Określ wagę, dotkniętych odbiorców i wpływ na decyzje oraz to, czy publikację należy wstrzymać.
Diagnoza: Prześledź problem przez systemy źródłowe, transformacje, dane referencyjne, definicje i ostatnie zmiany w biznesie.
Naprawa: Popraw źródło lub logikę, w razie potrzeby przelicz wskaźnik i zwaliduj wyniki w dalszych etapach.
Przegląd: Zapisz przyczynę źródłową, decyzję właściciela, dowody, działania zapobiegające powtórce i zamknięcie.
Właściciel powinien wyraźnie odnotować, kiedy anomalia zostaje uznana za uzasadnioną. Takie zatwierdzenie chroni organizację przed ciągłym wracaniem do znanego zdarzenia biznesowego i zachowuje uzasadnienie dla audytorów i przyszłych analityków.
Obowiązki korekty jako cele usługowe
Dane osobowe wprowadzają konkretny wymóg operacyjny. Zgodnie z art. 5 RODO dane osobowe muszą być prawidłowe i w razie potrzeby uaktualniane. Organizacje muszą podejmować rozsądne działania, aby bez zwłoki sprostować lub usunąć nieprawidłowe dane, jednocześnie ograniczając dane do tego, co niezbędne do celu, i przechowując je tylko tak długo, jak to konieczne. Rozporządzenie jest dostępne w tekście RODO w serwisie EUR-Lex.
Wytyczne Komisji Europejskiej dotyczące wniosków osób fizycznych stanowią, że gdy osoba prosi organizację o sprostowanie nieprawidłowych danych osobowych, organizacja musi działać bez zbędnej zwłoki, co do zasady w ciągu jednego miesiąca, albo pisemnie uzasadnić odmowę. Dla ładu KPI oznacza to mierzalny cel dla incydentów dotyczących danych osobowych.
Śledź cały cykl życia:
Pole workflow | Pytanie operacyjne |
|---|---|
Przyjęcie | Kiedy wpłynął błąd lub wniosek o korektę? |
Odpowiedzialność | Kto odpowiada za decyzję i naprawę? |
Zakres | Których rekordów, KPI, raportów i wyników AI to dotyczy? |
Naprawa | Co zmieniono i czy poprawiono źródło, czy tylko raport? |
Weryfikacja | Jakie dowody potwierdzają, że korekta zadziałała? |
Zamknięcie | Czy incydent rozwiązano w obowiązującym terminie? |
Dobry workflow nie obiecuje, że każdy incydent będzie prosty. Gwarantuje, że złożoność nie zatrze odpowiedzialności.
Budowanie odpornej strategii jakości KPI
Odporna strategia jakości KPI rośnie razem z organizacją, zamiast próbować od pierwszego dnia modelować każdą możliwą awarię. Zacznij od wskaźników, które napędzają istotne decyzje, a potem rozszerzaj zakres w miarę dojrzewania właścicieli, definicji i procedur obsługi incydentów.
Platforma powinna obsługiwać wiele typów kontroli bez zmuszania zespołów do przebudowy modelu operacyjnego dla każdego z nich. Business monitoring, Timeliness, śledzenie schematów, walidacja na poziomie rekordów, wykrywanie anomalii i analiza historyczna dotyczą różnych rodzajów awarii. Mimo to powinny tworzyć wspólny rejestr incydentów i wspólny model odpowiedzialności.
Skaluj warstwami
Praktyczna ścieżka wygląda tak:
Fundament: Zdefiniuj krytyczne KPI, właścicieli, systemy źródłowe, populacje, mianowniki i zastosowanie w decyzjach.
Niezawodność: Monitoruj aktualność, wolumen, kompletność, poprawność, zmiany schematu i uzgodnienia ze źródłami.
Znaczenie: Wersjonuj definicje, testuj kohorty i filtry, dokumentuj zdarzenia biznesowe i wymagaj akceptacji właściciela.
Reakcja: Dodaj wagi, routing, terminy napraw, przechowywanie dowodów i raportowanie zamknięć.
Optymalizacja: Analizuj powtarzające się incydenty, precyzję alertów, wpływ na decyzje i pokrycie kontrolami.
Wykonywanie w bazie danych pomaga monitorować dane wrażliwe bez zbędnego ich przenoszenia. Modułowe wdrożenie pozwala też organizacji zacząć od konkretnej funkcji, takiej jak wykrywanie anomalii lub Timeliness, a potem rozszerzyć działanie na reguły biznesowe i monitoring schematów, gdy program kontroli udowodni swoją wartość.
Właściwą miarą dojrzałości nie jest liczba skonfigurowanych kontroli. Jest nią to, czy zespoły potrafią szybko i z dowodami odpowiedzieć na cztery pytania: Co się zmieniło? Czy KPI nadal znaczy to, co myślimy? Kto decyduje, co dalej? Skąd wiemy, że problem jest zamknięty?
Traktuj kontrolę jakości KPI jako stałą kontrolę biznesową, a nie funkcję dashboardu. Inżynierowie chronią ścieżkę danych, właściciele biznesowi chronią znaczenie, a zespoły ładu danych sprawiają, że dowody można ponownie wykorzystać w raportowaniu, zgodności i AI. To właśnie ten podział odpowiedzialności sprawia, że czysto wyglądający wskaźnik nie staje się kosztowną błędną decyzją.
digna zapewnia modułową data observability obejmującą wykrywanie anomalii, Timeliness, walidację na poziomie rekordów, zmiany schematu i monitoring biznesowych KPI w Twoim własnym środowisku. Użyj digna, aby połączyć kontrole techniczne z walidacją przydatności do decyzji, procesami obsługi incydentów z jasną odpowiedzialnością i dowodami, na podstawie których Twoje zespoły danych i biznesu mogą działać.
Jeśli Twoje krytyczne KPI wymagają ciągłego nadzoru tuż obok danych, z których powstają, zobacz, jak business monitoring w digna śledzi ruchy wskaźników i kieruje nietypowe zmiany do odpowiedzialnych właścicieli.
Najczęściej zadawane pytania
Czym jest kontrola jakości KPI?
To praktyka sprawdzania, czy wskaźnik biznesowy jest nie tylko technicznie poprawny, ale nadal nadaje się do decyzji, którą wspiera. Łączy kontrole pipeline'u, takie jak schemat, wartości null i wolumen, z testami semantycznymi definicji, mianowników i kohort oraz przeglądem porównywalności przez właściciela biznesowego.
Dlaczego KPI może wprowadzać w błąd, choć pipeline przechodzi wszystkie kontrole?
Ponieważ udany przebieg pipeline'u dowodzi jedynie, że dane zostały przesłane. KPI wzrostu przychodów może być kompletny, aktualny i poprawnie typowany, a mimo to mylić, gdy przejęcie zmienia populację, ruch wynika z podwyżek cen albo mianownik pomija kohortę, która właśnie stała się istotna.
Kto powinien odpowiadać za jakość KPI?
Odpowiedzialność jest wspólna, ale ostatnie słowo w sprawie znaczenia ma właściciel biznesowy. Przewodnik zaleca zapisanie pięciu ról dla każdego krytycznego KPI: właściciela biznesowego, właściciela technicznego odpowiedzialnego za pipeline'y i testy, data stewarda od definicji i lineage, odbiorców zgłaszających problemy oraz audytora.
Czym różni się jakość danych syntaktyczna, semantyczna i pragmatyczna?
Norma ISO 8000-1:2022 rozdziela te trzy poziomy. Jakość syntaktyczna sprawdza zgodność z zatwierdzonym formatem, na przykład schematem i dozwolonymi wartościami. Semantyczna pyta, czy wartości oddają zamierzone pojęcie, co testuje się przez joiny, kohorty i mianowniki. Pragmatyczna sprawdza, czy KPI nadal wspiera swoją decyzję.
Czy anomalie w KPI należy wyciszać automatycznie?
Nie. Detektor anomalii może oznaczyć ruch jako nietypowy, ale nie rozstrzygnie, czy nowa polityka cenowa czyni go prawidłowym. Najpierw trzeba sprawdzić, czy zdarzenie jest rzeczywiste, czy definicja nadal obowiązuje i czy decyzja wymaga przeliczonego wskaźnika. Zaakceptowane anomalie właściciel zapisuje jako uzasadnione zdarzenia biznesowe.



