Czym jest plan naprawczy?
|
6
min. czyt.

Na ekranie widać dashboard, który wygląda źle, a moment nie mógłby być gorszy. Być może tabela przychodów rozjechała się po zmianie w źródle, feed regulacyjny dotarł z opóźnieniem albo wynik modelu przesunął się na tyle, że właściciel biznesowy stracił zaufanie. W takiej chwili pytanie nie dotyczy już tylko tego, co się zepsuło, ale tego, jaka reakcja się obroni, gdy ktoś zapyta, czy problem został naprawiony, opanowany i czy raczej nie wróci.
Szybkie ponowne uruchomienie albo łatka mogą uciszyć problem na dziś. Plan naprawczy zamienia tę reakcję w kontrolowany proces z właścicielem, dowodami i jasnym kryterium zamknięcia. Jeśli zdarzyło się już, że zgłoszenie oznaczono jako zrealizowane, a raport w systemie zależnym nadal budził wątpliwości, ten temat prawdopodobnie leży już na biurku.
Spis treści
Kiedy incydent danych wymaga prawdziwego planu
Poniedziałek zaczyna się od wiadomości na Slacku, a nie od uporządkowanego raportu z incydentu. Dashboard finansowy znowu pokazuje błędne dane, ładowanie do hurtowni się zakończyło, a mimo to liczby nie zgadzają się z systemem źródłowym. Ktoś proponuje ponownie uruchomić pipeline, ktoś inny chce załatać transformację, a właściciel biznesowy chce po prostu, żeby raport przestał zmieniać się co godzinę.
To właśnie tu zwykle zawodzą nieformalne procesy oparte na zgłoszeniach. Ponowne uruchomienie może być właściwym pierwszym krokiem, ale ogranicza jedynie objaw. Nie mówi, czy pierwotną przyczyną była zmiana schematu, błędne mapowanie, brakująca zależność, czy reguła walidacji, która nigdy nie istniała.
Prawdziwy plan zaczyna się od oddzielenia reakcji doraźnej od trwałej poprawki. Traktuje incydent jako proces poparty dowodami, a nie jednorazowe zadanie z polem statusu. Dla zespołów, które prowadzą już strony problemów takie jak digna data quality issues, ta zmiana jest prosta w teorii i trudna w praktyce: wpis musi przejść od „coś nie zadziałało” do „ta awaria jest zrozumiana, przypisana, poprawiona i zweryfikowana”.
Zgłoszenie może rejestrować aktywność. Plan naprawczy musi dowieść, że ryzyko spadło.
To rozróżnienie ma znaczenie, ponieważ zaufanie buduje się na zamknięciu, którego można bronić. Jeśli pipeline zostanie naprawiony, ale nikt nie sprawdzi odświeżenia w systemach zależnych, plan nie jest ukończony, jest tylko cichszy. W dalszej części artykułu stosujemy surowsze kryterium, zgodne ze sposobem pracy doświadczonych zespołów danych pod realną presją.
Podstawowa definicja każdego planu naprawczego
Plan naprawczy to kontrolowany, oparty na dowodach zestaw działań, który usuwa pierwotną przyczynę wykrytej niezgodności, przywraca dotknięty proces lub dane, zapobiega nawrotom i dowodzi, że poprawka zadziałała. Ta definicja jest ważna, ponieważ wymusza zadanie czterech różnych pytań, a nie jednego. Co się stało, co to spowodowało, co zmieniliśmy i skąd wiemy, że problem pozostał rozwiązany?
Wyobraźmy sobie cieknącą rurę. Można zetrzeć wodę z podłogi, dokręcić złączkę, sprawdzić instalację, a potem przez jakiś czas obserwować, czy woda znów się nie pojawi. Wycieranie to ograniczenie skutków, dokręcenie złączki to korekta, kontrola to weryfikacja, a obserwacja to zamknięcie z pewnością. W pracy z danymi obowiązuje ta sama kolejność, gdy wadliwe ładowanie, nieaktualna partycja albo uszkodzony schemat zaczynają wpływać na raportowanie.

Cztery etapy, które zapewniają rzetelność pracy
Ograniczenie skutków zapobiega dalszym szkodom. Może to oznaczać zamrożenie uszkodzonej tabeli, wstrzymanie publikacji do odbiorców BI albo przekierowanie użytkowników do ostatniego znanego poprawnego snapshotu na czas analizy.
Trwała korekta usuwa przyczynę źródłową. Na platformie danych może to być poprawka SQL, zmiana mapowania źródła, aktualizacja kontraktu schematu albo uzupełnienie brakującej zależności w orkiestracji.
Weryfikacja dowodzi, że poprawka działa. Sprawdza się tu liczby wierszy, reguły biznesowe, zgodność schematu i odświeżenia w systemach zależnych, zamiast zakładać, że sama zmiana wystarczyła.
Zamknięcie następuje dopiero wtedy, gdy istnieją dowody, a właściciel wyrazi akceptację. Wszystko wcześniej to wyłącznie wygoda administracyjna.
Wyraźny podział ma znaczenie, ponieważ działania naprawcze to nie to samo co reagowanie na incydenty ani rutynowe utrzymanie. Reagowanie na incydenty zatrzymuje krwawienie. Utrzymanie dba o zdrowie systemów. Działania naprawcze znajdują się pośrodku: coś już zawiodło, a zespół musi wykazać, że awaria została usunięta.
W szerszych modelach operacyjnych jakości danych digna data quality management naturalnie łączy się z tą ideą, ponieważ zarządzanie jakością zapewnia kontekst wykrywania i kontroli, a plan naprawczy obsługuje proces korygujący.
Kluczowe elementy skutecznego planu
Plan szybko się rozpada, gdy jest zbyt ogólny, by go wykonać. „Naprawić tabelę” brzmi jak działanie, ale nikt nie wie, kto za to odpowiada, co się zmieniło ani kiedy poprawkę uznać za zakończoną. Skuteczny plan musi zawierać tyle kontekstu, by inny inżynier mógł go przejąć bez zgadywania.
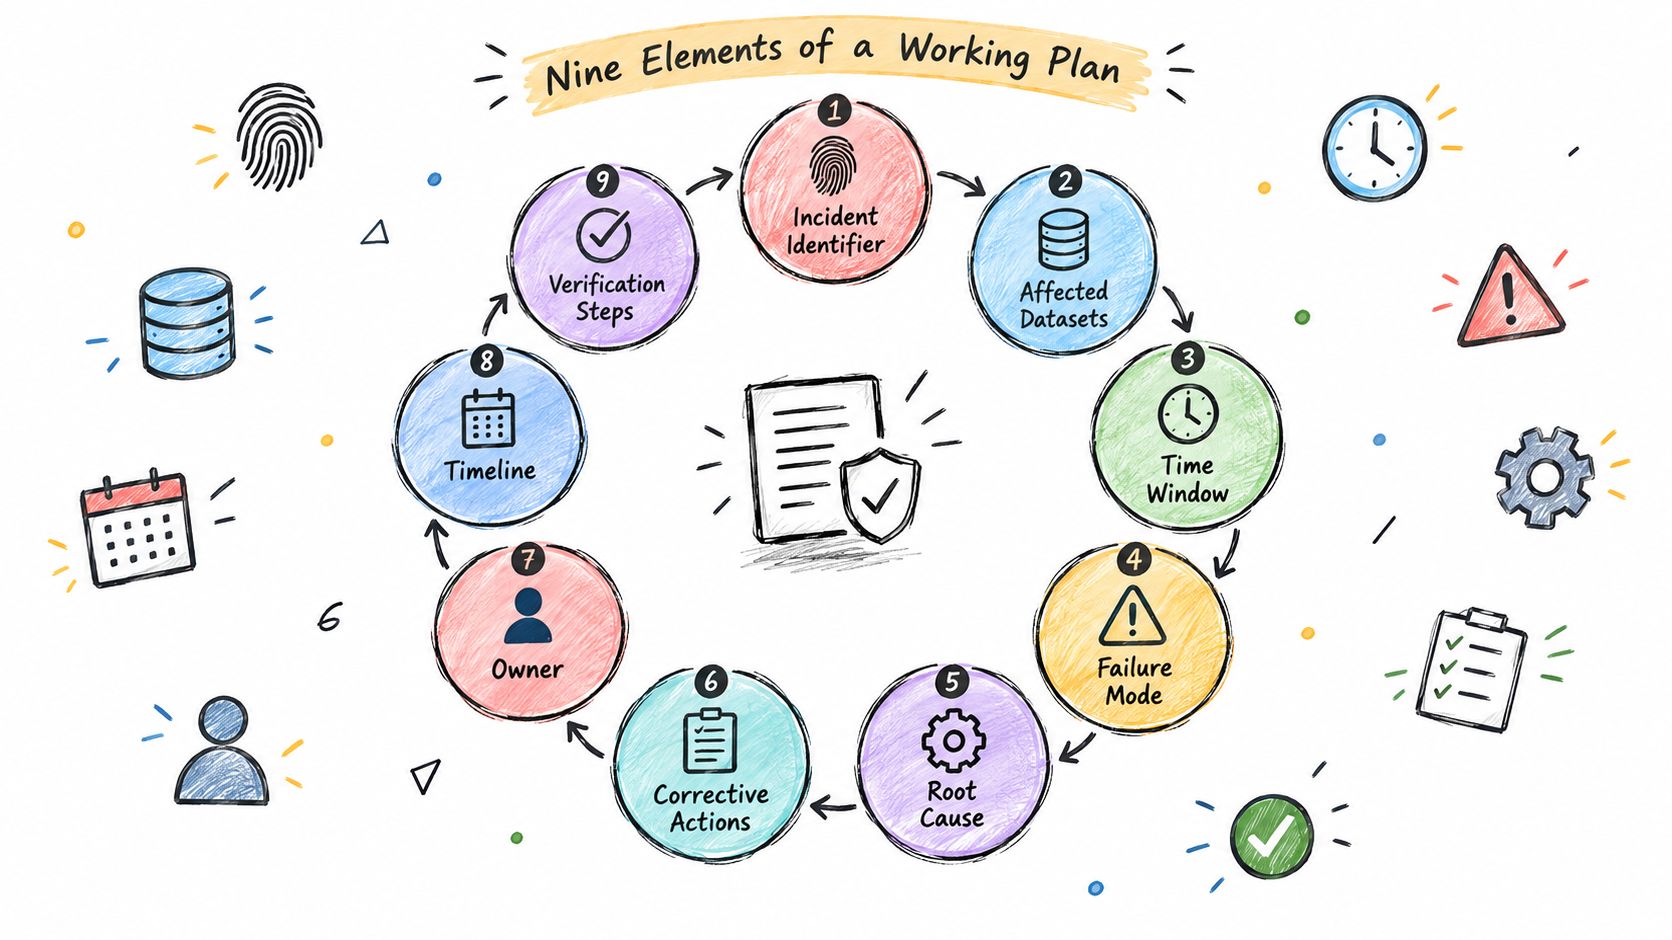
Pola, które zapobiegają niejasnościom
Identyfikator incydentu. Nadaje problemowi stałe odniesienie, dzięki czemu logi, wątki na czacie i zgłoszenia wskazują to samo zdarzenie.
Dotknięte zbiory danych i okno czasowe. Bez tego łatwo poprawić niewłaściwą partycję, przeoczyć zależność w systemach zależnych albo nadmiernie skorygować dane historyczne, których problem nie dotyczył.
Rodzaj awarii. Należy nazwać charakter problemu, na przykład opóźnione dostarczenie, uszkodzony schemat, nieprawidłowe wartości albo cichy dryf metryki.
Wpływ na biznes. Trzeba określić, na co wpłynęła awaria, ponieważ błędna metryka wewnętrzna i spóźniony feed regulacyjny nie mają tej samej pilności.
Hipoteza przyczyny. Należy zapisać, co zespół uważa za przyczynę awarii, nawet jeśli ta hipoteza jest jeszcze sprawdzana.
Właściciel. Jedna odpowiedzialna osoba, a nie kolejka zespołów.
Priorytet. Określa kolejność, gdy otwartych jest kilka planów.
Zależności. Trzeba wskazać, co musi nastąpić najpierw, na przykład poprawki w systemach źródłowych, zatwierdzenie dostępu lub koordynacja backfillu.
Metoda wycofania zmian. Jeśli korekta pogorszy sytuację, zespół potrzebuje bezpiecznej drogi powrotu.
Docelowa data ukończenia. Terminy wymuszają jawne kompromisy.
Kryteria akceptacji. To jest bramka. Jeśli nie da się ich zdefiniować, nie da się udowodnić zamknięcia.
Zasada praktyczna: jeśli plan nie określa, jak zostanie zweryfikowany sukces, nie jest jeszcze planem naprawczym, tylko listą zadań.
W praktyce często brakuje dwóch elementów i oba są kosztowne. Brak właściciela prowadzi do dryfu, bo każdy zakłada, że zajmuje się tym ktoś inny. Brak kryterium akceptacji prowadzi do pozornych zamknięć, bo zgłoszenie można zamknąć, nawet gdy problem nadal tkwi w danych.
Dla higieny procesu istotny jest digna's data quality issue management process, ponieważ plan musi przetrwać przekazania między osobami, a nie tylko wstępną selekcję.
Priorytetyzacja i etapowanie wielu otwartych planów
Zespoły rzadko mają tylko jeden otwarty plan naprawczy. Mają ich kilka, a niektóre konkurują o tych samych ludzi, to samo okno wdrożeniowe i tę samą uwagę kierownictwa. Sortowanie według wieku zgłoszenia jest łatwe, ale to słaby sposób na decyzję, co naprawić najpierw.
Kryteria priorytetyzacji konkurujących planów naprawczych | Dlaczego to ważne | Wyraźny sygnał pilności |
|---|---|---|
Wpływ na biznes | Wpływa na przychody, raportowanie, zaufanie klientów lub jakość decyzji | Kluczowe raporty dla zarządu są błędne lub niedostępne |
Ekspozycja regulacyjna | Tworzy ryzyko audytowe, zgodności lub sprawozdawcze | Obowiązkowy feed lub kontrola jest opóźniona albo niewiarygodna |
Krytyczność danych | Niektóre zbiory danych zasilają wielu odbiorców w systemach zależnych | Problem dotyczy szeroko wykorzystywanych danych źródłowych |
Prawdopodobieństwo nawrotu | Poprawka, która nie działa trwale, powoduje powtarzające się incydenty | Ta sama wada wciąż powraca |
Liczba zależności | Więcej zależności zwykle oznacza szerszy zasięg skutków | Od problemu zależy kilka pipeline'ów lub zespołów |
Czas do wystąpienia szkody | Niektóre problemy szybko narastają | Dane staną się bezużyteczne w ciągu następnego cyklu |
Dlaczego etapy mają znaczenie, gdy szybka poprawka nie wystarcza
Tymczasowa łatka może dziś przywrócić działanie usługi, a mimo to pozostawić pierwotną przyczynę nietkniętą. Dlatego ograniczenie skutków, trwała korekta i weryfikacja wymagają osobnego potraktowania. Jeśli spóźniony feed zostanie przekierowany ręcznie, zespół mógł utrzymać działanie biznesu, ale luka u podstaw istnieje nadal, dopóki automatyzacja lub źródło nie zostaną naprawione.
Trudniejsza decyzja pojawia się wtedy, gdy natychmiastowe ograniczenie skutków koliduje z trwałą korektą. Być może da się szybko ponownie odtworzyć zdarzenia, ale zrobienie tego przed poprawieniem kontraktu schematu może spowodować drugą awarię. W takim przypadku dobry plan mówi „nie” najszybszemu obejściu i „tak” kolejności, która zmniejsza ryzyko.
Administracyjne zamknięcie nie dowodzi naprawy. Dowodzą jej wyłącznie zweryfikowane dowody.
To rozróżnienie ma znaczenie na platformach danych, ponieważ praca może wyglądać na ukończoną na długo przed zniknięciem ryzyka. Dashboard może się odświeżyć, pipeline może przestać zgłaszać błędy, a zgłoszenie może zostać zamknięte. Jeśli jednak wyniki nie zostały uzgodnione, w praktyce plan jest nadal otwarty.
Gdy interesariusze pytają, dlaczego jeden problem ma pierwszeństwo przed innym, warto wyjaśniać kompromis w kategoriach biznesowych, a nie liczby zgłoszeń. Priorytet powinno otrzymać ustalenie, które może zaszkodzić szybciej, rozprzestrzenić się dalej lub naruszyć kontrolę, zanim zespół zajmie się problemem kosmetycznym, który jedynie wygląda nieporządnie.
Dwa playbooki dla typowych problemów z jakością danych
Dobry plan staje się realny w chwili, gdy można go zastosować do rzeczywistej awarii. Szczegóły się różnią, ale kolejność pozostaje ta sama: wykryć, ograniczyć skutki, skorygować, zwalidować, a następnie udowodnić, że poprawka utrzymała się wystarczająco długo, by można jej było zaufać.
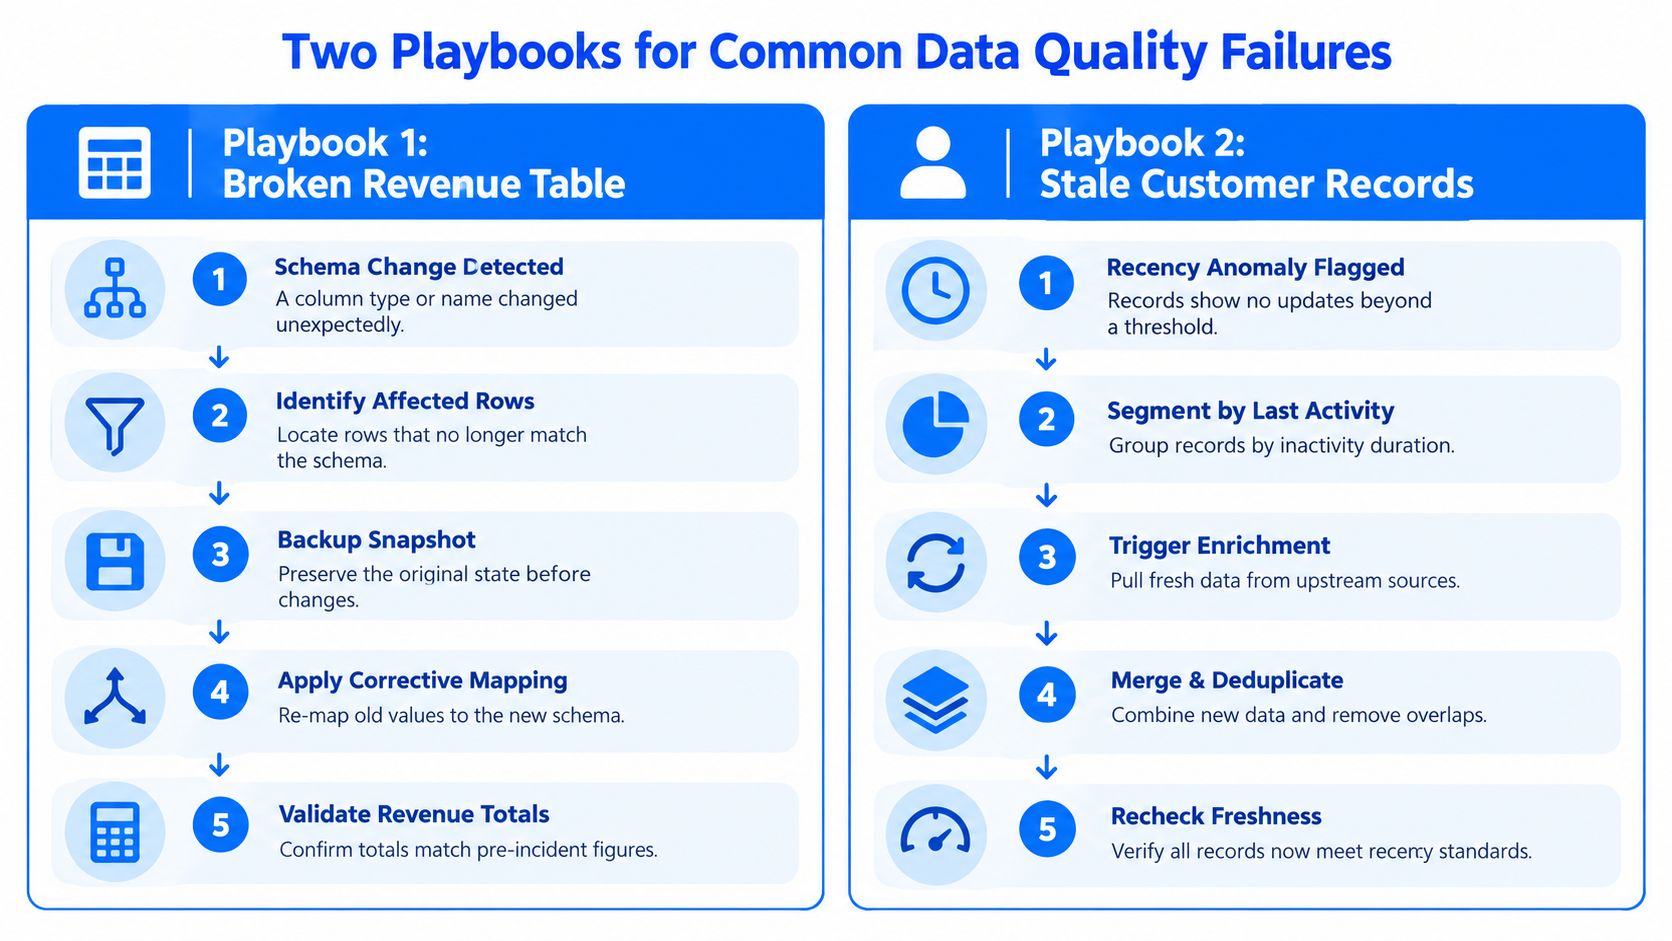
Playbook 1: uszkodzona tabela przychodów
System źródłowy z dnia na dzień zmienia typ kolumny, a tabela przychodów zaczyna ładować niepełne lub nieprawidłowe wartości. Najpierw zespół ogranicza zasięg skutków, wstrzymując publikację do systemów zależnych lub zamrażając wadliwą partycję. Następnie izoluje dotknięte wiersze, zachowuje stan pierwotny i poprawia mapowanie, aby nowy schemat był prawidłowo obsługiwany.
Potem przychodzi walidacja. Zespół sprawdza, czy sumy przychodów zgadzają się z autorytatywnym źródłem, czy naprawione rekordy ładują się bez błędów i czy odświeżenia w systemach zależnych kończą się powodzeniem bez ręcznej interwencji. Zamknięcie następuje dopiero po pozytywnym wyniku tych kontroli i akceptacji właściciela.
digna data completeness checks mają tu znaczenie, ponieważ niekompletne dostarczenie danych lub częściowy backfill mogą sprawić, że tabela wygląda na naprawioną, choć nadal brakuje w niej rekordów.
Playbook 2: nieaktualne rekordy klientów
Cichy spadek aktualności danych klientów nie zawsze wywołuje wyraźną awarię. Model nadal działa, ale dane wejściowe starzeją się i stają się mniej wiarygodne. W takim przypadku pierwszym krokiem jest oznaczenie anomalii aktualności, a następnie segmentacja dotkniętych rekordów według czasu nieaktywności, aby zespół widział, jak daleko sięga problem.
Następnie właściciel uruchamia wzbogacanie danych ze źródeł, scala nowe informacje i usuwa duplikaty. Ostatnim krokiem nie jest samo „zadanie się zakończyło”, lecz ponowna kontrola, która potwierdza, że rekordy spełniają teraz standard aktualności, a model w systemie zależnym otrzymuje poprawione dane wejściowe.
Jak powinny wyglądać dowody zamknięcia
Uszkodzona tabela przychodów: uzgodnione sumy, czyste backfille, brak krytycznych błędów walidacji i udane odświeżenia w systemach zależnych.
Nieaktualne rekordy klientów: przywrócona aktualność, zakończona deduplikacja i monitorowane przebiegi pokazujące, że problem nie wrócił w kolejnym cyklu.
Różnica między zamkniętym zgłoszeniem a zamkniętym planem jest prosta. Zgłoszenie mówi, że ktoś nad nim pracował. Plan mówi, że wyniki znów są wiarygodne.
Jak digna dostarcza dowody do planu naprawczego
Plan naprawczy staje się znacznie mocniejszy, gdy sygnał o incydencie od razu niesie ustrukturyzowane dowody. Nie oznacza to, że platforma zamknie problem za zespół, ale że plan zaczyna się od lepszych danych wejściowych i mniejszej liczby domysłów. Właściciel poświęca mniej czasu na odtwarzanie tego, co się stało, a więcej na decyzję, co z tym zrobić.
Które dane wejściowe trafiają w które miejsce
Data Anomalies i Timeliness zasilają początkowe pola planu. Pomagają ustalić, co się zmieniło, kiedy się zmieniło i czy problemem jest opóźnienie, brakujące ładowanie, czy nietypowy wzorzec wymagający analizy.
Schema Tracker wspiera hipotezę przyczyny. Jeśli kolumnę dodano, usunięto lub zmieniono jej typ, plan może wskazać dokładną zmianę strukturalną, zamiast zgadywać na podstawie objawów w systemach zależnych.
Data Validation pomaga zdefiniować kryteria akceptacji. Jeśli przed zamknięciem musi być spełniona reguła biznesowa na poziomie rekordu, plan może wprost wskazać tę regułę, zamiast polegać na tym, że ktoś oceni dashboard na oko.
Business Monitoring i Data Platform Observability w ogóle wychwytują sygnał. Pokazują, czy metryka biznesowa, zachowanie obciążeń lub stan platformy wyszły poza oczekiwany zakres, co daje właścicielowi czystszy punkt wyjścia do wpisu o incydencie.
Dla zespołów korzystających z digna data quality observability praktyczna wartość leży w ścieżce dowodowej. Plan może zawierać dotknięte zbiory danych, oczekiwane okna dostarczenia, zmiany schematu, wyniki walidacji i kontekst historyczny bez ręcznego odtwarzania tego kontekstu z rozproszonych logów.
Co się zmienia, gdy dowody są dostępne
Właściciele decydują szybciej, ponieważ rodzaj awarii jest jaśniejszy.
Kryteria akceptacji są precyzyjniejsze, ponieważ wiążą się z walidacją i obserwowanym zachowaniem.
Eskalacja przebiega sprawniej, ponieważ plan pokazuje, czy problem jest lokalny, systemowy czy powtarzający się.
Przegląd audytowy jest łatwiejszy, ponieważ wpis zawiera dowody stojące za korektą, a nie tylko podjęte działanie.
Działania naprawcze przestają być nieformalnym procesem i stają się procesem audytowalnym. Dowody nie zastępują osądu, ale sprawiają, że można go obronić.
Prawidłowe zamykanie planu i częste nieporozumienia
Zamknięte zgłoszenie to nie to samo co zakończona naprawa. Zespoły wpadają w kłopoty, gdy traktują działanie jako dowód, bo działanie to dopiero początek. Kluczowe pytanie brzmi, czy dane, proces i odbiorcy w systemach zależnych są stabilni po wprowadzeniu poprawki.
Czego wymaga rzeczywiste zamknięcie
Plan powinien zostać zamknięty dopiero wtedy, gdy kryteria akceptacji są spełnione, dowody zachowane, a właściciel odnotował akceptację. Jeśli incydent był na tyle poważny, że wymagał ograniczenia skutków, powinien działać także monitoring po zamknięciu. Ten monitoring to siatka bezpieczeństwa, która pokazuje, czy wada nie powróciła.
Częste nieporozumienia przybierają zwykle trzy formy. Po pierwsze, ponowne uruchomienia traktuje się jak poprawki, choć w rzeczywistości są tylko etapem ograniczenia skutków. Po drugie, łatki schematu uznaje się za trwałe korekty, nawet jeśli nikt nie sprawdził zgodności w systemach zależnych. Po trzecie, zespoły pomijają monitoring skuteczności i zakładają, że brak alertów oznacza zniknięcie problemu.
Jeśli nie da się wyjaśnić, jak zweryfikowano poprawkę, nie ma zamknięcia, jest tylko optymizm.
Lepszy przegląd zadaje kilka krótkich pytań, zanim ktokolwiek oznaczy plan jako zakończony. Czy poprawka usunęła pierwotną przyczynę, a nie tylko objaw? Czy dane wróciły do normy w dotkniętym oknie czasowym? Czy odbiorcy w systemach zależnych przeszli walidację? Czy problem nie pojawił się w kolejnych przebiegach, a nie tylko w pierwszym po zmianie?
Takie kryterium chroni zespół przed przedwczesnym zamknięciem i daje kierownictwu lepszą odpowiedź, gdy pyta, czy praca zmniejszyła ryzyko. Ułatwia też przekazanie do następnego problemu, ponieważ wzorzec dowodów staje się częścią tego, jak organizacja się uczy. Kolejnym przydatnym tematem są kryteria akceptacji dla incydentów jakości danych, bo właśnie tam wiele planów wciąż zawodzi na ostatnim kroku.
digna pomaga zespołom danych zamieniać incydenty w działania naprawcze oparte na dowodach, dzięki monitoringowi, walidacji, Timeliness i śledzeniu schematów, które zasilają jaśniejsze plany i czystsze zamknięcia. Jeśli celem jest przejście od nieformalnej obsługi zgłoszeń do kontrolowanego procesu, warto odwiedzić digna i sprawdzić, jak platforma wspiera ten proces we własnym środowisku.
Kryteria akceptacji zabezpieczają zamknięcie tylko wtedy, gdy istnieją jako wykonywalne kontrole. Jak przekształcić je w reguły, które przechodzą lub nie przechodzą na rzeczywistych rekordach, pokazuje poradnik jak projektować reguły walidacji danych.
Najczęściej zadawane pytania
Czym jest plan naprawczy w zarządzaniu jakością danych?
Plan naprawczy to kontrolowany, oparty na dowodach zestaw działań, który usuwa pierwotną przyczynę wykrytej niezgodności, przywraca dotknięte dane lub proces, zapobiega nawrotom i dowodzi, że poprawka zadziałała. W odróżnieniu od zgłoszenia, które tylko rejestruje aktywność, musi wykazać, że ryzyko faktycznie spadło.
Jakie są etapy planu naprawczego?
Są cztery: ograniczenie skutków, trwała korekta, weryfikacja i zamknięcie. Ograniczenie skutków zatrzymuje szkody, na przykład przez zamrożenie uszkodzonej tabeli. Korekta usuwa przyczynę, np. poprawką SQL lub mapowania. Weryfikacja sprawdza liczby wierszy, reguły i odświeżenia w systemach zależnych, a zamknięcie następuje dopiero po zebraniu dowodów i akceptacji właściciela.
Co powinien zawierać plan naprawczy?
Co najmniej identyfikator incydentu, dotknięte zbiory danych i okno czasowe, rodzaj awarii, wpływ na biznes, hipotezę przyczyny, jednego właściciela, priorytet, zależności, metodę wycofania zmian, termin docelowy i kryteria akceptacji. Najczęściej brakuje właściciela i kryteriów akceptacji, co prowadzi do przeciągania sprawy i pozornych zamknięć.
Jak ustalać priorytety wielu otwartych planów naprawczych?
Według ryzyka, a nie wieku zgłoszenia. Należy ocenić wpływ na biznes, ekspozycję regulacyjną, krytyczność danych, prawdopodobieństwo nawrotu, liczbę zależności i czas do wystąpienia szkody, a następnie najpierw naprawić to, co może zaszkodzić szybciej, rozprzestrzenić się dalej lub naruszyć kontrolę, zanim zajmie się problemem jedynie wyglądającym nieporządnie.
Kiedy można zamknąć plan naprawczy?
Dopiero gdy kryteria akceptacji są spełnione, dowody zachowane, a właściciel odnotował akceptację. Ponowne uruchomienie procesu to ograniczenie skutków, a nie naprawa, a brak alertów sam w sobie niczego nie dowodzi. Przy poważnych incydentach potrzebny jest więc także monitoring po zamknięciu w kolejnych przebiegach.


