Reguły walidacji danych: Praktyczny przewodnik projektowania
|
5
min. czyt.

Można poznać, że rurociąg danych ma kłopoty, gdy pulpit nawigacyjny technicznie działa, liczby są technicznie widoczne, a biznes wciąż nie może zaufać ani jednemu wierszowi na ekranie. Jedna błędna wartość referencyjna, jedno brakujące pole lub jeden rekord, który prześlizgnie się przez pobieżną regułę, wystarczy, aby piątkowy przegląd zamienił się w sesję archeologiczną. Zwykle w tym momencie ludzie uświadamiają sobie, że problemem nie jest sam raport, ale brak reguł walidacji danych, które zostały zaprojektowane, przetestowane i zarządzane jak prawdziwy kod produkcyjny.
Walidacja działa najlepiej, gdy przestaje się ją traktować jako zadanie biurowe, a zaczyna jako umowę. Sformułowanie Eurostatu jest bezlitosne: jeśli kombinacja wartości nie znajduje się w zaakceptowanym zestawie, kończy się to niepowodzeniem, a reguła musi być jednoznacznie zdefiniowana i udokumentowana, aby producenci i odbiorcy mieli takie samo zrozumienie stosowanej kontroli. Jest to znacznie czystsza podstawa do audytowalności i Data Governance niż niejasny i oparty na dobrych chęciach filtr (Wytyczne Eurostatu dotyczące walidacji danych). Jeśli chcesz poznać tę samą ideę w praktycznym kontekście produktowym, ten przegląd walidacji danych czyni cykl życia bardziej konkretnym, nie łagodząc przy tym realiów operacyjnych.
Dlaczego Twoje dane po cichu Cię okłamują
Najgorsze awarie danych rzadko ogłaszają się same. Raport nadal się ładuje, wykres nadal się renderuje i wszyscy zakładają, że liczby są „wystarczająco zbliżone”, dopóki na spotkaniu nie pojawi się wyjątek i ktoś będzie musiał wyjaśnić, dlaczego wczorajsze dane nie pokrywają się z dzisiejszym wyciągiem. Ręczne wyrywkowe kontrole nie rozwiążą takiego problemu, ponieważ błędne wiersze zazwyczaj ukrywają się wewnątrz tych, które wyglądają normalnie.
Walidacja to pakt, a nie filtr
Oto dlaczego walidacja na poziomie rekordu ma znaczenie. Zmienia ona rozmyte oczekiwanie we wspólną regułę i daje zespołom inżynieryjnym i biznesowym ten sam język opisywania błędów. Eurostat definiuje walidację danych jako sprawdzanie, czy kombinacja wartości należy do zaakceptowanego zestawu, a jego wytyczne mówią, że reguły muszą być jasno i jednoznacznie zdefiniowane, udokumentowane oraz dostosowane do celu, aby każdy mógł interpretować wynik w ten sam sposób (Wytyczne Eurostatu dotyczące walidacji danych).
Nieudana walidacja powinna informować o tym, która reguła biznesowa została złamana, a nie tylko o tym, że wiersz zdenerwował bazę danych.
Ta różnica zmienia sposób pracy zespołów. Błędny rekord to nie tylko „brudne dane”, to dowód na to, że naruszono ograniczenie biznesowe, założenie dotyczące schematu lub obowiązek sprawozdawczy. To jest główna wartość reguł walidacji danych: tworzą one mierzalne punkty kontrolne, zamiast zamieniać jakość w mglistą obietnicę.
Operacyjną korzyścią jest przewidywalność. Gdy reguły są dokumentowane i konsekwentnie egzekwowane, producenci danych wiedzą, co muszą wysłać, a odbiorcy wiedzą, jakiego rodzaju danym mogą zaufać. Jeśli kiedykolwiek obserwowałeś(-aś), jak rurociąg „w większości działa” przez miesiące, zanim ukryty przypadek brzegowy wysadził pulpit nawigacyjny, już wiesz, dlaczego ta dyscyplina się opłaca.
Anatomia reguł walidacji na poziomie rekordu
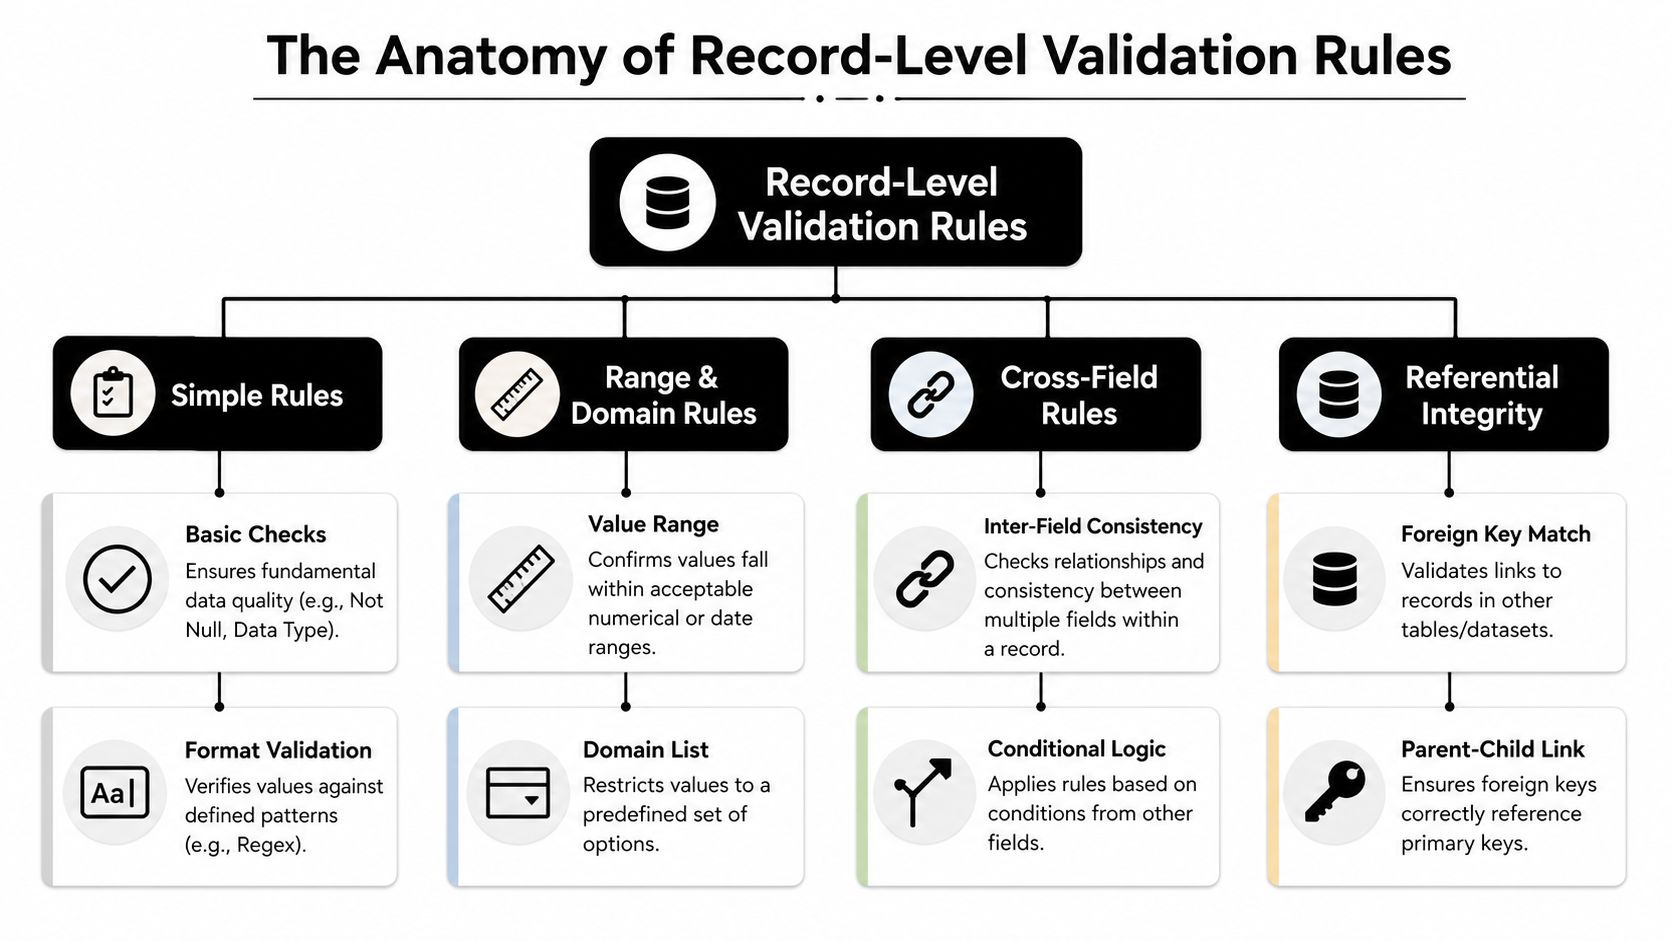
Przed napisaniem kodu potrzebujesz mapy rodzin reguł, z których będziesz korzystać. Standardowy przepływ pracy grupuje kontrole na walidację formatu, sprawdzanie zakresów, walidację schematu i walidację między polami, co stanowi użyteczny punkt wyjścia, ponieważ zmusza do oddzielenia problemów ze składnią od problemów z logiką biznesową (Przepływ pracy walidacji danych Atlan). To oddzielenie sprawia, że Twoje ramy pozostają zrozumiałe, co ma większe znaczenie niż brzmienie zaawansowane.
Zacznij od prostych kontroli
Najprostsze reguły to zazwyczaj te, które należy wdrożyć jako pierwsze. Obecność wartości Null, typ danych oraz walidacja formatu wychwytują błędy, których odrzucenie jest tanie, a późniejsze sprzątanie bolesne. Jeśli e-mail nie pasuje do oczekiwanego wzorca lub data pojawia się w złej postaci, nie ma sensu pozwalać temu rekordowi płynąć dalej tylko dlatego, że reszta wiersza wygląda dobrze.
Następnie dodaj ograniczenia numeryczne i domenowe
Sprawdzanie zakresów to moment, w którym walidacja zaczyna przypominać politykę biznesową, a nie tylko higienę pól. Cena powinna być dodatnia, rabat nie powinien przekraczać ceny, a pole wieku powinno mieścić się w akceptowalnym zakresie, jeśli wymaga tego domena biznesowa. W przypadku przepływów pracy związanych z opieką nad zwierzętami ta sama logika jest przydatna, gdy chcemy zapewnić zgodność dokumentacji medycznej zwierząt, ponieważ brakujące lub nieprawidłowo sformatowane pole może zerwać łańcuch odpowiedzialności, nawet jeśli rekord się „ładuje”.
Nie zapomnij o relacjach między polami
Walidacja między polami (cross-field) to obszar, na którym ludzie zwykle się spalają. Kraju wysyłki nie można traktować w izolacji, jeśli inne pole ma zawierać identyfikator specyficzny dla danego kraju, a flaga statusu może mieć sens tylko w połączeniu z pasującą datą lub kodem. Reguły te są trudniejsze do napisania niż kontrole pojedynczych pól, ale to one również wychwytują subtelne sprzeczności, które w przeciwnym razie sprawiłyby, że raporty wyglądałyby na wewnętrznie spójne, choć nadal byłyby błędne.
Zasada praktyczna: jeśli pole ma sens tylko w kontekście, waliduj je w kontekście.
Integralność referencyjna stoi obok logiki między polami, nawet jeśli wydaje się bardziej natywna dla baz danych niż dla biznesu. Klucz obcy, który nie wskazuje na rzeczywisty wiersz nadrzędny, nadal jest błędem biznesowym, a nie tylko problemem z przechowywaniem danych. Dlatego specyficzne dla domeny zestawy reguł walidacji często zawierają wyraźne kontrole, takie jak ceny dodatnie, brak ujemnych obserwacji i unikalne obserwacje, z których wszystkie są zapisane jako możliwe do zweryfikowania maszynowo warunki, dzięki czemu automatyczna kontrola jakości pozostaje czytelna dla inżynierów (Reguły walidacji domenowej SNStatComp).
Możesz również skorzystać z zorientowanego na platformę spojrzenia na tę anatomię, jeśli potrzebujesz szerszego wzorca korporacyjnego. Model na poziomie rekordu w podejściu digna do walidacji w przedsiębiorstwie jest przydatny właśnie dlatego, że mapuje te rodziny reguł na wykonanie wewnątrz bazy danych, zamiast pozostawiać je jako abstrakcyjne notatki polityki.
Od logiki do kodu
Teoria ma znaczenie dopiero wtedy, gdy reguła pozwala odrzucić błędne zamówienie bez utrudniania przetwarzania dobrych zamówień. Załóżmy, że walidujesz przychodzący rekord orders zawierający order_id, customer_id, price, discount, shipping_country i nif. Chcesz, aby kod był wystarczająco czytelny, by kolejny inżynier nie musiał odtwarzać reguł biznesowych ze stosu efektów ubocznych.
Spraw, aby reguła była oczywista w SQL
Zgrabne ograniczenie CHECK to wciąż najlepsza pierwsza linia obrony przy prostej logice pól.
Daje to jasny tryb zgłaszania błędów w oczywistych przypadkach. Pozwala to również utrzymać regułę blisko modelu danych, co jest ważne, ponieważ łatwo zapomnieć o ukrytej regule walidacji zakopanej w kodzie aplikacji i trudno ją skontrolować.
Używaj logiki między polami, gdy jedna kolumna zależy od innej
Niektóre reguły nie nadają się do zwykłego CHECK, ponieważ wymagają warunkowości. W takim przypadku wyrażenie CASE lub logika typu wyzwalacz (trigger) jest jaśniejsza niż próba wtłoczenia całej reguły biznesowej w jeden predykat.
Ten wzorzec czyni regułę jawną. Jeśli krajem wysyłki jest Hiszpania, rekord potrzebuje oczekiwanego identyfikatora, a jeśli go nie ma, otrzymujesz bezpośredni sygnał błędu zamiast enigmatycznego wyjątku w dalszych etapach.
Testuj unikalność i integralność referencyjną za pomocą zapytań
Kontrole unikalności są łatwiejsze w utrzymaniu, gdy są napisane jako bezpośrednie procedury diagnostyczne, a nie skomplikowany kod proceduralny.
Integralność referencyjna jest równie bezpośrednia.
Te zapytania są nudne w najlepszy możliwy sposób. Mówią dokładnie, co zawiodło, dlatego specyficzne dla domeny reguły walidacji są często wdrażane jako jawne kontrole na poziomie rekordu, takie jak ceny dodatnie, brak ujemnych obserwacji i unikalne obserwacje, z których wszystkie mogą być wykonywane na dużą skalę, pozostając czytelnymi dla inżynierów (Reguły walidacji domenowej SNStatComp).
Jeśli szukasz platformowego przykładu tego stylu, warto przeczytać dyskusję digna na temat ręcznego utrzymywania reguł wraz z własnymi wzorcami SQL, ponieważ istotnym pytaniem nie jest to, czy reguła istnieje, ale jak bezpiecznie można ją utrzymywać w miarę upływu czasu.
Dbaj o to, by komunikat o błędzie był użyteczny
Zła reguła z niejasnym komunikatem generuje tylko dodatkową pracę. „Walidacja nie powiodła się” nikomu nie pomaga, podczas gdy „shipping_country=ES wymaga nif” daje analitykowi i inżynierowi ten sam punkt wyjścia do diagnozy. W praktyce komunikat jest częścią reguły, a nie ozdobą.
Więcej niż „działa” – mądrzejsze strategie testowania
Reguła walidacji, która nie została przetestowana, to tylko teoria z budżetem produkcyjnym. Traktuj ją jak kod aplikacji, bo tym właśnie się staje, gdy potrafi blokować dane, ostrzegać o błędach lub zasilać procesy Compliance. Koszt pomyłki w tym miejscu jest ogromny, ponieważ zepsuta reguła walidacji może odrzucić dobre dane lub, co gorsza, pozwolić złym danym przejść dalej z zielonym światłem.
Testuj regułę warstwowo
Praktyczne podejście zaczyna się od małych rzeczy. Testy jednostkowe wykorzystują niewielki zbiór starannie dobranych rekordów – niektórych poprawnych, innych niepoprawnych – dzięki czemu każdą regułę można sprawdzić w izolacji. To tam wyłapuje się oczywiste błędy, przesunięte o jeden progi, odwrócone kontrole wartości null czy regułę, która przypadkowo flaguje uzasadnione przypadki brzegowe.
Testy integracyjne powinny odbywać się w samym rurociągu. Pokazują, jak reguły zachowują się podczas przygotowywania (staging), transformacji i ładowania, czyli w miejscach, gdzie schludna logika często zaczyna działać chaotycznie. Testy regresyjne chronią następnie istniejące zachowanie przy każdej zmianie reguły, aby nie „naprawić” jednej walidacji, niechcący psując trzech innych.
Rozróżniaj błędy na poziomie plików od błędów na poziomie rekordów
Najbardziej użytecznym wzorcem operacyjnym, jaki widziałem, jest ten stosowany w sprawozdawczości transakcyjnej w UE, gdzie zasady składniowe na poziomie schematu odrzucają cały plik, a zasady dotyczące zawartości odrzucają tylko nieprawidłowe transakcje. Taki podział ogranicza zasięg rażenia i zmniejsza liczbę niepotrzebnych ponownych przesłań (zasady walidacji raportów transakcyjnych ESMA MiFIR).
Nie każ cierpieć całej partii z powodu jednego błędnego wiersza, chyba że sama struktura jest uszkodzona.
Zasada ta jest łatwa do sformułowania i zaskakująco łatwa do zignorowania. Jeśli plik jest uszkodzony, zatrzymaj się wcześnie. Jeśli tylko jedna transakcja narusza logikę biznesową, poddaj rekord kwarantannie lub oznacz go flagą i pozwól reszcie kontynuować proces, zakładając, że pozwalają na to Twoje wymagania procesowe i w zakresie Compliance.
W przypadku poszukiwania przyczyn źródłowych, ten przewodnik po analizowaniu problemów z danymi za pomocą AI może pomóc zespołom przejść od „coś się nie udało” do „ten konkretny wzorzec to spowodował” bez zamieniania każdego incydentu w ręczne dochodzenie.
Prosta macierz testowa
Prawidłowy scenariusz optymistyczny (happy path): zamówienie powinno przejść każdą regułę.
Znany błędny rekord: zamówienie powinno nie przejść dokładnie jednej nazwanej reguły.
Przypadek graniczny: reguła powinna zachowywać się poprawnie przy wartości brzegowej.
Próbka regresyjna: wcześniej zaakceptowany rekord powinien pozostać zaakceptowany po edycji reguły.
To wystarczy, aby zachować rzetelność reguły bez nadmiernego komplikowania środowiska testowego. Jeśli nie potrafisz wyjaśnić, po co istnieje dany test, prawdopodobnie go nie potrzebujesz.
Wdrażanie i zarządzanie regułami bez bólu głowy
Pisanie reguł to łatwa część. Życie z nimi to moment, w którym zaczyna się kluczowa praca projektowa, ponieważ każda zmiana polityki biznesowej niesie ryzyko naruszenia starych założeń. Ramy walidacji, których nie można wersjonować, wyjaśnić i bezpiecznie ponownie uruchomić, ostatecznie staną się rzeczą, której wszyscy unikają dotykać.
Wybierz wzorzec wdrożenia celowo
Model Rygorystycznego Strażnika (Strict Gatekeeper) blokuje błędne rekordy zanim wejdą do systemów niższego szczebla. To właściwy wybór dla rurociągów o wysokim poziomie zaufania, raportowania regulowanego i wszystkiego, co stworzyłoby bałagan, gdyby nieprawidłowe dane rozprzestrzeniły się dalej.
Model Spostrzegawczego Monitora (Observant Monitor) przepuszcza dane, ale flaguje, poddaje kwarantannie lub kieruje błędy do przeglądu. Jest to przydatne, gdy dostępność ma większe znaczenie niż natychmiastowe odrzucenie, lub gdy musisz zaobserwować kształt problemu przed zaostrzeniem kontroli.
Żaden wzorzec nie jest uniwersalnie właściwy. Pilnowanie dostępu (gatekeeping) daje ściślejszą kontrolę, podczas gdy monitorowanie zapewnia odporność i widoczność. Większość dojrzałych zespołów korzysta ostatecznie z obu rozwiązań, ponieważ nie każdy zestaw danych zasługuje na taki sam poziom tarcia.
Uczyń cykl życia reguły jawnym
Reguła powinna mieć wersję, notatkę o zmianie i jasnego właściciela. Potrzebuje również logów pokazujących, kiedy została uruchomiona, co oceniała oraz jak zakończyła się sukcesem lub porażką, ponieważ to jedyny sposób na wsparcie audytów bez zamieniania każdego incydentu w opowieść detektywistyczną. Wytyczne Eurostatu są również przydatne w tym miejscu, ponieważ mówią, że reguły, a nawet komunikaty o błędach, powinny być dokumentowane, aby wszyscy interpretowali błędy w ten sam sposób (Zasady Eurostatu).
Dużym problemem związanym z utrzymaniem jest dryf reguł. Polityka biznesowa ulega zmianom, systemy źródłowe ewoluują, a próg, który kiedyś był rozsądny, może stać się uciążliwością lub ślepym punktem. Przepływ pracy walidacji ArcGIS to dobre przypomnienie, że walidacja ma charakter operacyjny, a nie statyczny, ponieważ reguły często wymagają oceny, kontroli i ponownej oceny po edycji, zwłaszcza gdy schematy i warunki raportowania zmieniają się w czasie (Reguły atrybutów walidacji ArcGIS).
Gdzie platforma może zmniejszyć ból
Platforma może pomóc, gdy liczba reguł, systemów i wyjątków zaczyna przerastać arkusze kalkulacyjne i skrypty ad hoc. Jedną z opcji jest digna, która wykorzystuje deterministyczną biznesową i techniczną logikę walidacji z wykonywaniem reguł wewnątrz bazy danych oraz pełnymi ścieżkami audytu, dając pewność, że kontrole są uruchamiane tam, gdzie znajdują się dane, a dowody są przechowywane na potrzeby audytu i przeglądu regulacyjnego (Wprowadzenie do platformy digna).
Ma to znaczenie, ponieważ walidacja jest przydatna tylko wtedy, gdy ludzie mogą zaufać zarówno wynikowi, jak i procesowi. Dobry interfejs użytkownika jest poręczny, ale głębszym zyskiem jest identyfikowalność – możliwość udzielenia odpowiedzi na pytanie, kto co zmienił, co zawiodło i dlaczego rekord został obsłużony w taki, a nie inny sposób.
Jeśli porównujesz również opcje Observability i wymuszania reguł, ochrona danych badawczych jest przydatną lekturą uzupełniającą, ponieważ skupia się na spójności, a nie tylko na alertach.
Finał: Walidacja jako filar zaufania do danych
Dobra reguła zaczyna się jako potrzeba biznesowa, staje się kodem, jest testowana i ostatecznie funkcjonuje jako monitorowany zasób produkcyjny z właścicielem i ścieżką audytu. Ten cykl życia to różnica między losowymi kontrolami a rzeczywistą postawą governance. Gdy organizacja zacznie postrzegać walidację jako system, a nie łatkę, zaufanie staje się łatwiejsze do zdobycia i łatwiejsze do obrony.
Najzdrowsze zespoły przestają pytać, czy powinny walidować dane, a zaczynają pytać, gdzie powinna znajdować się każda reguła, jak jest wersjonowana i co się dzieje, gdy zawiedzie. Ta zmiana jest tym, co zamienia inżynierów danych w strażników integralności, a nie w ekipy sprzątające. Jeśli potrzebujesz szerszego ujęcia na poziomie kultury organizacyjnej, ten przewodnik po budowaniu nawyków związanych z jakością danych w użyteczny sposób łączy kontrole techniczne z codzienną odpowiedzialnością.
Ostatecznym celem nie są doskonałe dane, ponieważ takie nie istnieją. Ostatecznym celem są przewidywalne dane, widoczne wyjątki i proces, który ujawnia prawdę wystarczająco szybko, aby analitycy, audytorzy i operatorzy mogli na jej podstawie działać. Gdy te elementy są na swoim miejscu, walidacja przestaje być narzutem, a staje się jednym z cichych powodów, dla których Twoja analityka, Compliance i automatyzacja trzymają się razem.
Wezwanie do działania (CTA) dla digna.
Uruchamianie tych reguł na poziomie rekordów bezpośrednio w bazie danych, ze ścieżką audytu pokazującą, co i dlaczego nie przeszło, umożliwia digna Data Validation.
Najczęściej zadawane pytania
Jakie są główne rodzaje reguł walidacji danych?
Artykuł dzieli reguły na walidację formatu, kontrole zakresu, walidację schematu i walidację międzypolową, a obok nich integralność referencyjną. Zacznij od prostych kontroli wartości null, typu i formatu, dodaj ograniczenia liczbowe i dziedzinowe, takie jak dodatnie ceny, a następnie napisz reguły międzypolowe dla pól, które mają sens tylko w kontekście.
Jak napisać regułę walidacji danych w SQL?
Dla prostej logiki pojedynczego pola użyj ograniczenia CHECK w definicji tabeli, np. CHECK (price > 0) lub CHECK (discount <= price). Reguły warunkowe lepiej zapisać w wyrażeniu CASE, które np. oznacza zamówienie jako błędne, gdy shipping_country = 'ES' i nif IS NULL, dzięki czemu reguła biznesowa pozostaje jawna.
Jak testować reguły walidacji danych?
Testuj je jak kod aplikacji, warstwowo: testy jednostkowe na małych, starannie dobranych zbiorach poprawnych i błędnych rekordów, testy integracyjne w pipeline oraz testy regresyjne przy każdej zmianie reguły. Prosta macierz obejmuje ścieżkę poprawną, znany błędny rekord, przypadek brzegowy i próbkę regresyjną.
Czy błąd walidacji powinien odrzucać cały plik?
Tylko wtedy, gdy uszkodzona jest sama struktura. Zgodnie z praktyką raportowania transakcji w UE w ramach MiFIR błędy składni na poziomie schematu odrzucają cały plik, a naruszenia reguł treści odrzucają tylko nieprawidłowe transakcje. Taki podział ogranicza zasięg skutków i pozwala uniknąć zbędnych ponownych przesyłek.
Czym różni się walidacja typu gatekeeper od walidacji monitorującej?
Strict Gatekeeper blokuje błędne rekordy, zanim trafią do systemów downstream, co sprawdza się w raportowaniu regulacyjnym i pipeline'ach wymagających wysokiego zaufania. Observant Monitor przepuszcza dane, ale oznacza błędy, kieruje je do kwarantanny lub do przeglądu. Większość dojrzałych zespołów łączy oba podejścia.



