Welche Ziele verfolgt die Sicherung der Datenintegrität?
|
6
min. Lesezeit
Ein Finanzteam kann einen Quartalsbericht mit ausgefeilten Diagrammen, abgestimmten Summen und der Freigabe der Geschäftsführung veröffentlichen und ihn trotzdem auf eine Tabelle stützen, deren Bedeutung sich bei einem Pipeline-Update geändert hat. Eine umbenannte Spalte, eine fehlende Datei oder eine überschriebene Korrektur kann dazu führen, dass eine vertraute Kennzahl das falsche Geschäftsereignis beschreibt. Bis es jemand bemerkt, speisen dieselben Daten womöglich schon ein operatives Dashboard, eine KI-Funktion und eine Meldung an die Aufsicht.
Deshalb kann die Antwort auf die Frage, welche Ziele die Sicherung der Datenintegrität verfolgt, nicht bei „Daten korrekt halten“ stehen bleiben. Ein tragfähiges Programm muss Genauigkeit, Vollständigkeit, Konsistenz, Nachvollziehbarkeit, Sicherheit und Wiederherstellbarkeit bewahren. Es muss außerdem belegen, dass diese Eigenschaften Transformationen, Korrekturen, Schemaänderungen und die Reaktion auf Vorfälle überstanden haben.
Inhaltsverzeichnis
Warum Datenintegrität ein Bündel von Zielen ist und kein einzelnes Häkchen
Wie sich die Ziele bei regulatorischen, operativen und KI-Anwendungsfällen unterscheiden
Der Zielkonflikt, den die meisten Integritätsleitfäden auslassen
Warum Datenintegrität ein Bündel von Zielen ist und kein einzelnes Häkchen
Datenintegrität wird oft wie eine Statusleuchte behandelt: Grün heißt vertrauenswürdig, Rot heißt kaputt. Echte Datenplattformen funktionieren so nicht. Ein Datensatz kann korrekte Werte enthalten, aber keinen Audit-Trail haben, verspätet, aber vollständig ankommen oder strukturelle Prüfungen bestehen und dabei eine inkonsistente fachliche Definition verwenden.
Nehmen wir eine Tabelle mit Quartalsumsätzen. Die Werte mögen für die eingegangenen Datensätze stimmen, doch eine regionale Datei wurde nie geladen. Der Bericht ist damit unvollständig. Hat ein Quellsystem net_revenue so geändert, dass der Wert nun den Umsatz nach einer anderen Anpassung darstellt, ist die Tabelle zudem inkonsistent mit früheren Perioden. Kann niemand sagen, wann die Änderung passiert ist oder welche Transformation sie angewendet hat, kann das Team das Ergebnis nicht verteidigen.
Genau hier liegt der praktische Unterschied zwischen Datenqualität und Datenintegrität. Qualität fragt, ob Informationen für einen bestimmten Zweck geeignet sind. Integrität fragt, ob sie über ihren gesamten Lebenszyklus vertrauenswürdig, kontrolliert und erklärbar geblieben sind.
Faustregel: Eine bestandene Qualitätsprüfung zeigt, wie die Daten jetzt aussehen. Integritätsnachweise helfen zu erklären, wie sie dorthin gekommen sind.
Die Ziele bauen daher aufeinander auf:
Genauigkeit: Werte bilden das zugrunde liegende Ereignis ab.
Vollständigkeit: Erforderliche Datensätze, Felder und Nachweise sind nicht verschwunden.
Konsistenz: Dieselbe Definition und dieselben Regeln gelten systemübergreifend und über die Zeit.
Nachvollziehbarkeit: Man kann rekonstruieren, wer was wann und warum geändert hat.
Sicherheit: Unbefugter Zugriff oder unbefugte Änderungen werden verhindert oder erkannt.
Wiederherstellbarkeit: Die Organisation kann einen vertrauenswürdigen Zustand wiederherstellen und überprüfen.
Diese Ziele unterstützen Analytics, KI, Finanzberichterstattung, Betrieb und Compliance gleichzeitig. Die richtige Frage ist nicht, ob ein Datensatz einen einzigen Integritätswert hat. Entscheidend ist, welches Ziel an jeder Übergabe gefährdet ist und welcher Nachweis belegt, dass die Kontrolle gegriffen hat.
Das Grundkonzept hinter den Zielen der Datenintegrität
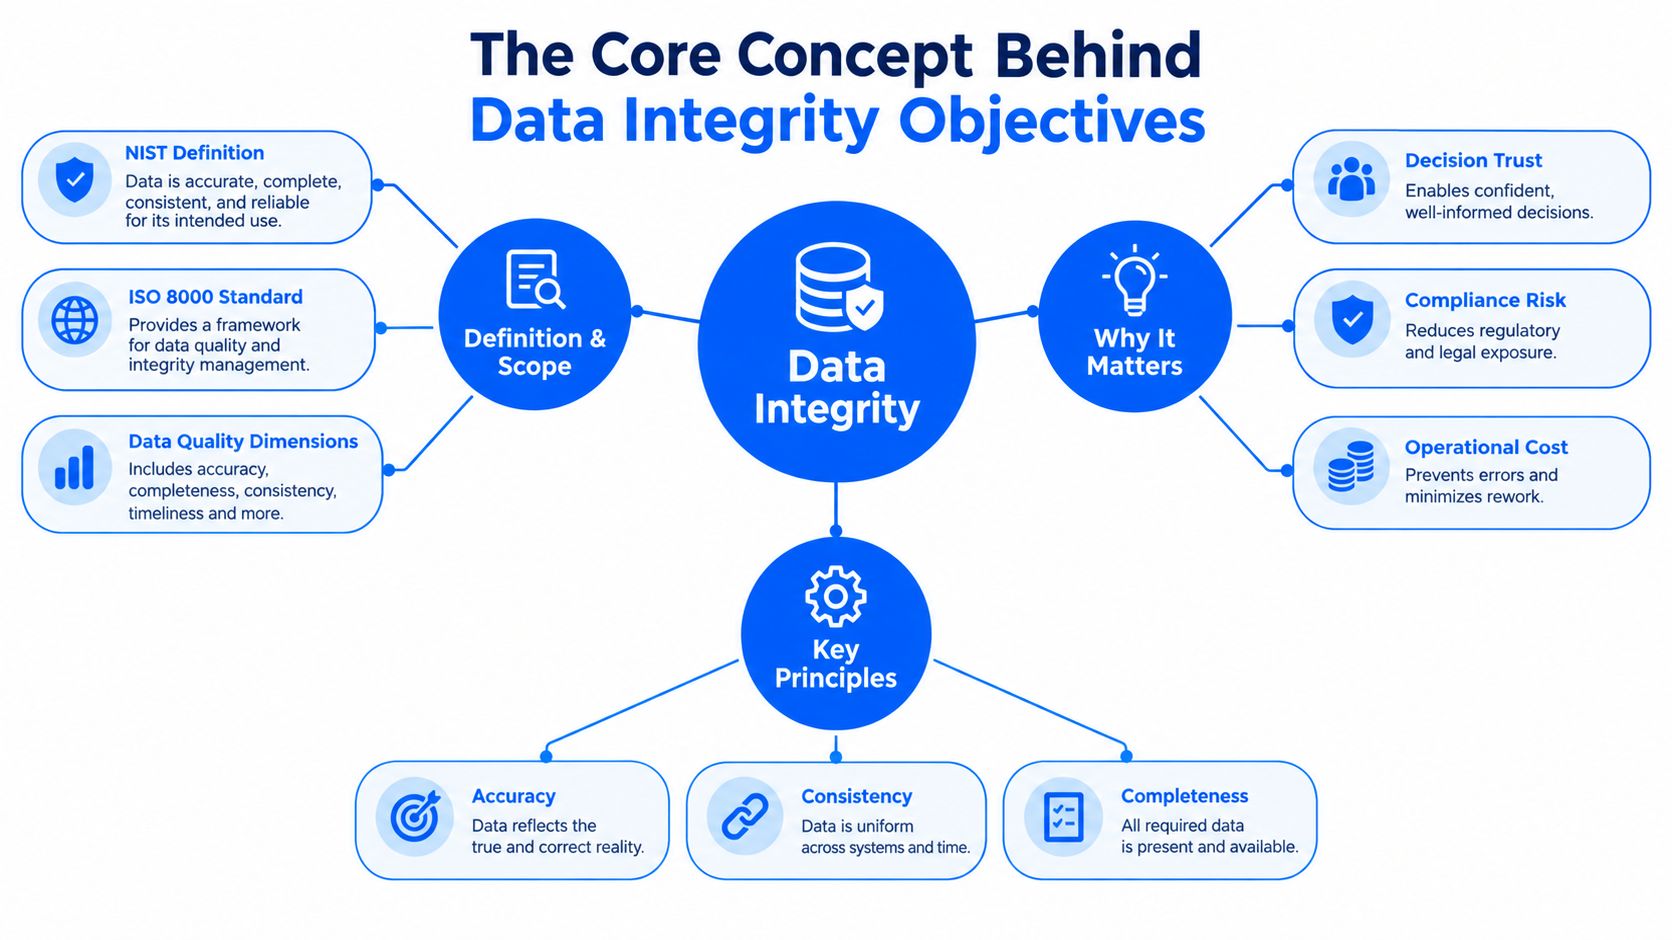
NIST definiert Integrität als die Eigenschaft, dass Daten weder unbefugt noch versehentlich verändert, zerstört oder verloren gegangen sind, und verknüpft Integrität zugleich mit Authentizität und Nichtabstreitbarkeit. Einfach gesagt: Der Datensatz soll weiterhin abbilden, was tatsächlich geschehen ist, und die Organisation soll das belegen können.
Die Dimensionen der Datenqualität helfen zu beschreiben, ob Informationen nutzbar sind, doch Integrität ergänzt die Kontrolle über den Lebenszyklus. Ein Wert kann im Warehouse plausibel aussehen und dennoch nicht vertrauenswürdig sein, wenn Quelle, Zeitstempel, Transformation oder Korrekturhistorie fehlen.
ALCOA in alltägliche Kontrollen übersetzen
Die FDA beschreibt Datenintegrität in ihren Leitlinien über die fünf ALCOA-Attribute: zuordenbar (attributable), lesbar (legible), zeitnah erfasst (contemporaneously recorded), original oder eine beglaubigte Kopie (original or a true copy) und korrekt (accurate). Nützlicher werden diese Begriffe, wenn man sie in Fragen übersetzt, die ein Datenteam beantworten kann.
Zuordenbar: Lässt sich die Person, das System, das Gerät oder der Dienst ermitteln, der den Datensatz erstellt oder geändert hat?
Lesbar: Kann eine berechtigte Prüferin den Datensatz und seine Metadaten auch später lesen und interpretieren?
Zeitnah: Wurde das Ereignis erfasst, als es eintrat, statt später aus dem Gedächtnis rekonstruiert zu werden?
Original: Bewahren Sie den Quelldatensatz oder eine verifizierte Kopie auf und nicht nur ein transformiertes Ergebnis?
Korrekt: Beschreibt der Wert das zugrunde liegende Ereignis getreu?
Ein Streaming-Ereignis, das verspätet ankommt, zeigt den Unterschied zwischen Erfassungszeit und Ereigniszeit. Werden beide festgehalten, können Prüfer erkennen, ob die Quelle das Ereignis verspätet erzeugt hat, das Netzwerk es verzögert hat oder die Ingestion fehlgeschlagen ist.
Integrität ist mehr als „die Daten sehen richtig aus“. Sie umfasst die Nachweise rund um die Daten, die Kontrollen, die sie schützen, und die Fähigkeit, den Ablauf der Ereignisse nach einer Korrektur oder einem Vorfall zu rekonstruieren.
Die zentralen Ziele, die jedes Programm abdecken muss
Die FDA beschreibt Datenintegrität in ihren Leitlinien als Vollständigkeit, Konsistenz und Genauigkeit von Daten und erwartet, dass Datensätze zuordenbar, lesbar, zeitnah erfasst, original oder eine beglaubigte Kopie und korrekt sind, also die fünf ALCOA-Attribute erfüllen. Diese Attribute sind ein solides Fundament, doch Unternehmenspipelines brauchen zusätzlich Kontrollen für Sicherheit, Nachvollziehbarkeit und Wiederherstellung.
Sechs Ziele in der Praxis
Genauigkeit bedeutet, dass ein Wert das Ereignis abbildet, das er abzubilden vorgibt. Wird eine Rechnung mit falscher Währungsumrechnung erfasst, fällt ein unplausibles Ergebnis vielleicht bei einer Bereichsprüfung auf, doch erst eine fachliche Regelprüfung oder ein Abgleich kann festlegen, welcher Wert richtig wäre. Hilfreiche Signale sind fehlgeschlagene Datensatzprüfungen, unerwartete Verteilungen und Abweichungen von einer vertrauenswürdigen Quelle.
Vollständigkeit bedeutet, dass erforderliche Datensätze, Felder und unterstützende Nachweise vorhanden sind. Ein erfolgreicher Dateiladevorgang kann trotzdem unvollständig sein, wenn die Quelle nur einen Teil des erwarteten Extrakts geliefert hat. Warnungen bei fehlenden Ladevorgängen, Zeilenzahlvergleiche, Null-Prüfungen und Prüfungen auf fehlgeschlagene Tests oder Wiederholungstests machen die Lücke sichtbar.
Konsistenz bedeutet, dass ein fachliches Konzept systemübergreifend und über die Zeit dieselbe Bedeutung behält. Ein Statuswert wie „aktiv“ sollte nicht in einer Anwendung „bezahlt“ und in einer anderen „nicht storniert“ bedeuten. Schema-Tracking, Referenzdatenprüfungen und systemübergreifende Abgleiche liefern Belege, wenn Definitionen auseinanderdriften.
Nachvollziehbarkeit bedeutet, dass Prüfer die Historie eines Datensatzes rekonstruieren können. Korrigiert ein Finanzanalyst einen Wert, sollten Originalwert, Begründung, Zeitstempel, Identität und die daraus entstandene Version zur Prüfung verfügbar bleiben. Audit-Logs, Lineage, Versionshistorie und Änderungskontext liefern diese Spur.
Sicherheit schützt Daten vor unbefugtem Zugriff, unbefugter Änderung, Verlust und Zerstörung. Rollenbasierte Zugriffe, das Least-Privilege-Prinzip, geschützte Logs und Änderungsüberwachung verringern das Risiko, dass eine unbefugte Aktion zu einer unsichtbaren Datenänderung wird.
Wiederherstellbarkeit bedeutet, dass das Team einen vertrauenswürdigen Zustand wiederherstellen und dessen Vertrauenswürdigkeit belegen kann. NIST fordert in seinen Leitlinien die Fähigkeit, Daten auf den letzten bekannten guten Zustand zurückzusetzen, das richtige unkontaminierte Backup zu identifizieren und festzustellen, wer Änderungen vorgenommen hat und wann. Backups allein reichen nicht, wenn die Wiederherstellung nie getestet wurde oder das Team nicht weiß, welche Version sicher ist.
Ziel | Wie ein Fehler aussieht | Typische Kontrolle |
|---|---|---|
Genauigkeit | Eine Kennzahl bildet den falschen Transaktionswert ab | Validierung auf Datensatzebene und Abgleich |
Vollständigkeit | Eine Quelldatei oder ein erforderlicher Datensatz fehlt | Überwachung von Aktualität, Ladevorgängen, Zeilenzahlen und Nullwerten |
Konsistenz | Ein System interpretiert ein Feld anders | Schema-Tracking und gemeinsame Geschäftsregeln |
Nachvollziehbarkeit | Ein korrigierter Wert hat keine dokumentierte Historie | Unveränderlicher Audit-Trail und Lineage |
Sicherheit | Ein unbefugter Nutzer ändert eine kritische Tabelle | Zugriffskontrollen und geschützte Änderungsprotokolle |
Wiederherstellbarkeit | Ein fehlerhafter Backfill überschreibt vertrauenswürdige Historie | Versionierte Backups und Wiederherstellungstests |
Diese Ziele überschneiden sich, ersetzen einander aber nicht. Ein sicherer Datensatz kann trotzdem unvollständig sein, und ein wiederherstellbarer Datensatz kann trotzdem fehlerhafte Geschäftslogik enthalten.
Die Ziele im Durchlauf einer echten Datenpipeline
Nehmen wir einen täglichen Umsatz-Feed aus einem Abrechnungssystem. Die Quelle sendet Transaktionen an ein Warehouse, wo Transformationen einen Datensatz für ein Business-Intelligence-Dashboard aufbereiten.
Bei der Ingestion beginnt Genauigkeit mit der Validierung von Datentypen, Währungen, Kennungen und Geschäftsregeln. Ein Datensatz mit negativem Betrag kann bei einer Rückerstattung gültig sein, daher braucht die Regel fachlichen Kontext statt einer simplen Prüfung „nur positive Werte“. Vollständigkeit wird zum Thema, wenn die Datei mit weniger Datensätzen als erwartet oder verspätet eintrifft. Die Pipeline sollte einen geschäftsfreien Tag von einer fehlgeschlagenen Übertragung unterscheiden können.
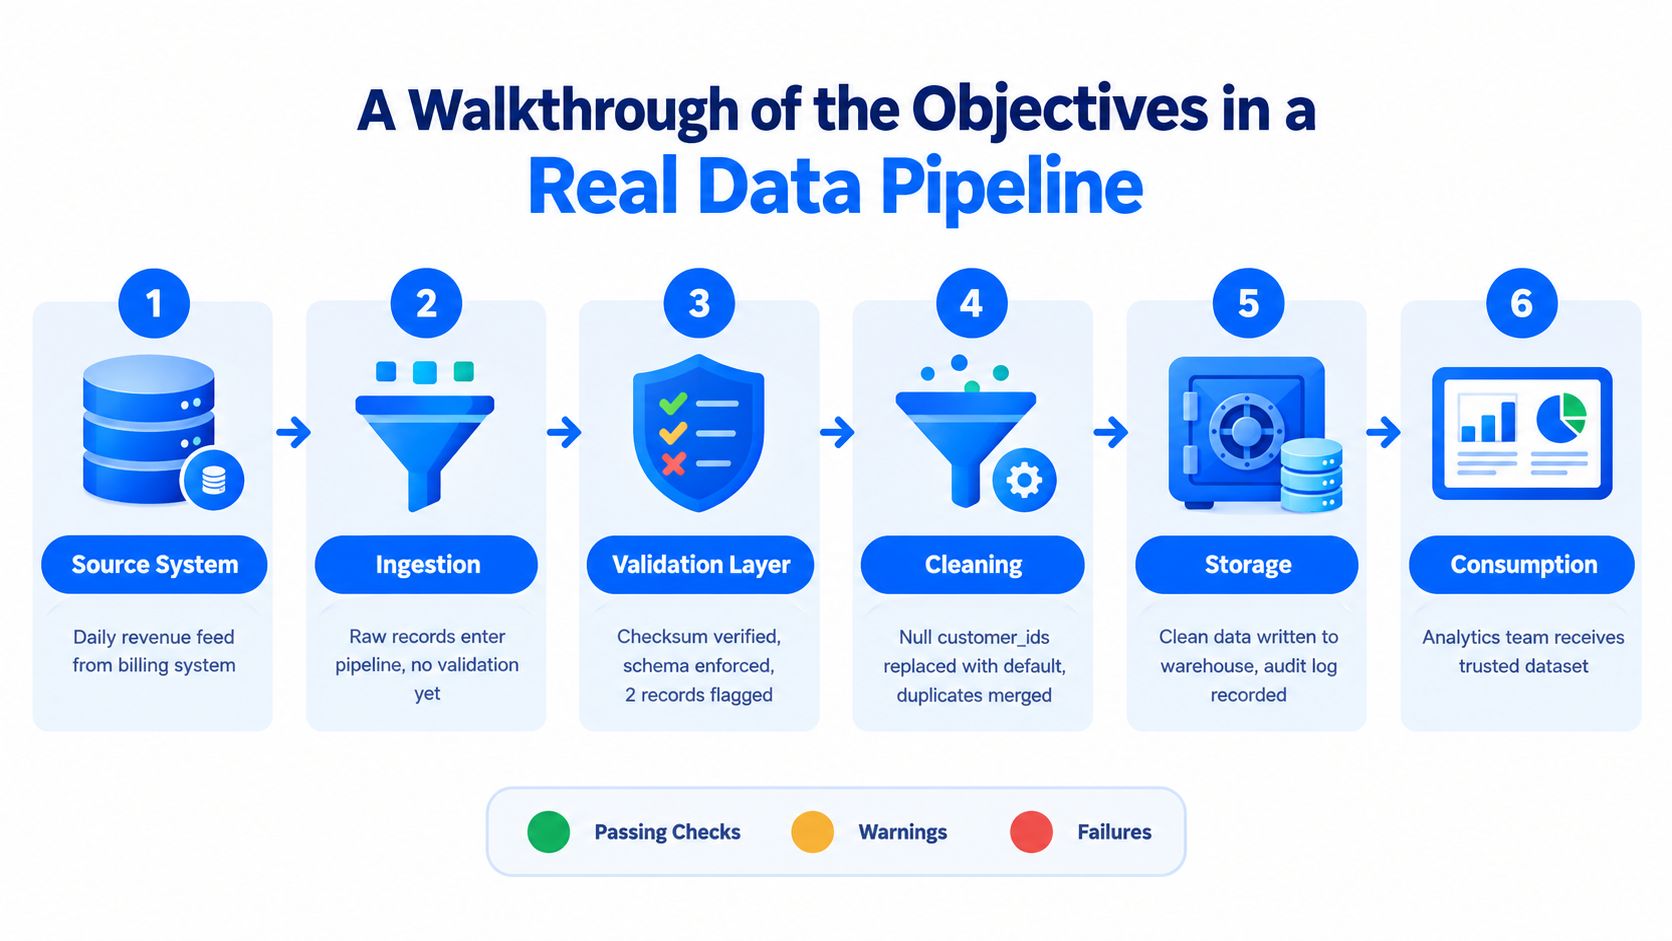
Dann benennt eine Schemaänderung in der Quelle eine Spalte um. Die Transformation läuft weiter, ordnet aber das falsche Feld dem Dashboard zu. Konsistenz erfordert die Erkennung struktureller und semantischer Änderungen, nicht bloß einen erfolgreichen Job-Status. Teams, die diese Übergaben gestalten, können zusätzlich einen Leitfaden zur Architektur von Datenpipelines heranziehen, um Verantwortlichkeiten und Kontrollpunkte explizit zu machen.
Als Nächstes findet eine Finanzanalystin eine berechtigte Korrektur und aktualisiert einen Wert. Nachvollziehbarkeit verlangt den ursprünglichen Wert, den neuen Wert, die Begründung, die Identität und den Zeitstempel. Ohne diesen Kontext kann eine spätere Prüferin nicht erkennen, ob die Änderung ein Abrechnungsproblem behoben oder einen fehlgeschlagenen Prozess verdeckt hat.
Dann ändert sich die Rolle eines Analysten. Sicherheitskontrollen bestimmen, ob die Person sensible Felder weiterhin sehen oder ändern darf. Zugriffe sollten der aktuellen Rolle folgen und nicht einer alten Berechtigung, die unbegrenzt aktiv bleibt.
Schließlich überschreibt ein fehlerhafter Backfill drei Tage an Warehouse-Daten. Wiederherstellbarkeit erfordert eine bekannte gute Version, geschützte Backup-Nachweise und eine Möglichkeit festzustellen, was sich geändert hat. Auch der Praxisleitfaden von NIST betont, Identität und Zeitpunkt von Änderungen zu ermitteln, daher gehören Wiederherstellung und Untersuchung in denselben Betriebsprozess.
Für Teams, die externe Informationen sammeln, bevor sie in eine Pipeline gelangen, lässt sich eine Web-Scraping-API gemeinsam mit Validierungs-, Herkunfts- und Quelländerungskontrollen bewerten. Die Beschaffung erspart nicht die Prüfung dessen, was angekommen ist.
Wie sich die Ziele bei regulatorischen, operativen und KI-Anwendungsfällen unterscheiden
Integritätskontrollen sollten zur Tragweite eines Fehlers und zur Art passen, wie die Daten genutzt werden. Ein regulatorischer Bericht braucht dauerhafte Nachweise und Prüfbarkeit. Eine operative Live-Kennzahl priorisiert womöglich schnelle Erkennung und einen klaren Aktualitätsstatus. Ein KI-Trainingsdatensatz braucht Herkunftsnachweise, Repräsentativitätsprüfungen, Versionierung und eine Möglichkeit, veraltete oder semantisch veränderte Eingaben zu erkennen.
Artikel 5 der EU-DSGVO verlangt, dass personenbezogene Daten sachlich richtig und erforderlichenfalls auf dem neuesten Stand sind, und fordert eine Verarbeitung, die angemessene Sicherheit gewährleistet, einschließlich Schutz vor unbefugter oder unrechtmäßiger Verarbeitung sowie vor unbeabsichtigtem Verlust, unbeabsichtigter Zerstörung oder Schädigung. Diese Pflicht macht Korrekturabläufe, Zugriffskontrollen und Nachweise zu Vorfällen für Datenprodukte mit personenbezogenen Daten wichtig, nicht nur für Compliance-Berichte.
Anwendungsfall | Vorrangige Ziele | Akzeptable Prüflatenz | Menschliche Prüfung |
|---|---|---|---|
Regulatorischer Bericht | Genauigkeit, Vollständigkeit, Nachvollziehbarkeit, Sicherheit, Wiederherstellbarkeit | Vor der Einreichung und nach wesentlichen Änderungen | Erforderlich für Ausnahmen, Korrekturen und Freigabe |
Operative Kennzahl | Aktualität, Genauigkeit, Konsistenz, Verfügbarkeit | Nahe am Zeitpunkt der Ingestion oder Veröffentlichung | Konzentriert auf wesentliche Anomalien und Ausfälle |
KI-Trainingsdatensatz | Herkunft, Vollständigkeit, Konsistenz, Genauigkeit, versionierte Wiederherstellbarkeit | Vor der Freigabe des Datensatzes und nach Quell- oder Schemaänderungen | Erforderlich für Labeling, Ausschlüsse, Drift und sensible Nutzung |
Die Kontrollen sollten nicht identisch sein. Eine verzögerte operative Kennzahl kann mehr Schaden anrichten als ein vorübergehend zurückgehaltener Datensatz, wenn Teams damit auf ein laufendes Ereignis reagieren. Ein regulatorischer Datensatz verträgt vielleicht ein längeres Prüffenster, muss aber Originaldatensätze und Entscheidungsnachweise bewahren.
Hier hilft die Unterscheidung zwischen Compliance und Governance. Compliance legt die Pflichten fest, die erfüllt werden müssen. Governance weist Verantwortung und Betriebsregeln zu, damit Teams diese Pflichten dauerhaft erfüllen können.
Die Ziele in operative Praktiken übersetzen
Ziele werden nützlich, wenn jedes eine beobachtbare Kontrolle und eine verantwortliche Person hat. Lineage und Audit-Trails unterstützen die Nachvollziehbarkeit, indem sie Quellen, Transformationen, Versionen, Identitäten und Zeitstempel festhalten. Validierung auf Datensatzebene unterstützt Genauigkeit und Konsistenz, indem sie exakte Werte, Wertebereiche, Referenzlisten, den Umgang mit Nullwerten und spaltenübergreifende Beziehungen prüft.
Vollständigkeit braucht mehr als eine Zeilenzählung. Die Überwachung der Aktualität kann fehlende Ladevorgänge, verspätete Lieferungen und unerwartete Liefermuster erkennen. Schema-Tracking kann hinzugefügte oder entfernte Spalten und geänderte Datentypen aufdecken, bevor sich für einen nachgelagerten Nutzer unbemerkt die Bedeutung ändert.
Anomalieerkennung fügt eine weitere Ebene hinzu. Deterministische Regeln fangen bekannte Fehler ab, während Verhaltens-Baselines ungewöhnliche Volumina, Verteilungen oder Geschäftskennzahlen hervorheben können, die eine feste Regel nicht vorhersieht.
Eine praktische Kontrolllandkarte
Genauigkeit: Datensätze gegen Geschäftsregeln validieren und kritische Summen abgleichen.
Vollständigkeit: Erwartete Lieferungen, Pflichtfelder sowie fehlgeschlagene oder abgelehnte Datensätze überwachen.
Konsistenz: Schemata, Referenzwerte, Definitionen und systemübergreifende Beziehungen verfolgen.
Nachvollziehbarkeit: Lineage, Audit-Ereignisse, Versionen und Änderungsgründe bewahren.
Sicherheit: Least Privilege, geschützte Protokollierung und prüfbare Zugriffsänderungen umsetzen.
Wiederherstellbarkeit: Versionierte Backups pflegen und die Wiederherstellung auf einen bekannten guten Zustand testen.
Der Praxisleitfaden von NIST nennt Ergebnisse wie die Wiederherstellung der letzten bekannten guten Konfiguration, die Identifizierung des richtigen Backups, die Feststellung, was sich wann geändert hat, und die Verknüpfung einer Änderung mit zugehörigen Ereignissen. Ein kleines Team kann mit den risikoreichsten Tabellen beginnen und die Abdeckung ausweiten, sobald Verantwortlichkeiten und Nachweise reifer werden.
Eine Plattform wie der Ansatz von digna zur Einführung von Datenqualität kann Anomalieerkennung, Validierung, Aktualitätsüberwachung und Schema-Tracking kombinieren. Die wichtige Designentscheidung ist nicht die Wahl einer einzelnen Funktion. Es geht darum, statistische Signale, deterministische Regeln, strukturelles Bewusstsein und Wiederherstellungsnachweise mit demselben Datenprodukt zu verbinden.
Der Zielkonflikt, den die meisten Integritätsleitfäden auslassen
Mehr Kontrollen erzeugen nicht automatisch mehr Integrität. Zu viele Warnungen führen zu Ermüdung, langsame Validierung kann Informationen unbrauchbar machen, und restriktive Zugriffe können Analysten zu unkontrollierten Kopien treiben.
Eine weltweite Umfrage unter mehr als 550 Daten- und Analytics-Fachleuten nannte Datenqualität als größte Herausforderung für die Datenintegrität. Nur 12 % gaben an, dass ihre Daten KI-tauglich sind, und der Mangel an Fachkräften und Personal war das größte Hindernis für bessere Qualität, so die Auswertung der Umfrage durch Precisely.
Das praktische Ziel sind verlässliche Daten zu angemessener Geschwindigkeit und angemessenen Kosten. Priorisieren Sie Kontrollen nach geschäftlicher Auswirkung, Aktualitätsanforderungen, regulatorischem Risiko und Verwendungszweck. Eine Checkliste zur Datenanreicherung von looot kann Teams helfen, Anreicherungsschritte zu prüfen, ohne Herkunft, Validierung und Verantwortung zu vergessen.
FAQ und eine kurze Checkliste der Integritätsziele
Wie können wir belegen, dass Daten nach einer Pipeline-Änderung vertrauenswürdig geblieben sind?
Bewahren Sie versionierte Schemata, Lineage, Audit-Ereignisse, Validierungsergebnisse, Zeitstempel, Verantwortlichkeiten und Änderungskontext auf. Vergleichen Sie bei einer wesentlichen Änderung das Verhalten vor und nach der Änderung, dokumentieren Sie betroffene Datensätze und bewahren Sie die Nachweise zusammen mit dem Release- oder Vorfallsdatensatz auf.
Wie sollte ein kleines Team Kontrollen priorisieren?
Beginnen Sie mit Datensätzen, die regulatorisches Reporting, kritische Abläufe oder Modelle mit großer Wirkung unterstützen. Wenden Sie dort zuerst Kontrollen für Aktualität, Validierung, Schema, Zugriff und Wiederherstellung an und erweitern Sie sie dann anhand des beobachteten Risikos, statt jede Tabelle gleich intensiv zu überwachen.
Worin unterscheiden sich Integritätsziele von Datenqualitäts-KPIs?
Ein Qualitäts-KPI misst eine Eigenschaft wie Vollständigkeit oder Gültigkeit zu einem bestimmten Zeitpunkt. Ein Integritätsziel fragt zusätzlich, ob das Ergebnis über den gesamten Lebenszyklus zuordenbar, geschützt, erklärbar und wiederherstellbar ist.
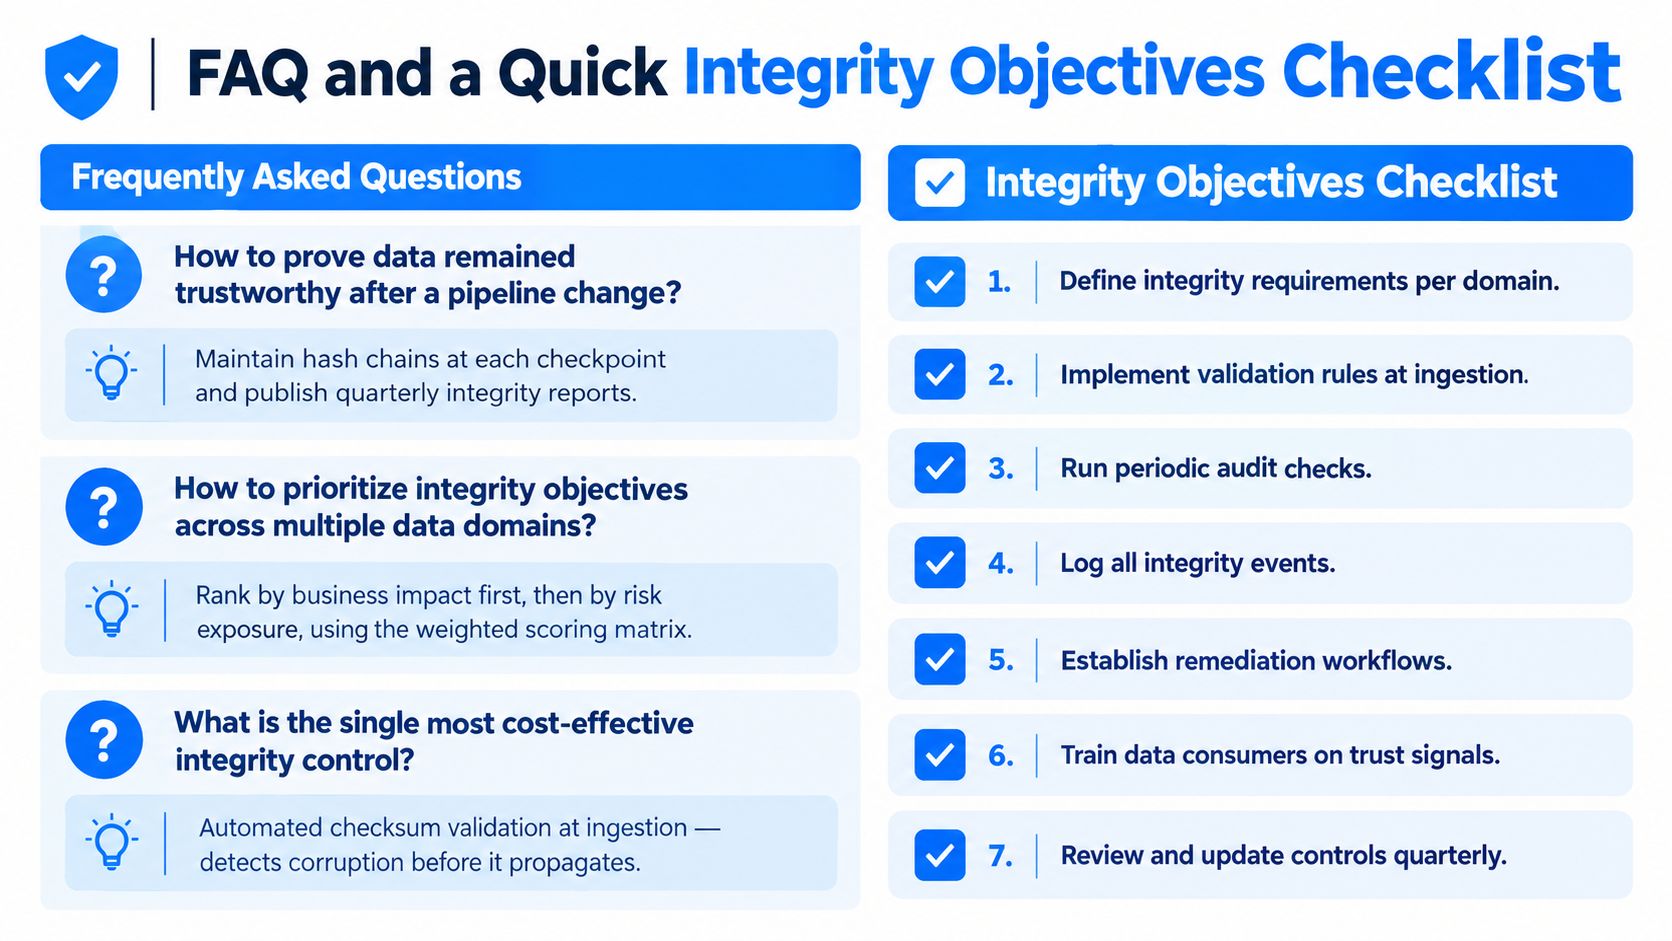
Nutzen Sie diese Checkliste für ein kritisches Datenprodukt:
Genauigkeit: Werte gegen Geschäftsregeln validieren.
Vollständigkeit: Fehlende Datensätze, Felder und Ladevorgänge erkennen.
Konsistenz: Definitionen, Schemata und systemübergreifende Bedeutung überwachen.
Nachvollziehbarkeit: Festhalten, wer was wann und warum geändert hat.
Sicherheit: Zugriffe beschränken und unbefugte Änderungen erkennen.
Wiederherstellbarkeit: Die Wiederherstellung auf einen verifizierten guten Zustand testen.
digna hilft Datenteams, das Verhalten von Daten zu überwachen, Datensätze zu validieren, die Aktualität zu verfolgen, Schemaänderungen zu erkennen und Anomalien zu untersuchen, und zwar in ihrer eigenen Umgebung. Besuchen Sie digna, um diese Kontrollen über die Pipelines und Datensätze hinweg zu verbinden, die Ihr Reporting, Ihren Betrieb und Ihre KI-Anwendungsfälle tragen.
Sind diese Ziele definiert, folgt als nächster Schritt ihre laufende Prüfung in produktiven Pipelines. Unser Praxisleitfaden zum Monitoring der Datenintegrität zeigt, wie sich Ziele für Genauigkeit, Vollständigkeit und Konsistenz in automatisierte Prüfungen übersetzen lassen.
Häufig gestellte Fragen
Was sind die wichtigsten Ziele bei der Sicherung der Datenintegrität?
Die wichtigsten Ziele sind Genauigkeit, Vollständigkeit, Konsistenz, Nachvollziehbarkeit, Sicherheit und Wiederherstellbarkeit. Jedes deckt einen anderen Fehler ab: Ein Datensatz kann sicher, aber unvollständig sein oder wiederherstellbar, aber fachlich falsch. Ein funktionierendes Programm braucht für alle sechs eine beobachtbare Kontrolle und Nachweise, keinen einzelnen Integritätswert.
Wofür steht ALCOA bei der Datenintegrität?
ALCOA steht für attributable, legible, contemporaneously recorded, original or a true copy und accurate, also zuordenbar, lesbar, zeitnah erfasst, original oder beglaubigte Kopie und korrekt. Die fünf Attribute stammen aus Leitlinien der FDA. Für Datenteams werden daraus konkrete Fragen, etwa wer einen Datensatz geändert hat und ob die Quelle aufbewahrt wird.
Warum reichen Backups nicht aus, um Daten wiederherstellbar zu machen?
Backups helfen nur, wenn feststeht, welche Version vertrauenswürdig ist, und die Wiederherstellung tatsächlich getestet wurde. NIST verlangt, den letzten bekannten guten Zustand wiederherzustellen, das richtige unkontaminierte Backup zu wählen und zu ermitteln, wer die Daten wann geändert hat. Wiederherstellung und Untersuchung gehören deshalb in einen gemeinsamen Prozess.
Wie unterscheiden sich die Integritätsziele bei regulatorischen Berichten und KI-Trainingsdaten?
Bei regulatorischen Berichten liegt der Schwerpunkt auf Nachvollziehbarkeit, dauerhaften Nachweisen und menschlicher Freigabe vor der Einreichung. KI-Trainingsdatensätze brauchen Herkunftsnachweise, versionierte Wiederherstellbarkeit und neue Prüfungen nach jeder Quell- oder Schemaänderung. Operative Kennzahlen setzen dagegen auf schnelle Erkennung und einen klaren Aktualitätsstatus nahe der Ingestion.
Können zusätzliche Integritätskontrollen die Lage verschlechtern?
Ja, zu viele Kontrollen können das Vertrauen eher senken als stärken. Übermäßige Warnungen ermüden, langsame Validierung macht Daten unbrauchbar, und strenge Zugriffsregeln treiben Analysten zu unkontrollierten Kopien. Besser ist es, Kontrollen nach geschäftlicher Auswirkung, Aktualitätsbedarf, regulatorischem Risiko und Verwendungszweck zu priorisieren.



