KPI-Qualitätskontrolle: Ein praxisnaher Governance-Leitfaden
|
8
min. Lesezeit

Ein Dashboard kann einwandfrei laden und trotzdem die falsche Geschichte erzählen. Genau das ist die unbequeme Schwachstelle der meisten Programme zur KPI-Qualitätskontrolle: Teams prüfen, ob Daten angekommen sind, ob Spalten zum Schema passen und ob Berichte aktualisiert wurden, und werten diese technischen Erfolge dann als Beweis, dass die Kennzahl sicher verwendet werden kann.
Das ist sie nicht. Ein KPI kann vollständig, aktuell und korrekt typisiert sein und nach einer Übernahme, einer Preisänderung, einer Währungsbewegung, einem veränderten Kundenmix oder einem geänderten Nenner trotzdem strategisch irreführend werden. Zuverlässiges Monitoring muss die Entscheidungstauglichkeit prüfen, nicht nur die Gesundheit der Pipeline. Das heißt zu fragen, ob die Kennzahl noch das bedeutet, was die Führung glaubt, ob sie mit früheren Perioden vergleichbar bleibt und ob sie die Entscheidung stützt, an die sie geknüpft ist.
Inhaltsverzeichnis
KPI-Qualitätskontrolle in modernen Datenplattformen verstehen
Die meisten Datenteams beginnen mit operativen Fragen: Ist der Job gelaufen? Wurde die Tabelle aktualisiert? War die Dashboard-Abfrage erfolgreich? Diese Prüfungen sind wichtig, beschreiben aber den Zustand der Datenplattform und nicht die Zuverlässigkeit der geschäftlichen Schlussfolgerung.
Eine technisch korrekte Berechnung des Umsatzwachstums kann trotzdem in die Irre führen, wenn eine Übernahme die Grundgesamtheit verändert, wenn Preiserhöhungen die Bewegung erklären oder wenn der Nenner eine neu relevante Kohorte ausschließt. Auch ein KPI zur Kundenbindung kann stabil aussehen, während sich die zugrunde liegende Kundendefinition geändert hat. Auf Schemaebene muss dabei nichts kaputtgehen. Das Versagen liegt in der Beziehung zwischen der Kennzahl und der Entscheidung, die sie unterstützen soll.
Technische Sauberkeit ist nur die erste Hürde
Ein nützliches KPI-Kontrollsystem trennt drei Fragen:
Kann die Pipeline den Wert erzeugen? Prüfen Sie Lieferung, Schema, Datentypen, Nullwerte, Volumen und Verarbeitungsstatus.
Bedeutet der Wert, was die Definition besagt? Prüfen Sie Filter, Kohorten, Joins, Nenner, Zeitfenster, Referenzdaten und den Abgleich mit dem führenden System.
Ist die Kennzahl für ihre vorgesehene Entscheidung noch nützlich? Prüfen Sie Vergleichbarkeit, Wesentlichkeit, geschäftlichen Kontext und die Annahmen, mit denen die Führung Veränderungen interpretiert.
Bei der dritten Frage hören viele Programme auf. Teams alarmieren vielleicht bei ungewöhnlichen Werten, ohne zu entscheiden, ob die Bewegung einen Fehler oder ein legitimes betriebliches Ereignis widerspiegelt. Daraus entstehen zwei gegensätzliche Risiken. Ein unauffälliger, aber verzerrter KPI rutscht durch, während eine berechtigte saisonale oder strategische Veränderung Rauschen erzeugt, das Nutzer zu ignorieren lernen.
Ein praktischer Ansatz für Data Observability sollte technische Signale deshalb mit semantischer Verantwortung verbinden. Jeder kritische KPI braucht eine freigegebene Definition, einen benannten fachlichen Owner, eine Beziehung zum führenden System und eine Erklärung, welche Entscheidungen von ihm abhängen.
Praxisregel: Eine erfolgreiche Pipeline belegt, dass Daten bewegt wurden. Sie belegt nicht, dass die Geschäftskennzahl entscheidungstauglich geblieben ist.
Vergleichbarkeit zu einer expliziten Kontrolle machen
Dokumentieren Sie zunächst Grundgesamtheit, Zähler, Nenner, Filter, Granularität, Zeitfenster, Währungsbehandlung und Ausschlüsse der Kennzahl. Halten Sie dann die Ereignisse fest, die die Interpretation verändern können, darunter Produkteinführungen, Übernahmen, Preisänderungen, neu zugeschnittene Vertriebsgebiete und geänderte Richtlinien.
Die Kontrolle sollte eine Berechnungsänderung von einer geschäftlichen Veränderung unterscheiden. Hat sich die Formel geändert, muss der Owner die historische Vergleichbarkeit bewerten und die Definition versionieren. Hat sich das Geschäft verändert, kann der Owner die Anomalie freigeben und dokumentieren, warum der KPI nützlich bleibt, oder begründen, warum eine neu berechnete Zeitreihe, eine neue Kohorte oder eine Ersatzkennzahl nötig ist.
So wird KPI-Qualitätskontrolle von einer Sammlung von Datentests zu einem System, das Entscheidungen schützt. Engineers überwachen weiterhin die Maschinerie, aber fachliche Owner validieren die Bedeutung.
Die wahren Kosten vernachlässigter KPI-Datenqualität
Schwache Validierung von Kennzahlen führt selten zu einem dramatischen Ausfall. Häufiger landet ein falscher Wert in einer Planungspräsentation, einem Leistungsreview, einer Prognose, einem Compliance-Bericht oder einem KI-Workflow. Die Organisation verbringt dann Zeit damit, das Ergebnis zu diskutieren, nachgelagerte Unterlagen zu korrigieren, Analysen erneut auszuführen und das Vertrauen in den Berichtsprozess wiederherzustellen.
Laut Gartner kostet schlechte Datenqualität Organisationen im Durchschnitt mindestens 12,9 Millionen US-Dollar pro Jahr, basierend auf Forschung aus dem Jahr 2020, während 59 % der Organisationen Datenqualität nicht messen, wie Docsumos Übersicht zu den Kosten schlechter Daten zusammenfasst. Die Schätzung stammt aus einer Befragung von 154 Referenzkunden von 16 Anbietern für Datenqualität und sollte daher nicht als allgemeingültige Belastung für jedes Unternehmen gelten. Sie zeigt aber, warum Organisationen Fehler mit geschäftlichen Folgen verknüpfen müssen, statt Qualität als abstrakte Engineering-Kennzahl zu behandeln.
Eine Beweiskette vom Fehler bis zur Entscheidung aufbauen
Ein ausgereiftes Kontrollprogramm hält mehr fest als einen Alarm. Es sollte Folgendes bewahren:
Den Fehler, etwa eine fehlende Ladung, einen ungültigen Wert, einen geänderten Join, einen veralteten Datensatz oder eine abweichende Definition.
Den betroffenen KPI, einschließlich Owner, Nutzern, Berichtsoberflächen und abhängigen Modellen.
Die geschäftlichen Auswirkungen, etwa eine verzerrte Prognose, eine verzögerte Maßnahme, einen fehlerhaften Bericht oder eine unnötige Untersuchung.
Die Behebung, einschließlich technischer Änderung, fachlicher Freigabe, Validierungsnachweisen und Abschlussdatum.
Die Präventionsmaßnahme, etwa eine neue Regel, eine überarbeitete Definition, eine Aktualisierung der Lineage oder eine angepasste Schwelle.
Diese Kette liefert Finanz- und Führungsverantwortlichen eine belastbare Begründung, Kontrollen zu finanzieren. Sie hilft auch dem Engineering bei der Priorisierung. Ein Fehler in einer selten genutzten explorativen Tabelle sollte nicht dieselbe Reaktion auslösen wie ein Fehler, der regulatorisches Reporting, Revenue Management oder einen Vorstands-KPI betrifft.
Das finanzielle Argument reicht über Datenteams hinaus. Ein Bericht des IBM Institute for Business Value aus dem Jahr 2025 ergab, dass 43 % der Chief Operating Officers Datenqualitätsprobleme als ihre wichtigste Datenpriorität nannten und mehr als ein Viertel der Organisationen jährliche Verluste von über 5 Millionen US-Dollar durch schlechte Datenqualität schätzt. Die Zahlen stammen aus IBMs Analyse schlechter Datenqualität, die das Thema als operatives Anliegen und nicht als enges Plattformproblem einordnet.
Teams, die die kommerziellen Auswirkungen bewerten, können außerdem fehlerhafte Daten für mehr Umsatz bereinigen als praktische Referenz nutzen, um unzuverlässige Daten mit Umsatzprozessen zu verknüpfen. Die nützliche Frage lautet nicht: „Wie viele Datensätze sind durchgefallen?“ Sondern: „Welche Entscheidungen haben diese Datensätze beeinflusst, und was hat die Organisation getan, weil der KPI falsch war?“
Qualität und Folgen gemeinsam messen
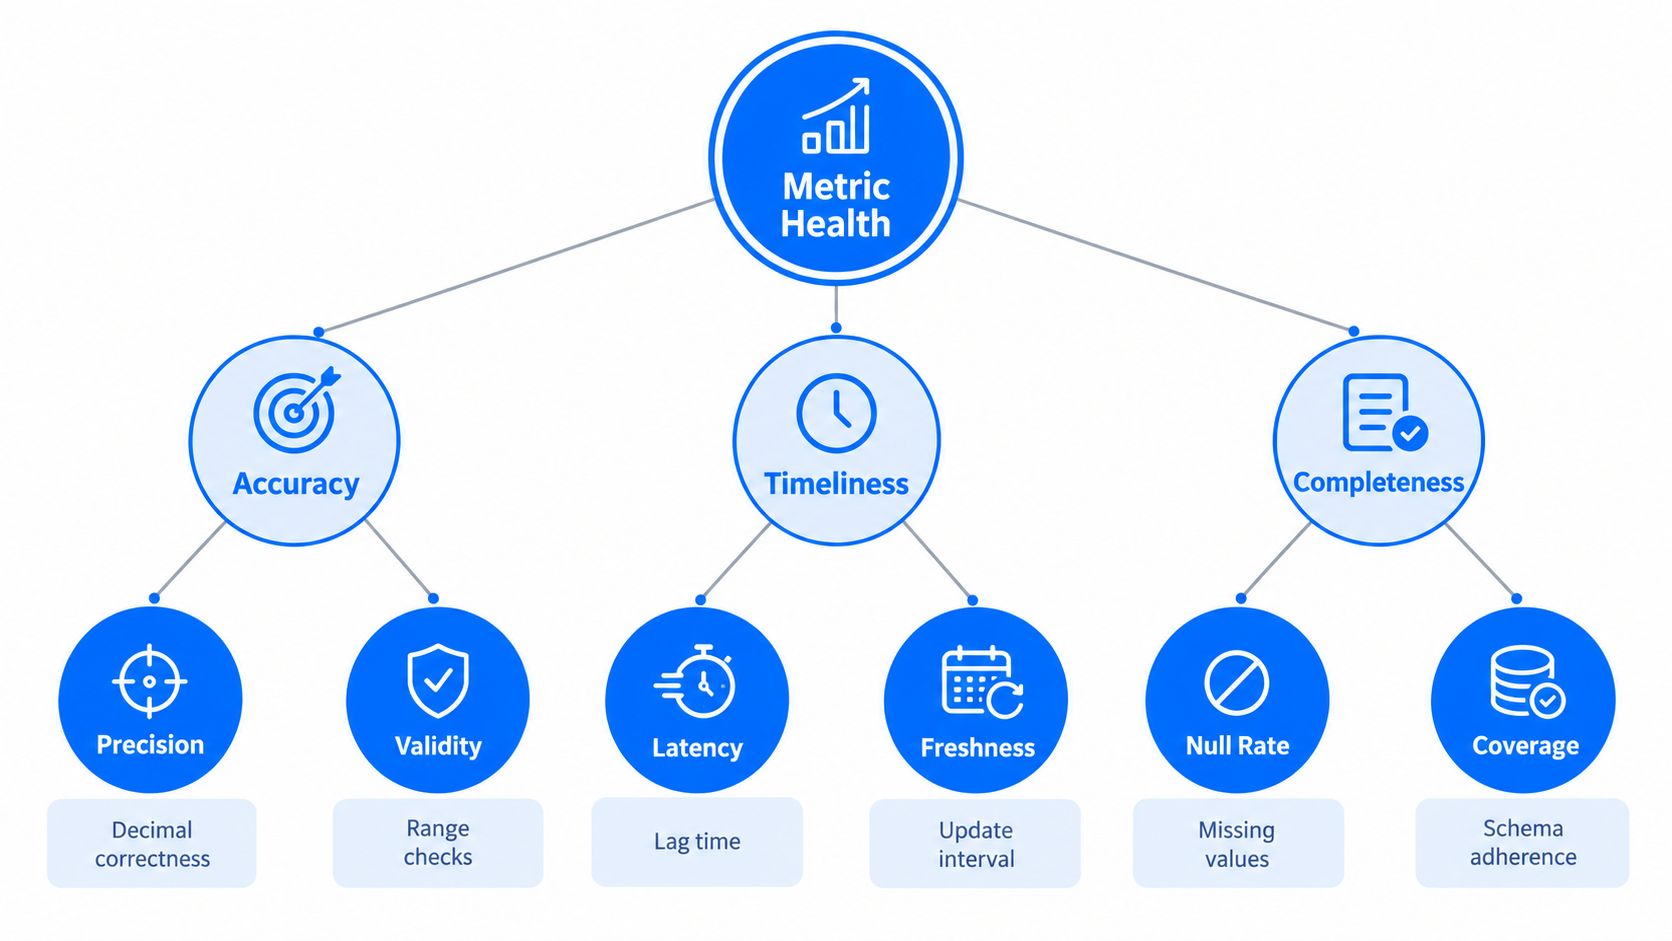
Verfolgen Sie Dimensionen wie Genauigkeit, Vollständigkeit, Konsistenz, Gültigkeit, Aktualität, Eindeutigkeit und Relevanz. Kombinieren Sie sie dann mit operativen Messgrößen wie Schweregrad von Vorfällen, betroffenen Berichten, Behebungsdauer, Wiederholungen und dem Verhältnis von akzeptierten zu fehlerhaften Anomalieentscheidungen.
Ein einzelner zusammengesetzter Score verdeckt Zielkonflikte. Hohe Vollständigkeit kann mit geringer Genauigkeit einhergehen. Hervorragende Aktualität kann mit einer fehlerhaften fachlichen Definition einhergehen. Getrennte Dimensionen machen das Versagen diagnostizierbar und lassen Owner Kontrollen nach Wesentlichkeit auswählen.
Für Führungskräfte, die einen prägnanten Business Case brauchen, kann der Leitfaden von digna zum Business Case für Datenqualität das Gespräch unterstützen. Das stärkste Argument ist meist eine prüfbare Verbindung zwischen einem Datenfehler, einem verzerrten KPI, einer verzögerten oder falschen Entscheidung und einer Kontrolle, die die Wahrscheinlichkeit einer Wiederholung senkt.
Kerndimensionen zuverlässiger Geschäftskennzahlen
Ein KPI sollte nicht ein einziges Bestanden- oder Durchgefallen-Etikett erhalten und dann in einem Dashboard verschwinden. Qualität ist mehrdimensional, und jede Dimension erfordert einen anderen Test. Eine Spalte kann ihrem deklarierten Typ entsprechen und trotzdem die falsche fachliche Bedeutung tragen. Ein vollständiger Datensatz kann dennoch falsche Werte enthalten.
Syntax, Bedeutung und Nutzen trennen
ISO 8000-1:2022 definiert Qualitätskonzepte, die sich über Kontrollen operationalisieren lassen: Syntaktische Qualität betrifft die Übereinstimmung mit einem freigegebenen Format, semantische Qualität die Frage, ob Werte ihre beabsichtigte Bedeutung abbilden, und pragmatische Qualität die Frage, ob Daten für die vorgesehenen Nutzer und Entscheidungen geeignet sind. Das Rahmenwerk wird in der Übersicht zu ISO 8000 zusammengefasst.
Wenden Sie diese Konzepte direkt an:
Qualitätsebene | Was geprüft wird | Praktische KPI-Kontrolle |
|---|---|---|
Syntaktisch | Ob Daten der freigegebenen Struktur folgen | Prüfungen von Schema, Typ, Format und zulässigen Werten |
Semantisch | Ob Werte das beabsichtigte Konzept abbilden | Validierung von Definition, Join, Kohorte, Nenner und Referenzdaten |
Pragmatisch | Ob der KPI die vorgesehene Entscheidung stützt | Freigabe durch den Owner, Prüfung der Vergleichbarkeit, Wesentlichkeit und Tests der Entscheidungsnutzung |
Syntaktische Prüfungen lassen sich meist am einfachsten automatisieren. Validieren Sie, dass Datumsangaben Datumsangaben sind, Kennungen dem erwarteten Muster folgen, numerische Felder in akzeptablen Formaten bleiben und Pflichtspalten vorhanden sind. Diese Prüfungen erkennen strukturelle Fehler früh, können aber nicht feststellen, ob „aktiver Kunde“ noch der freigegebenen fachlichen Definition entspricht.
Semantische Prüfungen brauchen eine stärkere Dokumentation. Gleichen Sie KPI-Summen mit dem jeweiligen führenden System ab, testen Sie die Grundgesamtheiten von Zähler und Nenner unabhängig voneinander und vergleichen Sie Ergebnisse über freigegebene Kohorten und Zeitfenster hinweg. Nutzt eine Kennzahl Referenzdaten, überwachen Sie Änderungen dieser Referenzdaten so sorgfältig wie Änderungen der Faktentabelle.
Pragmatische Prüfungen gehören den Menschen, die die Kennzahl nutzen. Der fachliche Owner sollte bestätigen, ob der KPI weiterhin für Planungs-, Preis-, Risiko-, Betriebs- oder Compliance-Entscheidungen geeignet ist. Hier erhalten auch legitime Anomalien Kontext, statt automatisch unterdrückt zu werden.
Vollständigkeit und Gültigkeit als getrennte Kontrollen behandeln
Das Government Data Quality Framework der britischen Regierung unterscheidet Vollständigkeit von Gültigkeit. Vollständigkeit fragt, ob erforderliche Datensätze und wesentliche Felder vorhanden sind. Gültigkeit fragt, ob Werte in erwartete Bereiche und Formate passen. Das Rahmenwerk warnt ausdrücklich, dass vollständige Daten nicht unbedingt korrekt sind.
Diese Unterscheidung verändert, wie Teams Tests gestalten:
Abdeckungsprüfungen erkennen fehlende Datensätze, Perioden, Entitäten oder Quell-Feeds.
Pflichtfeldprüfungen erkennen fehlende Werte in Feldern, die für die Berechnung nötig sind.
Gültigkeitsprüfungen erzwingen Formate, Wertebereiche, zulässige Werte und Typerwartungen.
Genauigkeitsprüfungen gleichen Werte mit einer vertrauenswürdigen Quelle oder einem Geschäftsprozess ab.
Konsistenzprüfungen vergleichen dasselbe Konzept über Systeme, Produkte und Berichtsebenen hinweg.
Aktualitätsprüfungen vergleichen Ankünfte mit dem erwarteten Lieferverhalten, nicht nur mit einer festen Uhrzeit.
Nutzen Sie die Dimensionen der Datenqualität von digna als Referenz, wenn Sie diese Kategorien in ein Monitoring-Inventar übersetzen. Die wichtige Designentscheidung ist, die Dimensionen sichtbar zu halten. Ein einzelnes „gesund“-Abzeichen kann genau die Schwäche verbergen, die eine Entscheidung entwertet.
Governance und klare Verantwortlichkeiten etablieren
Der schwierigste Teil der KPI-Qualitätskontrolle ist nicht das Schreiben einer Validierungsregel. Es ist die Entscheidung, wer handelt, wenn die Regel anschlägt, wer eine Anomalie als legitim akzeptieren darf und wer nachweisen muss, dass die Kennzahl wieder sicher veröffentlicht werden kann.
Actians Umfrage aus dem Jahr 2025 unter mehr als 600 Datenfachleuten in Unternehmen ergab, dass 83 % mit Herausforderungen bei Governance und Compliance konfrontiert waren, obwohl Organisationen ihre Governance-Reife mit 4,13 von 5 bewerteten und Führungskräfte die Datenreife 12 % höher einschätzten als Fachanwender. Diese Ergebnisse sind in Actians Umfrage zur Governance-Reife veröffentlicht. Die Lücke deutet auf ein praktisches Problem hin: Das Vertrauen der Führung kann schneller wachsen als die operative Klarheit.
Verantwortung im Kennzahlenvertrag verankern
Halten Sie für jeden kritischen KPI fest:
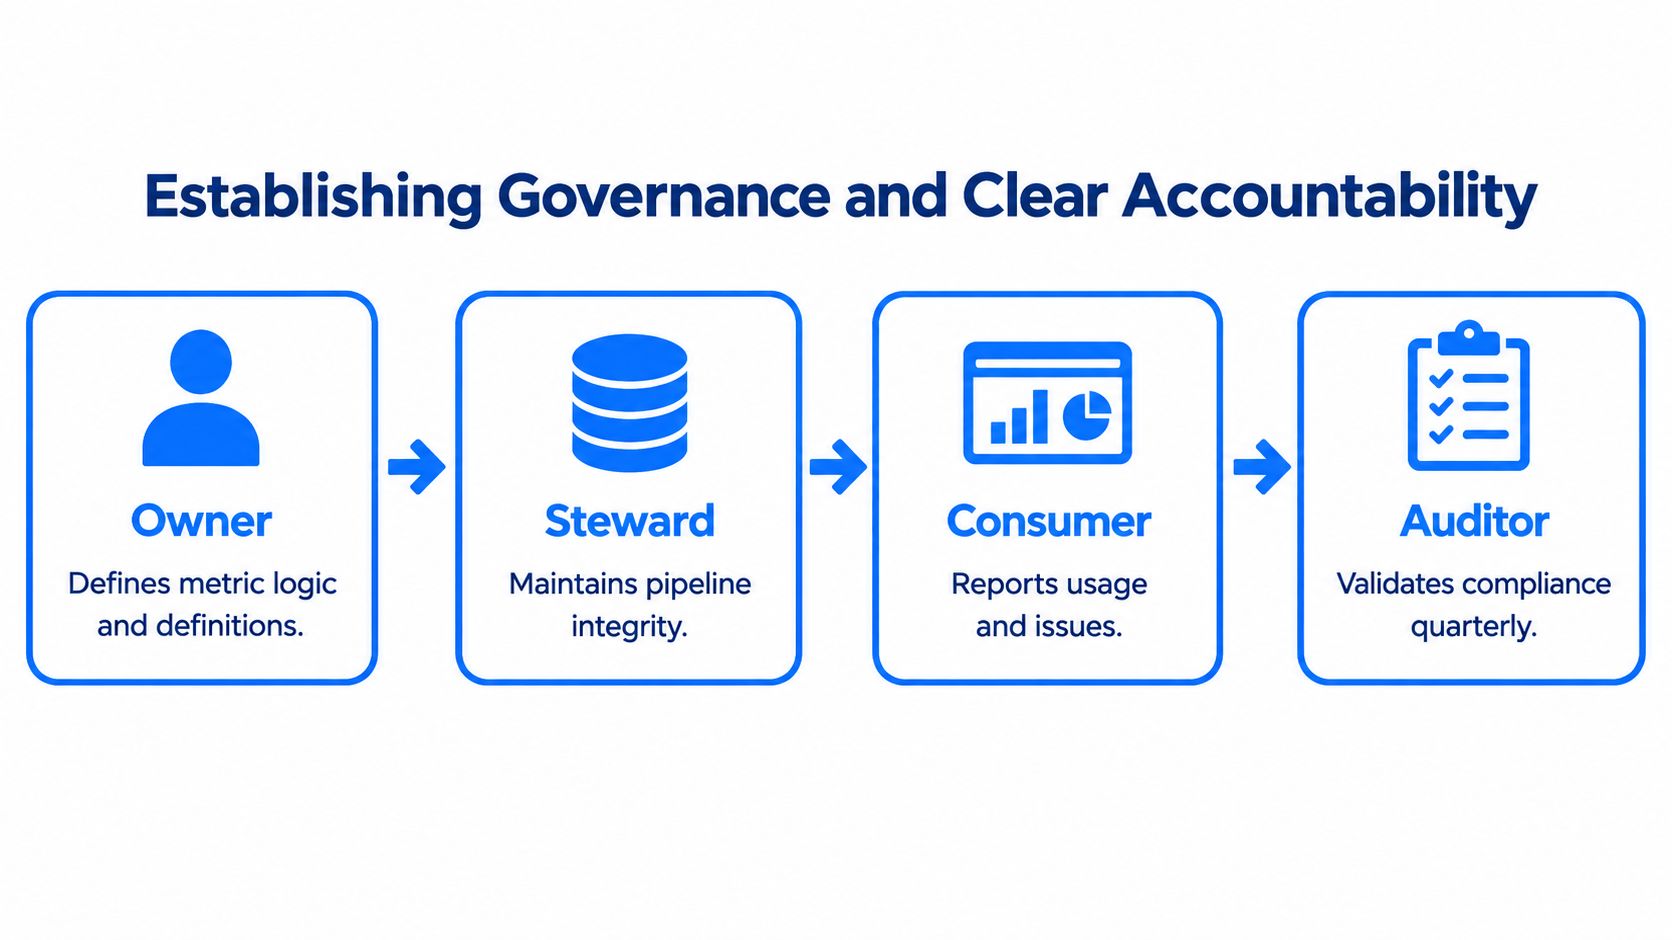
Fachlicher Owner: Definiert, was die Kennzahl bedeutet, gibt die Interpretation frei und entscheidet, ob sie zweckdienlich bleibt.
Technischer Owner: Pflegt Pipelines, Transformationen, Tests und Abhängigkeiten.
Data Steward: Pflegt Definitionen, Referenzdaten, Lineage und Dokumentation.
Nutzer: Meldet unerwartetes Verhalten und erklärt, wie der KPI verwendet wird.
Auditor oder Kontrollprüfer: Prüft Nachweise, Freigaben und die Historie der Behebungen.
Der Owner muss außerdem eine Wesentlichkeitsschwelle freigeben. Eine geringe Abweichung erfordert vielleicht nur Beobachtung, während eine starke Bewegung bei einem regulatorischen, finanziellen oder operativen KPI einen Veröffentlichungsstopp und eine Eskalation an die Geschäftsleitung erfordern kann. Schwellen sollten die Auswirkungen auf Entscheidungen widerspiegeln, nicht nur statistische Auffälligkeit.
Den Vorfallsdatensatz vor dem Vorfall gestalten
Ein nützlicher Vorfallsdatensatz erfasst den erkannten Zustand, den betroffenen Zeitraum, die aktuelle Definitionsversion, Quelländerungen, Schweregrad, Owner, Auswirkungen auf Entscheidungen, Einstufung, Behebung und Nachweise der erneuten Validierung. Er sollte drei Ergebnisse unterscheiden:
Technischer Fehler, bei dem die Quelle oder die Transformation falsch ist.
Semantischer Fehler, bei dem die Berechnung nicht mehr der freigegebenen Bedeutung entspricht.
Legitimes Ereignis, bei dem sich das Geschäft verändert hat und der KPI diese Veränderung korrekt abbildet.
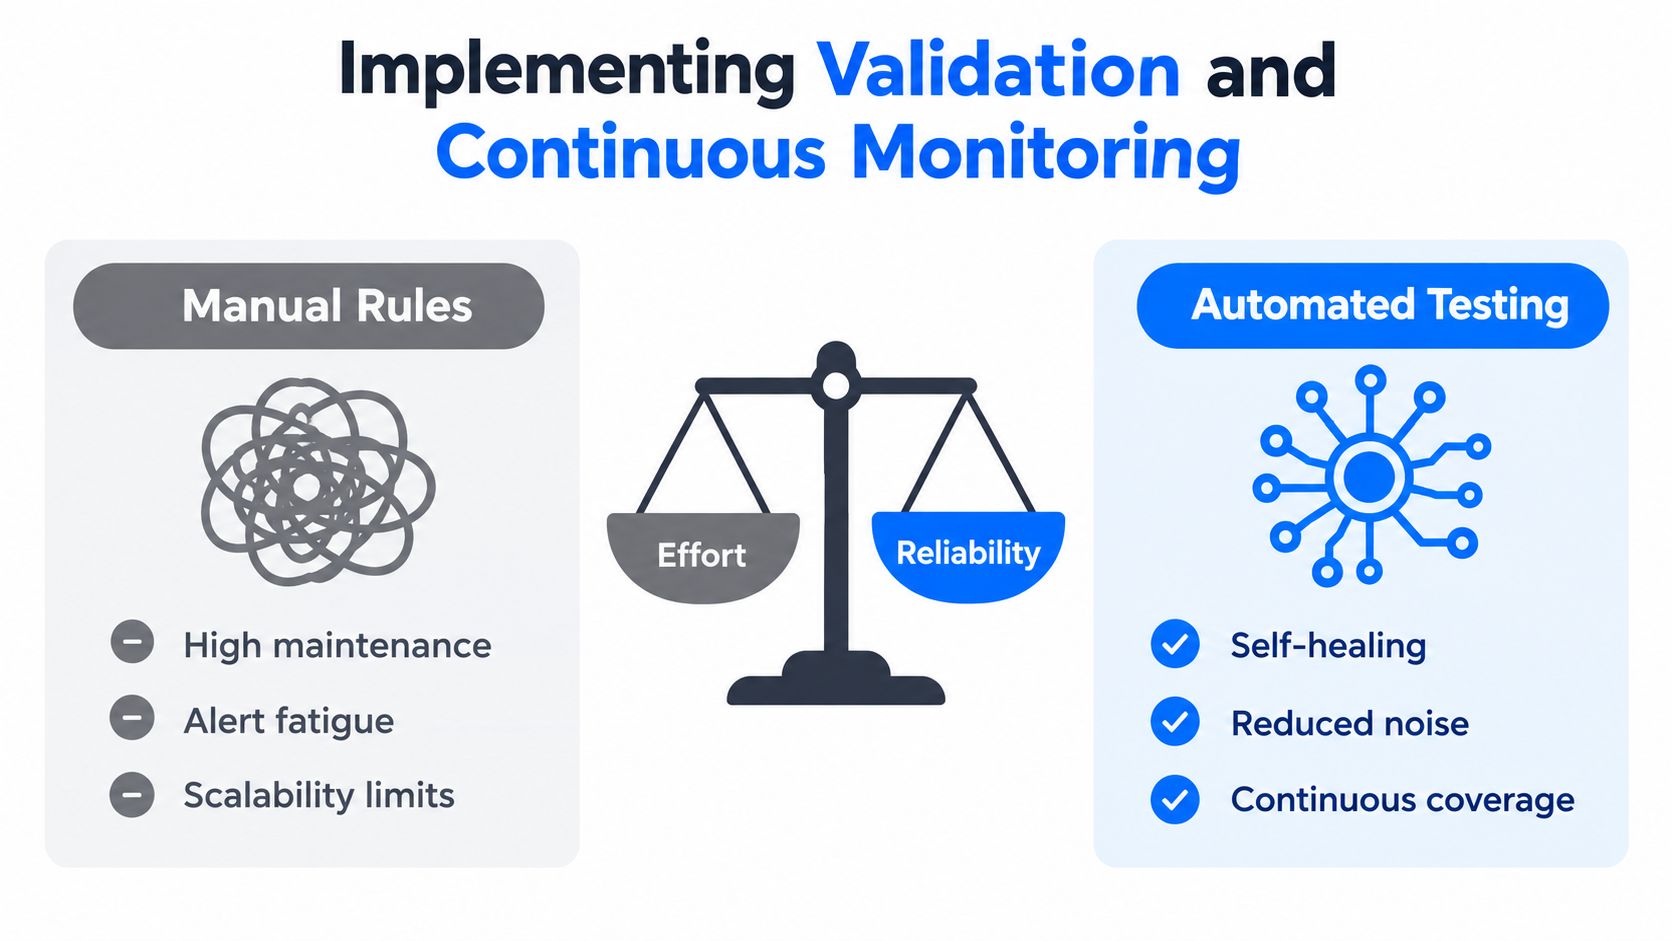
Manuelle Regeln bleiben für stabile Aussagen mit hoher Tragweite wertvoll. Teuer werden sie, wenn Teams für jede Tabelle, jede Kohorte und jeden Berichtskontext eigene Schwellen schreiben und diese nach jeder normalen geschäftlichen Veränderung nachjustieren. Automatische Baselines können den Pflegeaufwand senken und unbekannte Drift sichtbar machen, ersetzen aber keine fachliche Freigabe. Ein Anomaliedetektor kann „ungewöhnlich“ sagen. Er kann nicht entscheiden, ob eine neue Preispolitik die Bewegung korrekt macht.
Nutzen Sie die Ressource von digna zur Data Quality Governance, wenn Sie das Betriebsmodell gestalten. Das entscheidende Ergebnis ist messbare Verantwortlichkeit, einschließlich Zeit bis zur Triage, Zeit bis zur Behebung, Abschlussnachweisen, Wiederholungen und dem Anteil der Alarme, die Owner als gültige Geschäftsereignisse einstufen.
Ein wirksames Governance-Programm macht Meinungsverschiedenheiten sichtbar. Wenn Führungskräfte in einem Score Reife sehen, während Fachanwendern Owner und Eskalationswege fehlen, ist das Kontrollumfeld noch nicht reif. Es ist dokumentiert, aber nicht gelebt.
Validierung und kontinuierliches Monitoring umsetzen
Handgeschriebene Regeln sind präzise, skalieren aber nicht unbegrenzt. Sie funktionieren gut für vertragliche Bedingungen, regulatorische Anforderungen und bekannte Geschäftslogik. Als einzige Methode, unerwartetes Verhalten in einer großen, sich wandelnden Pipeline-Landschaft zu entdecken, funktionieren sie schlecht.
Deterministische und verhaltensbasierte Kontrollen kombinieren
Deterministische Validierung fragt, ob ein Wert oder Datensatz eine explizite Bedingung erfüllt. Beispiele:
Eine Bestellung muss auf einen existierenden Kunden verweisen.
Ein Transaktionsdatum muss in einen zulässigen Berichtszeitraum fallen.
Ein KPI-Nenner darf nicht null sein.
Ein regulierter Wert muss einen freigegebenen Code verwenden.
Ein erforderliches Geschäftsereignis muss eintreffen, bevor die abhängige Aggregation läuft.
Diese Regeln sind erklärbar und prüfbar. Sie erfordern aber auch Pflege. Fachliche Definitionen ändern sich, Quellsysteme entwickeln sich weiter, und Ausnahmen vervielfachen sich. Ohne Verantwortliche werden Regelsammlungen brüchig, und das Alarmvolumen steigt, bis Engineers ihnen nicht mehr vertrauen.
Verhaltensbasiertes Monitoring geht anders vor. Es lernt das normale Muster eines Datensatzes, eines Lieferplans, eines Volumenprofils oder eines Geschäfts-KPI und hebt dann ungewöhnliche Bewegungen hervor. Das hilft bei unbekannten Fehlern, schleichender Drift, ungewöhnlicher Volatilität, fehlenden Ladungen und Veränderungen, die beim Schreiben der ursprünglichen Regeln niemand vorhergesehen hat.
Der Zielkonflikt liegt in der Interpretierbarkeit. Eine feste Regel kann genau erklären, warum eine Zeile durchgefallen ist. Ein verhaltensbasierter Alarm kann eine bedeutsame Abweichung erkennen, ohne ihre Ursache zu benennen. Deshalb kombiniert die stärkste Architektur beide Methoden, statt sie als Konkurrenten zu behandeln.
Sensible Daten an Ort und Stelle belassen
In Unternehmensumgebungen ist die Monitoring-Architektur ebenso wichtig wie die Erkennungslogik. Wenn Kennzahlenberechnungen und Prüfungen auf Datensatzebene in den eigenen Datenbanken des Kunden ausgeführt werden, lässt sich Datenbewegung reduzieren und Sicherheitsanforderungen werden leichter erfüllt. Teams können Daten in Warehouse und Lake außerdem dort validieren, wo sie bereits liegen, statt zusätzliche Extraktionspfade für Observability aufzubauen.
Eine praktische Umsetzungsreihenfolge sieht so aus:
Mit kritischen KPIs beginnen, ihren Quelltabellen, Definitionen, Ownern und Geschäftsentscheidungen.
Deterministische Prüfungen ergänzen für bekannte Bedingungen zu Korrektheit, Compliance und Abgleich.
Verhaltensbasierte Baselines aufbauen für Volumen, Aktualität, Verteilungen und KPI-Bewegungen.
Alarme nach Verantwortung routen, nicht in einen gemeinsamen Kanal ohne zuständige Person.
Alarmergebnisse auswerten und dann Schwellen, Definitionen und Schweregrade anhand tatsächlicher Entscheidungen nachjustieren.
Der Leitfaden zu Datenvalidierung, Regeln, Prüfungen und kontinuierlicher Qualität hilft dabei, diese Kombination aus Validierung auf Datensatzebene und kontinuierlichem Monitoring zu strukturieren. Die Wahl der Plattform ist weniger wichtig als die operative Disziplin. Jeder Alarm braucht einen Empfänger, einen Entscheidungsweg und eine Aufzeichnung dessen, was danach geschah.
Alarmempfindlichkeit als operatives Budget steuern
Hohe Empfindlichkeit erkennt mehr potenzielle Fehler, erzeugt aber auch mehr Rauschen. Niedrige Empfindlichkeit schont die Aufmerksamkeit, kann aber schleichende Fehler oder Fehler bei geringem Volumen übersehen. Legen Sie den Schweregrad nach geschäftlicher Auswirkung fest und prüfen Sie Fehlalarme und übersehene Vorfälle als Teil des Kontrollprogramms.
Unterdrücken Sie ungewöhnliche Bewegungen nicht automatisch. Fragen Sie zuerst, ob das Ereignis real ist, ob die Definition noch gilt und ob die betroffene Entscheidung eine neu berechnete Kennzahl erfordert. Statistische Erkennung sollte eine Untersuchung auslösen, nicht die Verantwortlichkeit überschreiben.
Wirksame Workflows zur Behebung gestalten
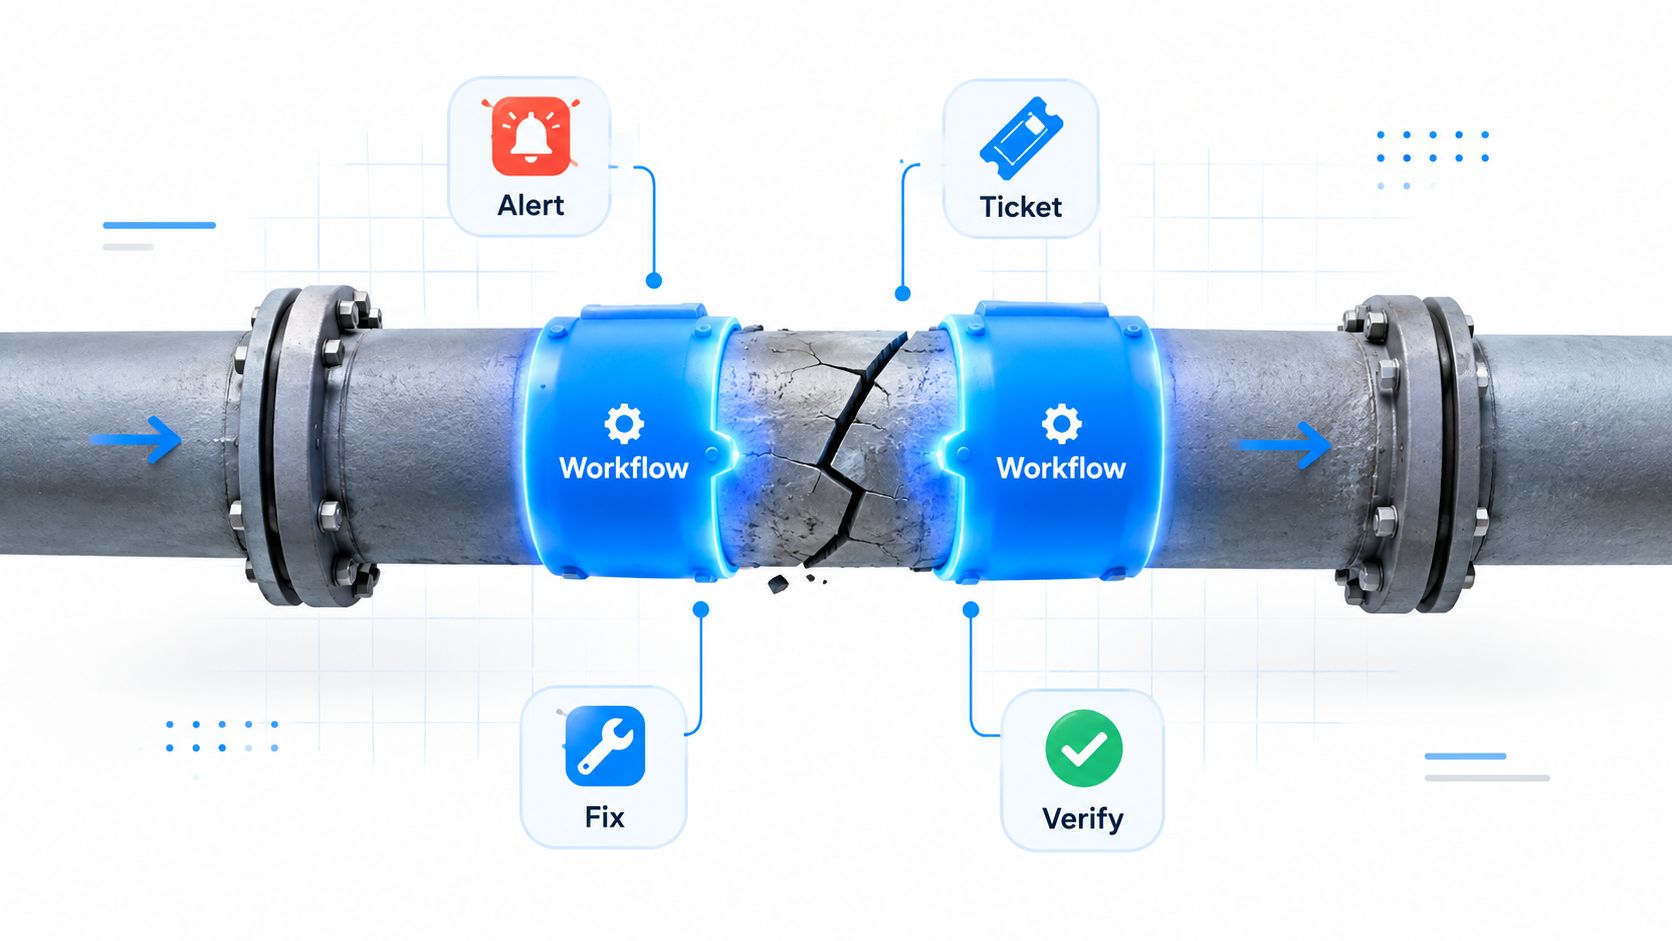
Erkennung ohne Reaktion ist teure Telemetrie. Ein nützlicher Workflow macht aus einer fehlgeschlagenen Prüfung eine verantwortete Entscheidung, mit genügend Nachweisen, damit eine andere Person nachvollziehen kann, was passiert ist, ohne die gesamte Untersuchung zu rekonstruieren.
Technische Reparatur und semantische Prüfung trennen
Eine kaputte Pipeline und eine veränderte fachliche Bedeutung brauchen unterschiedliche Zuständige. Ein Engineer kann eine fehlgeschlagene Transformation reparieren, aber ein fachlicher Owner muss entscheiden, ob ein neues Kundensegment zur Grundgesamtheit des KPI gehört. Werden beide Vorfälle in dieselbe Warteschlange geleitet, verlangsamt das die Wiederherstellung und verwischt die Verantwortlichkeit.
Nutzen Sie einen gemeinsamen Workflow mit unterschiedlichen Entscheidungszweigen:
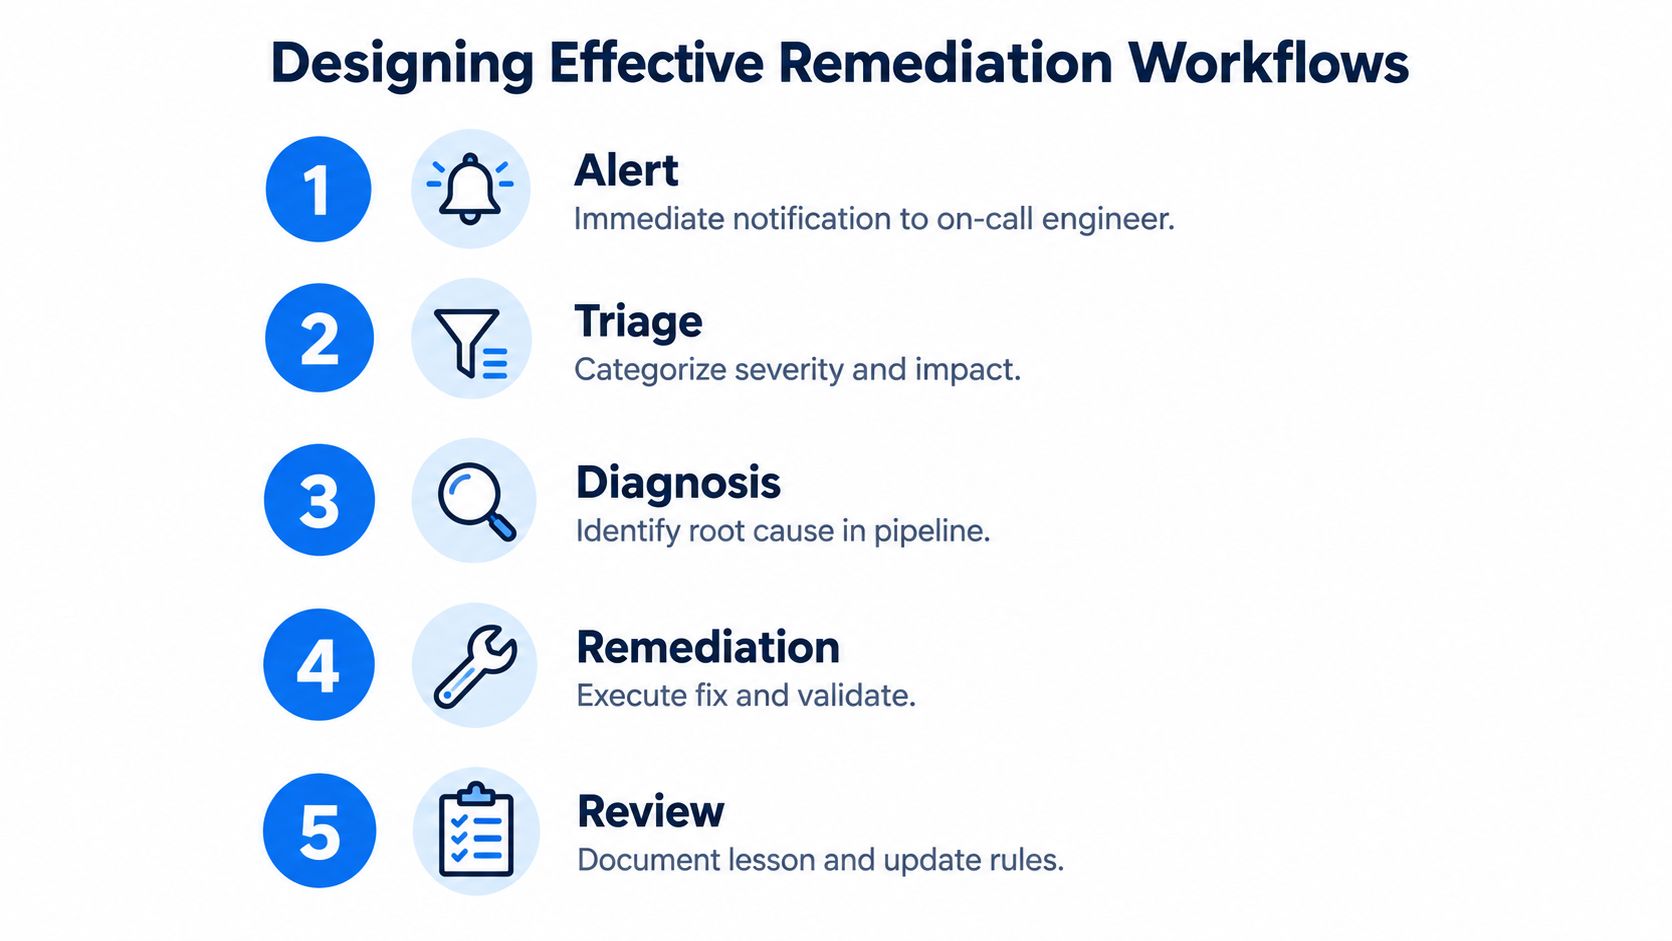
Alarm: Erfassen Sie die fehlgeschlagene Kontrolle, den betroffenen KPI, das Datenintervall und den Erkennungskontext.
Triage: Stufen Sie Schweregrad, betroffene Nutzer und Auswirkungen auf Entscheidungen ein und klären Sie, ob die Veröffentlichung pausieren sollte.
Diagnose: Verfolgen Sie das Problem durch Quellsysteme, Transformationen, Referenzdaten, Definitionen und jüngste geschäftliche Veränderungen.
Behebung: Korrigieren Sie Quelle oder Logik, berechnen Sie die Kennzahl bei Bedarf neu und validieren Sie die nachgelagerten Ergebnisse.
Review: Dokumentieren Sie Ursache, Entscheidung des Owners, Nachweise, Maßnahmen gegen Wiederholung und den Abschluss.
Der Owner sollte ausdrücklich festhalten, wenn eine Anomalie als legitim akzeptiert wird. Diese Freigabe bewahrt die Organisation davor, ein bekanntes Geschäftsereignis immer wieder neu aufzurollen, und erhält die Begründung für Auditoren und künftige Analysten.
Korrekturpflichten als Service-Ziele verfolgen
Personenbezogene Daten bringen eine konkrete operative Anforderung mit sich. Nach Artikel 5 der DSGVO müssen personenbezogene Daten sachlich richtig und erforderlichenfalls auf dem neuesten Stand sein. Organisationen müssen angemessene Maßnahmen treffen, um unrichtige Daten unverzüglich zu berichtigen oder zu löschen, und gleichzeitig Daten auf das für den Zweck notwendige Maß beschränken und nur so lange wie nötig speichern. Die Verordnung ist über den DSGVO-Text auf EUR-Lex verfügbar.
Laut Leitfaden der Europäischen Kommission zu Anfragen von Einzelpersonen muss eine Organisation, die gebeten wird, unrichtige personenbezogene Daten zu berichtigen, unverzüglich handeln, grundsätzlich innerhalb von einem Monat, oder die Ablehnung schriftlich begründen. Für die KPI-Governance entsteht so ein messbares Ziel für Vorfälle mit personenbezogenen Daten.
Verfolgen Sie den gesamten Lebenszyklus:
Workflow-Feld | Operative Frage |
|---|---|
Eingang | Wann ging der Fehler oder die Korrekturanfrage ein? |
Verantwortung | Wer ist für Entscheidung und Behebung verantwortlich? |
Umfang | Welche Datensätze, KPIs, Berichte und KI-Ergebnisse sind betroffen? |
Behebung | Was wurde geändert, und wurde die Quelle korrigiert oder nur der Bericht? |
Verifizierung | Welche Nachweise belegen, dass die Korrektur gewirkt hat? |
Abschluss | Wurde der Vorfall innerhalb der geltenden Erwartung gelöst? |
Ein starker Workflow verspricht nicht, dass jeder Vorfall einfach ist. Er sorgt dafür, dass Komplexität die Verantwortlichkeit nicht auslöscht.
Eine belastbare KPI-Qualitätsstrategie aufbauen
Eine belastbare KPI-Qualitätsstrategie wächst mit der Organisation, statt am ersten Tag jeden denkbaren Fehler modellieren zu wollen. Beginnen Sie mit Kennzahlen, die wesentliche Entscheidungen treiben, und erweitern Sie die Abdeckung, sobald Owner, Definitionen und Vorfallsroutinen reifen.
Die Plattform sollte mehrere Kontrolltypen unterstützen, ohne Teams zu zwingen, ihr Betriebsmodell für jeden einzelnen neu aufzubauen. Business Monitoring, Timeliness, Schema Tracking, Validierung auf Datensatzebene, Anomalieerkennung und historische Analyse adressieren unterschiedliche Fehlerarten. Sie sollten dennoch einen gemeinsamen Vorfallsdatensatz und ein gemeinsames Verantwortungsmodell erzeugen.
In Schichten skalieren
Eine praktische Abfolge ist:
Fundament: Kritische KPIs, Owner, Quellsysteme, Grundgesamtheiten, Nenner und Entscheidungsnutzung definieren.
Zuverlässigkeit: Aktualität, Volumen, Vollständigkeit, Gültigkeit, Schemaänderungen und Quellabgleich überwachen.
Bedeutung: Definitionen versionieren, Kohorten und Filter testen, Geschäftsereignisse dokumentieren und die Freigabe durch Owner verlangen.
Reaktion: Schweregrade, Routing, Fristen für die Behebung, Aufbewahrung von Nachweisen und Abschlussberichte ergänzen.
Optimierung: Wiederkehrende Vorfälle, Alarmpräzision, Auswirkungen auf Entscheidungen und Kontrollabdeckung analysieren.
Ausführung in der Datenbank hilft Teams, sensible Daten ohne unnötige Bewegung zu überwachen. Ein modulares Deployment erlaubt einer Organisation zudem, mit einer fokussierten Fähigkeit wie Anomalieerkennung oder Timeliness zu beginnen und dann auf Geschäftsregeln und Schema-Monitoring auszuweiten, sobald das Kontrollprogramm seinen Wert bewiesen hat.
Der richtige Maßstab für Reife ist nicht die Zahl der konfigurierten Prüfungen. Es ist die Frage, ob Teams schnell und mit Nachweisen vier Fragen beantworten können: Was hat sich geändert? Bedeutet der KPI noch, was wir glauben? Wer entscheidet, was als Nächstes passiert? Woran erkennen wir, dass das Problem abgeschlossen ist?
Behandeln Sie KPI-Qualitätskontrolle als dauerhafte Geschäftskontrolle, nicht als Dashboard-Funktion. Engineers schützen den Datenpfad, fachliche Owner schützen die Bedeutung, und Governance-Teams machen die Nachweise für Reporting, Compliance und KI wiederverwendbar. Diese Aufgabenteilung verhindert, dass eine sauber aussehende Kennzahl zu einer teuren Fehlentscheidung wird.
digna bietet modulare Data Observability für Anomalieerkennung, Timeliness, Validierung auf Datensatzebene, Schemaänderungen und das Monitoring von Geschäfts-KPIs in Ihrer eigenen Umgebung. Nutzen Sie digna, um technische Kontrollen mit entscheidungstauglicher Validierung, verantworteten Vorfalls-Workflows und Nachweisen zu verbinden, auf deren Basis Ihre Daten- und Fachteams handeln können.
Wenn Ihre kritischen KPIs eine kontinuierliche Überwachung direkt neben den Daten brauchen, aus denen sie entstehen, sehen Sie sich an, wie Business Monitoring mit digna Kennzahlenbewegungen beobachtet und ungewöhnliche Veränderungen an die verantwortlichen Owner weiterleitet.
Häufig gestellte Fragen
Was ist KPI-Qualitätskontrolle?
KPI-Qualitätskontrolle prüft, ob eine Geschäftskennzahl nicht nur technisch korrekt ist, sondern auch für die Entscheidung taugt, die sie stützen soll. Sie verbindet Pipeline-Prüfungen wie Schema, Nullwerte und Volumen mit semantischen Tests von Definitionen, Nennern und Kohorten sowie einer Prüfung der Vergleichbarkeit durch den fachlichen Owner.
Warum kann ein KPI irreführend sein, obwohl die Pipeline alle Prüfungen besteht?
Eine erfolgreiche Pipeline belegt nur, dass Daten bewegt wurden. Ein KPI zum Umsatzwachstum kann vollständig, aktuell und korrekt typisiert sein und trotzdem täuschen, wenn eine Übernahme die Grundgesamtheit verändert, Preiserhöhungen die Bewegung erklären oder der Nenner eine neu relevante Kohorte ausschließt. Auf Schemaebene bricht dabei nichts.
Wer sollte für die Qualität eines KPI verantwortlich sein?
Die Verantwortung ist geteilt, doch über die Bedeutung entscheidet der fachliche Owner. Der Leitfaden empfiehlt fünf Rollen pro kritischem KPI: einen fachlichen Owner für die Interpretation, einen technischen Owner für Pipelines und Tests, einen Data Steward für Definitionen und Lineage, Nutzer, die Probleme melden, sowie einen Auditor.
Was unterscheidet syntaktische, semantische und pragmatische Datenqualität?
ISO 8000-1:2022 trennt diese drei Ebenen. Syntaktische Qualität prüft die Übereinstimmung mit einem freigegebenen Format, etwa Schema und zulässige Werte. Semantische Qualität fragt, ob Werte das gemeinte Konzept abbilden, geprüft über Joins, Kohorten und Nenner. Pragmatische Qualität fragt, ob der KPI seine Entscheidung noch stützt.
Sollten Anomalien in KPIs automatisch unterdrückt werden?
Nein. Ein Anomaliedetektor kann eine Bewegung als ungewöhnlich markieren, aber nicht entscheiden, ob eine neue Preispolitik sie korrekt macht. Prüfen Sie zuerst, ob das Ereignis real ist, ob die Definition noch gilt und ob die Entscheidung eine neu berechnete Kennzahl braucht. Akzeptierte Anomalien dokumentiert der Owner als legitime Ereignisse.



