Was sind Qualitätsmetriken? Ein praktischer Leitfaden zur Datentauglichkeit
|
7
min. Lesezeit

Ihr Management-Dashboard zeigt ein stetiges Umsatzwachstum. Die Zahlen wirken beruhigend, also hinterfragt niemand die Kundendaten, die in das zugrunde liegende Modell einfließen. Dann beginnt ein KI-System, auf Basis unvollständiger Datensätze selbstsichere Prognosen zu treffen, und das erste sichtbare Anzeichen für ein Problem zeigt sich in einer Entscheidung, einem Bericht oder einer Kundeninteraktion.
Genau deshalb lohnt sich die Frage, was Qualitätsmetriken sind. Qualitätsmetriken sind messbare Indikatoren, die zeigen, ob Daten definierte Anforderungen erfüllen und für einen bestimmten Zweck geeignet sind. Sie verwandeln vages Vertrauen in Belege, sodass Teams erkennen, was fehlt, verspätet, doppelt, ungültig oder irreführend ist, bevor ein nachgelagerter Nutzer den Preis dafür zahlt.
Inhaltsverzeichnis
Warum Qualitätsmetriken für jede Datenentscheidung wichtig sind
Die Kerndimensionen, die jedes Qualitätsprogramm kennen sollte
Aktualität, Genauigkeit, Konsistenz und Eindeutigkeit in der Praxis
Warum Qualitätsmetriken für jede Datenentscheidung wichtig sind
Ein Dashboard kann technisch verfügbar und trotzdem nicht vertrauenswürdig sein. Wenn Kundendatensätze ohne Pflichtwerte ankommen, wenn Statuscodes in verschiedenen Systemen Unterschiedliches bedeuten oder wenn die Daten von gestern erst nach dem heutigen Entscheidungsfenster eintreffen, behebt die optische Politur des Dashboards das eigentliche Problem nicht.
Qualitätsmetriken machen diese Mängel sichtbar. Sie verbinden den Zustand eines Datensatzes oder einer Datenmenge mit dem Bericht, dem Modell, der regulatorischen Meldung, dem operativen Workflow oder dem KI-System, das sie nutzt. Eine Vollständigkeitsrate zeigt, ob wesentliche Felder befüllt sind. Eine Aktualitätsmessung kann aufdecken, dass eine geplante Lieferung ihren Berichtsstichtag verpasst hat. Eine Gültigkeitsprüfung kann Werte identifizieren, die gegen ein freigegebenes Format oder eine Geschäftsregel verstoßen.
Diese Verbindung ist wichtig, weil unterschiedliche Nutzer unterschiedliche Belege brauchen. Ein Data Engineer muss vielleicht wissen, ob eine Pipeline jede erwartete Partition geladen hat. Ein Analyst muss wissen, ob Kundenzahlen durch Duplikate aufgebläht sind. Ein Compliance-Team braucht womöglich den Nachweis, dass Pflichtfelder vorhanden und gültig waren, als ein Bericht erstellt wurde. Eine Entscheidungsträgerin muss wissen, ob die resultierenden Informationen für die anstehende Entscheidung sicher genug sind.
Praxisregel: Eine Metrik verdient ihren Platz, wenn jemand weiß, was zu tun ist, sobald sie sich verändert.
Ohne diese Handlung wird ein Qualitätsscore zu einer weiteren Dashboard-Dekoration. Ein sinnvolles Programm legt die gemessene Grundgesamtheit, die Berechnungsmethode, den akzeptablen Schwellenwert, die Messhäufigkeit und den geschäftlichen Kontext fest. Wer die übergeordnete organisatorische Begründung sucht, kann auch nachlesen, warum Datenqualität für ein Unternehmen wichtig ist.
Der Weg nach vorn ist klar. Definieren Sie Qualität zunächst in einfacher Sprache. Trennen Sie dann die Kerndimensionen, berechnen Sie sie konsistent und übersetzen Sie sie in entscheidungsspezifische Schwellenwerte. Verknüpfen Sie Verstöße schließlich mit Verantwortlichen, Behebungsmaßnahmen und Geschäftsergebnissen.
Eine praxistaugliche Definition von Qualitätsmetriken
Eine Qualitätsmetrik ist ein messbarer Indikator, mit dem festgestellt wird, ob Daten definierten Anforderungen entsprechen und für einen bestimmten Zweck geeignet sind. Die Definition hat zwei Teile. Der erste betrifft die Frage, ob die Daten Regeln einhalten. Der zweite fragt, ob die Daten für die Aufgabe nützlich sind, die jemand damit erledigen muss.

ISO 8000-8:2015 hat einen Rahmen zur Messung von Informations- und Datenqualität in drei Kategorien geschaffen: syntaktische, semantische und pragmatische Qualität. Damit wird strukturelle Korrektheit von Bedeutung und Nutzen getrennt.
Denken Sie an einen Brief, der per Post verschickt wird. Syntaktische Qualität umfasst das Adressformat, den Aufbau der Postleitzahl und die Angaben auf dem Umschlag. Der Brief folgt den Regeln, die das Postsystem für die Verarbeitung braucht. In einer Datentabelle kann das bedeuten, dass ein Datum ein zulässiges Format verwendet oder ein Statuswert zum erwarteten Datentyp passt.
Semantische Qualität fragt, ob der Inhalt das bedeutet, was er zu bedeuten vorgibt. Ein korrekt formatierter Kundenstatus-Code ist trotzdem schlechte Datenqualität, wenn er nicht den dokumentierten Kundenstatus wiedergibt. Die Struktur kann perfekt sein, während die Bedeutung falsch ist.
Pragmatische Qualität fragt, ob die Information für ihren vorgesehenen Nutzer geeignet und wertvoll ist. Ein Kundendatensatz kann strukturell korrekt und semantisch sinnvoll sein und trotzdem zu spät für eine Betrugsentscheidung oder zu grob für einen regulatorischen Bericht kommen.
Eine Metrik braucht daher mehr als eine Zahl. Legen Sie fest:
Grundgesamtheit: Welche Datensätze, Felder, Lieferungen oder Ereignisse sind enthalten?
Berechnung: Wie wird das Ergebnis ermittelt?
Schwellenwert: Welches Ergebnis ist für diesen Anwendungsfall akzeptabel?
Häufigkeit: Wie oft wird die Messung durchgeführt?
Kontext: Welche Entscheidung, welcher Workflow oder welche Kontrolle hängt davon ab?
Ein Score ohne diese Angaben kann in die Irre führen. Ein Vollständigkeitsergebnis kann über eine ganze Tabelle hinweg gut aussehen und dabei fehlende Werte in einem gesetzlich vorgeschriebenen Feld verbergen. Ein Aktualitätsergebnis kann für einen wöchentlichen Trendbericht akzeptabel wirken, aber für einen operativen Prozess, der die Daten noch am selben Tag braucht, nicht ausreichen.
Das nützlichste mentale Modell ist einfach: Qualitätsmetriken sind die Brücke zwischen einer Datenanforderung und einer Geschäftsentscheidung. Sie zeigen nicht nur, ob Daten korrekt aussehen, sondern ob sich ein bestimmter Nutzer darauf verlassen kann.
Die Kerndimensionen, die jedes Qualitätsprogramm kennen sollte
Das Data Quality Framework der britischen Regierung nennt sechs Kerndimensionen, die auf DAMA UK zurückgehen: Vollständigkeit, Eindeutigkeit, Genauigkeit, Konsistenz, Aktualität und Gültigkeit. Sie werden als getrennte Messgrößen behandelt und nicht als ein Gesamtscore. Die Definitionen des Frameworks liefern ein praktisches Vokabular, um Mängel zu diagnostizieren.
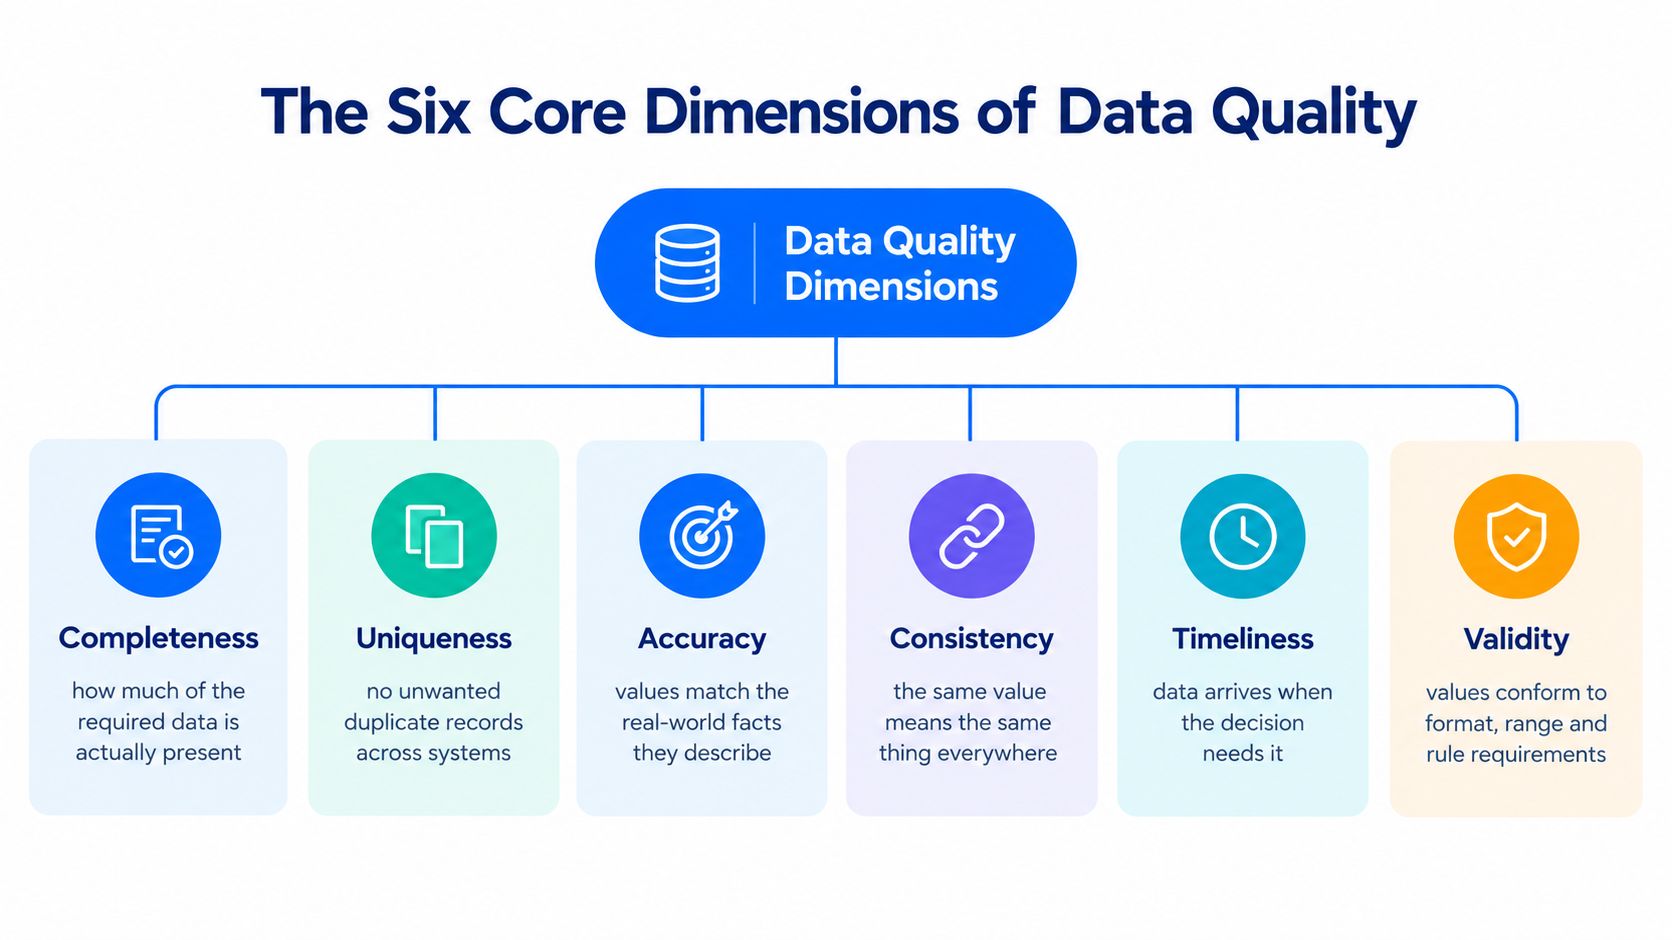
So unterscheiden Sie die Dimensionen:
Vollständigkeit fragt, ob erwartete Datensätze und Pflichtwerte vorhanden sind. Eine Kundentabelle kann jedes erwartete Konto enthalten und trotzdem fehlende Telefonnummern aufweisen.
Eindeutigkeit fragt, ob jede reale Entität nur einmal vorkommt. Zwei Datensätze für einen Kunden können Kontenzahlen und Umsatzauswertungen aufblähen.
Genauigkeit fragt, ob Werte die Realität abbilden. Eine Adresse kann befüllt und korrekt formatiert und dennoch falsch sein.
Konsistenz fragt, ob dieselbe Tatsache überall übereinstimmt, wo sie vorkommt. Der Kontostatus eines Kunden sollte zwischen operativem System und Data Warehouse nicht widersprüchlich sein.
Aktualität fragt, ob Daten dann ankommen, wenn eine Entscheidung sie braucht. Ein Sales-Dashboard kann genau, aber nutzlos sein, wenn die tägliche Ladung erst eintrifft, nachdem die Geschäftsführung die Zahlen geprüft hat.
Gültigkeit fragt, ob Werte definierten Formaten, Wertebereichen, Listen oder Geschäftsregeln entsprechen. Ein befülltes Datum kann trotzdem ungültig sein, wenn es ein unmögliches oder nicht freigegebenes Format verwendet.
Diese Dimensionen beschreiben unterschiedliche Fehlerarten. Ein Datensatz kann vollständig, aber ungenau, gültig, aber inkonsistent, oder aktuell, aber doppelt vorhanden sein. Wer sie zu früh zu einem einzigen „Qualitätsprozentsatz“ zusammenfasst, erschwert es, den Verantwortlichen und die nötige Maßnahme zu identifizieren.
Fehlende Kundenadressen können zum Beispiel in die Verantwortung des Quellsystem-Teams fallen, während doppelte Kundenschlüssel eine Identitätsauflösung erfordern. Ein systemübergreifender Statuskonflikt braucht womöglich eine gemeinsame Definition und einen Data Contract, nicht noch ein weiteres Bereinigungsskript. Für weitere praktische Muster können Beispiele für Datenqualitätsmetriken Teams helfen, Dimensionen mit konkreten Prüfungen zu verbinden.
Ein nützliches Dashboard bewahrt die Mechanik jeder Messgröße. Es sollte einem Team zeigen, ob ein Verstoß von fehlenden, falschen oder widersprüchlichen Werten, von verspäteter Lieferung oder von Duplikaten herrührt. Diese Diagnose ist wertvoller als ein einzelner Mischscore, weil sie auf eine konkrete Lösung hinweist.
Eine ausführlichere Erklärung dieser Kategorien finden Sie im digna-Leitfaden zu den Dimensionen der Datenqualität, doch das Arbeitsprinzip bleibt dasselbe: Messen Sie jede Dimension getrennt, bevor Sie entscheiden, wie Sie sie kombinieren oder priorisieren.
Vollständigkeit und Gültigkeit als Prozentwerte berechnen
Eine Dimension wird operativ, wenn ein Team sie jedes Mal auf dieselbe Weise berechnen kann. Vollständigkeit und Gültigkeit sind gute Ausgangspunkte, weil sich beide als explizite Prozentwerte ausdrücken lassen und dennoch unterschiedliche Probleme aufdecken.
Die Formel für Vollständigkeit lautet:
Vollständigkeitsrate = befüllte Pflichtwerte ÷ erwartete Pflichtwerte × 100
Angenommen, eine Tabelle enthält 98.000 befüllte Pflichtfelder von 100.000 erwarteten Feldern. Das Ergebnis ist eine Vollständigkeitsrate von 98 %, wie in diesem Leitfaden zur Messung von Datenqualitätsmetriken beschrieben.
Die Gültigkeit verwendet einen anderen Nenner:
Gültigkeitsrate = Datensätze, die vordefinierte Regelprüfungen bestehen ÷ insgesamt geprüfte Datensätze × 100
Eine Gültigkeitsregel kann verlangen, dass ein Datum ein freigegebenes Format verwendet, ein Betrag in einem zulässigen Bereich liegt oder ein Status zu einer erlaubten Liste gehört. Ein Feld kann befüllt sein und die Regel trotzdem verletzen, daher sollte Gültigkeit nicht als Ersatz für Vollständigkeit behandelt werden.
Metrik | Formel | Beispieleingabe | Ergebnis | Was sie zeigt |
|---|---|---|---|---|
Vollständigkeitsrate | Befüllte Pflichtwerte ÷ erwartete Pflichtwerte × 100 | 98.000 ÷ 100.000 × 100 | 98 % | Ob Pflichtwerte vorhanden sind |
Gültigkeitsrate | Datensätze, die Regelprüfungen bestehen ÷ geprüfte Datensätze × 100 | Bestandene Datensätze ÷ geprüfte Datensätze × 100 | Abhängig von den Regelergebnissen | Ob befüllte Werte den definierten Regeln entsprechen |
Die Unterscheidung verändert die Behebung. Fehlen Pflichtwerte, muss das Team womöglich einen vorgelagerten Erfassungsprozess reparieren oder ein Quellfeld zum Pflichtfeld machen. Sind die Werte vorhanden, aber ungültig, muss der Verantwortliche eventuell Transformationslogik, Referenzdaten oder Validierungsregeln korrigieren.
Auch die Schwellenwerte sollten getrennt bleiben. Ein Unternehmen kann einige fehlende optionale Attribute tolerieren und gleichzeitig jede ungültige regulatorische Kennung ablehnen. Der richtige Schwellenwert hängt von der Rolle des Feldes und der Entscheidung ab, die es unterstützt, nicht nur vom Gesamtdurchschnitt der Tabelle.
Für die praktische Umsetzung zeigt wie man Datenvollständigkeit misst, wie sich die Formel mit Monitoring-Routinen verbinden lässt. Halten Sie Grundgesamtheit, Regelversion, Prüfzeitpunkt, Ergebnis und Verantwortlichen fest. Diese Historie ermöglicht es Teams, einen einmaligen Fehler von einem wiederkehrenden Quellproblem zu unterscheiden.
Aktualität, Genauigkeit, Konsistenz und Eindeutigkeit in der Praxis
Eine Kundentabelle kann mehrere Prüfungen bestehen und trotzdem einen schlechten Bericht erzeugen. Nehmen Sie einen Vertriebsdatensatz, bei dem Stichproben der Adressen mit einer vertrauenswürdigen Referenz übereinstimmen, die Kundenstatus systemübergreifend übereinstimmen und jede tägliche Datei eintrifft, bevor der Analyst das Dashboard öffnet. Wenn der Ladeprozess doppelte Kundendatensätze erzeugt, können Umsatz und Kundenzahlen dennoch überhöht sein.
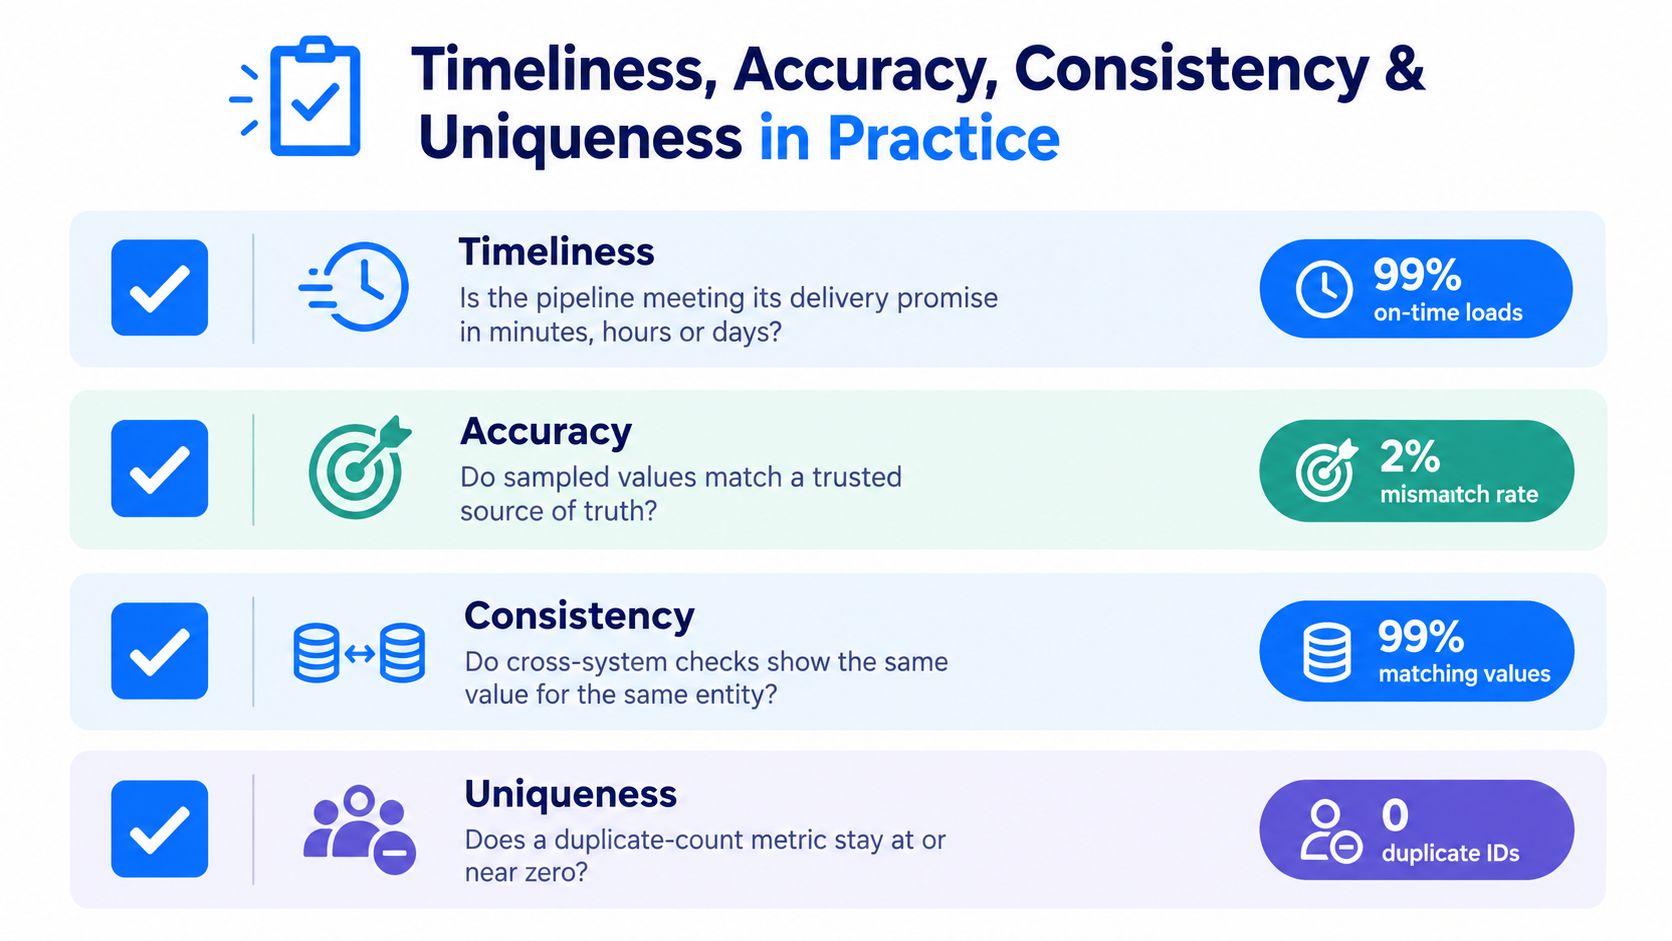
Jede Dimension beantwortet eine andere operative Frage:
Aktualität: Hat die Lieferung ihren erwarteten Zeitplan eingehalten?
Genauigkeit: Stimmen Stichprobenwerte mit einer vertrauenswürdigen Referenzquelle überein?
Konsistenz: Stimmt dieselbe Tatsache über alle Systeme hinweg überein?
Eindeutigkeit: Kommt jede reale Entität nur einmal vor?
Aktualität ist mehr als die Prüfung des neuesten Zeitstempels. Sie vergleicht jeden Lieferzeitpunkt mit einer erwarteten Frist oder einem gelernten Zeitplan und weist dann Kennzahlen aus wie mediane Verzögerung, maximale Verzögerung, Anteil der fristgerechten Lieferungen und Anzahl verpasster Lieferungen, wie in dieser technischen Abhandlung zur Datenaktualität erläutert.
Genauigkeit erfordert oft Stichproben, weil die Realität außerhalb des Datensatzes liegt. Ein Team kann ausgewählte Kundendatensätze mit einer vertrauenswürdigen Referenzquelle vergleichen und schätzen, wie oft die gespeicherten Werte übereinstimmen. Konsistenz erfordert systemübergreifende Vergleiche, etwa die Prüfung, ob ein Kontostatus in der operativen Datenbank und in der analytischen Tabelle denselben Wert hat.
Eindeutigkeit dreht sich um Identität. Ein doppelter Schlüssel oder ein doppelter Kundendatensatz kann Aggregate verzerren, selbst wenn jede einzelne Zeile plausibel erscheint. Deshalb ist Eindeutigkeit besonders wichtig für Kundenzahlen, Transaktionssummen und andere Kennzahlen, bei denen eine Zeile genau eine Entität oder ein Ereignis darstellen muss.
Frische und Aktualität sind keine Synonyme. Daten können einen aktuellen Zeitstempel tragen und trotzdem zu spät für das Entscheidungsfenster eintreffen.
Ändern Sie nun den Anwendungsfall. Derselbe Kundendatensatz kann für eine grobe Trendanalyse ausreichen, bei der einige Duplikate oder verspätete Datensätze die Richtung des Ergebnisses nicht verändern. Für einen regulatorischen Bericht kann er inakzeptabel sein, wenn ein doppeltes Konto, ein widersprüchlicher Status oder eine verpasste Lieferung eine kontrollierte Meldung ungültig machen kann.
Deshalb sollte eine Qualitätsprüfung fragen, welche Entscheidung die Daten unterstützen. Die Antwort bestimmt, ob ein Mangel tolerierbar ist, eine Ausnahme erfordert oder die nachgelagerte Nutzung blockieren muss.
Für Teams, die Liefererwartungen definieren, bietet Metriken und Monitoring der Datenaktualität eine nützliche Referenz, um das Ankunftsverhalten in messbare Kontrollen zu übersetzen.
Von Dimensionen zur Entscheidungstauglichkeit
Eine Qualitätsmetrik wird aussagekräftig, wenn sie eine Entscheidungsfrage beantwortet: Können diese Daten sicher für die anstehende Aufgabe verwendet werden?
Eine generische Checkliste meldet vielleicht Vollständigkeit, Genauigkeit, Gültigkeit und Aktualität für einen Kundendatensatz. Ein Rahmen für Entscheidungstauglichkeit geht weiter und weist jedem Anwendungsfall eine eigene Kritikalität, Gewichtung, Toleranz und einen eigenen Eskalationspfad zu.
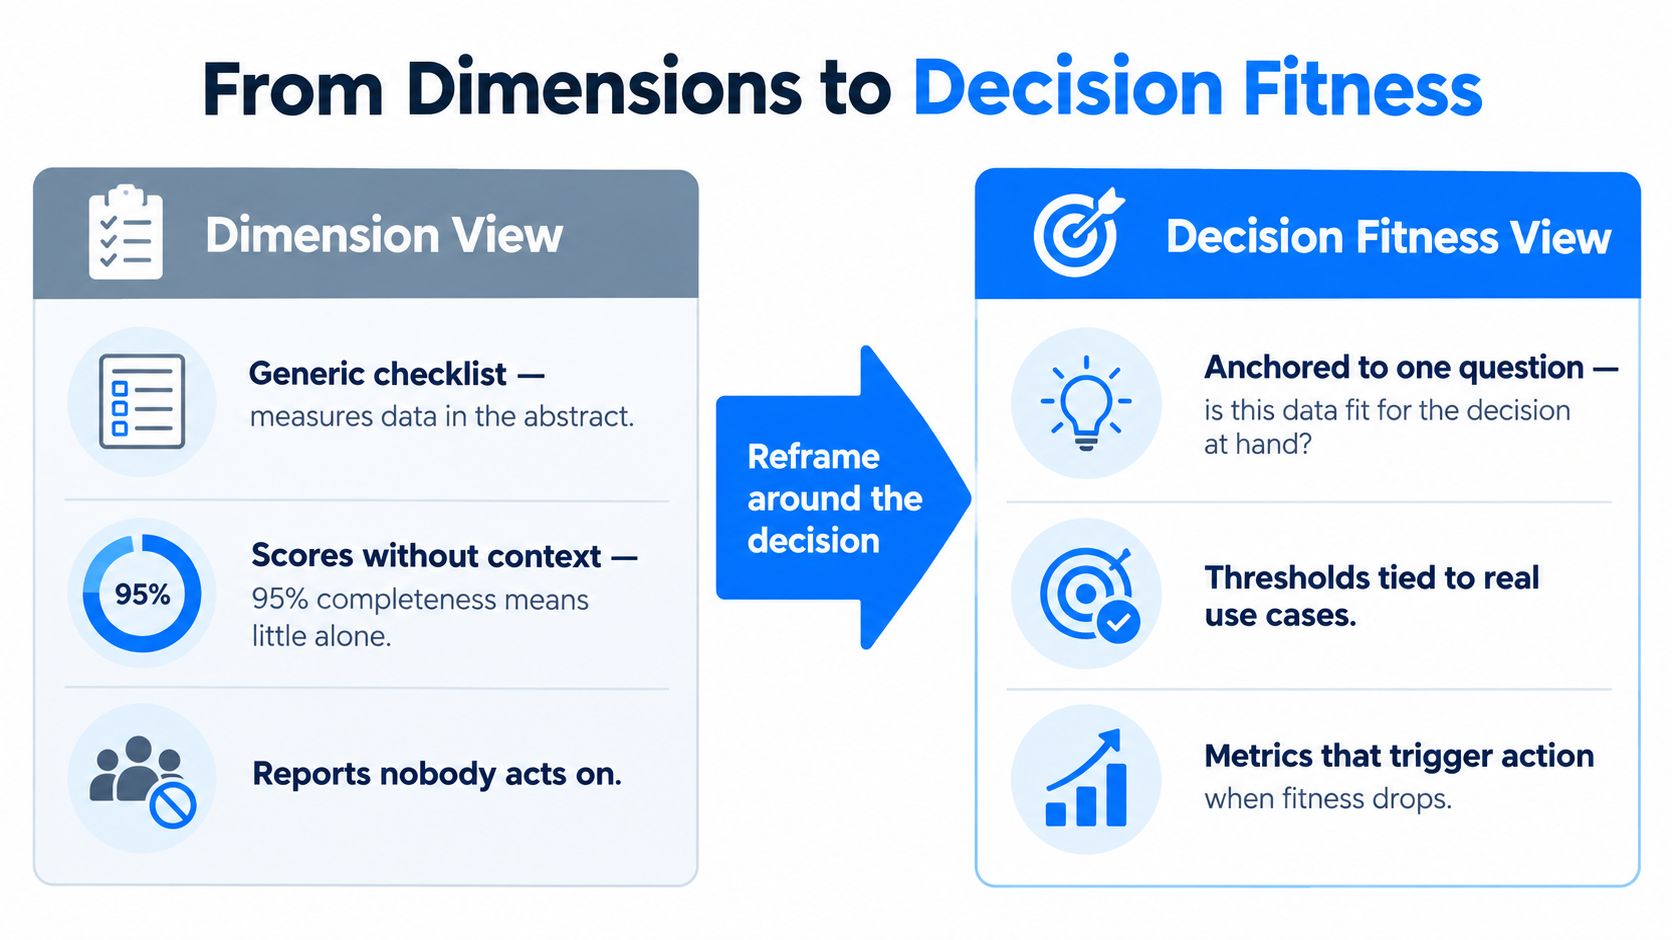
Nehmen Sie das Vollständigkeitsergebnis aus dem früheren Beispiel. Ein Vollständigkeitsscore von 98 % kann für eine Zielgruppenanalyse im Marketing akzeptabel sein, aber inakzeptabel, wenn die fehlenden 2 % gesetzlich vorgeschriebene Felder oder Hochrisikokunden enthalten. Der Gesamtprozentsatz verrät nicht, welche Datensätze fehlen oder welche Folgen das hat.
Ein Design für Entscheidungstauglichkeit sollte Folgendes festlegen:
Kritikalität: Welche Felder oder Datensätze können bei Fehlern wesentlichen Schaden verursachen?
Gewichtung: Sollte eine Pflichtkennung stärker zählen als eine optionale Präferenz?
Toleranz: Welche Unvollkommenheit kann das Unternehmen für diesen Zweck akzeptieren?
Eskalation: Wann löst das Problem eine Warnung, eine Ausnahme, eine Quarantäne oder einen Freigabestopp aus?
Verantwortung: Wer definiert die Regel und wer behebt das Quellproblem?
Derselbe Datensatz kann mehrere Qualitätskontexte durchlaufen. Explorative Analysen können Unsicherheiten tolerieren, die produktive KI nicht verträgt. Ein Trendbericht kann eine verspätete Aktualisierung akzeptieren, die eine regulierte Meldung nicht akzeptieren kann. Eine Kreditentscheidung kann stärkere Genauigkeitsnachweise erfordern als eine grobe Segmentierung.
Data Contracts helfen hier. Ein Contract kann die erwarteten Felder, Bedeutungen, das Lieferverhalten, Validierungsregeln, den Verantwortlichen und die Reaktion bei einer Schwellenwertverletzung dokumentieren. Er macht aus „gut genug“ statt einer informellen Annahme eine vereinbarte Betriebsbedingung.
Die Forschung zeigt, warum ein universeller Score unrealistisch ist. Eine systematische Übersichtsstudie aus dem Jahr 2025 zur Forschung im öffentlichen Sektor identifizierte rund 70 verschiedene Datenqualitätsmetriken und belegt damit fragmentierte Messpraktiken statt eines allgemein akzeptierten Master-Scores, so die systematische Übersichtsstudie.
Eine praktische Scorecard kann den Status weiterhin zusammenfassen, aber die zugrunde liegenden Messgrößen sollten sichtbar bleiben. Jeder Schwellenwert sollte mit einer Entscheidung und einer Handlung verbunden sein. Das ist der Unterschied zwischen dem Messen von Daten und der Steuerung ihrer Nutzung.
Der Business Case und das Argument gegen Perfektion
Qualitätsmetriken sind auch ökonomische Signale. IBM berichtete 2025, dass 43 % der Chief Operations Officers Datenqualitätsprobleme als ihre wichtigste Datenpriorität nannten, während mehr als ein Viertel der Unternehmen jährliche Verluste von über 5 Millionen USD schätzte, die auf schlechte Datenqualität zurückgehen, und 7 % Verluste von 25 Millionen USD oder mehr meldeten. Diese Zahlen sind in der IBM-Analyse zu den Kosten schlechter Datenqualität dokumentiert.
Die Zahlen sind wichtig, weil sie Führungskräften einen Grund geben, technische Messgrößen mit operativen Ergebnissen zu verbinden. Ein Qualitätsvorfall lässt sich gemeinsam mit folgenden Größen verfolgen:
Nacharbeitsstunden: Wie viel Zeit Analysten und Engineers mit der Korrektur von Berichten verbringen.
Pipeline-Ausfälle: Wie oft eine fehlerhafte Ladung einen abhängigen Prozess unterbricht.
Prüfungsfeststellungen: Welche Mängel Kontroll- oder Nachweislücken verursachen.
Fehlentscheidungen: Ob ungenaue oder unvollständige Daten Umsatz, Risiko oder Serviceergebnisse beeinflussen.
Behebungsleistung: Wie schnell Teams wiederkehrende Probleme erkennen und beheben.
Eine geschäftsorientierte Darstellung dieses Zusammenhangs finden Sie im Business Case für Datenqualität von digna, doch das Prinzip reicht über jede einzelne Plattform hinaus.
Mehr Qualität ist nicht immer besser. Die Behebung kann Zeit und Geld kosten, die Verarbeitungslatenz erhöhen, sensible Daten bei der Übertragung exponieren oder wenig Wert liefern, wenn der Datensatz nur eine explorative Frage mit geringem Risiko unterstützt. Eine dokumentierte Unvollkommenheit kann die vernünftige Wahl sein, wenn das Unternehmen die Einschränkung versteht und die Konsequenz akzeptiert.
Das heißt nicht, dass Teams Standards stillschweigend senken sollten. Es bedeutet, dass die Ausnahme einen Verantwortlichen, eine Begründung, ein Ablaufdatum oder eine Überprüfungsbedingung und eine sichtbare Wirkungsmessung braucht. Die Kosten für die Behebung des Mangels sollten mit dem Risiko verglichen werden, ihn bestehen zu lassen.
Das richtige Ziel ist entscheidungsgerechte Qualität, nicht das abstrakte Streben nach Perfektion. Messen Sie konsequent, priorisieren Sie Fehler mit hohen Folgen und machen Sie jede Ausnahme so sichtbar, dass eine verantwortliche Person sie freigeben kann.
Erste Schritte und häufig gestellte Fragen
Beginnen Sie mit zwei oder drei Datensätzen, die folgenreichen Entscheidungen zugrunde liegen. Benennen Sie Verantwortliche, definieren Sie die relevanten Dimensionen, legen Sie Schwellenwerte fest und richten Sie die Erkennung ein, bevor Sie die Abdeckung ausweiten. Verfolgen Sie die Zeit bis zur Erkennung und die Zeit bis zur Behebung zusammen mit Nacharbeit, Prüfungsfeststellungen und finanziellen Verlusten.
Welche Metrik kommt zuerst? Wählen Sie die Dimension, die die Entscheidung am wahrscheinlichsten beeinflusst, nicht den am einfachsten zu berechnenden Prozentsatz.
Wie oft sollten Teams messen? Passen Sie die Häufigkeit an das Entscheidungsfenster an. Operative Daten brauchen womöglich häufige Prüfungen, während langsamere Berichtszyklen seltenere Auswertungen zulassen.
Was, wenn es keine vertrauenswürdige Referenz für die Genauigkeit gibt? Nutzen Sie Konsistenz, Gültigkeit, Herkunftsnachweise und stichprobenartige fachliche Prüfungen, bis eine Referenzquelle etabliert ist.
Wie bleibt das Programm lebendig? Geben Sie jedem Verstoß einen Verantwortlichen, einen Reaktionspfad und eine Ergebnismessung. Überprüfen Sie Schwellenwerte, sobald Datensätze in neue Entscheidungen einfließen.
digna hilft Teams, das Verhalten von Daten zu überwachen, Datensätze anhand von Geschäftsregeln zu validieren, die Aktualität zu verfolgen, Schemaänderungen zu erkennen und Qualitätstrends zu analysieren, und zwar in ihrer eigenen Umgebung. Wenn Sie Qualitätsmetriken über Warehouses, Lakes und Pipelines hinweg mit Entscheidungstauglichkeit verbinden möchten, besuchen Sie digna und entdecken Sie die Plattform.
Wenn Sie die oben beschriebenen Schwellenwerte, Verantwortlichkeiten und Eskalationsregeln in eine verbindliche Betriebsbedingung zwischen Datenproduzenten und -konsumenten überführen möchten, lesen Sie unseren Leitfaden Datenqualität mit Data Contracts steigern.
Häufig gestellte Fragen
Was sind Qualitätsmetriken im Datenmanagement?
Qualitätsmetriken sind messbare Indikatoren, die zeigen, ob Daten definierte Anforderungen erfüllen und für einen bestimmten Zweck geeignet sind. Jede Metrik braucht eine festgelegte Grundgesamtheit, Berechnung, einen Schwellenwert, eine Häufigkeit und einen Geschäftskontext, sonst verbirgt ein einzelner Score etwa fehlende Werte in einem gesetzlich vorgeschriebenen Feld.
Welche sechs Kerndimensionen der Datenqualität gibt es?
Die sechs Kerndimensionen sind Vollständigkeit, Eindeutigkeit, Genauigkeit, Konsistenz, Aktualität und Gültigkeit, wie sie das Data Quality Framework der britischen Regierung auf Basis von DAMA UK beschreibt. Jede steht für eine andere Fehlerart. Ein Datensatz kann vollständig und trotzdem ungenau sein, deshalb misst man sie getrennt.
Wie berechnet man die Vollständigkeitsrate von Daten?
Man teilt die Zahl der befüllten Pflichtwerte durch die Zahl der erwarteten Pflichtwerte und multipliziert mit 100. Bei 98.000 befüllten von 100.000 erwarteten Feldern ergibt das eine Vollständigkeitsrate von 98 %. Die Gültigkeit wird anders berechnet: bestandene Regelprüfungen geteilt durch geprüfte Datensätze.
Worin unterscheiden sich Datenfrische und Aktualität?
Frische beschreibt, wie neu ein Zeitstempel ist, während Aktualität fragt, ob Daten rechtzeitig für die Entscheidung eintreffen, die sie braucht. Ein Datensatz kann einen neuen Zeitstempel tragen und dennoch den Berichtsstichtag verpassen. Gemessen wird Aktualität daher über mediane und maximale Verzögerung sowie verpasste Lieferungen.
Reicht ein Datenqualitätsscore von 98 % aus?
Das hängt ganz von der Entscheidung ab, die die Daten unterstützen. 98 % Vollständigkeit können für eine Zielgruppenanalyse im Marketing genügen, sind aber inakzeptabel, wenn die fehlenden 2 % gesetzlich vorgeschriebene Felder oder Hochrisikokunden betreffen. Legen Sie Schwellenwerte je Anwendungsfall fest, mit Kritikalität, Toleranz und klarem Eskalationspfad.



