Fuzzy-Matching-Algorithmen: Ein Leitfaden für die Praxis
|
7
min. Lesezeit

Bei einem Konfidenzniveau von 0,95 oder höher erreichte ein Ensemble-Ansatz mit Human-in-the-Loop eine Präzision von 88,0 %, während die Jaccard-Ähnlichkeit im selben hohen Score-Bereich auf 85,0 % kam. Die praktische Antwort: Es gibt keinen Fuzzy-Matching-Algorithmus, der universell am besten ist, denn verlässliche Identitätsauflösung hängt von Normalisierung, Kandidatengenerierung, Feldevidenz, Schwellenwerten und manueller Prüfung ab.
Wahrscheinlich kennen Sie das Problem schon. Ein Kunde taucht in Abrechnung, Support und Produktsystemen unter leicht unterschiedlichen Namen auf. Die Adresse eines Lieferanten wechselt das Format zwischen Tochtergesellschaften. Ein Patientendatensatz verwendet in einem System eine Schrift und in einem anderen eine transliterierte Fassung. Exakte Joins übersehen berechtigte Verknüpfungen, während eine zu großzügige Fuzzy-Regel Personen zusammenführen kann, die sich nur ähnlich sehen.
Schwierig ist nicht, einen Ähnlichkeitswert zu berechnen. Schwierig ist, zu entscheiden, was dieser Wert bedeutet, nachzuweisen, warum ein Match freigegeben wurde, und zu erkennen, wann der Matching-Prozess unbemerkt zu versagen beginnt.
Inhaltsverzeichnis
Grundlagen: von der Editierdistanz zur probabilistischen Verknüpfung
Die wichtigsten Algorithmusfamilien und ihre Leistungs-Trade-offs im Vergleich
Die versteckten Kosten ungenauen Datenabgleichs
Ein globaler Gesundheitsdienstleister baut eine Patientensicht womöglich aus Aufnahme-, Labor-, Abrechnungs- und klinischen Systemen auf. Eine Quelle speichert „Muller“, eine andere „Miller“, und eine dritte enthält einen zweiten Vornamen oder ein anderes Adressformat. Ein Gleichheits-Join behandelt diese als getrennte Datensätze, selbst wenn Mitarbeitende den wahrscheinlichen Zusammenhang sofort erkennen.
Der umgekehrte Fehler ist gefährlicher. Zwei Patienten können denselben Nachnamen, dieselbe Adresse oder einen ähnlichen Vornamen haben, ohne dieselbe Person zu sein. Eine falsche Zusammenführung kann Laborergebnisse oder die Krankengeschichte dem falschen Profil zuordnen. Ein nicht aufgelöstes Duplikat kann Behandlungsinformationen zersplittern, wiederholten Verwaltungsaufwand erzeugen und das Reporting schwächen.
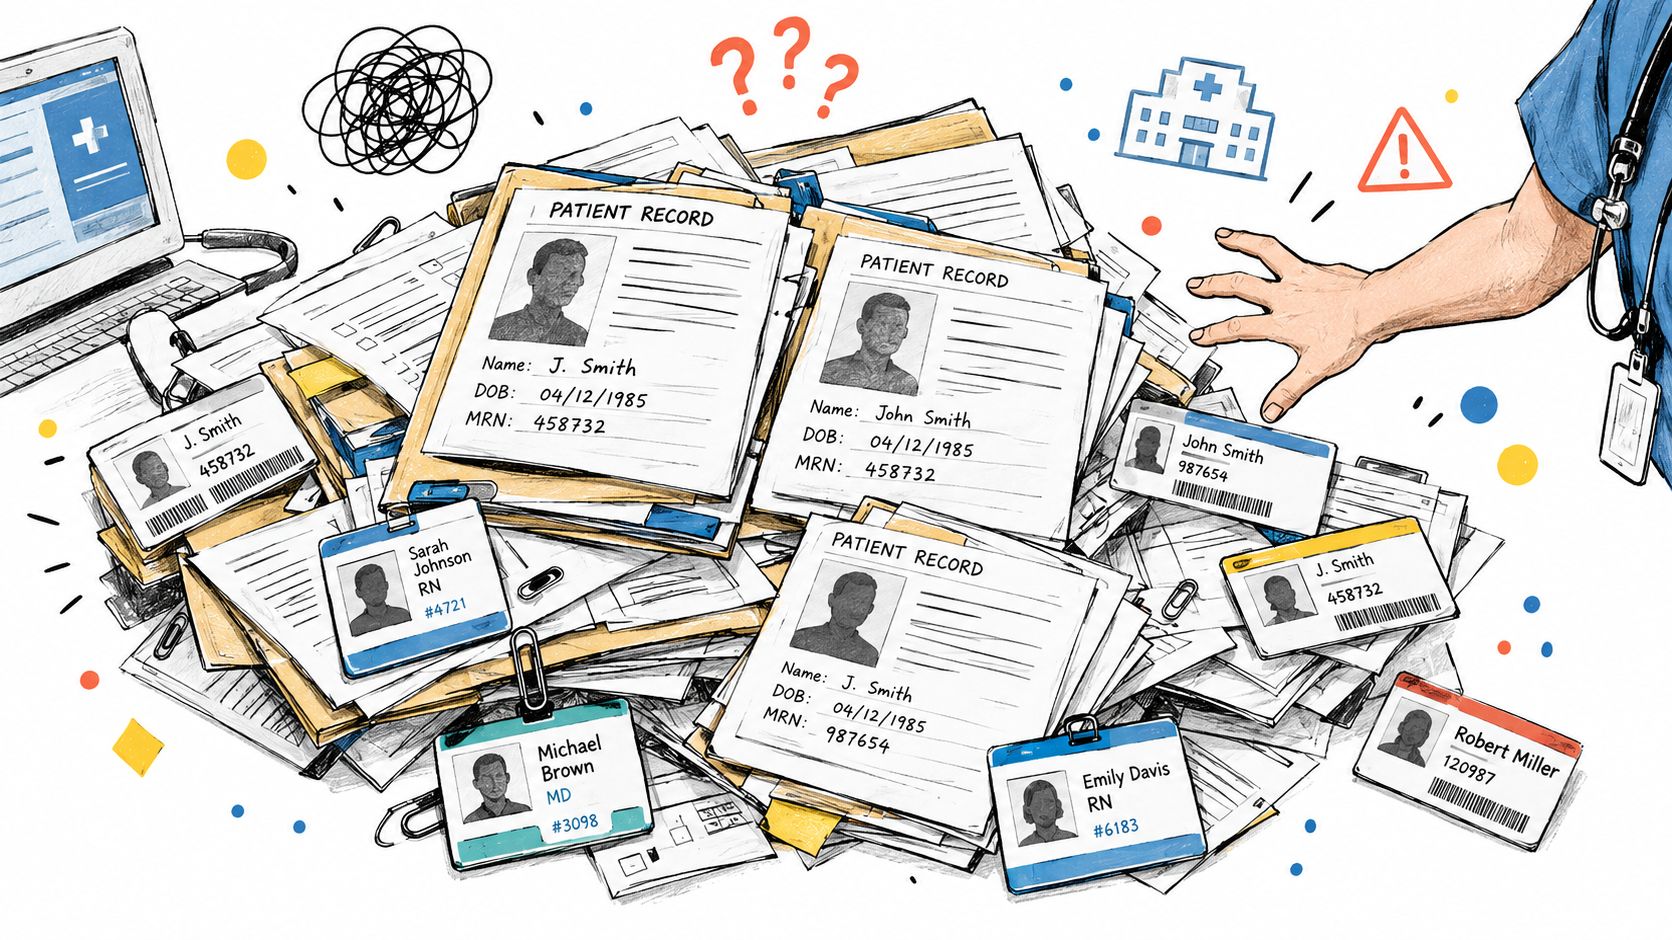
Warum exakte Joins scheitern
Exaktes Matching setzt voraus, dass Werte einheitlich erfasst und ohne nennenswerte Abweichungen übertragen wurden. Unternehmensdaten erfüllen diese Annahme selten. Namen enthalten Schreibvarianten, Adressen enthalten Abkürzungen und umgestellte Bestandteile, und Kennungen können unvollständig sein oder mit Formatierungsrauschen kopiert werden.
Fuzzy-Matching-Algorithmen helfen, indem sie Ähnlichkeit messen, statt Zeichen-für-Zeichen-Gleichheit zu verlangen. Doch Ähnlichkeit ist nur ein Indiz. Ein Namens-Score kann ein Kandidatenpaar identifizieren, aber ohne den Kontext anderer Felder und die geschäftlichen Folgen eines Irrtums keine Identität belegen.
Regel für die Produktion: Behandeln Sie Fuzzy Matching als Entscheidungsworkflow, nicht als klügere Variante eines Gleichheits-Joins.
Diese Unterscheidung zählt im Finanzwesen, im Gesundheitswesen, in der öffentlichen Verwaltung und im Kundenbetrieb. Ein falsches Match verknüpft nicht zusammengehörige Datensätze. Ein falsches Nicht-Match lässt dieselbe Entität zersplittert. Die Kosten jedes Fehlers hängen von der Domäne, dem Feld und davon ab, was nachgelagerte Systeme mit der resultierenden Identität tun.
Teams sollten das Matching-Design deshalb mit umfassenderer datenqualitätsbasierter Entscheidungsfindung verbinden. Die richtige Frage lautet nicht „Welche Zeichenketten sehen sich ähnlich?“, sondern „Welche Evidenz stützt diese Identitätsverknüpfung, welches Risiko entsteht durch eine falsche Zusammenführung, und kann jemand anderes die Entscheidung später prüfen?“
Grundlagen: von der Editierdistanz zur probabilistischen Verknüpfung
Fuzzy Matching hat sich von Editierdistanz-Methoden zur formalen probabilistischen Datensatzverknüpfung entwickelt. 1966 führte Vladimir Levenshtein die nach ihm benannte Distanz ein: die minimale Anzahl einzelner Einfügungen, Löschungen oder Ersetzungen von Zeichen, die nötig sind, um eine Zeichenkette in eine andere zu überführen, wie in der grundlegenden Literatur zur Datensatzverknüpfung von Fellegi und Sunter beschrieben.
Ein Tippfehler mit einem Zeichen hat die Distanz 1. Zeichenketten, die mehr Änderungen erfordern, erhalten größere Distanzen. Da das Verfahren sprachunabhängig ist, wurde es für Rechtschreibprüfung, Deduplizierung, Adressnormalisierung und Entity Resolution nützlich.
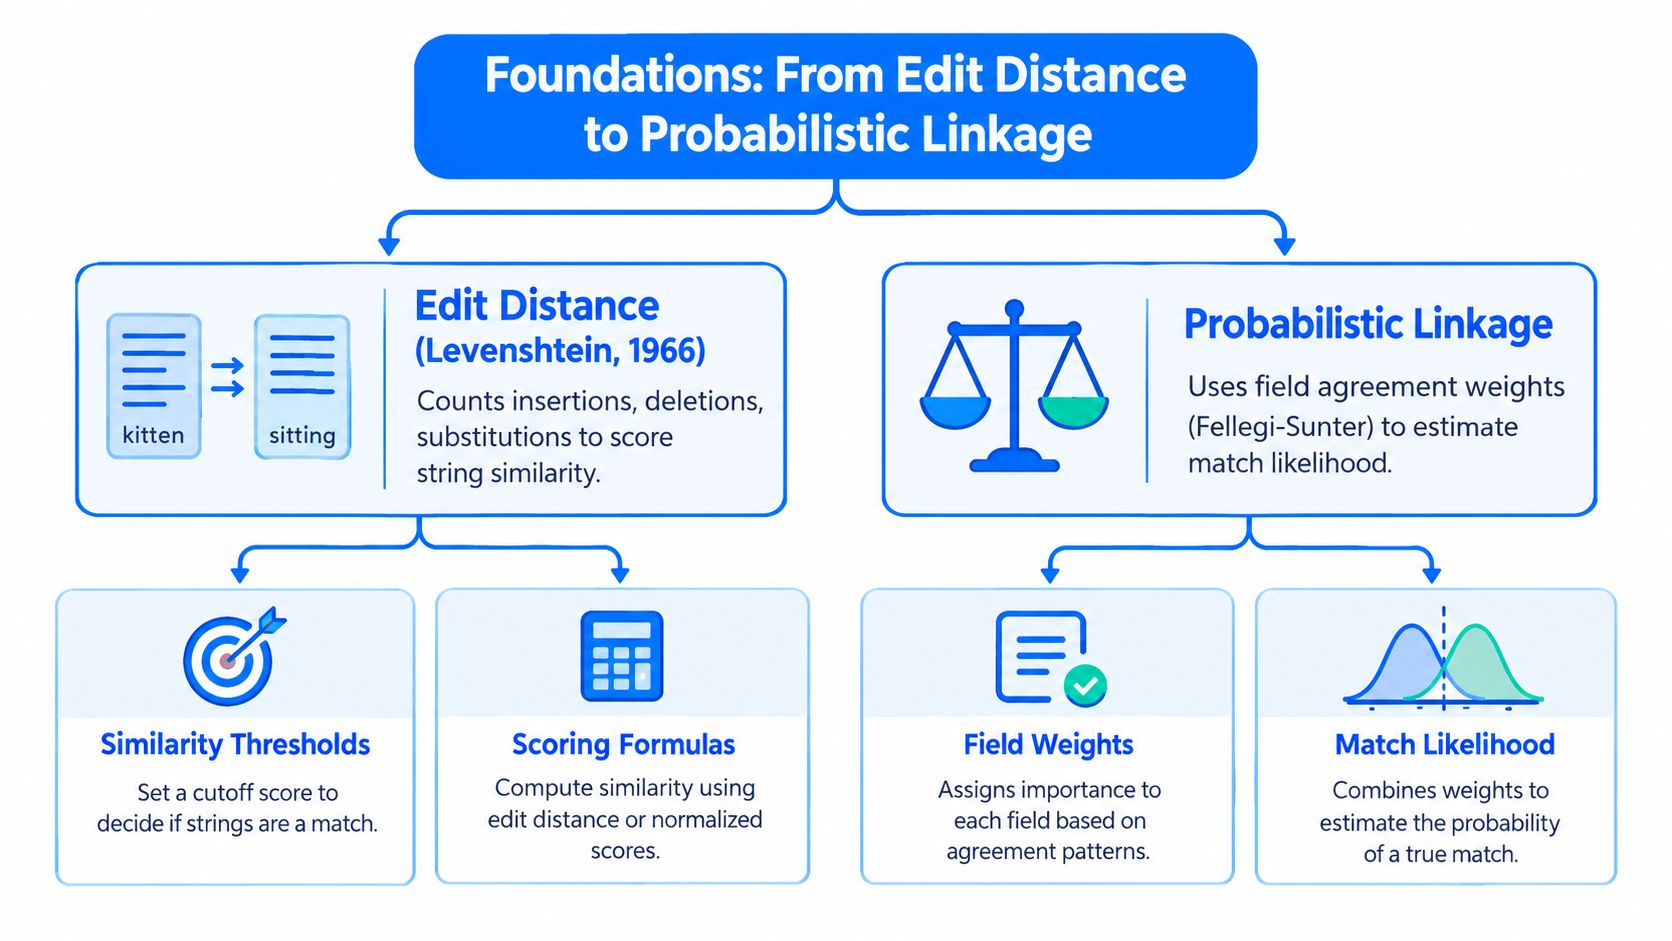
Distanz misst Unterschiede
Die Levenshtein-Distanz beantwortet eine enge, aber wertvolle Frage: Wie viel Text muss sich ändern, damit der andere Wert entsteht? Sie weiß nicht, ob die Werte zur selben Person, Firma, zum selben Konto oder zur selben Adresse gehören.
Das macht sie zu einer nützlichen Vergleichsebene. Sie kann einen Tippfehler in einem Namen oder eine kleine Änderung an einer Kennung erkennen, sollte aber keine unumkehrbare Zusammenführung allein auslösen. Dieselbe Distanz kann bei einem kurzen Namen, einer langen Adresse oder einer risikoreichen Kennung Unterschiedliches bedeuten.
Verknüpfung trifft eine Entscheidung
1969 veröffentlichten Ivan Fellegi und Alan Sunter „A Theory for Record Linkage“. Ihr Rahmenwerk behandelte Matching als statistisches Entscheidungsproblem statt als einzelnen Ähnlichkeits-Cutoff. Es kombiniert Evidenz aus Feldern wie Namen, Adressen, Geburtsdaten und Kennungen und klassifiziert Kandidatenpaare dann als Matches, Nicht-Matches oder unsichere Fälle zur Prüfung.
Das Rahmenwerk trennt ausdrücklich falsche Matches von falschen Nicht-Matches und wählt Schwellenwerte anhand gewünschter Obergrenzen für diese Fehlerarten. Diese Trennung ist für Matching im Unternehmen bis heute zentral, weil Automatisierung und manuelle Prüfung einen messbaren Zielkonflikt bilden.
Ebene | Kernfrage | Typisches Ergebnis |
|---|---|---|
Editierdistanz | Wie verschieden sind diese Werte? | Distanz oder Ähnlichkeit |
Feldvergleich | Welche Attribute stimmen überein? | Evidenz pro Feld |
Probabilistische Verknüpfung | Wie ist die Evidenz zu interpretieren? | Match, Nicht-Match oder Prüfung |
Governance | Lässt sich die Entscheidung später begründen? | Versionierte Evidenz und Audit-Trail |
Die praktische Lehre ist einfach: Nutzen Sie die Distanz, um textliche Unterschiede zu messen, und treffen Sie die Identitätsentscheidung dann mit Evidenz aus mehreren Feldern und gesteuerten Schwellenwerten. Das ist die Brücke zwischen statistischer Mustererkennung und dem produktiven Datenbetrieb.
Die wichtigsten Algorithmusfamilien und ihre Leistungs-Trade-offs im Vergleich
Im Produktivbetrieb gibt es selten den einen besten Algorithmus. Die richtige Wahl hängt vom Feld, seinen Fehlermustern, dem Kandidatenvolumen und den Kosten einer falschen Entscheidung ab. Eine Vergleichsstudie bewertete sieben Ansätze, nämlich Jaccard-Ähnlichkeit, Jaro-Winkler, längste gemeinsame Teilfolge, Levenshtein-Distanz, Kosinus-Ähnlichkeit, N-Gramm-Matching und Damerau-Levenshtein, anhand von Präzision, Recall, F-Maß, Genauigkeit und Rechenleistung in ihrem veröffentlichten Vergleich.
Das Experiment ergab, dass N-Gramm-Matching die beste Präzision, das beste F-Maß und die höchste Genauigkeit lieferte, während die Kosinus-Ähnlichkeit am schnellsten war. N-Gramm und Damerau-Levenshtein waren in diesem Vergleich am langsamsten. Diese Ergebnisse sind Benchmark-Evidenz, keine Einsatzregel. Sie zeigen den praktischen Zielkonflikt: Wer mehr lokale Zeichendetails bewahrt, kann die Match-Qualität verbessern, erhöht aber auch den Verarbeitungsaufwand.
Die Algorithmusfamilie passend zu den Daten wählen
Levenshtein eignet sich für kurze Zeichenketten mit Einfüge-, Lösch- oder Ersetzungsfehlern. Damerau-Levenshtein berücksichtigt zusätzlich benachbarte Vertauschungen und ist daher nützlich, wenn Tippfehler wie vertauschte Zeichen häufig vorkommen.
Jaro-Winkler funktioniert oft gut für Namen und kurze Kennungen, weil übereinstimmende Präfixe ein nützliches Signal tragen können. Jaccard misst die Überschneidung von Tokens, was zu Firmennamen und Adressbestandteilen passt, wenn die Wortreihenfolge weniger wichtig ist. Die Kosinus-Ähnlichkeit stellt Text als Vektoren dar und kann längere Felder effizient verarbeiten.
Algorithmusfamilie | Stärken | Bester Einsatzfall | Rechenaufwand |
|---|---|---|---|
Levenshtein | Klarer, editierbasierter Vergleich | Tippfehler und kurze Kennungen | Mittel |
Damerau-Levenshtein | Erkennt benachbarte Vertauschungen | Tippfehler in Namen und Codes | Hoch |
Jaro-Winkler | Belohnt übereinstimmende Präfixe | Personennamen und kurze Felder | Mittel |
Jaccard | Misst die Überschneidung von Token-Mengen | Adressen und Firmennamen | Mittel |
Kosinus-Ähnlichkeit | Schneller Vektorvergleich | Längere Textfelder | Niedrig im zitierten Vergleich |
N-Gramm-Matching | Erfasst lokale Zeichenstrukturen | Verrauschter Text und teilweise Überschneidung | Hoch im zitierten Vergleich |
Längste gemeinsame Teilfolge | Bewahrt gemeinsame Sequenzstruktur | Geordnete textliche Abweichungen | Datenabhängig |
Warum hybrides Scoring meist gewinnt
Datensätze kombinieren Felder mit unterschiedlichen Fehlermustern. Ein Name braucht vielleicht Zeichenähnlichkeit, eine Adresse profitiert von Token-Vergleichen, und eine Kennung erfordert womöglich eine deterministische Validierung. Eine einzige Metrik überall anzuwenden, erzeugt vermeidbare Fehler und verschwendet Rechenleistung bei Feldern, die eine andere Behandlung brauchen.
Ordnen Sie Algorithmen pro Feld zu und kombinieren Sie deren Evidenz dann nach Regeln, die am Identitätsrisiko ausgerichtet sind. Führen Sie teure Vergleiche erst aus, nachdem das Blocking die Kandidatenmenge verkleinert hat. Benchmark-Ergebnisse können das erste Design leiten, doch gelabelte Paare aus Ihren eigenen Daten sollten entscheiden, ob die zusätzliche Rechenleistung die Entscheidungen so weit verbessert, dass sich der Betriebsaufwand lohnt. Halten Sie die gewählten Algorithmen, Versionen, Schwellenwerte und Prüfergebnisse in einem Audit-Trail fest, damit spätere Änderungen nachvollziehbar bleiben.
Warum Ähnlichkeitswerte keine Wahrscheinlichkeiten sind
Ein produktiver Matcher kann zwei Kundendatensätzen einen Ähnlichkeitswert von 0,87 zuweisen und trotzdem keine direkte Antwort zur Identität liefern. Der Score misst Ähnlichkeit unter einer gewählten Metrik. Er gibt weder die Wahrscheinlichkeit an, dass die Datensätze zur selben Entität gehören, noch zeigt er, welche Felder das Ergebnis erzeugt haben, oder beziffert die Kosten einer falschen Zusammenführung.
Schwellenwerte legen die Lücke zwischen Messung und Entscheidung offen. Bei 0,95 oder höher erreichte ein Ensemble-Ansatz mit Human-in-the-Loop eine Präzision von 88,0 %, verglichen mit 85,0 % für die Jaccard-Ähnlichkeit in diesem hohen Score-Bereich. Die Jaccard-Präzision sank für Scores zwischen 0,90 und 0,95 auf 53,0 %, so die veröffentlichte Fuzzy-Matching-Studie. Wie der Benchmark zeigt, kann auch ein hoher Score unsichere Matches erzeugen.
Der Schwellenwert gehört zur Population
Ein für Kundennamen abgestimmter Cutoff kann für Lieferantenadressen unsicher sein. Transliteration kann das Score-Verhalten von Land zu Land verändern, und Gesundheitsidentitäten haben bei einer falschen Zusammenführung andere Folgen als Marketingkontakte.
Stimmen Sie Schwellenwerte mit gelabelten Paaren aus der Population ab, die das System verarbeiten wird. Messen Sie Präzision und Recall an den im Betrieb verwendeten Cutoffs und schlüsseln Sie die Ergebnisse dann nach Feld, Entitätstyp, Region, Sprache und Quellsystem auf. Ein Gesamtwert kann einen gravierenden Fehler verdecken, der nur eine Sprache oder eine Quelle betrifft.
Enthaltung gezielt einsetzen
Ein produktiver Matcher braucht einen kontrollierten Weg für Unsicherheit. Legen Sie ein Enthaltungsband fest, das mehrdeutige Paare an eine berechtigte prüfende Person weiterleitet, statt eine automatische Entscheidung zu erzwingen.
Automatisch verknüpfen: Nur mit Evidenz, die die geltenden Risikokontrollen bestanden hat.
Prüfen: Kandidatenwerte, Evidenz pro Feld, Schwellenwert und Regelversion anzeigen.
Ablehnen: Datensätze getrennt halten, wenn die vorliegende Evidenz keine Verknüpfung rechtfertigt.
Entscheidungen der Prüfenden sollten zu Governance-Daten werden, statt in einer Warteschlange zu verschwinden. Speichern Sie Kandidaten- und normalisierte Werte, Feld-Scores, den Entscheidungsschwellenwert, die Algorithmusversion, das Prüfergebnis und einen Zeitstempel. Dieser Audit-Trail unterstützt Untersuchungen, Schwellenwertänderungen und reproduzierbare Entscheidungen.
Ein hoher Score ist eine Messung. Eine freigegebene Identitätsverknüpfung ist eine gesteuerte Entscheidung.
Hier werden die Kosten falsch positiver und falsch negativer Ergebnisse operativ greifbar. In einer Hochrisikodomäne kann es sicherer sein, ein mögliches Duplikat ungelöst zu lassen, als eine falsche Zusammenführung zu erzeugen. Anderswo bietet eine breite Kandidatengenerierung mit anschließender manueller Prüfung womöglich bessere Kontrolle. Die richtige Richtlinie hängt von der Entität, der Evidenz und den Folgen eines Fehlers ab.
Mehrsprachiges Matching und der Engpass Blocking
Englische Tippfehler sind die einfache Demonstration. Produktivdaten bringen Transliteration, mehrere Schriftsysteme, wechselnde Namensreihenfolgen, diakritische Zeichen, Bindestriche und länderspezifische Kennungen mit sich. Diese Abweichungen beeinflussen sowohl den Recall als auch das Risiko falsch positiver Ergebnisse, noch bevor ein Scoring-Algorithmus das Paar bewertet.
Die Kandidatengenerierung ist der versteckte Engpass. Wenn eine Blocking-Strategie zwei zusammengehörige Datensätze in unterschiedliche Buckets legt, kann kein nachgelagerter Fuzzy-Matching-Algorithmus diese Beziehung wiederherstellen.
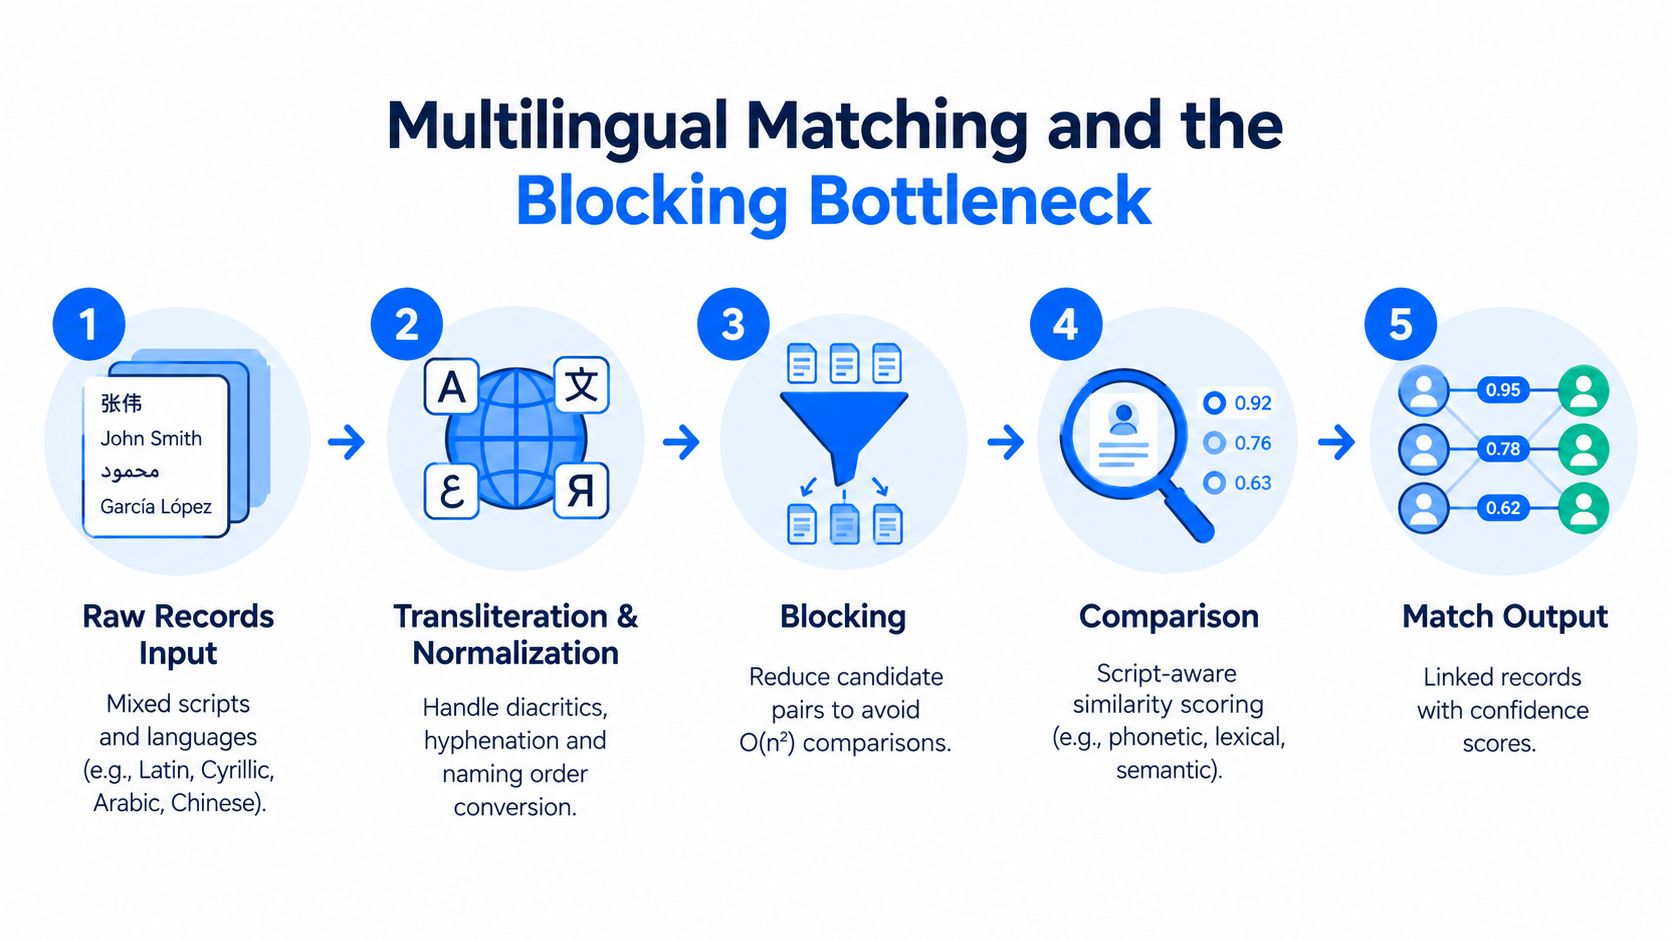
Normalisieren, ohne Evidenz zu zerstören
Bewahren Sie die Originalwerte und legen Sie normalisierte Darstellungen daneben an. Transliteration kann schriftübergreifende Vergleiche unterstützen, während die Originalschrift für Prüfung und Audit unverzichtbar bleibt. Normalisieren Sie diakritische Zeichen, Satzzeichen, Bindestriche und Namensreihenfolge mit Regeln, die zur Sprache und zum Entitätstyp passen.
Land oder Rechtsraum können nützlichen Kontext liefern, sollten aber nicht zur absoluten Identitätsregel werden. Ein grenzüberschreitendes Match kann berechtigt sein, während ein scheinbar lokales Match trotzdem falsch sein kann. Schriftübergreifende Paare mit geringer Konfidenz verdienen eine ausdrückliche Prüfung statt stillschweigender Ablehnung oder automatischer Freigabe.
Aktuelle Arbeiten zur Datensatzverknüpfung berichten, dass hierarchisches Blocking die größte Verbesserung beim mehrsprachigen Party-Matching bringt und dass Länder-Blocking länderübergreifende falsch positive Ergebnisse verringern kann, wie die beschriebene Studie zeigt.
Blocking tauscht Geschwindigkeit gegen Recall
Naive paarweise Vergleiche wachsen quadratisch mit der Anzahl der Datensätze. Blocking und Indizierung verkleinern die Kandidatenmenge, bringen aber einen neuen Fehlermodus mit sich: Ein zusammengehöriges Paar kann schon vor dem Scoring ausgeschlossen werden.
Setzen Sie auf mehrstufige Kandidatengenerierung statt auf einen einzigen fragilen Schlüssel:
Primärer Block: Verlässliche Kontextsignale wie Rechtsraum, Entitätstyp oder normalisierte Kennungsfragmente nutzen.
Ausweich-Block: Breitere Kombinationen für fehlende oder unsichere Werte zulassen.
Schriftübergreifender Pfad: Transliterierte Darstellungen vergleichen, wenn sich die Schriften unterscheiden.
Prüfpfad: Kandidaten mit geringer Konfidenz behalten, die wichtige Grenzen überschreiten.
Messen Sie den Blocking-Recall getrennt von der Scoring-Qualität. Ein Scoring-Modell kann bei den Kandidaten, die es erhält, hervorragend aussehen, während die Blocking-Ebene gültige Matches bereits verworfen hat. Tests nach Sprache, Schrift, Land und Quelle decken diese stillen Verluste auf.
Bei der Vorverarbeitung können selbst scheinbar unbedeutende Tokens den Vergleich verzerren. Teams sollten daher feldspezifische Bereinigungsregeln definieren, statt blind eine universelle Stoppwortliste anzuwenden. Eine praktische Referenz dafür ist diese Stoppwort-Ressource, einmalig genutzt als Teil des Normalisierungsdesigns und nicht als Ersatz für sprachbewusste Regeln.
Umsetzungsstrategien für Produktivumgebungen
Produktives Matching gelingt durch Kontrolle, nicht allein durch die Wahl des Algorithmus. Beginnen Sie mit einem eng umrissenen Workflow, erstellen Sie gelabelte Beispiele und legen Sie fest, was das System automatisch verknüpfen darf, was eine Prüfung erfordert und was getrennt bleiben muss.
Die Entscheidungspipeline aufbauen
Zuerst die Quellen profilieren. Fehlende Felder, häufige Varianten, Duplikatmuster und quellenspezifisches Rauschen identifizieren.
In parallele Felder normalisieren. Rohwerte für das Audit behalten und normalisierte Werte für den Vergleich anlegen.
Konservativ blocken. Messen, wie viele bekannte zusammengehörige Paare die Kandidatengenerierung überstehen.
Pro Feld bewerten. Metriken nach dem Verhalten des Feldes wählen, statt eine universelle Funktion anzuwenden.
Mit Enthaltung klassifizieren. Automatische Verknüpfungen, Prüfkandidaten und Nicht-Matches trennen.
Entscheidungen festhalten. Evidenz, Regelversionen, Schwellenwerte und Prüfergebnisse speichern.
Ein Kandidaten-Match ist keine freigegebene Identitätsverknüpfung. Diese Unterscheidung sollte im Datenmodell, in der Benutzeroberfläche und in nachgelagerten APIs existieren. Sie verhindert, dass vorläufige Empfehlungen als maßgebliche Stammdaten verwendet werden.
Die Fehler überwachen, auf die es ankommt
Berichten Sie Präzision und Recall an den operativen Schwellenwerten und schlüsseln Sie die Ergebnisse dann nach Region, Quelle, Entitätstyp und Sprache auf. Messen Sie falsche Matches und falsche Nicht-Matches getrennt. Prüfende sollten die Felder und Regeln sehen, die jede Empfehlung beeinflusst haben, nicht nur einen einzelnen undurchsichtigen Score.
Die Ausführung in der Datenbank kann Datenbewegungen verringern und das Matching mit Sicherheits- und Governance-Anforderungen in Einklang bringen. Eine Bereitstellung in der Private Cloud oder On-Premises kann den Prozess zudem in der Umgebung des Kunden halten, wenn Compliance-Vorgaben eine externe Verarbeitung ausschließen.
Ein modularer Ansatz ist leichter zu betreiben als eine ausufernde Regel-Engine. Fügen Sie eine Monitoring-Fähigkeit hinzu, prüfen Sie ihren Nutzen und erweitern Sie, wenn die Anforderungen reifen. Das Governance-Muster sollte versioniert, prüfbar und umkehrbar sein, wenn eine neue Quelle das Verhalten des Matchers verändert.
Teams, die Kundenstammdatenmanagement evaluieren, sollten besonders auf Survivorship und Audit-Design achten. Das Matching bestimmt, welche Datensätze verknüpft werden, doch Stammdatenprozesse brauchen auch eine klare Darstellung, welche Werte maßgeblich werden und wie sich spätere Korrekturen fortpflanzen.
Fuzzy Matching in die Data Observability integrieren
Ein Matcher kann jeden geplanten Job abschließen und trotzdem schlechter werden. Neue Quellformate, eine veränderte Zusammensetzung der Population, geänderte Namenskonventionen und Schemaänderungen können Score-Verteilungen verschieben, ohne dass die Pipeline sichtbar ausfällt.
Deshalb sollte das Monitoring das Verhalten abdecken, nicht nur die Verfügbarkeit. Verfolgen Sie Match-Raten, Score-Verteilungen, Prüfvolumen, Schwellenwertüberschreitungen, Blocking-Ausschlüsse und bestätigte Muster falsch positiver Ergebnisse. Eine plötzliche Änderung bei einem dieser Signale kann auf Drift in vorgelagerten Systemen hinweisen oder auf eine Annahme, die nicht mehr gilt.
Identitätsentscheidungen mit dem Datenverhalten verbinden
Schemaänderungen verdienen besondere Aufmerksamkeit. Hinzugefügte Spalten, geänderte Datentypen oder neue Entitätskategorien können die Verfügbarkeit und Gewichtung von Feldern verändern. Erkennt die Matching-Logik diese Änderungen nicht, läuft sie womöglich weiter und erzeugt dabei weniger verlässliche Verknüpfungen.
Eine umfassendere Data-Observability-Praxis kann Matching-Ergebnisse mit Aktualität, Validierung, Anomalieerkennung und Schema-Monitoring verbinden. So erhalten Data Engineers eine gemeinsame Sicht darauf, ob ein Matching-Problem im Algorithmus, in den Quelldaten, in der Pipeline oder in der Entscheidungsrichtlinie begann.
Für regulierte Teams umfasst eine sinnvolle Grundausstattung:
Entscheidungsevidenz: Welche Werte und Felder haben jede Verknüpfung gestützt?
Richtlinienhistorie: Welcher Schwellenwert und welche Algorithmusversion waren aktiv?
Populationsausschnitte: Hat sich die Leistung nach Region, Sprache oder Quelle verändert?
Menschliches Feedback: Welche Kandidaten haben Prüfende angenommen oder abgelehnt?
Operative Drift: Haben sich Datenlieferungen, Schemas oder Verteilungen verändert?
Die stärkste Umsetzung behandelt Fuzzy Matching als ein gesteuertes Datenprodukt. Sie hört nicht beim Verknüpfen von Datensätzen auf. Sie beobachtet, wie sich diese Verknüpfungen im Lauf der Zeit verhalten, und gibt Teams genug Evidenz, um das Ergebnis zu untersuchen, zu korrigieren und zu erklären.
digna hilft Datenteams, die Qualitätssignale rund um Fuzzy Matching zu überwachen, darunter Datensatzvalidierung, Anomalien, Aktualität und Schemaänderungen, während die Ausführung in der Umgebung des Kunden bleibt. Besuchen Sie digna und sehen Sie, wie Sie die Governance von Match-Entscheidungen mit umfassender Data Observability verbinden können.
Da eine umbenannte Spalte oder ein geänderter Datentyp unbemerkt verändern kann, welche Felder beim Matcher ankommen, lohnt es sich, Quellstrukturen genauso genau zu beobachten wie Match-Raten. Sehen Sie, wie die Erkennung von Schemaänderungen solche Änderungen meldet, bevor sie Identitätsentscheidungen verfälschen.
Häufig gestellte Fragen
Welcher Fuzzy-Matching-Algorithmus ist der beste?
Keiner ist universell der beste. In einem veröffentlichten Vergleich von sieben Ansätzen lieferte N-Gramm-Matching die beste Präzision, das beste F-Maß und die höchste Genauigkeit, während die Kosinus-Ähnlichkeit am schnellsten war. Produktive Systeme wählen meist eine Metrik pro Feld, etwa Jaro-Winkler für Namen und Jaccard für Adressen, und kombinieren dann die Evidenz.
Was ist der Unterschied zwischen Levenshtein- und Jaro-Winkler-Distanz?
Levenshtein zählt die minimale Anzahl einzelner Einfügungen, Löschungen oder Ersetzungen von Zeichen, die eine Zeichenkette in eine andere überführen, und passt daher zu Tippfehlern und kurzen Kennungen. Jaro-Winkler belohnt übereinstimmende Präfixe und eignet sich deshalb besonders für Personennamen und andere kurze Felder, bei denen die ersten Zeichen das meiste Signal tragen.
Ist ein Ähnlichkeitswert beim Fuzzy Matching eine Match-Wahrscheinlichkeit?
Nein. Ein Score wie 0,87 misst nur die Ähnlichkeit unter einer bestimmten Metrik. Er sagt nichts darüber, welche Felder das Ergebnis bestimmt haben oder was eine falsche Zusammenführung kostet. In der zitierten Studie fiel die Jaccard-Präzision bei Scores zwischen 0,90 und 0,95 auf 53 %, hohe Werte können also trotzdem unsicher sein.
Was bedeutet Blocking bei der Datensatzverknüpfung?
Blocking beschränkt Vergleiche auf Kandidatenpaare mit einem gemeinsamen Schlüssel, etwa Rechtsraum oder ein normalisiertes Kennungsfragment, weil naive paarweise Vergleiche quadratisch wachsen. Der Preis ist Recall: Landen zwei zusammengehörige Datensätze in verschiedenen Blöcken, kann kein nachgelagerter Algorithmus die Verknüpfung wiederherstellen. Den Blocking-Recall sollte man daher separat messen.
Wie lege ich einen Schwellenwert für Fuzzy Matching fest?
Stimmen Sie ihn mit gelabelten Paaren aus genau der Population ab, die der Matcher verarbeiten wird, und prüfen Sie Präzision und Recall nach Sprache, Region, Quelle und Entitätstyp. Statt eines einzigen Cutoffs empfiehlt sich ein Enthaltungsband, das mehrdeutige Paare zur Prüfung weiterleitet und Evidenz, Schwellenwert und Regelversion für das Audit speichert.



