Datenintegritäts-Monitoring: Ein praxisnaher Leitfaden für 2026
|
7
min. Lesezeit

Ihre Dashboards fallen selten mit einem spektakulären Absturz aus. Viel häufiger öffnet jemand aus der Finanzabteilung am Montag eine Umsatzansicht, sieht die Zahlen von gestern und geht davon aus, dass alles in Ordnung ist. Unter der Oberfläche wird eine Quelltabelle nicht mehr aktualisiert, ein Wochenendjob hat einen Ladevorgang verpasst, und ein KI-Modell, das bereits auf den Daten der Vorwoche trainiert wurde, trifft nun selbstsichere Entscheidungen auf Basis veralteter Eingaben.
Genau deshalb ist Datenintegritäts-Monitoring heute so wichtig. Es ist keine nachgelagerte Aufräumarbeit und auch nicht dasselbe wie gelegentliches Testen. Es ist eine kontinuierliche Kontrollebene, die Brüche bei Aktualität, Volumen, Verteilung, Schema und Lineage überwacht, damit Teams stille Fehler erkennen, bevor es die Stakeholder tun. Eine akademische Übersichtsarbeit beschreibt diese fünf Säulen als Kernrahmen, um zu beurteilen, ob Daten rechtzeitig eintreffen, ihre erwarteten statistischen Eigenschaften behalten, vollständig bleiben, ihre Struktur bewahren und eine nachvollziehbare Herkunft aufweisen – genau die Art von Transparenz, die moderne Pipelines benötigen akademische Übersichtsarbeit.
Ein hilfreiches Denkmodell ist, Integritäts-Monitoring als Sicherheitsnetz zwischen den Tests zu betrachten. Tests zeigen Ihnen, ob eine bekannte Regel noch erfüllt ist. Monitoring zeigt Ihnen, ob das System in einen Zustand abgedriftet ist, der später Reporting, Modelle oder nachgelagerte Automatisierung beeinträchtigen wird. Wenn Sie sich bereits mit Anomalieerkennung beschäftigen, ist der Leitfaden von ELECTE, um verborgene Muster in Daten zu finden, eine praktische Ergänzung, denn dieselben Instinkte greifen, wenn das relevante Muster ein stiller Verfall der Pipeline ist.
Wenn Sie dies auf Ihren eigenen Stack übertragen, spielt auch die Dashboard-Ebene eine Rolle. Eine gemeinsame Sicht auf Vorfälle, Trends und Status wird deutlich wertvoller, wenn sie auf kontinuierlichen Prüfungen statt nur auf Stichproben-Audits beruht. Eine Referenzimplementierung für diese Art von Transparenz sind die Datenqualitäts-Dashboards von digna, die denselben operativen Gedanken aus einem anderen Blickwinkel widerspiegeln.
Inhaltsverzeichnis
Warum Integritäts-Monitoring heute eine strategische Ebene ist
Häufige Fallstricke, die das Vertrauen in das Monitoring untergraben
Der Moment, in dem ein Dashboard unbemerkt ausfällt
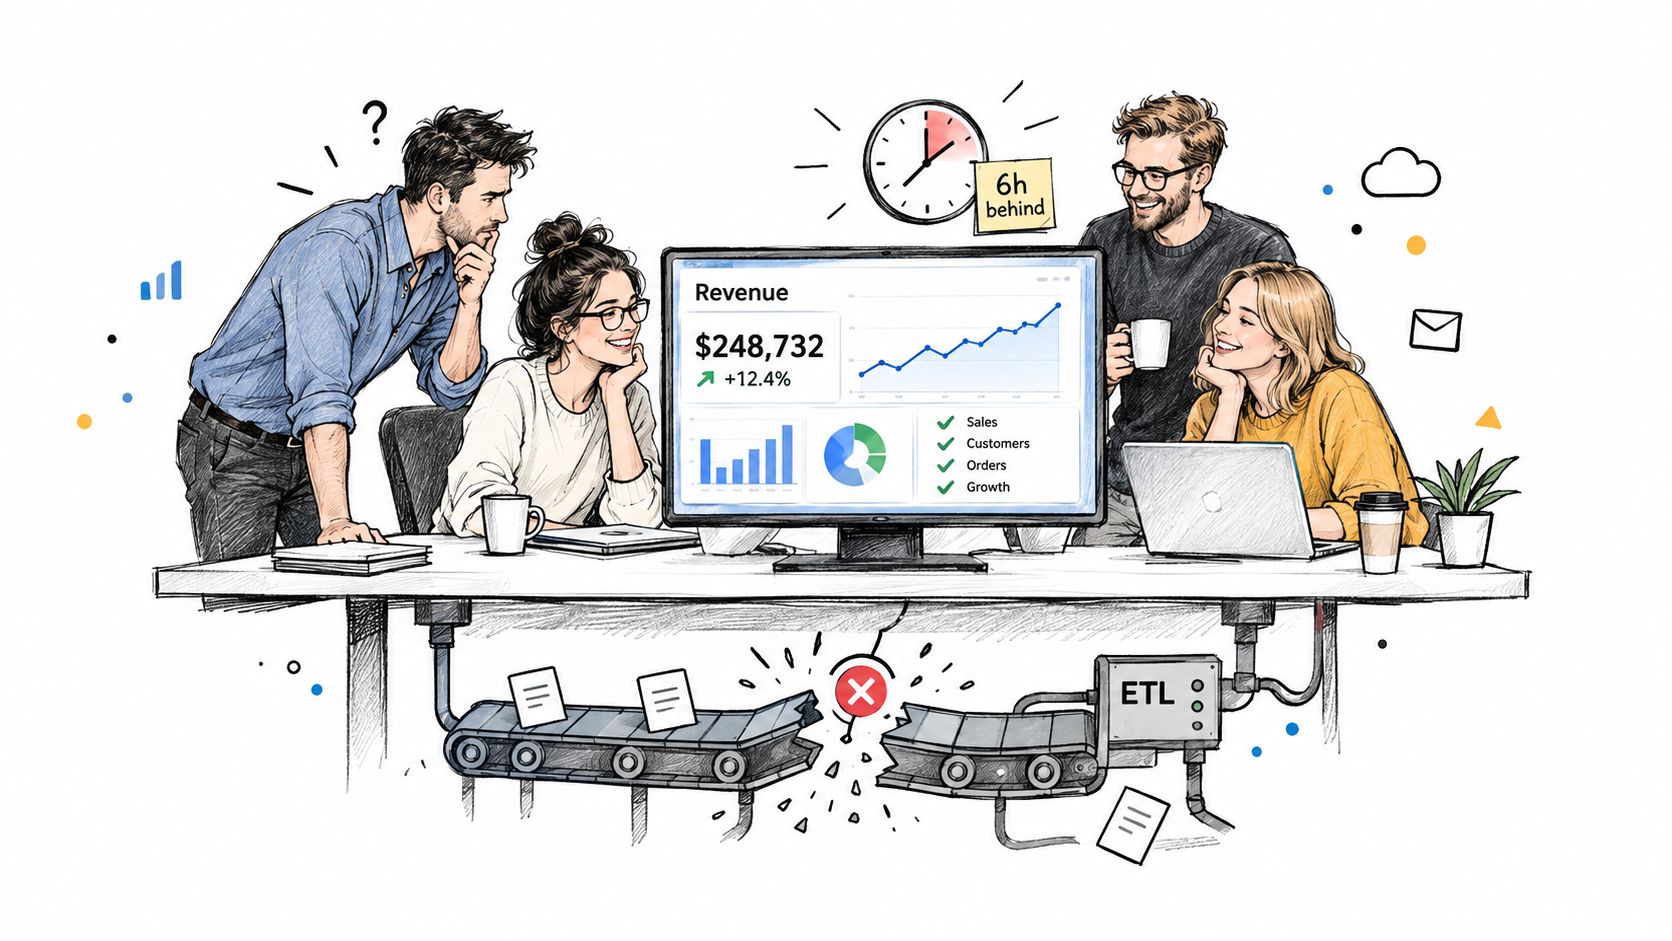
Der Montag beginnt mit einer Nachricht, die niemand gern liest. Der Warehouse-Ladevorgang, der über Nacht hätte abgeschlossen sein sollen, ist nicht sauber durchgelaufen, die Quelltabelle ist sechs Stunden alt, und das Executive-Dashboard zeigt weiterhin den Umsatz von gestern – ohne jeden Fehlerhinweis. Auch das Produktteam bemerkt es nicht, denn das Empfehlungsmodell, das es letzte Woche ausgeliefert hat, läuft weiterhin auf der alten Kohorte.
Genau für dieses Fehlerbild ist Datenintegritäts-Monitoring gemacht. Es geht darum, die Daten selbst kontinuierlich zu überwachen, damit veraltete Ladevorgänge, fehlende Datensätze, Schemaänderungen und unterbrochene Abhängigkeitsketten sichtbar werden, solange noch Zeit zum Handeln bleibt.
Ein lauter Fehler ist leicht zu erkennen. Die Pipeline bricht ab, ein Alarm wird ausgelöst und jemand wird benachrichtigt. Ein stiller Fehler ist schwieriger, denn die Zahlen wirken weiterhin plausibel, während sich die zugrunde liegenden Daten bereits so weit verschoben haben, dass sie eine Entscheidung verzerren.
Praxisregel: Wenn eine Prüfung erst anschlägt, nachdem sich ein Stakeholder beschwert hat, ist es zu spät, um von Monitoring zu sprechen.
Das ist auch der Grund, warum sich diese Ebene von einmaligem Testen unterscheidet. Tests finden in der Regel rund um Deployments oder Validierungspunkte statt. Datenintegritäts-Monitoring sitzt mitten im Lebenszyklus und beobachtet den aktuellen Zustand der Pipeline, während er sich verändert – wie ein Kontrollraum, der die Anzeigen fortlaufend prüft, während die Maschine bereits läuft.
Diese Unterscheidung ist für Teams wichtig, die sowohl Analytics als auch ML betreiben. Ein Modell kann weiterhin Vorhersagen liefern, wenn die Eingabetabelle veraltet ist, sich das Schema geändert hat oder ein Quell-Feed keine Zeilen mehr sendet. Nichts stürzt ab, aber die Geschäftslogik verschlechtert sich trotzdem. Deshalb muss die Monitoring-Ebene erfassen, ob der Job gelaufen ist und ob die Daten weiterhin vertrauenswürdig sind.
Die stärksten Setups korrelieren zudem mehrere Signale gleichzeitig. Aktualität allein übersieht womöglich Duplikate. Volumen allein übersieht womöglich eine Schemaänderung, die eine Spalte entfernt, ohne die Zeilenanzahl zu verändern. Schemaprüfungen allein übersehen womöglich eine verspätete Datei, die zwar vollständig, aber zu spät für das Reporting eintrifft. Eine Referenzimplementierung für diese Art von Transparenz sind die Datenqualitäts-Dashboards von digna, die zeigen, wie Vorfallsansichten neben kontinuierlichen Prüfungen stehen können. Für einen genaueren Blick darauf, wie Observability und Vorfallsansichten zusammenspielen, ist ein gemeinsames Vorfalls-Dashboard hilfreich, weil es die Art operativer Transparenz widerspiegelt, die Teams benötigen, sobald sie über manuelle Stichproben hinausgehen.
Die fünf Perspektiven des Datenintegritäts-Monitorings
Denken Sie an die Triage in einem Krankenhaus. Ein Arzt diagnostiziert einen Patienten nicht anhand eines einzigen Signals. Er prüft den Puls, stellt Fragen, wertet Blutwerte aus, betrachtet Bildgebung und vergleicht den aktuellen Zustand mit der Vorgeschichte und dem familiären Hintergrund. Datenpipelines verdienen dieselbe Sorgfalt.

Aktualität, Volumen, Verteilung, Schema und Lineage
Aktualität beantwortet die Frage, ob die Daten rechtzeitig eingetroffen sind. Wenn Ihr Vertriebs-Feed normalerweise vor 6 Uhr morgens eintrifft und um 8 Uhr noch nicht da ist, ist das kein theoretisches Problem, sondern veraltetes Reporting. Dasselbe gilt für verspätete Batch-Jobs, verpasste inkrementelle Ladevorgänge und verzögerte Partner-Feeds. Ein Leitfaden zur Data Observability fasst Aktualität zusammen mit Verfügbarkeit, Volumen und Schemaänderungen als zentrale Prüfungen für das Monitoring von Datensätzen DASCA-Leitfaden.
Volumen betrachtet Zeilenanzahlen, Dateigrößen und andere zählbasierte Signale. Ein plötzlicher Rückgang kann bedeuten, dass ein vorgelagerter Extraktor ausgefallen ist. Ein plötzlicher Anstieg kann auf Duplikate oder eine versehentliche Neuverarbeitung hindeuten. Die Zahl selbst erklärt die Ursache nicht, aber sie zeigt Ihnen, dass sich etwas verändert hat.
Verteilung umfasst Wertebereiche, Null-Raten, Kardinalität und Wertemuster. Hier zeigen sich plötzliche Null-Spitzen, gestörte Kategorienverhältnisse und untypische Werte. Es ist der Unterschied zwischen „die Tabelle wurde geladen“ und „die Daten sehen noch nach derselben Art von Daten aus“.
Schema erkennt hinzugefügte, entfernte, umbenannte und im Typ geänderte Spalten. Solche Änderungen sind oft der Grund, warum nachgelagertes SQL fehlschlägt oder dbt-Modelle unvollständige Ergebnisse liefern. Eine strukturelle Veränderung wird leicht übersehen, wenn Sie nur auf den Erfolg von Jobs achten.
Lineage verfolgt, woher die Daten stammen und was von ihnen abhängt. Das ist wichtig, wenn Sie wissen müssen, ob ein Fehler in einem Quellextrakt, einer Transformation oder bei einem nachgelagerten Verbraucher entstanden ist. Zugleich hilft es Teams zu verstehen, warum ein einziges fehlerhaftes Feld mehrere Dashboards gleichzeitig beeinträchtigen kann.
Einzelne Signale können auf ein Symptom hinweisen. Korrelierte Signale weisen auf die Ursache hin.
Das ist die zentrale Lehre. Ausgereiftes Monitoring schlägt nicht einfach bei einer einzelnen Anomalie an. Es korreliert mehrere Perspektiven, damit Teams zwischen einer veralteten Tabelle, einem saisonalen Geschäftsausschlag und einem echten Pipeline-Bruch unterscheiden können. Wenn Sie ein praktisches Beispiel dafür suchen, wie diese Signale in einer Monitoring-Ansicht zusammenwirken, orientiert sich die Seite zu digna Data Observability eng an diesem Modell der fünf Perspektiven.
Warum Integritäts-Monitoring heute eine strategische Ebene ist
Noch vor einigen Jahren betrachteten viele Teams Datenqualität als Aufräumarbeit. Fehlerhafte Zeilen korrigieren, das Dashboard flicken, weitermachen. Diese Denkweise trägt nicht mehr, sobald Analytics und KI Entscheidungen im großen Maßstab steuern.
Der Wandel in der Branche zeigt sich in den Adoptionsdaten. Eine Umfrage aus dem Jahr 2026 ergab, dass nur etwa 35 bis 36 Prozent der Organisationen ihre Datenintegritätsprogramme aktiv überwachen oder optimieren, während sich rund 15 bis 16 Prozent noch in der Vorplanungsphase befinden Umfrage. Die Praxis ist also im operativen Mainstream angekommen, aber noch längst nicht flächendeckend verbreitet.
Warum KI den Einsatz erhöht
KI-Systeme konsumieren Daten nicht nur, sie verstärken sie. Wenn die Eingabe veraltet, unvollständig oder strukturell verändert ist, kann das Modell dennoch ein sauber wirkendes Ergebnis ausgeben. Dieses Ergebnis kann falsch sein, wirkt aber oft überzeugend – und genau das macht das Problem so gefährlich.
Deshalb ist Integritäts-Monitoring längst nicht mehr nur eine Frage technischer Hygiene. Es fungiert als Steuerungsebene für die KI-Bereitschaft, denn Teams brauchen Nachweise dafür, dass die Daten, die in Analytics und Modelle einfließen, aktuell, vollständig und nachvollziehbar sind. Zudem unterstützt es Governance und Auditierbarkeit, weil Lineage und strukturelle Änderungen sichtbar werden, statt in Ad-hoc-Logs verborgen zu bleiben.
Wen es betrifft und warum
Treiber | Stakeholder | Was ohne Monitoring ausfällt |
|---|---|---|
KI-Bereitschaft | Daten- und ML-Teams | Modelle werden auf veralteten, unvollständigen oder strukturell veränderten Daten trainiert oder bewertet |
Governance | Risiko- und Compliance-Teams | Teams können nicht nachweisen, was sich geändert hat, wann es sich geändert hat oder was davon betroffen war |
Betriebliche Zuverlässigkeit | Plattform- und Analytics-Teams | Dashboards, Transformationen und nachgelagerte Verbraucher driften ab, bevor es jemand bemerkt |
Der strategische Punkt ist einfach. Fehlt Datenintegritäts-Monitoring, entstehen nicht nur fehlerhafte Dashboards. Es entsteht eine Kette von Fehlentscheidungen, die durch Automatisierung noch schneller getroffen werden. Für Teams, die operative Kontrollen bewerten, ist die Darstellung zum Datenqualitäts-Monitoring von digna hilfreich, weil sie Integrität als dauerhafte Kontrolle und nicht als einmalige Aufräumaktion behandelt.
Monitoring-Ansätze im Vergleich, die wirklich funktionieren
Nicht jeder Monitoring-Ansatz passt überall. Das richtige Design hängt davon ab, wo die Daten liegen, wie schnell sie sich ändern und wie viel Rauschen Ihr Team verkraften kann. Die besten Programme kombinieren in der Regel mehrere Methoden, statt alles auf eine zu setzen.
Wo jeder Ansatz glänzt und wo er an Grenzen stößt
In-Database-Ausführung hält Prüfungen nah an den Daten. Das reduziert Datenbewegungen, was in sicheren oder volumenstarken Umgebungen wichtig ist, und passt zu Teams, die ihre Validierungslogik dort ausführen möchten, wo Warehouse oder Lake bereits liegen. Der Kompromiss liegt jedoch auf der Hand: Sie übernehmen die Einschränkungen der Plattform, auf der Sie arbeiten, sodass die Portabilität geringer sein kann als bei externen Tools.
Externe Scanner sind systemübergreifend flexibler. Sie können Dateien, APIs, Warehouses und nachgelagerte Anwendungen von außerhalb der Datenbankgrenze untersuchen. Diese Flexibilität bringt Overhead mit sich, besonders wenn Umgebungen groß werden oder Sie die Latenz niedrig halten möchten.
Regelbasierte Schwellenwerte sind leicht nachvollziehbar. Sie erkennen offensichtliche Brüche, etwa eine Tabelle, die nie unter eine Mindestanzahl fallen sollte, oder einen Feed, der zu einer festen Uhrzeit eintreffen sollte. Schwierig wird es bei saisonalem Geschäft, denn ein statisches Limit kann normale Veränderungen als Problem markieren.
KI-gelernte Baselines passen sich besser an diese Art von Schwankungen an. Sie sind nützlich, wenn ein Datensatz wöchentliche Zyklen, allmähliche Drift oder eine unübersichtliche Historie aufweist. Sie benötigen allerdings eine Anlaufzeit, und das Team muss akzeptieren, dass die Zuverlässigkeit anfangs geringer ist als bei einer festen Regel.
Verwenden Sie statische Regeln für bekannte Invarianten, gelernte Baselines für sich änderndes Verhalten und Multi-Signal-Korrelation, wenn ein einzelnes Symptom nicht ausreicht.
Der letzte Punkt ist der wichtigste. Ein einzelner Aktualitätsalarm kann Rauschen sein. Aktualität plus Volumen plus Schema-Drift ergibt ein glaubwürdigeres Bild. Ein Team, das Prüfungen nah am Warehouse halten und dennoch eine breite Abdeckung erreichen möchte, kann sich den Data Integrity Checker von digna als Beispiel dafür ansehen, wie sich diese Bausteine kombinieren lassen, ohne jedes Signal gleich zu behandeln.
Ansatz | Stärke | Einschränkung | Am besten geeignet für |
|---|---|---|---|
In-Database-Ausführung | Geringe Datenbewegung, ideal für regulierte Umgebungen | Weniger plattformübergreifend portabel | Prüfungen in volumenstarken Warehouses |
Externe Scanner | Breite Abdeckung über Systeme hinweg | Mehr Overhead bei großem Umfang | Systemübergreifende Landschaften mit mehreren Tools |
Regelbasierte Schwellenwerte | Klar und leicht zu erklären | Anfällig bei saisonalen Schwankungen | Feste Geschäftsregeln und harte Grenzwerte |
KI-gelernte Baselines | Passt sich normalen Schwankungen an | Benötigt Anlaufzeit und Feinabstimmung | Volatile oder sich ändernde Datensätze |
Multi-Signal-Korrelation | Reduziert Fehlalarme und verbessert die Diagnose | Mehr Designaufwand im Vorfeld | Ausgereifte Monitoring-Programme |
Implementierungsmuster und Best Practices
Die meisten Monitoring-Programme scheitern, weil sie zu viel zu früh wollen. Ein besserer Rollout beginnt damit, die normale Form der Pipeline kennenzulernen, und fügt Alarme erst dann hinzu, wenn das Team versteht, wie „normal“ tatsächlich aussieht.
Der Maßstab, den Sie im Blick behalten sollten, ist der Umfang. Ein zitierter Monitoring-Datensatz ergab durchschnittlich 42 verschiedene Metriken pro Pipeline, darunter Aktualität, Volumenschwankungen, Schema-Drift und Verarbeitungslatenz QuerySurge. Das heißt nicht, dass jedes Team auf alle 42 gleichzeitig alarmieren sollte. Es bedeutet, dass ausgereifte Programme mehrere Signale beobachten und gemeinsam auswerten.

Ein Rollout, der das Team nicht überfordert
Lernen Sie zuerst die Baseline. Führen Sie Prüfungen im Beobachtungsmodus aus, bevor Sie jemanden alarmieren. Teams brauchen ein Gespür für den gewöhnlichen Tagesrhythmus, bevor sie beurteilen können, ob eine Veränderung echt ist.
Priorisieren Sie nach geschäftlicher Auswirkung. Beginnen Sie mit Aktualität, Volumen, Schema und den Verteilungsprüfungen, die die sichtbarsten Datensätze schützen. Verteilen Sie das Team nicht über jede Tabelle, nur weil das Tooling es einfach macht.
Nutzen Sie dynamische Schwellenwerte. Legen Sie Grenzwerte pro Asset fest, nicht einen globalen Schwellenwert. Ein Vertriebs-Feed, ein klinischer Feed und ein Telekommunikations-Nutzungsfeed folgen nicht demselben normalen Muster.
Verfeinern Sie anhand von Feedback. Jeder gelöste Vorfall sollte den nächsten Alarm verbessern. War eine Benachrichtigung zu laut, justieren Sie sie nach. Hat sie einen echten Bruch frühzeitig erkannt, behalten Sie das Muster bei und erweitern Sie es gegebenenfalls.
Verantwortlichkeit ist ebenso wichtig wie die Alarmlogik. Jedes überwachte Asset sollte einen namentlich benannten Verantwortlichen haben, denn Alarme ohne Zuständigen werden zu verwaisten Tickets. Auch eine vierteljährliche Überprüfung der Abdeckung hilft, da sich Pipelines schneller ändern als statische Monitoring-Übersichten.
Die operative Umsetzung dieses Denkens zeigt sich deutlich in der Datenqualitäts-Implementierung von digna, bei der die Disziplin beim Rollout ebenso wichtig ist wie die Prüfungen selbst.
Häufige Fallstricke, die das Vertrauen in das Monitoring untergraben
Monitoring verliert schnell an Glaubwürdigkeit, wenn es sich wie eine ständig lärmende Alarmanlage verhält. Teams verlieren das Vertrauen nicht, weil die Idee falsch ist, sondern weil die Umsetzung lästig, fragil oder blind für die tatsächlichen Fehlerbilder ist.
Die Fehler, die in realen Programmen auftreten
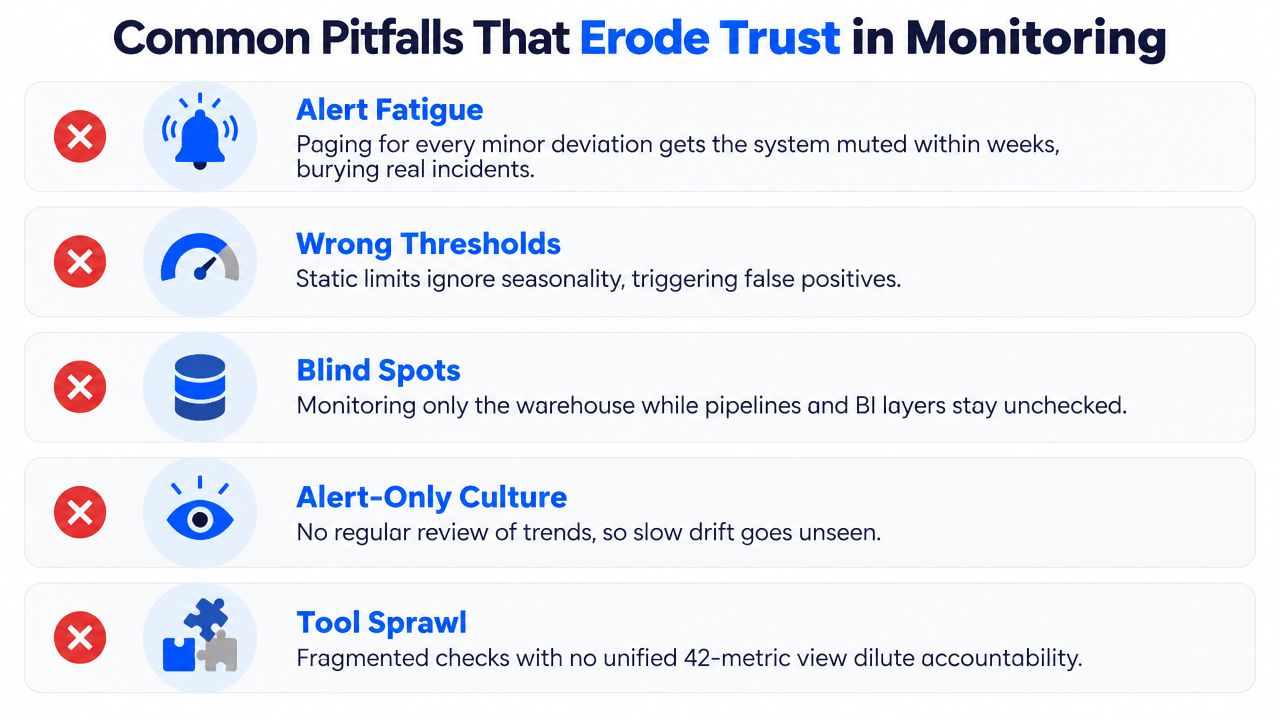
Alarmmüdigkeit ist der schnellste Weg, die Aufmerksamkeit zu verlieren. Wenn das System bei jeder kleinen Abweichung alarmiert, schalten die Leute es stumm – und dann rutscht der tatsächliche Ausfall durch.
Falsche Schwellenwerte erzeugen eine andere Art von Misstrauen. Statische Grenzwerte ignorieren Saisonalität, Aktionen, Monatsendspitzen und andere geschäftliche Rhythmen, sodass völlig normale Veränderungen wie Vorfälle aussehen.
Blinde Flecken entstehen, wenn Teams nur das Warehouse beobachten und die Pipeline-Stufen sowie die BI-Ebene ignorieren, die es nutzen. Das Ergebnis ist eine trügerische Abdeckung.
Eine reine Alarmkultur ist ein weiterer stiller Fehler. Wenn niemand Trends überprüft, übersieht das System schleichende Drift, die den harten Schwellenwert erst überschreitet, wenn sie für Nutzer bereits sichtbar ist.
Tool-Wildwuchs macht Verantwortlichkeiten unscharf. Fragmentierte Prüfungen, verteilt auf mehrere Systeme, ergeben selten ein einheitliches operatives Bild – deshalb ist eine einheitliche Sicht so wichtig.
Vertrauen entsteht durch weniger, aber bessere Alarme, nicht durch mehr Rauschen.
Die Gegenmaßnahmen sind einfach, aber nicht optional. Nutzen Sie Schweregradstufen, koppeln Sie Schwellenwerte an das Baseline-Verhalten, richten Sie Abonnements für Schemaänderungen ein und halten Sie einen festen Überprüfungsrhythmus im Kalender. Vor allem sollten Sie Monitoring als lebendige Kontrolle behandeln und nicht als Projekt, das nach dem Launch für abgeschlossen erklärt wird.
Branchenspezifische Risiken bei regulierten Daten
Dieselbe Monitoring-Logik wirkt je nach Branche unterschiedlich. Ein Finanzteam, eine Analytics-Gruppe im Krankenhaus, ein Telekommunikationsanbieter und eine Behörde legen alle Wert auf Integrität, fürchten aber nicht dieselben Bruchstellen.
Vier Beispiele, vier unterschiedliche Fehlermuster
Bei Finanzdienstleistern ist der gefährlichste Fehler oft ein veralteter oder verschobener Risiko-Feed. Ein Modell kann weiterhin Transaktionen bewerten, während das zugrunde liegende Betrugssignal veraltet ist – und das kann sowohl Entscheidungen als auch Audit-Trails verzerren.
Im Gesundheitswesen liegt die Gefahr in strukturellen Änderungen. Eine umbenannte Diagnosespalte kann schwerwiegende Fälle unbemerkt in die falsche Kategorie verschieben. Das Problem zeigt sich dann im klinischen Reporting, lange bevor jemand das Schemaproblem bemerkt.
In der Telekommunikation liegen die Schwierigkeiten meist in Umfang und Volatilität. Ein Churn-Dashboard kann einen regionalen Ausfall übersehen, wenn Umsatz- oder Nutzungstabellen normal weiterladen, während ein anderer Feed hinterherhinkt.
Im öffentlichen Sektor zeigen sich Abhängigkeitsbrüche häufig in Workflows zur Anspruchsberechtigung oder zu Leistungen. Eine Schemaänderung eines Anbieters kann dazu führen, dass ein Join Datensätze nicht mehr korrekt zuordnet. Das verursacht nachgelagerte Probleme in der Leistungserbringung, die sich im Nachhinein nur schwer entwirren lassen.
Branche | Primäres Integritätsrisiko | Wertvollstes Signal | Regulatorische Bedeutung |
|---|---|---|---|
Finanzdienstleistungen | Veraltete oder verschobene Risikoeingaben | Aktualität und Lineage | Auditierbarkeit und Reporting-Kontrollen |
Gesundheitswesen | Stille strukturelle Änderung | Schema und Verteilung | Klinische Zuverlässigkeit und Nachvollziehbarkeit |
Telekommunikation | Drift in volumenstarken Pipelines | Volumen und Aktualität | Betriebliche Kontinuität und Servicegenauigkeit |
Öffentlicher Sektor | Fehlerhafte Joins nach Anbieteränderungen | Schema und Lineage | Leistungsberechtigung, Rechenschaftspflicht und Integrität von Akten |
Der Fehler liegt in der Annahme, dass eine Konfiguration für alle passt. Der Rahmen ist derselbe, aber die Gewichtung ändert sich. Eine regulierte Umgebung braucht Signale, die auf den Fehler abgestimmt sind, den sie sich am wenigsten leisten kann zu übersehen – nicht eine generische Checkliste, die aus dem Stack eines anderen Teams kopiert wurde.
Alles zusammengeführt mit digna
Der eingangs beschriebene Dashboard-Ausfall, das Modell der fünf Perspektiven, der Richtwert von 42 Metriken und die branchenspezifischen Beispiele führen alle zum selben Schluss. Datenintegritäts-Monitoring funktioniert, wenn es zu einer kontinuierlichen Kontrollebene wird und nicht eine gelegentliche Inspektionsaufgabe bleibt.

Ein praktischer Bezugspunkt
digna ist eine Möglichkeit, dieses Modell in der eigenen Umgebung eines Kunden umzusetzen – mit Prüfungen, die in der Datenbank laufen und Aktualität, Volumen, Verteilung, Schema und Lineage in einem modularen Setup abdecken. Es entspricht außerdem dem oben beschriebenen Rollout-Muster, bei dem zuerst Baselines entstehen und Alarme erst dann verschärft werden, wenn das System das normale Verhalten versteht.
Einige Punkte sind dabei besonders wichtig:
Fünf Perspektiven angewendet. Dieselbe Suite kann Pünktlichkeit, strukturelle Änderungen, Abhängigkeitskontext und Baseline-Abweichungen gemeinsam überwachen.
Denken in 42 Metriken. Ausgereiftes Monitoring bedeutet nicht eine Prüfung pro Tabelle, sondern eine Reihe von Signalen, die auf den Datensatz und das Risiko zugeschnitten sind.
Schrittweiser Rollout. Beobachtung kommt vor Alarmierung – so bleibt das Programm nützlich statt laut.
Vertrauen bewahren. Fein abgestimmte Schwellenwerte sorgen dafür, dass das Team nur geweckt wird, wenn tatsächlich Handlungsbedarf besteht.
Der praktische nächste Schritt ist einfach. Wählen Sie eine kritische Pipeline aus, konfigurieren Sie die fünf Perspektiven, lernen Sie die Baseline kennen und lassen Sie Anomalien sichtbar werden, bevor Nutzer sie bemerken. Wenn Sie eine konkrete Referenz für ein solches Setup suchen, besuchen Sie digna und prüfen Sie, wie dessen Monitoring-Ansatz zu der einen Pipeline passt, bei der Sie sich keinen Fehler leisten können.
Für die oben beschriebenen KI-gelernten Baselines, die sich an wöchentliche Zyklen und allmähliche Drift anpassen, statt auf statische Schwellenwerte zu setzen, sehen Sie sich an, wie digna Data Anomalies das normale Verhalten je Datensatz lernt.
Häufig gestellte Fragen
Was ist Datenintegritäts-Monitoring?
Datenintegritäts-Monitoring ist eine kontinuierliche Kontrollebene, die Live-Daten auf Brüche bei Aktualität, Volumen, Verteilung, Schema und Lineage überwacht. Anders als einmalige Tests beim Deployment sitzt es mitten im Lebenszyklus der Pipeline, sodass veraltete Ladevorgänge, fehlende Datensätze und Schemaänderungen sichtbar werden, bevor Stakeholder sie bemerken.
Was sind die fünf Säulen des Datenintegritäts-Monitorings?
Die fünf Perspektiven sind Aktualität, Volumen, Verteilung, Schema und Lineage. Aktualität prüft, ob Daten rechtzeitig eingetroffen sind, Volumen verfolgt Zeilenanzahlen und Dateigrößen, Verteilung umfasst Null-Raten und Wertemuster, Schema erkennt hinzugefügte oder umbenannte Spalten, und Lineage zeigt, wo ein Fehler entstanden ist und was davon abhängt.
Wie unterscheidet sich Datenintegritäts-Monitoring vom Testen von Daten?
Tests prüfen, ob eine bekannte Regel noch erfüllt ist, meist rund um Deployments oder Validierungspunkte. Monitoring beobachtet den aktuellen Zustand der Pipeline und erkennt Drift, die später Berichte oder Modelle beeinträchtigen wird. Die Faustregel des Artikels: Wenn eine Prüfung erst anschlägt, nachdem sich ein Stakeholder beschwert hat, ist das kein Monitoring.
Wie viele Metriken sollten Sie pro Datenpipeline überwachen?
Ein zitierter Monitoring-Datensatz ergab durchschnittlich 42 verschiedene Metriken pro Pipeline, die Aktualität, Volumenschwankungen, Schema-Drift und Verarbeitungslatenz abdecken. Das bedeutet nicht, auf alle 42 gleichzeitig zu alarmieren; ausgereifte Programme beobachten viele Signale und korrelieren sie, beginnend mit den Datensätzen mit der größten geschäftlichen Auswirkung.
Wie führen Sie Datenintegritäts-Monitoring ohne Alarmmüdigkeit ein?
Beginnen Sie im Beobachtungsmodus, um die Baseline zu lernen, bevor Sie jemanden alarmieren, und priorisieren Sie dann die sichtbarsten Datensätze. Legen Sie dynamische Schwellenwerte pro Asset statt eines globalen Grenzwerts fest, justieren Sie jeden zu lauten Alarm nach einem Vorfall nach, benennen Sie für jedes überwachte Asset einen Verantwortlichen und überprüfen Sie die Abdeckung vierteljährlich.


