Was ist Datenqualitätsmanagement und warum es wichtig ist
|
8
min. Lesezeit

Sie kennen dieses Gefühl bereits. Das Dashboard sieht ruhig aus, die Führungsebene nutzt es in Meetings und niemand hat sich beschwert. Dann schleicht sich eine vorgelagerte Schemaänderung durch eine Zahlungspipeline, die Umsatzzahl weicht ab, und der Fehler bleibt lange genug bestehen, um Entscheidungen zu beeinflussen, bevor es überhaupt jemand bemerkt. Das ist der Punkt, an dem Datenqualitätsmanagement aufhört, eine theoretische Übung zu sein, und zu einem Kontrollsystem wird.
Datenqualitätsmanagement ist die kontinuierliche Praxis, sicherzustellen, dass Daten für die Personen und Systeme, die sie nutzen, geeignet sind. In der Produktion bedeutet das das Messen, Überwachen und Beheben von Daten, während sie sich durch Pipelines, Modelle, Berichte und operative Workflows bewegen. Das alte Modell, Daten nur ab und zu zu bereinigen, hat in echten Unternehmen nie standgehalten, insbesondere als Daten begannen, Analysen, Automatisierung und regulierte Berichterstattung zu speisen.
Inhaltsverzeichnis
Wenn vertrauenswürdige Daten zur Belastung werden
Ein CFO vertraut dem Umsatz-Dashboard. Die Finanzabteilung nutzt es seit Monaten, die Zahlen stimmen an den meisten Tagen überein, und der Bericht landet ohne Kontroversen im wöchentlichen Betriebsbericht. Dann landet eine kleine vorgelagerte Schemaänderung in der Zahlungspipeline, der Transformationsjob läuft immer noch, es wird kein Alarm ausgelöst, und das Dashboard bleibt drei Wochen lang fehlerhaft, bis eine Kundenbeschwerde jemanden dazu zwingt, genauer hinzusehen.
Diese Art von Fehler ist genau der Grund, warum Datenqualitätsmanagement als Disziplin existiert und nicht als bloße Aufräumaufgabe. Die historische Entwicklung spielt hier eine Rolle. Das MIT startete 1988 das Programm Total Data Quality Management, das dazu beitrug, einen lebenszyklusbasierten Ansatz zur Messung, Verbesserung und kontinuierlichen Überwachung der Datenqualität zu etablieren. Eine von der Harvard Business Review zusammengefasste Grundlagenforschung berichtete außerdem, dass nur 3 % der Daten von Unternehmen grundlegende Qualitätsstandards erfüllten, basierend auf 195 Messungen in den Bereichen Vollständigkeit, Genauigkeit, Konsistenz und Timeliness, und dass 47 % der neu erstellten Datensätze mindestens einen kritischen Fehler enthielten (Integrate.io).
Diese Zahlen erklären den Wandel von der Bereinigung hin zur Governance. Das Problem ist nicht, dass Teams nicht wissen, dass schlechte Daten existieren, sondern dass sich schlechte Daten oft verstecken, bis sie bereits weiter nachgelagert sind. Modernes Datenqualitätsmanagement muss mit Pipeline-Geschwindigkeit arbeiten, da ein veralteter Datensatz, ein fehlerhafter Join oder eine Schemaabweichung dazu führen können, dass ein vertrauenswürdiges Dashboard falsche Informationen anzeigt, ohne dass jemals eine traditionelle Batch-Prüfung ausgelöst wird.
Warum das alte Modell bricht
Periodische Audits funktionieren nur, wenn das Unternehmen Verzögerungen tolerieren kann. Das ist heute selten der Fall. Ein fehlerhafter Feed kann Modelle, Berichterstattungsebenen und Kontrollen vergiften, lange bevor eine monatliche Überprüfung dies bemerkt.
Praktische Regel: Wenn ein Datensatz Geld, Risiken oder die Patientenversorgung beeinflussen kann, gehören Qualitätsprüfungen in die Pipeline und nicht im Nachhinein in eine Tabellenkalkulation.
Die praktische Grenze zwischen „sauberen Daten“ und gemanagter Datenqualität ist einfach. Die Bereinigung erfolgt reaktiv, nachdem das Problem sichtbar geworden ist. Das Management erfolgt kontinuierlich, gemessen und an explizite Anforderungen der Verbraucher gebunden. Das ist der Unterschied zwischen dem Beheben eines Problems und dem Verhindern eines unbemerkten Ausfalls.
Die Sende-Dimensionen der Datenqualität
Viele Teams sprechen über Datenqualität, als ob es sich um eine einzige Sache handeln würde. Das ist nicht der Fall. Ein Datensatz kann für einen Anwendungsfall akzeptabel und für einen anderen unbrauchbar sein. Deshalb baut die Disziplin auf mehreren Dimensionen auf, nicht auf einer einzigen Bewertung. Technische Leitlinien, die an ISO- und NPL-Materialien ausgerichtet sind, behandeln Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Rückverfolgbarkeit, Verfügbarkeit und Compliance als unterschiedliche Dimensionen, die unabhängig voneinander gemessen werden sollten, da derselbe Datensatz für einen Workflow in Ordnung und für einen anderen inakzeptabel sein kann (NPL-Leitfaden).
Für die tägliche technische Arbeit sind die sechs Dimensionen, die die meisten Teams operationalisieren, die folgenden.
Was jede Dimension erfasst
Genauigkeit befasst sich mit der Frage, ob die Daten die Realität widerspiegeln. Wenn ein Join Zeilen dupliziert, kann eine Berechnung des Customer Lifetime Value plausibel aussehen, obwohl sie falsch ist. Messen Sie dies mit referenziellen Integritätsprüfungen, Abgleichen und Kontrollen, die erwartete mit beobachteten Werten vergleichen.
Vollständigkeit befasst sich mit fehlenden Informationen. Nullwerte in einem Segmentierungsfeld können Personen von einer Kampagne ausschließen oder ein Modell für einen Teil der Bevölkerung blind machen. Nullwert-Ratenprüfungen und die Validierung von Pflichtfeldern sind hier die grundlegenden Werkzeuge.
Timeliness gibt an, ob Daten rechtzeitig im Verhältnis zu dem von ihnen beschriebenen Ereignis eintreffen. Ein Betrugsmodell, das mit veralteten Merkmalen arbeitet, kann eine selbstbewusste, aber falsche Entscheidung treffen. SLAs für Aktualität, Erkennung von verspätetem Eintreffen und altersbasierte Schwellenwerte sind die praktischen Kontrollen.
Konsistenz bedeutet, dass sich dieselbe Entität in verschiedenen Systemen nicht widerspricht. Wenn CRM und Abrechnung bei einer Kundenadresse nicht übereinstimmen, werden nachgelagerte Workflows miteinander in Konflikt geraten. Quellübergreifende Abgleiche und Standardisierungsregeln fangen dies auf.
Gültigkeit prüft, ob Werte in den erwarteten Bereich, das Format oder das Regelwerk passen. Nach einer Quellmigration kann ein Statusfeld plötzlich Werte außerhalb der genehmigten Aufzählung (Enum) enthalten. Bereichsprüfungen und Formatvalidierungen übernehmen diese Aufgabe.
Eindeutigkeit befasst sich mit doppelten Datensätzen. Im Gesundheitswesen fragmentieren doppelte Patientendaten die Krankengeschichten und erschweren die Koordinierung der Pflege. Deduplizierungslogik, Prüfungen auf eindeutige Schlüssel und Identitätsabgleich sind die üblichen Abwehrmechanismen.
Datenqualitätsdimensionen auf einen Blick | Wie es gemessen wird | Sensibelste Anwendungsfälle |
|---|---|---|
Genauigkeit | Abgleich, referenzielle Integrität, Kontrollsummen | Finanzen, Abrechnung, Berichterstattung an die Geschäftsführung |
Vollständigkeit | Nullwert-Raten, Pflichtfeldprüfungen | Segmentierung, regulatorische Berichterstattung, klinische Workflows |
Timeliness | Aktualitäts-SLAs, Schwellenwerte für das Eingangsalter | Betrug, Betrieb, Echtzeit-Analysen |
Konsistenz | Quellübergreifender Vergleich, Standardisierungsregeln | Stammdaten, Kundenbetrieb, Berichterstattung |
Gültigkeit | Enum-Prüfungen, Bereichsprüfungen, Formatprüfungen | Operative Systeme, Compliance, Automatisierung |
Eindeutigkeit | Duplikaterkennung, Identitätsabgleich | Gesundheitswesen, CRM, Identitätsauflösung |
Wenn Sie eine tiefere Aufschlüsselung des Dimensionenmodells wünschen, lohnt es sich, den praktischen Rahmen der Dimensionen der Datenqualität von digna mit Ihrem eigenen Kontrollkonzept zu vergleichen.
Der Fehler, den ich am häufigsten sehe, ist, dass Teams einen einzigen Gesamtwert erstellen und diesen governance nennen. Das verbirgt die Fehlermodi, auf die es wirklich ankommt.
Die richtige Frage lautet nicht „Sind die Daten gut?“. Die richtige Frage lautet „Gut wofür und wie gemessen?“
Wie Datenqualitätsmanagement tatsächlich funktioniert
Datenqualitätsmanagement funktioniert als Lebenszyklus, nicht als Kontrolltor. Die ISO 8000-61:2016 formuliert es als eine Plan-Do-Check-Act-Schleife: Planen Sie die Strategie, implementieren Sie die Prozesse, überwachen und messen Sie die Leistung im Vergleich zu den Anforderungen und ergreifen Sie dann Korrekturmaßnahmen, um sich kontinuierlich zu verbessern (ISO 8000-61:2016). Diese Struktur ist wichtig, weil sie Qualität in einen operativen Rhythmus anstelle eines einmaligen Projekts verwandelt.
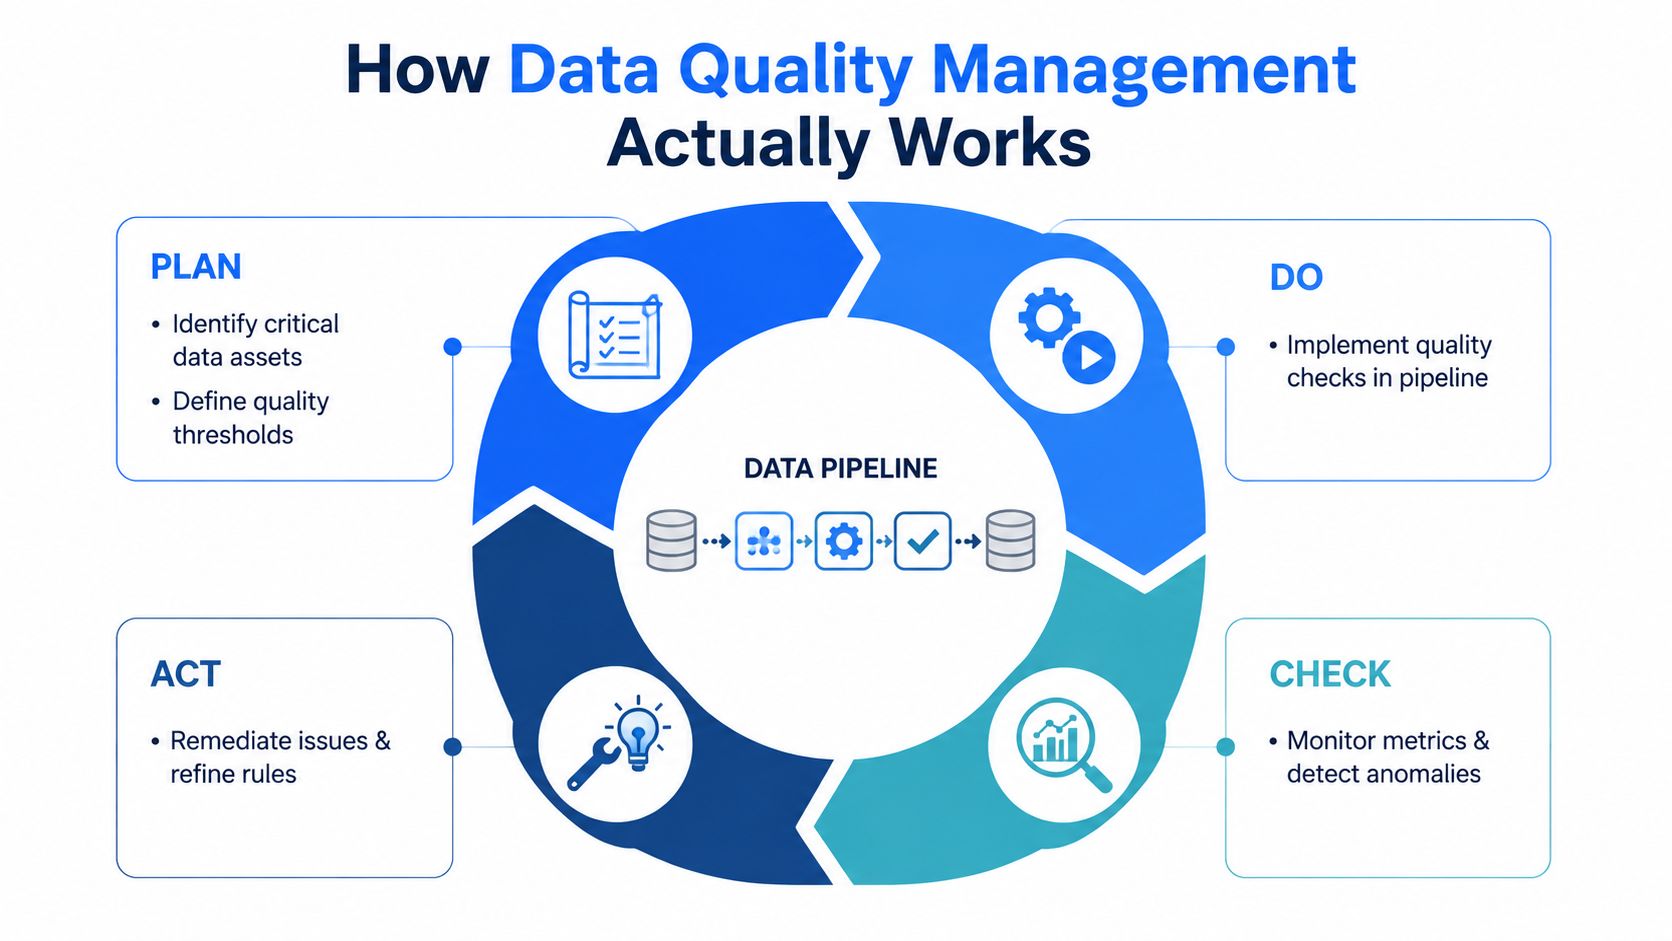
Planen, Ausführen, Überprüfen, Handeln in der Produktion
Planen beginnt mit der Identifizierung kritischer Assets, der Definition von Schwellenwerten mit den geschäftlichen Stakeholdern und der Zuweisung von Verantwortlichkeiten. Die ISO 8000-150:2022 konzentriert sich auf Rollen und Verantwortlichkeiten – der Teil, den viele Teams überspringen, bis ein Vorfall beweist, dass sie es sich nicht leisten können, dies zu tun (ISO 8000-150:2022). Jemand muss die Regel, die Ausnahme und die Korrektur verantworten.
Ausführen ist der Ort, an dem die Validierung stattfindet. In gut geführten Pipelines bedeutet das Schemakontrakte, Bereichsprüfungen, Domänenprüfungen, Nullwertprüfungen und Transformationstests, die direkt in die Jobs eingebettet sind, anstatt nachträglich hinzugefügt zu werden. Eine praktische Implementierung kann auch den Best Practices im Data Engineering folgen, bei denen Orchestrierung, Versionierung und Testbarkeit von Anfang an in den Workflow integriert sind.
Überprüfen ist die kontinuierliche Überwachung. Sowohl die ISO-Leitlinien als auch die Implementierungsarbeit unterstützen die Messung in Intervallen oder kontinuierlich. Dies ist von entscheidender Bedeutung, da sich viele Mängel als Abweichung, Verzögerung oder strukturelle Änderung zeigen, bevor sie zu offensichtlichen Fehlern werden (ISO 8000-61:2016, MDPI-Implementierungsstudie). Warnmeldungen sollten den Schweregrad klassifizieren und nicht nur Alarm schlagen.
Handeln ist die Behebung. Fehlerhafte Datensätze können unter Quarantäne gestellt, nach Möglichkeit korrigiert oder zur manuellen Überprüfung weitergeleitet werden. Wichtig ist jedoch, dass jede Ausnahme einen dokumentierten Pfad und eine Feedbackschleife zurück in das Regelwerk benötigt. So bleiben Data Stewards, Ingenieure und Analysten aufeinander abgestimmt, anstatt sich im Nachhinein zu streiten.
Operative Regel: Erstellen Sie kein Qualitätsprogramm, das nur Pipelines blockiert. Erstellen Sie eines, das dem Team sagt, was fehlgeschlagen ist, wie schlimm es ist und was als Nächstes zu tun ist.
Die Wahl der Plattform ist wichtig, aber das Betriebsmodell ist wichtiger. Ein gutes Kontrollsystem erkennt das Problem frühzeitig, begrenzt das Schadensausmaß und hinterlässt einen Prüfpfad.
Von statischen Regeln zu kontinuierlicher Observability
Herkömmliche Batch-Qualitätsprüfungen erkennen Fehler erst spät. Bis eine tägliche SQL-Assertion fehlschlägt, haben nachgelagerte Verbraucher möglicherweise bereits Entscheidungen getroffen, Modelle trainiert oder Dashboards auf der Grundlage schlechter Daten veröffentlicht. Jüngste Berichte über dieses Fachgebiet weisen auf eine Verschiebung hin zu kontinuierlicher Validierung, KI-gestützten Prüfungen und datenschutzkonformer Governance hin, da statische Bereinigungen nicht zu Live-Pipelines, Modellen und Geschäftsmetriken passen (DZone-Berichterstattung).
Dieser Wandel zeigt sich in den Tools, die Teams verwenden. Anstatt jeden Schwellenwert manuell zu schreiben, lernen moderne Observability-Ebenen Baselines kennen, achten auf Anomalien und verfolgen Schemaänderungen automatisch. Sie überwachen auch die Aktualität, sodass veraltete Feeds als betriebliche Probleme und nicht als geschäftliche Überraschungen auftauchen.
Was sich in der Praxis ändert
Ein praktischer Observability-Stack deckt in der Regel drei Dinge ab. Erstens sucht die Anomalieerkennung nach statistischen Abweichungen vom Baseline-Verhalten. Zweitens erfasst die Schema-Verfolgung hinzugefügte Spalten, entfernte Spalten und Typänderungen, bevor Verbraucher beeinträchtigt werden. Drittens meldet die Aktualitätsüberwachung verspätete oder fehlende Eingänge, sodass das Problem als Vorfall und nicht als Rätsel behandelt wird.
Es geht nicht nur um Geschwindigkeit. Es geht um den Kontext. Eine Spalte kann technisch vorhanden, aber semantisch falsch sein, und eine Tabelle kann eine generische Gültigkeitsprüfung bestehen, obwohl sie zu veraltet ist, um ihr zu vertrauen. Die Observability-Ebene liefert Ihnen das Signal, das das alte Auditmodell niemals liefern konnte, insbesondere wenn Daten beginnen, KI-Agenten und automatisierte Entscheidungen zu steuern.
Wenn Sie dies auf einen Produkt-Stack übertragen, ist die Architekturbeschreibung zum Data Observability-Ansatz von digna ein nützlicher Referenzpunkt dafür, wie sich kontinuierliche Prüfungen in eine umfassendere Überwachung einfügen.
Kontinuierliche Observability ersetzt keine Regeln, sie macht Regeln im Produktionstempo überlebensfähig.
Ein früherer Erkennungserfolg stellt sich ein. Anstatt erst von einer fehlerhaften Ladung zu erfahren, wenn sich das Unternehmen beschwert, sieht das Team das Problem fast in dem Moment, in dem es auftritt, und kann reagieren, solange das Schadensausmaß noch gering ist.

Die Wahl der richtigen Architektur und Tools
Ein mangelhafter Datenqualitätsmanagement-Stack scheitert meist auf eine von zwei Arten. Die Prüfungen sind zu weit von den Daten entfernt und verursachen Latenzen, oder sie befinden sich so nah an den Produktionssystemen, dass sie zu einer betrieblichen Belastung führen. Die In-Database-Ausführung hält die Validierung in der Nähe des Warehouse oder Lakehouse, was die Datenbewegung reduziert und in sicherheitssensible Umgebungen passt, jedoch die Rechenleistung erhöhen kann. Cloud-native Observability-Plattformen zentralisieren die Überwachung und das verwaltete Erkennen, können jedoch Bedenken hinsichtlich der Datenresidenz und des Datenschutzes aufwerfen, wenn die falschen Daten die Grenzen verlassen.
Architekturentscheidungen und Kompromisse
Kompromisse bei der Datenqualitätsarchitektur | Am besten geeignet für | Wichtigste Kompromisse | Datenschutzüberlegungen |
|---|---|---|---|
In-Database-Ausführung | Warehouses, Lakehouses, regulierte Pipelines | Geringe Datenbewegung, engere Integration, möglicher Anstieg der Rechenkosten | Hervorragend geeignet, wenn Daten innerhalb von Systemen verbleiben müssen, die vom Kunden kontrolliert werden |
Cloud-native Observability | Teams, die eine verwaltete Überwachung und gemeinsame Dashboards wünschen | Schnelle Einrichtung, zentralisierte Ansicht, mögliche Bedenken hinsichtlich der Datenresidenz | Erfordert eine sorgfältige Prüfung in Bezug auf PII (personenbezogene Daten), Zuständigkeiten und Anbieterzugriff |
Benutzerdefinierte Frameworks | Hochspezialisierte Kontrollanforderungen | Maximale Flexibilität, höherer Aufwand für die technische Wartung | Kann für eine strikte Isolierung ausgelegt werden, die Verantwortung für den Betrieb verbleibt jedoch im eigenen Haus |
Hybride Stacks | Umgebungen mit gemischtem Reifegrad | Gleichgewicht zwischen Geschwindigkeit und Kontrolle, mehr Integrationsarbeit | Nützlich, wenn sensible Prüfungen lokal verbleiben, während Metadaten zentralisiert werden |
Die richtige Architektur richtet sich nach Vorschriften, Skalierung und operativem Reifegrad. Teams in den Bereichen Finanzen, Gesundheitswesen, Telekommunikation und im öffentlichen Sektor benötigen in der Regel eine strengere Kontrolle darüber, wo Validierungen durchgeführt werden, wer die Ergebnisse sehen kann und wie Ausnahmen dokumentiert werden. Für Teams, die diese Kontrolle in ihrer eigenen Umgebung wünschen, hilft eine Übersicht über die Kompromisse bei der Datensystemarchitektur dabei, den Rahmen abzustecken, in dem Validierung, Anomalieerkennung, Aktualitätsüberwachung und Schemaverfolgung ausgeführt werden sollten.
Die Wahl einer Plattform sollte als Kontrollinstanz und nicht nur als Tool-Kauf beurteilt werden. Wenn das Team die Daten immer noch exportieren muss, um sie zu prüfen, geht ein Teil des Wertes verloren. Wenn sich die Plattform nicht in die Orchestrierungs-, Metadaten- und Vorfall-Workflows integrieren lässt, wird sie zu einem weiteren Dashboard, dem die Leute irgendwann nicht mehr vertrauen. Der praktische Test ist einfach: ob die Prüfungen in die Pipeline passen, ohne zusätzliche Übergaben, zusätzliche Kopien oder zusätzliche manuelle Prüfungen zu erzwingen.
Priorisieren, was am wichtigsten ist
Der Versuch, jede Tabelle gleichermaßen zu überwachen, ist der Grund, warum Qualitätsprogramme scheitern. Eine Alarmmüdigkeit setzt ein, Ingenieure schalten Benachrichtigungen stumm und das Team glaubt dem System nicht mehr, wenn es darauf ankommt. Das bessere Muster besteht darin, nach geschäftlicher Kritikalität zu priorisieren, da die Tabelle, die Berichte für die Geschäftsführung, Modelleingaben oder regulatorische Meldungen speist, einen anderen Standard verdient als ein weniger wichtiger Staging-Datensatz.
Umfrageergebnisse weisen auf ein verwandtes Problem hin: Teams wissen oft, dass Qualität wichtig ist, aber sie wissen nicht immer, wie man Daten gut testet. Das macht die Priorisierung umso wichtiger, weil sie Entscheidungen darüber erzwingt, welche Prüfungen wichtig sind, wo Schwellenwerte liegen sollten und welches Niveau an Fehlalarmen akzeptabel ist (Synq-Benchmark-Umfrage).
Wie man das Programm fokussiert
Beginnen Sie mit der Erfassung der Datenherkunft (Lineage), damit Sie das Schadensausmaß jedes Assets kennen. Eine einzige fehlerhafte Quelle kann sich auf ein Dashboard, eine Prognose und einen Compliance-Feed auswirken, aber die Dringlichkeit der Behebung wird nicht bei allen drei identisch sein. Es geht darum, den Datensatz nach seinen nachgelagerten Auswirkungen zu klassifizieren, bevor Sie entscheiden, was überwacht werden soll.
Die interne Planungssicht auf kritische Datenelemente ist ein nützlicher Rahmen für diese Art der Priorisierung.
Umsatz- und Risikodaten: Richten Sie Echtzeit- oder nahezu Echtzeitprüfungen für die Felder ein, die Geldbewegungen, Risikoexpositionen oder regulatorische Nachweise beeinflussen.
Modelleingaben: Achten Sie zuerst auf Aktualität, Schemaabweichungen und fehlende Werte, da veraltete oder fehlerhafte Eingaben das Vertrauen in Modelle schnell zerstören.
Operative Datensätze: Verwenden Sie Schwellenwerte, die die geschäftliche Toleranz widerspiegeln, und keine theoretische Reinheit.
Analysetabellen mit geringer Auswirkung: Akzeptieren Sie eine weniger intensive Überwachung, wenn die nachgelagerten Kosten eines Ausfalls gering sind.
Wenn alles kritisch ist, ist es nichts.
Das ist das praktische ROI-Argument. Ein fokussiertes Programm lenkt die Aufmerksamkeit der Ingenieure dorthin, wo die Kosten eines Ausfalls am höchsten sind, und belässt weniger wertvolle Tabellen unter einer einfacheren Überwachung, ohne so zu tun, als sei dies eine Schwäche. Die Governance wird gestärkt, weil sie aufhört, universell sein zu wollen.
Aufbau Ihres Datenqualitätsprogramms
Ein Programm, das den Kontakt mit der Produktion übersteht, benötigt Phasen. Die erste Phase umfasst die Asset-Inventarisierung und grundlegende SLAs. Die zweite ist die automatisierte Validierung an den Aufnahme- und Transformationsgrenzen. Die dritte umfasst Anomalieerkennung, Aktualitätsüberwachung und quellenübergreifenden Abgleich. Die vierte Phase betrifft die Reaktion auf Vorfälle, Eskalation und kontinuierliche Optimierung.
Der Implementierungsleitfaden für das Datenqualitätsteam von digna passt zu diesem phasenweisen Ansatz, da das Teammodell ebenso wichtig ist wie die Regeln selbst. Ohne klare Verantwortlichkeit bleiben Ausnahmen bestehen, und dieselben Fehler treten unter neuen Namen wieder auf.
Ein praktischer Einführungspfad
Beginnen Sie mit den Assets, die das höchste geschäftliche Risiko bergen. Definieren Sie gemeinsam mit den Geschäftsbereichen, und nicht nur mit der Technik, was „gut“ bedeutet, und schreiben Sie die Schwellenwerte auf. Wenn sich die Stakeholder nicht auf das SLA einigen können, hat das Programm kein Qualitätsproblem, sondern ein Anforderungsproblem.
Fügen Sie dann Kontrollen dort hinzu, wo Daten einfließen oder ihre Form ändern. Schemaprüfungen, Nullwert-Schwellenwerte und referenzielle Integritätstests sind die erste Ebene, da sie die häufigsten Pipeline-Ausfälle abfangen, ohne das System instabil zu machen. Führen Sie danach die Anomalieerkennung und Aktualitätsprüfungen ein, damit das Programm auch schleichende Abweichungen und nicht nur offensichtliche Regelverstöße erkennen kann.
Die Vorfallsebene sollte unspektakulär sein – und das ist ein Kompliment. Warnmeldungen benötigen eine Weiterleitung, Verantwortliche benötigen Betriebshandbücher (Runbooks) und Verstöße benötigen Eskalationspfade. Das Ziel ist nicht, mehr Tickets zu erstellen, sondern die Zeit zwischen Erkennung und Behebung zu verkürzen.
Der Erfolg sollte im Betrieb sichtbar sein, nicht in Slogans. Verfolgen Sie die mittlere Zeit bis zur Erkennung, die mittlere Zeit bis zur Behebung, den Anteil der kritischen Assets unter aktiver Überwachung und die Reduzierung nachgelagerter Vorfälle. Diese Signale zeigen Ihnen, ob das Programm die Kontrolle verbessert oder nur Rauschen erzeugt.
Sponsoren aus der Führungsebene hören zu, wenn Sie Qualität mit weniger Nacharbeitszyklen, schnellerem Modelltraining und weniger Compliance-Feststellungen verbinden. Sie hören auf zuzuhören, wenn das Gespräch abstrakt bleibt.
Ein gutes Programm macht Qualität messbar, verantwortbar und wiederholbar. Das ist der Unterschied zwischen einer Plattformfunktion und einer Unternehmensdisziplin.
Wenn Sie ein Datenqualitätsprogramm aufbauen oder ersetzen, kann digna Ihnen helfen, kritische Datensätze in Ihrer eigenen Umgebung mit Validierung, Anomalieerkennung, Aktualitätsprüfungen und Schemaverfolgung in einer operativen Ebene zu überwachen. Besuchen Sie digna, um zu sehen, wie sich kontinuierliche Kontrollen in Ihre Pipelines, Ihr Governance-Modell und die Geschäftssysteme einfügen können, die auf vertrauenswürdige Daten angewiesen sind.
Häufig gestellte Fragen
Was ist Data Quality Management?
Die fortlaufende Praxis, Daten für die Menschen und Systeme geeignet zu halten, die sie konsumieren. Entscheidend ist das Wort fortlaufend, denn die Disziplin existiert gerade deshalb, weil periodisches Prüfen nicht mehr genügte.
Woher stammt die Disziplin?
Das MIT startete 1988 das Programm Total Data Quality Management, das einen lebenszyklusbasierten Ansatz zum Messen, Verbessern und fortlaufenden Überwachen von Datenqualität etablierte. Genau diese Lebenszyklus-Rahmung trennt sie von Hauswirtschaft.
Warum bricht das Modell periodischer Audits?
Weil es nur funktioniert, solange das Geschäft Verzögerung verträgt. Sobald Entscheidungen fortlaufend aus fortlaufend veränderlichen Daten entstehen, beschreibt ein monatliches Audit einen Zustand, über den das Geschäft längst hinaus ist.
Wo gehören Qualitätsprüfungen hin?
In die Pipeline und nicht in eine nachträgliche Tabellenprüfung, sobald ein Datensatz Geld, Risiko oder Patientenversorgung beeinflussen kann. Diese Schwelle ist ein nützlicher Filter, denn sie trennt Datensätze, die Kontrollen brauchen, von solchen, die bloß Aufmerksamkeit brauchen.
Was macht vertraute Daten zur Belastung?
Vertrauen ohne Verifikation. Eine Finanzchefin, die dem Umsatz-Dashboard vertraut, handelt schneller danach, als irgendjemand es prüfen kann, und damit wird aus einem leisen Defekt eine Entscheidung, bevor der Qualitätsprozess überhaupt laufen konnte.



