Monitoring im Management: Ein praktischer Leitfaden
|
6
min. Lesezeit

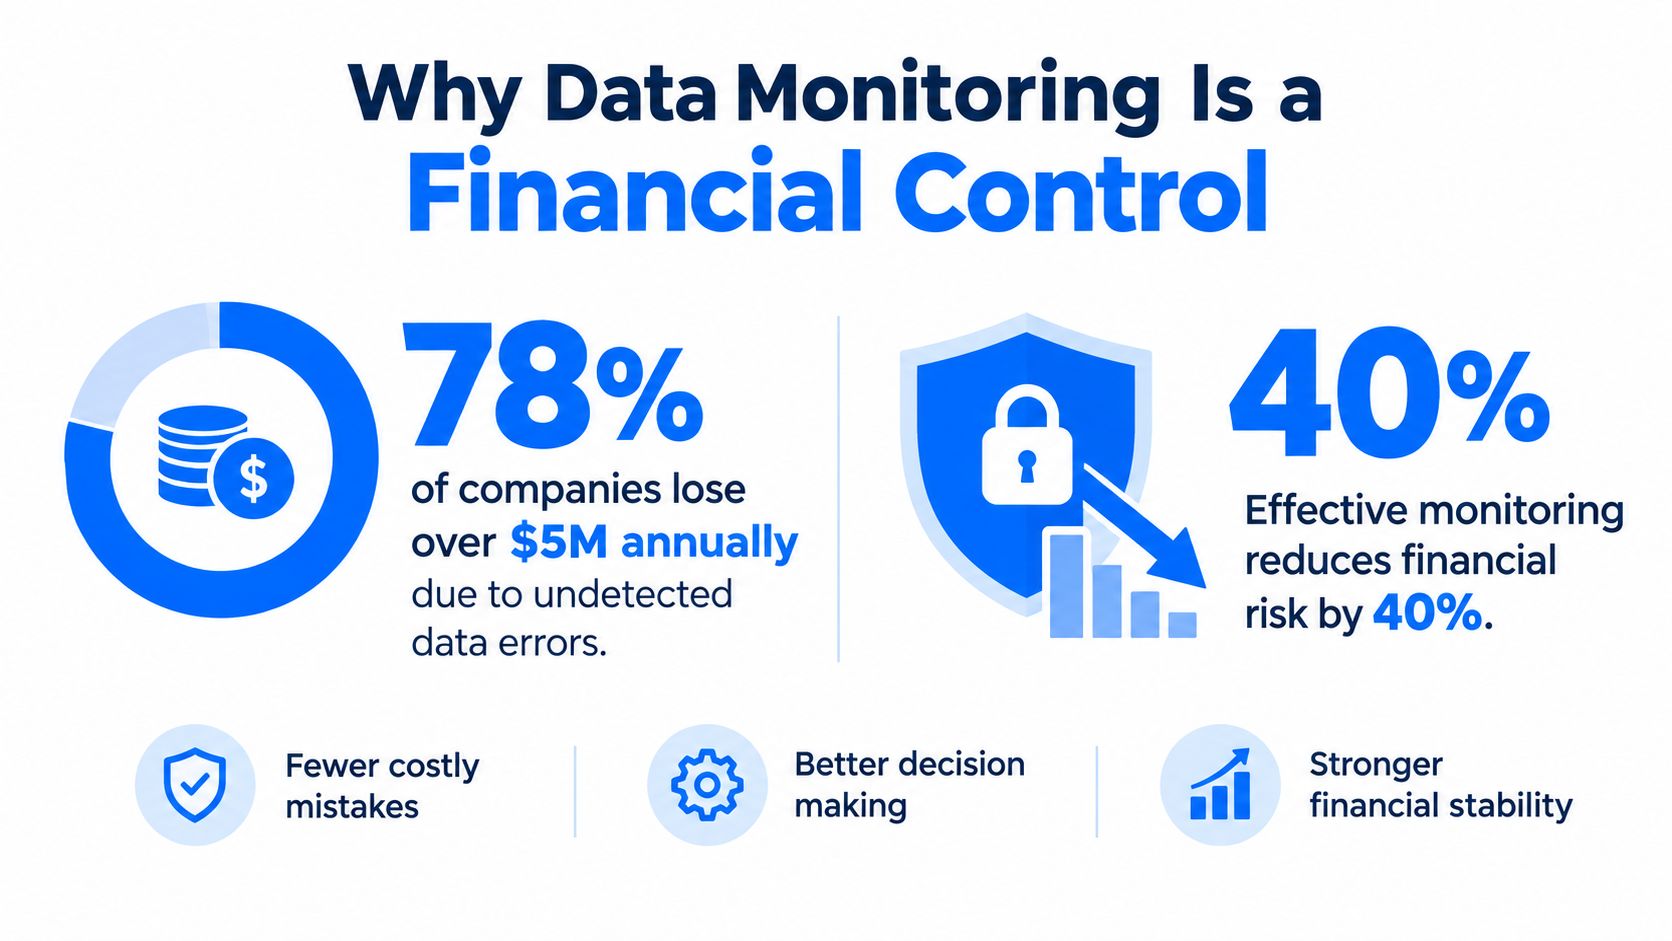
Mehr als ein Viertel der Unternehmen schätzt die jährlichen Verluste durch schlechte Datenqualität auf über 5 Millionen USD, und 7 % melden Verluste von mindestens 25 Millionen USD. Monitoring im Management verhindert dieses Risiko, indem es Datensignale mit verantwortlichen Ownern, geschäftlichen Auswirkungen und Korrekturmaßnahmen verbindet.
Diese Unterscheidung ist wichtig, denn ein Dashboard kann einen Fehler anzeigen, ohne dass jemand für seine Behebung verantwortlich ist. Wirksames Monitoring ist ein Management-Kontrollsystem: Teams definieren erwartete Zustände, beobachten das tatsächliche Verhalten, vergleichen beides und handeln, wenn die Abweichung relevant ist.
Inhaltsverzeichnis
Warum Datenmonitoring eine Finanzkontrolle ist
Schlechte Datenqualität ist nicht bloß ein technisches Ärgernis. Sie kann Prognosen verzerren, Abläufe unterbrechen, das regulatorische Reporting untergraben und automatisierte Entscheidungen in die falsche Richtung lenken. IBMs Analyse der Kosten schlechter Datenqualität berichtet, dass mehr als ein Viertel der Unternehmen die jährlichen Verluste auf über 5 Millionen USD schätzt, während 7 % Verluste von mindestens 25 Millionen USD melden.
Monitoring im Management bedeutet mehr, als einen aktuellen Wert anzuzeigen. Es bedeutet, einen erwarteten Bereich oder Zustand zu definieren, einen Daten- oder Geschäftsprozess zu beobachten, eine relevante Abweichung zu erkennen, Verantwortung zuzuweisen, Nachweise zu sichern und zu prüfen, ob die Behebung gewirkt hat. Ein Dashboard unterstützt diesen Prozess, ersetzt ihn aber nicht.
Dashboard-Transparenz versus Management-Kontrolle
Ein Dashboard beantwortet die Frage „Was passiert gerade?“ Eine Management-Kontrolle beantwortet umfassendere Fragen:
Erwartung: Was sollte passieren, und welcher Standard legt das fest?
Wesentlichkeit: Welche geschäftlichen, finanziellen, operativen oder regulatorischen Folgen hat es, wenn sich die Bedingungen ändern?
Ownership: Welche Person oder welches Team muss der Sache nachgehen?
Nachweis: Welche Aufzeichnungen zeigen, wann die Abweichung begann und was sich geändert hat?
Reaktion: Welche Maßnahme ist erforderlich, und wann kann der Fall geschlossen werden?
Bei einer Bank kann ein verspäteter Risikodatensatz das Reporting oder Entscheidungsprozesse beeinträchtigen. Teams, die am Datenmanagement in Banken arbeiten, brauchen mehr als einen Pipeline-Status. Sie brauchen Signale zu Aktualität, Validierung, Schema und Geschäftsregeln, die mit den Prozessen verknüpft sind, die diese Datensätze unterstützen.
Der praktische Zielkonflikt ist einfach. Breites Monitoring schafft Transparenz, doch wahlloses Sammeln erzeugt Rauschen und Kosten. Fokussiertes Monitoring finanziell wesentlicher Tabellen, regulatorischer Datensätze, Kundendaten und entscheidungskritischer Pipelines liefert eine kleinere Beweisbasis, mit der das Management tatsächlich arbeiten kann.
Die Entwicklung der Management-Kontrolltheorie
Moderne Observability kann wie ein Bruch mit dem traditionellen Management wirken, vor allem wenn Machine Learning ungewöhnliches Verhalten ohne manuell geschriebene Regel erkennt. Die zugrunde liegende Logik ist jedoch älter und stabiler als die Technologie. Teams vergleichen nach wie vor tatsächliche mit erwarteten Zuständen und entscheiden, ob eine Abweichung Handlungsbedarf auslöst.
Henri Fayol formulierte 1916 eine frühe Definition der Management-Kontrolle und beschrieb Kontrolle als Prüfung, ob Tätigkeiten dem beschlossenen Plan, den erteilten Anweisungen und den festgelegten Grundsätzen folgen, wie dieser Überblick über die Management-Kontrolltheorie dokumentiert. Damit wurde Kontrolle zu einer wiederkehrenden Führungsaufgabe statt zu einer einmaligen Inspektion.
Frühere Arbeiten des Scientific Management bestätigten dasselbe Muster. Frederick Taylor behandelte Kontrolle in Experimenten aus dem Jahr 1906 als Ziel, und Copley beschrieb Kontrolle 1923 als zentrale Idee des Scientific Management. Spätere Zusammenfassungen nennen fünf Prinzipien, die Urwick 1929 vorschlug: Verantwortlichkeit, Nachweis, Standardisierung, Vergleich und Nutzen.
Der Kontrollzyklus in einer Datenplattform
Diese Prinzipien lassen sich direkt auf den Datenbetrieb in Unternehmen übertragen:
Einen Standard setzen. Akzeptable Aktualität, gültige Datensätze, erwartetes Schema, Lieferverhalten oder KPI-Entwicklung definieren.
Leistung messen. Beobachtungen aus Tabellen, Pipelines, Workloads und Geschäftsprozessen erfassen.
Ergebnisse vergleichen. Das aktuelle Verhalten mit einer Baseline, einer Regel, einem Zielwert oder einem historischen Muster abgleichen.
Bedeutung bewerten. Harmlose Schwankungen von Abweichungen trennen, die Entscheidungen beeinflussen können.
Korrigierend eingreifen. Den Befund an einen Owner weiterleiten, die Reaktion dokumentieren und prüfen, ob die Bedingungen wieder akzeptabel sind.
KI-gestützte Anomalieerkennung verändert, wie Teams Baselines festlegen und Abweichungen erkennen. Den Kontrollzyklus schafft sie nicht ab. Sie automatisiert Teile der Beobachtung und des Vergleichs, während Menschen weiterhin entscheiden, was das Signal bedeutet und welche Reaktion angemessen ist.
Eine wissenschaftliche Synthese aus dem Jahr 2024 untersuchte die Forschung zur Organisationskontrolle mittels Kozitationsanalyse von 1.148 Artikeln, die zwischen 1938 und 2022 erschienen sind. Ihre multidisziplinäre Metaanalyse umfasste 293 Artikel, 310 unabhängige Stichproben und insgesamt 110.585 Beobachtungen, so der Cambridge-Überblick zur Organisationskontrolle. Die Forschungstradition reicht heute über das Finanz-Rechnungswesen hinaus bis zu nichtfinanziellen Kennzahlen, Informationssystemen, Organisationsverhalten und strategischer Performance.
Diese Entwicklung erklärt, warum eine Plattform wie digna Anomalieerkennung, Aktualitätsüberwachung, Validierung, Schema-Monitoring und KPI-Beobachtung kombinieren kann. Das sind keine unverbundenen Funktionen, sondern moderne Umsetzungen einer seit Langem etablierten Managementdisziplin.
Die zentralen Arten des Monitorings
Monitoring scheitert, wenn Teams jedes Signal als dieselbe Art von Problem behandeln. Eine Pipeline-Verzögerung, eine unerwartete Umsatzbewegung und eine fehlgeschlagene Datenschutzvalidierung können alle Alerts auslösen, erfordern aber unterschiedliche Standards, Owner, Reaktionszeiten und Nachweise.

Operatives Monitoring
Operatives Monitoring prüft, ob die Datenumgebung wie vorgesehen funktioniert. Es umfasst Verfügbarkeit, Workload-Verhalten, Performance, Durchsatz, Datenaktualität, Korrektheit, Qualität und Abdeckung. Ein abgeschlossener Job ist nicht zwangsläufig ein erfolgreicher Job. Das Ergebnis kann verspätet, unvollständig, strukturell verändert oder für die Weiterverarbeitung ungeeignet sein.
Nützliche Signale sind unter anderem:
Pünktlichkeit: Ist die erwartete Tabelle oder Partition innerhalb des vereinbarten Zeitfensters eingetroffen?
Schema-Verhalten: Wurden Spalten hinzugefügt, entfernt oder so geändert, dass Konsumenten betroffen sind?
Pipeline-Zustand: Ist ein Prozess fehlgeschlagen, ungewöhnlich oft neu gestartet worden oder hat er weniger Datensätze als erwartet geliefert?
Plattformverhalten: Haben sich Workload-Verbrauch oder Performance außerhalb ihres normalen Musters bewegt?
KPI-Monitoring
KPI-Monitoring bewertet die geschäftliche Bedeutung der Daten. Es verfolgt Umsatz, Verkäufe, Transaktionen, Kundenaktivität, operative Volumina oder andere Kennzahlen im Vergleich zu den geschäftlichen Erwartungen. Die wichtige Designentscheidung besteht darin, eine legitime geschäftliche Veränderung von einem Datenfehler zu unterscheiden.
Ein KPI-Alert sollte daher Kontext mitliefern. Welche Quelltabellen speisen die Kennzahl? Gab es zuvor eine Schemaänderung? Haben sich Datensatzanzahlen, Verteilungen oder Validierungsergebnisse verschoben? Kann der fachliche Owner bestätigen, dass die Bewegung der Realität entspricht?
Risikobasiertes Monitoring
Risikobasiertes Monitoring legt fest, wie engmaschig jede Kontrolle beobachtet werden sollte. Die NIST-Leitlinien zum kontinuierlichen Monitoring empfehlen eine Strategie, die die Frequenz nach Volatilität der Kontrolle, Risikotoleranz des Systems, Bedrohungs- und Schwachstellenlage, Auswirkungsniveau, bekannten Schwächen und Kritikalität der überwachten Funktion variiert. Außerdem empfehlen sie, Frühindikatoren wie Schemaänderungen mit Spätindikatoren wie wiederkehrenden Incidents zu kombinieren.
Monitoring-Art | Leitfrage | Typische Reaktion |
|---|---|---|
Operativ | Verhält sich der Datendienst korrekt? | Lieferung, Infrastruktur oder Pipeline-Bedingungen untersuchen |
KPI | Entwickelt sich die Geschäftsleistung wie erwartet? | Die Kennzahl validieren und den fachlichen Owner einbeziehen |
Risikobasiert | Wie viel Aufmerksamkeit braucht diese Kontrolle? | Frequenz, Schwellenwerte, Eskalation oder Akzeptanz anpassen |
Ein Monitoring-Programm braucht alle drei. Data Quality Observability kann eine fehlschlagende Datensatzregel aufdecken, doch das Management muss weiterhin die Folgen bestimmen, den Owner zuweisen und die Entscheidung dokumentieren.
Die Verantwortungslücke im modernen Monitoring
Viele Unternehmen haben schneller in Dashboards investiert, als sie Ownership-Modelle entwickelt haben. Das Ergebnis ist bekannt: Ein Team sieht eine rote Anzeige, geht davon aus, dass sich ein anderes Team darum kümmert, und stellt später fest, dass niemand die Nachweise gesichert oder die Korrektur getestet hat.
Eine Governance-Umfrage aus dem Jahr 2025 stufte Stewardship und Ownership als Top-Prioritäten ein, während unabhängige Berichte zur selben Governance-Studie zeigten, dass manchen Unternehmen noch Programme für Model Observability sowie grundlegende Fähigkeiten für Datenqualität oder Zugriffs-Governance fehlen, wie der 2025 State of Enterprise Data Governance Report dokumentiert.
Dieser Befund legt eine häufige Diskrepanz offen. Teams diskutieren Observability womöglich als technische Fähigkeit, während Governance-Verantwortliche eine operativere Frage stellen: Wer ist für das Signal, seine Interpretation und seinen Abschluss verantwortlich?
Jeden Alert umsetzbar machen
Ein brauchbarer Monitoring-Eintrag sollte fünf Elemente verbinden:
Benannter Owner: Das Team oder die Rolle, die für die Untersuchung verantwortlich ist.
Geschäftliche Auswirkung: Die gefährdete Entscheidung, der Prozess, der Kunde oder die Verpflichtung.
Handlungsschwelle: Die Bedingung, die den Befund von einer Beobachtung zu einer Eskalation macht.
Nachweiskette: Die Kennzahlenhistorie, fehlerhafte Datensätze, das Schema-Ereignis oder das Validierungsergebnis, die den Befund stützen.
Abschlusstest: Der Nachweis, der zeigt, dass die Behebung funktioniert hat.
Praxisregel: Ein Alert ohne Owner ist Telemetrie, keine Kontrolle.
Mehr Alerts können das Benachrichtigungsvolumen erhöhen, ohne die Zuverlässigkeit zu verbessern. Eine kleinere Zahl verlässlicher Signale, die über Data-Governance-Rollen geleitet werden, führt oft zu besseren Management-Ergebnissen als ein größerer Katalog technisch interessanter Ereignisse.
Der Zielkonflikt besteht zwischen Abdeckung und Aufmerksamkeit. Breite Abdeckung hilft Teams, unbekannte Fehlerarten zu entdecken, doch jeder Alert bindet Prüfkapazität. Risikobasierte Schwellenwerte, klare Eskalationswege und historischer Kontext erlauben es Führungskräften, ihre Aufmerksamkeit für Abweichungen zu reservieren, die eine Geschäftsentscheidung verändern können.
Eine praxistaugliche Monitoring-Strategie umsetzen
Beginnen Sie mit den Entscheidungen, die sich Ihr Unternehmen auf Basis schlechter Daten nicht leisten kann. Diese Liste umfasst meist regulatorisches Reporting, Finanzkontrollen, Kundenberechtigungen, operative Kapazitäten sowie KI- oder Analyseergebnisse, die wesentliche Entscheidungen beeinflussen. Ordnen Sie diesen Entscheidungen die Datensätze und Pipelines zu, bevor Sie Kennzahlen auswählen.
Indikatoren für unterschiedliche Fehlerarten wählen
Nutzen Sie Frühindikatoren, um Zustände zu erkennen, bevor ein Incident für Nutzer sichtbar wird. Schemaänderungen, verspätete Partitionen, Abweichungen bei der Aktualität, Verschiebungen der Null-Quote, ungewöhnlicher Workload-Verbrauch und Veränderungen von Verteilungen können eine Verschlechterung früh anzeigen.
Spätindikatoren zeigen, ob das Kontrollsystem nach einem Problem funktioniert. Wiederkehrende Incidents, fehlgeschlagene Abstimmungen, Korrekturen im Reporting und wiederholte Kontrollausnahmen zeigen dem Management, wo Behebung oder Kontrolldesign noch schwach sind.
Definieren Sie für die Aktualität ein Service-Level-Objective, statt zu sagen, Daten sollten „nahezu in Echtzeit“ vorliegen. Googles SRE-Leitfaden zu Service-Level-Objectives hält fest, dass Daten, die mehr als vier bis fünf Minuten veraltet sind, die Reaktion auf Incidents in Monitoring-Systemen deutlich verzögern können. Der richtige Schwellenwert hängt vom Prozess ab, das Prinzip bleibt aber gleich: Messen Sie den Anteil der Daten oder Pipeline-Läufe, die eine vereinbarte Aktualitätsbedingung innerhalb eines definierten Zeitfensters erfüllen.
Die Frequenz nach Risiko festlegen
Prüfen Sie nicht jede Tabelle im selben Takt. Ein finanziell wesentlicher Datensatz, eine identitätsbezogene Tabelle oder ein regulatorischer Feed verdient eine engere Beobachtung als eine wenig relevante explorative Tabelle. Passen Sie die Frequenz an, wenn sich Volatilität, Exposition, bekannte Schwächen oder geschäftliche Kritikalität ändern.
Vermeiden Sie außerdem Durchschnittswerte, die die Ausreißer des operativen Verhaltens verbergen. Google-SRE-Material bezeichnet Perzentilmessungen wie das 50., 95. und 99. Perzentil als nützlich, weil Durchschnittswerte eine kleine, aber folgenreiche Menge langsamer Anfragen verdecken können. Dieselbe Überlegung gilt für Pipeline-Latenz und Workload-Performance.
Den Reaktionsweg vor dem Aktivieren von Alerts definieren
Halten Sie für jede Kennzahl Baseline, Owner, Schwellenwert, Eskalationsweg, Ablageort der Nachweise und Wiederherstellungstest fest. Monitoring sollte nicht nur die Zeit von der Abweichung bis zur Erkennung messen, sondern auch die Zeit bis zur Bestätigung und bis zur Wiederherstellung.
Eine Plattform wie digna kann dieses Betriebsmodell unterstützen, indem sie das Datenverhalten überwacht, Datensätze validiert, die Aktualität verfolgt, Schemaänderungen erkennt und Geschäfts- sowie Plattformkennzahlen in der Umgebung des Kunden beobachtet. Teams sollten Deployment, Ownership und Schwellenwerte dennoch anhand ihrer eigenen Architektur und Risikopolitik prüfen. Die Monitoring- und Reporting-Funktion gehört in diesen umfassenderen Managementprozess, nicht daneben.
Praxisbeispiele aus regulierten Branchen
Ein Team im Finanzsektor könnte eine Risikotabelle vor einem Reporting-Zyklus auf unerwartete Schemaänderungen überwachen. Eine entfernte Spalte oder ein geänderter Datentyp kann nachgelagerte Logik ohne Vorwarnung zerstören, daher ist die nützliche Kontrolle nicht bloß ein Alert bei fehlgeschlagenem Job. Sie kombiniert strukturelles Monitoring, Wissen über Abhängigkeiten, Validierungsergebnisse und einen verantwortlichen Owner, der beurteilen kann, ob der betroffene Bericht verlässlich bleibt.
Teams im Gesundheitswesen stehen vor einer anderen Variante desselben Problems. Ein Patientendatensatz kann pünktlich eintreffen und technische Prüfungen bestehen, aber dennoch gegen eine fachliche oder rechtliche Regel verstoßen. Validierung auf Datensatzebene kann den fehlerhaften Datensatz identifizieren, die geprüfte Regel festhalten, den Fall zur Prüfung weiterleiten und den Nachweis der Lösung aufbewahren.
Artikel 5 der EU-Datenschutz-Grundverordnung verlangt, dass personenbezogene Daten sachlich richtig und auf dem neuesten Stand sind. Zudem fordert er angemessene Sicherheit, einschließlich Schutz vor unbefugter oder unrechtmäßiger Verarbeitung sowie vor unbeabsichtigtem Verlust, Zerstörung oder Schädigung. Kontinuierliches Monitoring hilft, diese Pflichten in operative Nachweise zu übersetzen, statt sich auf periodische manuelle Prüfungen zu verlassen.
Kontrollen nach Branche anwenden
Finanzdienstleistungen: Transaktions- und regulatorische Daten validieren, die Pünktlichkeit der Lieferungen überwachen, strukturelle Änderungen erkennen und Ausnahmen mit Reporting- und Risiko-Ownern verknüpfen.
Gesundheitswesen: Klinische und operative Datensätze gegen Geschäftsregeln prüfen, ungenaue oder inkonsistente Werte identifizieren und Prüfnachweise sichern.
Telekommunikation: Große Mengen an Kunden- und Netzdaten beobachten, echte Nutzungsänderungen von Pipeline-Fehlern unterscheiden und Fehler eskalieren, bevor sie das operative Reporting verzerren.
Öffentlicher Sektor: Nachvollziehbare Nachweise für kritische Datensätze führen, einschließlich der geprüften Regel, der betroffenen Datensätze, der getroffenen Entscheidung und der Korrekturmaßnahme.
Unternehmen mit komplexen Finanzkontrollen können zusätzlich Ressourcen zur automatisierten Durchsetzung von Richtlinien im FinTech-Bereich prüfen, wenn sie Richtlinienanforderungen mit wiederholbaren operativen Kontrollen verbinden müssen. Das zentrale Designprinzip bleibt dasselbe: Monitoring sollte Nachweise liefern, die ein verantwortliches Team interpretieren und umsetzen kann.
Für Gesundheitsorganisationen erfordert Datencompliance im Gesundheitswesen dieselbe Disziplin bei Qualität, Aktualität, Validierung und strukturellen Änderungen. Compliance entsteht nicht allein durch einen Score. Sie hängt davon ab, ob Teams zeigen können, was sie geprüft haben, was fehlgeschlagen ist, wer reagiert hat und ob das Ergebnis korrigiert wurde.
Die Zukunft der evidenzbasierten Governance
Die nächste Stufe des Monitorings ist keine größere Wand voller Diagramme. Es ist eine engere Verbindung zwischen Beobachtung, Managementurteil und Nachweis. KI kann das spezifische Verhalten von Datensätzen lernen, Signale korrelieren, Anomalien priorisieren und den manuellen Pflegeaufwand für Regeln senken. Ob eine geschäftliche Ausnahme akzeptabel ist, kann sie aber ohne definierte Richtlinie und verantwortliche Instanz nicht entscheiden.
Der beständigste Betriebszyklus besteht aus vier Teilen:
Tatsächliche Zustände beobachten über Daten, Plattformen, Geschäftskennzahlen und Kontrollen hinweg.
Zustände mit Erwartungen vergleichen anhand von Regeln, Baselines, Service-Objectives oder Risikoschwellen.
Korrekturmaßnahmen zuweisen und umsetzen mit dokumentiertem Owner und Eskalationsweg.
Das Ergebnis überprüfen durch nachfolgende Messungen und aufbewahrte Nachweise.
Dieser Ansatz hilft Teams auch, Datenprobleme von Modellproblemen zu trennen. Ein unerwarteter Modell-Output kann auf ein geändertes Upstream-Schema, verspätete Daten, eine verschobene Verteilung, eine fehlgeschlagene Validierungsregel oder ein legitimes Geschäftsereignis zurückgehen. Wer der Ursachenkette folgt, verhindert, dass Model Monitoring als isolierte Lösung für jedes KI-Zuverlässigkeitsproblem behandelt wird.
Monitoring entfaltet seinen Managementwert, wenn die Nachweise eine Entscheidung verändern.
Der praktische Wandel führt von passiver Transparenz zu evidenzbasierter Governance. Data Engineers werden nicht nur für die Verfügbarkeit von Pipelines verantwortlich, sondern auch für die Integrität, Aktualität und Nachvollziehbarkeit der Informationen, die Analysten, Führungskräfte, Aufsichtsbehörden und KI-Systeme nutzen. Fachliche Owner erhalten eine klarere Rolle, weil sie Wesentlichkeit und akzeptable Ergebnisse definieren. Governance-Teams erhalten Nachweise, die im normalen Betrieb entstehen, statt unter Druck rekonstruiert zu werden.
Das ist die eigentliche Bedeutung von Monitoring im Management. Teams überwachen nicht, um mehr Telemetrie zu sammeln. Sie überwachen, um relevante Veränderungen früh zu erkennen, Verantwortung explizit zu machen und Entscheidungen vor unzuverlässigen Daten zu schützen.
digna bietet eine Enterprise-Plattform für Datenqualität und Data Observability, die in der eigenen Umgebung des Kunden läuft, mit Modulen für Anomalieerkennung, Aktualität, Validierung auf Datensatzebene, Schema-Tracking sowie Geschäfts- und Plattform-Monitoring. Besuchen Sie digna und erfahren Sie, wie Ihr Team Monitoring-Signale mit verantwortlicher Behebung und verlässlichen Nachweisen verbinden kann.
Wenn Ihre Verantwortungslücke beim KPI-Monitoring am größten ist, sehen Sie sich an, wie Business Monitoring mit digna echte Bewegungen bei Umsatz, Transaktionen und Volumina von Datenfehlern in den zugrunde liegenden Tabellen unterscheidet.
Häufig gestellte Fragen
Was bedeutet Monitoring im Management?
Monitoring im Management ist ein Kontrollprozess und nicht bloß ein Dashboard. Teams definieren einen erwarteten Bereich, beobachten einen Daten- oder Geschäftsprozess, erkennen relevante Abweichungen, weisen einen Owner zu, sichern Nachweise und prüfen, ob die Behebung gewirkt hat. Ein Dashboard unterstützt diesen Zyklus, ersetzt ihn aber nicht.
Worin unterscheidet sich ein Dashboard von einer Management-Kontrolle?
Ein Dashboard zeigt nur, was gerade passiert. Eine Management-Kontrolle klärt zusätzlich Erwartung, Wesentlichkeit, Ownership, Nachweis und Reaktion: welcher Standard gilt, welche geschäftlichen Folgen drohen, wer untersuchen muss, welche Aufzeichnungen die Änderung belegen und wann der Fall geschlossen werden kann.
Welche Arten von Monitoring im Management gibt es?
Der Artikel unterscheidet drei Arten. Operatives Monitoring prüft Aktualität, Schema, Pipeline-Zustand und Plattformverhalten. KPI-Monitoring verfolgt Umsatz, Transaktionen oder Volumina gegenüber geschäftlichen Erwartungen. Risikobasiertes Monitoring legt fest, wie oft und wie genau jede Kontrolle beobachtet wird, abhängig von Auswirkung, Volatilität und bekannten Schwächen.
Warum braucht jeder Monitoring-Alert einen Owner?
Ohne benannten Owner ist ein Alert Telemetrie, keine Kontrolle. Teams sehen eine rote Anzeige, gehen davon aus, dass sich jemand anderes kümmert, und merken später, dass niemand Nachweise gesichert oder die Korrektur getestet hat. Ein guter Alert verbindet Owner, Geschäftsauswirkung, Handlungsschwelle, Nachweiskette und Abschlusstest.
Wie oft sollten Daten überwacht werden?
Die Monitoring-Frequenz sollte sich nach dem Risiko richten, nicht nach einem einheitlichen Takt für alle Tabellen. Finanziell wesentliche Datensätze, Identitätstabellen und regulatorische Feeds verdienen engere Beobachtung als explorative Tabellen. NIST empfiehlt, die Frequenz an Volatilität, Auswirkungsniveau, bekannte Schwächen und Kritikalität anzupassen.



