10 Business-Monitoring-Software-Lösungen im Vergleich
|
11
min. Lesezeit

Der gängigste Rat zur Auswahl von Business-Monitoring-Software lautet, Feature-Listen zu vergleichen. Damit geht die wichtigste Entscheidung unter: welche Monitoring-Ebene Sie kontrollieren müssen. Eine Plattform, die Umsätze direkt an der Datenquelle überwacht, erfüllt einen anderen Zweck als ein BI-Tool, das Nutzer über ein gesteuertes Dashboard alarmiert, eine Observability-Plattform, die fehlgeschlagene Checkouts mit Anwendungsservices verknüpft, oder ein Product-Analytics-System, das Veränderungen bei Conversion und Retention erklärt.
Dieser Vergleich bewertet jede Option nach ihrer Monitoring-Grenze, ihrem Deployment-Modell, der Datenbewegung, Governance, Anomalieerkennung, Aktualität, Validierung, Integrationen, dem Preismodell, dem Implementierungsaufwand und der Eignung für Finanzwesen, Gesundheitswesen und Telekommunikation. Diese Kriterien zählen, weil ein nützlicher Alert nur der Anfang ist. Teams müssen außerdem wissen, ob Produktionsdaten ihre Umgebung verlassen, wem die Metrikdefinition gehört, wie ein Incident den richtigen Verantwortlichen erreicht und ob die Kosten mit Tabellen, Telemetrie, Nutzern, Kapazität oder Datenvolumen wachsen.
Die Kategorie wächst über Dashboards und Schwellenwertregeln hinaus. Der breitere Observability-Markt wurde laut der Data-Observability-Marktanalyse von Grand View Research für 2023 auf 2,143 Milliarden USD geschätzt und soll bis 2030 4,7332 Milliarden USD erreichen, bei einer CAGR von 12,2 % von 2024 bis 2030. Für regulierte Unternehmen macht dieses Wachstum eine disziplinierte Bewertung wichtiger, nicht weniger wichtig. Eine breite Plattform mag beeindruckende Abdeckung bieten und gleichzeitig unnötige Datenbewegung, Governance-Aufwand oder Preiskomplexität verursachen.
Inhaltsverzeichnis
Die 10 besten Business-Monitoring-Lösungen im Funktionsvergleich
Wählen Sie die Monitoring-Grenze, die Sie kontrollieren müssen
1. Solutions Business Monitoring
Solutions Business Monitoring ist ein Modul der digna Plattform, das Business- und operative KPIs direkt auf den zugrunde liegenden Datensätzen überwacht. Statt darauf zu warten, dass ein nachgelagertes Dashboard ein Problem sichtbar macht, analysiert es das Datenverhalten dort, wo die Metrik berechnet wird, und erkennt ungewöhnliche Veränderungen, Volatilität, Trends, Schema-Änderungen, Validierungsfehler und Lieferverzögerungen.
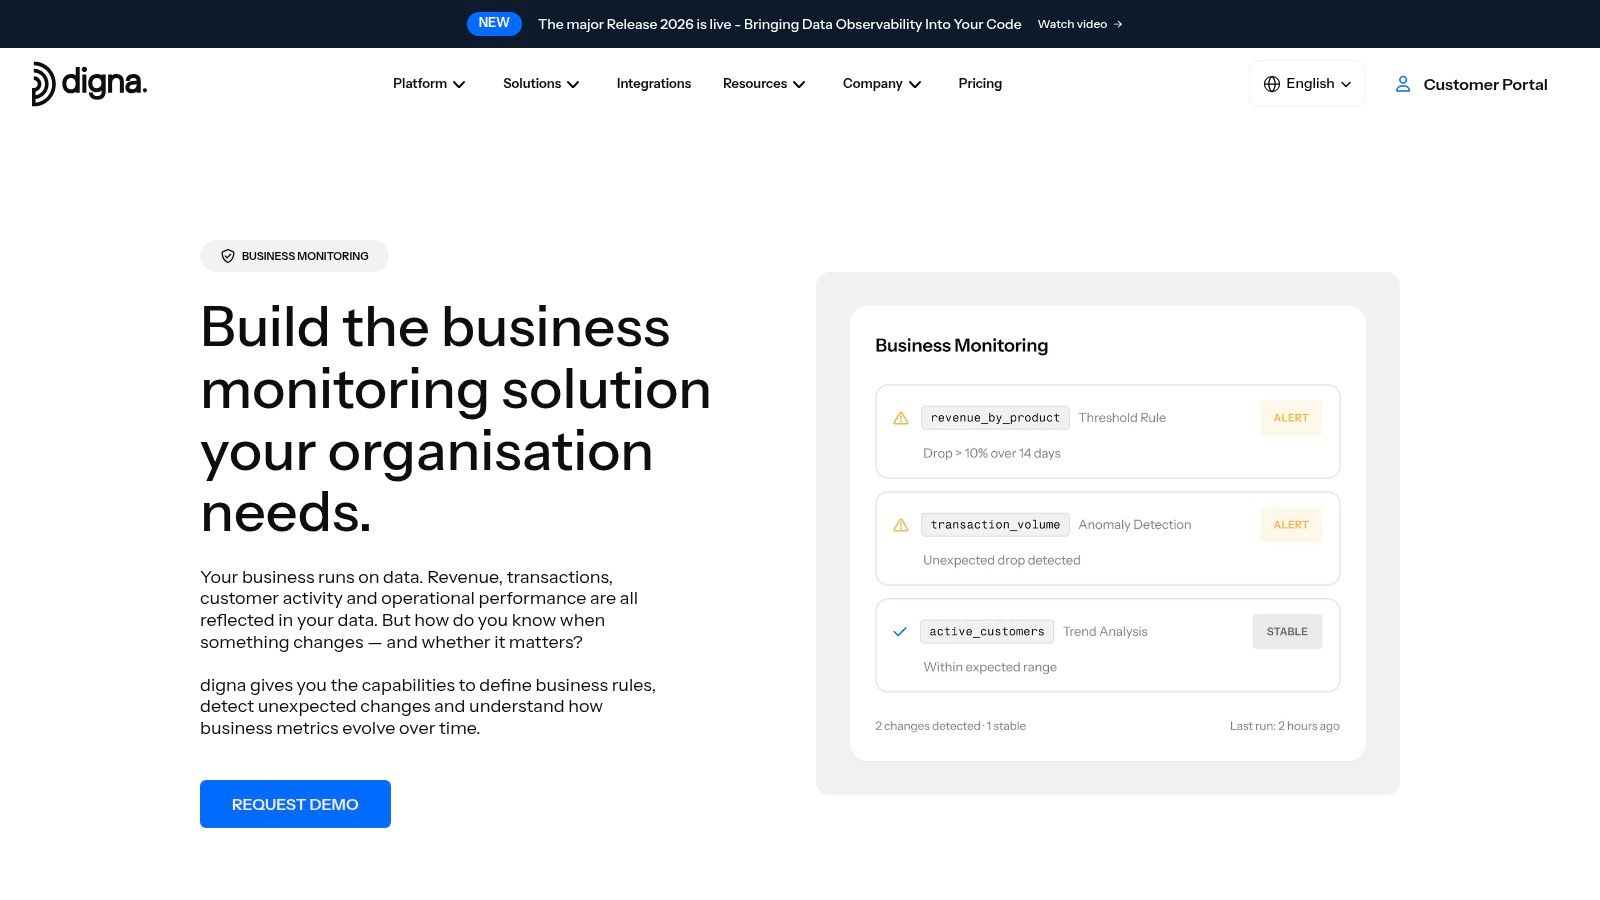
Der entscheidende Unterschied ist die Monitoring-Grenze. digna führt Metrikberechnung und Analyse innerhalb der Datenbank oder Datenumgebung des Kunden aus, mit Deployment in einer Private Cloud, einer VPC oder On-Premises-Infrastruktur. Produktionsdaten bleiben unter der Kontrolle des Kunden, ein erheblicher Vorteil bei Finanzdaten, klinischen Informationen, Telekommunikationsdaten und Workloads des öffentlichen Sektors. Die Ausführung in der Datenbank verringert außerdem die Notwendigkeit, große Datensätze in einen separaten Monitoring-Service zu kopieren.
Die Plattform lernt das Normalverhalten von Datensätzen und nutzt KI-gestützte Anomalieerkennung, um manuelles Regelschreiben zu reduzieren. Außerdem vereint sie mehrere Formen von Observability, die oft getrennt eingekauft werden:
Business-KPI-Monitoring: Erkennt unerwartete Bewegungen bei Umsatz, Vertrieb, Transaktionen, Kundenaktivität und operativen Kennzahlen.
Timeliness-Monitoring: Lernt Liefermuster und berechnet erwartete Ankunftszeiten, um verspätete, fehlende oder verfrühte Ladevorgänge zu erkennen.
Datenvalidierung: Prüft Datensätze gegen Geschäftsregeln und gezielte Qualitätskontrollen.
Schema-Tracking: Erkennt strukturelle Änderungen wie hinzugefügte oder entfernte Spalten und geänderte Datentypen.
Diese Kombination macht digna dort stark, wo ein Business-Alert in eine Datenuntersuchung münden muss. Die gemeinsame Oberfläche bietet Analysten, Data Engineers und Fachverantwortlichen einen zentralen Ort, um Incidents, Trends und Status zu prüfen. Teams, die Monitoring- und Reporting-Workflows bewerten, sollten testen, ob diese gemeinsame Sicht die Übergaben zwischen KPI-Verantwortlichen und Plattformbetreibern reduziert.
Deployment und kommerzielle Eignung
Die modulare Lizenzierung von digna erlaubt es Kunden, mit einem Monitoring-Modul zu starten und schrittweise zu erweitern. Der Preis setzt sich aus einer Grundgebühr plus aktiven Tabellen pro Modul zusammen, nicht aus API-Aufrufen, Scan-Anzahl oder Alert-Volumen. Diese Struktur lässt sich für stabile Workloads leichter planen, auch wenn sehr große Tabellenbestände die Kosten erhöhen können, wenn das Monitoring breit über mehrere Module ausgeweitet wird.
Der Implementierungs-Tradeoff ist klar. Der Kunde muss Rechen- und Speicherressourcen in seiner eigenen Umgebung bereitstellen und verwalten, doch dieser Aufwand ermöglicht stärkere Sicherheits- und Governance-Kontrollen. Laut digna liefert die Installation erste Erkenntnisse in unter zwei Stunden. Diese Aussage sollte dennoch am Data Warehouse, Zugriffsmodell und an repräsentativen Datensätzen des Kunden überprüft werden.
Praxisregel: Wählen Sie diese Option, wenn die Frage nicht nur lautet „Hat sich der KPI verändert?“, sondern auch „Wurden die Daten geliefert, sind sie strukturell intakt, valide und lassen sie sich sicher innerhalb unserer Umgebung untersuchen?“
Für Finanzwesen, Gesundheitswesen und Telekommunikation eignet sich digna am besten für Organisationen, die kombiniertes Business-, Daten- und Plattform-Monitoring benötigen, ohne Produktionsdaten an einen Anbieter zu senden. Die Einschränkung: digna ersetzt kein Application Performance Monitoring. Es erklärt auffälliges Daten- und KPI-Verhalten, doch Teams, die Request-Traces und Service-Maps brauchen, benötigen möglicherweise zusätzlich eine Application-Observability-Plattform.
2. Anodot
Anodot ist auf Business-KPI-Monitoring und Anomalieerkennung ausgerichtet. Der stärkste Anwendungsfall ist ein großer, sich verändernder Metrikbestand, in dem Teams relevante Abweichungen bei Umsatz-, Conversion-, Kosten-, Engagement-, Partner- oder Kanaldaten erkennen müssen, ohne für jede Metrik eine eigene statische Regel anzulegen.
Der unüberwachte Ansatz der Plattform lernt normale Muster über hochkardinale Business-Metriken hinweg. Das ist relevant für Organisationen, in denen derselbe KPI nach Produkt, Region, Kundengruppe, Kanal oder Partner segmentiert werden muss. Kontextbezogene Alerts und Root-Cause-Indikatoren helfen dabei, eine breite Umsatzbewegung von einem lokalen Vertriebs- oder Partnerproblem zu unterscheiden.
Anodot legt außerdem Wert auf Alerts mit Business-Impact, einschließlich Schätzungen der monetären Auswirkungen, und bietet Use-Case-Beschleuniger für Szenarien wie Echtzeit-Umsatzmonitoring. Das breite Ingestion-Modell kann Teams helfen, viele Signale zu zentralisieren und schnell Baselines aufzubauen.
Der wesentliche Unterschied zu digna liegt in Umfang und Ausführungsort. Anodot ist ein starker Kandidat, wenn das Hauptziel ein zentralisiertes, KI-gestütztes Monitoring von Business-Metriken ist. digna hebt sich stärker ab, wenn dasselbe Team Anomalieerkennung kombiniert mit Aktualität, Datensatzvalidierung und Schema-Monitoring innerhalb der eigenen Datenbanken benötigt. Teams, die Ansätze zur Anomalieerkennung vergleichen, können sich auch Anomalieerkennung in Zeitreihen als eigene Designfrage neben Dashboard-Alerts ansehen.
Anodot ist am sinnvollsten, wenn die Organisation bereits über einen breiten, zugänglichen Strom an KPI-Signalen verfügt und eine KI-Schicht zur Reduzierung von Alert-Rauschen sucht.
Die Preisgestaltung ist auf Unternehmen ausgerichtet, öffentliche Listenpreise gibt es kaum. Der Einkauf sollte daher Metrikvolumen, Ingestion-Muster, Aufbewahrung, Nutzer und benötigten Support modellieren, statt Lizenz-Schlagzeilen zu vergleichen. Die Implementierung ist relativ leicht, wenn die Organisation ihre Signale streamen oder zentralisieren kann, aber weniger attraktiv, wenn sensible Daten die Kundenumgebung nicht verlassen dürfen oder wenn Validierung an der Quelle die Hauptanforderung ist.
Im Finanzwesen kann Anodot helfen, Umsatzverluste und Kostenveränderungen sichtbar zu machen. Im Gesundheitswesen sollten Governance-Teams Datenverarbeitung, Zugriffskontrollen und zulässige Signalbewegungen prüfen, bevor klinische oder operative Metriken angebunden werden. Telekommunikationsunternehmen mit großen, segmentierten KPI-Beständen können vom hochkardinalen Ansatz profitieren, sofern die Plattform die benötigten Daten unter akzeptabler Kontrolle erhalten kann.
3. ThoughtSpot
ThoughtSpot nähert sich dem Business Monitoring von der gesteuerten BI- und Self-Service-Analytics-Ebene. Mit dem KPI Monitor können Fachanwender wichtige Metriken abonnieren, Anomalie- oder Schwellenwert-Alerts erhalten und Veränderungen über Kanäle wie Slack, Microsoft Teams, E-Mail und mobile Benachrichtigungen verfolgen.
Damit passt ThoughtSpot gut zu Stakeholdern, die nicht ständig ein Dashboard öffnen möchten, um die Performance zu prüfen. SpotIQ und Spotter können Metrikveränderungen und mögliche Treiber aufzeigen, während gesteuerte Datenquellen einen konsistenten analytischen Kontext liefern. Besonders nützlich ist die Plattform, wenn das Unternehmen seine BI-Umgebung bereits als offiziellen Ort für KPI-Definitionen nutzt.
Die Einschränkung ist grundlegender Natur. ThoughtSpot-Alerts hängen von einer gut modellierten, gesteuerten Datenschicht innerhalb der Plattform ab. Ist die zugrunde liegende Tabelle verspätet, fehlerhaft oder von Schema Drift betroffen, kann ein sauber wirkender KPI-Monitor dennoch ein unvollständiges Ergebnis melden. ThoughtSpot kann einem Nutzer sagen, dass sich eine gesteuerte Metrik bewegt hat, ist aber nicht in erster Linie ein System für Datenaktualität oder Datensatzvalidierung.
Diese Unterscheidung ist in regulierten Umgebungen wichtig. Ein Finanzteam möchte vielleicht Alerts zu einer gesteuerten Risiko- oder Umsatzmetrik, während Data-Governance-Teams separat Nachweise benötigen, dass die Quelle rechtzeitig geliefert wurde und die Geschäftsregeln erfüllt. Teams im Gesundheitswesen sollten festlegen, wem das semantische Modell gehört und wer Alerts mit sensiblem Kontext verteilen darf. Telekommunikationsteams schätzen womöglich den Collaboration-Workflow, sollten aber testen, ob hochdimensionale operative Metriken im BI-Modell nutzbar bleiben.
Wo die BI-Grenze funktioniert
Die Stärke von ThoughtSpot ist die Akzeptanz im Fachbereich. Ein Stakeholder kann einen KPI in derselben Umgebung verfolgen, die er für Suche und Analyse nutzt, und sich bei einer Veränderung in einem Collaboration-Kanal abstimmen. Sehen Sie sich Self-Service Analytics als gegensätzliche Anforderung an, wenn Analysten Anomalien auf der zugrunde liegenden Datenebene untersuchen müssen, statt nur gesteuerte Metriken zu konsumieren.
Die Preisgestaltung ist auf Großunternehmen ausgerichtet, und die Plattform ist für kleine Teams in der Regel keine günstige Wahl. Der Implementierungsaufwand konzentriert sich auf semantische Modellierung, Berechtigungen, Metrik-Ownership und Alert-Design. Für Finanz- und Gesundheitswesen ist diese Governance-Arbeit ein Vorteil, wenn sie gründlich erledigt wird. Für Teams, die Observability auf Quellebene suchen, kann sie zu einer Abhängigkeit werden, die den Nutzen verzögert.
4. Splunk Observability Cloud
Splunk Observability Cloud bedient die Grenze zwischen Gesundheit von Geschäftsprozessen und Anwendungstelemetrie. Business Journeys und APM Business Workflows helfen Teams, mehrstufige Prozesse wie Checkout, Onboarding oder andere Customer Flows den Services zuzuordnen, die sie ausführen.
Am wertvollsten ist die Plattform, wenn eine Organisation eine kausale Frage beantworten muss: Ein Geschäftsprozess verschlechtert sich, welcher Service, welche Abhängigkeit oder welche Transaktion ist verantwortlich? Splunk kombiniert Logs, Metriken und Traces, während APM hochkardinale Analysen und ungesampelte Traces für tiefere Diagnosen unterstützt. Individuelle Dashboards und Alerts können Business-Meilensteine mit der Service-Gesundheit verknüpfen.
Das ist ein anderes Angebot als KPI-Monitoring auf Quellebene. Splunk kann zeigen, dass eine Checkout-Journey fehlschlägt, und Engineers helfen, den Fehler durch die Anwendungskomponenten zu verfolgen. Es ersetzt keine Data-Observability-Plattform, die Datensätze im Data Warehouse validiert, die erwartete Lieferung von Datensätzen überwacht oder einen geänderten Spaltenvertrag erkennt, bevor das nachgelagerte Reporting bricht.
Technische Tiefe versus operativer Aufwand
Splunk passt gut zu Unternehmen, in denen Engineering- und Datenteams bereits rund um die Anwendungszuverlässigkeit zusammenarbeiten. Ungesampeltes Tracing kann wertvolle Belege liefern, wenn eine KPI-Verschlechterung eine technische Ursache hat. Die Breite an Logs, Metriken, Traces, Dashboards und Workflows erhöht jedoch auch die Anforderungen an Implementierung und Governance.
Organisationen, die Alternativen zu Splunk in Betracht ziehen, sollten zwei Kaufentscheidungen trennen. Ist das Hauptproblem die Diagnose von Anwendungen und Services, ist die technische Tiefe von Splunk relevant. Sind es auffällige Geschäftsdaten in einem regulierten Data Warehouse, ist der vollständige Observability-Stack womöglich mehr, als das Team braucht.
Preis und Deployment-Komplexität können für reines KPI-Monitoring hoch sein. Finanzteams profitieren, wenn Umsatzprozesse von vielen Services und Transaktionspfaden abhängen. Organisationen im Gesundheitswesen sollten Trace-Inhalte, Aufbewahrung, Identitätskontrollen und die Frage prüfen, ob sensibler Anwendungskontext in operativen Workflows offengelegt wird. Telekommunikationsteams mit verteilten Customer Journeys können das Mapping von Geschäftsprozessen wertvoll finden, besonders wenn Anwendungsgesundheit und Kundenerlebnis gemeinsam untersucht werden müssen.
5. Datadog
Datadog ist eine breite Observability-Plattform für Engineering- und SRE-Teams, die benutzerdefinierte Business-Metriken mit Anwendungen, Infrastruktur, Logs und Traces korrelieren müssen. Monitore können eigene KPIs verfolgen, während Watchdog Anomalie-Insights und kontextbezogene Unterstützung bei der Ursachenanalyse liefert.
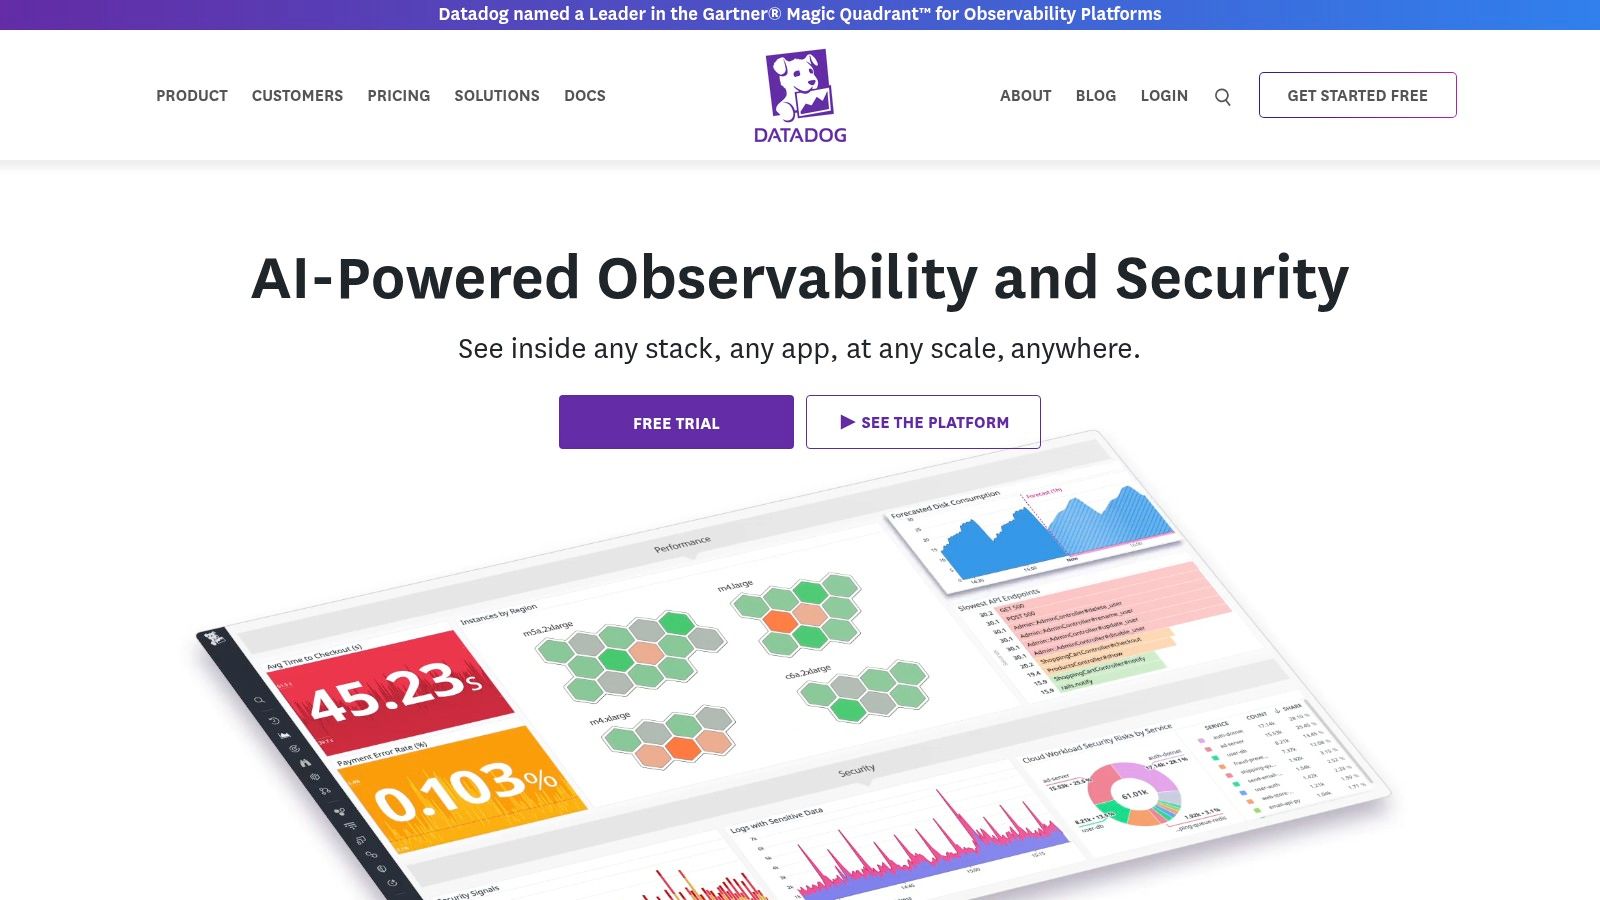
Der Wert der Plattform entsteht durch Korrelation. Ein Team kann eine Business-Metrik neben die Service-Performance stellen, eine Zeitreihen-Anomalie untersuchen und einen Alert über PagerDuty, Slack, E-Mail oder einen anderen operativen Kanal weiterleiten. Forecasting und Dashboard-Analysen ergänzen das Echtzeit-Monitoring um Planungskontext.
Datadog ist daher am stärksten, wenn Business-KPIs direkt vom Verhalten von Anwendungen oder Infrastruktur abhängen. Eine steigende Rate fehlgeschlagener Zahlungen kann es beispielsweise erfordern, Anwendungsfehler, Datenbanklatenz und Infrastrukturänderungen in einem Workflow zu untersuchen. Teams, die dagegen die Qualität von Geschäftsdaten überwachen, benötigen möglicherweise eine separate Lösung für Validierung auf Datensatzebene, Schema-Verträge und erwartete Datenlieferungen.
Datadog kann Kontextwechsel reduzieren, aber keine Metrikbedeutung automatisch erzeugen. Tags, Ownership, Dimensionen und Alert-Schwellenwerte brauchen weiterhin Governance.
Die Preisgestaltung ist einer der zentralen Bewertungspunkte. Die Kosten können bei vielen Custom Metrics, Telemetrie-Ingestion, Aufbewahrung, Hosts und Integrationen komplex werden. Das kommerzielle Modell belohnt sorgfältiges Scoping, doch schlechtes Tagging und unkontrollierte Metrikerstellung können sowohl finanzielle Verschwendung als auch Alert-Rauschen erzeugen.
Finanzteams sollten testen, ob sensibler Transaktionskontext sicher in Telemetrie abgebildet werden kann. Teams im Gesundheitswesen brauchen strikte Kontrollen über Attribute und Logs. Telekommunikationsteams profitieren möglicherweise vom Integrationsökosystem und der Skalierbarkeit des operativen Monitorings, besonders wenn Kunden-KPIs und Netzwerkservices bereits von Engineering-Teams verwaltet werden. Sehen Sie sich Echtzeit-Datenmonitoring an, wenn die Anforderung stattdessen darin besteht, Datenankunft und Datenverhalten innerhalb der Datenplattform zu überwachen.
6. New Relic
New Relic kombiniert Full-Stack-Observability mit einem Business-Observability-Ansatz. Teams können eigene Business-Events und Attribute senden, sie mit NRQL abfragen, KPI-Dashboards erstellen und Alerts auf Basis von Schwellenwerten oder gelernten Baselines konfigurieren.
Der zentrale Vorteil ist die Konsolidierung. Anwendung, Infrastruktur, Logs, User Experience und Business-Kontext lassen sich über eine einzige Telemetrie-Plattform abfragen. Vorgefertigte Quickstarts, darunter E-Commerce-orientierte Workflows, können den Weg von der Instrumentierung zu einer ersten Business-Sicht verkürzen. Developer-Tooling und öffentliche Dokumentation unterstützen zudem Teams, deren Engineers eigene Business-Attribute definieren sollen.
Der Tradeoff: New Relic funktioniert am besten, wenn die Organisation bereit ist, diese Attribute sorgfältig zu modellieren. Ein Business-KPI ist nur nützlich, wenn Event-Namen, Dimensionen, Identität, Zeitstempel und Ownership konsistent sind. Dieser Modellierungsaufwand liegt beim Kunden, und erweiterte Funktionen können von der gewählten Edition abhängen.
Das verbrauchsbasierte Preismodell von New Relic und der Einstieg über eine kostenlose Stufe unterstützen eine schrittweise Einführung. Diese Flexibilität ist nützlich für ein Team, das eine Anwendung oder einen Workflow pilotiert, dennoch sollten Käufer Telemetrievolumen, Aufbewahrung, Custom Events und Wachstum prognostizieren. Die scheinbare Einfachheit eines kleinen Starts macht Nutzungskontrollen nicht überflüssig.
Eignung nach Monitoring-Ebene
Im Finanzwesen ist New Relic eine plausible Wahl, wenn Transaktionsergebnisse durch Services hindurch nachverfolgt werden müssen. Teams im Gesundheitswesen sollten klären, ob eigene Attribute geschützte Informationen enthalten und wie der Zugriff segmentiert ist. Telekommunikationsunternehmen können New Relic dort einsetzen, wo Kundenerlebnis und Service-Performance eine gemeinsame Telemetrie-Basis haben.
Weniger geeignet ist es als einzige Plattform, wenn Business Monitoring direkt in der Datenbank mit Validierung, Aktualität und Schema-Tracking gefordert ist. Der Vergleich mit New Relic sollte sich daher auf die kontrollierte Grenze konzentrieren und nicht nur darauf, ob beide Produkte Anomalie-Alerts bieten.
7. Tableau Pulse
Tableau Pulse bringt KI-gestütztes KPI-Monitoring in das Tableau-Ökosystem. Es zeigt Veränderungen, Trends und kontextbezogene Erklärungen proaktiv über Zusammenfassungen und Digests an, mit Zustellung unter anderem über Slack und E-Mail.
Das Produkt richtet sich an Fachverantwortliche, die relevante KPI-Updates in ihrem täglichen Workflow erhalten möchten, statt ein weiteres Dashboard aufzurufen. Den größten Nutzen bietet es, wenn Tableau Cloud bereits der BI-Standard der Organisation ist und gesteuerte Metriken zur Interpretation durch Pulse verfügbar sind.
Diese Abhängigkeit definiert zugleich die Grenze. Tableau Pulse macht aus einem ungesteuerten Data Warehouse kein verlässliches Monitoring-System. Die Qualität des narrativen Kontexts und die Nützlichkeit der Alerts hängen von Datenmodellierung, Metrikdefinitionen, Berechtigungen und der eingesetzten Tableau-Cloud-Edition ab. Verfügbarkeit und Funktionstiefe können je nach Edition variieren, daher sollte der Einkauf die konkrete Konfiguration prüfen, statt sich auf eine allgemeine Produktbeschreibung zu verlassen.
Im Finanzwesen kann Tableau Pulse die Verteilung freigegebener Management-Kennzahlen verbessern, sofern sich Finanz- und Data-Governance-Teams auf Definitionen und Empfänger einigen. Organisationen im Gesundheitswesen sollten prüfen, wie Zusammenfassungen mit sensiblen Dimensionen umgehen und ob die Alert-Empfänger angemessen eingeschränkt sind. Telekommunikationsteams schätzen womöglich den täglichen Strom an Business-Updates, für die Diagnose operativer Services braucht es aber in der Regel eine Application- oder Netzwerk-Observability-Ebene.
Die Preisgestaltung kann komplex werden, wenn Tableau-Lizenzen, Cloud-Editionen, Governance und Nutzerzugriffe zusammen betrachtet werden. Die Implementierung ist in einer bestehenden Tableau-Landschaft moderat und deutlich aufwendiger für Teams, die zunächst ihr Metrikmodell standardisieren müssen. Es ist eine starke BI-zentrierte Monitoring-Option, aber kein Ersatz für Anomalie-, Validierungs- oder Aktualitätskontrollen auf Quellebene.
8. Looker Google Cloud
Looker bietet Business Monitoring über ein gesteuertes BI-Modell, das mit LookML aufgebaut wird. Alerts können auf Zeitreihen- oder kategorialen Ergebnissen laufen, Schwellenwerte nutzen und Benachrichtigungen per E-Mail oder Slack zustellen. Öffentliche und private Alert-Optionen helfen Organisationen, die Sichtbarkeit zu steuern.
Das zentrale Unterscheidungsmerkmal ist die semantische Governance. LookML gibt Teams eine versionierte Möglichkeit, Business-Metriken, Dimensionen, Joins und Zugriffsregeln zu definieren. Diese Struktur kann eine verlässliche Single Source of Truth für KPI-Alerts schaffen, besonders in Organisationen, in denen verschiedene Abteilungen Umsatz, Marge, Auslastung oder Kundenaktivität sonst unterschiedlich berechnen.
Looker erfordert Modellierungsdisziplin und LookML-Know-how. Ein Alert kann technisch korrekt konfiguriert und operativ dennoch schwach sein, wenn das Modell mehrdeutige Joins, unvollständige Filter oder unklare Ownership aufweist. Einige Slack-Funktionen erfordern zudem eine Workspace-Konfiguration durch Administratoren, daher gehört die Integrationsbereitschaft in den Implementierungsplan.
Ein gesteuerter Alert ist kein Data Contract
Looker eignet sich gut für Finanzteams, die konsistente Metrikdefinitionen über Reporting und Alerting hinweg benötigen. Organisationen im Gesundheitswesen profitieren möglicherweise von berechtigungsabhängiger Zustellung und kontrolliertem Zugriff auf gesteuerte Explores, müssen aber weiterhin die zugrunde liegenden Datenkontrollen bewerten. Telekommunikationsteams können Looker für standardisierte kommerzielle und operative KPIs nutzen, während separate Plattform-Tools Pipelines und Infrastruktur überwachen.
Das Preismodell ist an das breitere Google-Cloud- und Looker-Deployment gekoppelt. Käufer sollten daher Lizenzen, Modellentwicklung, Administration und Warehouse-Verbrauch gemeinsam bewerten. Die Implementierung ist aufwendiger als ein einfacher Dashboard-Alert, weil die semantische Schicht Teil des Produktnutzens ist.
Looker ist eine gute Wahl, wenn vertrauenswürdiger Metrikkonsum Priorität hat. Als alleiniges Tool ist es nicht richtig, wenn Teams KI-basiertes Baseline-Lernen auf Rohdaten, Datensatzvalidierung, Schätzungen erwarteter Lieferzeiten oder kontinuierliche Erkennung von Schema-Änderungen benötigen.
9. Amplitude
Amplitude ist eine Product-Analytics-Plattform zur Überwachung von Nutzerverhalten, Produkt-KPIs und Growth-Funnels. Anomalieerkennung, Forecasting, KPI-Monitore und Root-Cause-Analyse sind für Metriken wie Daily Active Users, Conversion, Retention und andere Produkt- oder Engagement-Kennzahlen ausgelegt.
Die Monitoring-Grenze von Amplitude ist das Produkterlebnis. Teams können Veränderungen in Zeitreihen-Metriken mit Konfidenzintervallen erkennen, Slack- oder E-Mail-Alerts konfigurieren und Treiber über Verhaltenssegmente und Funnel-Analysen untersuchen. KI-gestütztes Charting erleichtert es Produktteams, Monitore zu erstellen, ohne vollständig auf Analytics Engineers angewiesen zu sein.
Dieser Fokus verschafft Amplitude bei Produkt- und Wachstumsfragen einen praktischen Vorteil gegenüber allgemeinen Observability-Tools. Ein Produktmanager kann untersuchen, ob eine Conversion-Veränderung mit einem Funnel-Schritt, einer Gerätegruppe, einer Release-Kohorte oder einem Nutzungsmuster zusammenhängt. Derselbe Workflow ist nicht dafür gedacht, Warehouse-Aktualität, Application Traces, Netzwerkgesundheit oder regulatorische Datenkontrollen zu überwachen.
Amplitude bietet kostenlose und Plus-Stufen für Pilotprojekte, während höhere Volumen und erweiterte Funktionen Käufer zu Growth- oder Enterprise-Vereinbarungen führen. Teams sollten Event-Volumen, Aufbewahrung, Lizenzplätze und die einbezogenen Produktbereiche modellieren. Ein Pilot mag leicht zugänglich sein, doch ein unternehmensweiter Rollout erfordert weiterhin Instrumentierungsstandards und Event-Governance.
Im Finanzwesen ist Amplitude für digitale Kundengewinnung, Conversion und Customer Journeys relevant, nicht für zentrale Finanzkontrollen. Organisationen im Gesundheitswesen sollten die Event-Erfassung sorgfältig prüfen, insbesondere wenn sich Rückschlüsse auf Patienten oder klinisches Verhalten ziehen lassen. Telekommunikationsteams können damit Self-Service, Onboarding, Tarifauswahl und digitale Kundenbindung überwachen, Netzwerk- und Abrechnungsbetrieb brauchen jedoch ergänzendes Monitoring.
Nutzen Sie Amplitude, wenn die Frage lautet „Wie bewegen sich Nutzer durch das Produkt?“ Nutzen Sie Data Observability, wenn die Frage lautet „Können wir dem Datensatz hinter dem KPI vertrauen?“
10. Qlik Qlik Cloud und Qlik Alerting
Qlik Cloud und Qlik Alerting verbinden Analytics mit Benachrichtigungen auf Basis von Datenbedingungen, Ausreißern und Anomalien. Die Plattform unterstützt Daten-, System- und Broadcast-Alerts, während Qlik Automations Benachrichtigungen an Slack, Teams und andere Systeme weiterleiten kann.
Qlik ist am stärksten für Organisationen, die auf Qlik Cloud Analytics standardisieren und gesteuerte Erkenntnisse flexibel verteilen müssen. Komplexe Alert-Bedingungen ermöglichen operative Anwendungsfälle jenseits einfacher Schwellenwertprüfungen, während berechtigungsabhängige Zustellung die Benachrichtigungen an die Nutzerzugriffe anpasst.
Der Deployment-Unterschied ist wichtig. Die Funktionen von Qlik Cloud und das On-Premises-Produkt Qlik Alerting für Windows sind nicht identisch. Unternehmen mit hybriden Landschaften sollten daher editionsspezifisches Verhalten, Administration, Konnektivität und Alert-Ownership prüfen, bevor sie sich für eine Architektur entscheiden.
Qlik nutzt kapazitätsbasierte Qlik-Cloud-Pläne, die Alerting enthalten. Das kann es erleichtern, das kommerzielle Modell an einem breiteren Analytics-Deployment auszurichten, doch Käufer müssen Datenvolumen und Nutzung einplanen. Ein Kapazitätsmodell kann zudem die Kostenzuordnung erschweren, wenn viele Teams dieselbe Umgebung teilen.
Finanzteams können Qlik nutzen, um gesteuerte Performance- und Risikokennzahlen zu verteilen. Organisationen im Gesundheitswesen sollten das Berechtigungsverhalten mit realistischen Rollenstrukturen und Klassifizierungen sensibler Daten testen. Telekommunikationsunternehmen profitieren von flexiblen Alerts über kommerzielle, operative und Service-Datensätze hinweg, auch wenn Validierung auf Quellebene und Pipeline-Aktualität eine ergänzende Plattform erfordern können.
Die Implementierung ist moderat, wenn Qlik bereits etabliert ist, und anspruchsvoller, wenn Teams Datenmodell, Automations und Alert-Administration gleichzeitig einführen. Qlik eignet sich gut für analytics-zentriertes Alerting. Als eigenständiger Ersatz für Application Traces oder Data Observability direkt in der Datenbank ist es weniger geeignet.
Die 10 besten Business-Monitoring-Lösungen im Funktionsvergleich
Lösung / Anbieter | Kernfunktionen ✨ | Nutzen / USP 🏆 | Qualität / UX ★ | Zielgruppe 👥 | Preis / Wert 💰 |
|---|---|---|---|---|---|
Solutions - Business Monitoring (digna) | ✨ KI-gestützte Anomalieerkennung, Timeliness, Datensatzvalidierung, Schema-Tracking, Ausführung in der Datenbank | 🏆 Läuft in der Kundeninfrastruktur + einheitliche Observability für KPIs & Incidents | ★★★★☆ Gemeinsame Oberfläche, schneller Time-to-Value (<2 Std.) | 👥 Daten- und Analytics-Teams in Unternehmen; regulierte Branchen | 💰 Modular: Grundgebühr + pro aktiver Tabelle; transparent, stabil bei der Nutzung |
Anodot | ✨ Unüberwachte KI-Anomalieerkennung für hochkardinale KPIs; schnelles Baseline-Lernen | 🏆 Starke KPI-fokussierte Erkennung mit Signalen zum monetären Impact | ★★★★☆ Wenige False Positives; schnell im großen Maßstab | 👥 Umsatz-, Betriebs- und Finanzteams, die KPI-Alerts in Echtzeit brauchen | 💰 Enterprise-Preise (kaum öffentliche Listenpreise) |
ThoughtSpot | ✨ KPI-Monitore, SpotIQ/Spotter AI, Alerts über Slack/Teams/Mobil | 🏆 Suchbasierte BI + proaktive KPI-Alerts für Fachanwender | ★★★★ Alerts einfach abonnierbar; fachbereichsfreundliche UX | 👥 Fachverantwortliche und Analysten | 💰 Enterprise-orientierte Lizenzierung |
Splunk Observability Cloud | ✨ Business Journeys, APM, Korrelation von Logs/Metriken/Traces | 🏆 Korreliert technische Telemetrie mit End-to-End-Geschäftsprozessen | ★★★★ Robuste Diagnose; komplexe Oberfläche für Nicht-Engineering-Teams | 👥 Engineering + Business Operations in Großunternehmen | 💰 Hohe Kosten/Komplexität für reine KPI-Anwendungsfälle |
Datadog | ✨ Flexible Metrik-Monitore, Watchdog-Anomalie-Engine, umfangreiche Integrationen | 🏆 Ausgereiftes Alerting und Korrelation über Telemetriearten hinweg | ★★★★ Skalierbare Alerts; braucht Governance gegen Rauschen | 👥 SRE- und Engineering-Teams (können Business-Metriken abbilden) | 💰 Nutzungsbasiert; kann bei hoher Ingestion teuer werden |
New Relic | ✨ Custom Metrics/Events, NRQL-Abfragen, einheitliche Telemetrie | 🏆 Eine Telemetrie-Plattform mit optional verbrauchsbasierter Preisgestaltung | ★★★★ Gutes Developer-Tooling; flexible NRQL-Dashboards | 👥 DevOps, SRE und Teams, die eigene KPIs verfolgen | 💰 Verbrauchsbasierte Preise; Einstieg über kostenlose Stufe |
Tableau Pulse | ✨ KI-gestützte KPI-Digests/Alerts, Push in Collaboration-Tools, in Tableau integriert | 🏆 Bringt KPI-Monitoring in den Arbeitsalltag von BI-Nutzern | ★★★★ Fachbereichsfreundliche Zusammenfassungen; abhängig vom Tableau-Setup | 👥 Fachverantwortliche, die Tableau nutzen | 💰 Editionsabhängige Lizenzierung; kann komplex sein |
Looker (Google Cloud) | ✨ Gesteuerte Alerts auf Looks/Kacheln, LookML-Modellierung, Alerts per Slack/E-Mail | 🏆 Starke Governance / Single Source of Truth für KPIs | ★★★★ Verlässliches Alerting, wenn Metriken gut modelliert sind | 👥 Analytics-Teams & Metrik-Verantwortliche | 💰 Enterprise-Preise; erfordert LookML-Know-how |
Amplitude | ✨ Product-Analytics-KPIs, Anomalieerkennung, Forecasting, Root-Cause-Analyse | 🏆 Schnelle Operationalisierung von Produkt- und Growth-Metriken | ★★★★ Freundlich für Produktteams; gute Dokumentation | 👥 Produkt-, Growth- und Analytics-Teams | 💰 Free/Plus-Stufen → Growth/Enterprise-Preise |
Qlik (Qlik Cloud + Alerting) | ✨ Komplexe Alert-Logik, Automations zu Slack/Teams, governance-konforme Zustellung | 🏆 Flexible Verteilung und Alerting auf Enterprise-Niveau | ★★★★ Passt zu gesteuerten Qlik-Umgebungen; Admin-Setup erforderlich | 👥 Organisationen, die auf Qlik Cloud standardisiert haben | 💰 Kapazitätsbasierte Pläne; Volumen/Nutzung einplanen |
Wählen Sie die Monitoring-Grenze, die Sie kontrollieren müssen
Die richtige Business-Monitoring-Software hängt weniger von der Zahl der Dashboards, Integrationen oder KI-Labels ab als von der Grenze, die Ihr Team kontrollieren muss.
Wählen Sie digna, wenn Daten in der Kundenumgebung bleiben müssen und das Monitoring Business-Anomalien mit Validierung, Aktualität, Schema-Tracking und Plattform-Transparenz verbinden soll. Die Ausführung in der Datenbank, Deployment-Optionen in der Private Cloud und On-Premises, die gemeinsame Oberfläche und die modulare Struktur adressieren ein Problem, das BI-Alerts oft unberührt lassen: Der KPI kann falsch sein, weil die zugrunde liegenden Datensätze verspätet, unvollständig, strukturell verändert oder außerhalb des erwarteten Verhaltens sind. Aktualität sollte als Betriebsmodell verstanden werden, das Lieferzusagen, Frische, prognostizierte Ankunft, Fehlererkennung, Schwankungen und Diagnose auf Stufenebene umfasst, nicht als einfache Zeitstempelprüfung. Der Leitfaden von digna zur Datenaktualität beschreibt diesen umfassenderen Ansatz.
Wählen Sie eine BI-zentrierte Option wie ThoughtSpot, Tableau Pulse, Looker oder Qlik, wenn gesteuerter Metrikkonsum Priorität hat. Diese Plattformen sind wirksam, wenn Fachanwender proaktive Updates in Slack, Teams, E-Mail oder mobilen Workflows benötigen und die Organisation bereits ein vertrauenswürdiges semantisches Modell hat. Ihre Alerts sind nur so verlässlich wie Modell, Joins, Berechtigungen und Quelldaten darunter. Sie sollten nicht mit automatischen Data Contracts oder vollständiger Pipeline-Observability verwechselt werden.
Wählen Sie Application Observability wie Splunk Observability Cloud, Datadog oder New Relic, wenn KPI-Veränderungen bis zu Services, Infrastruktur, Logs, Requests und User Experience zurückverfolgt werden müssen. Diese Produkte sind wertvoll, wenn ein Transaktionsfehler, eine Latenzänderung oder eine Service-Abhängigkeit ein Geschäftsergebnis erklärt. Kosten und Implementierungsaufwand können mit Telemetrie, Custom Metrics, Aufbewahrung, Instrumentierung und Tagging steigen. Der Pilot sollte daher einen realistischen Incident und ein prognostiziertes Nutzungsmodell enthalten.
Wählen Sie Product Analytics wie Amplitude, wenn sich die zentrale Frage um Nutzerverhalten, Funnels, Conversion, Retention oder Produktakzeptanz dreht. Product Analytics kann erklären, welche Nutzer oder Journeys eine Veränderung ausgelöst haben, validiert aber allein keine Warehouse-Tabelle, erkennt keine geänderte Spalte und belegt nicht, dass ein regulierter Daten-Feed rechtzeitig angekommen ist.
Eine praxisnahe Bewertung sollte denselben repräsentativen Workflow in jeder Plattform der Shortlist testen. Im Finanzwesen eignet sich ein Umsatz-, Risiko- oder Transaktionsprozess. Im Gesundheitswesen ein klinischer, operativer oder regulatorischer Datensatz mit angemessenen Zugriffskontrollen. In der Telekommunikation ein Kunden-, Abrechnungs-, Service- oder hochvolumiger operativer Workflow. Prüfen Sie dann sechs Punkte:
Deployment: Läuft die Plattform dort, wo die Governance es verlangt, und verlassen Produktionsdaten die Umgebung?
Ownership: Kann das Team jeden Alert einer Person oder Betriebsgruppe mit definierter Reaktion zuweisen?
Datenmodellierung: Wie viel Aufwand ist nötig, um Metriken, Dimensionen, Lineage, Events und Geschäftsregeln zu definieren?
Integration: Erreichen Alerts die Systeme, die die Menschen nutzen, ohne doppelte Incidents zu erzeugen?
Kostentreiber: Skalieren die Kosten mit Tabellen, Metriken, Events, Nutzern, Kapazität, Telemetrie, Aufbewahrung oder Alert-Volumen?
Nachweise: Kann die Plattform zeigen, was sich geändert hat, wann es sich geändert hat, welche Daten oder welcher Service betroffen waren und wie das Team das Problem gelöst hat?
Schema Drift verdient besondere Aufmerksamkeit, weil es sich um eine Vertragsverletzung handelt und nicht nur um ein Problem der Wertqualität. Hinzugefügte oder entfernte Spalten, umbenannte Felder und geänderte Datentypen können nachgelagerte Konsumenten brechen, selbst wenn einzelne Zeilen gültig erscheinen. Unabhängige Leitlinien zu Schema Drift empfehlen, Schemas gegen eine erwartete Baseline oder vertragliche Definition zu validieren.
Die Größe des Marktes unterstreicht, wie wichtig eine Entscheidung ausgehend von der Monitoring-Grenze ist. Laut der Monitoring-Software-Schätzung von Dataintelo erreicht der Markt für Enterprise-Monitoring-Software 33,3 Milliarden USD im Jahr 2025 und soll bis 2034 auf 79,3 Milliarden USD wachsen, bei einer CAGR von 10,2 %, wobei BFSI mit 28,2 % im Jahr 2025 den größten Branchenanteil hielt. Diese Zahlen beschreiben eine breite Kategorie und sind kein Grund, die breiteste Plattform zu kaufen. Die beste Wahl ist diejenige, die den Fehlerfall kontrolliert, den Ihr Team sich nicht leisten kann zu übersehen.
digna bietet Business Monitoring innerhalb Ihrer eigenen Umgebung mit KI-gestützter Anomalieerkennung, Datenvalidierung, Timeliness-Tracking, Schema-Monitoring und Plattform-Observability für Data Warehouses, Data Lakes und Pipelines. Besuchen Sie digna, um zu prüfen, wie eine kontrollierte, modulare Monitoring-Grenze Finanzwesen, Gesundheitswesen, Telekommunikation und andere datensensible Bereiche unterstützen kann.
Die Auswahl eines Tools ist nur die halbe Arbeit: Sobald es läuft, muss das Monitoring selbst funktionieren. Unser Praxisleitfaden für den Betrieb eines Business-Monitoring-Systems zeigt, wie Sie über feste Schwellenwerte hinauskommen, KPI-Drift auf die Daten zurückführen, aus denen er entsteht, und Alert-Fatigue reduzieren, ohne echte Incidents zu übersehen.
Häufig gestellte Fragen
Was ist die beste Business-Monitoring-Software für regulierte Branchen?
Das hängt davon ab, welche Monitoring-Grenze Sie kontrollieren müssen. Wenn Produktionsdaten in Ihrer Umgebung bleiben müssen, führt digna die Metrikberechnung in Ihrer Datenbank aus, On-Premises, in einer Private Cloud oder VPC, und vereint KPI-Anomalieerkennung mit Aktualität, Validierung und Schema-Tracking in einer gemeinsamen Oberfläche.
Wie wird Business-Monitoring-Software bepreist?
Die Preismodelle unterscheiden sich je nach Anbieter deutlich. digna berechnet eine Grundgebühr plus aktive Tabellen pro Modul, während Datadog und New Relic mit Telemetrie und Custom Metrics skalieren, Qlik kapazitätsbasierte Pläne nutzt und Anodot sowie ThoughtSpot Enterprise-Lizenzen mit kaum öffentlichen Listenpreisen verkaufen. Modellieren Sie Ihre realen Volumen, bevor Sie Listenpreise vergleichen.
Können BI-Tools wie Tableau Pulse oder Looker das Datenmonitoring ersetzen?
Nein, nicht allein. Tableau Pulse, Looker, ThoughtSpot und Qlik alarmieren auf Basis gesteuerter Metriken, doch diese Alerts sind nur so verlässlich wie das Modell und die Quelldaten darunter. Eine verspätete, fehlerhafte oder von Schema Drift betroffene Tabelle kann trotzdem einen sauber wirkenden KPI-Alert erzeugen, der ein unvollständiges Ergebnis meldet.
Datadog vs. digna für Business-KPI-Monitoring: Was sollte ich wählen?
Wählen Sie Datadog, wenn eine KPI-Veränderung bis zu Services, Logs und Infrastruktur zurückverfolgt werden muss, etwa eine Rate fehlgeschlagener Zahlungen, die mit Datenbanklatenz zusammenhängt. Wählen Sie digna, wenn die Frage lautet, ob die Daten selbst rechtzeitig angekommen sind, ihre Struktur behalten und die Geschäftsregeln erfüllt haben. Manche Teams betreiben beide parallel.
Was sollte ich in einem Pilotprojekt für Business-Monitoring-Software testen?
Führen Sie denselben repräsentativen Workflow in jeder Plattform der Shortlist aus, etwa einen Umsatzprozess im Finanzwesen oder einen Abrechnungs-Workflow in der Telekommunikation. Prüfen Sie dann sechs Punkte: Deployment und Datenbewegung, Alert-Ownership, Aufwand für Datenmodellierung, Integrationen, Kostentreiber und ob das Tool nachweist, was sich geändert hat und wie es gelöst wurde.


