Datenmanagement in Banken: Ein Leitfaden für 2026
|
7
min. Lesezeit

Die wichtigsten Aufsichtsrahmenwerke definieren Datenmanagement in Banken über vier messbare Kontrolldimensionen: Genauigkeit, Integrität, Vollständigkeit und Aktualität. In der Praxis heißt das: Es geht nicht nur darum, Daten zu speichern, sondern nachzuweisen, dass sie bis in Risiko-, Finanz- und Reporting-Prozesse hinein verlässlich bleiben.
Banken, die das als Dokumentationsübung behandeln, verfehlen meist den Kern. Die eigentliche Arbeit steckt in operativen Kontrollen, Freshness-Checks, Abstimmungen, Data Lineage und Nachvollziehbarkeit entlang des gesamten Datenpfads, denn veraltete oder unvollständige Eingangsdaten verbreiten sich schnell, sobald sie in nachgelagerte Systeme gelangen.
Inhaltsverzeichnis
Zentrale Kontrolldimensionen, die Aufsichtsbehörden messen
Vier Kontrolldimensionen geben Aufsichtsbehörden ein praktisches Instrument, um die Datenqualität von Banken zu beurteilen: Genauigkeit, Integrität, Vollständigkeit und Aktualität. Von Banken wird erwartet, dass sie diese Dimensionen mit Governance, einer integrierten Datenarchitektur und messbaren Qualitätskontrollen verknüpfen, statt sie als bloße Richtlinienformulierungen stehen zu lassen (BDO). Die operativen Folgen sind unmittelbar. Ein verspäteter Feed kann die Risikoaggregation verzerren, ein fehlendes Feld eine Finanzkontrolle schwächen und ein inkonsistenter Datensatz Fehler in Reporting-Schichten tragen, die auf gemeinsame Daten angewiesen sind.
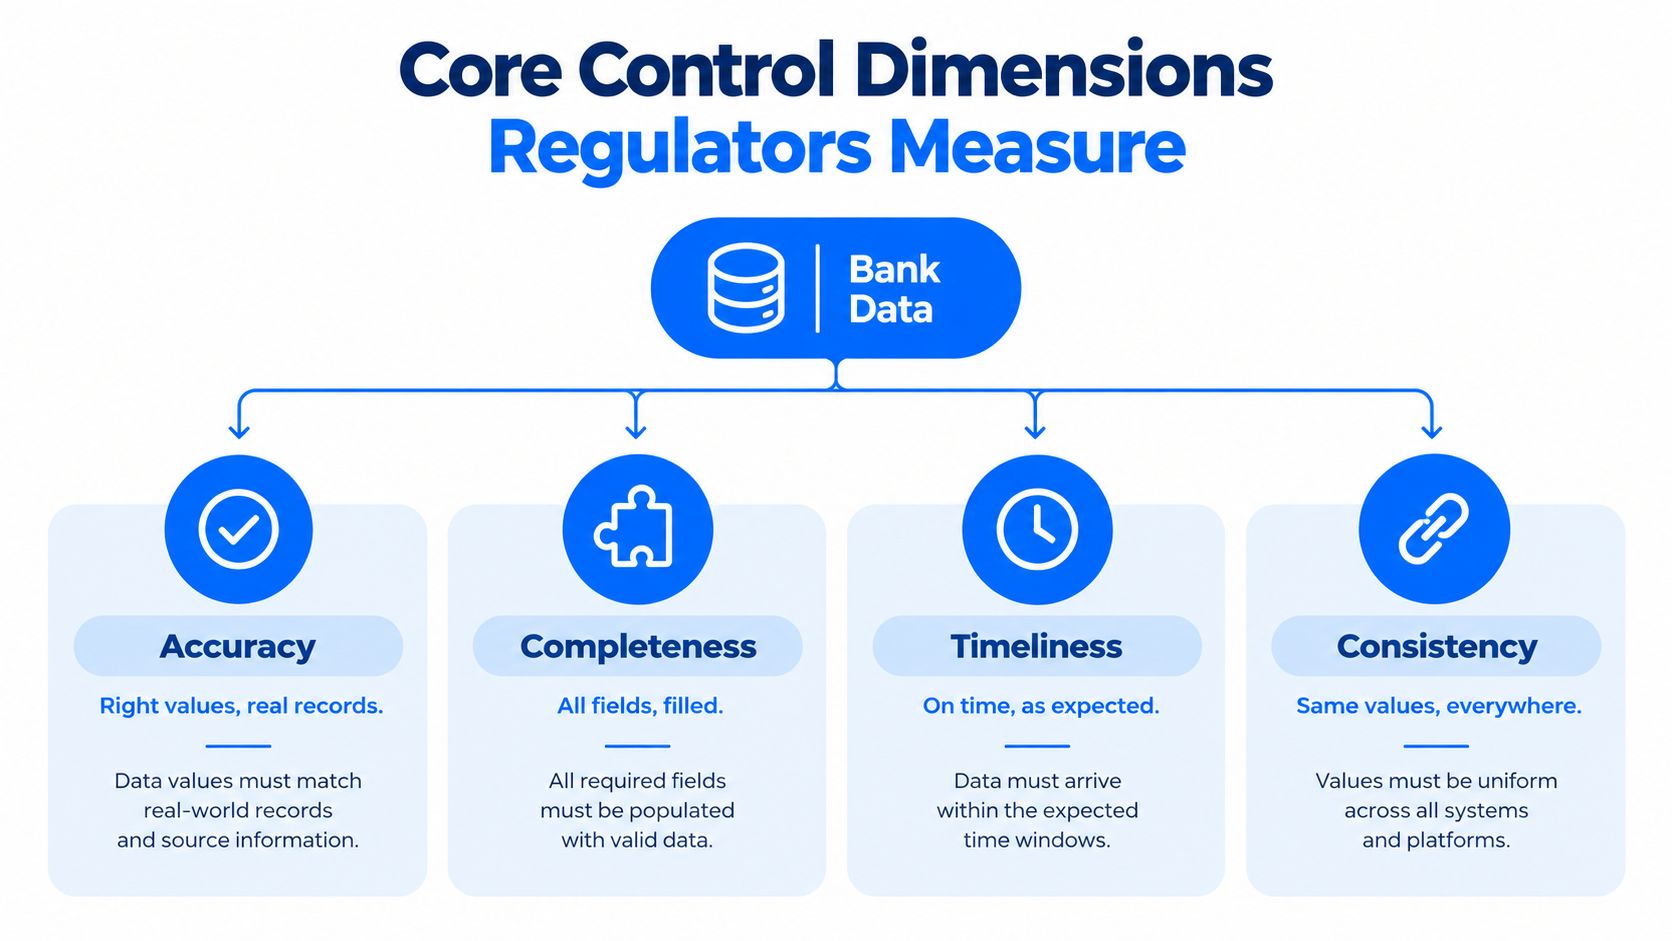
Was jede Kontrolldimension in der Praxis bedeutet
Genauigkeit bedeutet, dass Werte mit dem maßgeblichen Quelldatensatz übereinstimmen, den sie abbilden sollen. Für eine Bank heißt das: Salden, Kundenattribute, Klassifizierungen und Referenzdaten müssen mit dem freigegebenen System of Record übereinstimmen, nicht bloß mit einer Kopie im Data Warehouse, die womöglich schon veraltet ist.
Integrität bewahrt Beziehungen und Bedeutung, während Datensätze zwischen Systemen wandern. Dazu gehören gültige Schlüssel, lückenlose Audit Trails, kontrollierte Transformationen und einheitliche Definitionen. Ohne diese Kontrollen kann eine gemeldete Zahl zwar ihr Format behalten, aber die Bedeutung verlieren, die sie bei der Erfassung hatte.
Vollständigkeit umfasst die Felder, Datensätze und Attribute, die für eine fachliche oder regulatorische Kontrolle erforderlich sind. Ein Transaktions-Feed kann gesund wirken und trotzdem einen Pflichtbestandteil auslassen. Nachgelagerte Reports sehen dann fertig aus, verbergen aber eine wesentliche Lücke.
Aktualität erkennt Daten, die für ihren Verwendungszweck zu spät eintreffen. Eine Bank kann alle erforderlichen Datensätze besitzen, doch veraltete Eingangsdaten taugen weder für eine aktuelle Liquiditätsanalyse noch für Stresstests, Risikoaggregation oder das regulatorische Reporting.
Praxisregel: Behandeln Sie Freshness-Checks und Abstimmungen als operative Kontrollen, nicht als periodische Aufräumarbeiten.
Der EZB-Leitfaden zur effektiven Risikodatenaggregation und Risikoberichterstattung wendet dieselben Dimensionen an und fordert dafür detaillierte KPIs (EZB-Leitfaden). Ein nützlicher KPI zeigt mehr als nur, ob eine Regel bestanden wurde. Er sollte die betroffene Quelle, die Data Pipeline, den Owner, den nachgelagerten Report und den Zeitpunkt der Erkennung benennen.
Diese Unterscheidung legt die Lücke zwischen Kontrolldesign und Umsetzung offen. Eine Bank kann einen Freshness-Schwellenwert dokumentiert haben und einen ausgefallenen Feed dennoch erst bemerken, wenn ein Report zu spät kommt. Moderne Observability-Tools können Anlieferung, Schema-Änderungen, Volumenverschiebungen und Regelverstöße über die gesamte Pipeline hinweg überwachen. In-Database-Validierung kann Salden, referenzielle Beziehungen und Geschäftsregeln nah an den Daten prüfen, bevor sich Fehler ausbreiten.
Trennen Sie zunächst beschreibende Qualitätsprüfungen von Kontrollprüfungen. Beschreibende Regeln decken offensichtliche Anomalien auf. Kontrollregeln belegen, dass die Pipeline innerhalb definierter Erwartungen arbeitet, bevor Daten in Risiko-, Finanz- oder Reporting-Prozesse gelangen.
Verwenden Sie ein gemeinsames Vokabular für Prüfer, Engineers und fachliche Owner und verknüpfen Sie jede Regel mit einer geschäftlichen Konsequenz. Die Dimensionen der Datenqualität sind dafür ein hilfreicher Bezugspunkt. Datenmanagement in Banken wird zu einer operativen Disziplin, wenn Teams jede Dimension messen, Fehler bis zur Quelle zurückverfolgen und Nachweise für die Behebung liefern können.
Praxistaugliche Governance- und Ownership-Modelle
Gute Governance scheitert, wenn niemand ein Datenproblem von Anfang bis Ende verantwortet. Banken brauchen klare Ownership, eindeutige Eskalationswege und dokumentierte Lineage, damit Qualitätsmängel priorisiert und behoben werden, statt nur protokolliert und vergessen zu werden (Dunnixer). Genau das ist der praktische Unterschied zwischen einer Governance-Charta und einem funktionierenden Kontrollmodell. Die eine schafft Verantwortlichkeit auf dem Papier, das andere verändert, wie Incidents durch die Organisation laufen.
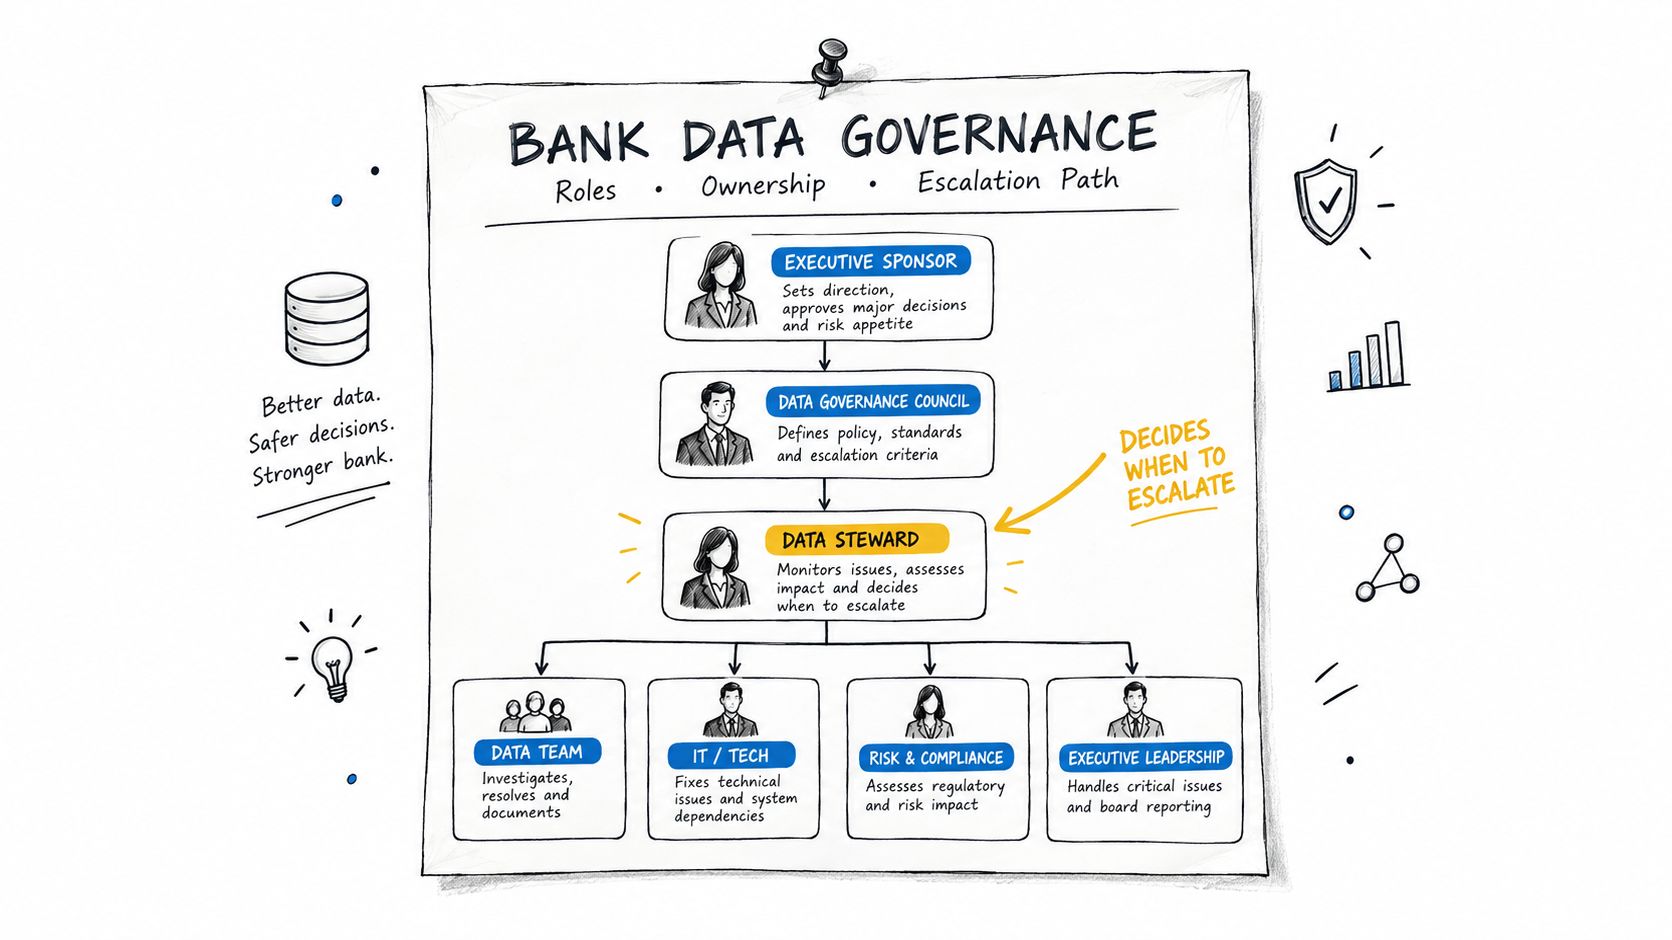
Wie funktionierende Ownership aussieht
Eine Bank braucht nicht mehr Gremien. Sie braucht benannte Owner für kritische Datendomänen, einen dokumentierten Eskalationsweg und ein gemeinsames Verständnis davon, was „behoben“ bedeutet. Fällt ein Referenzdaten-Feed aus, sollte der Data Steward wissen, wer die Triage übernimmt, wer die Korrektur freigibt und welche nachgelagerten Konsumenten informiert werden müssen.
Die stärksten Programme standardisieren außerdem kritische Definitionen. Wenn Kunde, Produkt, Exposure oder Saldo in verschiedenen Teilen der Bank Unterschiedliches bedeuten, wird jede Abstimmung schwieriger und jedes Audit dauert länger. Einheitliche Definitionen reduzieren Diskussionen über Semantik und lenken den Blick auf tatsächliche Fehler.
Ownership ist keine Berichtslinie. Sie ist die Verpflichtung, dafür zu sorgen, dass die Daten auch nach dem Meeting noch funktionieren.
Aus demselben Grund ist eine aktuelle Qualitäts-Baseline wichtig. Wenn niemand weiß, wie „normal“ aussieht, kann ein schleichender Drift wochenlang in Produktion bleiben, bevor es jemand bemerkt. Besonders gefährlich ist das in Banken mit heterogenen Landschaften, in denen Kernsysteme, Data Marts und Reporting-Schichten denselben Datensatz jeweils leicht anders interpretieren.
Unser Leitfaden zur Data Governance im Finanzbereich passt gut zu diesem Modell, denn Governance funktioniert nur, wenn sie Richtlinien, Stewardship und operatives Monitoring verbindet. In der Praxis organisieren die besten Banken die Kontrollverantwortung entlang des Datenpfads, nicht entlang vager Abteilungsgrenzen. Das bedeutet: Der Owner des Quellsystems, der Steward der fachlichen Definition und der Konsument des Reports haben jeweils klar definierte Pflichten.
Das Fehlermuster, das es zu vermeiden gilt
Das typische Fehlermuster ist einfach. Ein Qualitätsproblem wird protokolliert, aber niemand hat die Befugnis, die Quelle zu korrigieren, also baut das Team nachgelagert einen Workaround. Der Workaround hält den Report am Laufen, verdeckt aber das ursprüngliche Problem und schafft ein zweites in der Lineage.
Deshalb muss Governance Eskalation einschließen. Trifft ein Fehler einen regulatorischen Datensatz, sollte das Problem nicht auf den monatlichen Review-Zyklus warten. Es sollte einen definierten Weg durchlaufen, der Maßnahmen, Nachweissicherung und klare Verantwortung für die Nachverfolgung auslöst.
Banken, denen das gelingt, verlassen sich nicht auf Heldentaten. Sie setzen auf klare Rollen, einheitliche Definitionen und die Disziplin, Qualitätsprobleme als operative Incidents zu behandeln, nicht als administratives Rauschen.
BCBS-239-Anforderungen und Compliance-Architektur
BCBS 239 bleibt der Maßstab, weil es die Risikodatenaggregation mit den Erwartungen der Aufsicht verbindet. Das Rahmenwerk definiert 14 Grundsätze für eine effektive Risikodatenaggregation und Risikoberichterstattung und hilft Banken, genaue, zeitnahe und vollständige Risikoinformationen zu erzeugen, auch in Stressphasen (BIZ). Seine Anforderungen reichen weit über das Reporting-Team hinaus. Sie prägen Governance, Architektur, Kontrolldesign und die Fähigkeit der Bank, Risikoinformationen über Rechtseinheiten und Geschäftsbereiche hinweg konsistent zu aggregieren.
Dimension | Anforderung | Operative Auswirkung |
|---|---|---|
Aggregation | Risikodaten weitgehend automatisiert erzeugen, um Fehler zu reduzieren | Weniger manuelle Eingriffe, weniger Umwandlungsfehler, schnellere Erstellung |
Abdeckung | Daten über alle relevanten Geschäftsbereiche, Rechtseinheiten, Anlageklassen, Regionen und Gruppierungen verfügbar machen | Klarere Sicht auf Exposures, Konzentrationen und neu entstehende Risiken |
Lineage | Daten von der Erfassung bis zum finalen Reporting nachverfolgen, einschließlich Rückverfolgbarkeit auf Attributebene | Bessere Prüfbarkeit und schnellere Eingrenzung von Fehlern |
Automatisierung ist wichtig, weil jede manuelle Übergabe eine weitere Fehlerquelle schafft. Mitarbeitende können Werte falsch abtippen, eine Einreichung verzögern oder Tabellenkalkulationslogik anwenden, die nie Teil des formalen Kontrolldesigns wird. Automatisierte Workflows reduzieren diese Fehlerquellen, ersetzen aber keine Kontrollverantwortung. Sie machen definierte Kontrollen im großen Maßstab wiederholbar und messbar.
Die Abdeckung ist ein eigener Architekturtest. Die Risikoaggregation muss das Institut als Ganzes abbilden, einschließlich relevanter Rechtseinheiten, Regionen, Anlagegruppen und Reporting-Sichten. Fehlt einer dieser Bereiche, hat die Bank am Ende zwar einen ausgefeilten Report, aber ein unvollständiges Risikobild. Das Design braucht daher einen klar definierten Scope, Einschlussregeln und Prüfungen, die fehlende Grundgesamtheiten vor dem Reporting erkennen.
Lineage ist die Nachweisebene. Die mit BCBS 239 verbundenen Aufsichtsleitlinien betonen die Rückverfolgbarkeit von der Datenerfassung bis zum finalen Reporting, einschließlich der Möglichkeit, einzelne Attribute zu verfolgen (EY). Ein Lineage-Diagramm allein beweist nicht, dass die Kontrolle funktioniert. Teams brauchen Ausführungsnachweise, die den Quellwert, jede Transformation, das Validierungsergebnis und die Report-Ausgabe zeigen.
Der EZB-Leitfaden ergänzt operative Details, indem er von Banken verlangt, KPIs zur Überwachung der Datenqualitätsdimensionen festzulegen. Damit verschiebt sich die Compliance-Architektur von statischer Dokumentation hin zu kontinuierlicher Beobachtung. Moderne Observability-Tools können Freshness-, Volumen-, Schema- und Regelverstöße über fragmentierte Pipelines hinweg sichtbar machen, während In-Database-Validierung Datensätze nah an dem Punkt prüft, an dem sie erzeugt oder geändert werden.
Details zur Umsetzung finden Sie im Leitfaden zur Erfüllung der BCBS-239-Grundsätze mit KI-gestützter Datenqualität.
Operativer Test: Wenn sich eine Risikokennzahl ändert, sollte das Team ihre Quelle, Transformationen, Validierungskontrollen und Nachweise ohne manuelle Rekonstruktion benennen können.
Banken bezeichnen eine teilweise Kontrollabdeckung oft als BCBS-239-Abdeckung. Der Unterschied ist wichtig. Lücken in Lineage, Automatisierung oder institutsweitem Scope können verborgen bleiben, bis Stress das Reporting-Volumen erhöht oder inkonsistente Daten offenlegt. Eine resiliente Architektur sollte diese Lücken durch Monitoring sichtbar machen, statt darauf zu warten, dass eine aufsichtliche Prüfung oder ein Reporting-Vorfall sie aufdeckt.
Warum Kontrollen ohne Verantwortung an der Quelle scheitern
Das Frustrierende am Datenmanagement in Banken ist, dass Kontrollen auf dem Papier stark wirken und in Produktion trotzdem versagen können. Eine europäische Studie zum regulatorischen Reporting aus dem Jahr 2025 ergab, dass 90% der Banken mindestens drei Datenqualitätskontrollen und 66% eine zentralisierte Datenarchitektur hatten, aber nur 18% eine vollständige Umsetzung von BCBS 239 meldeten und lediglich 24% über eine umfassende Lineage-Dokumentation verfügten (Deloitte). Dieselbe Studie zeigte, dass fehlende bzw. fehlerhafte Quelldaten weiterhin die Hauptursache für Reporting-Fehler waren, genannt von 56% bzw. 50% der Banken.
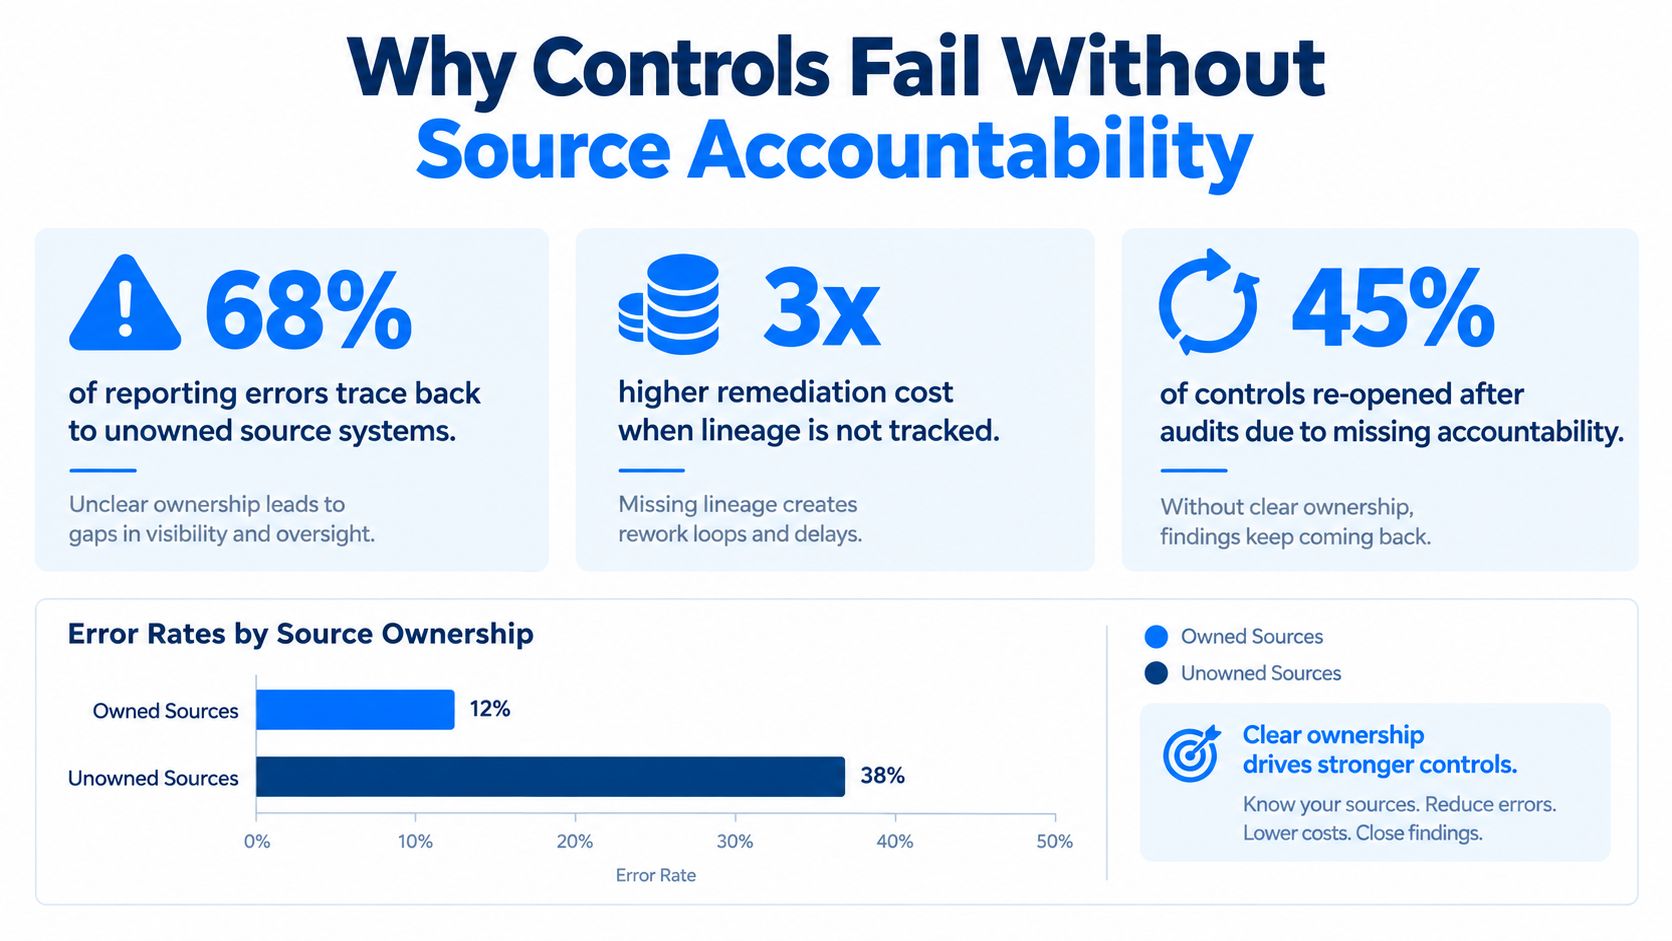
Warum eingerichtete Kontrollen die eigentliche Ursache trotzdem verfehlen
Das ist die unbequeme Lektion, die die meisten Banken hören müssen. Der begrenzende Faktor ist oft nicht ein Mangel an Kontrollen, sondern schwache Verantwortlichkeit für Quelldaten, fragmentierte Datenflüsse und unzureichende Lineage-Transparenz. Teams können Validierungsregeln einrichten, doch wenn niemand das Quellsystem verantwortet und niemand einen fehlerhaften Wert bis zu seinem Ursprung zurückverfolgen kann, taucht derselbe Fehler immer wieder in anderen Reports auf.
Deshalb ist Incident Management so wichtig. Ein Problem zu protokollieren ist nicht dasselbe, wie es zu lösen. Liegt der Fehler vorgelagert, kann das nachgelagerte Team nur Symptome behandeln, nicht die Ursache.
Unser Leitfaden zu den Aufgaben eines Data Owners passt zu dieser operativen Realität. Ownership muss bis zur Quelle reichen, denn dort beginnt die Verantwortlichkeit und dort lässt sich ein Fehler meist auch beheben.
Was fragmentierte Datenflüsse für die Behebung bedeuten
Fragmentierte Datenflüsse machen die Behebung auf eine Weise teuer, die leicht unterschätzt wird. Eine Bank mag den sichtbaren Report korrigieren, doch wenn die Lineage fehlt, muss jeder nachgelagerte Konsument dasselbe Problem separat erneut validieren. Das vervielfacht den Prüfaufwand und verzögert den Abschluss.
Außerdem schwächt es die Reaktion auf Audits. Wenn Prüfer fragen, wie eine Zahl zustande kam, brauchen Teams einen Pfad von der Datenerfassung bis zur Report-Ausgabe, keine lose Sammlung von Screenshots und Ticketnotizen. Ist die Lineage dünn, kann die Bank zwar belegen, dass eine Kontrolle gelaufen ist, aber nicht, dass die richtigen Daten durch sie hindurchgegangen sind.
Wenn das Team nur das Symptom beschreiben kann, steuert das Problem an der Quelle weiterhin die Bank.
Eine bessere Diagnose ist die Frage, ob die Organisation Ausnahmen bis zu ihren Ursprungspunkten zurückverfolgen kann. Lautet die Antwort nein, wirken die Kontrollen als Filter, nicht als Mechanismen der Verantwortlichkeit. Dieser Unterschied ist wichtig, denn Filter können sichtbare Fehler reduzieren, während der Produktionsprozess unverändert bleibt.
Banken, die dieses Muster durchbrechen, machen meist zwei Dinge anders. Sie verankern Ownership an der Quelle und gestalten Kontrollen so, dass der Weg der Daten nachweisbar bleibt. Genau diese Kombination schließt die Lücke zwischen Kontrolldesign und Umsetzung.
Die Lücke im KI-fähigen Betriebsmodell
Banken wissen, dass Daten für KI entscheidend sind, doch viele schaffen den Schritt von der Ambition zur Umsetzung noch nicht. Eine aktuelle KPMG-Bankenumfrage ergab, dass 93% der Befragten Datenschutz und Risiko, 89% Datenqualität und 81% Altsysteme und Integrationskomplexität als größte Herausforderungen der Modernisierung nannten, während 68% angaben, eine Zielbild-Vision zu haben, und 65% über eine Roadmap und ein Finanzierungsmodell verfügen (KPMG-Bankenumfrage). Diese Lücke sagt viel aus. Die Strategie existiert. Das operative Rückgrat oft nicht.
Wo KI-Programme ins Stocken geraten
Der erste Schwachpunkt ist meist Vertrauen. Ist die Datenqualität uneinheitlich, verlassen sich Teams weder beim Modelltraining noch beim Modell-Monitoring oder beim GenAI-Retrieval darauf. Das bremst Experimente, bevor der erste Pilot etwas Brauchbares liefert.
Der zweite Schwachpunkt ist die Integration. Gewachsene Altsystemlandschaften erschweren es, validierte Daten zwischen Risiko-, Finanz- und KI-Workflows zu bewegen, ohne neue Kopien und neuen Abstimmungsaufwand zu erzeugen. Das Ergebnis ist ein Stack, der oben modern aussieht und darunter brüchig ist.
Der dritte Schwachpunkt ist der Governance-Druck. Banken brauchen nicht nur Daten, die technisch funktionieren, sondern Daten, die einer Compliance-Prüfung standhalten. Lässt sich der Modell-Input nicht nachverfolgen, erklären und validieren, hat die Bank womöglich einen vielversprechenden Use Case, der die operative Prüfung nie besteht.
Unsere Ressource zu KI-fähigen Daten ist hier relevant, denn KI-Readiness hängt vor allem von der Stärke der Kontrollen ab, nicht vom Hype. Kann die zugrunde liegende Data Pipeline Aktualität, Struktur und Nachvollziehbarkeit nicht belegen, erbt die KI-Schicht diese Schwäche.
Wie ein realistisches Betriebsmodell aussieht
Ein realistisches Betriebsmodell beginnt nicht mit dem Modell. Es beginnt mit dem Datenpfad. Banken brauchen Validierung dort, wo die Daten landen, Aktualitätsprüfungen dort, wo Feeds eintreffen, und eine Lineage, die intakt bleibt, wenn Datensätze transformiert oder verknüpft werden.
Genau hier wird Observability nützlich. Teams müssen sehen, wenn sich ein Feed ändert, ein Schema verschiebt oder eine Quelle nicht mehr pünktlich liefert, bevor sich das Problem in nachgelagerten Analysen festsetzt. Der Wert liegt nicht nur in der Geschwindigkeit. Er liegt in der Fähigkeit zu verhindern, dass aus fehlerhaften Daten ein fehlerhaftes Modell wird.
KI-Readiness ist zuallererst ein Problem des Datenbetriebs.
Die praktische Erkenntnis: Zielbild-Roadmaps reichen nicht aus. Banken brauchen operative Kontrollen, die den Sprung von Modernisierungsfolien zu produktiven Pipelines überstehen. Sonst wird das KI-Programm zu einer weiteren Initiative, die auf dem Papier engagiert wirkt und in Produktion fragil ist.
Ein integriertes Datenmanagement-Framework aufbauen
Ein wirksames Framework verbindet Governance, Architektur, Lineage und Validierung zu einem Betriebsmodell. Es geht nicht darum, weitere Prüfschritte hinzuzufügen. Es geht darum, Qualität früh genug sichtbar zu machen, damit die Bank verhindern kann, dass fehlerhafte Daten das regulatorische Reporting, Risikomodelle oder KI-Workflows erreichen.
Das stärkste Design beginnt mit kontinuierlichem Monitoring auf Ebene des Datenpfads. Banken müssen die Aktualität der Anlieferung, Schema-Änderungen und Regelverstöße dort beobachten, wo die Daten in die Umgebung gelangen, nicht erst, wenn jemand einen fehlerhaften Report bemerkt. Hier kommt es auf In-Database-Validierung an, denn Prüfungen nah an den Daten reduzieren Datenbewegungen, bewahren Kontrollnachweise und verhindern, dass jede Ausnahme zu einer Kopieren-und-Vergleichen-Übung wird.
Das Framework, das in der Praxis trägt
Ein praxistaugliches Framework für Banken hat in der Regel fünf Ebenen.
Kontrolldefinition: Für jeden kritischen Datensatz gibt es explizite Regeln für Genauigkeit, Integrität, Vollständigkeit und Aktualität.
Ownership: Ein benannter Owner und ein Steward sind für das Verhalten der Quelle und die Behebung verantwortlich.
Lineage: Die Bank kann Daten von der Erfassung über die Transformation bis zum finalen Reporting nachverfolgen.
Monitoring: Aktualität, Validierung und Schema-Änderungen werden kontinuierlich geprüft, nicht periodisch.
Reaktion: Ausnahmen lösen eine Eskalation mit Nachweisen aus, nicht nur eine Ticketnummer.
Diese Ebenen sollten auf der tatsächlichen Bankarchitektur aufsetzen, nicht außerhalb davon. Leben Kontrollen in separaten Tools, die manuell synchronisiert werden müssen, stimmen Teams am Ende die Kontrollen selbst ab statt der Daten.
Das beste Kontrollmodell ist das, dem die Betreiber vertrauen können, ohne von Hand nachzuprüfen.
Deshalb sind Observability-Tools heute wichtiger denn je. Die Erwartungen der Aufsicht bewegen sich immer stärker in Richtung Nachweis statt Absichtserklärung. Kann die Bank zeigen, was angekommen ist, was sich geändert hat, was fehlgeschlagen ist und was behoben wurde, wird das Kontrollmodell prüfbar statt bloß angestrebt.
digna ist eine Option in diesem Bereich, weil es Datenvalidierung, Timeliness-Monitoring, Schema-Tracking und In-Database-Ausführung in der eigenen Umgebung des Kunden vereint. Im Bankenkontext passt ein solches Design zu der Anforderung, Daten an Ort und Stelle zu belassen und sie gleichzeitig kontinuierlich über Data Warehouses, Data Lakes und Pipelines hinweg zu prüfen.
Der letzte Test ist einfach. Wenn die Bank fehlerhafte Eingangsdaten früh erkennen, bis zur Quelle zurückverfolgen und ohne manuelles Zusammenstückeln belegen kann, was passiert ist, leistet das Betriebsmodell echte Arbeit. Wenn nicht, hat die Organisation zwar Governance-Vokabular, aber noch keine resiliente Datenmanagement-Fähigkeit.
Wenn Sie die Datenkontrollen Ihrer Bank modernisieren und einen praktischen Weg suchen, Aktualität zu überwachen, Datensätze zu validieren und Lineage in Ihrer eigenen Umgebung zu erhalten, besuchen Sie digna und sehen Sie sich an, wie die Observability- und Validierungsmodule in regulierte Datenprozesse passen. Die Plattform ist für Teams gebaut, die Nachweise brauchen, nicht nur Dashboards.
Mehr als ein Jahrzehnt nach der Veröffentlichung von BCBS 239 behandeln viele Banken die Grundsätze immer noch als Dokumentationsprojekt statt als Chance, ihr Risikodatenmanagement zu verbessern. Unser Artikel darüber, wie man BCBS-239-Compliance in geschäftlichen Mehrwert verwandelt, beleuchtet die Grundsätze zu Genauigkeit, Aktualität und Reporting und zeigt, wie Banken aus dieser regulatorischen Pflicht einen Wettbewerbsvorteil machen können.
Häufig gestellte Fragen
Welche vier Datenqualitätsdimensionen verwenden Aufsichtsbehörden bei Banken?
Aufsichtsbehörden bewerten Bankdaten nach Genauigkeit, Integrität, Vollständigkeit und Aktualität. Der EZB-Leitfaden zur Risikodatenaggregation verlangt von Banken detaillierte KPIs für jede dieser Dimensionen, und ein nützlicher KPI sollte die betroffene Quelle, Pipeline, den Owner, den nachgelagerten Report und den Erkennungszeitpunkt benennen, nicht nur, ob eine Regel bestanden wurde.
Wie viele Grundsätze umfasst BCBS 239?
BCBS 239 legt 14 Grundsätze für eine effektive Risikodatenaggregation und Risikoberichterstattung fest. Drei Anforderungen prägen die Bankarchitektur am stärksten: weitgehend automatisierte Aggregation zur Reduzierung manueller Fehler, Abdeckung über Rechtseinheiten, Regionen und Anlageklassen hinweg sowie eine Lineage, die einzelne Attribute von der Datenerfassung bis zum finalen Report nachverfolgt.
Warum scheitern Banken trotz Datenqualitätskontrollen noch an BCBS 239?
Kontrollen scheitern vor allem, weil Quelldaten keinen verantwortlichen Owner haben. Eine Deloitte-Studie aus dem Jahr 2025 ergab, dass 90% der europäischen Banken mindestens drei Datenqualitätskontrollen betreiben, aber nur 18% eine vollständige Umsetzung von BCBS 239 melden und 24% eine umfassende Lineage haben, während fehlende oder fehlerhafte Quelldaten die Hauptursache für Reporting-Fehler bleiben.
Was bremst den Einsatz von KI bei Bankdaten?
Vor allem Datenvertrauen und Integration, weniger die Strategie. In einer KPMG-Bankenumfrage nannten 89% Datenqualität und 81% Altsysteme und Integrationskomplexität als größte Herausforderungen, obwohl 68% bereits eine Zielbild-Vision hatten. Ohne Freshness-Checks, Validierung und Lineage entlang des Datenpfads erben KI-Modelle die Schwächen ihrer Eingangsdaten.
Was sollte ein Datenmanagement-Framework für Banken umfassen?
Ein praxistaugliches Framework hat fünf Ebenen: Kontrolldefinition, Ownership, Lineage, Monitoring und Reaktion. Jeder kritische Datensatz erhält explizite Regeln, einen benannten Owner und Steward, Rückverfolgbarkeit bis zum finalen Report, kontinuierliche Prüfungen von Aktualität, Validierung und Schema-Änderungen sowie eine Eskalation, die Nachweise liefert statt nur einer Ticketnummer.


