Was ist eine In-Memory-Datenbank? Die wichtigsten Trade-offs
|
7
min. Lesezeit

Eine In-Memory-Datenbank kommt nicht ohne Festplatte aus. Sie nutzt RAM als primäre Arbeitsschicht und persistenten Speicher als Grundlage für die Wiederherstellung. Deshalb kann eine scheinbar flüchtige Architektur dauerhafte Produktions-Workloads tragen. Das Performance-Argument ist ebenso eindeutig: Branchenbeobachter beschreiben den Speicherzugriff als etwa 10-mal schneller als den Festplattenzugriff, und aktuelle technische Referenzen verbinden In-Memory-Systeme mit Leselatenzen im Mikrosekundenbereich und Schreiblatenzen im einstelligen Millisekundenbereich (Mordor Intelligence erklärt die historische Entwicklung, AWS beschreibt das heutige In-Memory-Verhalten).
Damit ist die eigentliche Frage beantwortet: Was ist eine In-Memory-Datenbank? Es ist eine Datenbank, die aktive Daten im Hauptspeicher hält, sie dort verarbeitet und Logs, Snapshots, Save Points oder andere Persistenzmechanismen nutzt, um sich nach einem Ausfall wiederherzustellen. Der Geschwindigkeitsvorteil ist real, ebenso aber die Kosten, Kapazitätsgrenzen, betrieblichen Entscheidungen und die Verantwortung für die Dauerhaftigkeit der Daten.
Inhaltsverzeichnis
Das Geschwindigkeitsparadox - Daten im Speicher und trotzdem sicher auf der Festplatte
In-Memory vs. klassischer Speicher - die Performance in der Praxis
Das Durability-Rätsel lösen - Persistenz ohne Performanceverlust
Das Geschwindigkeitsparadox - Daten im Speicher und trotzdem sicher auf der Festplatte
Das verbreitete Bild ist falsch: „In-Memory“ heißt nicht „nirgendwo sonst gespeichert“. Ein Produktivsystem hält häufig genutzte Daten im RAM, weil die CPU sie erreicht, ohne auf einen klassischen Speicherzugriff zu warten, während persistenter Speicher die Informationen sichert, die nach einem Absturz oder Stromausfall gebraucht werden. SAP beschreibt RAM als zentralen Verarbeitungsort einer In-Memory-Datenbank, die für die dauerhafte Persistenz dennoch Festplatten- oder SSD-Speicher benötigt (SAP erklärt den zentralen Unterschied).
Warum Engineers den RAM-Aufpreis in Kauf nehmen
Nehmen wir einen Transaktionsservice, der immer wieder aktive Konten, aktuelle Events oder den aktuellen Lagerbestand prüfen muss. Ein Disk-first-Design zahlt fortlaufend für Storage-I/O. Ein Memory-first-Design zahlt mehr für RAM und für die Mechanismen, die diesen Speicher befüllt halten, verkürzt aber den Weg zwischen einer Anfrage und den Daten, die für die Antwort nötig sind.
Wirtschaftlich praktikabel wurde die Architektur in den 1980er- und frühen 1990er-Jahren, als günstigerer RAM und ein größerer 64-Bit-Adressraum größere Working Sets möglich machten. Die In-Memory-Version von IBM DB2 kam in den frühen 1990er-Jahren auf den Markt, und 2014 meldete eine DBTA-Umfrage, die in der Marktübersicht von Mordor Intelligence zitiert wird, einen In-Memory-Einsatz in rund 32 % der Unternehmen, während 75 % der Befragten eine Ausweitung in den folgenden 3 Jahren erwarteten.
Faustregel: Betrachten Sie RAM als schnelle Arbeitsfläche, nicht als dauerhaften Datenbestand.
Diese Unterscheidung löst das Stromausfall-Rätsel. Verliert der Server die Stromversorgung, verlässt sich die Datenbank nicht darauf, dass der RAM-Inhalt erhalten bleibt. Sie rekonstruiert ihren Zustand aus dauerhaft gespeicherten Daten und befüllt den Speicher anschließend neu. Das genaue Recovery-Design unterscheidet sich je nach Produkt, doch für ein System, das Transaktionen verantwortet, ist Dauerhaftigkeit kein optionales Feature.
Der Trade-off bleibt wichtig. RAM kostet mehr als persistenter Speicher, und alles im Speicher zu halten kann Verschwendung sein, wenn nur ein Teil der Daten sofort verfügbar sein muss. Moderne Systeme kombinieren daher Memory-first-Ausführung mit Speicherebenen: Hot Data bleibt im RAM, kältere Daten wandern bei Bedarf auf NVMe-SSDs (AWS beschreibt diesen Tiering-Ansatz).
So funktionieren In-Memory-Datenbanken unter der Haube
Eine In-Memory-Datenbank verändert mehr als nur den Ort der Daten. Sie verändert, worauf die Engine optimiert. Ein festplattenorientiertes System ist darauf ausgelegt, Storage-Lesezugriffe zu minimieren, Pages zu verwalten und einen Buffer Pool effizient zu nutzen. Eine In-Memory-Engine kann mehr von ihrem Design-Budget in CPU-Effizienz, Speicherbandbreite, Kompression, parallele Ausführung und schnelle Zugriffspfade investieren.
Die erste Architekturentscheidung betrifft das Datenlayout. Zeilenbasierte Speicherung hält die Felder eines Datensatzes zusammen, was zu vielen transaktionalen Operationen passt, die vollständige Datensätze lesen oder aktualisieren. Spaltenbasierte Speicherung gruppiert Werte nach Spalten, sodass eine analytische Abfrage, die eine Kennzahl und einige Filter benötigt, nicht jedes Feld jeder Zeile verarbeiten muss. SAP nennt die spaltenorientierte Organisation und die Verteilung auf mehrere Server als wichtige Fähigkeiten von In-Memory-Systemen (SAPs HANA-Überblick).
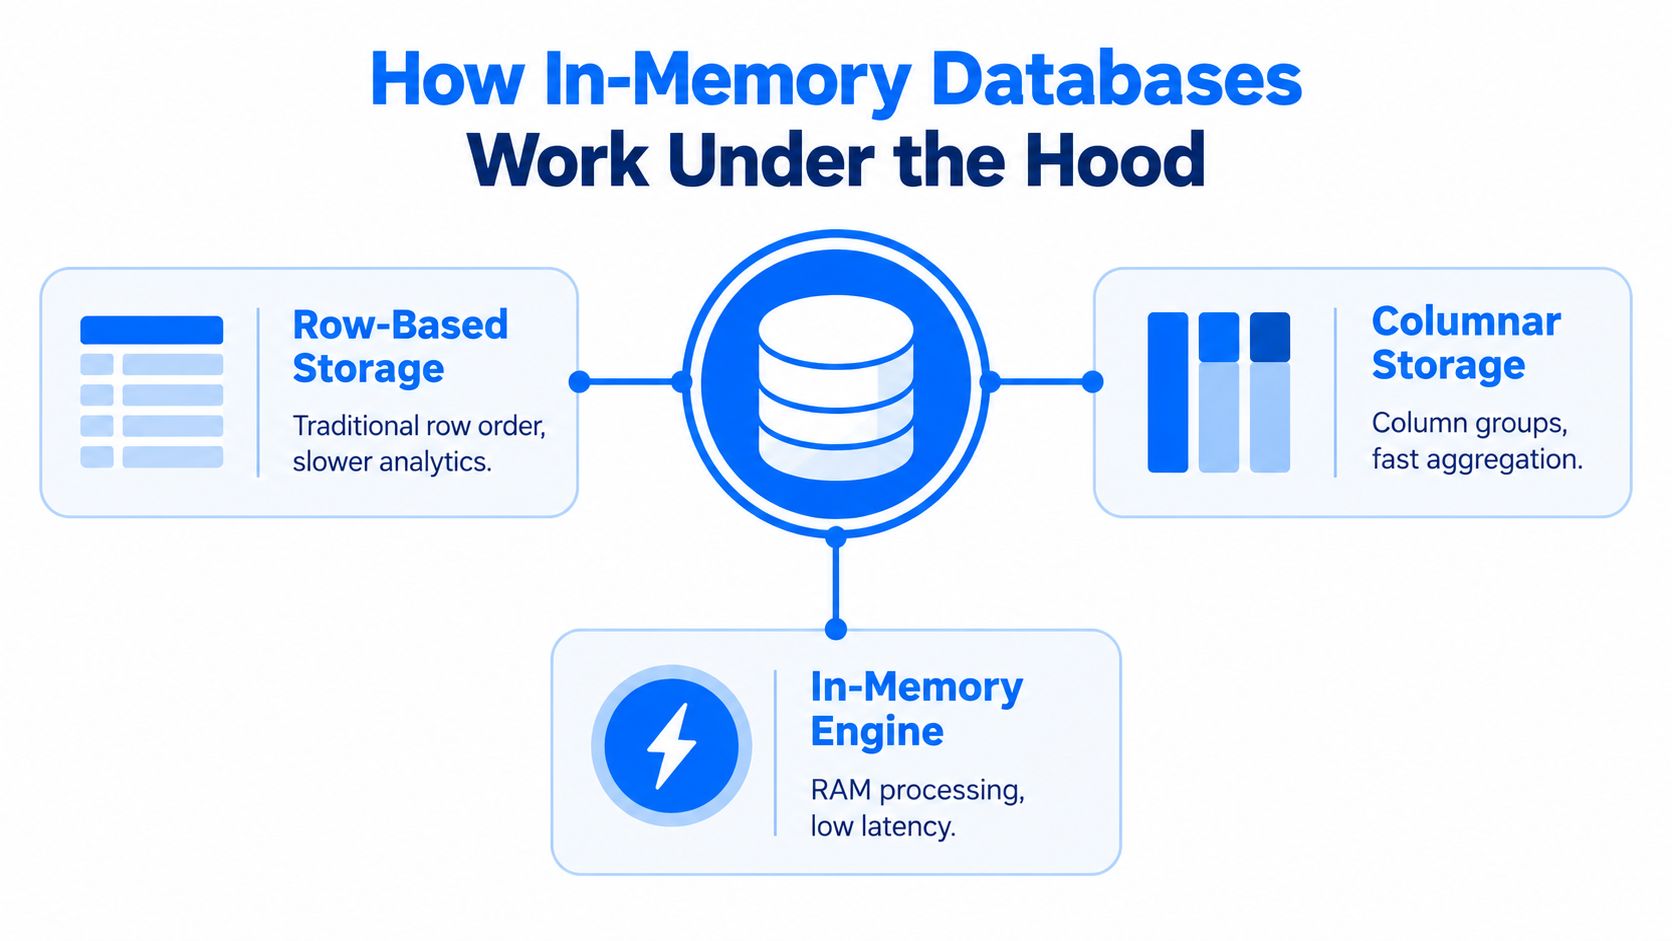
Kompression und Verteilung
Kompression ist wichtig, weil RAM wertvoll ist. Wiederholte Werte, sortierte Spalten und kompakte Encodings erlauben es der Engine, mehr aktive Informationen im Speicher zu halten und die Datenmenge zu reduzieren, die die CPU bewegen muss. Kostenlos ist Kompression allerdings nicht. Die Engine verbraucht CPU-Zeit für das Kodieren und Dekodieren von Werten. Die sinnvolle Frage ist also nicht, ob es Kompression gibt, sondern ob ihre CPU-Kosten niedriger sind als die Speicher- und I/O-Kosten, die sie einspart.
Verteilung adressiert eine andere Einschränkung. Ein einzelner Server hat begrenzten Speicher und begrenzte Rechenkapazität, daher können Systeme Daten und Verarbeitung auf mehrere Maschinen partitionieren. Das bringt Koordination, Netzwerkverkehr, Replikationsentscheidungen und Failure Domains mit sich. Scale-out kann das Working Set vergrößern, macht verteilte Operationen aber nicht kostenlos.
Das Verhältnis zwischen Speicher und Festplatte sollte im Design explizit bleiben. RAM übernimmt die aktive Verarbeitung, persistenter Speicher unterstützt Recovery und kältere Daten. Manche Plattformen nutzen Tiering, damit Anwendungen nicht jede Datenbewegung selbst steuern müssen. Andere halten ein kleineres, bewusst ausgewähltes Working Set im Speicher und belassen die Source of Truth in einer konventionellen Datenbank.
Für Teams, die abwägen, wo Berechnungen stattfinden sollen, bietet In-Database-Processing einen nützlichen Architekturvergleich. Berechnungen nah an den Daten auszuführen kann Datenbewegungen reduzieren, doch die Datenbank braucht weiterhin genug Speicher, CPU und Reserven für Parallelität, um sowohl operative Abfragen als auch analytische Workloads zu bedienen.
In-Memory vs. klassischer Speicher - die Performance in der Praxis
In-Memory-Datenbanken sind schneller, weil sie Storage-I/O aus dem heißesten Pfad entfernen, nicht weil sie SQL selbst verändern. Die Engine parst weiterhin Abfragen, wertet Prädikate aus, pflegt Indizes oder andere Strukturen, koordiniert Worker und bewältigt Konflikte beim gleichzeitigen Zugriff. Ein CPU-gebundener Workload oder ein schlechtes Datenmodell kann den Vorteil von Daten im RAM zunichtemachen.
Technische Referenzen beschreiben In-Memory-Datenbanken häufig mit Lesezugriffen im Mikrosekundenbereich und Schreibzugriffen im einstelligen Millisekundenbereich. Die tatsächliche Latenz hängt von Engine, Hardware, Durability-Konfiguration, Abfrageform und Parallelität ab (AWS dokumentiert diese Latenzeigenschaften). Dieses Profil eignet sich für Entscheidungen, die getroffen werden müssen, solange ein Ereignis noch aktuell ist.
Performance: In-Memory- vs. festplattenbasierte Datenbank
Kennzahl | In-Memory-Datenbank | Festplattenbasierte Datenbank |
|---|---|---|
Leselatenz | Vermeidet die meisten Storage-Roundtrips, doch Cache-Misses, Locks, Serialisierung und Netzwerk-Hops beeinflussen weiterhin die Tail-Latenz | Storage-Zugriffe, Buffer-Cache-Misses, Indizes und Queue-Tiefe sorgen für stärker schwankende Verzögerungen |
Schreiblatenz |
| Die Latenz hängt von Storage-Hardware, Logging, Checkpoints, Indizes und Konkurrenz im Workload ab |
Durchsatzprofil | Sehr gut geeignet für häufige Lesezugriffe mit niedriger Latenz und aktive Transaktionsverarbeitung | Sehr gut geeignet für kapazitätsorientierte Speicherung, Archivdaten und Batch-Workloads |
Hardwarekosten | Höhere Speicherkosten, ggf. zusätzlich Anforderungen an Replikation und Persistenz | Geringere Kosten pro gespeicherter Dateneinheit, dafür stärkere Abhängigkeit von der Storage-Infrastruktur |
Bester betrieblicher Einsatz | Live-Dashboards, Decision Services, Sessions und sich schnell ändernde Working Sets | Kalte Daten, lange Aufbewahrung, große historische Bestände und Batch-Verarbeitung ohne enge Zeitfenster |
Die Tabelle unterstützt Architekturentscheidungen, keine Produktvergleiche nach Etikett. Eine festplattenbasierte Datenbank kann ein In-Memory-System übertreffen, wenn die Abfrage besser gestaltet ist, und ein In-Memory-System kann enttäuschen, wenn sein Working Set in langsamere Speicherebenen ausweicht. Messen Sie Zugriffsmuster und Durability-Verhalten gemeinsam.
Geschwindigkeit zählt nur, wenn die Anwendung die kürzere Antwortzeit auch nutzen kann.
Bewerten Sie p95- und p99-Latenz, Anforderungen an die Dauerhaftigkeit von Schreibvorgängen, Speicherauslastung, Eviction- oder Tiering-Verhalten, Replikationsverzögerung und Wiederherstellungszeit. Database Performance Tuning ist hier relevant, weil Abfrageform und Workload-Verhalten den Vorteil schnelleren Speichers zunichtemachen können, wenn Ausführungsmuster nicht gemessen werden.
Das Durability-Rätsel lösen - Persistenz ohne Performanceverlust
In-Memory heißt nicht ohne Speicher. RAM liefert den Arbeitszustand mit niedriger Latenz, doch eine Produktivdatenbank braucht weiterhin dauerhafte Datensätze für Neustart, Failover und Disaster Recovery. Der Springer-Review behandelt Durability und Benchmarking von IMDBs und betrachtet Persistenz als Teil des In-Memory-Datenbankdesigns, nicht als optionale Absicherung.
Logs, Snapshots und Save Points
Ein Transaktionslog zeichnet Änderungen in einer dauerhaften Reihenfolge auf. Nach einem Neustart lädt die Engine einen gespeicherten Basiszustand und spielt die relevanten Log-Einträge erneut ein. Bestätigte Arbeit bleibt erhalten, während die aktive Verarbeitung weiter auf den Daten im Speicher läuft.
Save Points und Snapshots legen Wiederherstellungsgrenzen fest. In Intervallen schreibt die Engine eine konsistente Darstellung des Arbeitszustands in den persistenten Speicher. Nach einem Absturz muss die Datenbank dann diese Darstellung wiederherstellen und die späteren Log-Einträge anwenden. Häufigere Persistierung kann das Wiederherstellungsrisiko verkürzen, verbraucht aber Storage-Bandbreite und kann mit laufenden Abfragen und Schreibvorgängen konkurrieren.
Das Design kombiniert in der Regel vier Mechanismen:
Transaktions-Logging: Zeichnet Änderungen für die Wiederherstellung auf und sichert bestätigte Transaktionen dauerhaft.
Save Points: Persistieren einen wiederherstellbaren Zustand, ohne für jede Operation den gesamten Datenbestand neu zu schreiben.
Snapshots: Erzeugen eine dauerhafte Point-in-Time-Darstellung, die Neustart und Wiederherstellung beschleunigen kann.
Asynchrone Backups: Führen Backups im Hintergrund aus, im Rahmen der Wiederherstellungsgarantien der Datenbank.
Laut SAP bleibt Festplatten- oder SSD-Speicher für die dauerhafte Persistenz nach einem Stromausfall oder einer Katastrophe notwendig, selbst wenn die Daten im Speicher verfügbar sind (SAPs Hinweise zur Persistenz). SAP HANA veranschaulicht dasselbe Design mit ACID-konformer Verarbeitung, komprimierten spaltenbasierten Daten im Speicher und bestätigten Transaktionen, die über Logging und Save Points persistiert werden, damit sich das System nach einem Neustart wiederherstellen kann (SAPs HANA-Administrationsunterlagen).
Recovery-Test: Geben Sie sich nicht mit „die Datenbank hat Persistenz“ zufrieden. Stellen Sie einen ausgefallenen Knoten wieder her, spielen Sie Logs ein und validieren Sie bestätigte Transaktionen, wie in unserem Leitfaden zu Database Reliability Engineering beschrieben, und messen Sie das Verhalten der Anwendung während der Wiederherstellung.
Durability-Einstellungen legen einen direkten Trade-off offen. Aggressive Persistierung schützt mehr aktuelle Schreibvorgänge, erhöht aber die Last auf dem Storage und den Koordinationsaufwand. Lockerere Einstellungen können den Schreibdurchsatz verbessern, verlagern aber mehr Arbeit in die Wiederherstellung. Wählen Sie die Konfiguration danach, welche geschäftlichen Folgen der Verlust aktueller Daten hätte, welches Recovery-Ziel gilt und welche Storage-Kapazität für den Workload zur Verfügung steht.
Enterprise-Anwendungsfälle, in denen Geschwindigkeit zählt
Eine In-Memory-Datenbank rechnet sich, wenn eine verzögerte Antwort das Ergebnis verändert. Die besten Kandidaten erzeugen kontinuierlich Daten, werten sie sofort aus und können nicht auf eine Warehouse-Ladung oder einen langen Batch-Zyklus warten. Die richtige Frage ist nicht nur, wie schnell die Abfrage läuft, sondern was die Anwendung tun muss, wenn ein Knoten neu startet.
Finanzdienstleistungen liefern ein klares Beispiel. Eine Transaktion trifft ein, und ein Fraud-Service benötigt aktuelles Kontoverhalten, Transaktionskontext und Risikosignale, bevor er sie freigibt oder beanstandet. Diese aktiven Signale im RAM zu halten, verkürzt den Weg von der Event-Erfassung bis zur Entscheidung. Der Workload braucht trotzdem eine definierte Durability-Policy: Bestätigte Entscheidungen müssen wiederherstellbar sein, während temporäre Features oder abgeleitete Signale neu berechnet werden können. Risikoanalysen profitieren aus demselben Grund, besonders wenn Analysten oder automatisierte Kontrollen sich ändernde Positionen statt der Extrakte von gestern brauchen.

Die Engine passend zur Entscheidung wählen
Teams in Fertigung und Logistik haben ein verwandtes Problem. Sensoren, Aufträge, Lagerbewegungen und Lieferereignisse verändern das operative Bild laufend. Eine Memory-first-Schicht kann Live-Dashboards, Ausnahmeerkennung, Dispositionsentscheidungen und Kapazitätsansichten versorgen, ohne jede Anfrage über einen storage-lastigen analytischen Pfad zu zwingen. Sie eignet sich für Workloads, bei denen veraltete Informationen eine verpasste Lieferung, eine unnötige Produktionsänderung oder eine schlechte Zuteilungsentscheidung auslösen können.
Definieren Sie das aktive Working Set, bevor Sie die Plattform wählen:
Entscheidungsfenster bestimmen. Legen Sie fest, welche Events, Entitäten und Kennzahlen sofort verfügbar sein müssen.
Aktive und historische Daten trennen. Halten Sie den aktuellen operativen Kontext in der schnellen Schicht und bewahren Sie ältere Datensätze in geeigneten persistenten Systemen auf.
Ausfallverhalten definieren. Entscheiden Sie, was einen Neustart überstehen muss, was neu aufgebaut werden kann und wie schnell der Service wieder verfügbar sein muss.
Den gesamten Pfad messen. Berücksichtigen Sie Ingestion, Transformation, Abfrageausführung, Persistenz, Replikation und die Antwortzeit der Anwendung.
SAP HANA ist ein prominentes Beispiel für die Kombination von transaktionaler und analytischer Verarbeitung auf einer Plattform, wodurch ein Datenbewegungsschritt zwischen operativen Updates und Analyse entfallen kann. Die allgemeinere Lehre hängt vom Workload ab: Konsolidierung hilft, wenn getrennte Systeme eine inakzeptable Verzögerung verursachen würden, bündelt aber auch Performance-, Recovery- und Kapazitätsfragen auf einer einzigen Plattform.
Echtzeit-Datenmonitoring erfordert mehr als eine schnelle Query-Engine. Teams müssen wissen, ob Daten angekommen sind, ob sich ihre Struktur geändert hat und ob die Werte plausibel bleiben. Ein Ansatz für Real-Time Data Monitoring kann die Datenbankschicht ergänzen, indem er das Verhalten und die Verfügbarkeit der Daten prüft, von denen schnelle Anwendungen abhängen. Diese Nachweise gehören ins Betriebsmodell, neben Messungen zu Latenz, Recovery und Kapazität.
Verbreitete Irrtümer über In-Memory-Technologie
Der erste Irrtum lautet, dass die RAM-Kosten eine In-Memory-Datenbank automatisch unwirtschaftlich machen. RAM ist teurer als Festplattenkapazität, die Sorge ist also berechtigt. Der Vergleich sollte aber nicht bei der Speicherrechnung enden. Ein Memory-first-Design kann wiederholtes I/O reduzieren, manche Verarbeitungspfade vereinfachen und Teile einer fragmentierten Architektur überflüssig machen. Ob die Gesamtkosten sinken, hängt von Workload-Profil, Lizenzierung, Replikation, Betrieb und davon ab, wie viele Daten schnell verfügbar sein müssen.
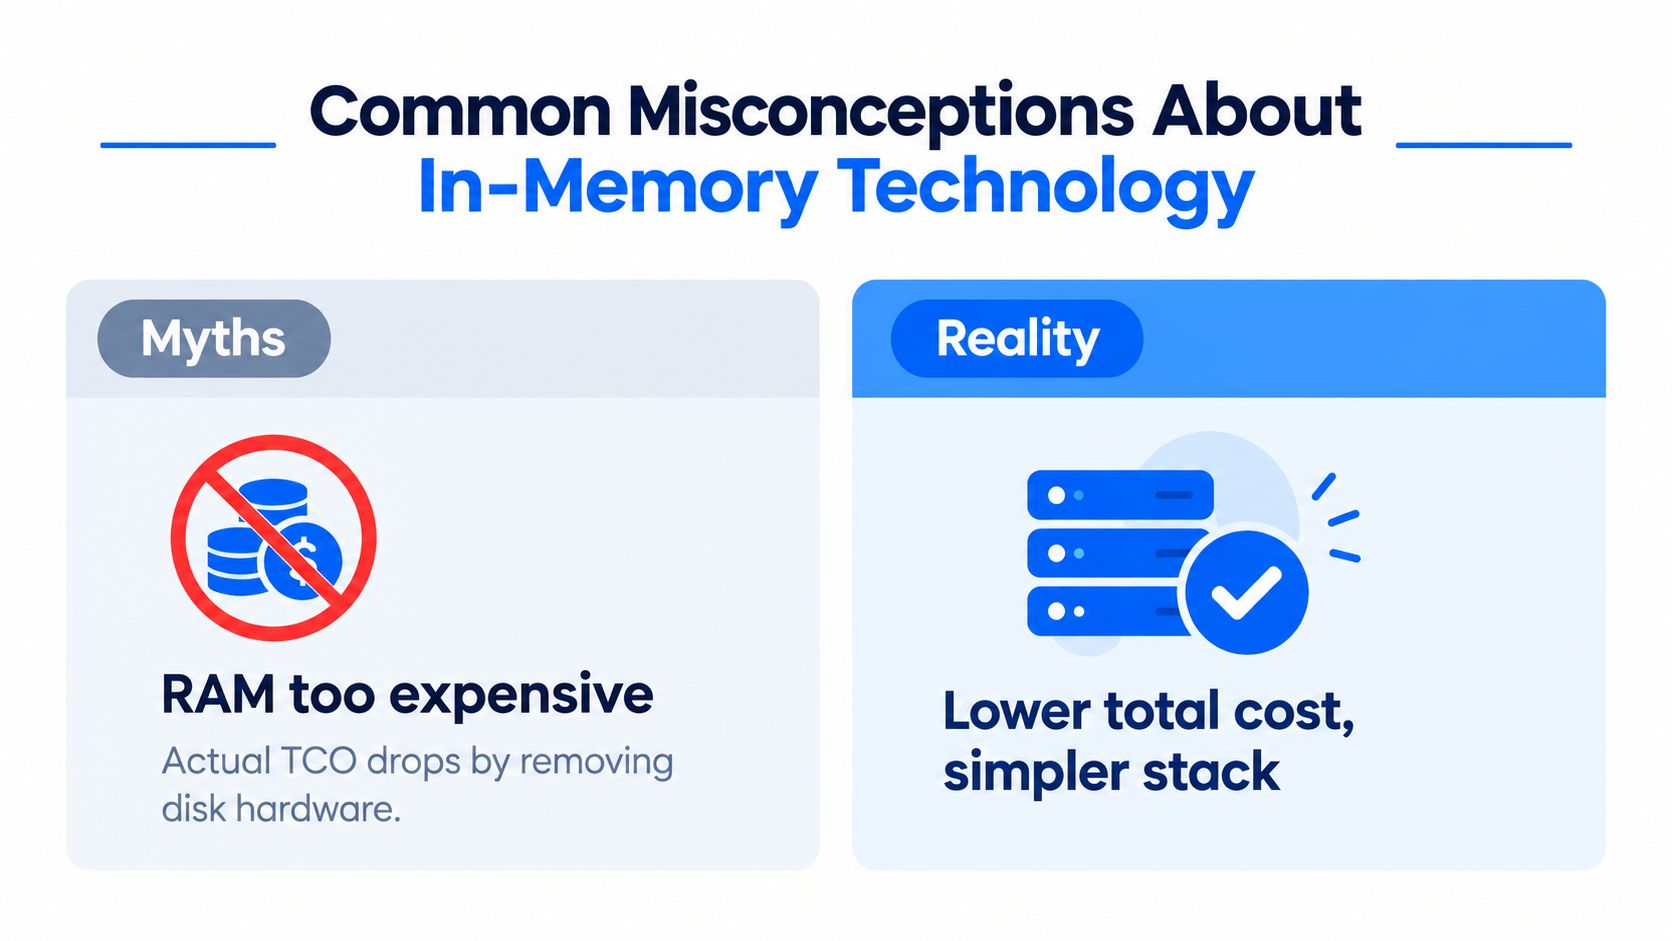
Drei Annahmen, die man hinterfragen sollte
„Der gesamte Datenbestand muss in den RAM passen.“ Nicht unbedingt. Moderne Designs können Hot Data im RAM und kältere Daten auf NVMe-SSDs vorhalten, während verteilte Architekturen die aktive Verarbeitung auf mehrere Server verteilen können (AWS beschreibt Tiering zwischen Speicher und SSD). Die entscheidende Sizing-Frage betrifft das aktive Working Set und sein Zugriffsmuster, nicht nur den gesamten historischen Datenbestand.
„In-Memory heißt, dass Daten bei einem Ausfall verschwinden.“ Ein reiner In-Memory-Prototyp mag sich so verhalten. Eine produktive In-Memory-Datenbank nutzt Persistenzmechanismen wie Logs, Snapshots oder Recovery-Dateien, und die Durability-Konfiguration bestimmt, was das System rekonstruieren kann. Teams sollten diese Garantien testen, statt sie aus dem Produktnamen abzuleiten.
„Schnellerer Speicher löst jedes Datenbankproblem.“ Tut er nicht. Schlechte Joins, übermäßige Serialisierung, Lock-Contention, ineffiziente Datenmodellierung und unbegrenzte Kardinalität können auch eine schnelle Engine ausbremsen. In-Memory-Technologie beseitigt eine Klasse von Engpässen, die Storage-Latenz, lässt aber den Rest des Systems sichtbar.
Die richtige Frage ist nicht „Können wir diese Datenbank in den Speicher legen?“, sondern „Welche Daten und Entscheidungen rechtfertigen eine Memory-first-Ausführung?“
Ein weiterer Irrtum ist, dass eine einzige Architektur jeden Workload bedienen muss. Historische Archive, große Aufbewahrungsbestände und Batch-Transformationen profitieren oft von kapazitätsorientiertem persistentem Speicher. Eine In-Memory-Schicht kann neben diesen Systemen stehen und den aktiven Pfad beschleunigen, ohne zum einzigen Ort zu werden, an dem Daten liegen.
Passt eine In-Memory-Datenbank zu Ihrem Stack?
Wählen Sie zuerst den Workload, dann das Produkt. Eine In-Memory-Datenbank passt, wenn Nutzer oder Services durchgehend niedrige Latenz benötigen, Transaktionen kontinuierlich eintreffen, aktive Datensätze häufig wiederverwendet werden und verzögerte Entscheidungen betriebliche Kosten verursachen. Weniger geeignet ist sie für Archivzugriffe, geplante Batch-Abfragen oder ein Working Set, das zu selten genutzt wird, um seinen RAM-Bedarf zu rechtfertigen.
Nutzen Sie diesen Entscheidungsfilter:
Setzen Sie auf Memory-first-Ausführung für Fraud-Signale, operative Live-Ansichten, Session-State, hochfrequente Entscheidungen und Workloads, bei denen Storage-I/O die Antwortzeit dominiert.
Lassen Sie klassischen Speicher im Zentrum für kalte Archive, Datensätze mit langer Aufbewahrung, seltenes Reporting und Batch-Jobs mit flexiblen Zeitfenstern.
Nutzen Sie ein hybrides Design, wenn nur ein Teil der Daten sofort verfügbar sein muss und der Rest auf persistenten Speicherebenen bleibt.
Der Markt hat das Nischenstadium hinter sich gelassen. Laut der Marktschätzung von Fortune Business Insights lag der globale Markt für In-Memory-Datenbanken bei etwa 7,20 Mrd. USD im Jahr 2024, 8,14 Mrd. USD im Jahr 2025 und 9,05 Mrd. USD im Jahr 2026 und soll bis 2031 rund 15,31 Mrd. USD erreichen. Das Marktwachstum spricht für eine weitere Verbreitung, ersetzt aber keine Workload-Tests und keine Validierung der Wiederherstellung nach Ausfällen.
Bevor Sie sich festlegen, benchmarken Sie repräsentative Abfragen, prüfen die Persistenz bei Stromausfall und Neustart, messen den Speicherdruck und kontrollieren das Tiering-Verhalten. Optimieren Sie den SQL-Pfad mit SQL-Query-Optimierung und vergleichen Sie die gemessenen Latenzgewinne dann mit Speicher-, Lizenz-, Replikations- und Betriebskosten. Das Ergebnis sollte eine Infrastrukturentscheidung sein, die auf dem System basiert, das Sie tatsächlich betreiben.
digna unterstützt Datenteams dabei, Anomalien, Timeliness, Schema-Änderungen und Qualitätsprüfungen auf Datensatzebene direkt in ihren eigenen Datenbanken zu überwachen. Wenn Ihre In-Memory-Architektur auf aktuelle, vertrauenswürdige Eingangsdaten angewiesen ist, besuchen Sie digna und prüfen Sie einen In-Database-Observability-Ansatz.
Eine schnelle Engine hilft nur, wenn die Daten, die sie speisen, aktuell sind. Deshalb lohnt es sich zu verfolgen, ob jede Quelltabelle tatsächlich pünktlich angekommen ist; lesen Sie, wie digna Timeliness erwartete Ankunftsmuster lernt und verspätete oder fehlende Ladevorgänge meldet.
Häufig gestellte Fragen
Verliert eine In-Memory-Datenbank bei einem Stromausfall Daten?
Nicht in einem Produktivsystem. RAM dient als schnelle Arbeitsfläche, nicht als dauerhafter Datenbestand. Nach einem Stromausfall stellt die Engine daher einen gespeicherten Zustand von Festplatte oder SSD wieder her und spielt ihr Transaktionslog erneut ein. SAP HANA zum Beispiel persistiert bestätigte Transaktionen über Logging und Save Points.
Wie viel schneller ist eine In-Memory-Datenbank als eine festplattenbasierte?
Der Speicherzugriff wird als etwa 10-mal schneller als der Festplattenzugriff beschrieben, und technische Referenzen nennen Lesezugriffe im Mikrosekundenbereich und Schreibzugriffe im einstelligen Millisekundenbereich. Die tatsächliche Latenz hängt dennoch von Hardware, Durability-Einstellungen, Abfrageform und Parallelität ab. Teams sollten deshalb p95- und p99-Latenz messen, statt Werbezahlen zu vertrauen.
Müssen alle meine Daten in den RAM passen?
Nein. Moderne Designs halten Hot Data im RAM und verschieben kältere Daten auf NVMe-SSDs, und verteilte Setups verteilen das Working Set auf mehrere Server. Die entscheidende Sizing-Frage betrifft das aktive Working Set und die Art des Zugriffs darauf, nicht den gesamten historischen Umfang der Datenbank.
Wann sollte man eine In-Memory-Datenbank statt einer klassischen Datenbank einsetzen?
Immer dann, wenn eine verzögerte Antwort das Ergebnis verändert, etwa bei Fraud-Signalen, operativen Live-Dashboards, Session-State oder Dispositionsentscheidungen. Kalte Archive, Daten mit langer Aufbewahrung und Batch-Jobs mit flexiblen Zeitfenstern gehören meist auf kapazitätsorientierten Festplattenspeicher, während ein hybrides Design zu Workloads passt, bei denen nur ein Teil der Daten heiß ist.
Was ist der Unterschied zwischen fsync-per-commit und Group Commit?
Beide legen fest, wann Schreibvorgänge dauerhaften Speicher erreichen. Fsync-per-commit schreibt jede Transaktion sofort weg und bietet so die stärkste Dauerhaftigkeit bei höheren Kosten pro Schreibvorgang. Group Commit bündelt mehrere Flushes, steigert den Durchsatz, erfordert aber zusätzliche Commit-Koordination. Die richtige Wahl hängt davon ab, wie teuer der Verlust aktueller Schreibvorgänge wäre.


