Automatisiertes Data Profiling für zuverlässige Datenplattformen
|
7
min. Lesezeit

Das Dashboard lädt weiterhin. Die nächtlichen Jobs sind durchgelaufen, und niemand hat einen Fehler gemeldet. Dann bemerkt ein Business Analyst, dass eine vertraute Kundenkategorie aus der zugrunde liegenden Tabelle fast verschwunden ist. Ihre Checks sind grün, weil sie prüfen, ob die Pipeline gelaufen ist - nicht, ob sich die Daten noch wie erwartet verhalten.
Inhaltsverzeichnis
Warum manuelles Data Profiling im großen Maßstab scheitert
Nehmen Sie ein Data Warehouse einer Sozialversicherung, in dem Engineers eine große Sammlung handgeschriebener Checks pflegen. Einige validieren Leistungsdatensätze, andere prüfen Liefertermine, wieder andere setzen Annahmen durch, die aus stillgelegten Systemen übernommen wurden. Es handelt sich um ein illustratives Betriebsmuster, nicht um einen dokumentierten Kundenfall.
Jeder Check mag sinnvoll gewesen sein, als er geschrieben wurde. Die Schwierigkeit besteht darin, seine Bedeutung zu bewahren, während sich Quellsysteme, Reporting-Anforderungen und Team-Zuständigkeiten ändern.
Ein Engineer verlässt das Unternehmen, sein SQL bleibt. Ein neuer Feed kommt hinzu, und das Team kopiert ein bestehendes Regelset, ohne zu wissen, welche Annahmen gelten. Analysten ergänzen nach Vorfällen weitere Checks, während veraltete Checks weiterhin Alarme erzeugen.
Regelabdeckung ist kein Datenverständnis
Ein statisches Regelset beantwortet Fragen, die bereits jemand zu stellen wusste. Es deckt nicht unbedingt eine unbekannte Kategorie, eine veränderte Verteilung oder ein Feld auf, dessen tatsächliche Bedeutung von seinem Namen abweicht.
Die operativen Symptome sind bekannt:
Lückenhafte Abdeckung: Wichtige Tabellen haben Checks, doch diese decken ausgewählte Fehlerbilder ab statt des beobachteten Verhaltens der Tabelle.
Unklare Verantwortung: Engineers finden zwar die Regel, aber niemanden, der ihren fachlichen Zweck erklären kann.
Alarmmüdigkeit: Prüfer stoßen immer wieder auf wenig aussagekräftige Benachrichtigungen und gehen der nächsten mit geringerer Wahrscheinlichkeit nach.
So lassen sich operative Datenprobleme sinnvoll einordnen: nicht als fehlerhafte Werte, sondern als Lücken zwischen dem, was Teams messen, und dem, was nachgelagerte Nutzer brauchen.
Erst erkunden, dann vorschreiben
Automatisiertes Data Profiling beginnt mit einer anderen Frage: Was ist in diesem Datensatz tatsächlich vorhanden? Es macht eine unbekannte Tabelle messbar, bevor Analysten, Statistikwerkzeuge oder Modelle von ihr abhängen.
Geschäftsregeln werden dadurch nicht überflüssig. Es reduziert aber die Menge an explorativem SQL, die Engineers schreiben müssen, bevor sie entscheiden können, welche Regeln gerechtfertigt sind.
Praxisregel: Behalten Sie explizite fachliche Anforderungen bei, aber zwingen Sie Engineers nicht, jede beobachtbare Änderung vorherzusehen, bevor das Monitoring beginnen kann.
Auch die Architekturentscheidung zählt. Für sensible Unternehmensdaten empfehle ich, diese Messwerte innerhalb der Kundenumgebung zu erlernen und zu pflegen. Die Erkundung sollte keinen Export von Produktionsdaten in einen gehosteten Scanner erfordern.
Das nützliche Ergebnis ist kein größerer Bestand an Checks. Es ist eine gepflegte Baseline, ein verantwortlicher Prüfer und Evidenz, die hilft, eine bedeutsame Änderung von routinemäßiger Schwankung zu unterscheiden.
Was automatisiertes Data Profiling tatsächlich misst
Beginnen Sie mit einer unbekannten Warehouse-Tabelle. Sie können ihr Schema lesen, doch die deklarierten Typen verraten nicht, ob Felder befüllt sind, Identifikatoren sich wiederholen oder Textwerte konsistenten Mustern folgen.
Das grundlegende Paper Data Profiling Revisited, veröffentlicht 2013, beschreibt Profiling als Untersuchung von Dateneigenschaften wie Spaltentypen, Anzahl der Null-Werte, Anzahl eindeutiger Werte und häufigen Mustern. Es erläutert zudem, wie Profiling die Prüfung von Constraints und die Konfiguration späterer Statistik- oder Data-Mining-Werkzeuge unterstützt.
Die beobachtbare Form erlernen
Stellen Sie sich ein Profil als Grundriss und Belegungszählung eines Gebäudes vor. Es beschreibt die Räume und wo sich Menschen aufhalten, erklärt aber nicht, warum sie das Gebäude betreten haben.
Ebenso kann ein Profil zeigen, dass eine Statusspalte unbekannte Werte enthält. Es kann nicht feststellen, ob diese Werte eine genehmigte fachliche Änderung darstellen.

Eine erste Inspektion sollte Folgendes klären:
Struktur: Welche Spalten existieren und welche Datentypen ihre Werte unterstützen.
Befüllung: Wo Werte fehlen und wie viele eindeutige Werte vorkommen.
Form: Welche Wertebereiche, wiederkehrenden Formate und häufig auftretenden Werte die Tabelle kennzeichnen.
Diese Messwerte geben Engineers einen Ausgangspunkt für die Erkundung. Ein datumsähnliches Textfeld kann eine genauere Prüfung verdienen; eine häufig wiederholte Kunden-ID kann in Transaktionen erwartet, in einem Kundenstamm aber verdächtig sein.
Evidenz speichern, nicht nur einen Bericht
Die Kernmessgrößen - Vollständigkeit, Eindeutigkeit, Typkonformität, Häufigkeit und Verteilung - gelten für relationale Datenbanken, Warehouses, Data Lakes und analytische Dateien gleichermaßen. Die Speichertechnologie ändert die Ausführungsmethode, nicht die gestellten Fragen.
Bewahren Sie das resultierende Profil als Referenz für spätere Beobachtungen auf. Halten Sie die Quelle und die Bedingungen fest, unter denen es erstellt wurde, statt nur ein Diagramm aufzubewahren, das später niemand reproduzieren kann.
Für Teams, die diese Nachvollziehbarkeit formalisieren, ist Fetchins Leitfaden zur Datenherkunft eine nützliche ergänzende Ressource. Die Herkunft gehört neben die statistischen Ergebnisse, weil Prüfer verstehen müssen, woher die Evidenz stammt.
Die praktische Grenze ist wichtig: Beobachtetes Verhalten ist nicht automatisch korrektes Verhalten. Profiling liefert Evidenz für eine Entscheidung, nicht die Erlaubnis, jedes häufige Muster in eine verbindliche Anforderung zu verwandeln.
Profiling-Techniken und Qualitätsmetriken
Ein ausgereifter Profiler braucht mehr als einen Zähler für fehlende Werte. In einer systematischen Evaluierung von 13 Datenqualitätswerkzeugen wurde einfaches Profiling breit unterstützt, während fortgeschrittene Abhängigkeits- und Mehrspaltenfunktionen nur in einzelnen Werkzeugen vorkamen, wie in der Frontiers-Evaluierung von Datenqualitätswerkzeugen beschrieben.
Evidenz passend zur Frage wählen
Organisieren Sie die Erfassung entlang dieser Evidenzklassen:
Evidenzklasse | Nützliche Berechnungen und Interpretation |
|---|---|
Kardinalitäten einzelner Spalten | Anzahl eindeutiger Werte und Duplikate zeigt Wiederholungen und mögliche Eindeutigkeit. |
Werteverteilungen | Quantile, Häufigkeitshistogramme und Ausreißerquoten beschreiben Konzentration und Streuung. |
Datentypen und Muster | Abgeleitete semantische Typen und Formatregelmäßigkeiten unterscheiden die Speicherdarstellung von der wahrscheinlichen Bedeutung. |
Wertebereiche | Beobachtete Wertemengen liefern Kandidaten für zulässige Werte, die geprüft werden sollten. |
Beziehungen zwischen und über mehrere Spalten | Schlüsselkandidaten und funktionale Abhängigkeiten zeigen mögliche Integritäts-Constraints. |
Erfassen Sie Null- und Leerwertraten explizit. Ein leerer String und ein Datenbank-Null müssen unter Umständen unterschiedlich behandelt werden; dokumentieren Sie daher jede Entscheidung, sie zusammenzufassen.

Abdeckung gegen Scan-Kosten abwägen
Versionieren Sie Messwerte nach Tabelle, Spalte, Partition und Beobachtungszeitpunkt. Andernfalls können Prüfer eine dauerhafte Verteilungsverschiebung nicht zuverlässig von einem isolierten Partitionsproblem unterscheiden.
Exakte Distinct-Zählungen und erschöpfende paarweise Abhängigkeitstests können bei großen Datensätzen teuer werden. Approximative Sketches, geschichtete Stichproben und inkrementelle Profile sind vernünftige Alternativen, doch validieren Sie Näherungen bei kritischen Datensätzen gegen exakte Berechnungen.
Die Wahl sollte sich nach den Folgen eines Fehlers richten. Explorative Erkundung verträgt Unsicherheit, die eine regulatorische Integritätsprüfung nicht verträgt.
Die Datenmanagement-Richtlinie von Queensland Health umfasst Genauigkeit, Validität, Zuverlässigkeit, Aktualität, Relevanz, Vollständigkeit und Eindeutigkeit. Diese Breite ist ein nützliches Korrektiv bei der Auswahl von Datenqualitätsmetriken: Leicht berechenbare Statistiken sollten nicht das gesamte Programm bestimmen.
Erkenntnisse in Kontrollen überführen
Ein genehmigter abgeleiteter Wertebereich kann zur Validierungsregel werden. Ein bestätigter Schlüsselkandidat kann zur Integritätsprüfung werden, während eine Verteilungs-Baseline Eingaben für die Anomalieerkennung liefern kann.
Fachlicher Abgleich erfordert weiterhin Domänenlogik. Teams, die beispielsweise mit Charter AI Bankbuchungen mit Buchhaltungsdatensätzen abgleichen, lösen eine fachliche Zuordnungsaufgabe und zählen nicht bloß eindeutige Transaktionsreferenzen.
Halten Sie diese Unterscheidung klar. Profiling hilft zu erkennen, was eine Kontrolle verdient; die fachlichen Verantwortlichen legen fest, was diese Kontrolle bedeuten muss.
Wenn mehr Profile mehr Rauschen erzeugen
Jede verfügbare Statistik zu erfassen, verbessert Entscheidungen nicht automatisch. Wenn niemand erklären kann, welche Abweichungen relevant sind, haben Engineers die Produktion von Benachrichtigungen automatisiert statt ein verlässliches Monitoring aufzubauen.
Normales Verhalten kann sich je nach Wochentag, Monatsende, Saison, Release-Zyklus oder Geschäftsereignis unterscheiden. Wer jeden Ladevorgang mit einem undifferenzierten historischen Durchschnitt vergleicht, lässt eine erwartete Änderung fehlerhaft aussehen.
Fehlende Daten von falschen Daten trennen
Das Data Quality Framework der britischen Regierung unterscheidet Vollständigkeit von Genauigkeit. Ein Datensatz kann alle erwarteten Einträge enthalten und dennoch falsche Werte aufweisen.
Messen Sie das Vorhandensein von Zeilen, fehlende Werte auf Feldebene und die Korrektheit von Werten getrennt. Ist eine Lieferung noch nicht abgeschlossen, erfordert ein scheinbares Vollständigkeitsproblem womöglich eine Untersuchung der Pipeline statt einer Korrektur der Datensätze.
Eine Änderung einer Metrik ist eine Beobachtung. Sie als Fehler zu bezeichnen, erfordert Kontext.
Die in Atlans State of Enterprise Data and AI zusammengetragenen Ergebnisse aus 2025 veranschaulichen dieses Kontextproblem: 97 % der Organisationen berichteten von Lücken bei Definitionen, Qualität und Vertrauen, während 52 % Bedenken bei Sicherheit und dem Zugriff auf sensible Daten nannten. Dieselbe Quelle berichtet, dass Führungskräfte die Datenreife ihrer Organisation um 12 % höher einschätzten als Praktiker, während fast 90 % der Datenfachleute mit Skalierung und Komplexität kämpften.
Diese Ergebnisse sprechen für eine vorsichtige Haltung im Betrieb: Gehen Sie nicht davon aus, dass zusätzliche Messwerte Meinungsverschiedenheiten über Bedeutung oder Reife auflösen.

Zeit und Auswirkung in die Triage einbeziehen
Nutzen Sie zeitbewusste Baselines und adaptive Schwellenwerte, wo das erwartete Verhalten schwankt. Prüfen Sie Fehlalarme explizit und halten Sie fest, ob ein Alarm zu einem bestätigten Fehler, einer akzeptierten fachlichen Änderung oder einer Untersuchung mit unzureichender Evidenz führte.
Die Modellierung erwarteter Lieferzeiten hilft, unvollständige Beobachtungsfenster von abgeschlossenen Ladevorgängen zu unterscheiden. Eine Lineage-bewusste Triage sollte die Abweichung mit Lieferverzögerungen, Schemaänderungen und den gefährdeten nachgelagerten Berichten oder Modellen verknüpfen.
Stellen Sie diese Zusammenhänge in Datenqualitäts-Dashboards dar, statt nur einen unerklärten roten Indikator zu zeigen. Ein Prüfer sollte sehen, was sich geändert hat, wem es gehört und welche Maßnahme möglich ist.
KI-Readiness erfordert mehr als statistische Normalität. Ohne semantische Definitionen, Verantwortlichkeiten und einen Weg zur Behebung begründet selbst ein technisch detailliertes Profil keine vertrauenswürdigen Trainings- oder Betriebsdaten.
In-Database-Profiling richtig auswählen
Machen Sie bei sensiblen Unternehmens-Workloads die kundenkontrollierte Ausführung zur Designanforderung. Legen Sie fest, wo Abfragen laufen, welche Identität sie ausführt und welche Evidenz die Umgebung verlassen darf, bevor Sie Oberflächenfunktionen vergleichen.
Eine von CIO Dive berichtete Enterprise-KI-Umfrage aus 2025 befragte 1.050 Führungskräfte und nannte Datenschutz- und Compliance-Vorgaben, Duplikate und ineffiziente Integration als führende Datenprobleme. Weniger als die Hälfte hielt ihre KI-Ziele für erreichbar.
Wo automatisiertes Profiling laufen sollte
Entscheidungsfrage | In-Database in der Kundenumgebung | Extern gehosteter Scan |
|---|---|---|
Wo werden Werte untersucht? | Innerhalb der kontrollierten Datenbankgrenze. | In der gehosteten Scan-Umgebung, falls Datensätze dorthin übertragen werden. |
Was darf die Umgebung verlassen? | Eine explizite Richtlinie für berechnete Metriken und Metadaten festlegen. | Exportierte Datensätze, gespeicherte Stichproben und abgeleitete Metadaten bewerten. |
Wessen Zugriff gilt? | Eine dedizierte Ausführungsidentität mit minimalen Rechten verwenden. | Connector-Berechtigungen und das Zugriffsmodell des gehosteten Dienstes prüfen. |
Wie wird die Last gesteuert? | Abfragen passend zur Datenbankkapazität einplanen. | Extraktionslast, Übertragung und externe Verarbeitung berücksichtigen. |
Was muss auditiert werden? | Datenbankausführung plus Profiling-Entscheidungen. | Extraktion, externer Zugriff, Aufbewahrung und Profiling-Entscheidungen. |
Eine gehostete Control Plane ist nicht zwangsläufig ein gehosteter Scanner. Fragen Sie gezielt, wo Datensätze verarbeitet werden, statt sich auf ein Deployment-Label zu verlassen.
Die autorisierte Sicht testen
Kann die Arbeit innerhalb der Umgebung einer Bank, eines Krankenhauses, eines Telekommunikationsanbieters oder einer Behörde bleiben? Welche Metadaten dürfen sie verlassen, und wer genehmigt diese Entscheidung?
Testen Sie verschlüsselte, maskierte, tokenisierte und auf Zeilenebene autorisierte Eingaben getrennt. Eine geänderte Tokenisierungsrichtlinie oder eine eingeschränkte Zeilensicht darf nicht als Fehler in den Quelldaten eingestuft werden; der Profiler kann nur die Darstellung beschreiben, die seine Identität sehen darf.
Fordern Sie Audit-Evidenz für Umfang, Identität, Zeitstempel, Regelversion, Zugriffsentscheidung und Behebungshistorie. In-Database-Ausführung ersetzt weder Zugriffskontrollen noch Ressourcenmanagement.
Eine Option innerhalb der eigenen Umgebung
In-Database-Verarbeitung von digna ist eine Option für dieses Ausführungsmuster. Checks und Metrikberechnung bleiben in der Kundendatenbank, das Deployment erfolgt in der Private Cloud oder On-Premises, und der Anbieter hat keinen Zugriff auf Produktionsdaten.
Die Module decken erlernte Anomalie-Baselines ohne händisches Anlegen jedes Checks, historische Metriktrends, erwartete Lieferzeiten, Validierung auf Datensatzebene sowie hinzugefügte, entfernte oder umtypisierte Spalten ab. Das erste Modul umfasst ein gemeinsames Dashboard, Scheduler, Katalog, Integrationen und Funktionen für die Zusammenarbeit.
Das Preismodell besteht aus einer Grundgebühr plus einer Gebühr pro aktiver Tabelle und Modul, ohne Gebühren für API-Aufrufe, Scans oder Alarmvolumen. Laut Anbieter liegen erste Erkenntnisse in unter zwei Stunden vor; behandeln Sie das als Onboarding-Versprechen, das Sie während der Evaluierung anhand Ihrer Konnektivität, Berechtigungen und Workloads prüfen.
Enterprise-Workflows für Profiling und Monitoring
Beginnen Sie mit einem Referenzprofil, nicht mit einem leeren Regeleditor. In einer begutachteten Studie aus 2022 zum Monitoring mit Referenzprofilen implementierten Forschende DQ-MeeRKat und evaluierten es an sechs realen Datenströmen von Telematikgeräten.
Die Methode erlernte automatisch Sammlungen von Profiling-Statistiken, um die Zielqualität zu modellieren. Sie unterstützte die Initialisierung über kontinuierliches Monitoring, ohne dass Fachexperten vorab jede Regel schreiben mussten.
Jede Beobachtung an die richtige Prüfung weiterleiten
Initialisieren Sie die Referenz, lassen Sie einen Fachexperten ihre Eignung bewerten, und vergleichen Sie eingehende Ladevorgänge mit der genehmigten Version. Halten Sie Vergleich und operative Reaktion miteinander verbunden.
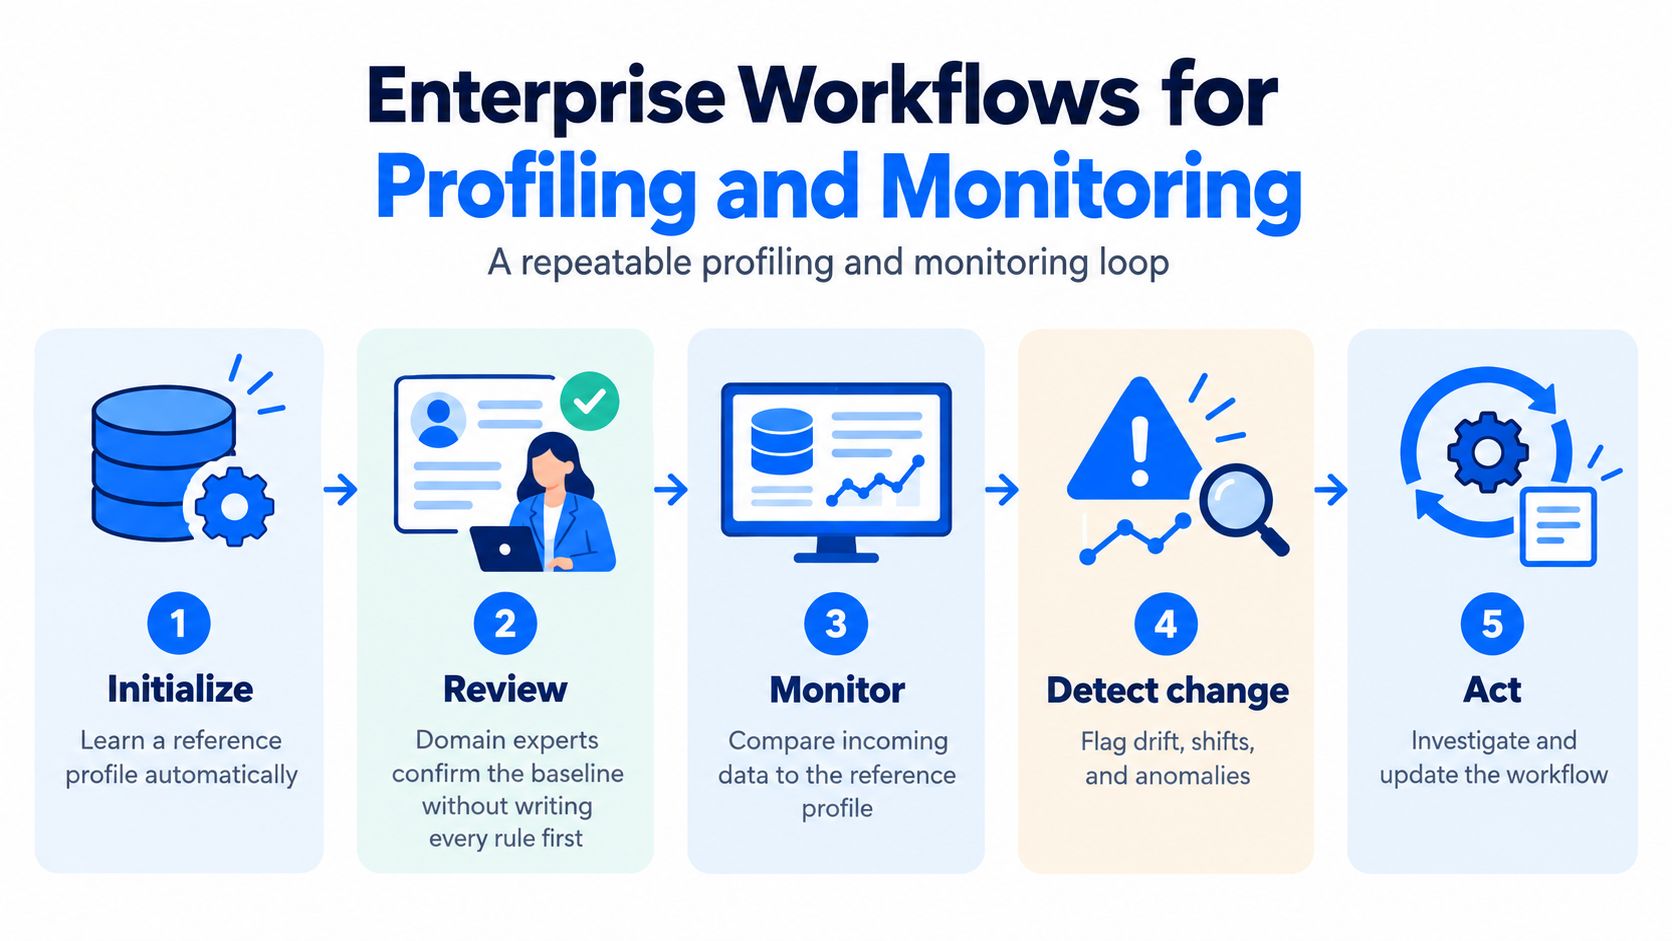
Nutzen Sie getrennte Übergaben, statt jede Beobachtung in dieselbe Warteschlange zu schicken:
Verteilungsabweichung: Weisen Sie eine Anomalieprüfung zu, um festzustellen, ob sich das Geschäft geändert oder die Pipeline einen Fehler eingeführt hat.
Fehlende oder verfrühte Lieferung: Leiten Sie an die Prüfung der Aktualität weiter, mit erwarteter Lieferzeit und Nachweis der tatsächlichen Ankunft.
Vermuteter Verstoß gegen eine Geschäftsregel: Führen Sie eine Validierung auf Datensatzebene durch, um die betroffenen Datensätze zu identifizieren.
Hinzugefügte, entfernte oder umtypisierte Spalten: Starten Sie eine Schemaprüfung, bevor abhängige Transformationen weiterlaufen.
Branchenanforderungen bestimmen die Eskalation. Im Finanzwesen haben Risiko- und Regulierungsfeeds Vorrang vor dem Reporting; im Gesundheitswesen sind klinische und operative Lieferanforderungen zu unterscheiden.
Telekommunikationsteams sollten Abweichungen in großvolumigen Kundendaten mit Pipeline-Verzögerungen verknüpfen. Teams im öffentlichen Sektor sollten nachvollziehbare Entscheidungen und prüfungsfeste Evidenz sichern.
Unsicherheit sichtbar halten
Fehlende Werte können falsche funktionale Abhängigkeiten erzeugen. Forschung zur automatisierten Erkennung von Schemata und Abhängigkeiten berichtet zudem von einer Evaluierung, in der der Anteil exakt und vollständig generierter Schemata von 60 % auf 72 % stieg, wenn das System die fünf besten Kandidaten statt eines einzigen Ergebnisses lieferte.
Das spricht für gerankte Hypothesen, Konfidenzwerte und menschliche Freigabe statt der automatischen Übernahme der erstbesten Antwort. Prüfer müssen plausible Alternativen sehen, wenn Namen, Typen, Schlüssel oder Beziehungen unsicher sind.
Freigabegrenze: Lassen Sie die Automatisierung die Interpretation vorschlagen. Lassen Sie folgenreiche Constraints von einer verantwortlichen Person freigeben.
Eine integrierte Plattform kann diesen Ablauf abbilden, ohne zum Eigentümer der fachlichen Bedeutung zu werden. Legen Sie Verantwortlichkeiten für Monitoring und Reporting fest, damit Engineers die Ausführung übernehmen, Fachverantwortliche die Bedeutung bewerten und Governance-Prüfer Entscheidungen rekonstruieren können.
Schließen Sie einen Vorfall erst, wenn jemand Ursache, Maßnahme und Baseline-Entscheidung dokumentiert hat. Eine akzeptierte fachliche Änderung kann eine Aktualisierung der Referenz rechtfertigen; ein Pipeline-Fehler sollte nicht in das normale Verhalten aufgenommen werden.
Automatisiertes Data Profiling bei kritischen Tabellen starten
Wählen Sie eine kritische Tabelle, deren Ausfall einen Bericht, ein Modell oder eine regulatorische Ausgabe beeinträchtigen würde. Bevorzugen Sie eine Tabelle mit einem identifizierbaren fachlichen Verantwortlichen und einem Engineer, der ihren Lieferweg kennt.
Halten Sie fest, welche Entscheidung sie unterstützt und was ein Ausfall bedeuten würde. Das gibt Prüfern eine konkrete Grundlage, um Erkenntnisse zu priorisieren, statt jede Abweichung als gleich dringend zu behandeln.
Die erste Betriebsgrenze definieren
Profilieren Sie die Tabelle direkt an Ort und Stelle und bewahren Sie die Evidenz auf, die nötig ist, um die Inspektion zu wiederholen. Halten Sie Snapshot, Quellabfrage oder Sampling-Richtlinie, Algorithmusversion, Konfidenz und Freigabeentscheidung zusammen.
Übernehmen Sie einen Schlüssel, Typ oder eine Abhängigkeit mit geringer Konfidenz nicht direkt in die produktive Durchsetzung. Lassen Sie den Verantwortlichen erklären, ob der vorgeschlagene Constraint eine Anforderung widerspiegelt oder nur ein Muster in der beobachteten Stichprobe.

Die Prüfung wiederholbar machen
Geben Sie dem Pilotprojekt eine kleine, explizite Betriebsvereinbarung:
Prüfer benennen: Weisen Sie Data Engineer und fachlichen Verantwortlichen zu, bevor Benachrichtigungen aktiviert werden.
Reaktion festlegen: Bestimmen Sie, wer eine Beobachtung untersucht und wer eine Baseline-Änderung freigeben darf.
Nachgelagerte Nutzung schützen: Entscheiden Sie, welche Schemaänderungen eine Prüfung erfordern, bevor abhängige Jobs die Tabelle verarbeiten.
Ergebnis festhalten: Dokumentieren Sie, ob der Vorfall ein Lieferproblem, fehlerhafte Daten oder eine akzeptierte Änderung war.
Vergleichen Sie jeden neuen Ladevorgang mit der genehmigten Referenz. Trennen Sie verspätete Ankunft von echter Verteilungsänderung, und untersuchen Sie strukturelle Änderungen, bevor Sie sie als harmlos einstufen.
Besprechen Sie den ersten erklärbaren Vorfall gemeinsam. Der Engineer sollte zeigen können, was in der Pipeline passiert ist, und der fachliche Verantwortliche die Folgen für den nachgelagerten Prozess beschreiben können.
Erweitern Sie Modul für Modul erst, wenn dieser Kreislauf funktioniert. Mehr Abdeckung ist nützlich, wenn das Team untersuchen und handeln kann, nicht nur, wenn es mehr Beobachtungen erzeugen kann.
Für einen begrenzten Rollout installieren Sie die Plattform in der bestehenden Cloud, VPC oder im Rechenzentrum, inspizieren die ausgewählte Tabelle und prüfen Anomalien, Aktualität und Schemastatus im gemeinsamen Dashboard. Halten Sie diese Prüfung so eng, dass das Team eine Entscheidung treffen und dokumentieren kann.
digna bietet für dieses Betriebsmodell Baseline-Lernen innerhalb Ihrer Umgebung, Anomalie-Monitoring, Aktualitätsprüfungen, Datensatzvalidierung und Schema-Tracking. Besuchen Sie digna, um die Plattform an einer kritischen Tabelle zu evaluieren, und prüfen Sie die ersten Erkenntnisse mit Ihrem Data Engineer und fachlichen Verantwortlichen, bevor Sie die Abdeckung ausweiten.
Sobald ein Referenzprofil existiert, besteht der nächste Schritt darin, es aktuell zu halten, ohne für jede Spalte eine Regel zu schreiben: Das Data Anomalies Modul von digna erlernt für jede Tabelle die normalen Volumina, Verteilungen und Null-Raten und meldet Abweichungen, sobald neue Ladevorgänge eintreffen. So wird aus der Baseline eine kontinuierliche Erkennung statt eines einmaligen Berichts.
Häufig gestellte Fragen
Was ist automatisiertes Data Profiling?
Automatisiertes Data Profiling misst systematisch, was ein Datensatz tatsächlich enthält - Spaltentypen, Null-Werte, eindeutige Werte, häufige Muster, Wertebereiche und Verteilungen -, bevor Analysten oder Modelle darauf aufbauen. Ergebnis ist eine gespeicherte Baseline, mit der spätere Ladevorgänge verglichen werden, statt eines einmaligen Berichts, den niemand reproduzieren kann.
Warum funktionieren handgeschriebene Datenqualitätsregeln im großen Maßstab nicht mehr?
Statische Regeln beantworten nur Fragen, an die bereits jemand gedacht hat. Ändern sich Quellen, Berichte und Verantwortliche, entstehen lückenhafte Abdeckung, SQL, das nach dem Weggang des Autors niemand mehr erklären kann, und Alarmmüdigkeit durch veraltete Checks, während neue Kategorien oder verschobene Verteilungen unbemerkt bleiben.
Welche Metriken sollte ein Datenprofil enthalten?
Ein nützliches Profil umfasst Vollständigkeit, Eindeutigkeit, Typkonformität, Häufigkeit und Verteilung sowie explizite Null- und Leerwertraten, da ein leerer String und ein Datenbank-Null unterschiedlich behandelt werden müssen. Ausgereifte Profiler ergänzen Wertebereiche, Schlüsselkandidaten und funktionale Abhängigkeiten, versioniert nach Tabelle, Spalte, Partition und Beobachtungszeitpunkt.
Wie lassen sich Fehlalarme beim Data Profiling reduzieren?
Setzen Sie zeitbewusste Baselines und adaptive Schwellenwerte ein, denn normales Verhalten unterscheidet sich nach Wochentag, Monatsende, Saison oder Release-Zyklus. Trennen Sie fehlende von falschen Daten, modellieren Sie erwartete Lieferzeiten und dokumentieren Sie, ob ein Alarm zu einem bestätigten Fehler, einer akzeptierten Änderung oder einer ergebnislosen Prüfung führte.
Sollte Data Profiling in der Datenbank oder in einem gehosteten Scanner laufen?
Für sensible Unternehmensdaten ist In-Database-Profiling in der Kundenumgebung die sicherere Wahl. Die Werte bleiben innerhalb der kontrollierten Grenze, eine Identität mit minimalen Rechten führt die Abfragen aus, und nur berechnete Metriken verlassen sie nach klarer Richtlinie. Bei einem externen Scanner sind exportierte Datensätze, gespeicherte Stichproben und Connector-Rechte zu prüfen.


