Observability vs. Monitoring: Ein praktischer Entscheidungsleitfaden
|
7
min. Lesezeit

Der schlechteste Rat in dieser Debatte ist zugleich der einfachste: Observability einführen und Monitoring abschaffen. Das klingt modern, ist für echte Datenteams aber falsch. Monitoring ist Ihre Kontrollschicht, Observability Ihre Diagnoseschicht, und die richtige Antwort hängt davon ab, was ein Fehler bei der jeweiligen Workload kostet.
Entscheidungskriterium | Monitoring | Observability |
|---|---|---|
Hauptaufgabe | Bekannte Fehlerzustände erkennen | Unbekannte oder mehrschichtige Ausfälle erklären |
Beste Evidenz | Schwellenwerte, Alerts, stabile Signale | Korrelierte Metriken, Logs, Traces und Kontext |
Auditierbarkeit | Hoch, wenn Kontrollen explizit sind | Schwächer, wenn sie explizite Kontrollen ersetzt |
Kostenprofil | Geringer und enger gefasst | Höher und breiter angelegt |
Am besten geeignet für | Stabile, gut verstandene Fehlerbilder | Komplexe, verteilte Ausfälle oder Ausfälle mit großer Tragweite |
Inhaltsverzeichnis
Warum die Debatte Observability vs. Monitoring an der eigentlichen Frage vorbeigeht
Wo sich KI-Anomalieerkennung und Schema-Tracking wirklich lohnen
Tool-Fragmentierung und die wahren Hindernisse für eine einheitliche Abdeckung
Ein hybrides Betriebsmodell und branchenspezifische Konsequenzen
Warum die Debatte Observability vs. Monitoring an der eigentlichen Frage vorbeigeht
Die Diskussion wird meist wie ein Pferderennen dargestellt, als müsse eine Disziplin die andere ablösen. Diese Sichtweise ist bequem, aber falsch. Monitoring und Observability lösen unterschiedliche Probleme, und wer das eine durch das andere ersetzt, schafft blinde Flecken statt Klarheit.
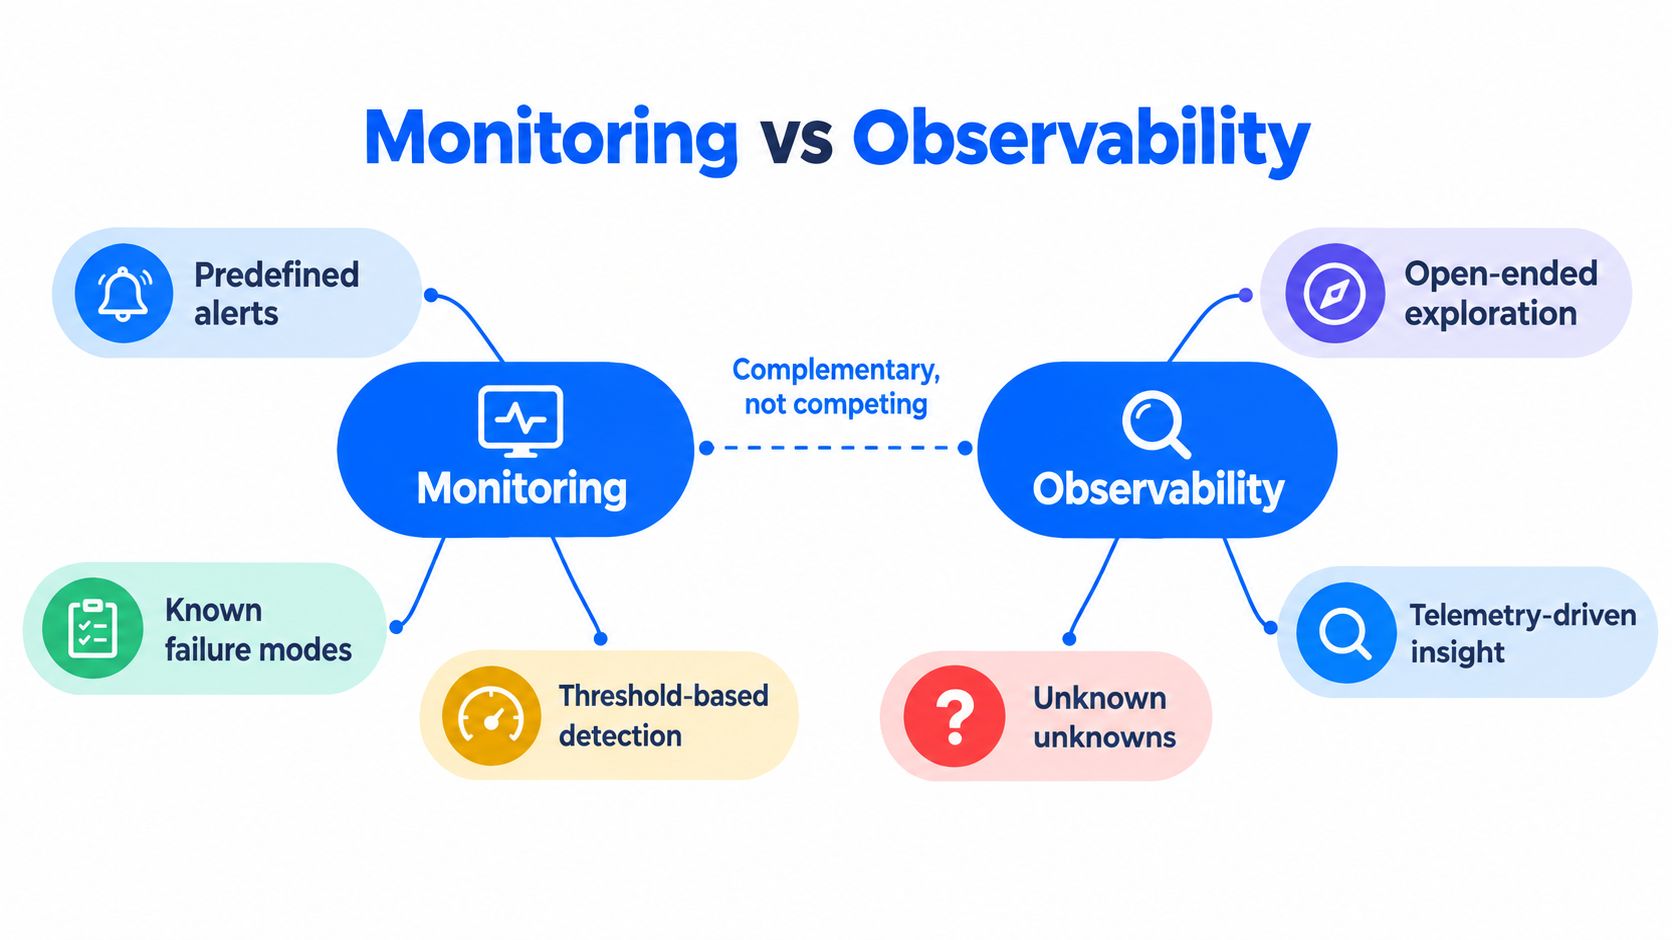
Monitoring ist explizite Kontrolle. Sie definieren das Signal, legen den Grenzwert fest und lösen einen Alert aus, wenn die Realität ihn überschreitet. Observability geht weiter: Sie soll den internen Zustand aus den ausgegebenen Daten ableitbar machen, damit Engineers auch unbekannte Ausfälle erklären können, statt nur erwartete zu bestätigen. Die praktische Frage ist nicht, welcher Begriff zeitgemäßer klingt, sondern welche Diagnosetiefe die jeweilige Workload rechtfertigt.
Das ist wichtig, denn wer Monitore durch breite Observability ersetzt, kann die Governance schwächen. Implizite Kontrollen sind schwerer zu auditieren. Für eine Datenplattform ist das ein schlechter Tausch. Ein fehlender Load, ein defektes Schema oder ein driftender KPI braucht keine philosophische Eleganz, sondern einen klaren Verantwortlichen, einen Alert und einen nachvollziehbaren Evidenzpfad.
Praxisregel: Behalten Sie explizite Monitore für bekannte Fehlerbilder und ergänzen Sie Observability nur dort, wo Sie Ursachentiefe, Korrelation oder explorative Diagnose brauchen.
Googles Buch Site Reliability Engineering hat die vier Golden Signals für nutzerorientierte Services formalisiert: Latenz, Traffic, Fehler und Sättigung. Diese Basis trägt bis heute, weil sie Teams eine kompakte Monitoring-Schicht für bekannte Probleme liefert. Datenplattformen brauchen jedoch mehr als Service-Health. Sie müssen auch Aktualität, Schemastabilität, die Gültigkeit von Datensätzen, das Verhalten von Business-Metriken und den Workload-Verbrauch im Blick behalten.
Wenn Sie entscheiden, wo Sie investieren, hören Sie auf zu fragen, ob Observability besser ist als Monitoring. Fragen Sie stattdessen, welche Evidenz Sie brauchen, wenn ein Datensatz, eine Pipeline oder ein Report fehlerhaft ist, und wie teuer es ist, zu spät, zu ungenau oder falsch zu liegen.
Was Monitoring und Observability wirklich bedeuten
Monitoring ist eine vordefinierte Erkennungsfunktion. Teams wählen Indikatoren wie Request-Rate, Fehlerrate, Latenz, CPU-Auslastung oder den Ankunftsstatus von Daten und lösen einen Alert aus, wenn Werte einen Schwellenwert überschreiten oder einen erwarteten Bereich verlassen. Damit beantwortet Monitoring eine enge, aber essenzielle Frage: Liegt ein bekannter Zustand außerhalb seines Grenzwerts?
Observability geht weiter. Sie fragt, ob Sie den internen Zustand eines Systems aus den Daten ableiten können, die es ausgibt. In der Praxis heißt das, Metriken, Logs und Traces zu korrelieren, damit Engineers einen Ausfall untersuchen können, den sie beim Schreiben des Alerts nicht vorhergesehen haben.
Die Basis, mit der die meisten Teams starten sollten
Die klassische Sicht auf Service-Level bleibt relevant. Das SRE-Modell von Google liefert eine minimale Monitoring-Basis mit Latenz, Traffic, Fehlern und Sättigung. Diese Signale sind nützlich, weil sie Disziplin erzwingen. Ein Latenz-Alert sagt Ihnen, dass der Service langsam ist, Traffic zeigt eine veränderte Nachfrage, Fehler zeigen fehlgeschlagene Requests, und Sättigung zeigt, dass eine knappe Ressource fast ausgelastet ist. Mehr Theorie brauchen Sie dafür nicht.
Für Datenplattformen lässt sich das direkt übertragen, aber nicht eins zu eins. Ersetzen Sie Service-Latenz durch Aktualität und Lieferzeitpunkte. Ersetzen Sie Traffic durch Workload- und Nutzungsmuster. Ersetzen Sie Fehler durch fehlgeschlagene Jobs, ungültige Datensätze oder defekte Transformationen. Ersetzen Sie Sättigung durch die Last auf Warehouse, Cluster oder Pipeline.
Monitoring sagt Ihnen, dass etwas eine Grenze überschritten hat. Observability hilft Ihnen zu erklären, was sich verändert hat, wo es sich verändert hat und was davon noch betroffen ist.
Genau deshalb erleben Datenteams böse Überraschungen, wenn sie ein grünes Dashboard als Beweis für Korrektheit werten. Ein Dashboard kann verfügbar und trotzdem analytisch falsch sein, weil die Daten veraltet, unvollständig, dupliziert oder strukturell verändert sind. Wenn Ihr Geschäft von diesem Ergebnis abhängt, brauchen Sie beides: die Kontrolle und die Evidenz.
Einen praktischen Einstieg bietet der Data-Observability-Ansatz von digna.
Ziele, Telemetrie sowie Erkennung versus Diagnose
Am klarsten lassen sich die beiden Disziplinen trennen, wenn Sie vergleichen, wozu sie dienen, welche Evidenz sie nutzen und wie weit sie Sie bringen. Monitoring verfolgt Kontrollziele. Observability dient der Diagnose. Das eine ist für bekannte Grenzwerte gebaut, das andere für Untersuchungen unter Unsicherheit.
Entscheidungsmatrix
Kriterium | Monitoring | Observability |
|---|---|---|
Kontrollziel | Bekannte Grenzwerte und Service-Erwartungen durchsetzen | Internes Verhalten und neu auftretende Fehlermuster erklären |
Typischer Auslöser | Schwellenwertverletzung, fehlender Job, fehlgeschlagene Regel, verspätete Lieferung | Ungewöhnliche Korrelation, Verhaltensänderung, unerklärte Anomalie |
Telemetrie-Schwerpunkt | Aggregierte Metriken und Alerts | Korrelierte Metriken, Logs, Traces und umfassenderer Kontext |
Beantwortete Frage | Was ist passiert, und wurde die Toleranz überschritten? | Was hat sich verändert, warum, und was könnte noch betroffen sein? |
Verantwortungsmuster | Klarer operativer Verantwortlicher für bekannte Checks | Funktionsübergreifende Diagnose über Plattform-, Daten- und Applikationsteams hinweg |
Audit-Trail | Stark, wenn Kontrollen explizit sind | Stärker für Untersuchungen als für formale Kontrollnachweise |
Kostenprofil | Meist enger gefasst und günstiger im Betrieb | Breiter, teurer und leichter zu überdimensionieren |
Die grundlegende Aufteilung von OpenTelemetry ist hier hilfreich. Metriken sind Laufzeitmessungen, Logs sind Ereignisaufzeichnungen, und Traces sind Request-Pfade durch Services. Der eigentliche Sinn liegt in der Korrelation. Eine Metrik zeigt, dass die Latenz gestiegen ist, ein Trace zeigt, welcher Pfad langsamer wurde, und Logs erklären das Ereignis, das die Ursache war. Die Observability-Materialien von IBM bringen es ebenso einfach auf den Punkt: Metriken alarmieren, Traces zeigen Ausführungspfade, und Logs liefern den Kontext für die Behebung.
Für Datenteams bedeutet das: Telemetrie wählen Sie nicht nach Mode, sondern nach diagnostischem Wert. Wenn ein fehlgeschlagener Batch-Job das Problem ist, kann ein Monitor genügen. Wenn ein nachgelagertes Modell, ein Report oder ein Kunden-Workflow falsch ist, brauchen Sie den zusätzlichen Kontext, um das Symptom mit der Ursache zu verbinden.
Die richtige Evidenz für die richtige Aufgabe
Monitoring für Kontrollen: Setzen Sie es ein, wenn das Fehlerbild bekannt, der Grenzwert stabil und die Evidenz explizit sein muss.
Observability für die Diagnose: Setzen Sie sie ein, wenn die Ursache unklar, der Abhängigkeitsgraph unübersichtlich oder mehrere Systeme beteiligt sein könnten.
Beides zusammen: Setzen Sie beides ein, wenn ein Fehler teuer ist und unbemerkt bleiben könnte.
Wenn Sie eine operativere Perspektive suchen, beginnen Sie mit den Observability Best Practices für Datenteams. Es geht nicht darum, alles zu sammeln. Es geht darum, genug Evidenz zu sammeln, damit die nächste Entscheidung belastbar ist.
Erkennungsszenarien in einer Datenplattform
Abstrakte Definitionen bringen Teams nicht weiter. Incidents schon. Am einfachsten trennen Sie Monitoring von Observability, indem Sie beide an den Ausfällen messen, die Datenplattformen tatsächlich hervorbringen.
Fehlgeschlagener nächtlicher Load und verspätete Lieferung
Ein fehlgeschlagener Batch-Job ist der einfachste Fall. Monitoring sollte den abgebrochenen Lauf, die fehlende Tabelle oder die verspätete Ankunft erkennen. Der Alert sollte unmissverständlich und handlungsorientiert sein. Observability bringt nur dann einen Mehrwert, wenn der Ausfall nicht offensichtlich ist, zum Beispiel wenn der Job durchgelaufen ist, aber eine Abhängigkeit hängen blieb, eine Partition nicht ankam oder die Daten erst nach Ablauf des geschäftlichen Zeitfensters eintrafen.
Genau hier zählt die Überwachung der Pünktlichkeit. Wenn ein regulatorischer Feed, ein Finanzextrakt oder ein operativer Snapshot eine Deadline hat, sollte der Alert melden, dass die Daten zu spät sind. Die Observability-Schicht sollte zeigen, ob sich die Quelle verzögert hat, der Transfer hinterherhinkte oder ein nachgelagerter Schritt den Datensatz zurückgehalten hat.
Stille Schemaänderung und Brüche in nachgelagerten Systemen
Bei Schema Drift ist Monitoring allein besonders schwach. Die Pipeline läuft womöglich weiter, aber der Data Contract ist gebrochen. Monitoring kann eine fehlende Spalte, einen fehlgeschlagenen Parse-Vorgang oder eine Regelverletzung erkennen, sofern Sie den Check bereits geschrieben haben. Observability braucht Schemakontext, Lineage und die betroffenen Konsumenten, damit Sie sehen, was sich geändert hat und welcher Report oder welches Modell nun nicht mehr vertrauenswürdig ist.
KPI-Einbruch und geschäftliche Auswirkungen
Ein Einbruch im Umsatzreporting ist ein anderes Problem. Die Daten können technisch noch gültig sein, aber das Geschäftsergebnis hat sich verschoben. Monitoring kann die KPI-Abweichung melden, wenn Sie sie explizit überwachen. Observability ist dann nützlich, wenn Sie diese Veränderung mit Volumen, Saisonalität, Upstream-Verhalten oder einer Workload-Verschiebung in den Quellsystemen in Verbindung bringen müssen.
In-Database-Ausführung und -Analyse
Der beste Diagnosepfad endet oft im Warehouse oder Lake selbst. Wenn Sie Checks direkt vor Ort berechnen, reduzieren Sie Datenbewegungen und halten die Evidenz nah an den Daten. Für sensible Umgebungen ist das deutlich besser geeignet, als Kopien von Datensätzen über zusätzliche Tools zu verteilen.

Wenn Sie mit anomalieintensiven Datensätzen arbeiten, sind die Arten der Anomalieerkennung die richtige nächste Frage. Verkomplizieren Sie aber keine statischen Referenztabellen oder Append-only-Compliance-Feeds. Diese Workloads brauchen in der Regel zuerst solides Monitoring, keine aufwendige Exploration.
Telemetrie-Stacks und was sie wirklich kosten
Beim Tooling scheitern gute Vorsätze am häufigsten. Teams glauben meist, sie kaufen Transparenz, und stellen dann fest, dass sie Einrichtungsaufwand, Integrationsbremsen und eine weitere Alert-Warteschlange gekauft haben.
Die eigentlichen Kosten sind operative Reibungsverluste
In der Umfrage von Grafana Labs aus dem Jahr 2025 mit 1.255 Befragten war Komplexität die größte Sorge im Bereich Observability, Alert Fatigue das größte Hindernis für eine schnellere Incident Response, und die Ausgaben für Observability lagen im Schnitt bei 17 % der gesamten Ausgaben für Compute-Infrastruktur. Daraus folgen zwei Dinge. Erstens: Observability ist nicht kostenlos. Zweitens: Mehr Telemetrie bedeutet nicht automatisch schnellere Diagnose. Sie kann auch einfach mehr Arbeit bedeuten.
Offene Standards helfen, beseitigen den Aufwand aber nicht. OpenTelemetry und Stacks der Prometheus-Klasse erleichtern es, Daten zu bewegen und die Instrumentierung portabel zu halten. Sie reduzieren aber nicht wie von Zauberhand das Alert-Rauschen, den Aufbau von Datenpipelines oder die Abstimmung, die nötig ist, um aus Signalen Maßnahmen zu machen.
Den Stack nach dem Wert der Evidenz wählen
Stack-Muster | Bester Einsatz | Wichtigster Kompromiss |
|---|---|---|
Metrics-first-Monitoring | Stabile Services, bekannte SLOs, explizite Alerts | Geringere Diagnosetiefe |
Metriken plus Logs plus Traces | Verteilte Systeme und mehrstufige Untersuchungen | Höherer Aufwand für Einrichtung und Korrelation |
In-Database-Ausführung | Sensible Daten, Warehouse-zentrierte Workloads, weniger Datenbewegung | Weniger Flexibilität, wenn Sie das Modell zu stark einschränken |
Ein In-Database-Ansatz verändert die Wirtschaftlichkeit. Die Daten bleiben, wo sie sind, Datenbewegungen sinken, und der Ansatz passt zu Umgebungen, in denen Governance ebenso wichtig ist wie Geschwindigkeit. Für Enterprise-Datenplattformen ist das oft die richtige Antwort, denn Telemetrie sollte nah an den Daten liegen, die sie beschreibt. Wenn Sie das halbe Warehouse kopieren müssen, nur um es zu messen, betreiben Sie wahrscheinlich zu viel Aufwand.

Wenn Sie eine einzige praktische Empfehlung möchten: Nutzen Sie den günstigsten Stack, der für die jeweilige Workload noch eine belastbare Diagnose liefert. Alles darüber hinaus ist Dekoration.
Wo sich KI-Anomalieerkennung und Schema-Tracking wirklich lohnen
KI-Anomalieerkennung ist dann nützlich, wenn statische Schwellenwerte versagen. Wenn ein Datensatz volatile Umsätze, sprunghaftes Kundenverhalten, Sensorrauschen oder maschinell erzeugte Ereignisse enthält, werden feste Grenzwerte zu stumpfen Werkzeugen. Gelernte Baselines und kontinuierlicher Abgleich können relevante Abweichungen erkennen, ohne dass Teams jede Regel von Hand nachjustieren müssen.
Statistische Erkennung dort einsetzen, wo sich Verhalten verändert
Genau hier lohnt sich KI-gestützte Anomalieerkennung. Sie hilft, wenn sich die Form der Daten im Zeitverlauf verändert und das Signal wichtiger ist als die exakte Zahl. Ein Schwellenwert kann Ihnen sagen, dass etwas hoch ist. Eine Baseline kann Ihnen sagen, dass etwas ungewöhnlich ist.
Schlecht geeignet ist sie für statische Referenztabellen, deterministische Schlüssel und Append-only-Compliance-Feeds. Diese Workloads brauchen keine Raffinesse. Sie brauchen verlässliche Checks und klare Verantwortlichkeiten.
Die Kontrolle auf den Datensatz abstimmen
Aktualität und Pünktlichkeit: Setzen Sie Ankunfts-Monitoring ein, wenn es dem Business darauf ankommt, wann Daten eintreffen, und nicht nur, ob sie eintreffen.
Schema-Tracking: Setzen Sie es überall dort ein, wo nachgelagerte Konsumenten auf eine stabile Struktur angewiesen sind.
Validierung von Datensätzen: Setzen Sie sie ein, um Geschäftsregeln durchzusetzen, besonders wenn Audit-Nachweise zählen.
In-Database-Ausführung: Setzen Sie sie ein, wenn Sicherheit, Governance oder Datenbewegung die limitierenden Faktoren sind.
Der typische Fehler in der Praxis besteht darin, jeden Datensatz als gleich dynamisch zu behandeln. Das ist er nicht. Eine Slowly Changing Dimension verdient nicht dieselbe Observability-Rechnung wie ein transaktionaler Feed mit hohem Volumen oder ein volatiler Umsatzstrom.
Ich würde Schema-Tracking und Anomalieerkennung auch gedanklich voneinander trennen. Schema Drift ist strukturell. Anomalieerkennung ist verhaltensbezogen. In einer ernstzunehmenden Datenlandschaft brauchen Sie beides, doch sie lösen unterschiedliche Probleme und sollten nicht mit demselben Argument begründet werden.
Wenn Sie entscheiden, wo Sie investieren, ist wie KI Datenanomalien in Pipelines erkennt die richtige Perspektive. Setzen Sie Intelligenz dort ein, wo die Varianz real ist, und nicht dort, wo eine Regel die Aufgabe sauber erledigt.
Tool-Fragmentierung und die wahren Hindernisse für eine einheitliche Abdeckung
Wäre Observability nur ein Tooling-Upgrade, wäre eine einheitliche Abdeckung längst Standard. Das ist sie nicht. Eine CNCF-Umfrage aus dem Jahr 2026 unter 407 Praktikern ergab, dass 46,7 % der Organisationen zwei oder drei Observability-Tools parallel betreiben, während nur 7,4 % eine einheitliche Observability-Erfahrung erreicht haben. Die Konfiguration von Dashboards und Alerts war mit 54 % die größte Herausforderung beim Setup.

Darum geht es. Das Schwierige ist nicht, eine weitere Plattform zu kaufen. Schwierig ist es, Telemetrie so in einen Workflow einzubinden, dass am Ende eine umsetzbare Diagnose steht und nicht noch mehr Browser-Tabs. Integrationskomplexität und der Aufbau von Datenpipelines bremsen Teams, weil jedes zusätzliche Signal Arbeit für Engineers, Operatoren und Analysten erzeugt.
Betriebsregel: Instrumentieren Sie möglichst wenige Datensätze auf der tiefsten Ebene und lassen Sie den Rest unter explizitem Monitoring. Flächendeckende Abdeckung erzeugt meist nur Alert Fatigue und schwache Verantwortlichkeiten.
Deshalb ist Observability-Reife auch zuerst ein Workflow-Problem und erst dann ein Tooling-Problem. Wenn niemand für den Monitor verantwortlich ist, wird der Alert zu Rauschen. Wenn niemand das Signal erklären kann, werden die Daten zur Dekoration. Richten Sie die Tiefe der Abdeckung an der Kritikalität aus, nicht am Optimismus.
Für einen praktischen Umsetzungspfad passen die Data-Observability-Tools von digna zum Modell der selektiven Tiefe. Der richtige Stack ist der, den Ihr Team auch betreiben kann.
Ein hybrides Betriebsmodell und branchenspezifische Konsequenzen
Das belastbare Modell ist hybrid. Monitoring deckt Kontrollziele, Audit-Nachweise und stabile Service-Level-Erwartungen ab. Observability deckt explorative Diagnose, Baselining und neu auftretende Ausfälle ab. Das ist kein Kompromiss, sondern Disziplin.
Am wichtigsten ist das in regulierten Umgebungen oder dort, wo Fehler eine große Tragweite haben. Im Finanzsektor brauchen Sie explizite Checks für Finanz-, Risiko-, Melde- und Transaktionsdaten, weil die Evidenz vor Prüfern und Operations-Teams bestehen muss. Im Gesundheitswesen zählen Zuverlässigkeit und Nachvollziehbarkeit, weil klinische und operative Daten nicht unbemerkt abdriften dürfen. In der Telekommunikation ändert sich das Verhalten bei hohem Volumen schnell. Sie brauchen also starkes Monitoring plus genug Observability, um Lastspitzen, Lieferprobleme und den Plattformverbrauch zu erklären. Im öffentlichen Sektor sind auditfähige Evidenz und Konsistenz wichtiger als eine glänzende Abdeckung.
Eine einfache Betriebsrichtlinie
Überwachen Sie, was nicht unbemerkt ausfallen darf. Nutzen Sie explizite Kontrollen für fehlende Loads, veraltete Daten, Schemaänderungen und Verstöße gegen Geschäftsregeln.
Beobachten Sie, was Sie nicht vorhersagen können. Ergänzen Sie tiefere Telemetrie dort, wo der Fehlerpfad mehrdeutig, verteilt oder aufwendig zu entwirren ist.
Bewerten Sie jede Workload neu. Wenn sich die Daten schneller ändern als Ihre Schwellenwerte, verlagern Sie mehr von dieser Workload in die Observability.
Der größte Fehler ist die Annahme, eine Disziplin sei die ausgereifte Version der anderen. Sie sind Partner mit unterschiedlichen Aufgaben. Monitoring sorgt dafür, dass das Licht brennt. Observability erklärt, warum es geflackert hat.
Für Enterprise-Datenteams ist das die ganze Entscheidung. Ordnen Sie jede Workload der Disziplin zu, die zu ihren Fehlerkosten, ihrem Compliance-Aufwand und ihrer Telemetrie-Reife passt, und passen Sie die Aufteilung an, während sich Ihr Stack weiterentwickelt. Wenn Sie eine Plattform suchen, die genau auf dieser Logik aufbaut, besuchen Sie digna und sehen Sie, wie sie Datenanomalien, Pünktlichkeit, Schemaänderungen, Validierung und In-Database-Ausführung in Ihrer eigenen Umgebung abdeckt.
Diese hybride Aufteilung lässt sich einfacher umsetzen, wenn die expliziten Kontrollen und die diagnostische Evidenz am selben Ort liegen wie die Daten. Die Data Platform Observability von digna führt Anomalieerkennung, Validierung, Timeliness und Schema-Tracking direkt in Ihrer eigenen Datenbank aus. So erhält jede Workload genau die Tiefe, die sie braucht, ohne dass Datensätze in ein weiteres Tool kopiert werden müssen.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Observability und Monitoring?
Monitoring erkennt bekannte Fehlerzustände über vordefinierte Schwellenwerte und Alerts, Observability erklärt unbekannte oder mehrschichtige Ausfälle, indem sie Metriken, Logs und Traces korreliert. Monitoring ist die Kontrollschicht, Observability die Diagnoseschicht. Deshalb brauchen die meisten Datenteams beides, statt das eine durch das andere zu ersetzen.
Sollte Observability das Monitoring ersetzen?
Nein. Wer explizite Monitore durch breite Observability ersetzt, macht Kontrollen implizit und schwerer prüfbar, ein schlechter Tausch für eine Datenplattform. Behalten Sie explizite Monitore für bekannte Fehlerbilder wie fehlende Ladeläufe, defekte Schemas und KPI-Drift bei und ergänzen Sie Observability nur dort, wo Sie Ursachentiefe oder Korrelation benötigen.
Was sind die vier Golden Signals des Monitorings?
Das Site-Reliability-Engineering-Buch von Google nennt Latenz, Traffic, Fehler und Auslastung. Auf einer Datenplattform entsprechen sie Aktualität und Lieferzeitpunkt, Workload- und Nutzungsmustern, fehlgeschlagenen Jobs oder ungültigen Datensätzen sowie Druck auf Warehouse, Cluster oder Pipeline, ergänzt um Schemastabilität und das Verhalten von Geschäftskennzahlen.
Wie viel kostet Observability im Vergleich zu Monitoring?
Observability ist breiter angelegt und spürbar teurer. In der Umfrage von Grafana Labs 2025 mit 1.255 Teilnehmenden lagen die Observability-Ausgaben im Schnitt bei 17 % der gesamten Compute-Infrastrukturkosten, und Komplexität war die größte Sorge. Monitoring ist schmaler und günstiger, daher lautet der Rat: der günstigste Stack, der noch eine belastbare Diagnose liefert.
Wann ist KI-Anomalieerkennung besser als feste Schwellenwerte?
KI-Anomalieerkennung lohnt sich, wenn sich das Datenverhalten bewegt, etwa bei volatilen Umsätzen, sprunghaftem Kundenverhalten, Sensorrauschen oder maschinell erzeugten Events, wo feste Grenzwerte zu stumpfen Werkzeugen werden. Für statische Referenztabellen, deterministische Schlüssel und Append-only-Compliance-Feeds passt sie schlecht, dort braucht es verlässliche regelbasierte Prüfungen und klare Verantwortung.


