8 przypadków użycia data observability dla wiarygodnych danych
|
9
min. czyt.

Pierwsza awaria w środowisku danych rzadko jest zatrzymanym potokiem. To pulpit, który odświeża się poprawnie na niekompletnych danych, model, który dostaje strukturalnie poprawne, ale zmienione w zachowaniu wejścia, albo KPI, który wychodzi poza swój normalny wzorzec bez przypisanej osoby do zbadania sprawy. Szeroko cytowane badanie wykazało, że liczba miesięcznych incydentów danych wzrosła z 59 w 2022 r. do 67 w 2023 r., a 68 % respondentów podało, że wykrycie incydentu zajmowało w 2023 r. co najmniej cztery godziny, wobec 62 % rok wcześniej. To samo badanie odnotowało wzrost o 166 % średniego czasu rozwiązania, do 15 godzin na incydent (relacja Business Wire z badania Monte Carlo).
Te dane wyjaśniają cel data observability. Zespoły muszą monitorować zachowanie danych, dostawę, strukturę, znaczenie biznesowe i pracę platformy, a następnie łączyć każdy sygnał ze wskazanym właścicielem i ścieżką reakcji. Poniższe osiem przypadków użycia data observability porządkuje pracę nad niezawodnością według awarii, której zespół ma zapobiec. Każdy wskazuje odpowiedzialną rolę, sygnał, reprezentatywny incydent, właściwe moduły digna i następne działanie. digna działa wewnątrz środowiska klienta i łączy wykrywanie anomalii, Timeliness, walidację, śledzenie schematu, monitoring biznesowy i observability platformy bez przenoszenia danych produkcyjnych.
Spis treści
2. Niewykryte przesunięcie danych i zapobieganie dryfowi modelu
4. Wykrywanie zmian schematu i zapobieganie zmianom łamiącym zgodność
1. Wykrywanie nieaktualnych i zepsutych pulpitów
Pulpit może być dostępny, choć jego decyzje są już niebezpieczne. Warstwa wizualna się ładuje, ale tabela wyżej w łańcuchu może zawierać brakującą partycję, opóźnioną dostawę albo rozkład wskaźnika, który nie odzwierciedla już bieżącej działalności. To czyni wykrywanie nieaktualnych pulpitów jednym z najbardziej bezpośrednich przypadków użycia data observability dla zespołów analitycznych i biznesowych.
Głównym właścicielem jest zwykle analytics engineer lub deweloperka BI, a data engineer odpowiada za potok wyżej w łańcuchu. Sygnał łączy świeżość, wolumen, kompletność i rozkład. Alert dotyczący pulpitu powinien wskazać, który zbiór danych jest spóźniony lub niekompletny, który wskaźnik się zmienił i które raporty niżej w łańcuchu od niego zależą.
Instytucja finansowa mogłaby wykryć, że dzienny pulpit ryzyka się nie odświeżył, bo proces ETL wyżej w łańcuchu dostarczył dane z opóźnieniem. Zespół operacyjny w ochronie zdrowia mógłby rozpoznać brakujące dane o liczbie pacjentów, zanim decyzje kadrowe oprą się na niepełnym obrazie. Zespół analityki detalicznej mógłby wychwycić częściowe dane sprzedażowe, zanim kadra kierownicza przejrzy dzienne KPI.

Wykrycie musi prowadzić do diagnozy
Moduły Data Anomalies i Timeliness od digna potrafią nauczyć się oczekiwanych wzorców dotarcia i zachowania wskaźników, a następnie zgłaszać brakujące załadowania, opóźnione dostawy i nietypowe wartości. Wykonywanie in-database utrzymuje analizę w bazach klienta, a wspólny pulpit daje inżynierom i interesariuszom jeden widok incydentu. Zespoły mogą skorzystać z przewodnika digna po Data Timeliness, aby zdefiniować najważniejsze sygnały dostawy.
Zacznij od pulpitów, które wpływają na ryzyko, działalność medyczną, przychody lub decyzje zarządu. Kieruj alerty do właścicieli potoków, zamiast wysyłać każde powiadomienie do szerokiej grupy danych. Przejrzyj zachowanie linii bazowej podczas pierwszego wdrożenia, bo użyteczny alert odzwierciedla faktyczny rytm zbioru danych, a nie arbitralny harmonogram.
Reguła praktyczna: alert dotyczący pulpitu powinien mówić, czy awaria to spóźniona dostawa, niepełny wolumen czy zmienione zachowanie wskaźnika. Te warunki wymagają innych dochodzeń.
2. Niewykryte przesunięcie danych i zapobieganie dryfowi modelu
Potok może działać bez błędów i mimo to dostarczać dane, które nie odzwierciedlają już zachowania oczekiwanego przez model lub proces decyzyjny. Zmiany rozkładu są szczególnie trudne do wychwycenia przy monitoringu statusu zadań, bo infrastruktura raportuje sukces, podczas gdy zawartość się przesunęła.
Odpowiedzialne role to data scientist, inżynier ML i data engineer. Powinni monitorować rozkłady cech, częstości kategorii, zachowanie wartości pustych, wzorce transakcji i inne sygnały opisujące populację wejściową. Incydentem może być platforma e-commerce widząca zmianę zachowań zakupowych osłabiającą prognozę popytu albo operator telekomunikacyjny dostrzegający przesunięcie wzorców odejść, zanim model straci wiarygodność.
Zespoły w ochronie zdrowia mogą zobaczyć nieoczekiwaną zmianę wskaźników przyjęć, która wymaga dochodzenia operacyjnego. Zespoły w usługach finansowych mogą wykryć nietypowe wzorce transakcji odzwierciedlające problem potoku, prawdziwe zdarzenie biznesowe albo sygnał oszustwa. Observability nie rozstrzyga, które wyjaśnienie jest poprawne. Skraca drogę od nietypowego zachowania do osoby, która potrafi to wyjaśnienie sprawdzić.
Stosuj uczenie linii bazowej przed ręcznymi progami
Moduł Data Anomalies od digna stosuje ciągłe uczenie linii bazowej do zachowania zbiorów danych, a Data Analytics pomaga zespołom przeglądać wzorce historyczne, zmienność i powtarzalne zmiany. Materiał digna o wykrywaniu dryfu modelu jest przydatny, gdy zespoły chcą powiązać zmiany danych z monitoringiem modeli, zamiast traktować je jako osobne incydenty.
Praktyczny alert powinien zawierać dotknięty zbiór danych, model lub proces decyzyjny, który z niego korzysta, zmieniony sygnał i właściciela ścieżki eskalacji. Inżynierowie mogą wtedy porównać anomalię z wydajnością modelu, historią wdrożeń, zmianami w systemie źródłowym albo zachowaniem sezonowym. Jeśli alerty trafiają do platformy monitoringu ML, zespół może badać dryf wejść i degradację wyjść jedną ścieżką incydentu.
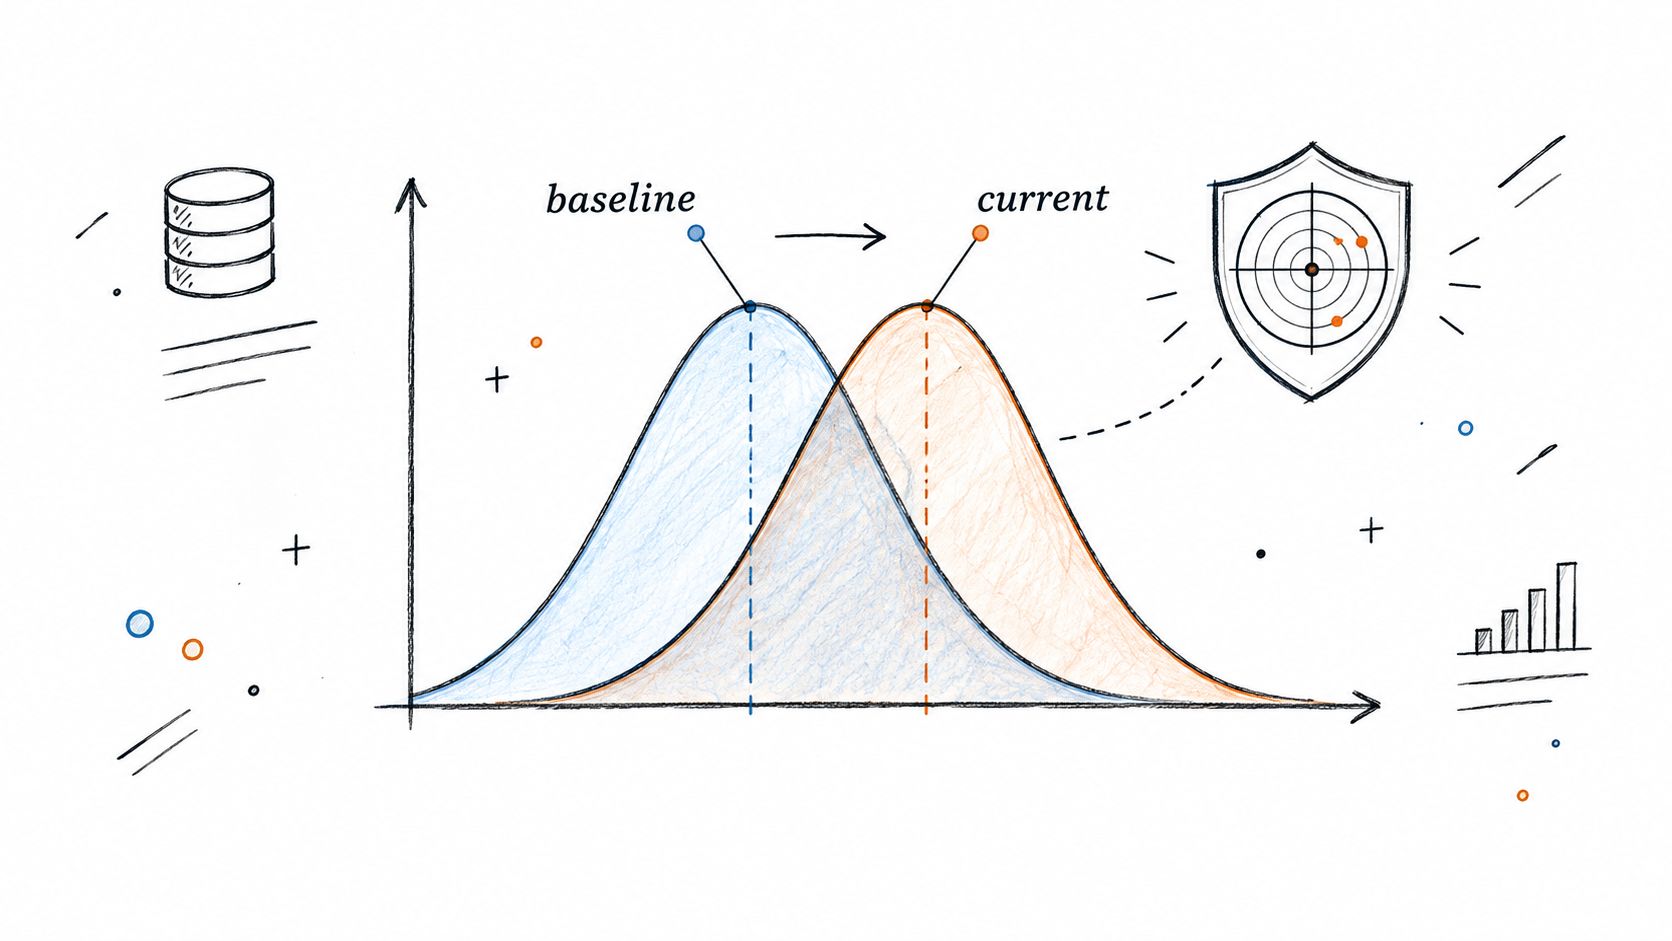
Ryzyko strategiczne to nie tylko dokładność modelu. Zmienione wejście potrafi zmienić prognozy, priorytety, przegląd oszustw, planowanie opieki albo obsługę klienta, zanim ktokolwiek nazwie to incydentem modelu.
3. Opóźnienia dostaw w potokach i monitoring SLA
Spóźnione dane tworzą inną awarię niż dane błędne. Transformacja może być poprawna, źródło dostępne, a tabela i tak dociera po tym, jak proces biznesowy jej potrzebował. To czyni Timeliness kontrolą biznesową, a nie tylko wskaźnikiem inżynierskim.
Właścicielem jest data platform engineer lub właściciel potoku. Sygnałem jest oczekiwany czas dostawy w porównaniu z faktycznym dotarciem, wsparty obecnością załadowania, czasem wykonania i historycznym rytmem. Na przykład tabela, która ma odświeżać się co godzinę, może wywołać alert, gdy nie aktualizowała się dłużej niż 2 godziny, zamieniając mgliste narzekanie na spóźnione dane w zdefiniowany próg incydentu (wyjaśnienie data observability od DataDriven).
Bank może potrzebować nocnych danych o ryzyku przed posiedzeniem komitetu ryzyka. Placówka medyczna może polegać na dziennych danych o pacjentach w pulpitach operacyjnych. Firma telekomunikacyjna mogłaby monitorować duże załadowania danych klientów wspierające provisioning, a detalista wymagać danych sprzedażowych przed porannym raportowaniem.
Traktuj dostawę jak kontrakt operacyjny
Moduł Timeliness od digna uczy się harmonogramów i oczekiwanych okien dostawy, a następnie zgłasza opóźnienia, brakujące załadowania i zbyt wczesne dostawy. Zespoły mogą skorzystać z materiału digna o monitoringu potoków danych w AWS, gdy chcą dopasować monitoring Timeliness do pracy potoków w chmurze.
Następne działanie powinno być jawne. Skonfiguruj eskalację po przekroczeniu oczekiwanego czasu dostawy, wyślij incydent do właściciela potoku i zintegruj alert z zarządzaniem incydentami. Śledź trend oczekiwanych czasów dostawy, a nie tylko pojedyncze uchybienia. Stopniowe pogarszanie może ujawnić problemy z przepustowością lub zależnościami, zanim dojdzie do pełnej awarii.
SLA dostawy jest użyteczne tylko wtedy, gdy ktoś odpowiada za jego naruszenie, rozumie wpływ niżej w łańcuchu i wie, kiedy eskalować.
Wykrycie wskazuje przekroczone okno. Diagnoza sprawdza orkiestrator, system źródłowy, łańcuch zależności i stan załadowania. Reakcja może polegać na ponownym uruchomieniu zadania, kontakcie z właścicielem źródła albo oznaczeniu wyników niżej w łańcuchu jako tymczasowo niezaufanych.
4. Wykrywanie zmian schematu i zapobieganie zmianom łamiącym zgodność
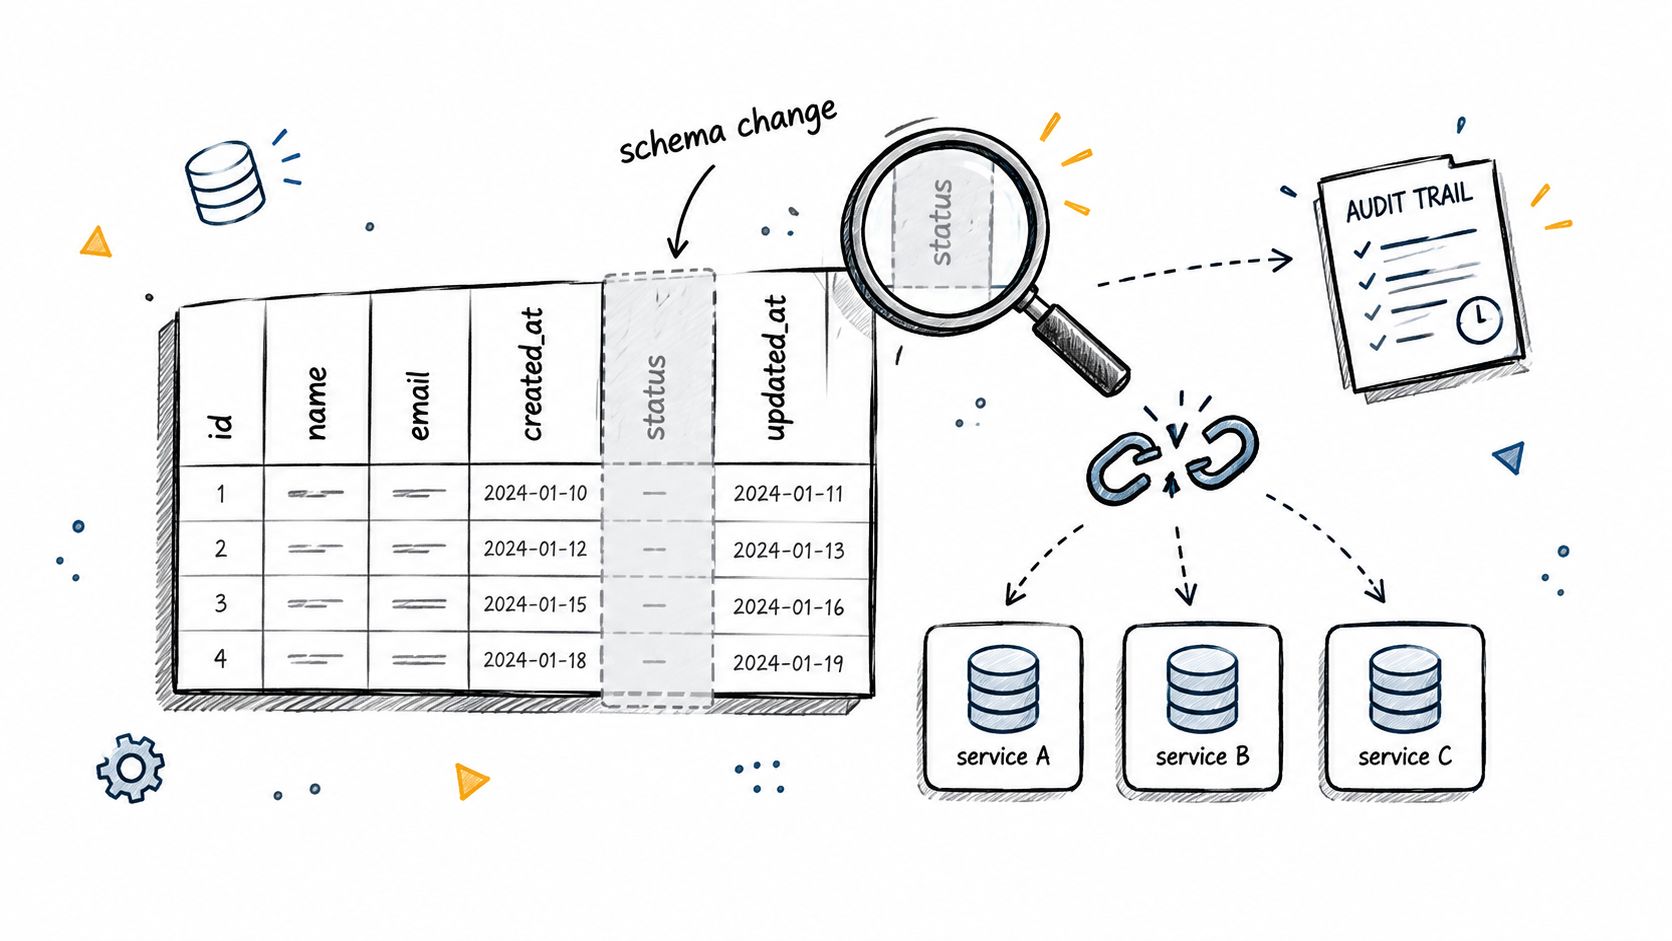
Zmiany strukturalne są groźne, bo potrafią zepsuć odbiorców, nie wyglądając na awarie operacyjne. Dodane kolumny, usunięte kolumny, przemianowane pola, zmiany typów oraz przełączenia między dopuszczaniem i niedopuszczaniem wartości pustych mogą powodować brakujące wartości, konwersje typów, nieudane transformacje albo błędne złączenia, nawet gdy potok raportuje pomyślne wykonanie (wyjaśnienie Ataccama o schemacie i data observability).
Za reakcję odpowiada data engineer lub analytics engineer, a właściciele systemów źródłowych powinni zatwierdzać zamierzone zmiany. Sygnałem jest porównanie bieżącego schematu z oczekiwaną strukturą. Reprezentatywny incydent to na przykład aplikacja źródłowa dodająca niezapowiedzianą kolumnę, zmieniająca identyfikator klienta z tekstu na liczbę całkowitą albo usuwająca pole używane w obliczeniu ryzyka.
Zespoły IT w ochronie zdrowia mają dodatkowy problem kontrolny, gdy struktury danych klinicznych zmieniają się bez jasnej komunikacji. Bezpośrednim problemem technicznym może być nieudana transformacja, ale szerszym ryzykiem jest utrata możliwości prześledzenia, która wersja danych zasiliła raport.
Wykryj zmianę, zanim odkryją ją odbiorcy
Schema Tracker od digna stale monitoruje właściwości strukturalne i alarmuje zespoły, gdy schematy dryfują. Moduł digna Schema Tracker może wspierać przepływ, w którym zespoły dokumentują oczekiwane schematy, kierują alerty do właścicieli niżej w łańcuchu i sprawdzają, czy zmiana była zamierzona.
Diagnoza wymaga czegoś więcej niż potwierdzenia, że kolumna się zmieniła. Inżynierowie powinni wskazać dotknięte tabele, transformacje, pulpity, modele i wyniki regulacyjne. Następnym działaniem może być aktualizacja kontraktu, przywrócenie zgodności, poprawa transformacji albo formalne zatwierdzenie zmiany. Powiąż alerty schematu z procesami katalogu i governance, żeby decyzje strukturalne nie zostawały w prywatnych wiadomościach ani nieudokumentowanych zgłoszeniach.
Alert schematu jest więc sygnałem kontroli wpływu. Mówi zespołowi nie tylko, że struktura się zmieniła, ale też że zależność niżej w łańcuchu może teraz wymagać przeglądu.
5. Monitoring biznesowych KPI i alerty anomalii
Kontrole techniczne mogą przechodzić, podczas gdy wynik biznesowy wygląda źle. Hurtownia może otrzymać dane na czas, zachować schemat i zakończyć każdą transformację, a mimo to przychody, wartość zamówienia, liczba klientów, odejścia albo wyniki leczenia mogą wyjść poza oczekiwane zachowanie.
Odpowiedzialnym właścicielem jest analityczka biznesowa lub interesariuszka operacyjna, wspierana przez analytics engineering. Sygnałem jest wskaźnik biznesowy porównany z jego zachowaniem historycznym, sezonowością, zmiennością i istotnymi warunkami danych. Organizacja detaliczna mogłaby wykryć nietypowy spadek przychodów i zacząć badać sprawę, zanim trafi ona na formalny przegląd wyników. Zespół telekomunikacyjny mógłby zauważyć nietypowe odejścia, a grupa usług finansowych badać zmianę wolumenu transakcji, która może odzwierciedlać oszustwo lub problem systemu.
Postaw znaczenie biznesowe obok kontekstu technicznego
Rozwiązanie Business Monitoring od digna stosuje wykrywanie anomalii do wskaźników przechowywanych w hurtowni lub jeziorze. Moduł Data Analytics pomaga zespołom zrozumieć historyczne wzorce KPI, trendy i zmienność, a system monitoringu biznesowego digna daje skoncentrowaną ścieżkę obserwowania zachowań biznesowych.
Zacznij od KPI, które mają wyraźnego właściciela decyzji. Określ, jakie działanie następuje po alercie: sprawdzenie kompletności źródła, walidacja promocji, przegląd kontroli transakcji albo kontakt z zespołem operacyjnym. Unikaj traktowania każdego ruchu jak incydentu. Czułość powinna odzwierciedlać normalną zmienność wskaźnika i skutki przeoczonej anomalii.
Test własności: jeśli nikt nie potrafi nazwać decyzji, która zmienia się po alercie KPI, ten wskaźnik prawdopodobnie nie jest gotowy na ciągły monitoring.
Diagnoza łączy ruch biznesowy z jakością danych, zdarzeniami w źródle, zmianami produktu albo rzeczywistym zachowaniem rynku. Reakcja należy wtedy do zespołu, który potrafi poprawić warunek źródłowy, niekoniecznie do zespołu utrzymującego pulpit.
6. Egzekwowanie reguł biznesowych i walidacja zgodności
Wykrywanie anomalii pyta, czy dane zachowują się inaczej niż ich linia bazowa. Walidacja pyta, czy każdy rekord spełnia znaną regułę biznesową, logiczną lub zgodnościową. Oba podejścia są potrzebne, bo zbiór danych może wyglądać statystycznie normalnie, a jednocześnie naruszać wymagany warunek.
Właścicielem jest zwykle szef jakości danych, data steward, zespół compliance albo ekspert dziedzinowy. Sygnały obejmują obecność pól obowiązkowych, poprawne segmenty, zakresy wartości, sekwencje dat, integralność referencyjną i inne ograniczenia deterministyczne. Zespół usług finansowych mógłby weryfikować, czy transakcje zawierają pola obowiązkowe i mieszczą się w progach zgodności. Zespoły w ochronie zdrowia mogą sprawdzać, czy rekordy spełniają wymogi sprawozdawcze przed wysyłką. Operatorzy telekomunikacyjni mogą weryfikować rekordy rozliczeniowe względem reguł taryfowych, a urzędy testować warunki audytu i możliwości prześledzenia.
Uczyń dowody walidacji użytecznymi operacyjnie
Moduł Data Validation od digna wykonuje kontrole na poziomie rekordu względem udokumentowanych reguł biznesowych. Zespoły powinny zacząć od dziedzin regulowanych lub wysokiego ryzyka, włączyć ekspertów w projektowanie reguł i zapisywać, które zbiory danych przeszły, a które nie. Katalog danych może dać wspólny widok statusu walidacji i pomóc analitykom odróżnić dane nadające się do użycia od tych, które wymagają przeglądu.
Wykrycie wskazuje rekordy naruszające regułę. Diagnoza ustala, czy przyczyną była reguła, źródło, transformacja czy proces biznesowy. Reakcja może polegać na kwarantannie dotkniętych rekordów, poprawieniu źródła, zatwierdzeniu odstępstwa albo udokumentowaniu naprawy na potrzeby przeglądu audytowego.
Niezależne wskazówki dotyczące observability potoków podkreślają, że monitoring musi oceniać jakość wyjścia, w tym liczbę rekordów, zmiany rozkładu pól i zmiany schematu, zamiast opierać się wyłącznie na sukcesie zadania (wskazówki dotyczące monitoringu i kontroli potoków na poziomie danych). To rozróżnienie ma znaczenie w środowiskach wrażliwych na zgodność, gdzie zakończone zadanie nie jest wystarczającym dowodem, że wynik jest wiarygodny lub audytowalny.
7. Observability platformy danych i monitoring zużycia
Zespoły platformy danych mogą dziedziczyć problemy z niezawodnością z zachowania zasobów, a nie z zawartości danych. Skok obciążenia, nieefektywne zapytanie, rozbiegany potok, nieużywana tabela albo nieoczekiwany trend składowania mogą obniżyć dostępność i uczynić dostawę niżej w łańcuchu mniej przewidywalną.
Odpowiedzialną rolą jest data platform engineer. Sygnały obejmują wzorce obciążenia, wolumen zapytań, moc przetwarzania, czas wykonania potoków, dostępność, przyrost składowania i zmiany zużycia. Zespół hurtowni w chmurze mógłby znaleźć nieużywane tabele komplikujące zarządzanie składowaniem. Analytics engineer mogłaby rozpoznać zapytania zużywające nadmiar zasobów i zoptymalizować SQL. Zespół platformy mógłby wykryć nietypowy wzorzec zużycia wywołany przez rozbiegany potok.
Monitoruj infrastrukturę stojącą za danymi
Rozwiązanie Data Platform Observability od digna skupia się na kondycji platformy, jej zachowaniu, zużyciu i zmianach operacyjnych. Moduł Data Analytics może pomóc zespołom śledzić trendy wskaźników platformy i odróżnić jednorazowy skok od narastającego problemu z przepustowością. Udostępniaj pulpity platformy odbiorcom danych, żeby inżynierowie nie byli jedynymi, którzy widzą skutki nieefektywnego użycia.
Następne działanie zależy od sygnału. Anomalia zapytania może wymagać optymalizacji SQL. Trend składowania może wymagać zarządzania cyklem życia albo przeglądu własności. Zmiana czasu wykonania potoku może wymagać analizy przepustowości, zbadania zależności albo korekty harmonogramu. Ustal linie bazowe normalnego obciążenia, kieruj poważne alerty do właścicieli platformy i wykorzystuj trendy zużycia w planowaniu infrastruktury.
Ten przypadek użycia obnaża też problem priorytetów. Badanie observability z 2025 r. wykazało, że tylko 13 % zebranej telemetrii było aktywnie wykorzystywane do monitoringu, alertowania lub rozwiązywania problemów, a 84 % firm wykorzystywało mniej niż jedną czwartą tego, co zbierały (raport observability firmy Sawmills AI). Więcej telemetrii nie tworzy automatycznie większej niezawodności. Zespoły muszą wybierać sygnały, które prowadzą do decyzji.
8. Zgodność regulacyjna i data governance gotowe na audyt
Organizacje regulowane potrzebują czegoś więcej niż czystego pulpitu w dniu, w którym audytor prosi o dowody. Potrzebują ciągłego nadzoru nad jakością danych krytycznych, walidacją, Timeliness, zmianami strukturalnymi, własnością i historią kontroli.
Odpowiedzialne role to szef data governance, compliance officer, audytor wewnętrzny i właściciel danych w dziedzinie. Sygnały łączą wyniki walidacji, status dostawy, historię schematu, anomalie jakości danych i dowody, że kontrole działały zgodnie z projektem. Bank może musieć wykazać, że dane do sprawozdawczości regulacyjnej spełniły określone wymogi i dotarły na czas. Organizacja medyczna może potrzebować możliwości prześledzenia wrażliwych danych klinicznych. Urząd może musieć wykazać, że dane krytyczne pozostawały objęte udokumentowanymi kontrolami w wymaganym środowisku.
Połącz monitoring kontroli z dowodami
digna łączy w tym celu Data Validation, Schema Tracker, Timeliness i wykonywanie in-database. Opcje wdrożenia w chmurze prywatnej lub on-premises utrzymują wrażliwe dane w chmurze, VPC albo centrum danych klienta. Taka architektura wspiera wymogi governance, w których przenoszenie danych produkcyjnych do zewnętrznej usługi monitoringu jest niedopuszczalne.
Zespoły compliance powinny wskazać dziedziny danych wymagające ciągłego nadzoru, udokumentować reguły w platformie governance i ustanowić cykliczne przeglądy. Następne działanie dla każdego alertu powinno określać, czy sprawa wymaga naprawy, zatwierdzenia odstępstwa, zachowania dowodu czy eskalacji. Powstały zapis powinien pomóc audytorowi zrozumieć, co sprawdzono, kiedy sprawdzono, co zawiodło, kto to zbadał i jak zareagowała organizacja.
Kontekst rynkowy pokazuje, dlaczego stało się to sprawą platformy, a nie wąskim zadaniem jakościowym. Badania szacują rynek data observability na 2,94 mld USD w 2025 r. i prognozują 6,02 mld USD do 2030 r., co odpowiada CAGR na poziomie 15,4 %, przy czym Ameryka Północna jest zwykle wskazywana jako największy rynek, a Azja i Pacyfik jako region rosnący najszybciej (raport rynkowy The Business Research Company). Adopcja rośnie, bo governance, niezawodność i odpowiedzialność operacyjna coraz mocniej się nakładają.
Dodatkową perspektywę na budowanie kontroli prywatności i zgodności znajdziesz w analizach Nexus IT Group.
Data observability: porównanie 8 przypadków użycia
Cecha | 🔄 Złożoność wdrożenia | ⚡ Zasoby & szybkość | ⭐ Oczekiwana skuteczność | 📊 Kluczowe rezultaty / wpływ | 💡 Idealne zastosowania |
|---|---|---|---|---|---|
Wykrywanie nieaktualnych i zepsutych pulpitów | Umiarkowana, potrzebny okres dostrajania linii bazowej AI | Umiarkowane zasoby; wykonywanie in-database; alerty w czasie rzeczywistym | ⭐⭐⭐⭐ | Mniej awarii pulpitów; krótszy czas rozwiązania przy nieaktualnych danych | Krytyczne pulpity, raporty zarządcze, finanse, handel, ochrona zdrowia |
Niewykryte przesunięcie danych i zapobieganie dryfowi modelu | Wysoka, wymaga danych historycznych i dostrojenia czułości | Umiarkowana–wysoka moc obliczeniowa do analizy rozkładów; ciągły monitoring | ⭐⭐⭐⭐ | Wczesne wykrycie dryfu; chroni wydajność modeli ML | Prognozowanie, wykrywanie oszustw, modele odejść, potoki ML |
Opóźnienia dostaw w potokach i monitoring SLA | Umiarkowana, uczy się harmonogramów i oczekiwanych czasów dostawy | Niskie–umiarkowane zasoby; szybkie wykrywanie; skraca MTTD ⚡ | ⭐⭐⭐⭐ | Egzekwowanie SLA; alerty o terminowości dostaw; mniej pominiętych załadowań | Zadania nocne, raportowanie wrażliwe czasowo, regulowane terminy |
Wykrywanie zmian schematu i zapobieganie zmianom łamiącym zgodność | Niska–umiarkowana, ustal schemat bazowy, potem kontroluj ciągle | Niskie zasoby; natychmiastowe wykrycie zmian strukturalnych | ⭐⭐⭐⭐⭐ | Zapobieganie cichym awariom; krótsze debugowanie; ślad audytowy schematu | Dynamiczne źródła, potoki ETL, analytics engineering |
Monitoring biznesowych KPI i alerty anomalii | Umiarkowana, wymaga definicji KPI i linii bazowych sezonowości | Umiarkowane zasoby; pulpity dla użytkowników; alerty na czas | ⭐⭐⭐⭐ | Wykrywanie anomalii istotnych biznesowo; mniejsze zmęczenie alertami | Śledzenie przychodów, wskaźniki produktowe, operacyjne KPI |
Egzekwowanie reguł biznesowych i walidacja zgodności | Wysoka, wstępna definicja reguł i bieżące utrzymanie | Umiarkowane–wysokie zasoby na kontrole na poziomie rekordu; logowanie audytowe | ⭐⭐⭐⭐⭐ | Ciągłe egzekwowanie reguł; dowody gotowe na audyt; mniej błędów niżej w łańcuchu | Dziedziny regulowane (finanse, ochrona zdrowia), rozliczenia, raportowanie zgodności |
Observability platformy danych i monitoring zużycia | Wysoka, integruje wskaźniki platformy i linie bazowe obciążenia | Umiarkowane zasoby; stała telemetria; umożliwia optymalizację kosztów | ⭐⭐⭐⭐ | Planowanie przepustowości; oszczędności; wykrywanie wąskich gardeł wydajności | Hurtownie w chmurze, zespoły platformowe, modele chargeback |
Zgodność regulacyjna & data governance gotowe na audyt | Bardzo wysoka, integracja międzymodułowa i dopasowanie do governance | Wysoki nakład zasobów i procesów; wdrożenia in-database & prywatne | ⭐⭐⭐⭐⭐ | Dowody gotowe na audyt; mniejsze ryzyko zgodności; suwerenność danych | Banki, ochrona zdrowia, sektor publiczny, regulowane procesy raportowania |
Zamień alerty w operacyjny model niezawodności
Osiem przypadków użycia data observability staje się użyteczne, gdy zespół wdraża je w kolejności odpowiadającej ryzyku biznesowemu. Zacznij od krytycznych zbiorów danych i sygnałów dostawy. Jeśli zespoły nie wiedzą, czy kluczowe tabele dotarły albo czy pulpity są kompletne, monitoring anomalii i KPI wygeneruje mylące objawy zamiast incydentów, na które da się zareagować.
Następnie dodaj behawioralne wykrywanie anomalii i monitoring schematu. Te kontrole obejmują awarie, których nie widzą sprawdzenia statusu zadań, w tym przesunięcia rozkładów, brakujące wartości i zmiany strukturalne. W środowiskach zależnych od AI ten fundament staje się coraz ważniejszy. W 2025 r. adopcja monitoringu AI wzrosła z 42 % do 54 % organizacji, przy czym 73 % wciąż nie miało observability na pełnym stosie, a średnia liczba narzędzi observability spadła z 6 do 4,4, gdy zespoły konsolidowały platformy (wyniki badania observability firmy Databahn). Praktyczny wniosek jest jasny. Zespoły potrzebują jednego przepływu dochodzenia, który wiąże kondycję zbiorów danych, zachowanie cech, sygnały modelu i wyniki biznesowe.
Potem rozszerz zasięg na walidację, biznesowe KPI, zużycie platformy i dowody regulacyjne. Walidacja chroni znane reguły. Monitoring biznesowy chroni decyzje. Observability platformy chroni infrastrukturę, która dostarcza i udostępnia dane. Monitoring governance zamienia działanie operacyjne w dowody, które mogą przejrzeć zespoły compliance i audytu.
Każdy alert powinien mieć pięć atrybutów:
Wskazany właściciel: określ osobę lub zespół odpowiedzialny za zbadanie sprawy.
Waga: powiąż priorytet z wpływem biznesowym, a nie tylko z odchyleniem technicznym.
Sygnał wykrycia: podaj, czy wyzwalacz dotyczy świeżości, wolumenu, rozkładu, schematu, walidacji, zachowania KPI czy zużycia platformy.
Ścieżka dochodzenia: powiąż alert ze źródłem, potokiem, tabelą, wskaźnikiem, modelem albo odbiorcą niżej w łańcuchu, który wymaga sprawdzenia.
Ścieżka eskalacji: określ, kiedy właściciel musi włączyć zespoły platformowe, biznesowe, compliance lub reagowania na incydenty.
digna wspiera ten model operacyjny modułowym licencjonowaniem, dzięki czemu organizacje mogą zacząć od jednego modułu i rozszerzać zakres wraz z liczbą aktywnych tabel i potrzebami monitoringu. Wykonywanie in-database oraz opcje wdrożenia w chmurze prywatnej lub on-premises utrzymują dane produkcyjne w środowisku klienta. Platforma zawiera od pierwszego wybranego modułu scheduler, katalog danych, integracje i funkcje współpracy, dając zespołom inżynierskim i governance wspólne miejsce do przeglądu incydentów i trendów.
Pierwsze zasoby wybieraj, zadając praktyczne pytania. Które tabele zasilają najbardziej brzemienne w skutki pulpity lub modele? Które dostawy mają najsilniejszą zależność czasową? Które schematy zmieniają się bez rzetelnej komunikacji? Które rekordy niosą ryzyko regulacyjne lub finansowe? Które KPI wyzwalają decyzje operacyjne? Które obciążenia platformy zagrażają dostępności lub kontroli zasobów?
Monitoruj te tabele i wskaźniki w pierwszej kolejności. Wyznacz właściciela, zanim włączysz alert. Zdefiniuj reakcję, zanim zaczniesz mierzyć pokrycie. Niezawodność rośnie, gdy sygnały observability stają się zarządzaną pracą, a nie kolejnym strumieniem telemetrii, na który nikt nie ma czasu.
digna oferuje data observability wewnątrz Twojego środowiska poprzez wykrywanie anomalii, monitoring Timeliness, śledzenie schematu, walidację na poziomie rekordu, monitoring biznesowy i observability platformy. Odwiedź digna, aby ocenić, jak modułowa platforma działająca in-database może powiązać te przypadki użycia data observability ze wskazanymi właścicielami i konkretnymi ścieżkami reakcji.
Warstwę pomiarową stojącą pod tymi przypadkami użycia — świeżość, kompletność, stabilność schematu, poprawność formalną i dryf rozkładu oraz progi, które należą do kontraktu dostawy — opisuje materiał niezawodność jakości danych.
Najczęściej zadawane pytania
Jakie są główne przypadki użycia data observability?
Osiem pokrywa większość pracy nad niezawodnością: wykrywanie nieaktualnych pulpitów, przesunięcie danych i dryf modelu, opóźnienia dostaw w potokach, wykrywanie zmian schematu, anomalie biznesowych KPI, walidacja reguł biznesowych, monitoring platformy i zużycia oraz governance gotowe na audyt. Każdy łączy sygnał ze wskazanym właścicielem i zdefiniowaną ścieżką reakcji.
Czym data observability różni się od monitoringu potoków?
Monitoring statusu zadań mówi, że potok się wykonał; observability pyta, co dostarczył. Transformacja może zakończyć się powodzeniem przy trzech brakujących partycjach, a przemianowana kolumna może przejść ścieżką zgodności, gdy udział wartości pustych w niej rośnie. Pulpit w obu przypadkach odświeża się poprawnie.
Od którego przypadku użycia data observability powinien zacząć zespół?
Zacznij od krytycznych zbiorów danych i sygnałów dostawy. Jeśli nikt nie wie, czy kluczowe tabele dotarły ani czy pulpity są kompletne, monitoring anomalii i KPI daje mylące objawy zamiast incydentów, na które da się zareagować. Behawioralne wykrywanie anomalii i monitoring schematu są następne, a po nich walidacja, KPI, zużycie platformy i dowody regulacyjne.
Dlaczego zmiany schematu powodują ciche awarie?
Dodane, usunięte, przemianowane lub przetypowane kolumny rzadko zatrzymują potok. Powodują brakujące wartości, konwersje typów i błędne złączenia, podczas gdy wykonanie wciąż raportuje sukces. Alert schematu jest sygnałem kontroli wpływu, więc powinien wskazywać dotknięte tabele, transformacje, pulpity, modele i wyniki regulacyjne, a nie tylko kolumnę.
Co sprawia, że alert data observability nadaje się do działania?
Pięć atrybutów: wskazany właściciel, waga powiązana z wpływem biznesowym, sygnał wykrycia, ścieżka dochodzenia do źródła lub odbiorcy oraz ścieżka eskalacji. Sama liczba alertów nie pomaga. Badanie z 2025 r. wykazało, że tylko 13 % zebranej telemetrii było aktywnie wykorzystywane do monitoringu lub rozwiązywania problemów.


