Niezawodność jakości danych: jak zespoły naprawdę ją mierzą
|
8
min. czyt.

Poniedziałkowy poranek zaczyna się znajomym sukcesem. Pulpit przychodów się ładuje, sumy zgadzają się z finansami, a przed spotkaniem zarządu każdy wykres świeci na zielono. Nikt nie widzi, że spóźnione transakcje mobilne wciąż są uzupełniane, że zadanie sesjonizacji zgubiło partycje, a przemianowane pole generuje znacznie więcej wartości pustych niż jego linia bazowa. Pulpit wygląda wiarygodnie, bo widoczny wynik się wyrenderował, a nie dlatego, że łańcuch dostawy pozostał niezawodny.
To rozróżnienie ma znaczenie, gdy analityka, operacje i systemy AI korzystają z tych samych potoków. Niezawodność jakości danych nie jest listą kontrolną nakładaną na tabelę po fakcie. To właściwość operacyjna całego łańcucha: świeżość, kompletność, zachowanie schematu, poprawność formalna, lineage i governance. Ten przewodnik traktuje niezawodność jako temat produkcyjny i pokazuje, jak ją mierzyć, nie zamieniając każdego wydania w wąskie gardło ręcznych testów.
Spis treści
Ukryta awaria za pulpitami, które wyglądają wiarygodnie
Dlaczego jakość i niezawodność to nie to samo
Błąd inwestycyjny
Wskaźniki, które naprawdę mierzą niezawodność
Kontrole regułowe, kontrole statystyczne i wykrywanie anomalii przez AI
Układaj je według stopnia pewności
Observability, kontrole in-database i walidacja działające razem
Bariery operacyjne, które nie pozwalają programom niezawodności utknąć
Kieruj alerty do produktu danych
Rozdziel poziomy usług
Utrzymuj kontrole w ścieżce dostawy
Czego naprawdę wymaga niezawodność danych gotowa na AI
Prześledź pełny łańcuch wejść AI
Jak to wszystko połączyć i co dalej
Ukryta awaria za pulpitami, które wyglądają wiarygodnie
Pierwszy problem pojawia się w strumieniu zdarzeń. Wydanie aplikacji mobilnej zmienia sposób emitowania transakcji, więc część rekordów dociera z opóźnieniem zamiast w oczekiwanym oknie przetwarzania. Zadanie ingestii kończy się sukcesem, bo otrzymało dane, ale dane nie są kompletne w momencie, gdy czytają je odbiorcy w dalszej części łańcucha.
Następnie sesjonizacja przetwarza dostępne partycje. Trzech brakuje, a mimo to transformacja tworzy tabelę. Dzienna liczba wierszy mieści się w szerokim zakresie historycznym, bo ruch desktopowy maskuje lukę mobilną. Odświeżenie pulpitu kończy się powodzeniem, a jego sumy nadal mogą zgadzać się z finansami, jeśli finanse otrzymają późniejsze uzupełnienie albo stosują inną datę graniczną.
Trzecia awaria ma charakter strukturalny. Pole wyżej w łańcuchu zostaje przemianowane, a transformacja zachowuje kolumnę przez ścieżkę zgodności. Udział wartości pustych w polu rośnie, ale żaden alert nie porównuje tej zmiany ze znaną linią bazową. Cechy atrybucji zawierają teraz mniej użytecznej informacji, podczas gdy model odejść trenuje dalej, jakby cecha zachowała swoje wcześniejsze znaczenie.
Zielony pulpit dowodzi, że zapytanie się wykonało i zwróciło wynik. Nie dowodzi, że dotarły właściwe dane, że każda transformacja zadziałała poprawnie ani że odbiorcy otrzymali je w wymaganym oknie.
Dlatego zespoły mogą ufać warstwie wizualnej i mimo to podejmować niepewne decyzje. Raport może być liczbowo spójny z jednym systemem referencyjnym, a jednocześnie pozostawać niekompletny, nieaktualny lub semantycznie uszkodzony dla innego zastosowania. Model również może wchłonąć degradację długo przed tym, zanim ktokolwiek zauważy widoczny błąd w raportowaniu.
Praktyczna odpowiedź to monitorowanie łańcucha dostawy, a nie tylko końcowej tabeli. Pulpit potrzebuje dowodów świeżości, kompletności partycji, historii schematu, kontekstu lineage i przypisanej odpowiedzialności dla każdego krytycznego zasobu wyżej w łańcuchu. Zespoły skupione wyłącznie na objawach widocznych na pulpicie znajdą więcej w materiale o pulpitach jakości danych, ale głębsza naprawa polega na ustaleniu, która kontrola zawiodła, zanim pulpit stał się mylący.
Dlaczego jakość i niezawodność to nie to samo
Jakość danych opisuje, czy dane spełniają oczekiwane warunki. Wartość może być poprawna, niepusta, właściwie otypowana, mieścić się w dozwolonym zakresie i być powiązana z istniejącym rekordem referencyjnym. Te kontrole badają zawartość i strukturę rekordów.
Niezawodność danych pyta, czy odbiorcy mogą polegać na danych w czasie i na całej ścieżce dostawy. Obejmuje jakość, ale pyta też, czy oczekiwane dane dotarły, czy potok udostępnił je w swoim oknie usługi, czy znane jest ich lineage i czy zmiany zostały zakomunikowane oraz kontrolowane.
Analogia z cegłą czyni różnicę namacalną. Jakość pyta, czy każda cegła jest solidna i ma właściwy kształt. Niezawodność pyta, czy mur dociera na czas, ma wszystkie warstwy, ma znane pochodzenie i nadal stoi, gdy zmieniają się warunki.
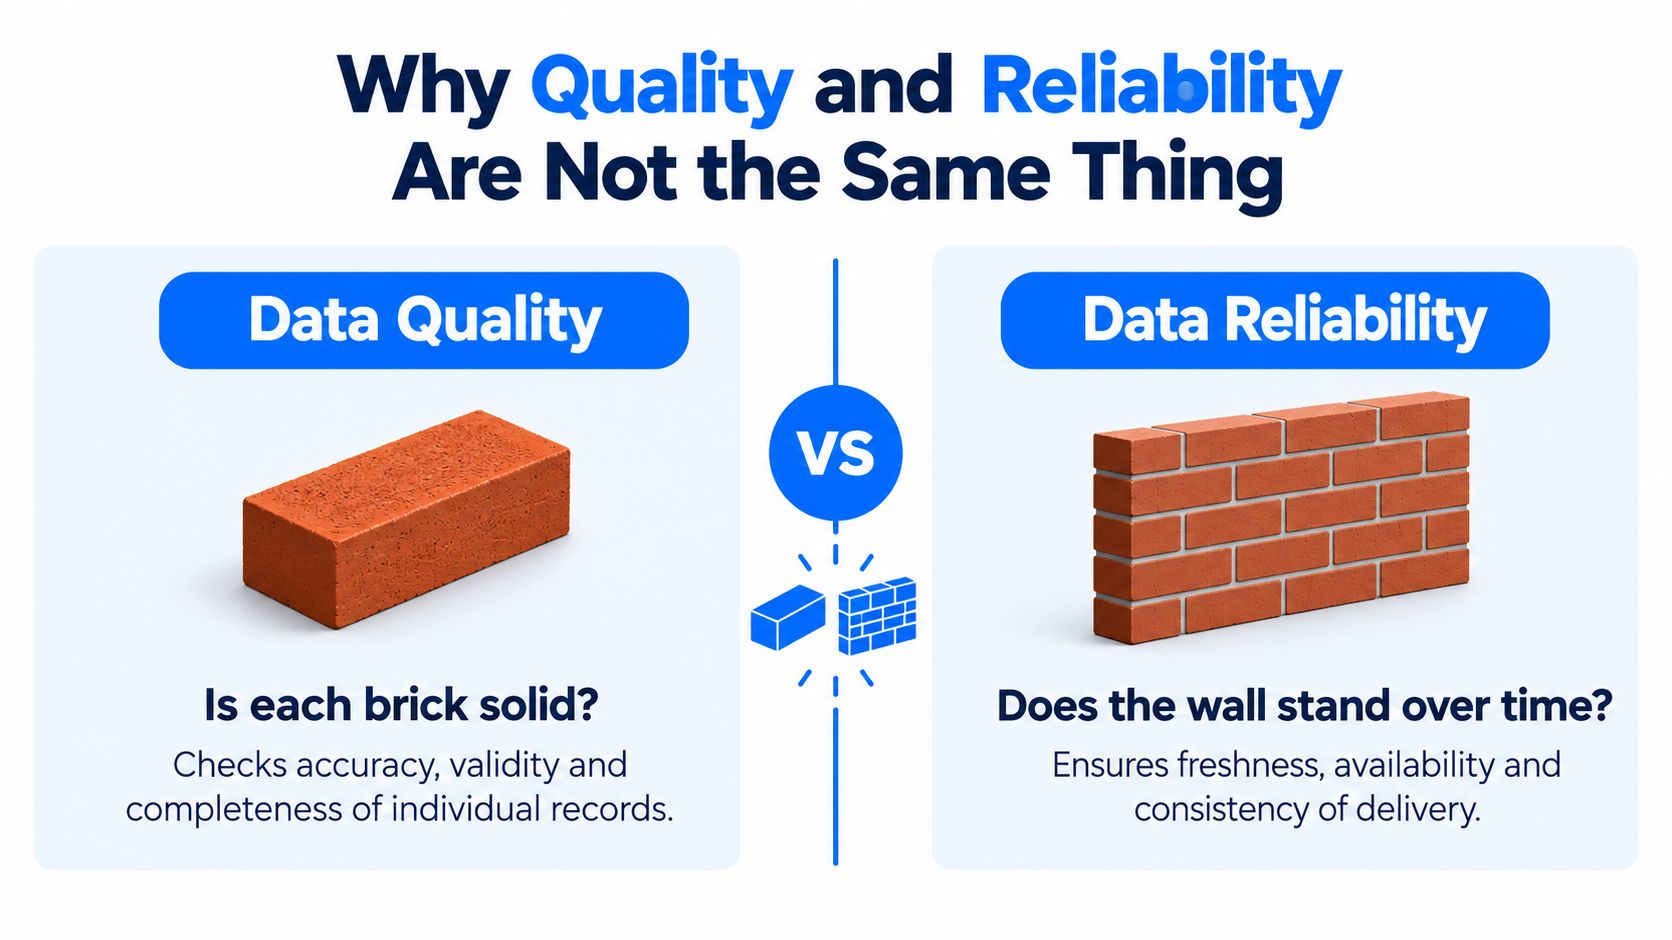
Tabela może przejść walidację na poziomie wiersza i zawieść jako wiarygodny produkt. Każdy dostarczony rekord może mieć poprawny identyfikator klienta, a mimo to brakuje całej partycji. Walidator schematu może potwierdzić, że kolumna istnieje, podczas gdy lineage jest przerwane i nikt nie wie, które źródło ją wytworzyło. Zbiór danych może być poprawny w spoczynku i nadal zbyt nieaktualny dla decyzji operacyjnej.
Błąd inwestycyjny
Gdy zespoły traktują jakość i niezawodność jako synonimy, często kupują lub budują niewłaściwe kontrole. Dokładają kolejne sprawdzenia wartości pustych, asercje typów i reguły dziedzinowe, zostawiając oczekiwania wobec świeżości niezdefiniowane. Badają wartości w hurtowni, ale nie monitorują spóźnionych partycji, czasu wykonania, zależności wyżej w łańcuchu ani wpływu niżej.
Powstaje przez to nierówny system kontroli. Kontrole deterministyczne chronią cegłę, a nikt nie sprawdza, czy mur jest kompletny ani czy dotarł wtedy, gdy odbiorca go potrzebował. Efektem jest duży zbiór zaliczonych testów przypiętych do niepewnego produktu.
Niezawodność wymaga więc definicji usługi od końca do końca. Producent i odbiorca powinni uzgodnić, co ma dotrzeć, do kiedy, w jakim kształcie, przy jakich ograniczeniach biznesowych i z jakim dowodem lineage. Jakość na poziomie wiersza pozostaje niezbędna, ale staje się częścią kontraktu dostawy, a nie całą definicją zaufania.
Wskaźniki, które naprawdę mierzą niezawodność
Niezawodność produkcyjna staje się sterowalna, gdy zespoły przekładają oczekiwania na obserwowalne sygnały. Pięć wskaźników pokrywa główne tryby awarii: świeżość, kompletność, stabilność schematu, poprawność formalna i dryf rozkładu. Nie należy ich traktować jako uniwersalnych wartości „zdał – nie zdał”. Każdy próg należy do kontraktu odzwierciedlającego tolerancję odbiorcy i rolę zasobu.
Świeżość mierzy odstęp między oczekiwaną dostępnością zdarzenia a jego faktycznym dotarciem. Użyteczna implementacja porównuje znaczniki czasu typu high-watermark z oknem poziomu usługi, a następnie alarmuje, gdy partycja jest spóźniona lub jej brakuje. Wskazówki techniczne dotyczące monitoringu świeżości opisują to podejście oparte na SLA, zamiast traktować znacznik czasu jako wystarczający dowód kondycji.
Kompletność porównuje to, co miało dotrzeć, z tym, co dotarło. Kontrola powinna działać na poziomie partycji lub jednostki dostawy, bo kompletny zestaw wierszy w niekompletnym dniu wciąż może dać mylący wynik. Alert może zadziałać, gdy brakuje oczekiwanej partycji albo gdy dostarczona liczba wypada poza uzgodnionym pasmem.
Stabilność schematu śledzi dodania, usunięcia, zmiany nazw i zmiany typów względem linii bazowej lub jawnego kontraktu. Takie zmiany mogą zepsuć transformacje, zmienić znaczenie albo podnieść udział wartości pustych, nie powodując natychmiastowej awarii potoku. Azure Databricks udostępnia pola dryfu, takie jak count_delta, avg_delta, percent_null_delta, percent_zeros_delta, percent_distinct_delta i non_null_columns_delta, pokazując, jak zespoły mogą kwantyfikować zmiany strukturalne i rozkładowe w tabeli porównawczej. Dokumentacja Azure Databricks dotycząca metryk dryfu wyjaśnia ten model wyjścia.
Poprawność formalna sprawdza wartości względem ograniczeń i reguł dziedzinowych. Obejmuje dopuszczalność wartości pustych, zakresy, dozwolone kategorie, formaty, oczekiwania co do unikalności i integralność referencyjną. Praktycznym warunkiem alertu może być każde naruszenie kluczowego ograniczenia, natomiast łagodniejsze reguły mogą alarmować, gdy odsetek naruszeń przekroczy tolerancję uzgodnioną z odbiorcą.
Dryf rozkładu mierzy ruch w zachowaniu wartości liczbowych, kategorialnych i pustych. Wychwytuje zmiany, które przechodzą przez reguły statyczne, na przykład uprawnioną kategorię stającą się nietypowo dominującą albo zwykle wypełnione pole, które się przerzedza. Incydenty dryfu schematu obejmujące ponad 5 % pól wiązano ze wzrostem o 30 % liczby problemów z jakością danych zgłaszanych przez użytkowników końcowych, według analizy incydentów dryfu schematu firmy Integrate.io. Traktuj to jako sygnał ryzyka, a nie uniwersalny próg produkcyjny.
Wskaźnik | Co mierzy | Typowy próg | Wychwytywany tryb awarii |
|---|---|---|---|
Świeżość | Oczekiwane wobec faktycznego opóźnienia dotarcia | Zdefiniowane okno SLA, często z ostrzeżeniem przed twardym naruszeniem | Spóźnione załadowania, nieaktualne pulpity, opóźnione cechy |
Kompletność | Oczekiwane wobec dostarczonych rekordów lub partycji | Wymagane partycje obecne, a wolumen dostawy w uzgodnionym paśmie | Brakujące wycinki, częściowe załadowania, utracone zdarzenia |
Stabilność schematu | Zmiana strukturalna względem linii bazowej lub kontraktu | Brak niezatwierdzonych zmian łamiących zgodność, z przeglądem zmian addytywnych | Zmiany nazw, usunięcia, zmiany typów, awarie niżej w łańcuchu |
Poprawność formalna | Zgodność z ograniczeniami i regułami biznesowymi | Reguły krytyczne muszą przechodzić, przy tolerowanych odsetkach dla niekrytycznych | Nieprawidłowe klucze, niemożliwe wartości, błędne odwołania |
Dryf rozkładu | Ruch statystyczny w czasie | Alert, gdy ruch przekroczy skalibrowaną linię bazową | Przesunięcia populacji, skoki wartości pustych, zmiany kategorii |
Te wskaźniki tworzą kontrakt między producentami a odbiorcami. Użyteczne pytanie nie brzmi, czy zbiór danych ma „dobrą jakość”. Brzmi: czy łańcuch dostawy spełnił warunki wymagane dla konkretnej decyzji, modelu lub raportu. Zespoły mogą sięgnąć po praktyczne ramy pomiaru niezawodności, aby powiązać te warunki z monitoringiem na poziomie zasobu.
Kontrole regułowe, kontrole statystyczne i wykrywanie anomalii przez AI
Żadna pojedyncza metoda wykrywania nie zobaczy każdej awarii. Kontrole regułowe są najmocniejsze, gdy oczekiwane zachowanie jest jawne. Niepusty klucz, zatwierdzona wartość statusu, poprawne odwołanie czy wymagany wzorzec da się jasno wyrazić i tanio ocenić na granicach ingestii lub transformacji.
Kontrole statystyczne rozwiązują inny problem. Ustalają linię bazową dla zachowań, których nie da się sprowadzić do jednej deterministycznej reguły, takich jak wolumen wierszy, wartość średnia, wariancja, kardynalność, udział wartości pustych czy moment dotarcia. Reguła może mówić, że kolumna nie może być pusta, a kontrola statystyczna zauważy, że wartości puste nagle stały się częste, choć kolumna technicznie pozostaje wypełniona.
Wykrywanie anomalii uczone przez AI dodaje trzecią warstwę. Modele potrafią łączyć wiele sygnałów i rozpoznawać skorelowane zachowania, których autor reguł nie przewidział. Jednoczesne przesunięcie wolumenu, świeżości, rozkładu i konsumpcji niżej w łańcuchu może wskazywać na problem z wydaniem, nawet gdy żaden pojedynczy sygnał nie przekracza ręcznie wybranej granicy.
Podejście | Najlepsze do | Ograniczenia | Warstwa |
|---|---|---|---|
Walidacja regułowa | Gwarancje kontraktowe i ograniczenia biznesowe | Koszt utrzymania przy zmianach logiki, ograniczone pokrycie nieznanych zachowań | Granice ingestii i transformacji |
Kontrole statystyczne | Dryf, sezonowość, wolumen, opóźnienia i zmiany rozkładu | Wymaga użytecznej linii bazowej i starannej kalibracji fałszywych alarmów | Monitoring zbiorów danych i potoków |
Wykrywanie anomalii przez AI | Skorelowane i wyłaniające się ryzyko w wielu sygnałach | Mniej bezpośrednio wyjaśnialne i zależne od reprezentatywnej historii | Observability międzysygnałowa i priorytetyzacja |
Układaj je według stopnia pewności
Zacznij od reguł dla warunków, które nigdy nie mogą zostać naruszone. Te kontrole powinny głośno zawodzić, gdy zepsuty klucz albo nieprawidłowe odwołanie uczyniłyby wynik niebezpiecznym. Monitoring statystyczny ustaw wokół wskaźników, które naturalnie się wahają, a czułość dostrajaj na podstawie historii incydentów, a nie arbitralnie wybranej granicy.
Wykrywanie przez AI zasługuje na swoje miejsce, gdy środowisko daje dość kontekstu behawioralnego do nauki. Powinno wskazywać kandydatów do zbadania, a nie automatycznie blokować każdy potok. Przegląd przez człowieka wciąż należy się tam, gdzie anomalia ma istotny wpływ biznesowy, gdzie linia bazowa się zmienia albo gdy system nie potrafi wyjaśnić, którego odbiorcę to dotknie.
Właściwe podejście do wykrywania anomalii w danych szeregów czasowych zależy od zachowania sygnału i od działania przypiętego do alertu. Hałaśliwe ostrzeżenie bez właściciela to nie observability. To kolejna kolejka, którą inżynierowie zignorują.
Observability, kontrole in-database i walidacja działające razem
Wyobraź sobie potok, który pobiera zdarzenia z Kafki, przekształca je w dbt i udostępnia wyselekcjonowane tabele ze Snowflake. Niezawodność rośnie, gdy zespół traktuje observability, kontrole in-database i walidację biznesową jako jedną warstwę kontroli rozłożoną na tej osi czasu.
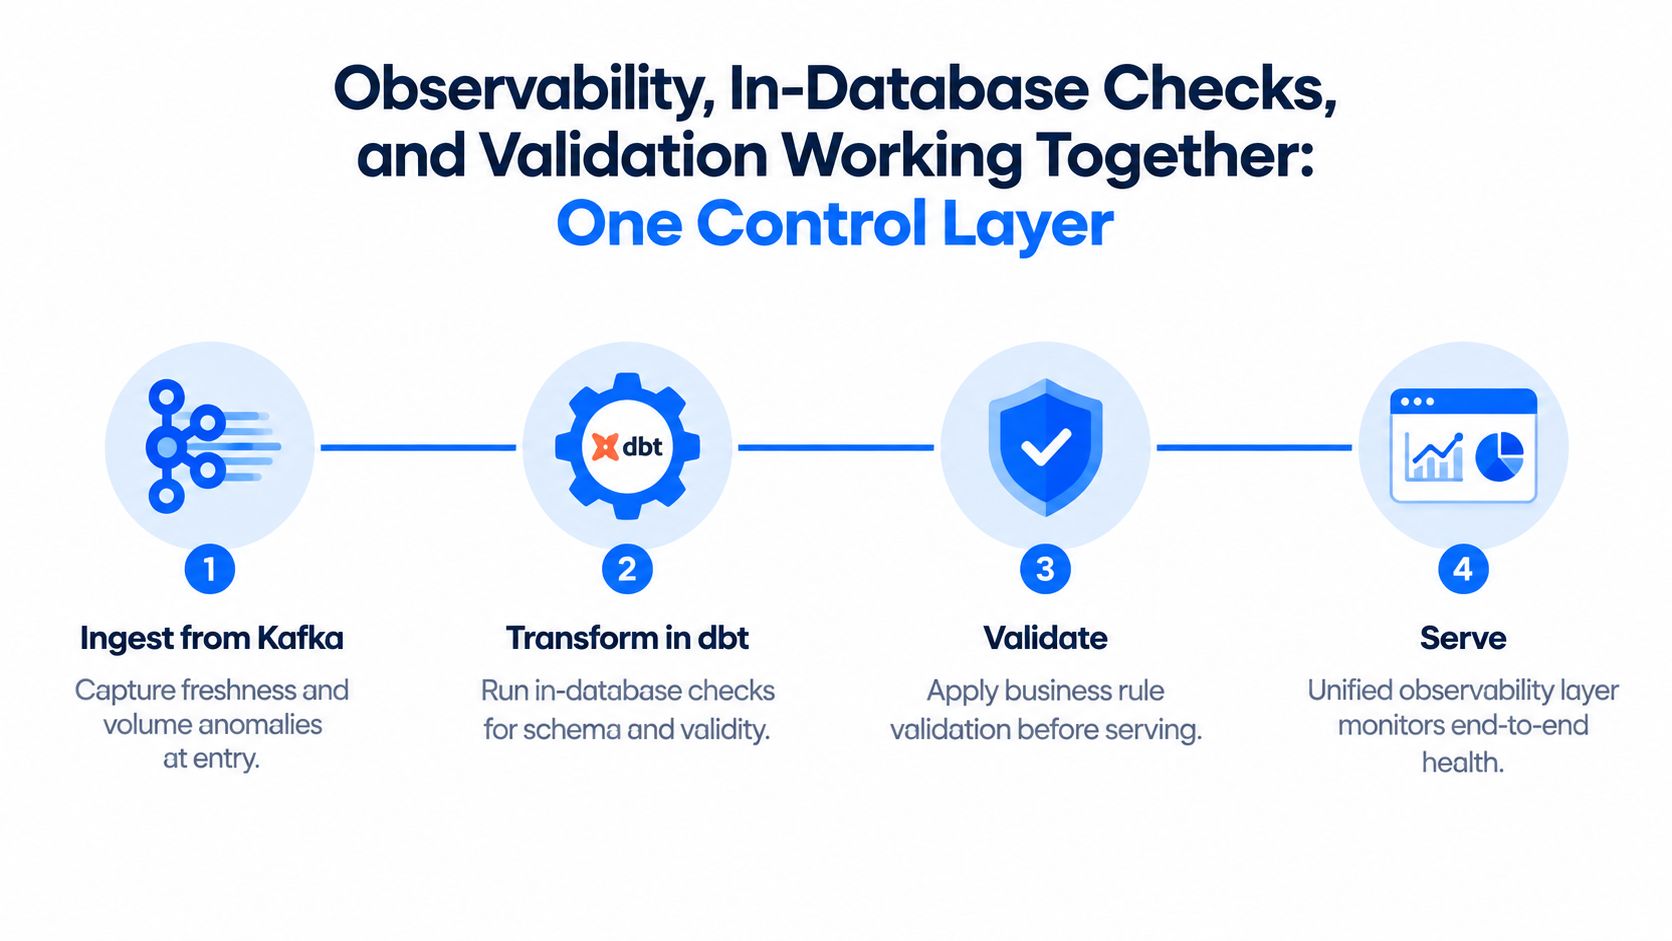
Przy ingestii lekkie kontrole porównują moment dotarcia i wolumen z oczekiwanym wzorcem. Natywne ograniczenia hurtowni i zaplanowane zapytania potrafią wychwycić brakujące pola, nieoczekiwane typy albo nietypowe liczności blisko miejsca składowania danych. Te kontrole nie wyjaśnią każdego objawu niżej w łańcuchu, ale mogą powstrzymać rozprzestrzenianie się oczywistego problemu strukturalnego.
Podczas transformacji testy dbt egzekwują kontrakty kolumn i założenia biznesowe. Równolegle warstwa observability obserwuje czas wykonania, liczbę wierszy, kondycję partycji, lineage i zachowanie zależności. Jeśli model kończy się powodzeniem, ale tworzy nieoczekiwanie małą relację, telemetria potoku dostarcza kontekstu, którego sama asercja na kolumnie nie zapewni.
Po udostępnieniu zespół porównuje konsumpcję niżej w łańcuchu z oczekiwaniami wyżej. Pulpit może pomyślnie odpytać dane i jednocześnie otrzymać nieaktualną partycję, dlatego oś czasu incydentu musi połączyć spóźnione dotarcie do Kafki, przebieg dbt, stan tabeli w Snowflake i dotknięty pulpit.
Kontrole in-database widzą naruszenia tam, gdzie mieszkają dane. Walidacja widzi, czy dane są zgodne ze znaczeniem biznesowym. Observability widzi, jak zachował się otaczający system.
Punktem integracji jest wspólny zestaw wskaźników poziomu usług i wspólny zapis incydentu. Każdy alert powinien wskazywać zasób, producenta, odbiorcę, naruszony warunek, moment pierwszej obserwacji i znane lineage. Wskazówki dotyczące reguł walidacji danych i ciągłej jakości danych pomagają zdefiniować warstwę reguł, ale wartość operacyjna pojawia się wtedy, gdy ta warstwa dzieli kontekst z monitoringiem potoków.
Bez wspólnego kontekstu zespoły wymieniają się zrzutami ekranu między narzędziami i spierają, czy awaria należy do Kafki, dbt, Snowflake czy pulpitu. Przy jednej osi czasu potrafią oddzielić wyzwalacz od objawu i przypisać naprawę zespołowi, który kontroluje właściwy kontrakt.
Bariery operacyjne, które nie pozwalają programom niezawodności utknąć
Programy niezawodności zwykle utykają z powodów organizacyjnych, zanim zawiodą technicznie. Alerty trafiają do kolejki infrastruktury, właściciele zbiorów danych nie są wskazani, a każdy zespół inaczej definiuje „zdrowy”. Bariery czynią model operacyjny jawnym.
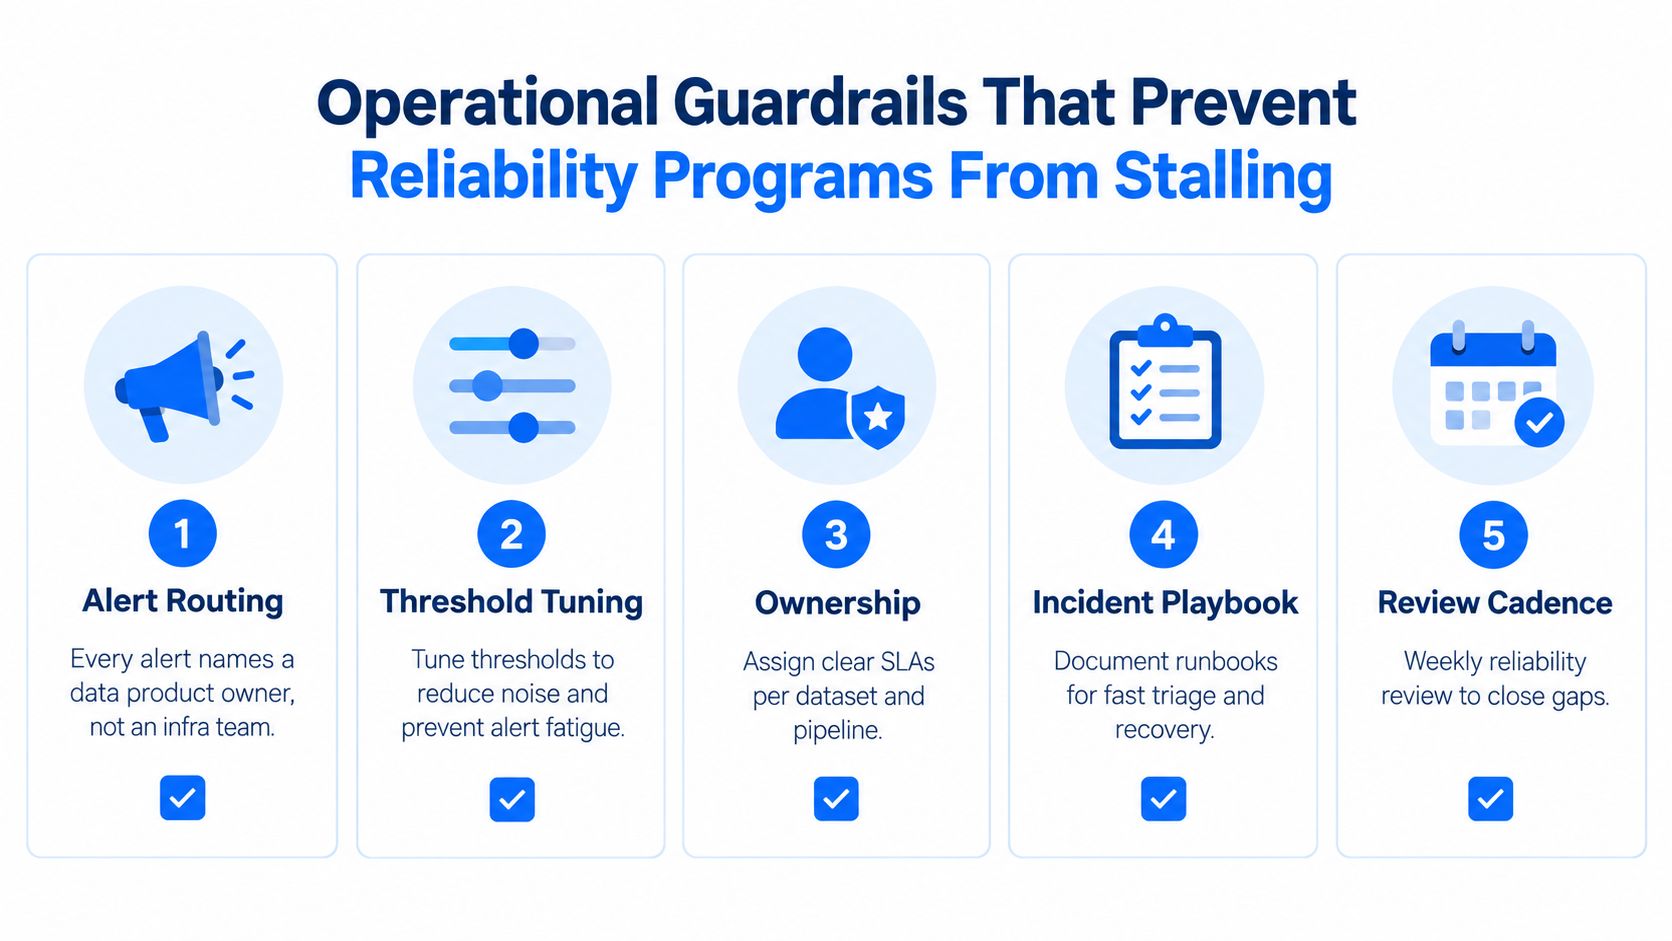
Kieruj alerty do produktu danych
Alert powinien wskazywać dotknięty produkt danych, jego właściciela i odbiorcę niżej w łańcuchu. Zespoły infrastrukturalne mogą odpowiadać za wspólne zdolności wykonawcze i monitoringowe, podczas gdy osadzone zespoły analityczne lub dziedzinowe odpowiadają za zbiory, których znaczenie kontrolują. Współwłasność bez głównej osoby reagującej zwykle oznacza, że nikt nie działa szybko.
Rozdziel poziomy usług
Nie sprowadzaj wszystkich warunków do jednej oceny ani jednego „SLA jakości danych”. Zdefiniuj osobne oczekiwania dla:
Świeżość: dopuszczalne opóźnienie ingestii, z oknem ostrzegawczym przed twardym naruszeniem.
Poprawność: wymagany udział rekordów przechodzących krytyczne reguły walidacji.
Dostępność: oczekiwane zakończenie zaplanowanych przebiegów potoku.
Wpływ: odbiorcy i procesy biznesowe dotknięci naruszeniem.
Ten podział pomaga zespołom wybrać właściwą reakcję. Spóźniona, ale poza tym poprawna tabela może wymagać uzupełnienia, natomiast tabela wyglądająca poprawnie, lecz z zerwaną integralnością referencyjną, może wymagać kwarantanny.
Utrzymuj kontrole w ścieżce dostawy
Natywne kontrole hurtowni, testy dbt, bramki zmian schematu i testy kontraktów zapobiegają temu, by niezawodność stała się osobną fazą ręcznego QA. Udokumentowany przepływ monitoringu w AWS SageMaker rozdziela przechwytywanie danych, tworzenie linii bazowej i zaplanowane zadania monitorujące, a jego linia bazowa korzysta z Deequ do obliczania ograniczeń schematu i statystyk. Dokumentacja AWS dotycząca monitoringu jakości danych modelu daje konkretny przykład zamiany oczekiwań w zaplanowane kontrole produkcyjne.
Uważaj na trzy antywzorce:
Pulpity bez właściciela: wizualna strona statusu bez osoby reagującej tworzy świadomość bez działania.
Erozja progów: zespoły stopniowo rozszerzają progi, aż alerty przestają się odzywać, zamiast naprawić linię bazową albo źródło.
Teatr niezawodności: odhaczone pola zadowalają audyt, podczas gdy spóźnione dane, zerwane lineage i nieprzejrzane zmiany schematu nadal dotykają odbiorców.
Po incydentach przeglądaj jakość alertów. Jeśli alert nie doprowadził do decyzji, zmień jego kierowanie, kontekst, próg albo działanie. Celem nie jest maksymalne pokrycie monitoringiem. Celem jest niezawodne wykrywanie powiązane z powrotem do normy.
Czego naprawdę wymaga niezawodność danych gotowa na AI
Gotowość do AI nie zaczyna się wraz z wdrożeniem modelu. Zaczyna się od dowodu, że wejścia, cechy, kontekst wyszukiwania i wyniki pozostają wiarygodne w warunkach produkcyjnych.
Najnowsze doniesienia jasno pokazują lukę. 71 % specjalistów od danych wskazuje błędne lub zmyślone wyniki docierające do interesariuszy jako jedną z głównych obaw, a PwC ustaliło, że tylko 51 % respondentów buduje czysty, uporządkowany fundament danych przed skalowaniem inicjatyw cyfrowych, jak podsumowano w tym materiale o przyspieszeniu AI i zaufaniu. Te liczby wskazują na problem operacyjny, a nie wyłącznie na problem oceny modeli.
Prześledź pełny łańcuch wejść AI
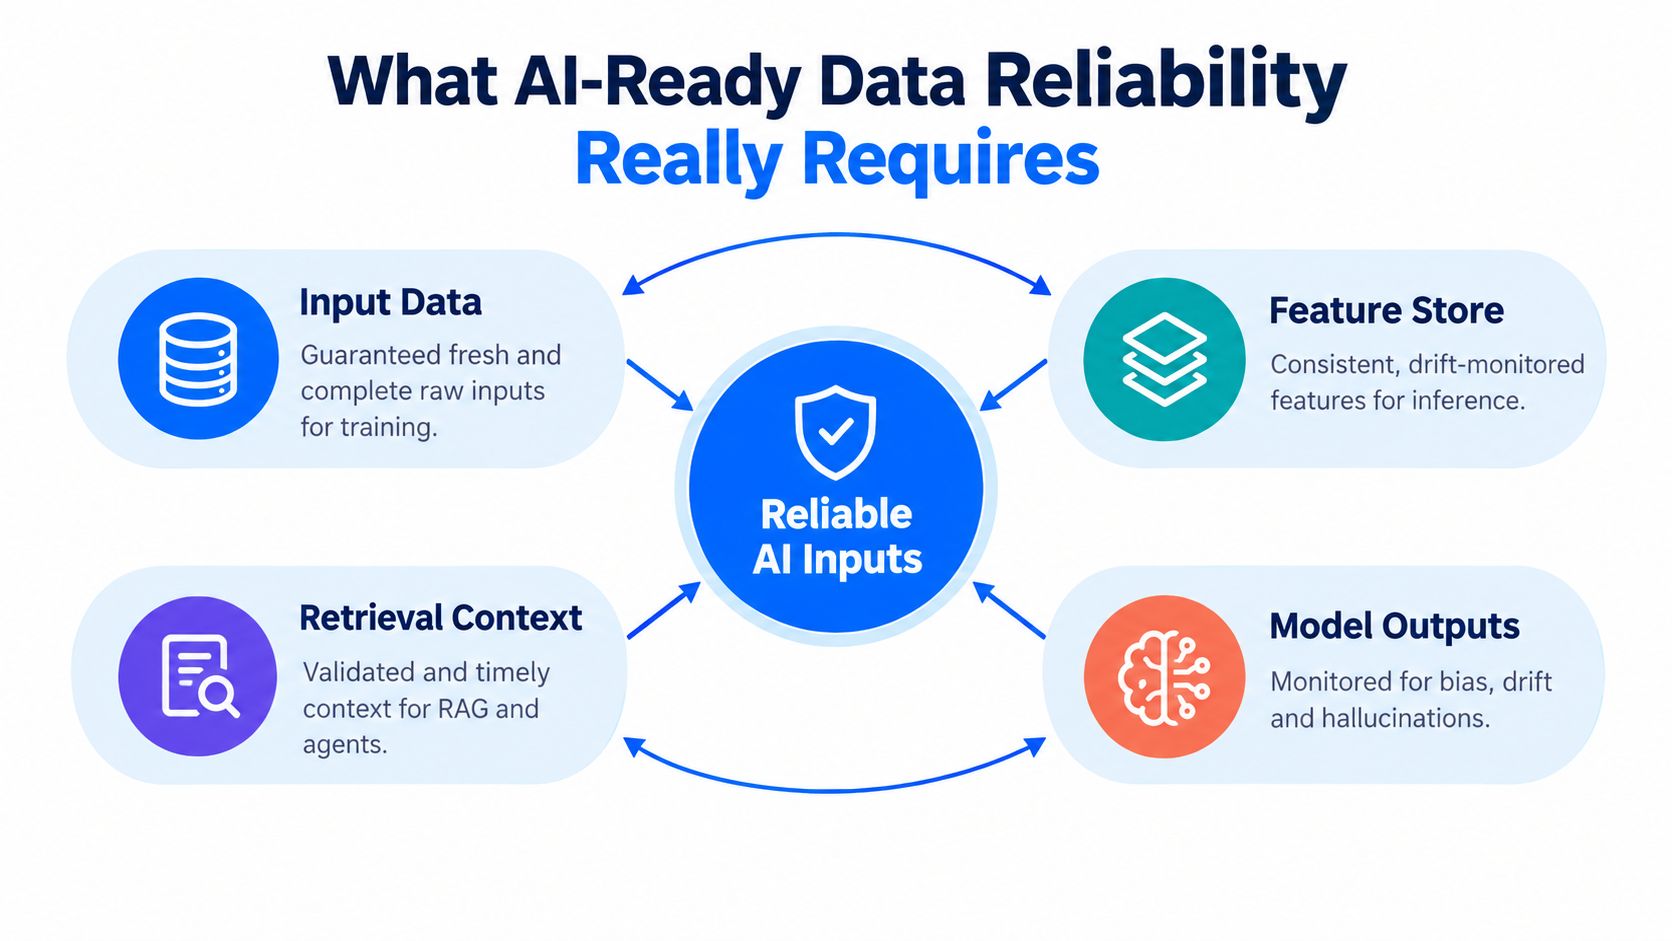
Surowe wejścia potrzebują gwarancji świeżości i kompletności. Feature store'y potrzebują spójnych definicji i monitoringu dryfu dopasowanego do okien wnioskowania. Systemy z generowaniem wspomaganym wyszukiwaniem oraz agenci potrzebują zwalidowanego, terminowego kontekstu, w tym dowodu, że dokumenty nie zostały usunięte, zmienione ani pobrane z niemonitorowanej lokalizacji.
Lineage musi łączyć cechy i pobierane treści z ich źródłami oraz transformacjami. Bez tej możliwości prześledzenia regresja jakości modelu może zamienić się w dochodzenie bez końca. Inżynierowie muszą wiedzieć, czy zmiana wyszła z danych źródłowych, logiki cech, indeksowania, wyszukiwania czy z samego modelu.
Wyniki modelu potrzebują własnej pętli zwrotnej. Monitoruj sygnały uprzedzeń, dryfu i halucynacji tam, gdzie da się je ocenić, a następnie wiąż awarie z warunkami danych wyżej w łańcuchu. Bramki promocji powinny blokować lub wstrzymywać wydanie, gdy krytyczne SLA wejść przestają być dotrzymywane, zamiast pozwalać modelowi konsumować cechy znane jako nieaktualne.
Ramy ETSI odzwierciedlają to szersze spojrzenie, definiując według cytowanego materiału 18 mierzalnych wskaźników jakości danych, w tym niezawodność, pokrycie, lineage, możliwość prześledzenia i terminowość. Gotowość do AI wynika więc z programu niezawodności, który już chroni analitykę i operacje. Nie jest osobnym ćwiczeniem zgodności ani końcowym odhaczeniem dokładności. Zasada stojąca za związkiem między modelami AI a jakością danych jest operacyjna: niepewne wejścia dają niepewne zachowanie niżej w łańcuchu, nawet gdy sam model się nie zmienił.
Jak to wszystko połączyć i co dalej
Pierwszy sprint niezawodności powinien być na tyle wąski, by go skończyć, i na tyle ważny, by się liczył. Wybierz zbiór danych krytyczny dla przychodów, zmapuj jego zależności w górę i w dół łańcucha i zdefiniuj warunki, które czynią go bezpiecznym dla głównego odbiorcy.
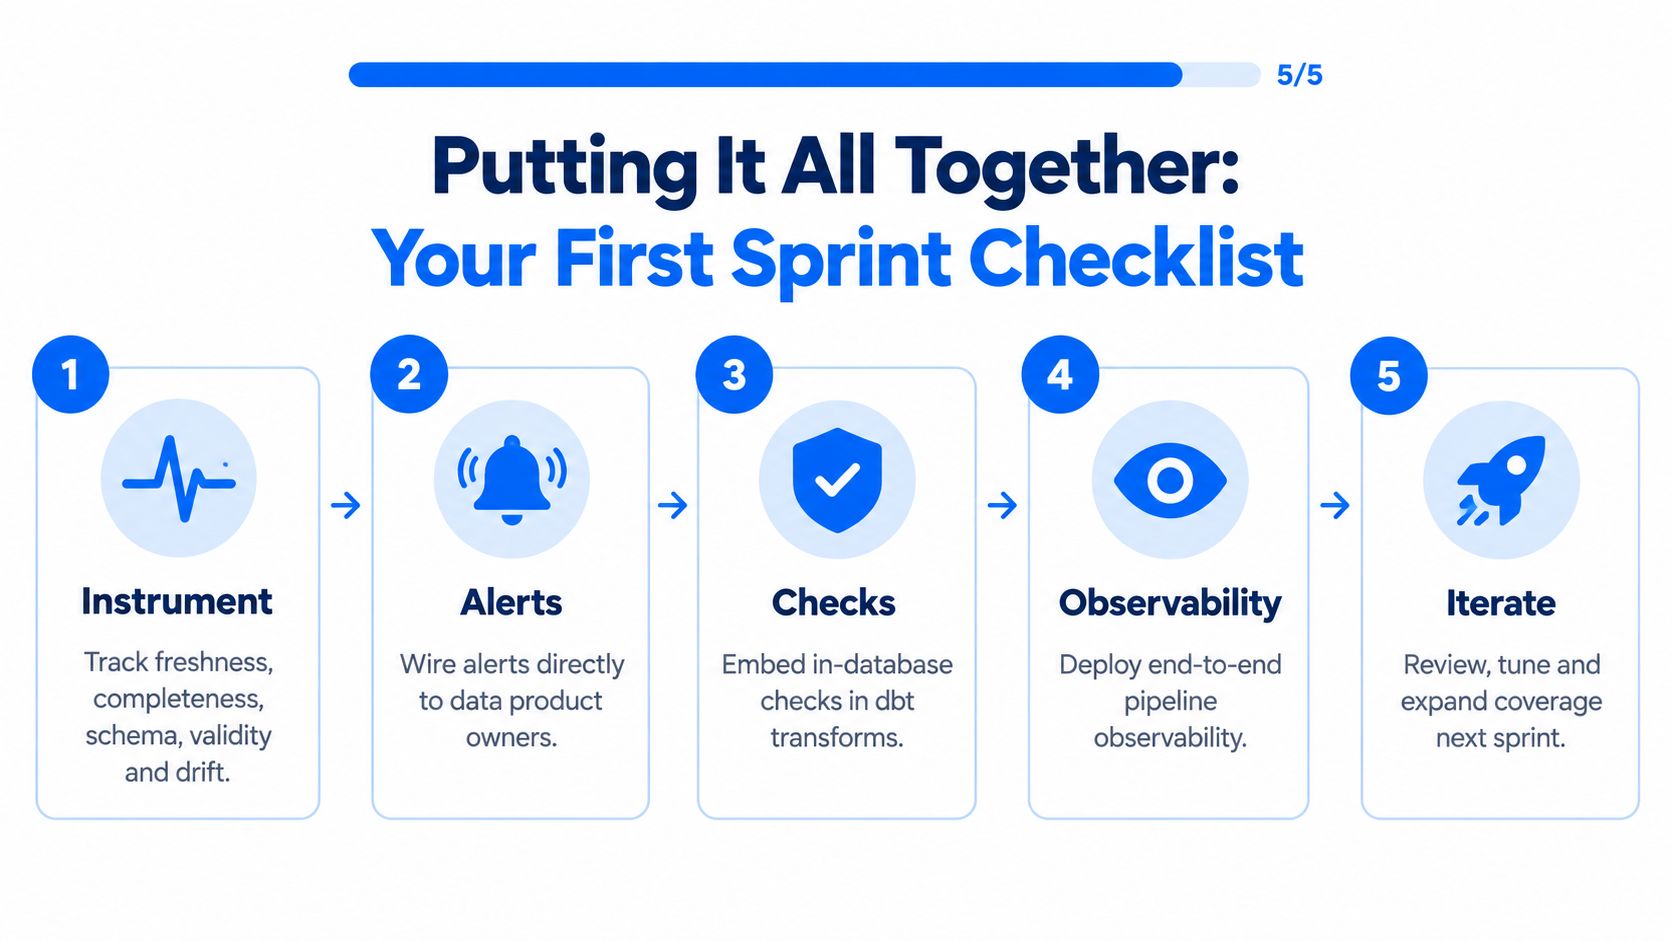
Zastosuj tę kolejność:
Oprzyrząduj łańcuch: śledź świeżość, kompletność, stabilność schematu, poprawność formalną i dryf rozkładu.
Przypisz reakcję: kieruj każdy alert do wskazanego właściciela produktu danych i wskaż dotkniętego odbiorcę.
Skodyfikuj kontrakt: udokumentuj oczekiwania dotyczące świeżości, poprawności i dostępności zasobu.
Rozmieszczaj kontrole świadomie: reguły deterministyczne dla twardych gwarancji, kontrole statystyczne dla dryfu i wykrywanie uczone dla skorelowanych anomalii.
Rozszerz ochronę na wejścia AI: zastosuj te same kontrole do danych cech, kontekstu wyszukiwania i zbiorów zasilających modele.
Rynek zmierza ku mierzalnej rękojmi zamiast mglistego języka zaufania. Wyzwaniem operacyjnym jest uczynienie tych pomiarów użytecznymi w zespołach, potokach, hurtowniach i wskaźnikach biznesowych. Wspólne karty wyników niezawodności i międzyzespołowe SLO są bardziej użyteczne niż odosobnione pulpity poszczególnych narzędzi, bo łączą kondycję techniczną z decyzjami, które od niej zależą.
Zespoły wciąż mierzą się z wąskim gardłem ręcznych testów. Badania pokazują, że 61 % polega na ręcznych kontrolach lub walidacji w SQL, tylko 27 % korzysta z dedykowanej platformy observability, a 14 % egzekwuje SLA w całej organizacji, według raportu trendów 2025 firmy Integrate.io o jakości danych i observability. Praktyczną odpowiedzią nie jest testowanie wszystkiego ręcznie. Jest nią automatyzacja dowodów w momencie dostawy, przypisanie właściciela każdej kontroli i traktowanie naruszenia na krytycznym zasobie jak incydentu produkcyjnego.
Wybierz ten zbiór danych jeszcze w tym tygodniu. Zdefiniuj trzy wskaźniki niezawodności, wskaż jednego odpowiedzialnego właściciela i przeanalizuj pierwsze naruszenie jak incydent z osią czasu i planem naprawy, a nie jak zwykłe zgłoszenie dotyczące danych.
digna dostarcza korporacyjną platformę jakości danych i observability działającą wewnątrz Twojego środowiska, łącząc walidację in-database, monitoring Timeliness, śledzenie schematu i wykrywanie anomalii w hurtowniach, jeziorach i potokach. Aby połączyć te kontrole w praktyczny program niezawodności dla analityki i AI, odwiedź digna i poznaj platformę.
Te same kontrole uporządkowane według awarii, której każda zapobiega, a nie według wskaźnika, który ją mierzy, znajdziesz w ośmiu przypadkach użycia data observability wraz z przypisanym do każdego właścicielem i ścieżką reakcji.
Najczęściej zadawane pytania
Jaka jest różnica między jakością danych a niezawodnością danych?
Jakość pyta, czy każdy rekord spełnia wymagania: poprawny, niepusty, właściwie otypowany, w zakresie. Niezawodność pyta, czy odbiorcy mogą polegać na zbiorze w czasie, w tym czy oczekiwane partycje dotarły w oknie usługi ze znanym lineage. Cegła może być solidna, podczas gdy murowi brakuje warstw.
Które wskaźniki naprawdę mierzą niezawodność danych?
Pięć pokrywa główne tryby awarii: świeżość, kompletność, stabilność schematu, poprawność formalna i dryf rozkładu. Żaden nie powinien być uniwersalną wartością „zdał – nie zdał”. Każdy próg należy do kontraktu odzwierciedlającego tolerancję odbiorcy, a kompletność warto sprawdzać per partycja, a nie per wiersz.
Kiedy stosować wykrywanie anomalii zamiast kontroli regułowych?
Reguły pasują do warunków, które nigdy nie mogą zostać naruszone, takich jak niepusty klucz czy poprawne odwołanie. Kontrole statystyczne obsługują sygnały naturalnie się wahające, w tym wolumen, kardynalność, udział wartości pustych i moment dotarcia. Wykrywanie przez AI zasługuje na miejsce przy skorelowanych przesunięciach w wielu sygnałach, których nie przewidział żaden autor reguł.
Dlaczego programy niezawodności danych utykają?
Zwykle z powodów organizacyjnych, zanim pojawią się techniczne. Alerty lądują w kolejce infrastruktury bez wskazanej osoby reagującej, każdy zespół inaczej definiuje „zdrowy”, a progi rozszerzają się, aż nic się nie odzywa. Uważaj na pulpity bez właściciela, erozję progów i odhaczone pola, które zadowalają audyt, gdy odbiorcy wciąż dostają spóźnione dane.
Czego wymaga niezawodność danych gotowa na AI?
Dowodów wzdłuż całego łańcucha wejść, a nie końcowej kontroli dokładności. Surowe wejścia potrzebują gwarancji świeżości i kompletności, feature store'y monitoringu dryfu dopasowanego do okien wnioskowania, a lineage musi łączyć cechy z ich źródłami, żeby regresja modelu nie zamieniła się w dochodzenie bez końca.


