Dlaczego jakość danych jest ważna i jak złe dane obniżają ROI
|
7
min. czyt.

Pulpit może być perfekcyjnie sformatowany, odświeżać się zgodnie z harmonogramem i mimo to doprowadzić zarząd do błędnej decyzji. Zduplikowany rekord klienta potrafi zawyżyć popyt, spóźnione załadowanie transakcji zniekształcić raportowanie przepływów pieniężnych, a zmieniony typ kolumny zepsuć model. Usterka techniczna może wyglądać drobno. Konsekwencja biznesowa rzadko taka jest.
Gartner szacuje, że złe dane kosztują organizacje średnio co najmniej 12,9 mln USD rocznie, natomiast badania cytowane przez MIT Sloan Management Review wskazują, że słaba jakość danych obniża przychody o 15–25 % w wielu firmach (dane o poprawie jakości danych). Te liczby wyjaśniają, dlaczego jakość danych jest ekonomiczną warstwą kontroli, a nie jedynie obowiązkiem inżynierii danych.
Spis treści
Wprowadzenie: dlaczego złe dane psują dobre decyzje
Koszt jest większy niż sama usterka
Co naprawdę oznacza dobra jakość danych
Poprawność otwiera przepis
Pozostałe wymiary decydują o użyteczności
Jak słaba jakość danych szkodzi biznesowi i technologii
Gdzie ujawnia się szkoda
Dlaczego jakość danych jest jeszcze ważniejsza dla AI i governance
AI wzmacnia usterki w całym przepływie pracy
Gotowość to przydatność, którą da się wykazać
Realne przykłady ryzyka, gdy jakość danych zawodzi
Naprawa reaktywna kontra wczesna kontrola
Jak kontrolować jakość danych za pomocą walidacji, Timeliness i monitoringu
Zacznij od jawnych oczekiwań
Monitoruj dostawę i strukturę
Podsumowanie: budowanie zaufania do danych w analityce i AI
Wprowadzenie: dlaczego złe dane psują dobre decyzje
Dyrektorka finansowa widzi spowolnienie przychodów w jednym regionie, wstrzymuje rekrutacje, tnie zapasy i przesuwa kampanię. Później analityk odkrywa, że system źródłowy zmienił klasyfikację transakcji. Pulpit pokazywał wiarygodne liczby, więc błąd umknął uwadze i ukształtował realne decyzje.
Analityka i AI tworzą tę samą ekspozycję w innej formie. Model prognostyczny potrafi wygenerować dopracowaną rekomendację z niepełnej historii. Przepływ oceny ryzyka klienta może korzystać z nieaktualnych atrybutów. Raport zarządczy może technicznie się zgadzać, łącząc rekordy zbudowane na różnych definicjach. Efektem są poprawki, opóźnione działanie i słabsze zaufanie do platformy danych.
Koszt jest większy niż sama usterka
Słaba jakość danych zachowuje się jak awaria na wspólnej linii zaopatrzenia. Inżynierowie sprawdzają potoki, analitycy uzgadniają sprzeczne liczby, menedżerowie czekają na potwierdzenie, a zespoły biznesowe odkładają działanie. Jeśli problem dotrze do kilku systemów niżej w łańcuchu, każda kopia staje się kolejnym miejscem do zbadania i poprawienia.
Dane branżowe podsumowane w opracowaniu TechTarget na temat jakości danych pokazują, że średnia liczba miesięcznych incydentów jakości danych wzrosła z 59 w 2022 r. do 67 w 2023 r., a średni udział dotkniętych przychodów zwiększył się z 26 % do 31 %. Odrębne badanie finansowe z 2022 r. wykazało według tego samego źródła, że 86 % liderów biznesu nie ufało, że ich dane są w stanie wesprzeć podejmowanie decyzji.
Ekonomiczną warstwą kontroli jest więc zarówno czas, jak i poprawność. Usterka wykryta przed publikacją wymaga być może jednej korekty. Ta sama usterka wykryta po tym, jak skonsumowały ją pulpity, procesy operacyjne i modele, wymaga dochodzenia na każdej dotkniętej ścieżce. Prewencja i szybkie wykrywanie ograniczają tę pracę naprawczą, nawet gdy doskonałe dane pozostają nieosiągalne.
Utrata zaufania również zmienia sposób pracy. Zespoły dokładają ręczne kontrole, prowadzą równoległe arkusze i proszą o kolejne akceptacje. Organizacja może mieć nowoczesne hurtownie, pulpity i systemy uczenia maszynowego, a mimo to decyzje zwalniają, bo nikt nie potrafi szybko zweryfikować danych wejściowych.
Dobrym punktem wyjścia jest definicja jakości danych: dane mają wartość wtedy, gdy nadają się do decyzji, procesu lub modelu, który z nich korzysta. Miarą jest niezawodne użycie, mierzone tym, jak szybko problemom zapobiegamy lub jak szybko je znajdujemy.
Co naprawdę oznacza dobra jakość danych
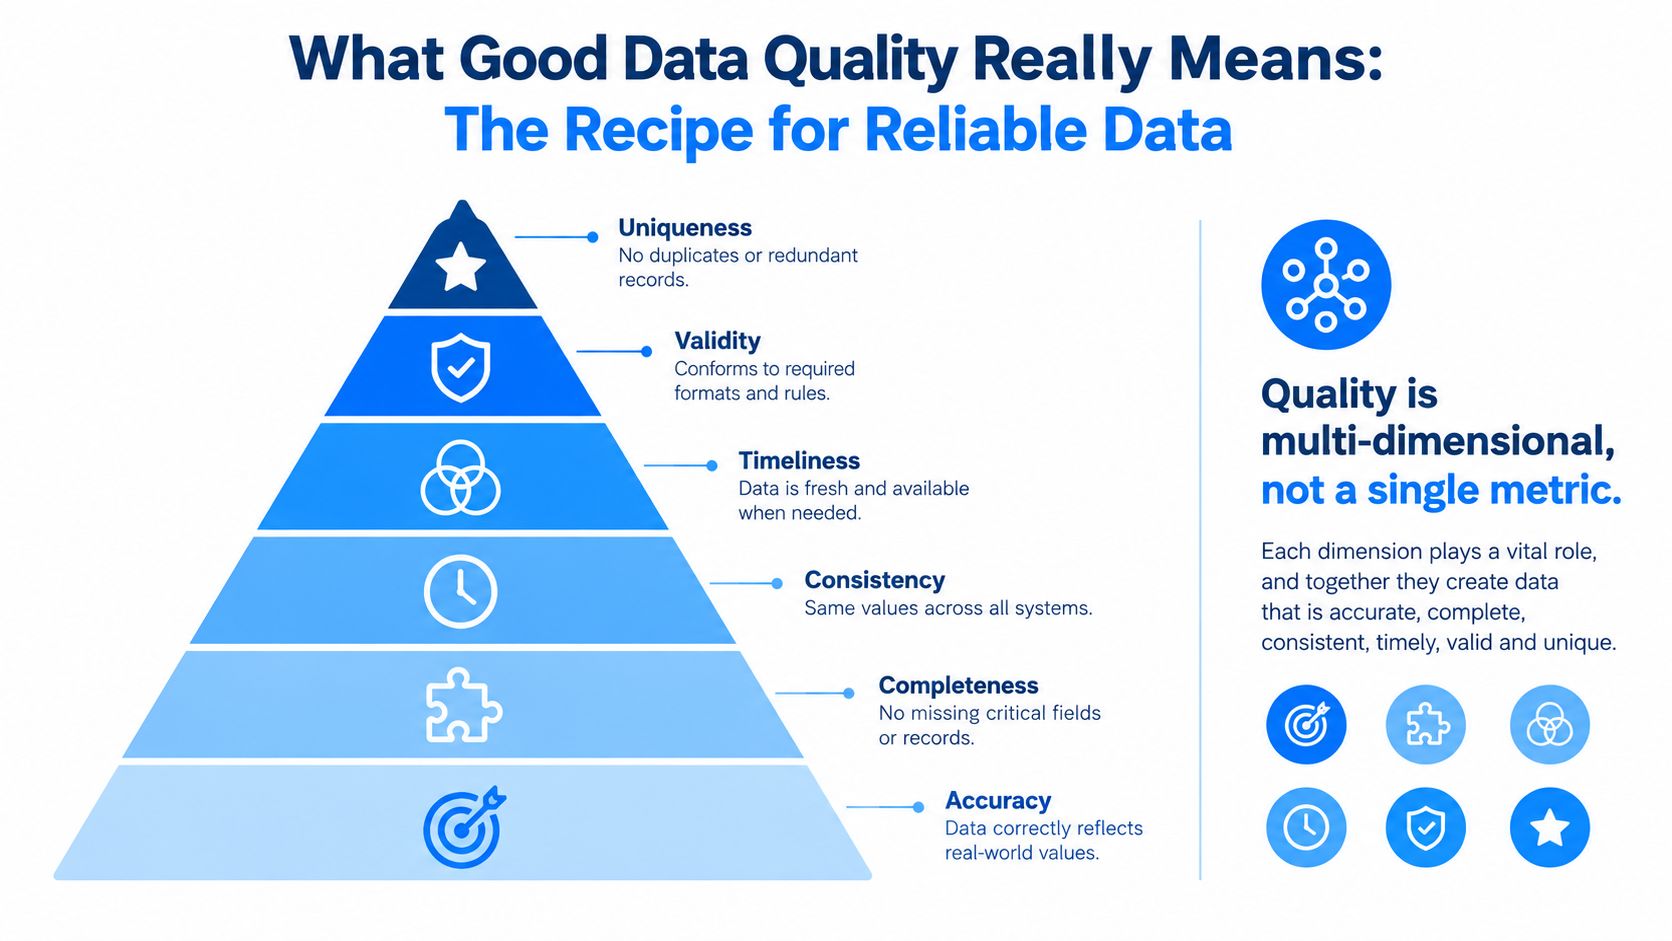
Pomyśl o zbiorze danych jak o składnikach przepisu. Świeże składniki nie wystarczą, jeśli ilości są błędne, brakuje wymaganej pozycji, dwa opakowania inaczej opisują ten sam produkt albo składniki docierają po zamknięciu kuchni. Wiarygodny wynik zależy od kilku warunków działających razem.
Jakość danych oznacza przydatność do użycia. Zbiór danych może istnieć, dawać się odpytywać i być technicznie poprawny, a mimo to nie nadawać się do konkretnego pytania biznesowego.
Poprawność otwiera przepis
Poprawność pyta, czy wartość odzwierciedla rzeczywistość. Adres klienta, saldo rachunku, cena produktu czy kod medyczny może być zapisany we właściwym polu i nadal być błędny. Poprawność zwykle wymaga porównania z zaufanym źródłem, regułą transakcyjną lub znanym warunkiem biznesowym.
Kompletność pyta, czy istnieją krytyczne rekordy i pola. Brak identyfikatora klienta może uniemożliwić złączenia. Brak znacznika czasu może uniemożliwić pomiar aktualności. Nie każda pusta wartość jest błędem, ale każda istotna pusta wartość wymaga zdefiniowanej interpretacji.
Spójność pyta, czy systemy się zgadzają. Jeśli jedna aplikacja uznaje klienta za „aktywnego”, a druga stosuje inną regułę statusu, każda tabela może wyglądać wewnętrznie spójnie, podczas gdy widok korporacyjny jest sprzeczny.
Pozostałe wymiary decydują o użyteczności
Timeliness mierzy, czy dane docierają wystarczająco świeże do swojego celu. Dzienny raport planistyczny i przepływ wykrywania fraudów w czasie rzeczywistym mają inne oczekiwania.
Poprawność formalna sprawdza, czy wartości spełniają wymagane formaty i reguły. Daty powinny dać się zinterpretować jako daty, identyfikatory podążać za przyjętymi wzorcami, a wartości statusu należeć do zatwierdzonego zbioru.
Unikalność zapobiega temu, by zduplikowane lub nadmiarowe rekordy zmieniały liczniki, salda albo historie klientów.
Te wymiary nie są wymienne. Zbiór danych może być poprawny, ale spóźniony, kompletny, ale niespójny, albo aktualny, ale nieprawidłowy formalnie. Dlatego pojedyncza ocena jakości często zasłania rzeczywisty problem.
Praktycznym zadaniem jest zdefiniowanie jakości dla konkretnego zastosowania. Raport regulacyjny może stawiać na kompletność, poprawność formalną i audytowalność. Model rekomendacyjny może potrzebować reprezentatywności, aktualności i zrównoważenia obok poprawności. Wymiary jakości danych dają zespołom słownik pozwalający zamienić mgliste obawy w testowalne oczekiwania.
Jak słaba jakość danych szkodzi biznesowi i technologii
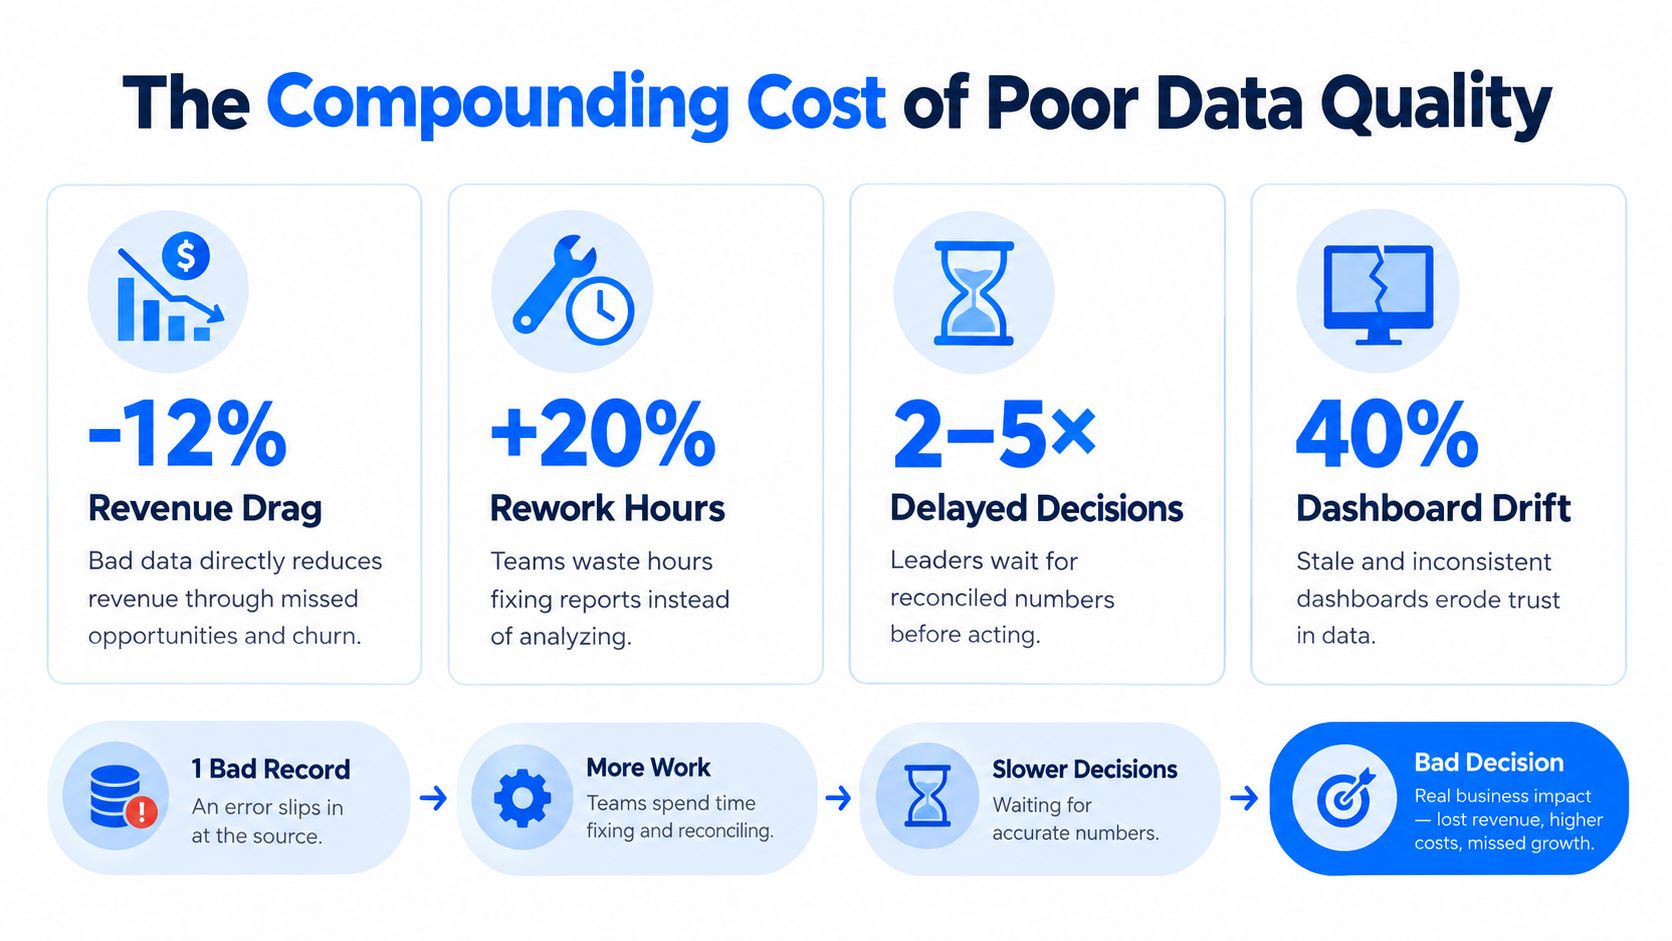
Wadliwy rekord potrafi przejść przez organizację szybciej, niż zauważy to jego właściciel. Trafia do potoku, zmienia agregat, pojawia się na pulpicie, wpływa na decyzję, a później może stać się danymi treningowymi. Każde przekazanie dodaje kolejne miejsce, w którym pierwotna usterka może zostać zamaskowana, skopiowana lub przypisana komuś innemu do naprawy.
Szeroko cytowany szacunek Gartnera określa średni koszt słabej jakości danych dla organizacji na 12,9 mln USD rocznie (ekonomiczny wpływ słabej jakości danych). Koszt ujawnia się jako ręczne uzgodnienia, nieudane procesy, odpad, poprawki, opóźnione decyzje i utracone przychody. Biznesowe korzyści z jakości danych widać wyraźniej, gdy jakość traktuje się jako warstwę kontroli tych kosztów, a nie jedynie jako porządkowanie.
Badania podsumowane w artykule recenzowanym wskazują, że słaba jakość danych może pochłaniać 8–12 % przychodów w niektórych badaniach zastrzeżonych, podczas gdy inne szacunki określają koszt na 15–25 % przychodów w wielu firmach (recenzowana dyskusja o kosztach jakości danych). Metody i organizacje się różnią, ale mechanizm pozostaje ten sam. Wadliwa informacja wpływa na marże i realizację, a nie tylko na wygląd raportu.
Gdzie ujawnia się szkoda
Zespoły zwykle widzą skutki w rozpoznawalnych postaciach:
Wyciek przychodów: zduplikowane, brakujące lub błędnie sklasyfikowane rekordy potrafią zniekształcić aktywność klientów i ukryć szanse sprzedaży.
Poprawki operacyjne: analitycy i inżynierowie uzgadniają sprzeczne wyniki zamiast ulepszać systemy źródłowe.
Opóźnienie decyzji: kadra kierownicza czeka na weryfikację liczb, zanim zatwierdzi działanie.
Dryf pulpitów: nieaktualne lub niespójne źródła sprawiają, że raporty się rozjeżdżają, i osłabiają zaufanie.
Zniekształcenie modeli: przepływy treningu i scoringu korzystają z danych wejściowych, które nie odzwierciedlają już warunków operacyjnych.
Czas do wykrycia zmienia ekonomię problemu. Usterka znaleziona przy wczytywaniu wymaga być może jednej korekty. Ta sama usterka znaleziona po raportowaniu, realizacji zamówień lub scoringu modelu może wymagać dochodzenia w kilku systemach i zespołach.
Techniczne określenie tej przerwy to zwykle data downtime. Ramy ETSI do pomiaru jakości danych opisują praktyczny model oparty na liczbie incydentów pomnożonej przez czas wykrycia i rozwiązania. Szybsze wykrywanie i usuwanie ograniczają pracochłonność i zakłócenia, nawet gdy doskonałe dane nie są od razu osiągalne. Reguły prewencyjne są cenne z tego samego powodu: zatrzymują powtarzalne usterki, zanim każde kolejne przekazanie wygeneruje więcej poprawek.
Badanie 20 000 organizacji zatrudniających co najmniej dziesięć osób wykazało, że słaba jakość samych danych relacyjnych powodowała w Holandii około 400 mln euro dodatkowych kosztów rocznie (badania empiryczne nad biznesowym wpływem jakości danych). Powtarzalne lokalne awarie mogą więc urosnąć do kosztów w skali przedsiębiorstwa.
Praktyczne pytanie brzmi: jak szybko zespół potrafi wykryć zmianę, ograniczyć jej skutki i wskazać osobę do korekty, zanim usterka dotrze do decyzji.
Dlaczego jakość danych jest jeszcze ważniejsza dla AI i governance
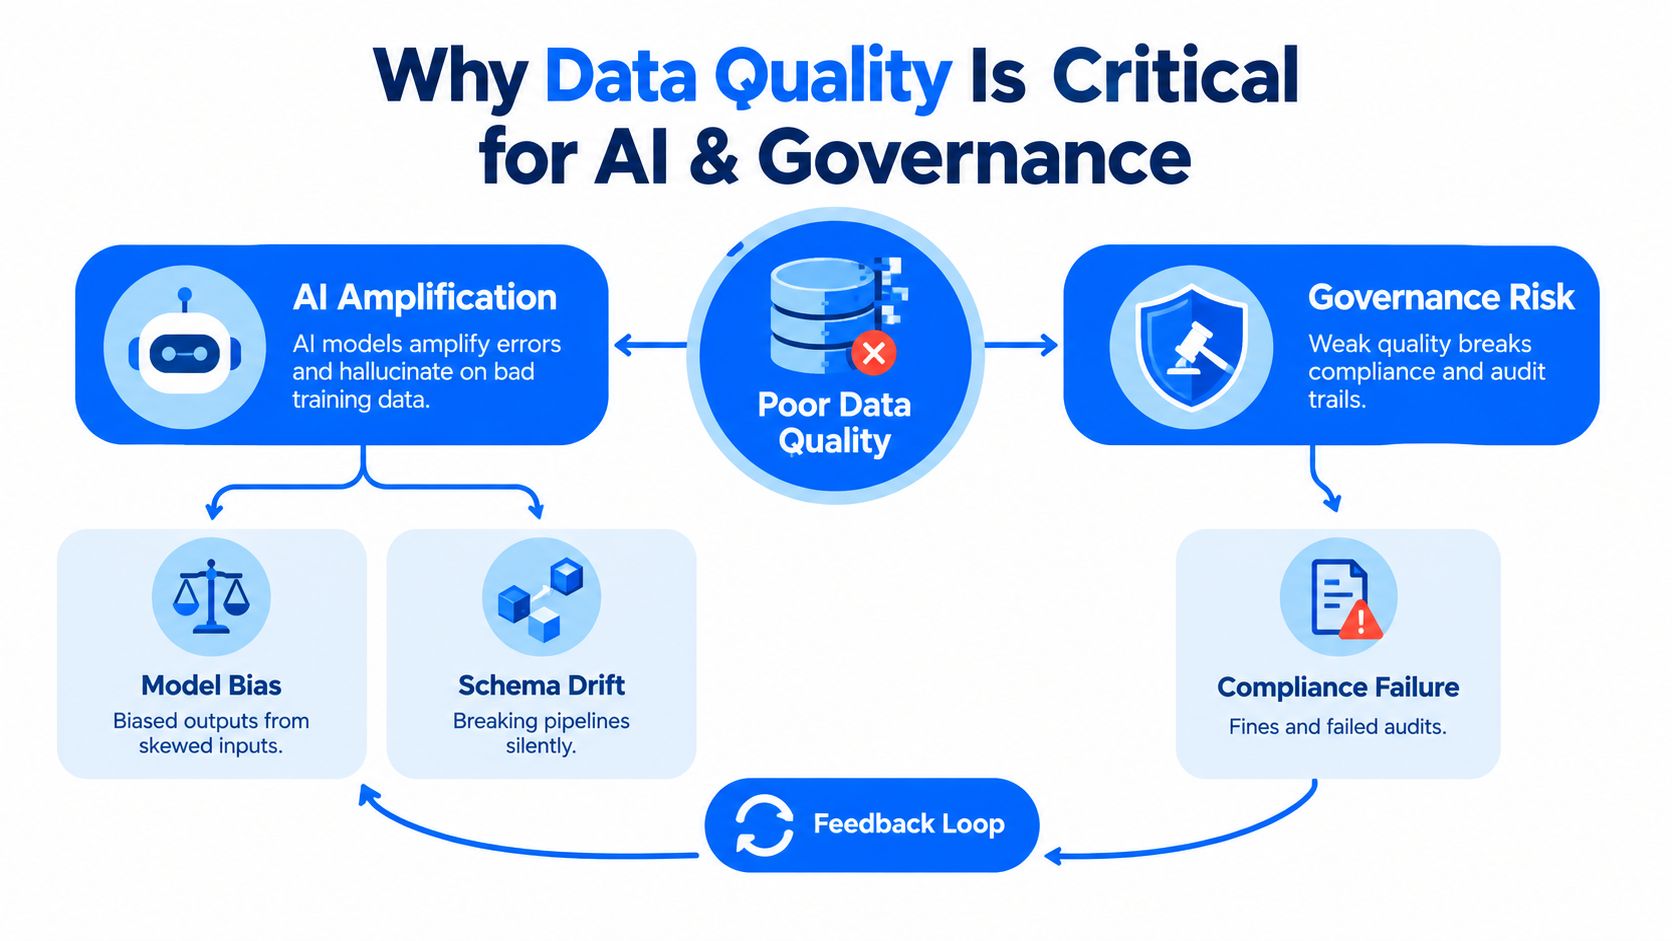
AI potrafi zamienić drobną usterkę danych w pewne siebie działanie biznesowe. Klasyczne raportowanie ujawnia czasem oczywisty błąd, gdy suma się nie zgadza albo pulpit jest nieaktualny. System AI może natomiast przekształcić to samo wadliwe wejście w klasyfikację, rekomendację, wygenerowany tekst lub automatyczną decyzję, która wygląda rozsądnie.
Gotowość do AI zależy od czegoś więcej niż poprawne wartości. Zespoły muszą wiedzieć, czy dane są aktualne, zrównoważone, reprezentatywne, dostępne, audytowalne i możliwe do prześledzenia w całym cyklu życia. Model może dobrze wypaść na wąskim zbiorze testowym, a potem zawieść, gdy zmienią się dane produkcyjne albo do przepływu trafią przypadki niedoreprezentowane. Jakość danych stojących za modelem AI decyduje o tym, na ile można ufać jego wynikom.
AI wzmacnia usterki w całym przepływie pracy
Brakujące pole może dotknąć jednego raportu. W przepływie uczenia maszynowego to samo pominięcie może wpłynąć na tworzenie cech, trening, ewaluację i scoring produkcyjny. Zmiana schematu może zatrzymać potok albo przejść niezauważona, zmieniając przy tym znaczenie cechy.
Governance dokłada wymóg dowodów. Zespoły muszą pokazać, jakich danych użył system, jakie reguły obowiązywały, kiedy dane dotarły i jak obsłużono incydent. Bez takiego zapisu wyjaśnienie automatycznej decyzji staje się trudne, nawet gdy wynik wygląda wiarygodnie.
ISO/IEC 5259-5:2025 definiuje ramy governance jakości danych dla analityki i uczenia maszynowego w całym cyklu życia danych. Do jej wymiarów należą dostępność, audytowalność, aktualność, poprawność, terminowość, zrównoważenie, różnorodność i reprezentatywność (ramy ISO/IEC 5259-5:2025).
Gotowość to przydatność, którą da się wykazać
Badanie rynku przywołane wraz z normą wykazało, że tylko 12 % organizacji uznało swoje dane za wystarczająco dobre jakościowo i dostępne do skutecznego wdrożenia AI, a 64 % wskazało jakość danych jako największe wyzwanie w obszarze integralności danych. Liczby wskazują na lukę gotowości, a nie na wymóg bezbłędnych danych wszędzie.
Praktycznym celem jest kontrolowane użycie. Określ, które wymiary liczą się dla każdego modelu, monitoruj je w sposób ciągły, zachowuj dowody i zatrzymuj lub izoluj dane wykraczające poza uzgodnione granice. Governance działa najlepiej, gdy jest połączone z potokami tworzącymi i konsumującymi dane, dzięki czemu zespoły wcześnie wykrywają problemy i zapobiegają powtarzalnym kosztom w dalszej części łańcucha, zamiast traktować jakość jako papierologię po wdrożeniu.
Realne przykłady ryzyka, gdy jakość danych zawodzi
Awaria jakości danych może pozostać niewidoczna, gdy systemy działają normalnie. Wpływ biznesowy zależy mniej od tego, czy błąd istnieje, a bardziej od tego, jak długo pozostaje dostępny dla odbiorców w dalszej części łańcucha.
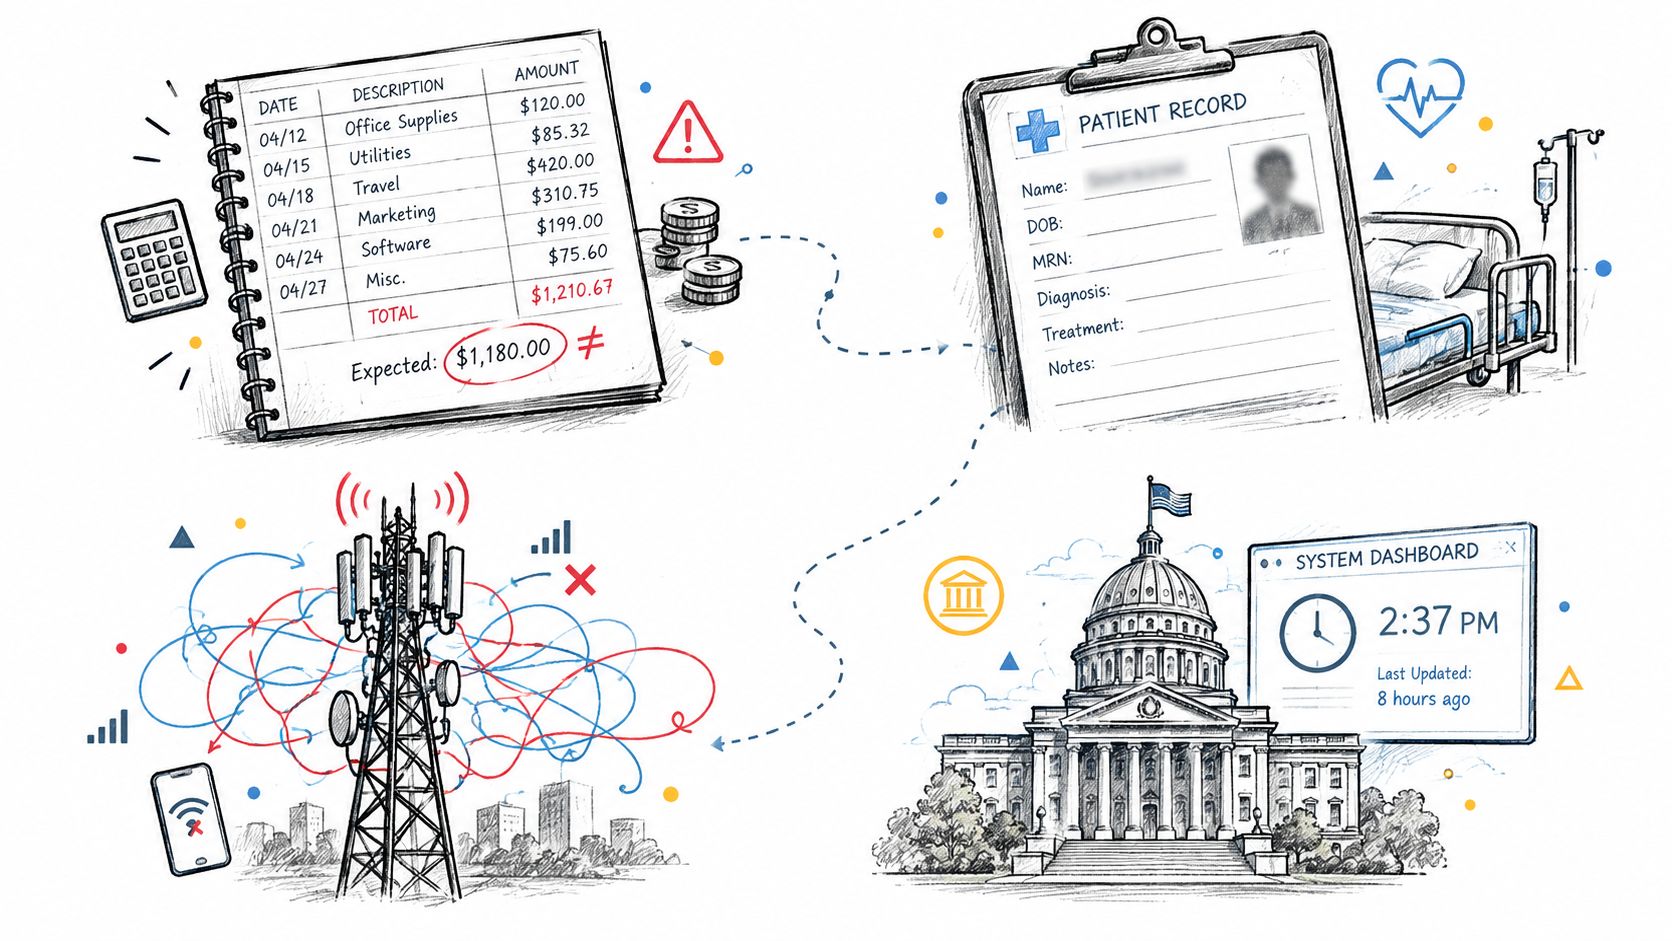
W finansach spóźnione załadowanie transakcji może sprawić, że pulpit ryzyka wygląda spokojniej niż faktyczny portfel. W ochronie zdrowia brakujące lub niespójne atrybuty pacjentów mogą utrudnić raportowanie kliniczne i sprawozdawczość regulacyjną. W telekomunikacji zmiana schematu w danych o użyciu może zmienić logikę agregacji i zostawić zespoły z niepełnym obrazem aktywności klientów. W sektorze publicznym niespójne identyfikatory mogą uniemożliwić wiarygodne uzgodnienia między urzędami.
Takie awarie nie wymagają spektakularnej przerwy w działaniu. Raport może odświeżyć się poprawnie, pomijając partycję. Potok może przyjąć nowy typ danych, podczas gdy logika niżej interpretuje go błędnie. Model może dalej scorować po przesunięciu rozkładu wejściowego, dając wyniki, które wyglądają poprawnie, ale nie wspierają już tej samej decyzji.
Naprawa reaktywna kontra wczesna kontrola
Reguła 1-10-100 pokazuje, dlaczego czas wykrycia ma skutek ekonomiczny. Zapobieżenie błędowi w danych kosztuje około 1 USD, poprawienie go po wejściu do systemu 10 USD, a poradzenie sobie z nim, gdy pozostanie niezauważony, 100 USD (model kosztowy 1-10-100 dla jakości danych).
Podejście | Co się dzieje | Typowa konsekwencja |
|---|---|---|
Kontrola prewencyjna | Reguła lub kontrakt blokuje nieprawidłową wartość przed publikacją | Problem pozostaje blisko swojego źródła |
Wczesne wykrycie | Monitoring wskazuje nietypową wartość, opóźnienie lub zmianę strukturalną | Mniejszy zespół może zbadać sprawę przed użyciem w dalszej części łańcucha |
Naprawa reaktywna | Użytkownicy odkrywają problem w raporcie, modelu lub procesie biznesowym | Uzgadnianie, poprawki i odbudowa zaufania trwają dłużej |
Doskonałe dane nie są wymogiem operacyjnym. Praktycznym celem jest wychwycenie usterek, dopóki są lokalne, zanim zależeć będą od nich raporty, modele i procesy biznesowe.
Dane branżowe podsumowane przez TechTarget pokazują, że średnia liczba miesięcznych incydentów wzrosła z 59 do 67 między 2022 a 2023 r., a średni udział dotkniętych przychodów zwiększył się z 26 % do 31 % (dane o incydentach i wpływie na przychody). W tym kontekście liczby stawiają pytanie o prewencję: jak szybko zespół potrafi wykryć usterkę, wskazać narażonych odbiorców i wstrzymać dalsze użycie? Szybsze wykrycie ogranicza liczbę systemów wymagających korekty i utrzymuje naprawę bliżej źródła.
Jak kontrolować jakość danych za pomocą walidacji, Timeliness i monitoringu
Działający program jakości łączy kontrole w różnych punktach cyklu życia danych. Walidacja zapobiega naruszeniom znanych reguł. Wykrywanie anomalii znajduje zachowania, których reguły nie opisują. Monitoring Timeliness wskazuje awarie dostaw, a śledzenie schematu wychwytuje zmiany strukturalne mogące zepsuć odbiorców.
Zacznij od jawnych oczekiwań
Walidacja na poziomie rekordu to właściwe narzędzie dla warunków deterministycznych. Sprawdzaj pola obowiązkowe, dopuszczalne wartości, unikalność, integralność referencyjną, relacje między datami i reguły biznesowe. Rekord płatności może wymagać prawidłowego odniesienia do rachunku. Zamówienie może wymagać nieujemnej ilości i daty dostawy następującej po dacie zamówienia.
Wykrywanie anomalii odpowiada na inne pytanie: czy dzisiejsze zachowanie różni się od ustalonego wzorca? Statyczny próg może przeoczyć stopniowe przesunięcie albo zgłosić normalną zmianę sezonową. Uczenie linii bazowej pomaga rozpoznać nietypowe wolumeny, rozkłady lub ruchy wskaźników bez konieczności pisania przez inżynierów każdej możliwej reguły.
Monitoruj dostawę i strukturę
Monitoring Timeliness powinien odzwierciedlać sposób, w jaki odbiorcy korzystają z danych. Śledź oczekiwany czas dotarcia, brakujące załadowania, spóźnione partycje i nieoczekiwanie wczesne dostawy. Zbiór danych docierający po porannej decyzji może być technicznie kompletny, a operacyjnie bezużyteczny.
Śledzenie schematu obserwuje dodane lub usunięte kolumny, przemianowane pola i zmiany typów danych. Daje producentom i odbiorcom szansę uzgodnienia zmian, zanim modyfikacja struktury zmieni pulpit albo model.
Reguła praktyczna: wykrywaj awarię możliwie blisko punktu, w którym wchodzi do systemu, a następnie kieruj alert do osoby, która potrafi ją naprawić.
Wspólny pulpit pozwala inżynierom danych, analitykom i właścicielom biznesowym widzieć ten sam incydent, tę samą historię i ten sam status. Wykonywanie in-database pozwala utrzymać obliczanie wskaźników w środowisku klienta, ograniczając zbędny ruch danych i dopasowując monitoring do wymogów bezpieczeństwa. Zespoły mogą łączyć te praktyki z podejściem opisanym w materiale reguły walidacji danych i ciągła jakość.
Etap | Koszt względny | Wpływ biznesowy |
|---|---|---|
Zapobiegać | Około 1 USD | Zatrzymuje błąd, zanim się rozprzestrzeni |
Wykryć i poprawić wcześnie | Około 10 USD | Ogranicza liczbę dotkniętych systemów i zmniejsza nakład dochodzenia |
Naprawiać po awarii | Około 100 USD | Wydłuża poprawki, opóźnia decyzje i niszczy zaufanie |
Kolejność ma znaczenie. Prewencja chroni proces, wykrywanie chroni decyzję, a naprawa przywraca system po tym, jak szkoda już się rozeszła.
Podsumowanie: budowanie zaufania do danych w analityce i AI
Wiarygodny program jakości zaczyna się od wyboru, a nie od listy kontrolnej. Wybierz trzy zbiory danych, których awaria najpoważniej uderzyłaby w przychody, zgodność, operacje lub system AI. Te zbiory stają się pierwszym poligonem dla kontroli na tyle konkretnych, by wspierały decyzje.
Dla każdego z nich zapisz decyzję, którą wspiera, akceptowalny czas dotarcia oraz warunki czyniące rekord użytecznym. Wyznacz właściciela, który potrafi zadziałać, gdy te warunki zostaną naruszone. Walidacja sprawdza wtedy, czy dane nadają się do swojego celu, a kontrole Timeliness potwierdzają, że są dostępne, gdy wymaga tego decyzja.
Zadawaj dla każdego zbioru danych ten sam krótki zestaw pytań:
Przydatność: które pola, wartości i relacje muszą być poprawne, kompletne, prawidłowe formalnie, spójne i unikalne?
Timeliness: jak późno mogą dotrzeć dane, zanim ucierpi wspierana przez nie decyzja?
Własność: kto bada alert, poprawia źródło i potwierdza powrót do normy?
Dowód: jaki zapis pokazuje awarię, reakcję i wynik?
Takie podejście pozwala uniknąć częstej pułapki: wkładania tego samego wysiłku w każdą tabelę. Eksploracyjny zbiór o niskim wpływie może poczekać, a wskaźnik finansowy, strumień regulacyjny albo model produkcyjny dostaje uwagę w pierwszej kolejności. Celem nie są doskonałe dane wszędzie. Celem są wiarygodne dane tam, gdzie błędy niosą konsekwencje, wraz z kontrolami, które można testować i ulepszać.
digna wspiera ten model operacyjny jako platforma jakości danych i observability działająca wewnątrz środowiska klienta. Jej moduły zapewniają wykrywanie anomalii, walidację na poziomie rekordu, monitoring Timeliness, śledzenie zmian schematu, analizę historyczną i wspólną widoczność w hurtowniach, jeziorach i potokach, bez wyprowadzania danych produkcyjnych poza środowisko klienta.
Odwiedź digna, aby zobaczyć, jak modułowa platforma może pomóc Twojemu zespołowi walidować krytyczne rekordy, śledzić terminowość dostaw, wykrywać anomalie i rozpoznawać zmiany schematu we własnej infrastrukturze. Zacznij od udokumentowania najważniejszych trzech zbiorów danych, a następnie rozszerzaj monitoring w miarę, jak zespół rozpozna, które kontrole zapobiegają najpoważniejszym awariom.
Timeliness to wymiar, który zespoły najczęściej zostawiają niezdefiniowany, a to on decyduje, czy poprawny zbiór danych jest jeszcze użyteczny w momencie decyzji — wskaźniki i wzorce monitoringu stojące za nim opisuje przewodnik digna po Data Timeliness.
Najczęściej zadawane pytania
Dlaczego jakość danych jest ważna dla ROI biznesu?
Ponieważ usterki wędrują. Zduplikowany rekord klienta potrafi zawyżyć popyt, a spóźnione załadowanie transakcji zniekształcić raportowanie przepływów pieniężnych. Gartner określa średni koszt słabej jakości danych na 12,9 mln USD rocznie, a badania cytowane przez MIT Sloan szacują spadek przychodów w wielu firmach na 15–25 %.
Ile kosztuje naprawa problemu z jakością danych po tym, jak się rozprzestrzenił?
Reguła 1-10-100 jest roboczym punktem odniesienia: około 1 USD, by zapobiec błędowi, 10 USD, by poprawić go po wejściu do systemu, i 100 USD, by poradzić sobie z nim, gdy pozostanie niezauważony. Większość tego kosztu napędza czas do wykrycia, a nie rozmiar usterki.
Jakie są wymiary jakości danych?
Poprawność, kompletność, spójność, Timeliness, poprawność formalna i unikalność. Nie są wymienne: zbiór danych może być poprawny, ale spóźniony, kompletny, ale niespójny, albo aktualny, ale nieprawidłowy formalnie. Dlatego pojedyncza ocena jakości zwykle zasłania właśnie ten problem, który wymaga naprawy.
Dlaczego jakość danych ma większe znaczenie dla AI niż dla raportowania?
Raportowanie często ujawnia błąd, gdy suma się nie zgadza albo pulpit traci aktualność. System AI zamienia to samo wadliwe wejście w pewnie sformułowaną klasyfikację lub rekomendację. Tylko 12 % organizacji uważa swoje dane za wystarczająco dobre jakościowo i dostępne do skutecznego wdrożenia AI.
Jak zacząć program jakości danych?
Wybierz trzy zbiory danych, których awaria najmocniej uderzyłaby w przychody, zgodność lub model produkcyjny. Dla każdego zapisz decyzję, którą wspiera, jak późno może dotrzeć i jakie warunki czynią rekord użytecznym, a następnie wskaż właściciela, który zadziała, gdy te warunki zostaną naruszone.


