Projektowanie i wdrażanie dashboardu do monitorowania KPI
|
6
min. czyt.

Większość porad dotyczących dashboardu do monitorowania KPI zaczyna się w niewłaściwym miejscu. Zespoły obsesyjnie dopracowują style wykresów, palety kolorów i siatki układu, a potem są zaskoczone, gdy interesariusze przestają ufać liczbom. W środowiskach enterprise dashboardy zwykle nie zawodzą dlatego, że źle wyglądają. Zawodzą, bo dane pod nimi zmieniają strukturę, tracą aktualność albo oddalają się od biznesowej definicji, którą wszyscy uważali za obowiązującą.
Dashboard może być jednocześnie przejrzysty wizualnie i niebezpieczny operacyjnie. Jeśli zespół finansowy, proces w CRM i model marketingowy liczą ten sam KPI na różne sposoby, wykres może wyglądać dopracowanie, a decyzja, którą wspiera, jest już podważona. Dlatego niezawodny monitoring zaczyna się od zaufania, a nie od dekoracji, a najlepsze dashboardy działają mniej jak tablice wyników, a bardziej jak systemy kontrolne.
Spis treści
Dlaczego większość dashboardów do monitorowania KPI zawodzi
Najczęstszy scenariusz porażki jest prosty. Zespoły budują dashboard, który wygląda na kompletny, i zakładają, że sama obecność wykresów oznacza stabilność metryki. W rzeczywistości dashboard do monitorowania KPI często staje się kruchy w chwili, gdy zmieniają się dane źródłowe, modyfikowana jest transformacja albo reguła biznesowa zostaje przepisana, a nikt nie aktualizuje warstwy definicji.
Ładny widok potrafi ukryć poważne problemy operacyjne. Jednym z najwyraźniejszych przykładów jest rozdźwięk między tym, co widzą użytkownicy, a tym, co faktycznie robi pipeline danych. Jeśli dashboard jest zasilany cyklem nocnego przeładowania z zachowaną historią, jak w publicznym przewodniku KPI hrabstwa Los Angeles, to już działa jako system operacyjny, a nie statyczny raport, ponieważ jego wartość wynika z ciągłości, historii i kontrolowanego odświeżania, a nie z samej prezentacji (przewodnik użytkownika dashboardów KPI hrabstwa Los Angeles).
Zaufanie niszczy cichy dryf
Cichy dryf jest gorszy niż zepsuty wykres, bo sam się nie zdradza. Wykres z brakującymi danymi wygląda podejrzanie, ale wykres z nieznacznie błędną logiką często wygląda na tyle normalnie, że przechodzi weryfikację. Na tym polega zagrożenie w środowiskach enterprise, zwłaszcza gdy różne zespoły liczą ten sam KPI na podstawie różnych systemów źródłowych.
Zaufanie umiera na długo przed tym, zanim wykres zacznie wyglądać na zepsuty.
Praktyczną odpowiedzią jest traktowanie dashboardu jako monitorowanego produktu, a nie statycznego artefaktu. Oznacza to jednoczesne obserwowanie danych wejściowych, definicji i sposobu korzystania. Korzystanie ma znaczenie, bo wartość dashboardu często mierzy się tym, czy docelowi użytkownicy otwierają go w określonym okresie, a wytyczne dotyczące adopcji zwykle śledzą liczbę aktywnych użytkowników tygodniowo, odsetek powrotów w kolejnych tygodniach, liczbę eksportów oraz liczbę cytowań w przeglądach biznesowych (wytyczne dotyczące adopcji dashboardów).
Dashboard, do którego nikt nie wraca, zwykle coś komunikuje. Albo dane są nieaktualne, albo definicje są niejasne, albo układ ukrywa sygnał pod nadmiarem szumu. Jako praktyczne spojrzenie na jakość warto przeczytać wewnętrzny materiał dlaczego problemy z danymi wciąż wywołują konflikty i jak poprawić jakość danych, ponieważ spory o dane są często w istocie sporami o zaufanie, odpowiedzialność lub pochodzenie danych.
Wybór metryk, które prowadzą do realnych działań biznesowych
Dashboard pełen metryk próżności jest gorszy niż pusty ekran. Tworzy iluzję kontroli, a operatorom nie daje niczego, co mogliby zmienić. Wybieraj KPI, które przekładają się na konsekwencję biznesową, próg i wskazanego właściciela.
Zacznij od decyzji, nie od wykresu. Zapytaj, jakie działanie powinno nastąpić, gdy KPI się zmieni, kto powinien je podjąć i jak duża musi być zmiana, zanim zasłuży na uwagę. Jeśli odpowiedzi na te trzy pytania są niejasne, metryka należy do raportu, a nie do dashboardu monitorującego.

Zbuduj metrykę wokół decyzji
Użyteczny KPI spełnia trzy warunki. Odzwierciedla wynik biznesowy, a nie surową aktywność. Ma strefę ostrzegawczą i strefę krytyczną. Ma też właściciela, który może zareagować, gdy metryka przekroczy granicę.
Taka struktura odpowiada praktycznym wytycznym zarządzania przez wyjątki, w którym każdy KPI ma wartość docelową, próg ostrzegawczy i próg krytyczny. Ułatwia też ograniczenie głównego widoku do około 5–10 KPI, aby dashboard nie zamienił się w wizualny backlog (dobre praktyki Domo dotyczące dashboardów KPI). Nie chodzi o minimalizowanie informacji. Chodzi o to, by zachować uwagę dla anomalii, które wymagają działania.
Praktyczna zasada: jeśli metryka nie wywołuje reakcji, to nie jest KPI monitorujący, tylko wartość referencyjna.
OKR i KPI pełnią różne funkcje. OKR opisuje kierunek lub cel. KPI sprawdza, czy system zachowuje się zgodnie z oczekiwaniami. Przewodnik dla liderów OKR vs KPI pomaga zespołom oddzielić aspiracje od kontroli operacyjnej.
Odpowiedzialność jest równie ważna jak sama metryka. Wytyczne dotyczące dashboardów KPI w czasie rzeczywistym zalecają stałe progi powiązane z wpływem na biznes oraz odpowiedzialnego właściciela, tak aby spadek prowadził do eskalacji, a nie biernej obserwacji (wytyczne dotyczące dashboardów KPI w czasie rzeczywistym). Jeśli próg zostaje przekroczony, a nikt nie wie, kto odpowiada za reakcję, dashboard jedynie dokumentuje porażkę.
Dla zespołów, które budują raportowanie jakości równolegle z monitoringiem, przydatne jest podejście digna do raportowania jakości danych, ponieważ stawia ono na ustrukturyzowane dowody zamiast swobodnej interpretacji. Ma to znaczenie, gdy KPI wpływa na audyt, finanse lub działalność regulowaną.
Projektowanie układu pod zarządzanie przez wyjątki
Najlepsze dashboardy pozostają ciche, dopóki coś się nie zmieni. Stabilne metryki powinny pozostawać w tle, a układ powinien kierować uwagę na nieliczne sygnały wymagające działania. Takie podejście pasuje do sposobu pracy zespołów operacyjnych: w krótkich sesjach, pod presją i przy niskiej tolerancji na szum.
Zarządzanie przez wyjątki działa, bo nikt nie jest w stanie przejrzeć pięćdziesięciu wskaźników i nadać im równej wagi. Układ musi uszeregować sygnały, zanim użytkownik je zobaczy. Jasne progi, wyciszone stabilne metryki i jeden oczywisty stan błędu wykonują tę pracę za odbiorcę.

Projektuj pod selektywną uwagę
W głównym widoku umieść tylko najważniejsze operacyjnie wskaźniki, a diagnostykę pomocniczą przenieś głębiej. Dzięki temu dashboard nie staje się ścianą równorzędnych kafelków, na której nic się nie wyróżnia.
Kompromisem, na który trzeba uważać, jest zmęczenie alertami. Jeśli każda metryka jest traktowana jak sytuacja awaryjna, żadna nie zostaje usłyszana. Progi ostrzegawcze i progi wezwań nadają sygnałowi znaczenie, gdy alert w końcu się uruchomi, a zespół reaguje staranniej, bo eskalacja jest konkretna.
Dobry układ sprawia też, że stabilność jest widoczna. Gdy KPI pozostaje w swoim paśmie docelowym, to użyteczna informacja, bo mówi zespołowi, gdzie nie tracić czasu. Wytyczne dla przedsiębiorstw ujmują to inaczej: ukryte definicje, nieaktualne odświeżenia i brak właściciela to częste przyczyny porażek w przeładowanym głównym widoku (dobre praktyki Domo dotyczące dashboardów KPI).
Praktyczna struktura dzieli widok według pilności.
Warstwa górna: KPI, które wymagają natychmiastowego przeglądu po przekroczeniu progu.
Warstwa środkowa: kontekst trendów i porównania pomocnicze.
Warstwa dolna: drill-downy, lineage i diagnostyka.
Taka hierarchia dobrze współgra z wewnętrznymi procesami jakości, zwłaszcza gdy zespół wykorzystuje dashboardy jakości danych digna jako warstwę diagnostyczną pod metrykami biznesowymi. Dashboard staje się wtedy ścieżką do analizy, a nie ślepym zaułkiem.
Wdrażanie alertów i mechanizmów kontroli data observability
KPI jest tak wiarygodny, jak pipeline, który go zasila. Dlatego alerty muszą zaczynać się poniżej warstwy biznesowej, tam gdzie aktualność, schemat, wolumen i odsetek wartości null można sprawdzić, zanim złe dane trafią na dashboard kierownictwa. Gdy takie mechanizmy są na miejscu, stos monitoringu przestaje być reaktywnym teatrem i zaczyna działać jak system obsługi incydentów.
Najskuteczniejszym wzorcem, jaki widziałem, jest łańcuch kontroli podążający za danymi przez każdy etap. Najpierw wypisz etapy pipeline'u. Następnie zdefiniuj możliwe awarie, takie jak brakujące pliki, duplikaty, schema drift czy nieaktualne ładowania. Potem zakoduj kontrole jako wykonywalne zapytania i zachowuj wyniki, tak aby każde uruchomienie zostawiało zapis historyczny.
Zamień kontrole w dowody incydentów
Historyczne wyniki kontroli są ważne, bo pozwalają zespołom widzieć linie trendu, a nie tylko awarie. Jednorazowy alert mówi, że dziś coś się zepsuło. Zapisana historia mówi, czy problem się powtarza, narasta albo przemieszcza między etapami. To znacznie lepsza podstawa do eskalacji.
Warstwa observability powinna też bezpośrednio odpowiadać znanym filarom kontroli. Data observability zwykle opiera się na filarach aktualności, rozkładu, wolumenu, schematu i lineage, które odpowiadają kontrolom terminowości, wykrywaniu anomalii, kontrolom kompletności, wykrywaniu zmian strukturalnych i śledzeniu pochodzenia danych (filary data observability). W praktyce łatwiej zarządzać tymi filarami, gdy kontrole są jawne i przypisane do właścicieli.
Dobry zestaw kontroli jest konkretny. Wytyczne dotyczące monitorowania jakości danych zalecają kontrole aktualności, liczby wierszy, schema drift, wartości null w wymaganych kolumnach, unikalności klucza głównego oraz dozwolonych wartości lub zakresów, uruchamiane przy ingestii, po transformacji i ponownie na tabeli udostępniającej, z kontrolami blokującymi przy każdym wykonaniu i codziennymi zadaniami rekoncyliacji (dobre praktyki jakości danych). To właściwe podejście również dla systemów KPI, ponieważ dashboard nigdy nie powinien być pierwszym miejscem, w którym uszkodzone dane stają się widoczne.
Kieruj każde ustalenie do wskazanego właściciela. Jeśli nikt nie odpowiada za alert, staje się on szumem.
Monitorowanie schematu zasługuje na osobne potraktowanie, bo zmiany strukturalne mogą zepsuć logikę downstream, nawet gdy liczba wierszy wygląda poprawnie. Badania nad systemami observability opisują alerty uruchamiane przy zmianie metadanych w tabelach źródłowych, dzięki czemu dodane, usunięte lub zmodyfikowane struktury są wykrywane, zanim założenia raportowe przestaną być prawdziwe (badania nad monitorowaniem zmian schematu). Ten mechanizm jest szczególnie ważny w finansach, ochronie zdrowia, telekomunikacji i sektorze publicznym, gdzie koszt cichego błędu w raportowaniu jest znacznie wyższy niż koszt hałaśliwej kontroli.
Praktycznym wewnętrznym punktem odniesienia dla tej warstwy jest data observability w digna, ponieważ ta kategoria obejmuje terminowość, walidację, wykrywanie anomalii i śledzenie schematu w jednym widoku operacyjnym.
Dopasowanie widoków do różnych grup interesariuszy
Jeden dashboard rzadko pasuje każdemu interesariuszowi. Data engineerowie potrzebują sygnałów o awariach, analitycy kontekstu, a członkowie zarządu krótkiego widoku, który wspiera decyzje, bez przedzierania się przez szum z pipeline'ów. Jeśli wszystkim trzem grupom pokażesz ten sam ekran, użytkownicy techniczni nie znajdą potrzebnych szczegółów, a użytkownicy biznesowi utoną w nadmiarze informacji.
Lepszym wzorcem jest jedna zarządzana warstwa metryk z widokami dopasowanymi do ról na wierzchu. Dzięki temu definicje KPI pozostają spójne, a każdy zespół widzi taki poziom szczegółowości, na podstawie którego może działać.
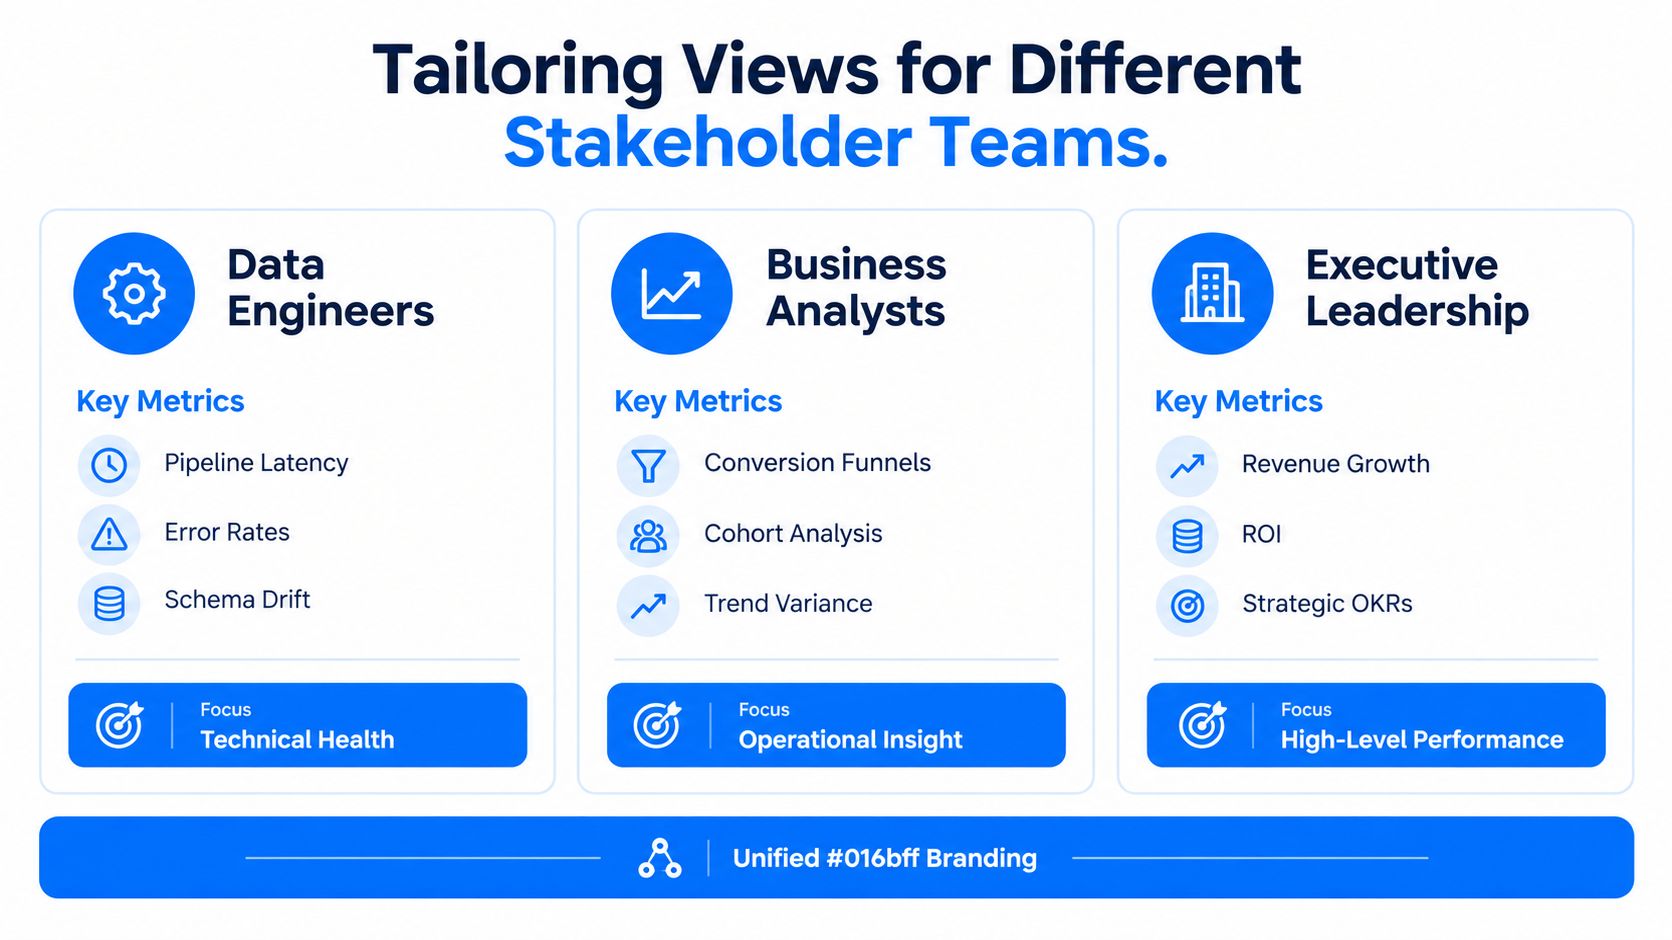
Inżynier, analityk, członek zarządu
Data engineerowie potrzebują technicznych sygnałów o kondycji. Muszą widzieć, czy ładowania się opóźniają, czy schematy się zmieniły, czy kontrole kończą się błędem albo czy założenie dotyczące lineage przestało obowiązywać. Ich widok powinien pokazywać pipeline, a nie tylko wynik biznesowy. Jeśli udostępniana metryka jest błędna, potrzebują szybkiej drogi z powrotem do źródła.
Analitycy biznesowi potrzebują kontekstu, który potrafią wyjaśnić. Liczą się trendy, odchylenia i wzorce operacyjne, a nie ściana szumu infrastrukturalnego. Potrzebują wystarczająco dużo informacji o lineage i definicjach, by wyjaśnić, dlaczego KPI się zmienił, bez odtwarzania metryki od zera.
Członkowie zarządu potrzebują zwięzłego obrazu wyników. Chcą niewielkiego zestawu wskaźników, który pokazuje, czy firma jest na dobrej drodze, dryfuje, czy znajduje się pod presją. Jeśli eksportują podsumowanie do slajdów i odbudowują je gdzie indziej, widok zarządczy nie spełnia swojej roli w podejmowaniu decyzji.
Korzystanie z widoków w podziale na role jest lepszym sygnałem niż ogólne statystyki ruchu. Jeśli widok inżynierski jest ignorowany podczas incydentów, jeśli analitycy wciąż eksportują oczyszczoną metrykę do arkuszy kalkulacyjnych albo jeśli zarząd omija dashboard na rzecz osobnego podsumowania, widok nie odpowiada zadaniu, które ma wykonywać.
Użyteczny sposób na zorganizowanie widoków jest prosty.
Inżynierowie: opóźnienia pipeline'ów, schema drift, nieudane kontrole, przerwania lineage.
Analitycy: odchylenia od trendu, wzorce kohort, kontekst metryk, wyjaśnianie wyjątków.
Zarząd: zwięzłe podsumowanie kondycji biznesu z jasnym statusem progów.
Praktycznym punktem odniesienia przy budowie takiej konfiguracji opartej na rolach jest self-service analytics w digna. Self-service działa tylko wtedy, gdy zarządzana warstwa pod spodem jest na tyle wiarygodna, że różni użytkownicy mogą z niej korzystać bez odtwarzania metryki we własnym arkuszu.
Utrzymanie governance metryk i spójności semantycznej
Najniebezpieczniejszy jest dashboard, który wygląda poprawnie, a liczy coś niewłaściwego. Dzieje się tak, gdy definicje KPI rozjeżdżają się między systemami finansowymi, marketingowymi, CRM czy operacyjnymi, a nikt na bieżąco nie sprawdza, czy ta sama etykieta wciąż oznacza to samo obliczenie. Wtedy wykres przestaje być źródłem prawdy i staje się źródłem zamieszania.
Governance metryk to brakująca warstwa w wielu programach dashboardowych. Zespoły często poświęcają cały wysiłek na układ i progi, a warstwę semantyczną zostawiają bez monitoringu. Powstaje luka, w której KPI może pozostawać wizualnie stabilny, podczas gdy logika pod spodem się zmienia, i właśnie w ten sposób wkrada się ryzyko audytowe i decyzyjne.
Zarządzaj definicją, nie tylko prezentacją
Poważna strategia monitoringu potrzebuje sposobu na wykrywanie dryfu definicji. Oznacza to śledzenie sporów o źródło prawdy, nieaktualnych danych, zmian w transformacjach upstream i niezgodności logiki biznesowej, zanim rozprzestrzenią się na raporty. Jest to szczególnie ważne w środowiskach regulowanych, gdzie niespójna logika KPI może wywołać problemy ze zgodnością na długo przed tym, zanim trend na wykresie zacznie wyglądać podejrzanie.
Praktycznym krokiem jest traktowanie definicji metryk jak zasobów produkcyjnych. Wersjonuj je, dokumentuj i obserwuj, kiedy odbiorca downstream przestaje być zgodny z obowiązującym obliczeniem. To nie jest problem wizualizacji, tylko problem spójności semantycznej.
Niezależne wytyczne już ostrzegały przed sprzecznymi metrykami, sporami o źródło prawdy, nieaktualnymi danymi i brakiem kontekstu operacyjnego, co prowadzi do tego samego wniosku: głębszym problemem jest governance, a nie ramy dashboardu. W przedsiębiorstwach ryzyko jest większe, bo różne zespoły mogą pobierać ten sam KPI z różnych systemów i nie zdawać sobie sprawy z rozbieżności, dopóki nie ujawni jej przegląd biznesowy lub audyt. Użytecznym wewnętrznym punktem odniesienia w tym temacie jest warstwa semantyczna dbt w digna, ponieważ to właśnie w warstwie semantycznej spójne definicje albo się utrzymują, albo rozpadają.
Praktyczny standard jest prosty.
Zdefiniuj KPI raz.
Śledź, gdzie jest ponownie używany.
Wysyłaj alert, gdy zmienia się jego znaczenie.
Dokumentuj właściciela, który zatwierdza zmianę.
Gdy taka dyscyplina jest wdrożona, dashboard staje się na tyle wiarygodny, by używać go operacyjnie. Bez niej nawet najczystszy interfejs jest tylko bardzo dopracowanym sposobem na szerzenie niejasności.
Jeśli chcesz zbudować dashboard do monitorowania KPI, który wychwytuje cichy dryf, a nie tylko pokazuje ładne wykresy, współpracuj z digna. Funkcje jakości danych i observability pomagają zespołom monitorować aktualność, walidację, zmiany schematu i metryki biznesowe we własnym środowisku. Odwiedź digna, aby zobaczyć, jak wpisuje się w zarządzany stos monitoringu.
Gdy KPI na dashboardzie są metrykami biznesowymi, takimi jak przychody, zamówienia czy liczba transakcji, ta sama logika wyjątków może działać na samych metrykach: business monitoring w digna uczy się normalnego wzorca każdej metryki i sygnalizuje zmianę, zanim dotrze ona do widoku zarządu.
Najczęściej zadawane pytania
Ile KPI powinien pokazywać dashboard do monitorowania KPI?
Ogranicz główny widok do około 5–10 KPI. Każdy z nich powinien mieć wartość docelową, próg ostrzegawczy, próg krytyczny i wskazanego właściciela. Trendy pomocnicze i diagnostyka należą do głębszych warstw, aby nieliczne sygnały wymagające działania nie ginęły wśród równorzędnych kafelków.
Dlaczego ludzie przestają ufać dashboardom KPI?
Zwykle nie dlatego, że wykresy źle wyglądają. Zaufanie spada, gdy dane tracą aktualność, schematy zmieniają się upstream albo zespoły liczą ten sam KPI inaczej w systemach finansowych, CRM i marketingowych. Prawdziwym zagrożeniem jest cichy dryf, bo nieznacznie błędna liczba wciąż wygląda na tyle normalnie, że przechodzi weryfikację.
Czym jest zarządzanie przez wyjątki w projektowaniu dashboardów?
To podejście do układu, w którym stabilne metryki pozostają wizualnie wyciszone, a uwagę przyciągają tylko KPI przekraczające próg. Warstwa górna zawiera metryki wymagające natychmiastowego przeglądu, środkowa dodaje kontekst trendów, a dolna oferuje drill-downy i lineage do diagnostyki.
Jakie kontrole danych powinny zostać wykonane, zanim KPI trafi na dashboard?
Sprawdzaj aktualność, liczbę wierszy, schema drift, wartości null w wymaganych kolumnach, unikalność klucza głównego i dozwolone zakresy wartości. Uruchamiaj kontrole przy ingestii, po transformacji i ponownie na tabeli udostępniającej, a każdy wynik zapisuj, aby powtarzające się lub narastające problemy stawały się z czasem widoczne.
Jak zapobiec dryfowi definicji KPI między zespołami?
Traktuj definicje metryk jak zasoby produkcyjne. Zdefiniuj każdy KPI raz, wersjonuj go i dokumentuj, śledź każde miejsce jego ponownego użycia i wysyłaj alert, gdy obliczenie downstream przestaje być zgodne z obowiązującym. Każdą zmianę definicji powinien zatwierdzać wskazany właściciel.


