Liczenie wierszy w pliku: szybkie metody dla każdego systemu
|
5
min. czyt.

Patrzysz na plik dziennika, eksport CSV lub dane wejściowe potoku, a liczba różni się o jeden. W edytorze plik wygląda poprawnie, ale skrypt twierdzi inaczej, a ta drobna rozbieżność może przerwać ładowanie, kontrolę walidacyjną lub bramkę wdrożeniową.
Przyczyną zwykle nie jest wadliwe narzędzie, lecz problem z definicją. Liczenie wierszy w pliku wydaje się proste, dopóki znaki końca wiersza, brak końcowego znaku nowej linii, konwencje Windows i Unix oraz wybór kodowania nie zaczną zmieniać tego, co oznacza „wiersz”.
Spis treści
Ukryta pułapka prostego liczenia wierszy
Typowy scenariusz awarii wygląda tak: potok danych oczekuje dokładnej liczby rekordów, a następnie trafia do niego plik bez końcowego znaku nowej linii. Edytor pokazuje ostatni wiersz, ale wynik z wiersza poleceń się z tym nie zgadza. Ta różnica wystarczy, by wywołać fałszywy alarm w zadaniu importu lub sprawić, że kontrola aktualności danych da błędny wynik.
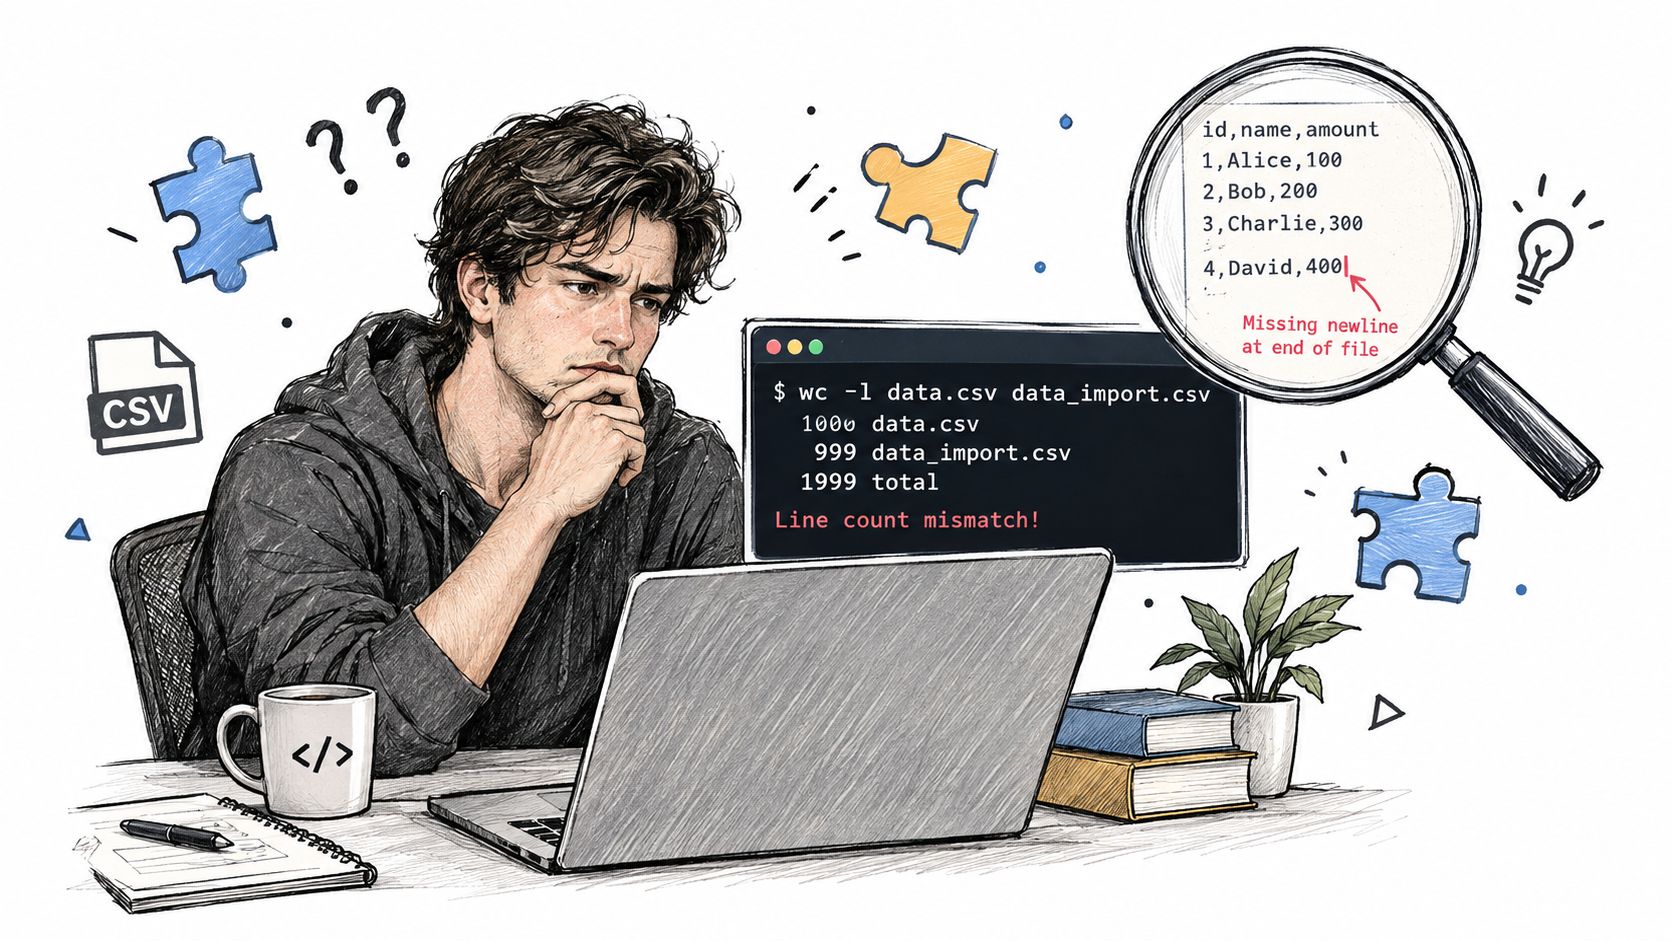
Sedno problemu polega na tym, że narzędzia często liczą znaki nowej linii, a nie to, co człowiek postrzega jako widoczne wiersze. Tak działa GNU wc -l, które nie policzy niepełnego ostatniego wiersza, jeśli plik nie kończy się znakiem nowej linii, więc w tym przypadku brzegowym plik z jednym wierszem może zwrócić 0 wierszy (GNU wc – podręcznik). Z tego samego powodu pytanie nie brzmi tylko „które polecenie jest najszybsze”, lecz „co ta liczba ma oznaczać”.
Zasada praktyczna: jeśli wynik zasila automatyzację, z góry zdecyduj, czy interesują Cię fizyczne znaki końca wiersza, czy logiczne rekordy.
To rozróżnienie ma znaczenie w plikach generowanych automatycznie, dziennikach i strumieniach danych, których nikt nie edytuje ręcznie. Parser może uznać ostatni wiersz za obecny nawet wtedy, gdy brakuje znaku nowej linii, a licznik w powłoce już nie. W pracy nad jakością danych ta rozbieżność należy do tej samej dyskusji co reguły walidacji i kompletność rekordów, dlatego ustrukturyzowana kontrola, taka jak podejście digna do walidacji danych i ciągłej kontroli jakości, jest lepszym modelem myślowym niż „po prostu policz wiersze”.
Liczenie wierszy w systemach Linux i macOS
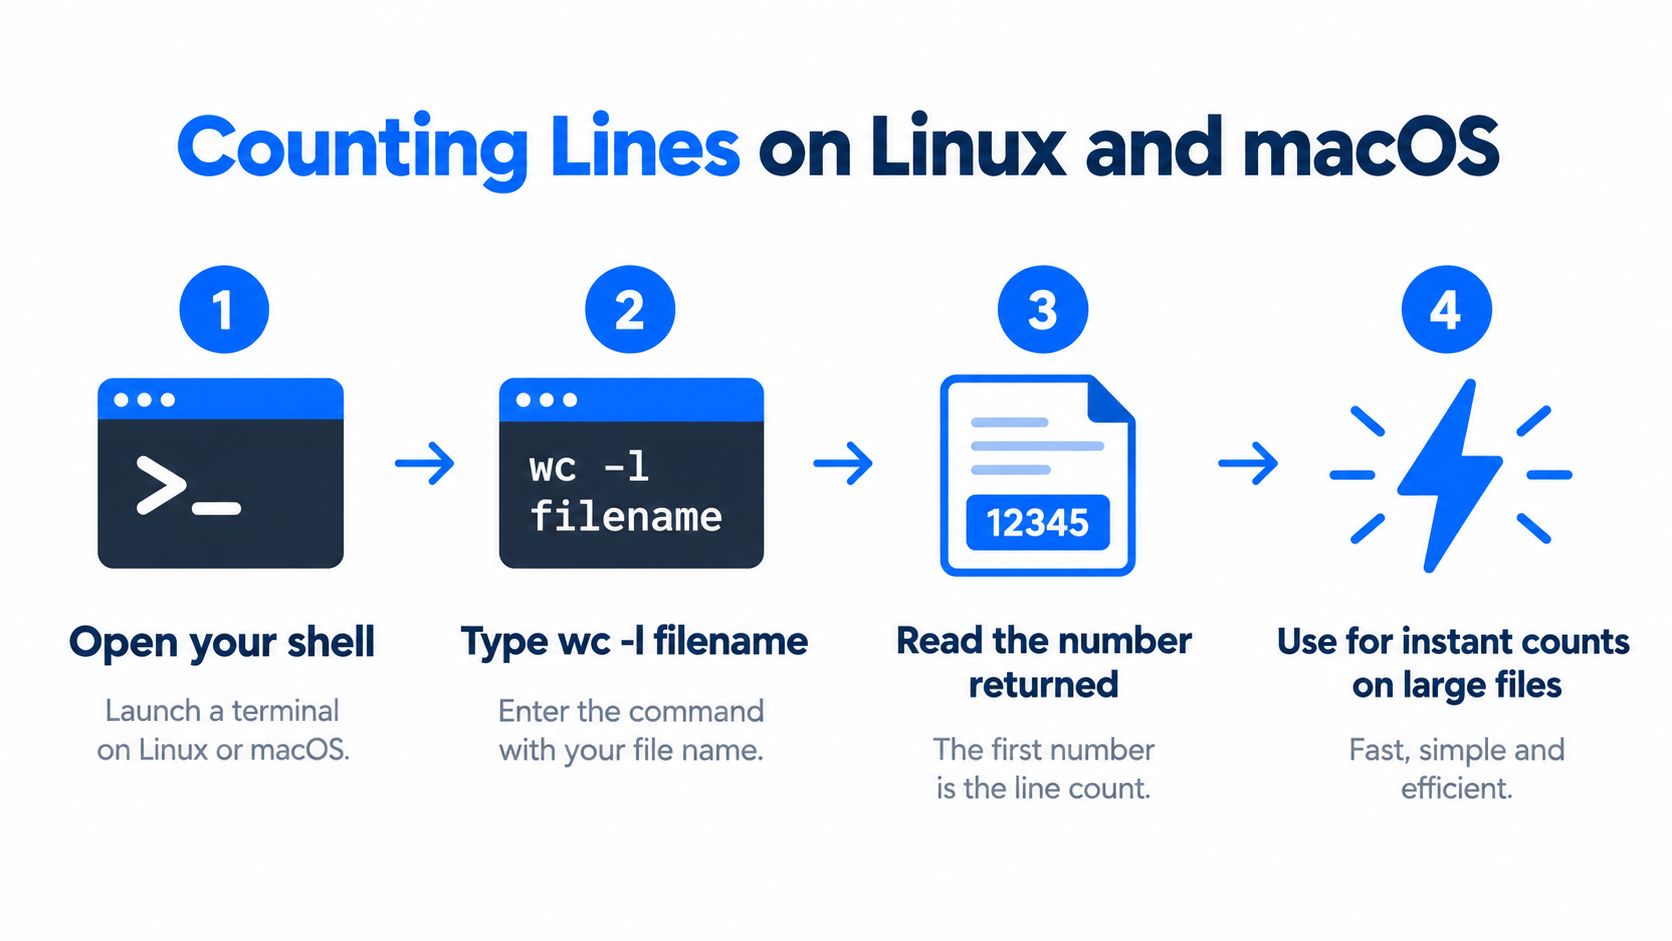
W systemach Linux i macOS zacznij od wc -l. Polecenie od dawna jest częścią uniksowego przetwarzania tekstu i nadal pozostaje najszybszym wyborem do prostego liczenia wierszy, ponieważ jest proste, natywne dla powłoki i łatwe do użycia w skryptach.
Polecenia do uruchomienia
Użyj tego polecenia, gdy chcesz, aby w wyniku pojawiła się nazwa pliku:
wc -l filename
Użyj tego polecenia, gdy potrzebujesz wyłącznie liczby:
wc -l < filename
Druga forma lepiej sprawdza się w skryptach, ponieważ pomija nazwę pliku i zwraca samą liczbę. Współczesne strony podręcznika opisują wc jako narzędzie wypisujące liczbę znaków nowej linii, słów, bajtów i znaków, a przy podaniu wielu plików zwraca ono również sumy. Przykłady przetwarzania tekstu od Red Hat pokazują ten sam prosty styl liczenia w powłoce, w tym polecenie grep -c '.' /usr/share/dict/words zwracające 479 826 pasujących wierszy (przykłady przetwarzania tekstu od Red Hat).
Gdy liczy się szybkość
Do prostego liczenia sumy wierszy wc -l jest zwykle właściwą odpowiedzią, ponieważ skanuje strumienie bajtów bezpośrednio. W teście porównawczym na syntetycznym pliku o rozmiarze 110 MB i 10 000 000 wierszy polecenie wc -l < big.txt zakończyło się w 0,13 s, wobec 0,33 s dla awk 'END{print NR}' big.txt, więc AWK był w tym teście około 2,5 raza wolniejszy (szczegóły testu). Używaj awk, gdy potrzebujesz filtrowania lub logiki dla poszczególnych plików. Pozostań przy wc -l, gdy potrzebujesz tylko liczby.
Nawyk operacyjny: najpierw używaj
wc -l, a na AWK przechodź dopiero wtedy, gdy liczenie jest częścią większej transformacji.
W zadaniach pobierania plików trzymaj liczenie wierszy obok kontroli strefy docelowej i walidacji rekordów, zwłaszcza jeśli dane przepływają przez potok pozyskiwania danych digna. Chodzi o to, by usunąć niejednoznaczność, zanim plik trafi dalej.
Liczenie wierszy w systemie Windows i w PowerShell
Windows oferuje dwie praktyczne ścieżki: PowerShell i CMD. PowerShell jest czystszym rozwiązaniem do liczenia wierszy, ponieważ traktuje zawartość plików jako obiekty, podczas gdy CMD nadal opiera się na starszych sztuczkach tekstowych, które działają, ale są niewygodne w automatyzacji.
Najpierw PowerShell
Podstawowe liczenie wygląda tak:
(Get-Content "file.txt").Count
Aby uzyskać wynik przyjazny dla potoku, użyj:
(Get-Content "file.txt" | Measure-Object -Line).Lines
Dokumentacja PowerShell opisuje, że Get-Content domyślnie zwraca zawartość pliku jako tablicę ciągów rozdzielonych znakami nowej linii, natomiast -Raw zwraca cały plik jako jeden ciąg z zachowanymi znakami nowej linii; jeśli separator nie występuje, Get-Content może zwrócić cały plik jako jeden nierozdzielony obiekt (dokumentacja PowerShell Get-Content, dokumentacja PowerShell 5.1). Ma to znaczenie, ponieważ wynik może się zmienić w zależności od tego, czy PowerShell traktuje plik jako zbiór wierszy, czy jako jeden blok tekstu.
CMD, gdy nie ma innego wyjścia
CMD nie ma bezpośredniego odpowiednika wc -l. Typowe obejście to:
find /c /v "" file.txt
Wynik zawiera nazwę pliku i dodatkowe formatowanie, więc sprawdza się przy szybkich kontrolach, ale jest niewygodny w skryptach. Jeśli potrzebujesz tej liczby w automatyzacji, umieść polecenie w pętli for /f, choć PowerShell nadal jest lepszym wyborem.
Praktyczna wskazówka: w skryptach używaj PowerShell, a CMD tylko wtedy, gdy maszyna jest zablokowana i nic innego nie jest dostępne.
Jeśli budujesz automatyzację w systemie Windows i potrzebujesz podstawowej kontroli jakości przed głębszą walidacją, liczenie wierszy jest często pierwszym, tanim testem. Platforma taka jak digna może się tu sprawdzić jako jedna z opcji obserwowalności na poziomie zbiorów danych, ponieważ śledzi zachowanie liczby wierszy w czasie, zamiast traktować każdy plik jako jednorazowy przypadek.
Liczenie wierszy w dużych plikach za pomocą Pythona
Python dobrze się sprawdza, gdy plik jest duży, platformy się różnią lub liczenie wierszy jest częścią większego zadania. Pułapką jest wczytywanie całego pliku do pamięci, gdy potrzebna jest jedynie liczba.
Buforowany odczyt binarny
Otwórz plik w trybie binarnym, odczytuj go fragmentami, np. po 64 KiB lub więcej, zliczaj bajty \n i dodaj jeden wiersz tylko wtedy, gdy plik nie jest pusty i nie kończy się znakiem \n. Pozwala to uniknąć operacji wejścia/wyjścia znak po znaku, które są wolne w każdym języku. Test porównawczy w C wykazał, że fgetc/fputc potrzebowały 5,90 s na przetworzenie 150 MB, podczas gdy odczyt fragmentami za pomocą fread/fwrite po 65 536 bajtów zajął 0,63 s (notatki z testów w C). To to samo wąskie gardło, którego pętla w Pythonie unika dzięki odczytowi fragmentami po 64 KiB.
Dlaczego odczyt fragmentami jest lepszy
Skanowanie binarne jest przenośne, ale semantyka nadal ma znaczenie. Liczenie znaków nowej linii mierzy fizyczne podziały wierszy, więc windowsowe \r\n, brak końcowych znaków nowej linii oraz znaki nowej linii osadzone w rekordach mogą zmienić wynik, jeśli oczekujesz logicznych wierszy zamiast surowych wierszy tekstu. Tryb binarny Pythona i bytes.count sprawiają, że to zachowanie jest jawne, a reguła dotycząca znaku nowej linii jest taka sama jak w wytycznych File::CountLines.
W kontrolach potoków ustrukturyzowane statystyki wierszy są często bardziej przydatne niż jednorazowe liczenie. Narzędzie monitorujące zachowanie liczby wierszy w czasie, takie jak podejście digna do obserwowalności z wykrywaniem anomalii, sprawdza się wtedy, gdy wykrycie niepełnego ładowania jest ważniejsze niż konkretne polecenie użyte do jego wychwycenia.
Przypadki brzegowe i pułapki semantyczne
Liczenie na poziomie bajtów nie jest uniwersalne. Kodowania niezgodne z ASCII, takie jak UTF-16 czy UTF-32, mogą zaburzyć naiwne liczenie wierszy, a konwencje końca wiersza różnią się między systemami Unix i Windows. Plik może też zawierać rekordy, które w edytorze wyglądają na kompletne, ale zachowują się inaczej, gdy narzędzie odczytuje surowe bajty.
GNU grep -c liczy pasujące wiersze, a jego działanie zorientowane na wiersze może się zmienić, gdy ostatni bajt nie jest znakiem nowej linii (podręcznik GNU grep). Ma to znaczenie w potokach, w których liczenie jest częścią walidacji, a nie tylko szybką kontrolą.
Kodowanie zmienia reguły gry
Podejścia przetwarzające znak po znaku źle sprawdzają się przy dużych plikach. Problem praktyczny dotyczy nie tylko szybkości, ale i interpretacji. UTF-16 i UTF-32 zapisują tekst w sposób, który sprawia, że proste skanowanie bajtów staje się zawodne, więc narzędzie zakładające podziały wierszy w stylu ASCII może zwrócić błędny wynik.
Python daje tu większą kontrolę, ale najbezpieczniejsze podejście nadal zależy od formatu pliku i sposobu jego wygenerowania. W pamięci ustrukturyzowanej liczba wierszy może być częścią samego formatu, a nie warstwy tekstowej, dlatego potoki oparte na formacie Parquet wymagają innych kontroli niż zwykłe pliki tekstowe.
Konwencje końca wiersza nie są zamienne
Unix używa \n, Windows zwykle \r\n, a ten sam plik może być traktowany różnie w zależności od narzędzia. Polecenie Get-Content w PowerShell domyślnie zwraca tekst rozdzielony znakami nowej linii jako ciągi, natomiast -Raw zachowuje plik jako jeden ciąg, więc postać wyniku zmienia metodę liczenia (dokumentacja PowerShell Get-Content).
Jeśli sprawdzasz pliki generowane automatycznie, ta różnica ma większe znaczenie niż nazwa polecenia. Wynik poprawny dla surowego tekstu może być błędny dla logicznych rekordów.
Na tym polega pułapka. Liczenie wierszy w pliku jest proste tylko wtedy, gdy kodowanie, konwencja końca wiersza i model rekordów są ze sobą zgodne.
Wybór właściwej metody
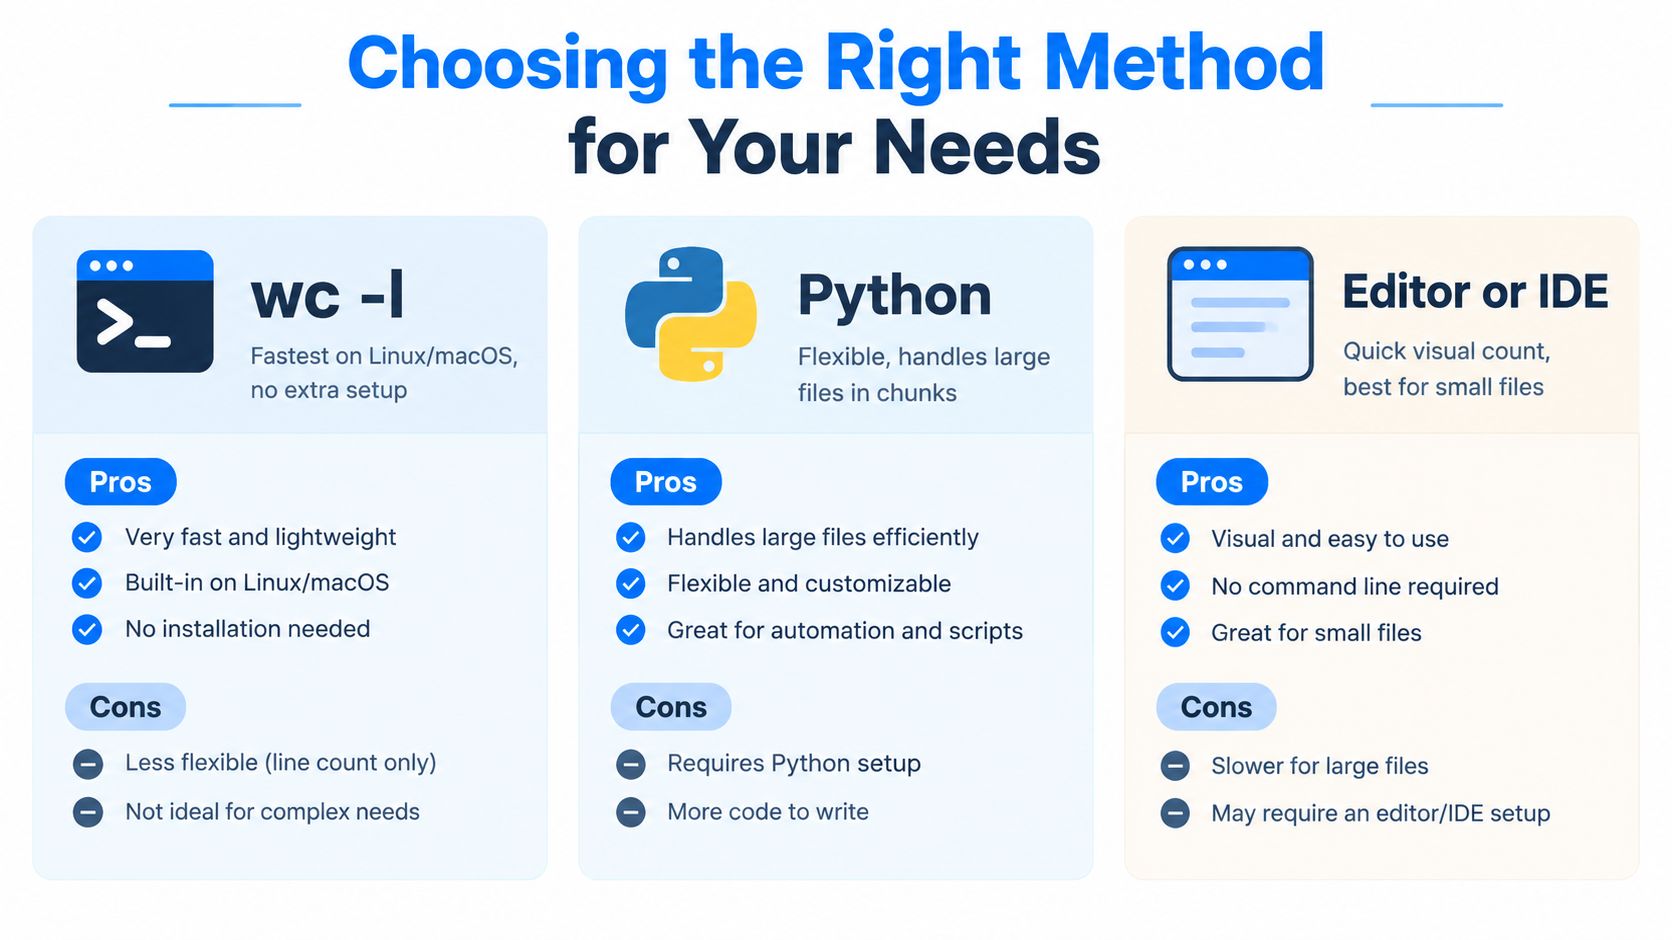
Najlepsza metoda to ta, która odpowiada platformie, rozmiarowi pliku i znaczeniu wyniku. W systemach Linux i macOS domyślnym wyborem do surowej sumy jest wc -l. W systemie Windows czystszym, natywnym dla powłoki wyborem jest PowerShell, a w zadaniach programistycznych Python daje kontrolę nad buforowaniem i obsługą przypadków brzegowych.
Szybkie kryteria wyboru
Użyj
wc -l, gdy pracujesz w systemie Linux lub macOS i potrzebujesz najszybszego prostego liczenia bez dodatkowej logiki.Użyj PowerShell, gdy pracujesz w systemie Windows i chcesz uzyskać wynik, który można przekazać potokiem do dalszej części skryptu.
Użyj Pythona, gdy plik jest duży, kodowanie jest niepewne lub liczenie wymaga niestandardowej obsługi.
Użyj edytora lub IDE, gdy plik jest mały i potrzebujesz tylko wizualnej kontroli.
Praktyczna różnica jest prosta. wc -l to najszybszy licznik surowych wierszy, PowerShell to najbardziej naturalna opcja powłoki w systemie Windows, a Python to najbezpieczniejsze wyjście awaryjne, gdy semantyka jest ważniejsza niż wygoda. W pracy zespołowej warstwa obserwowalności danych, taka jak modułowa platforma monitorowania digna, może działać ponad tymi doraźnymi kontrolami i gromadzić w jednym miejscu liczbę wierszy, anomalie oraz informacje o terminach dostarczania plików.
Jeśli masz dość tropienia po fakcie błędów „o jeden” w plikach, użyj digna do monitorowania danych stojących za tymi liczbami i wychwytuj puste lub niepełne ładowania, zanim trafią do systemów docelowych. Odwiedź digna, aby zobaczyć, jak walidacja, wykrywanie anomalii i kontrola terminowości wpisują się w produkcyjny potok danych.
Gdy liczba wierszy jest w rzeczywistości miarą tego, ile rekordów dotarło, digna Data Anomalies śledzi zachowanie liczby wierszy w bazie danych w czasie i sygnalizuje puste lub niepełne ładowania, których jednorazowe wc -l nigdy nie porówna z historią.
Najczęściej zadawane pytania
Jak policzyć wiersze w pliku w systemie Linux lub macOS?
Użyj wc -l filename, aby wyświetlić liczbę wraz z nazwą pliku, lub wc -l < filename, aby w skryptach zwrócić samą liczbę. W teście na pliku z 10 000 000 wierszy wc -l zakończyło się w 0,13 s, a awk w 0,33 s, dlatego awk warto zostawić do logiki filtrowania.
Dlaczego wc -l pokazuje o jeden wiersz mniej niż mój edytor?
Ponieważ wc -l liczy znaki nowej linii, a nie widoczne wiersze. Jeśli plik kończy się bez końcowego znaku nowej linii, niepełny ostatni wiersz nie jest liczony, więc plik z jednym wierszem może nawet zwrócić 0 wierszy. Z góry zdecyduj, czy automatyzacja potrzebuje fizycznych podziałów wierszy, czy logicznych rekordów.
Jak policzyć wiersze w pliku za pomocą PowerShell?
Uruchom (Get-Content "file.txt").Count, aby uzyskać podstawowy wynik, lub (Get-Content "file.txt" | Measure-Object -Line).Lines, aby uzyskać wynik przyjazny dla potoku. Get-Content domyślnie zwraca ciągi rozdzielone znakami nowej linii, a -Raw zwraca jeden ciąg, więc wybrana forma zmienia sposób, w jaki PowerShell widzi wiersze pliku.
Jaki jest odpowiednik wc -l w wierszu poleceń CMD systemu Windows?
CMD nie ma bezpośredniego odpowiednika wc -l, a typowe obejście to find /c /v "" file.txt. Wynik zawiera nazwę pliku i dodatkowe formatowanie, więc sprawdza się przy szybkich kontrolach, ale trudno go zautomatyzować bez umieszczenia w pętli for /f. W skryptach lepszym wyborem jest PowerShell.
Jaki jest najszybszy sposób na policzenie wierszy w dużym pliku za pomocą Pythona?
Otwórz plik w trybie binarnym, odczytuj go fragmentami po 64 KiB i zliczaj bajty nowej linii, dodając jeden tylko wtedy, gdy plik nie jest pusty i nie ma końcowego znaku nowej linii. Odczyt fragmentami pozwala uniknąć wolnych operacji wejścia/wyjścia znak po znaku: w teście w C zajął 0,63 s, a odczyt znak po znaku 5,90 s.


