Co oznacza federacyjność w danych i AI
|
5
min. czyt.

Federacyjność oznacza, że dane pozostają u źródła, a wspólne modele, zasady lub zapytania działają w wielu niezależnych systemach. W informatyce i pracy z danymi idea ta pojawiła się wcześnie w federacyjnych bazach danych, a później w uczeniu federacyjnym, gdzie wspólny mianownik pozostaje ten sam: lokalna kontrola przy skoordynowanym dostępie.
Wiele osób myli się, ponieważ słowo „federacyjny” brzmi prosto, ale w administracji publicznej, zarządzaniu tożsamością, bazach danych, ładzie danych i AI oznacza powiązane pojęcia o bardzo różnych kompromisach. Dlatego praktyczna definicja jest ważniejsza niż slogan.
Spis treści
Prawdziwe znaczenie systemów federacyjnych
Federacyjność oznacza, że odrębne części współpracują ze sobą, nie oddając własności jednemu centralnemu miejscu. W technologii zwykle oznacza to, że organizacja utrzymuje dane, tożsamość lub przetwarzanie blisko źródła, a następnie łączy te części za pomocą wspólnych reguł, standardów lub warstw koordynacji. Termin ten jest używany w odniesieniu do federacyjnych baz danych od końca lat 70. i lat 80., a na przełomie lat 80. i 90. rozumiano go już jako sposób integrowania autonomicznych systemów w jeden logiczny widok przy zachowaniu lokalnej kontroli graphapp.ai.
Przydatną analogią jest sieć lokalnych banków. Każdy oddział zarządza własnymi rachunkami, ale banki uzgadniają standardy rozliczeń, dzięki czemu klienci mogą przesyłać pieniądze między instytucjami, a żaden bank nie musi łączyć się z innymi w jedną gigantyczną księgę. Federacja w danych i AI działa tak samo: najpierw lokalna autonomia, potem wspólne reguły.
Zasada praktyczna: jeśli system źródłowy nadal jest właścicielem danych lub decyzji, a inna warstwa jedynie koordynuje dostęp lub agregację, najprawdopodobniej masz do czynienia z rozwiązaniem federacyjnym.
Cztery dziedziny, jedno mylące słowo
Problem polega na tym, że słowo to obejmuje bardzo różne konteksty. Użycie słownikowe obejmuje federację polityczną, federację tożsamości oraz przetwarzanie lub wyszukiwanie federacyjne, przy czym federacja tożsamości oznacza konkretnie powiązanie tożsamości użytkownika w odrębnych systemach za pomocą uzgodnionych atrybutów i reguł logowania Merriam-Webster. Dlatego rozmowa o państwie federacyjnym, logowaniu federacyjnym i analityce federacyjnej może brzmieć tak, jakby rozmówcy mówili o zupełnie różnych rzeczach.
W praktyce przydatnym punktem odniesienia jest następująca definicja: systemy federacyjne koordynują działanie niezależnych części bez ich pełnej centralizacji. Pasuje ona do federacyjnych baz danych, uczenia federacyjnego i federacyjnego ładu danych, choć każde z nich stosuje ten wzorzec inaczej. Wyjaśnia to również, dlaczego szczegóły implementacji są ważniejsze niż etykieta.
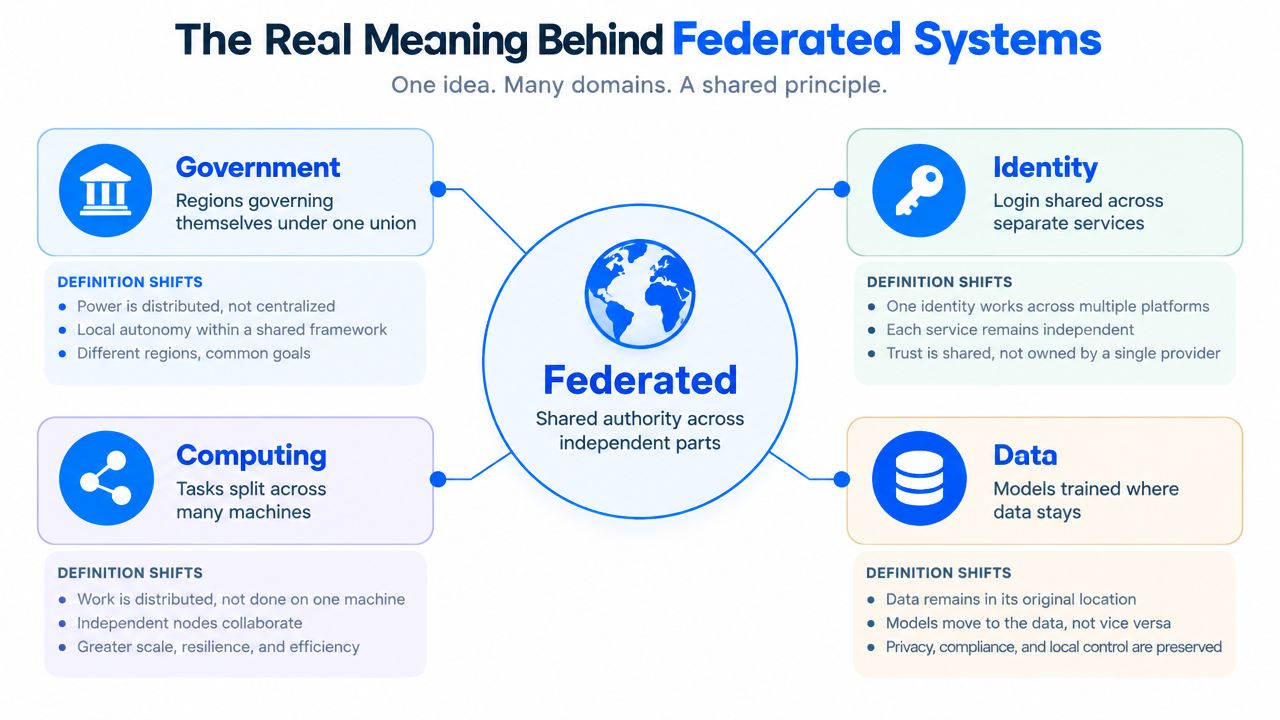
Dla zespołów budujących nowoczesne platformy danych związek między federacją a wyborem architektury staje się wyraźniejszy w porównaniu z innymi podejściami. Solidnym wprowadzeniem do powiązanych kompromisów projektowych jest wyjaśnienie data mesh w nowoczesnych architekturach, ponieważ oba wzorce kładą nacisk na autonomię, ład danych i wspólne standardy.
Scentralizowane a federacyjne architektury danych
Scentralizowana architektura danych gromadzi dane we wspólnej hurtowni lub jeziorze danych i zakłada, że potoki, modelowanie i ład danych będą realizowane właśnie tam. Architektura federacyjna pozostawia dane tam, gdzie już się znajdują, a do koordynacji zapytań i odpowiedzi między źródłami wykorzystuje serwer federacyjny lub warstwę dostępu. Opis systemów federacyjnych IBM jasno przedstawia mechanikę: serwer federacyjny, jedno lub więcej źródeł danych oraz aplikacje klienckie współpracują tak, aby pojedyncza instrukcja SQL mogła uzyskać dostęp do danych rozproszonych w wielu źródłach IBM.
Różnica nie jest wyłącznie techniczna, ponieważ zmienia to, kto co kontroluje. W modelu scentralizowanym zespół platformy często staje się wąskim gardłem w zakresie integracji, standardów i dostępu. W modelu federacyjnym zespoły domenowe zachowują własność, a przedsiębiorstwo definiuje reguły interoperacyjności, oczekiwania dotyczące metadanych i granice bezpieczeństwa. Właśnie dlatego architektury federacyjne pojawiają się w środowiskach regulowanych i wielodomenowych.
Wniosek operacyjny: rozwiązania scentralizowane optymalizują kontrolę i konsolidację, a rozwiązania federacyjne autonomię i kontrolowaną koordynację.
Porównanie architektury federacyjnej i scentralizowanej
Wymiar | Scentralizowana | Federacyjna |
|---|---|---|
Lokalizacja danych | Przeniesione do wspólnej hurtowni lub jeziora danych | Przechowywane w systemach źródłowych |
Własność | Zespół platformy lub centralny zespół danych | Zespół domenowy lub zespół źródła |
Koordynacja dostępu | Bezpośredni dostęp do centralnego magazynu | Zapytania kierowane przez warstwę koordynującą |
Styl integracji | Najpierw konsolidacja, potem użycie | Dostęp w miejscu, agregacja na żądanie |
Ład danych | Scentralizowane egzekwowanie | Wspólne standardy z lokalną realizacją |
Podejście federacyjne pojawiło się, ponieważ duże organizacje napotkały ograniczenia modelu jednego gigantycznego potoku. Gdy przybywa zespołów, systemów i wymogów zgodności, pojedyncza strefa docelowa może stać się kosztowna w utrzymaniu i trudna do pogodzenia z wymogami dotyczącymi lokalizacji danych. Nie oznacza to, że centralizacja jest błędem, lecz że bilans zysków i strat się zmienia, gdy jeden zespół nie jest w stanie realnie odpowiadać za każdy zbiór danych i każdą zasadę.
Jeśli oceniasz tę różnicę z perspektywy jakości danych, uwidacznia się ona również w mechanizmach kontroli operacyjnej. To porównanie kompromisów jakościowych federacyjnych i scentralizowanych platform danych jest przydatne, gdy pytanie brzmi mniej „co brzmi przejrzyściej?”, a bardziej „jaką strukturą potrafimy zarządzać?”.
Jak działa uczenie federacyjne bez przenoszenia danych
Uczenie federacyjne to współczesne zastosowanie pojęcia federacyjny, z którym większość zespołów analitycznych styka się najpierw. Polega ono na trenowaniu modeli na zdalnych urządzeniach lub w odizolowanych centrach danych przy zachowaniu lokalności danych, a następnie wykorzystaniu serwera centralnego do koordynowania kolejnych rund treningowych i agregowania aktualizacji modelu od rozproszonych uczestników przegląd w arXiv. Surowe rekordy pozostają w telefonie, systemie szpitalnym lub w danej lokalizacji. Przesyłany jest sygnał aktualizacji, a nie zbiór danych.
Ten przepływ pracy ma znaczenie, ponieważ zmienia charakter rozmów o prywatności i zgodności. Zamiast kopiować wrażliwe dane do jednego środowiska budowy modelu, każdy uczestnik uczy się lokalnie i przekazuje wyłącznie to, co jest potrzebne do agregacji. Dlatego o uczeniu federacyjnym często mówi się w kontekście telefonów, szpitali i innych środowisk, w których przepływ danych jest ściśle kontrolowany.
Kolejne kroki w praktyce
Lokalne trenowanie rozpoczyna się na każdym kliencie z wykorzystaniem danych, które już tam są.
Aktualizacje modelu są wysyłane do koordynatora, a nie surowy zbiór danych.
Agregacja odbywa się centralnie, tworząc udoskonalony model globalny.
Zaktualizowany model wraca na kolejną rundę lokalną.
Ten wzorzec ogranicza zbędne przenoszenie danych, ale nie upraszcza procesu. Różne urządzenia mogą mieć różną moc obliczeniową, niezawodność sieci lub jakość danych. Narzut koordynacyjny staje się częścią projektu, a harmonogramy trenowania mają większe znaczenie niż w tradycyjnym, scentralizowanym potoku ML.
Praktyczna wskazówka: uczenie federacyjne to przede wszystkim model koordynacji, a dopiero w drugiej kolejności funkcja ochrony prywatności.
Strona operacyjna staje się jeszcze ważniejsza, gdy zespoły próbują monitorować dryf lub zachowanie modelu u wielu uczestników. Jeśli śledzisz stabilność modelu w środowisku rozproszonym, praktyki wykrywania dryfu modelu pomagają określić, jakie zmiany można zaobserwować, bez udawania, że system jest statyczny.
Federacyjne modele ładu danych w przedsiębiorstwie
Federacyjny ład danych to organizacyjna wersja tej samej idei. Centralny organ ustala zasady, standardy i wspólne mechanizmy kontroli obowiązujące w całej organizacji, a jednostki biznesowe stosują te reguły we własnych domenach Atlan. Taki podział jest przydatny, gdy przedsiębiorstwo potrzebuje spójności, ale domeny nadal potrzebują swobody w prowadzeniu własnych potoków, definiowaniu lokalnych reguł dotyczących danych i obsłudze wyjątków specyficznych dla domeny.
Kluczowe rozróżnienie dotyczy uprawnień decyzyjnych. Federacyjny ład danych nie oznacza, że każda decyzja jest zdecentralizowana, ani że zespoły centralne drobiazgowo zarządzają każdym zbiorem danych. Oznacza, że centrala wyznacza ramy, a domeny działają w ich obrębie. W praktyce obejmuje to zwykle wspólne metadane, mechanizmy kontroli bezpieczeństwa i standardy jakości, a także jasno przypisaną odpowiedzialność za ich egzekwowanie.
Gdzie model się sprawdza, a gdzie zawodzi
Federacyjny ład danych zazwyczaj pasuje do organizacji z wieloma jednostkami biznesowymi, danymi regulowanymi lub złożonymi liniami własności. Sprawdza się też lepiej, gdy zespoły lokalne znają dane lepiej, niż kiedykolwiek mogłaby je poznać centralna grupa platformowa. Ceną jest narzut koordynacyjny, ponieważ zasady muszą być interpretowane spójnie we wszystkich domenach, a nie tylko raz spisane.
Model zawodzi, gdy centralna warstwa zasad jest niejasna lub gdy zespoły domenowe działają w izolacji. Wtedy otrzymujesz najgorsze z obu światów: centralny zbiór reguł, z którego nikt nie korzysta, i lokalne praktyki, których nikt nie jest w stanie poddać audytowi. Dlatego federacyjny ład danych wymaga współodpowiedzialności, a nie tylko schematu z napisem „centrala plus lokalnie”.
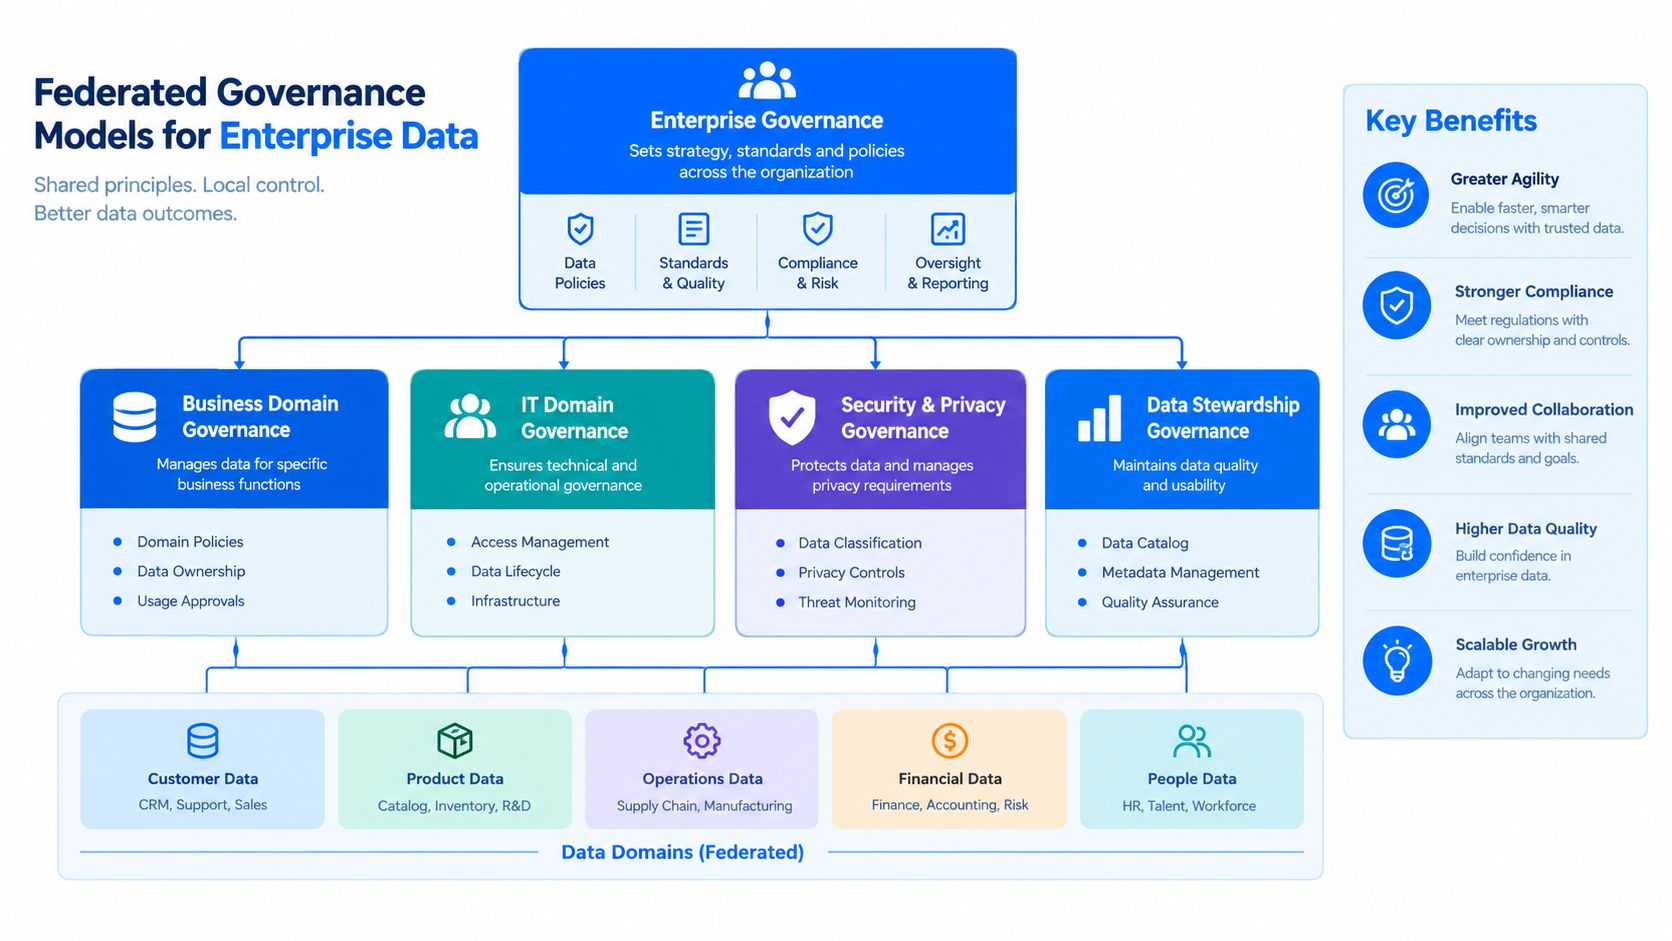
Dla zespołów formalizujących ten model operacyjny wytyczne dotyczące federacyjnego ładu danych są najbardziej przydatne w połączeniu z konkretnymi decyzjami dotyczącymi własności, eskalacji i dowodów jakości. Bez tych elementów „federacyjny” staje się etykietą bez żadnej ścieżki egzekwowania.
Dlaczego federacyjny nie oznacza automatycznie prywatny
Najbardziej uporczywym mitem jest przekonanie, że systemy federacyjne są domyślnie prywatne. Nie są. NIST zauważa, że nawet w uczeniu federacyjnym informacje wciąż można wydobyć z aktualizacji modelu lub z samego wytrenowanego modelu, co oznacza, że uczenie federacyjne ogranicza ekspozycję, ale nie eliminuje ryzyka dla prywatności NIST.
Ten element wiele objaśnień pomija. Pozostawienie surowych danych lokalnie to ważny mechanizm kontroli, ale nie wyczerpuje tematu bezpieczeństwa. Niezależne badania i wytyczne regulacyjne opisują ten sam mechanizm: klienci przechowują surowe dane na urządzeniu lub na miejscu, wykonują obliczenia lokalnie i wysyłają do agregacji wyłącznie ukierunkowane aktualizacje, czasem z dodatkiem prywatności różnicowej w celu ograniczenia wycieków CACM. To lepsze niż przesyłanie wszystkich rekordów do centralnego zbioru treningowego, ale nadal pozostawia ryzyko wycieku przez aktualizacje, inwersji modelu i ryzyka związanego z koordynacją.
Co powinny zakładać zespoły w branżach regulowanych
Architekturę federacyjną należy traktować jako strategię ograniczania przepływu danych, a nie jako ogólną gwarancję prywatności. Jeśli pracujesz w finansach, ochronie zdrowia, telekomunikacji lub sektorze publicznym, nadal potrzebujesz kontroli dostępu, audytowalności i zabezpieczeń kryptograficznych na ścieżce przesyłania aktualizacji. Taki projekt pomaga w kwestii lokalizacji danych i autonomii, ale nie zastępuje inżynierii bezpieczeństwa.
Dla zespołów skupionych na zgodności z przepisami materiał o ochronie prywatności danych jest przydatnym przypomnieniem, że ochrona prywatności wymaga wielowarstwowych mechanizmów kontroli, a nie pobożnych życzeń. Ta sama logika dotyczy systemów federacyjnych, w których powierzchnia ataku zmienia kształt, zamiast znikać.
Systemy federacyjne często przenoszą ryzyko, zamiast je usuwać. Najlepsze wdrożenia zakładają, że aktualizacje modelu również są wrażliwymi zasobami.
Jeśli Twoja organizacja stara się dostosować architekturę do wymogów dotyczących lokalizacji danych lub suwerenności, zgodność z zasadami suwerenności danych staje się częścią rozmowy o projekcie, a nie kwestią drugorzędną. Pytanie nigdy nie dotyczy wyłącznie tego, gdzie znajdują się surowe dane, ale także tego, kto i co może wywnioskować z otaczającego systemu.
Kiedy architektury federacyjne mają sens
Architektury federacyjne mają największy sens, gdy niezależne zespoły muszą zachować własność swoich danych, a jednocześnie uczestniczyć we wspólnym modelu operacyjnym. Dobrze się sprawdzają, gdy liczy się prywatność, suwerenność lub autonomia domen, ponieważ niezależne źródła zachowują kontrolę, udostępniając interoperacyjny dostęp za pośrednictwem wspólnych zasad, interfejsów API lub algorytmów MIT. Na tym polega ich główna wartość: koordynacja bez pełnej konsolidacji.
Sprawdzają się również wtedy, gdy scentralizowane potoki stały się wąskim gardłem. Jeśli każde nowe źródło danych wymaga, aby ten sam centralny zespół je pozyskał, zamodelował, zatwierdził i opublikował, platforma zaczyna spowalniać biznes. Model federacyjny może zmniejszyć tę presję, ale tylko wtedy, gdy przedsiębiorstwo jest gotowe inwestować w standardy, metadane, bezpieczeństwo i nadzór nad jakością we wszystkich domenach.
Stosuj rozwiązania federacyjne, gdy
Wiele domen potrzebuje własności: każdy zespół zachowuje kontrolę nad własnymi danymi i logiką.
Liczy się lokalizacja danych: nie możesz lub nie powinieneś przenosić wszystkich danych na jedną platformę.
Centralne potoki są przeciążone: zespół platformy poświęca więcej czasu na koordynację niż na wspieranie innych.
Liczą się zarówno autonomia, jak i zgodność: biznes potrzebuje lokalnego podejmowania decyzji w ramach globalnych zasad.
Podejście czysto scentralizowane nadal ma sens w przypadku mniejszych zbiorów danych, obciążeń jednodomenowych lub organizacji, które nie osiągnęły jeszcze dojrzałości w zakresie ładu danych pozwalającej koordynować pracę między domenami. Jeśli jest jeden zespół, jedno obciążenie i jeden model bezpieczeństwa, federacja może wnieść więcej procesów niż wartości. Strukturalny kompromis jest prosty: centralizuj dla prostoty, federuj dla kontrolowanej niezależności.
digna zapewnia jakość i obserwowalność danych we własnym środowisku klienta, dzięki czemu jest przydatna, gdy zespoły federacyjne potrzebują dowodów z odrębnych domen bez przenoszenia wszystkiego w jedno miejsce. Jeśli oceniasz architekturę federacyjną i potrzebujesz wglądu w anomalie, zmiany schematu, terminowość i walidację we wszystkich domenach, odwiedź digna i zobacz, jak platforma wpisuje się w ten model operacyjny.
Gdy domeny federacyjne przechowują dane na miejscu, ale nadal potrzebują wspólnych dowodów jakości, obserwowalność platformy danych działająca we własnym środowisku może monitorować każde źródło tam, gdzie się znajduje, zamiast kopiować je do centralnego magazynu.
Najczęściej zadawane pytania
Co oznacza „federacyjny” w kontekście danych i AI?
Federacyjność oznacza, że dane pozostają u źródła, a wspólne modele, zasady lub zapytania działają w wielu niezależnych systemach. Każda część zachowuje własność i lokalną kontrolę, a warstwa koordynacji obsługuje dostęp lub agregację. Idea sięga federacyjnych baz danych z końca lat 70. i lat 80., a dziś stanowi podstawę uczenia federacyjnego.
Czym różni się architektura federacyjna od scentralizowanej?
Podstawowa różnica dotyczy tego, gdzie znajdują się dane i kto jest ich właścicielem. Architektura scentralizowana przenosi dane do wspólnej hurtowni lub jeziora danych zarządzanego przez centralny zespół, natomiast architektura federacyjna pozostawia dane w systemach źródłowych i kieruje zapytania przez warstwę koordynującą, taką jak serwer federacyjny, a zespoły domenowe zachowują własność.
Jak działa uczenie federacyjne bez przenoszenia danych?
Uczenie federacyjne trenuje model lokalnie na każdym kliencie, czy to w telefonie, systemie szpitalnym, czy w danej lokalizacji. Do koordynatora trafiają wyłącznie aktualizacje modelu, które są agregowane w udoskonalony model globalny i odsyłane na kolejną rundę lokalną. Surowe rekordy nigdy nie opuszczają swojej pierwotnej lokalizacji.
Czy uczenie federacyjne jest domyślnie prywatne?
Nie. NIST zauważa, że informacje wciąż można wydobyć z aktualizacji modelu lub z samego wytrenowanego modelu, więc uczenie federacyjne ogranicza ekspozycję, ale nie eliminuje ryzyka. Zespoły w branżach regulowanych, takich jak finanse, ochrona zdrowia, telekomunikacja czy sektor publiczny, nadal potrzebują kontroli dostępu, audytowalności i zabezpieczeń kryptograficznych na ścieżce przesyłania aktualizacji.
Kiedy organizacja powinna stosować architekturę federacyjną?
Wybierz federację, gdy wiele domen potrzebuje własności swoich danych, przepisy dotyczące lokalizacji danych uniemożliwiają konsolidację lub centralne potoki stały się wąskim gardłem. W przypadku mniejszych zbiorów danych, obciążeń jednodomenowych lub zespołów bez dojrzałości w zakresie ładu danych potrzebnej do koordynacji między domenami podejście czysto scentralizowane zwykle wprowadza mniej procesów i pozostaje prostszą opcją.


