Data Observability Framework: praktyczny przewodnik na rok 2026
|
6
min. czyt.
Najbardziej popularna porada dotycząca data observability framework jest również najbardziej niekompletna: wdrożyć pięć filarów, podłączyć alerty i nazwać platformę obserwowalną. Świeżość (Freshness), wolumen, dystrybucja, schemat i pochodzenie (lineage) to niezbędne sygnały, ale nie mówią nikomu, kto musi działać, jak szybko i czy anomalia ma znaczenie dla biznesu.
Pulpit nawigacyjny może pokazywać zepsuty potok (pipeline), podczas gdy kadra kierownicza nadal otrzymuje błędne dane. Prawdziwe ramy łączą wykrywanie z własnością, governance, reagowaniem na incydenty i kontrolą kosztów. To rozróżnienie ma znaczenie, ponieważ Data Observability wchodzi do głównego nurtu planowania przedsiębiorstw. Jedno z badań rynkowych z 2026 r. szacuje, że ta kategoria wzrośnie z 3,51 mld USD w 2026 r. do 6,03 mld USD do 2031 r., podczas gdy inne prognozuje wzrost z 2,90 mld USD w 2025 r. do 8,79 mld USD do 2035 r. Oba szacunki plasują rynek na poziomie około 11% CAGR, co świadczy o tym, że Observability stała się trwałą kategorią oprogramowania, a nie eksperymentalną praktyką inżynierii danych (analiza rynku SNS Insider).
Spis treści
Dlaczego większość programów Data Observability zatrzymuje się na pięciu sygnałach
Wykrywanie to nie to samo co reagowanie
Warstwa governance to brakujący system
Czym w rzeczywistości są ramy Data Observability
Cztery warstwy sprawiają, że ramy są użyteczne
Pięć podstawowych sygnałów i co każdy z nich wychwytuje
Role i Governance wewnątrz ram
Umieszczenie odpowiedzialności w zasobie (asset)
Punkty integracji w potokach, hurtowniach danych i BI
Przenoszenie kontekstu do hurtowni danych i warstwy BI
Czterostopniowy model dojrzałości, według którego można dokonać samooceny
Cztery etapy dojrzałości operacyjnej
90-dniowa mapa drogowa na start w 2026 roku
Dni od 1 do 30: ustalenie odpowiedzialności
Dni od 31 do 60: dodanie lekkiego wykrywania
Dni od 61 do 90: zamknięcie pętli
Często zadawane pytania przez kupujących i architektów
Ile powinno kosztować budowanie własnego rozwiązania w porównaniu z zakupem gotowego?
Które możliwości dostawców mają znaczenie?
Jak długo trwa uzyskanie znaczącego pokrycia?
Dlaczego większość programów Data Observability zatrzymuje się na pięciu sygnałach
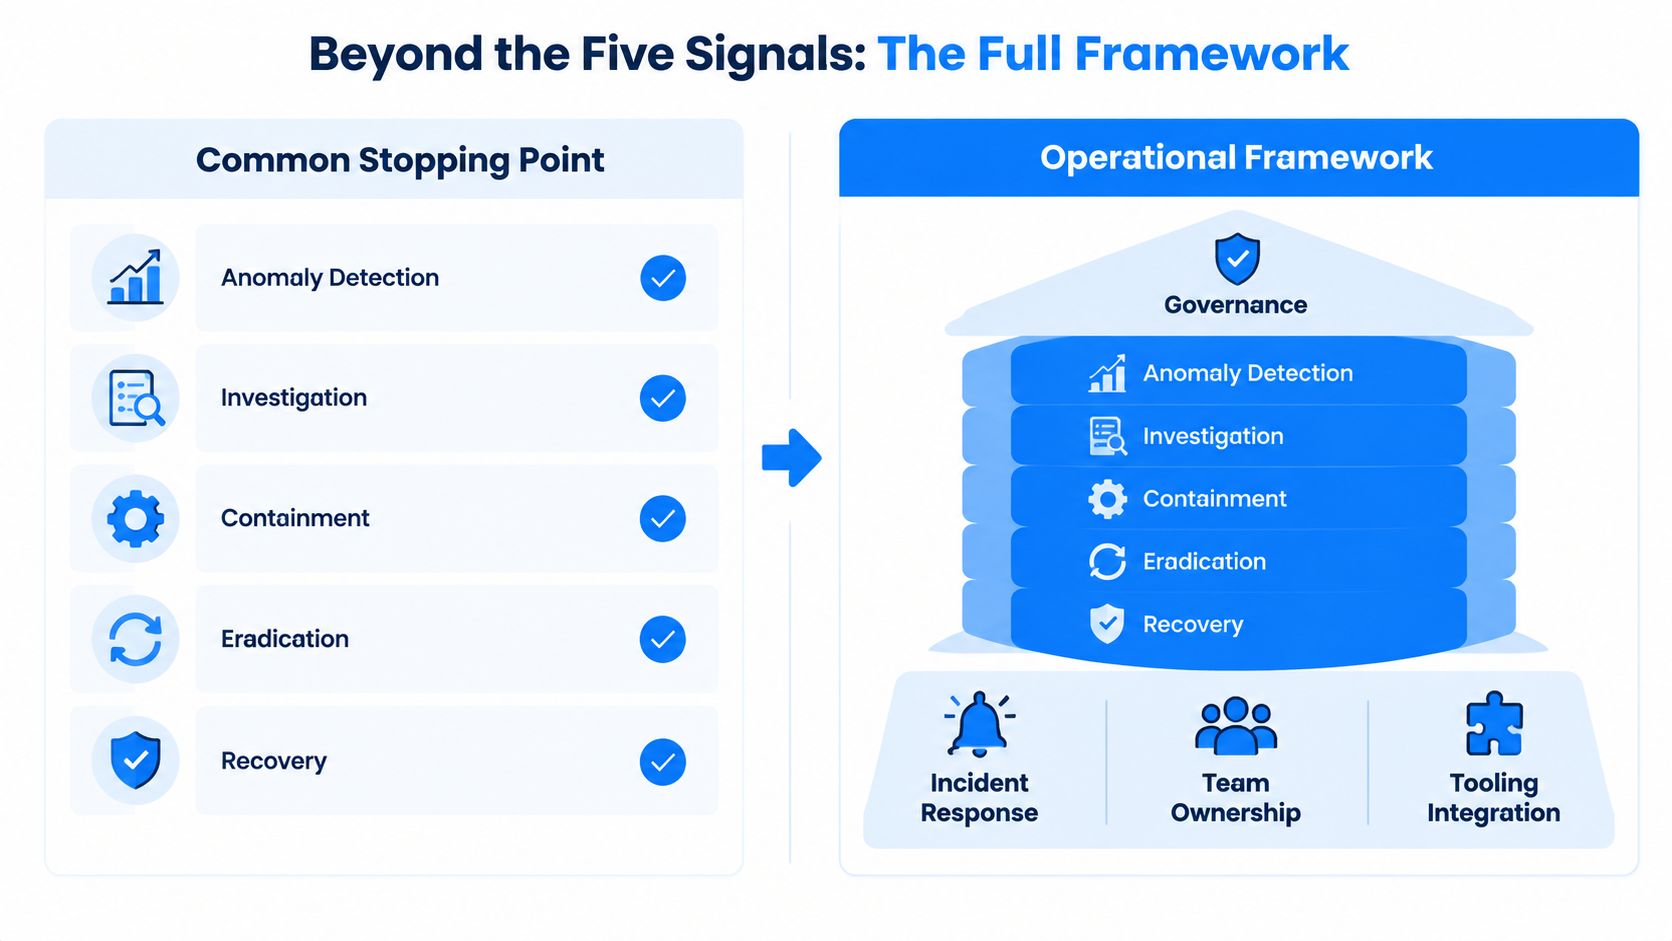
Pięć sygnałów jest często błędnie branych za gotowe ramy. Są one jedynie warstwą telemetryczną. Bez dyscypliny operacyjnej telemetria prowadzi jedynie do dobrze oprzyrządowanej awarii.
Świeżość, wolumen, dystrybucja, schemat i pochodzenie mogą wyświetlać się na zielono lub czerwono w pulpicie nawigacyjnym, podczas gdy organizacji nadal brakuje wyznaczonego właściciela, ścieżki eskalacji, reguły wyciszania lub instrukcji usuwania awarii (runbook). Następuje znany schemat awarii: alert trafia na Slacka, nikt nie ma zdefiniowanych oczekiwań co do klasyfikacji (triage), właściciel produktu danych zakłada, że inżynieria się tym zajmuje, a incydent pozostaje otwarty, dopóki interesariusz nie zauważy błędnej liczby.
Wykrywanie to nie to samo co reagowanie
Sygnał odpowiada na jedno wąskie pytanie. Czy tabela dotarła na czas? Czy zmienił się wolumen wierszy? Czy nastąpiło przesunięcie schematu (schema drift)? Nie odpowiada on na pytania operacyjne, które określają wpływ na biznes:
Kto jest właścicielem zasobu?
Kto klasyfikuje alert?
Na których odbiorców ma to wpływ?
Jaki czas reakcji ma zastosowanie?
Czy potok powinien poddać dane kwarantannie, ponowić próbę czy kontynuować działanie?
Jaka powtarzająca się przyczyna źródłowa wymaga naprawy architektonicznej?
Ta luka sprawia, że bogate w sygnały środowisko może nadal wysyłać błędne dane do kadry kierowniczej. Organizacja ma widoczność, ale brakuje porozumienia co do działań, które ta widoczność powinna wywołać.
Mniejsza konfiguracja monitorowania może działać lepiej, gdy własność jest wyraźnie zdefiniowana. Krytyczny zestaw danych z udokumentowanym opiekunem (steward), oczekiwanym poziomem usług, kanałem eskalacji i przetestowaną instrukcją jest bardziej użyteczny niż setki monitorów bez właściciela. Ramy te zyskują na wartości, skracając drogę od anomalii do odpowiedzialnego działania.
Zasada praktyczna: Alert bez właściciela, określonego poziomu ważności i ścieżki reakcji to tylko powiadomienie, a pasywna kontrola operacyjna.
Warstwa governance to brakujący system
Zasady governance decydują o tym, które odchylenia przerywają pracę, a które powinny trafić do raportu o trendach. Definiuje krytyczność, dopuszczalną zmienność, okna konserwacyjne, reguły wyciszania, przechowywanie dowodów i poziomy eskalacji. Rejestruje również, czy powtarzający się incydent odzwierciedla tymczasowy problem ze źródłem, czy też wadę projektową potoku.
Ewolucja tej kategorii odzwierciedla tę zmianę odpowiedzialności. Gartner opublikował swój pierwszy przewodnik rynkowy Market Guide for Data Observability Tools 23 lutego 2026 r., uznając Data Observability za odrębną kategorię oprogramowania dla przedsiębiorstw, obejmującą wykrywanie anomalii, alertowanie, pochodzenie danych (lineage) oraz przepływy pracy związane z reagowaniem na incydenty (dyskusja Monte Carlo na temat przewodnika Gartnera). Istotna zmiana ma charakter praktyczny: przedsiębiorstwa mogą traktować Observability jako architekturę i zdolność governance, a nie tylko zbiór skryptów monitorujących.
Czym w rzeczywistości są ramy Data Observability
Praktyczna definicja zaczyna się od celu operacyjnego. Gartner opisuje narzędzia Data Observability jako pomagające organizacjom zrozumieć stan i kondycję danych, potoków, infrastruktury oraz finansowych kosztów operacyjnych w rozproszonych środowiskach poprzez ciągłe monitorowanie, śledzenie, alertowanie, analizę i rozwiązywanie problemów (definicja narzędzi Data Observability według Gartnera).
Przekładając to na język inżynierii, ramy data observability framework to wielowarstwowy system, który przekształca telemetrię danych w uregulowane zasadami governance działania ludzi. Łączy sygnały wykrywania, metadane kontekstowe, przypisaną własność, procesy reagowania oraz zasady, które określają, które anomalie mają znaczenie i co dzieje się dalej. Ramy te znajdują się pomiędzy surową telemetrią a decyzjami operacyjnymi, podobnie jak system operacyjny koordynuje sygnały sprzętowe, aplikacje, uprawnienia i działania użytkownika.

Cztery warstwy sprawiają, że ramy są użyteczne
Każda niezależna od dostawcy implementacja potrzebuje czterech warstw:
Warstwa sygnałowa: Świeżość, wolumen, dystrybucja, schemat, pochodzenie danych oraz wszelkie metryki jakości specyficzne dla domeny lub platformy.
Warstwa kontekstowa: Krytyczność zestawu danych, Data Contract, własność, zależności podrzędne, ostatnie zmiany, wrażliwość i wykorzystanie biznesowe.
Warstwa reakcji: Kierowanie alertów, tworzenie incydentów, klasyfikacja, kwarantanna, usuwanie skutków, przegląd poincydentowy i rejestrowanie dowodów.
Warstwa governance: Zasady dotyczące SLA, ważności, wyciszania, dostępu, przechowywania, eskalacji i zarządzania powtarzającym się ryzykiem.
Pięć sygnałów należy do pierwszej warstwy. Stają się one operacyjne tylko wtedy, gdy pozostałe trzy warstwy nadają im znaczenie i konsekwencje. W przypadku zwięzłego wprowadzenia do tematu ograniczania ryzyka dzięki Data Observability, użytecznym wnioskiem jest to, że wykrywanie jest wartościowe, ponieważ wspiera wcześniejszą, lepiej poinformowaną interwencję, a nie dlatego, że dodaje kolejny pulpit nawigacyjny.
Architektura powinna również odpowiadać środowisku. W regulowanych obszarach zespoły potrzebują kontroli, które działają w systemach chmurowych, hybrydowych i lokalnych (on-premises), zachowują dowody audytowe i unikają niepotrzebnego przesyłania wrażliwych danych. Ramy mogą być zbudowane z istniejących koordynatorów, możliwości hurtowni danych, katalogów i systemów incydentów lub dostarczane za pośrednictwem dedykowanej platformy. Projekt ma większe znaczenie niż nazwa dostawcy.
Zespoły oceniające platformę mogą wykorzystać możliwości Data Observability digna jako jeden z przykładów modułowego podejścia, które łączy wykrywanie anomalii, Timeliness, walidację i śledzenie schematów z wykonywaniem operacji bezpośrednio w bazie danych.
Pięć podstawowych sygnałów i co każdy z nich wychwytuje
Pięć sygnałów pozostaje właściwym fundamentem technicznym, pod warunkiem, że każdy z nich jest powiązany z trybem awarii i polityką reakcji. Dojrzałe ramy nie zbierają metryk tylko dlatego, że są one dostępne. Wybierają pomiary, które mogą wykryć znaczące zmiany blisko samych danych.
Świeżość (Freshness) mierzy czas przybycia danych w stosunku do oczekiwanego harmonogramu lub SLA. Sygnatura czasowa najwyższego poziomu (high-watermark) może ujawnić wstrzymane zadania, utracone partycje lub dławienie API, które blokuje pobieranie danych. Gdy opóźnienie jest zmienne, lepiej używać percentyli niż średnich, ponieważ średnia może ukryć opóźnienia z długiego ogona, które wpływają na odbiorców. Praktyczne wskazówki dotyczące Timeliness powinny rozróżniać dostawy opóźnione, brakujące i nieoczekiwanie wczesne, jak wyjaśniono w metrykach i monitorowaniu Timeliness danych.
Wolumen porównuje liczbę wierszy, rozmiar w bajtach lub rozmiar partycji z oczekiwanymi zakresami. Wychwytuje obcięte ładowania danych, zduplikowane zapisy spowodowane ponownymi próbami oraz ciche pętle ponownego wypełniania danych (backfill). Zakres musi uwzględniać normalny wzrost i sezonowość, w przeciwnym razie monitor zmieni rutynową zmianę biznesową w szum.
Dystrybucja bada zachowanie statystyczne w polach numerycznych i częstotliwości kategorii w wymiarach. Statystyki okna ruchomego i wskaźniki Z-score mogą wykazać przesunięcia, które umykają całkowitej objętości, w tym błędy mapowania na wcześniejszych etapach lub zmiany kalibracji czujników. Kontrola dystrybucji wymaga punktów odniesienia specyficznych dla zestawu danych, ponieważ metryki produkcyjne mogą być sezonowe, zmienne, wielowymiarowe i podatne na zmiany reżimu rynkowego. Benchmark BOOM firmy Datadog ilustruje to wyzwanie modelowania na przykładzie 350 milionów obserwacji w 2807 rzeczywistych produkcyjnych szeregach czasowych, ocenianych w wielu horyzontach prognozowania (dyskusja na temat benchmarku BOOM firmy Datadog).
Schemat sprawdza strukturę pod kątem zgodności z oczekiwanym kontraktem (Data Contract). Dodane lub usunięte kolumny, zmienione typy danych i zmodyfikowana dopuszczalność wartości null mogą zepsuć transformacje bez zatrzymywania pobierania danych. Przesunięcie schematu (schema drift) jest szczególnie niebezpieczne, gdy zespół źródłowy zmienia pole z dopuszczającego wartość null na niedopuszczające lub usuwa kolumnę, której nadal oczekuje kod SQL na dalszych etapach.
Pochodzenie danych (Lineage) reprezentuje graf zależności od źródła do konsumpcji. Ujawnia osierocone zestawy danych, zerwane połączenia po refaktoryzacji i niezgłoszone wycofania z użycia na wcześniejszych etapach. Pochodzenie na poziomie kolumn jest szczególnie przydatne, gdy zmienione pole zasila niewielką liczbę krytycznych metryk w znacznie większej tabeli.
Sygnał | Wykryty tryb awarii | Mechanizm wykrywania |
|---|---|---|
Świeżość (Freshness) | Opóźnione, brakujące, wstrzymane lub nieoczekiwanie wczesne dostarczenie | Opóźnienie sygnatury czasowej względem SLA, harmonogramu lub wyuczonego punktu odniesienia |
Wolumen | Obcięte ładowania, zduplikowane zapisy i pętle ponownego napełniania | Porównanie liczby wierszy, rozmiaru w bajtach i rozmiaru partycji |
Dystrybucja | Przesunięcie statystyczne, błędy mapowania i zmiany kategorii | Statystyki okna ruchomego, analiza częstotliwości i wskaźniki Z-score |
Schemat | Pola dodane, usunięte, o zmienionym typie lub naruszające kontrakt | Porównanie strukturalne z zarejestrowanymi oczekiwaniami |
Pochodzenie (Lineage) | Zerwane zależności, osierocone zasoby i ukryty promień rażenia awarii | Ciągłość grafu zależności i analiza wpływu |
Te sygnały są stosunkowo proste do wdrożenia. Trudniej je utrzymać, gdy każda tabela otrzyma identyczne oczekiwania. Podziel zasoby na poziomy (tier), zdefiniuj różne zasady ważności i pozwól anomaliom o niskiej wartości gromadzić się w raportach, zamiast przerywać pracę inżyniera pełniącemu dyżur. Governance, a nie wykrywanie, jest kosztowną częścią sprawiania, by Observability była użyteczna.
Role i Governance wewnątrz ram
Ramy bez przypisanej własności to tylko pulpit nawigacyjny, na który nikt nie odpowiada. Najczystszy model operacyjny oddziela wykrywanie, klasyfikację (triage) i naprawę, a następnie jasno określa zasady przekazywania zadań.
Inżynierowie platformy danych lub inżynierowie niezawodności witryn (SRE) zazwyczaj obsługują infrastrukturę monitorowania i wykrywają anomalie techniczne. Właściciele produktów danych klasyfikują te anomalie, ponieważ rozumieją biznesowe znaczenie zasobu, jego odbiorców i akceptowalne zachowanie. Naprawa często wymaga udziału zarówno inżynierów danych, którzy naprawiają potoki pobierania lub transformacji, jak i inżynierów analitycznych, którzy poprawiają logikę metryk lub modele semantyczne.
Umieszczenie odpowiedzialności w zasobie (asset)
Macierze RACI pomagają podczas uruchamiania projektu, ale często dezaktualizują się po reorganizacjach. Własność powinna być zapisana w metadanych kontraktu danych (Data Contract) lub katalogu dołączonych do zasobu. Każdy krytyczny zestaw danych powinien przynajmniej deklarować:
Odpowiedzialny opiekun (steward): Osoba lub zespół odpowiedzialny za produkt danych.
Oczekiwania dotyczące usługi: Świeżość, kompletność i zachowanie dostępności, na których mogą polegać odbiorcy.
Ścieżka dyżuru: Kanał lub usługa obsługi incydentów, która odbiera alerty wymagające działania.
Krytyczność: Poziom biznesowy, który określa ważność i eskalację.
Instrukcja postępowania (runbook): Pierwsze kroki diagnostyczne i naprawcze.
Incydent o najwyższym priorytecie (P1) wpływający na pulpit nawigacyjny kadry kierowniczej powinien ominąć standardową kolejkę i dotrzeć do określonej osoby na dyżurze w ciągu 15 minut. To oczekiwanie na reakcję jest polityką operacyjną, a nie funkcją narzędzia do wykrywania. Polityka musi również określać, kto może poddać dane kwarantannie, kto zatwierdza ponowne napełnienie (backfill) i kto komunikuje się z odbiorcami.
Moduł | Właściciel wykrywania | Właściciel klasyfikacji | Właściciel naprawy |
|---|---|---|---|
Świeżość pobierania danych | Platforma danych lub SRE | Właściciel produktu danych | Inżynier danych i właściciel źródła |
Kontrakt schematu | Zespół ds. pobierania lub platformy | Właściciel produktu danych | Inżynier źródłowy i inżynier danych |
Dystrybucja metryk | Operator Observability | Inżynier analityki | Inżynier analityki i inżynier danych |
Wpływ na pochodzenie (lineage) | Zespół ds. katalogu lub platformy | Opiekun i poszkodowani właściciele | Właścicielskie zespoły inżynieryjne |
Przepływ pracy incydentu | SRE lub operacje na danych | Kierownik ds. incydentów | Przypisany specjalista techniczny |
Typowe problemy są łatwe do przewidzenia. Warstwy pobierania danych często nie mają stałego właściciela, reorganizacje pozostawiają osierocone zasoby, a brak płynnego przekazywania zadań między inżynierią danych a inżynierią analityczną sprawia, że przesunięcia semantyczne utrzymują się, ponieważ każda grupa zakłada, że ta druga jest właścicielem metryki. Jasny model ról data governance pomaga, ale kontrakt i ścieżka eskalacji muszą być egzekwowane w codziennych operacjach.
Integration Points Across Pipelines, Warehouses, and BI
Observability działa tylko tam, gdzie dołączona jest telemetria. Ramy, które monitorują hurtownię danych, ale ignorują pobieranie, orkiestrację, modele semantyczne lub ścieżki odwrotnego ETL (reverse-ETL), mają martwe punkty, które jedynie pozornie wyglądają na niezawodne.
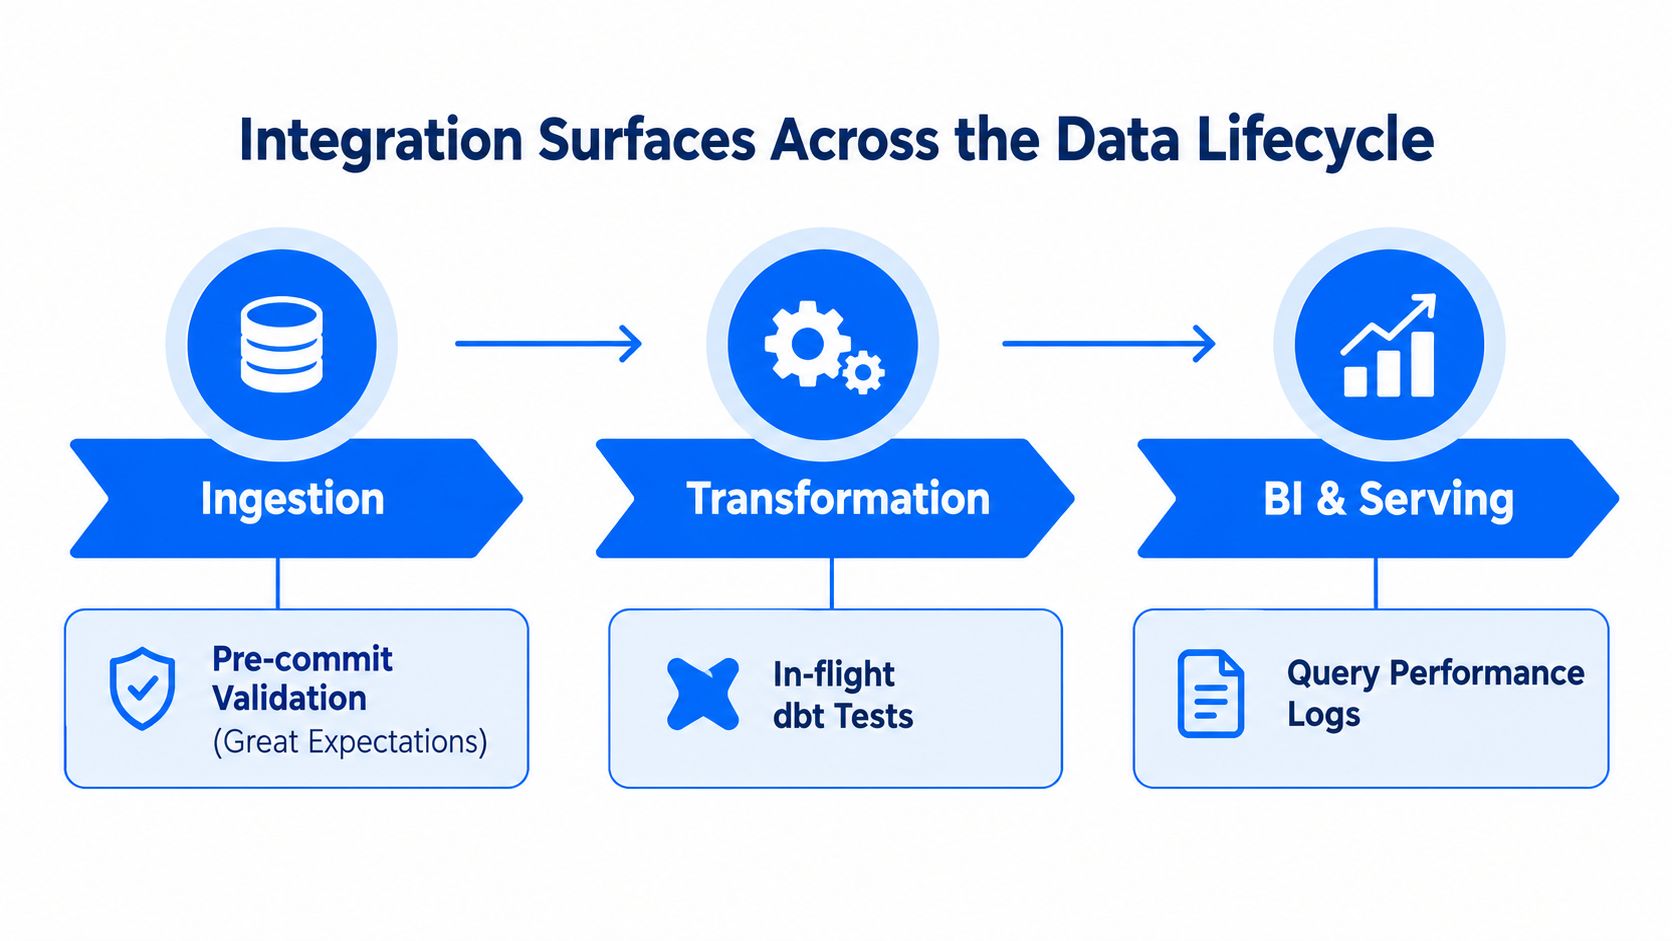
Na etapie pobierania danych należy dołączyć walidację schematu przed zatwierdzeniem zmian (pre-commit) do adapterów źródłowych i kontroli wdrożeniowych. Great Expectations może walidować jawne oczekiwania, podczas gdy porównywanie schematów (schema diffing) pozwala zestawić przychodzące struktury z zarejestrowanymi kontraktami. Wynik należy wyemitować jako zdarzenie walidacji zawierające zasób, wersję, zmienione pola i kontekst wdrożenia. Odpowiedni alert powinien skierować niszczące zmiany do właścicieli źródła i systemów podrzędnych, zanim nowa struktura trafi na produkcję.
Podczas transformacji należy używać testów dbt, czujników Airflow, kontroli zasobów Dagster lub limitów czasu Prefect w punkcie, w którym potok wie, czy zadanie zostało ukończone i czy jego wynik nadaje się do użytku. Wyemituj stan uruchomienia, czas trwania, wyjściową sygnaturę czasową, liczbę wierszy i kontekst awarii do wspólnego magazynu telemetrycznego. Awaria orkiestracji powinna wygenerować jeden incydent z kontekstem zależności, a nie osobne alerty dla każdego podrzędnego zadania.
Przenoszenie kontekstu do hurtowni danych i warstwy BI
Historia zapytań w hurtowni danych może ujawnić zmiany w dystrybucji, nietypowe zużycie, kosztowne skanowania i obciążenia, które omijają oczekiwaną ścieżkę transformacji. Metryki te powinny trafiać obok sygnałów o stanie zdrowia danych, aby zespoły platformy mogły powiązać anomalię danych z niedawnym zapytaniem, wdrożeniem lub zmianą obciążenia.
Warstwa BI wymaga uzgodnienia, a nie tylko statusu potoku. Porównuj wyniki modeli semantycznych z tabelami będącymi jedynym źródłem prawdy (source-of-truth), waliduj definicje metryk i monitoruj, czy stan odświeżenia pulpitu nawigacyjnego odpowiada jego opublikowanym oczekiwaniom. Logika biznesowa często ulega przesunięciu, nawet gdy surowe transformacje pozostają technicznie sprawne.
Integracja pochodzenia danych (lineage) z DataHub, Atlan lub Unity Catalog pozwala na szybkie obliczenie promienia rażenia awarii. Jeśli to możliwe, uwzględnij w grafie niezarządzane skrypty SQL, źródła reverse-ETL zasilające systemy operacyjne oraz definicje warstwy semantycznej. Podejście do integracji z hurtownią danych powinno zachować przepływ metryk od kontroli źródłowych, przez zdarzenia transformacji, aż po uzgadnianie BI.
Celem jest ujednolicona oś czasu incydentów. Zmiana schematu, nieudane zadanie, anomalia wolumenu, dotknięty problemem pulpit nawigacyjny, właściciel i zdarzenie naprawcze powinny pojawiać się jako jeden połączony rekord, a nie jako fragmenty rozproszone w narzędziach do monitorowania, katalogu, orkiestracji i na czatach.
Czterostopniowy model dojrzałości, według którego można dokonać samooceny
Modele dojrzałości stają się bezużytecznymi ćwiczeniami pokazowymi, gdy mierzą instalację narzędzi zamiast zachowań operacyjnych. Użyteczne pytanie na każdym etapie nie brzmi, czy dana funkcja istnieje, ale czy zespół potrafi udowodnić, że ludzie reagują w sposób spójny.
Cztery etapy dojrzałości operacyjnej
Etap 1: Reaktywny (Reactive). Interesariusze dowiadują się o problemach, skarżąc się na pulpity nawigacyjne lub raporty. Zapytaj, czy zespół w ogóle mierzy czas rozwiązywania incydentów. Jeśli nikt nie potrafi określić, kiedy incydent się rozpoczął, kto był jego właścicielem ani kiedy został zamknięty, program ma charakter reaktywny – niezależnie od liczby istniejących kontroli.
Etap 2: Proaktywny (Proactive). Automatyczne monitorowanie świeżości i schematów obejmuje krytyczne potoki, ale pokrycie pozostaje częściowe, a własność ma charakter nieformalny. Zapytaj, jaka część zasobów o najwyższym poziomie krytyczności (tier-one) ma zadeklarowane SLA i wyznaczonego opiekuna. Jeśli odpowiedź wymaga ręcznego dochodzenia, organizacja ma wykrywanie, ale nie ma niezawodnej odpowiedzialności.
Etap 3: Operacyjny (Operational). Sygnały, pochodzenie danych (lineage) i reagowanie na incydenty są standaryzowane. Alerty odwołują się do kontraktów danych (Data Contract), reguł ważności i właścicieli, podczas gdy zespół śledzi koszty Observability i powtarzające się awarie. Zapytaj, czy awarie mało krytycznych zasobów nadal powodują zalew alertów. Jeśli tak, w programie nie wprowadzono jeszcze governance opartego na krytyczności.
Etap 4: Osadzony (Embedded). Observability jest częścią cyklu życia oprogramowania danych (data SDLC). Testowanie kontraktów, polityka jako kod (policy-as-code), kontrole schematów i bramki wdrożeniowe zapobiegają regresjom przed trafieniem na produkcję. Zapytaj, czy zespoły rutynowo wdrażają zmiany bez regresji w zakresie Observability. Dojrzałe zespoły sprawiają, że takie błędy są trudne do popełnienia, ponieważ kontrakty i kontrole działają jako część procesu dostarczania.
Etap | Pytanie diagnostyczne | Wskaźnik operacyjny |
|---|---|---|
Reaktywny | Czy mierzony jest czas rozwiązania incydentu? | Interesariusze zgłaszają awarie po tym, jak odczują ich skutki |
Proaktywny | Które zasoby o najwyższym poziomie krytyczności mają zadeklarowane SLA? | Istnieją automatyczne kontrole na krytycznych potokach |
Operacyjny | Czy awarie o niskiej krytyczności nadal wywołują burze alertów? | Standaryzowane sygnały, pochodzenie danych, własność i reakcja |
Osadzony | Czy zespoły mogą wdrażać zmiany bez regresji w Observability? | Kontrakty i bramki zasad działają w SDLC |
Zespoły często utykają między wdrożeniem a dyscypliną. Kupują narzędzie przed sklasyfikowaniem zasobów, tworzą ogólne progi i świętują liczbę monitorów, podczas gdy własność pozostaje niejasna. Strukturalny model dojrzałości jakości danych jest przydatny tylko wtedy, gdy każdy etap wymaga dowodów w postaci incydentów, kontraktów i zachowań związanych z reagowaniem.
90-dniowa mapa drogowa na start w 2026 roku
Zespół o ograniczonych zasobach nie musi wdrażać instrumentacji dla każdego zestawu danych pierwszego dnia. Potrzebuje wąskiej pętli kontrolnej, która potwierdza własność, generuje użyteczne sygnały i tworzy powtarzalny rejestr incydentów.
Dni od 1 do 30: ustalenie odpowiedzialności
Zacznij od 20 zestawów danych mających wpływ na przychody, od których zależy kierownictwo, finanse, klienci lub kluczowe operacje. Przypisz jednego odpowiedzialnego właściciela do każdego z nich, zarejestruj jego krytyczność i oczekiwany sposób dostarczania oraz utwórz jeden kanał Slack jako przestrzeń dla incydentów. Kanał nie jest systemem obsługi incydentów, ale daje zespołowi wspólną ścieżkę w okresie dojrzewania przepływu pracy.
Dla każdego zasobu określ obecne tryby awarii, odbiorców podrzędnych, kontakt eskalacyjny i minimalną instrukcję postępowania. Nie dodawaj jeszcze szerokiego monitorowania. Najpierw upewnij się, że każdy przyszły alert będzie miał przypisanego adresata.
Dni od 31 do 60: dodanie lekkiego wykrywania
Podłącz kontrole świeżości i wolumenu do istniejącego koordynatora. Dodaj porównywanie schematów (schema diffing) przy pobieraniu danych i wysyłaj informacje o awariach wraz z zasobem, właścicielem, oczekiwanym zachowaniem, zaobserwowanym zachowaniem i prawdopodobnym kontekstem zależności. Przeprowadzaj cotygodniowy przegląd stanu zdrowia danych, badając nierozwiązane alerty, powtarzające się przyczyny i monitory, na które nikt nie zareagował.
Unikaj ogólnych progów. Sztywna reguła zastosowana do każdej tabeli generuje szum, ponieważ tabele mają różne harmonogramy, wzorce wzrostu i konsekwencje biznesowe. Zacznij od jasnych oczekiwań dla krytycznych zestawów danych i używaj historycznych punktów odniesienia tam, gdzie zachowanie jest zmienne.
Dni od 61 do 90: zamknięcie pętli
Dodaj pochodzenie danych (lineage) dla krytycznych kolumn i zdefiniuj SLO na poziomie zestawu danych. Udokumentuj różnicę między automatyczną kwarantanną a eskalacją z udziałem człowieka. Wadliwa partia danych może zostać bezpiecznie poddana kwarantannie, podczas gdy opóźnione zasilanie danymi regulacyjnymi może wymagać natychmiastowego powiadomienia właściciela i komunikacji biznesowej.
Dwie pułapki wdrożeniowe to burze alertów i osierocone zestawy danych. Wyciszaj lub agreguj anomalie o niskiej ważności i odmawiaj wdrożenia zasobu bez wyznaczonego opiekuna. Rezultatem powinny być małe, ale kompletne ramy: wykrywanie połączone z własnością, reakcją, dowodami i przeglądem.
Często zadawane pytania przez kupujących i architektów
Ile powinno kosztować budowanie własnego rozwiązania w porównaniu z zakupem gotowego?
Decyzja zależy od możliwości inżynieryjnych, głębokości integracji, pokrycia i oczekiwań dotyczących usług. Stos open-source korzystający z narzędzi takich jak Great Expectations, OpenLineage i Marquez może obniżyć koszty licencji, ale zespół nadal odpowiada za wdrożenie, aktualizacje, konektory, jakość metadanych, kierowanie alertów i przepływy pracy związane z incydentami.
Komercyjne platformy wymieniają część tego wewnętrznego nakładu pracy na koszty licencji i zależność od dostawcy. Porównuj całkowite obciążenie operacyjne, a nie tylko samą cenę subskrypcji. Uwzględnij czas pracy inżynierów, infrastrukturę, przesyłanie danych, audyt bezpieczeństwa, wsparcie oraz operacyjny koszt fałszywych lub niekompletnych alertów.
Dostępne dane z badań z 2026 r. pokazują, dlaczego ten kompromis zasługuje na szczegółową analizę. 38% respondentów wskazało złożoność i koszty ogólne jako największe obawy związane z Observability, podczas gdy 30% uznało zmęczenie alertami za główną barierę dla szybszego reagowania na incydenty, zgodnie z wynikami ankiety Grafana Labs (badanie Observability Grafana Labs). Potraktuj te liczby jako sygnały do planowania, a nie jako automatyczny argument za budowaniem lub kupowaniem.
Ramy muszą również uwzględniać mechanizmy kontrolne, które prezentacja produktu może ukryć. Zapytaj, kto utrzymuje reguły, kto jest właścicielem nieudanych kontroli, jak przechowywane są dowody i czy model operacyjny nadal działa, gdy platforma jest niedostępna.
Które możliwości dostawców mają znaczenie?
Oceń ścieżkę wykrywania i reakcji przed oceną wyglądu pulpitu nawigacyjnego:
Wykrywanie oparte na logach vs na zapytaniach: Logi zapewniają kontekst zdarzeń w potoku, podczas gdy zapytania badają rzeczywiste zachowanie w hurtowni danych. Wiele środowisk wymaga obu tych rozwiązań.
Pochodzenie danych (Lineage) na poziomie kolumn: Grafy na poziomie tabel mogą nie wspierać analizy wpływu w przypadku metryk podlegających regulacjom prawnym.
Natywne wsparcie dla hurtowni danych: Upewnij się, że kontrole działają wydajnie w systemach przechowujących dane.
Egzekwowanie własności: Sprawdź, czy platforma kieruje i eskaluje incydenty, czy tylko wyświetla anomalie.
Ekonomia: Sprawdź, czy ceny zależą od skanów, alertów, wywołań API, tabel, modułów czy wolumenu użytkowania.
Kontrola wdrożenia: Opcje chmury prywatnej i wdrożenia lokalnego (on-premises) mają znaczenie, gdy dane produkcyjne nie mogą opuścić środowiska klienta.
Pulpit nawigacyjny nie jest modelem operacyjnym. Ramy potrzebują wykrywania, własności, eskalacji, dowodów i przeglądu połączonych ze sobą za pomocą tych funkcji.
Jak długo trwa uzyskanie znaczącego pokrycia?
Znaczące pokrycie średniej wielkości środowiska trwa od sześciu do dziewięciu miesięcy, a nie sześć tygodni. Wczesne prace mogą szybko zabezpieczyć wybrane zasoby, ale trwałe pokrycie wymaga klasyfikacji, kontraktów, pochodzenia danych, uporządkowania własności, praktyki reagowania i integracji na etapach pobierania, transformacji, hurtowni danych i BI.
Wymiar | Stos Open-Source | Platforma komercyjna |
|---|---|---|
Początkowe licencjonowanie | Często niskie lub brak opłat | Opłaty subskrypcyjne lub platformowe |
Własność inżynieryjna | Wysoka, w tym operacje i utrzymanie | Dzielona z dostawcą, w zależności od usługi |
Dostosowanie do potrzeb | Szeroka kontrola poprzez kod i interfejsy API | Ograniczone funkcjami i rozszerzeniami produktu |
Obciążenie integracją | Zespół buduje i utrzymuje konektory | Dostawca może zapewnić natywne integracje |
Przepływ pracy governance | Zazwyczaj składany z osobnych komponentów | Może być w pakiecie, ale wymaga weryfikacji |
Kontrola wdrożenia | Pełna kontrola w infrastrukturze klienta | Zależy od modelu hostingu i wdrożenia |
Niestandardowe ramy pasują do środowisk o nietypowych wymaganiach audytowych, głębokich inwestycjach w Dagster lub Airflow lub granicach sieci danych (data mesh), które sprawiają, że pochodzenie danych u dostawcy jest zbyt powierzchowne, by mu zaufać. Komercyjna platforma pasuje do zespołów, które potrzebują szybszej integracji, spójnego wsparcia i utrzymywanej warstwy operacyjnej. Podejmij decyzję w oparciu o wymagane mechanizmy kontrolne, własność i przepływy pracy związane z reagowaniem, a nie atrakcyjność wizualną pulpitów nawigacyjnych.
digna zapewnia modułową platformę jakości danych i Observability, która działa wewnątrz chmury klienta, VPC lub centrum danych, oferując wykonywanie operacji bezpośrednio w bazie danych na potrzeby wykrywania anomalii, monitorowania Timeliness, walidacji na poziomie rekordów, śledzenia schematów i metryk platformy. Zespoły projektujące nadzorowaną Observability dla regulowanych potoków danych lub obciążeń AI mogą ocenić digna pod kątem swojej istniejącej architektury.
Najczęściej zadawane pytania
Czym są ramy data observability?
Warstwowym systemem, który zamienia telemetrię danych w zarządzane działanie ludzi. Użyteczność dają cztery warstwy: warstwa sygnałów, warstwa kontekstu z krytycznością i własnością, warstwa reakcji obejmująca triaż i naprawę oraz warstwa governance ustalająca SLA, wagę, wyciszanie i eskalację.
Dlaczego większość programów zatrzymuje się na pięciu sygnałach?
Bo wykrycie to nie reakcja. Świeżość, wolumen, rozkład, schemat i lineage mogą świecić na zielono albo czerwono, gdy nikt nie wskazał właściciela, ścieżki eskalacji, reguły wyciszania ani runbooka naprawy. Alert bez właściciela, wagi i ścieżki reakcji jest powiadomieniem, a nie kontrolą operacyjną.
Czy data observability to uznana kategoria oprogramowania?
Tak. Gartner opublikował pierwszy Market Guide for Data Observability Tools 23 lutego 2026 r., obejmujący wykrywanie anomalii, alerty, lineage i przepływy reagowania na incydenty. Badanie rynku z 2026 r. szacuje wzrost z 3,51 mld USD w 2026 r. do 6,03 mld USD do 2031 r.
Co wychwytuje każdy z pięciu sygnałów?
Świeżość mierzy moment dotarcia względem harmonogramu lub SLA, wolumen porównuje liczbę wierszy i rozmiary partycji z oczekiwanymi zakresami, rozkład bada zachowanie statystyczne i częstości kategorii, schemat weryfikuje strukturę wobec kontraktu, a lineage odwzorowuje graf zależności od źródła do konsumpcji.
Czy więcej monitoringu oznacza większą niezawodność?
Nie samo z siebie. Mniejszy zestaw potrafi wypaść lepiej, gdy własność jest jasna, bo ograniczeniem jest zwykle governance, a nie pokrycie. Powiąż każdy sygnał z trybem awarii i polityką reakcji, zanim dołożysz kolejny.


