Metryki Data Observability: Katalog referencyjny
|
7
min. czyt.

Patrzysz na pulpit nawigacyjny, który wygląda normalnie, ale wczoraj po południu jedna z tabel nadrzędnych zmieniła nazwę kolumny i nikt tego nie zauważył, dopóki raport o przychodach nie zatrzymał się na poniedziałkowych liczbach. Potok danych nie zgłosił błędu, wykresy się nie zepsuły, a model nadal generował wartości NULL. To jest dokładnie ten rodzaj awarii, który powinny wykrywać metryki Data Observability, ale tylko wtedy, gdy Twój zespół potrafi nazwać ten sygnał, obliczyć go w ten sam sposób i uzgodnić, co się stanie, gdy przekroczy on granicę.
Zespoły mają już fragmenty odpowiedzi. Mają testy świeżości w jednym narzędziu, alerty o liczbie wierszy w drugim, logi schematu w trzecim i kilka niepisanych zasad zapisanych w notatkach z dyżurów. To, czego zazwyczaj nie mają, to gotowy do nawigacji katalog referencyjny, wspólna mapa samych metryk, sposobu obliczania każdej z nich oraz progu, dla którego warto kogoś obudzić. Przejrzysty katalog zamienia chaotyczny monitoring w coś, z czego ludzie mogą korzystać podczas incydentu, a nie tylko podziwiać na prezentacji demonstracyjnej. Jako praktyczny punkt wyjścia, przegląd Data Observability od digna jest użytecznym przykładem tego, jak zespoły podchodzą do tego problemu w środowisku produkcyjnym.
Spis treści
Dlaczego metryki Data Observability potrzebują wspólnego katalogu
Wspólne słownictwo zapobiega rozbieżnościom podczas incydentów
Czym są metryki Data Observability
Metryki są ciągłe, testy są punktowe
Pięć głównych kategorii w skrócie
Świeżość, wolumen, schemat, dystrybucja, pochodzenie danych (lineage)
Szczegółowe metryki świeżości i Timeliness
Cztery metryki, które czynią świeżość operacyjną
Ustawianie okna według klasy zasobów
Wskaźniki anomalii oraz miary dryftu lub zmienności
Trzy sposoby na wykrywanie nietypowych zachowań
Liczba zmian schematu i sygnały dryftu strukturalnego
Cztery metryki, które czynią strukturę widoczną
Monitory biznesowych KPI jako warstwa klasy decyzyjnej
Budowanie KPI na podstawie powiązanych zasobów
Macierz szybkiego dostępu dla katalogu
Powiązania między kategoriami metryk
Świeżość do wolumenu, schemat do dystrybucji, pochodzenie do dryftu
Wybór najmniejszego zestawu metryk, który ma znaczenie
h2 id="33">Dlaczego metryki Data Observability potrzebują wspólnego katalogu
Najgorszą częścią cichego dryftu schematu nie jest sam dryft. Jest to pół dnia, które Twój zespół traci na kłótnie o to, jak go nazwać. Jeden inżynier mówi, że tabela była nieaktualna, inny, że ekstrakcja się nie powiodła, a trzeci wskazuje, że dane wyjściowe modelu były błędne, ponieważ zmieniono nazwę kolumny wejściowej. Pulpit nawigacyjny nadal się renderował, więc awaria wyglądała na niegroźną, dopóki ktoś nie użył tych danych do podjęcia decyzji.
Katalog zmienia tę rozmowę. Zamiast luźnego stosu testów otrzymujesz nazwane metryki observability, z których każda ma znany wzór, jasnego właściciela i postawę alertową, którą można zweryfikować po fakcie. Ma to znaczenie, ponieważ tę samą sytuację można opisać na trzy różne sposoby, jeśli nikt nie uzgodnił, czy mowa o opóźnieniu świeżości, zgodności schematu czy utracie wolumenu downstream.
Wspólne słownictwo zapobiega rozbieżnościom podczas incydentów
Kiedy lider danych, analityk i inżynier rozumieją to samo pod pojęciem „opóźnionych danych”, przestają marnować czas na tłumaczenie. Katalog metryk daje im jedną definicję dla każdego sygnału, jedną ścieżkę obliczeniową i jedną regułę eskalacji. Jest to szczególnie przydatne, gdy tabela zachowuje się inaczej w godzinach pracy niż w nocy, ponieważ to samo słowo może opisywać bardzo różne tryby awarii.
Katalog zmniejsza również rozrost progów. Bez niego każdy inżynier na dyżurze wymyśla nowy próg odcięcia dla każdego zasobu, co skutkuje niespójnymi powiadomieniami, niespójną ważnością problemów i brakiem zaufania. Dzięki niemu zespół może przeanalizować, czy dany sygnał kwalifikuje się do poziomu ostrzegawczego, poziomu powiadomień alarmowych, czy poziomu „monitoruj, ale nikogo nie budź”.
Praktyczna zasada: jeśli dwie osoby mogą się spierać o to, czy problem dotyczy świeżości, wolumenu czy schematu, Twój katalog nie jest jeszcze wystarczająco szczegółowy.
Wartość staje się wyraźniejsza podczas rzeczywistego incydentu. Pulpit nawigacyjny może pokazywać płaskie przychody o 9:00 rano, ale metryka świeżości może wykazać, że tabela zamówień przestała się aktualizować o 2:14 w nocy. To jest pierwsze zerwane ogniwo i to należy naprawić, zanim ktokolwiek zacznie kłócić się o raporty downstream. Jako praktyczny punkt wyjścia, przegląd Data Observability od digna pokazuje, jak zespoły podchodzą do tego problemu w środowisku produkcyjnym.
Czym są metryki Data Observability
Metryki Data Observability to pomiary szeregów czasowych pobierane z zasobów danych i potoków, które je przenoszą. Obejmują one liczbę wierszy, współczynniki wartości null, odciski palców schematów, podsumowania dystrybucji, luki w pochodzeniu danych (lineage) oraz wskaźniki pochodne, takie jak wskaźniki anomalii lub wskaźniki dryftu. W praktyce są to sygnały, których trendy analizujesz w czasie, aby móc stwierdzić, kiedy tabela przestaje zachowywać się tak, jak zwykle.
Użyteczny katalog sprawia, że sygnały te są czytelne na pierwszy rzut oka. Metryka o nazwie null_rate_email_hourly mówi analitykowi znacznie więcej niż check_7, ponieważ nazwa niesie już ze sobą temat, miarę i częstotliwość. Ustrukturyzowane konwencje nazewnictwa, takie jak wzorzec data tags for ai content creation, działają w ten sam sposób – etykiety powinny pomagać ludziom rozpoznać, na co patrzą, zanim jeszcze otworzą definicję.
Metryki are continuous, checks are point-in-time
Podstawowy test jakości danych zazwyczaj odpowiada na pytanie „tak” lub „nie”. Czy ta kolumna ma wartość null? Czy ten identyfikator jest unikalny? Czy wartość mieści się w zakresie? Te testy są przydatne, ale weryfikują one jedynie znaną regułę w danym momencie.
Metryki observability działają inaczej. Są mierzone w sposób ciągły, porównywane z linią bazową dla tego konkretnego zasobu i alarmują o odchyleniu, a nie tylko o niespełnieniu reguły. Test współczynnika wartości null w polu e-mail to statyczny test jakości. Cogodzinna seria współczynnika wartości null z ruchomą linią bazową to metryka observability, ponieważ może wykryć powolny problem z ekstrakcją upstream na długo przed tym, jak ktoś zauważy niedziałające kampanie.
To rozróżnienie ma znaczenie dla sposobu, w jaki zespoły dokumentują katalog. Każdy wpis powinien odpowiadać na trzy pytania w sposób spójny i bez zgadywania.
Definicja: co metryka oznacza w prostym języku.
Metoda obliczania: wzór lub agregacja stojąca za metryką.
Postawa alertowa: czy ostrzega, wysyła powiadomienia alarmowe, czy tylko zasila analizę.
Użyteczne rozróżnienie: jeśli zespół uruchamia test tylko wtedy, gdy ktoś podejrzewa problem, jest to test. Jeśli metryka jest trendowana, odniesiona do linii bazowej i może generować alerty, jest to observability.
Najczystszym sposobem na myślenie o katalogu jest traktowanie go jako warstwy między surową telemetrią a działaniem człowieka. Surowe liczby i znaczniki czasu stają się metrykami. Metryki stają się progami. Progi stają się decyzjami w procedurach operacyjnych (runbooks).
Pięć głównych kategorii w skrócie
Ta dziedzina zazwyczaj organizuje się wokół pięciu koszyków pomiarowych, a każdy z nich wychwytuje inną klasę awarii. Nie są to konkurencyjne taksonomie, ale nakładające się widoki tego samego zasobu. Zdrowy katalog nazywa wszystkie pięć, aby zespoły nie dopasowywały się nadmiernie do jednego sygnału, który już potrafią zbierać.
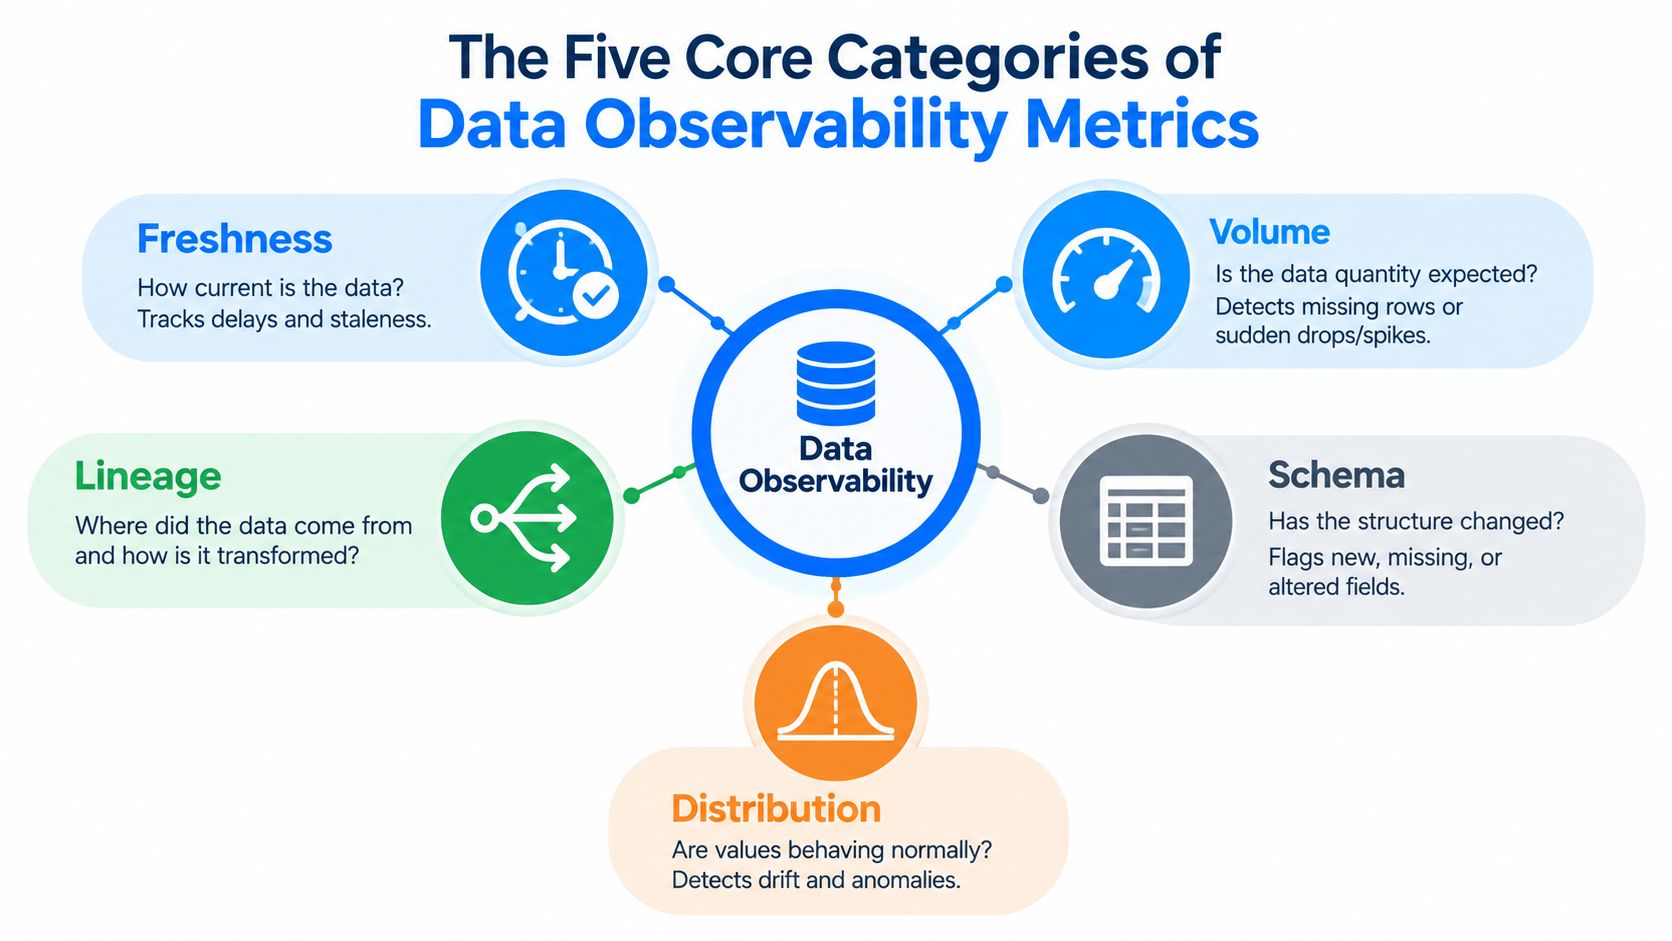
Świeżość, wolumen, schemat, dystrybucja, pochodzenie danych (lineage)
Świeżość odpowiada na pytanie, czy dane są wystarczająco aktualne dla danego scenariusza biznesowego. Wychwytuje późno przybywające partycje i zablokowane zadania ELT – te, które sprawiają, że pulpit nawigacyjny staje się nieaktualny.
Wolumen sprawdza, czy liczba rekordów jest mniej więcej taka, jakiej oczekiwano. To pierwsza linia obrony przed pustymi zrzutami, obciętymi ładunkami i zduplikowanym zasilaniem danych.
Schemat obserwuje zmiany strukturalne, takie jak nowe kolumny, brakujące pola, zmienione nazwy pól i zmiany typów danych. Wychwytuje uszkodzenia, które sprawiają, że modele downstream zaczynają zwracać wartości NULL, nawet gdy tabela nadal się ładuje.
Dystrybucja patrzy na zachowanie wartości, a nie tylko na ich liczbę. Zmiany we współczynnikach wartości null, kardynalności, zakresach lub kształcie danych często pojawiają się zanim użytkownik biznesowy zauważy błędną odpowiedź.
Pochodzenie danych (lineage) mapuje ścieżki zależności. Mówi o tym, który pulpit nawigacyjny, model lub tabela downstream zależy od zasobu, który uległ zmianie. Jest to kategoria, która zapobiega sytuacji, w której jedno uszkodzone źródło zamienia się w godzinę poszukiwań po omacku.
Użyteczną stroną grupowania ich w koszyki jest to, że każdy z nich ma inną sygnaturę awarii. Opóźnione zadanie często wygląda najpierw na problem ze świeżością, a następnie z wolumenem. Migracja API dostawcy często objawia się jednocześnie jako dryft schematu i skoki wartości null. Awaria źródła może rozejść się po ścieżkach pochodzenia danych i ostatecznie pojawić się downstream jako dryft dystrybucji.
Użyj koszyka, który pasuje do symptomu, który możesz zmierzyć jako pierwszy, a następnie potwierdź pozostałe przed eskalacją problemu.
Szczegółowe metryki świeżości i Timeliness
Świeżość dotyczy opóźnienia, a nie tylko tego, czy zadanie się uruchomiło. Pipeline może zakończyć się sukcesem i nadal dostarczyć dane zbyt późno, by miały znaczenie. W przypadku zdarzeń produktowych, strumieni zamówień i operacyjnych pulpitów nawigacyjnych samo opóźnienie jest incydentem.
Czystym sposobem na wyrażenie świeżości jest pomiar luki między oczekiwaną a rzeczywistą dostępnością. Daje to metrykę, którą można odnieść do linii bazowej, dla której można ustawić alerty i którą można przekazać osobie będącej właścicielem potoku danych. Definicja Timeliness i notatki z monitorowania od digna dobrze pasują do tego scenariusza, jeśli chcesz zobaczyć przykład platformy, która traktuje czas dostawy jako sygnał pierwszej klasy.
Cztery metryki, które czynią świeżość operacyjną
max_event_lag_seconds to najprostsza miara opóźnienia. Praktyczny wzór to now() - max(event_time), który mówi, jak bardzo najświeższe zdarzenie opóźnia się w stosunku do obecnej chwili.
row_arrival_rate śledzi przepustowość w czasie, zazwyczaj jako liczbę wierszy pobranych na minutę. Nagły spadek może oznaczać, że źródło przestało wysyłać dane, filtr stał się zbyt agresywny lub zadanie upstream utknęło.
pipeline_completion_lag porównuje zaplanowany czas zakończenia z rzeczywistym czasem zakończenia. Wychwytuje sytuacje, w których zadanie technicznie się kończy, ale dopiero po przekroczeniu poziomu SLA.
sla_breach_minutes mierzy, jak długo zasób pozostawał poza budżetem świeżości. To liczba, która zamienia techniczne opóźnienie w czas trwania incydentu.
Metryka | Wzór | Przykład | Ostrzeżenie | Alert |
|---|---|---|---|---|
max_event_lag_seconds |
| Najnowsze zdarzenie jest opóźnione względem obecnego czasu | Przy 50 procentach SLA | Przy 100 procentach SLA |
row_arrival_rate |
| Tempo pobierania spada poniżej oczekiwanej częstotliwości | Przy 50 procentach oczekiwanej przepustowości | Przy 100 procentach oczekiwanej przepustowości |
pipeline_completion_lag |
| Zadanie kończy się po zamknięciu okna czasowego | Przy 50 procentach budżetu świeżości | Przy 100 procentach budżetu |
sla_breach_minutes | Czas powyżej budżetu świeżości | Zasób pozostaje opóźniony poza oknem SLA | Przy 50 procentach dopuszczalnego opóźnienia | Przy 100 procentach i eskalacja przy 200 procentach |
Ustawianie okna według klasy zasobów
Używaj różnych budżetów świeżości dla różnych produktów danych. Zdarzenia produktowe zazwyczaj wymagają okien krótszych niż minuta. Transakcyjne bazy danych (marts) często tolerują około 5 minut. Agregacje nocne zazwyczaj mieszczą się w przedziale od 15 do 60 minut. Ekstrakty Compliance mogą być mierzone w 24-godzinnych oknach, gdy pozwala na to proces biznesowy.
Właśnie dlatego globalne progi odcięcia to zły nawyk. Pojedynczy próg świeżości nie może obsługiwać wysokoczęstotliwościowego strumienia kliknięć i tabeli rozliczeń dziennych bez generowania szumu. Warstwowe alertowanie jest bardziej stabilne: ostrzeżenie przy 50 procentach SLA, powiadomienie alarmowe przy 100 procentach i eskalacja przy 200 procentach, jeśli zasób nadal jest opóźniony.
Zasada operacyjna: zapisz SLA obok nazwy metryki. Jeśli budżet świeżości nie jest oczywisty w instrukcji, alert nie będzie operacyjny.
Wskaźniki anomalii oraz miary dryftu lub zmienności
Nie każdy uszkodzony zestaw danych jest opóźniony lub niekompletny. Czasami dane docierają na czas, ale zachowują się w sposób pozbawiony sensu. W tym miejscu swoją wartość pokazują wskaźniki anomalii i miary dryftu, ponieważ zamieniają one odczucie „to wygląda dziwnie” w sygnał, który można porównać z historią.
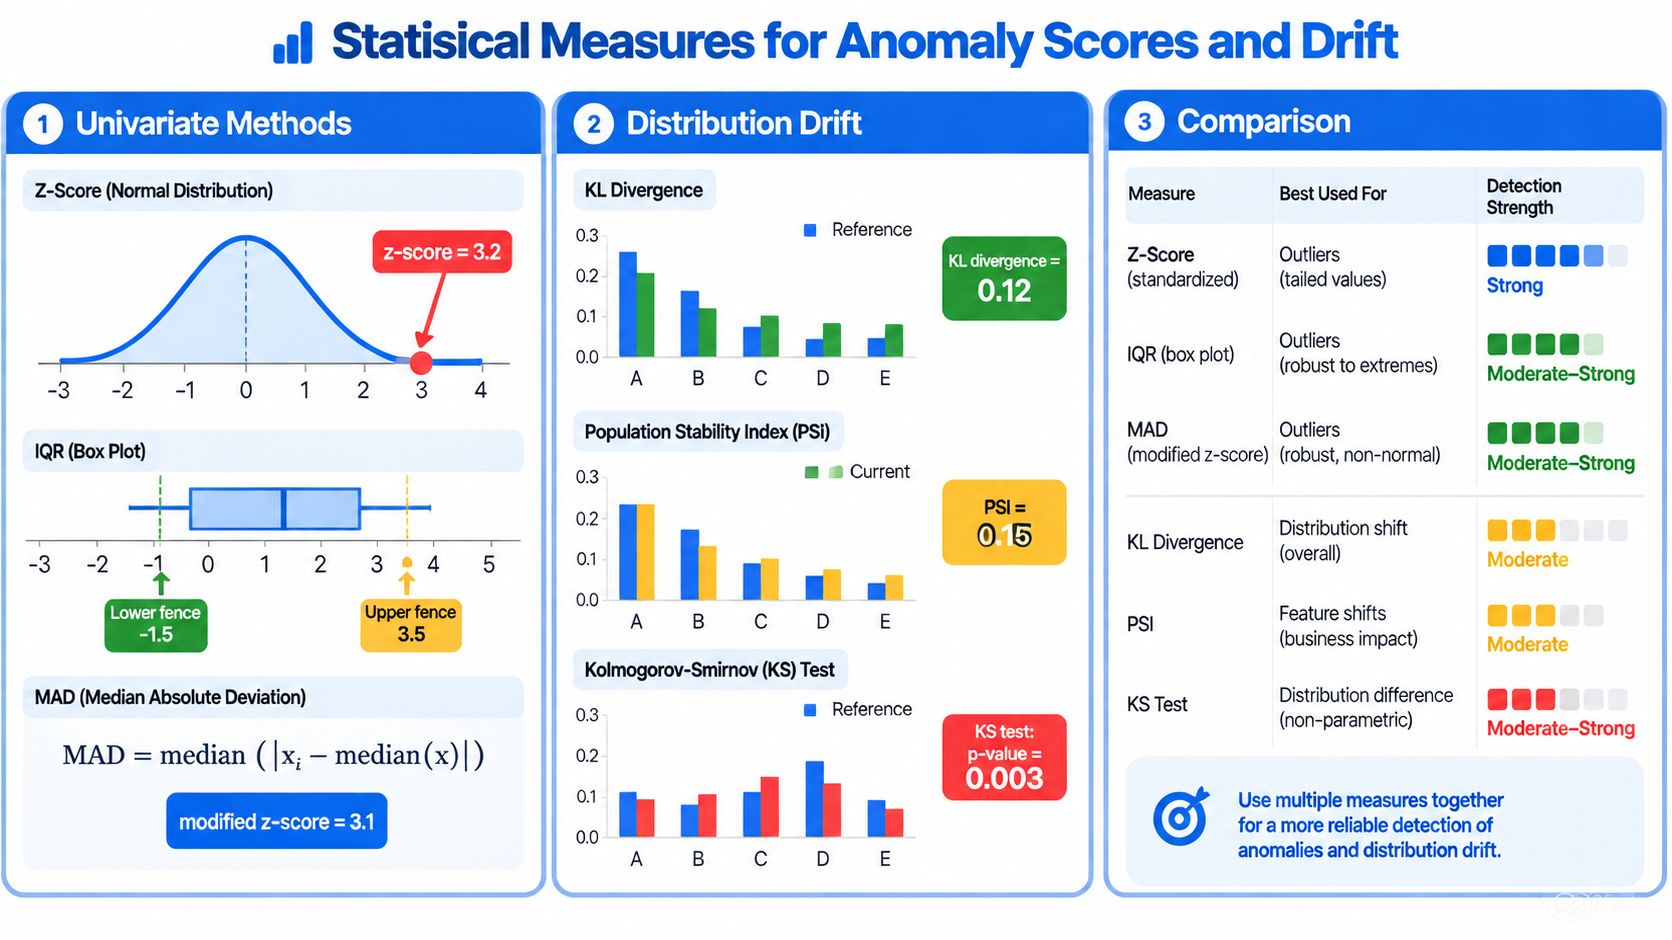
Trzy sposoby na wykrywanie nietypowych zachowań
Metody jednowymiarowe analizują jedną metrykę na raz. Wskaźnik z-score mówi, jak daleko dzisiejsza wartość znajduje się od średniej, wyrażona w odchyleniach standardowych. Zmodyfikowany z-score używa mediany i odchylenia bezwzględnego (MAD), co pomaga, gdy dane zawierają wartości odstające. Granice IQR (rozstępu ćwiartkowego) również są proste, ponieważ oznaczają wartości poza środkowym rozproszeniem rozkładu.
Metody oparte na rozkładzie porównują kształt jednej próbki z drugą. Dywergencja KL, PSI oraz test KS to powszechne wybory, gdy chcesz dowiedzieć się, czy histogram kolumny uległ znaczącej zmianie.
Linie bazowe uwzględniające czas radzą sobie z sezonowością. Metryka dzienna może wyglądać alarmująco, jeśli porównasz poniedziałkowy poranek z niedzielnym wieczorem, dlatego ruchome linie bazowe według dnia tygodnia, godziny dnia lub kalendarza biznesowego są zazwyczaj bezpieczniejsze niż jeden płaski próg.
Weźmy konkretny przykład: daily_active_users. Jeśli obliczysz 14-dniową ruchomą średnią i odchylenie standardowe, dzisiejszy wolumen można porównać z tą ruchomą linią bazową. Prosty alert może zostać uruchomiony, gdy wartość wzrośnie powyżej 3 sigma lub spadnie poniżej linii bazowej dla 10. percentyla. Ta dwustronna konfiguracja ma znaczenie, ponieważ zarówno nagłe skoki, jak i spadki mogą naruszyć założenia downstream.
Największym błędem jest tutaj stosowanie jednostronnych progów dla danych sezonowych. Seria ruchu detalicznego, partia rozliczeniowa i strumień logowań do aplikacji B2B nie mają takiego samego kształtu, więc jedna uniwersalna reguła ma tendencję do wywoływania zmęczenia alertami zamiast jasności. Koszt zbyt wielu fałszywych alarmów jest realny, ponieważ zespoły wsparcia przestają ufać alertom, które miały ich chronić.
Wskazówki dotyczące wykrywania dryftu danych są przydatnym przewodnikiem, jeśli chcesz zobaczyć, jak monitorowanie dryftu przekłada się na wzorce produkcyjne. Kluczowa idea jest taka sama: mierz odchylenie od właściwej linii bazowej, a nie od abstrakcyjnego pojęcia normy.
Liczba zmian schematu i sygnały dryftu strukturalnego
Dryft schematu staje się łatwy do opanowania, gdy przestaniesz traktować go jako niejasny problem ze zgodnością, a zaczniesz go mierzyć. Zmianę nazwy pola, zmianę typu lub usuniętą kolumnę łatwiej jest przekierować, gdy alert wskazuje dokładne zdarzenie strukturalne i kieruje do właściciela przed wdrożeniem (deploy).
Cztery metryki, które czynią strukturę widoczną
schema_change_count zlicza dodania, usunięcia i zmiany typów na jedno uruchomienie potoku. Jeśli źródło zacznie dodawać kolumny co tydzień, ta liczba wykaże schemat na długo przed popsuciem się modelu downstream.
backward_incompatible_change_rate to odsetek edycji schematu, które mogą zakłócić działanie dotychczasowych odbiorców. Mówi o tym, czy zmiany zachodzą w bezpieczny, czy niebezpieczny sposób.
drift_detection_latency_minutes mierzy czas od zatwierdzenia (commit) lub wydania (Release) w upstream do momentu uruchomienia alertu. Jeśli nie wiesz, jak długo trwa zauważenie dryftu, nie wiesz, jak bardzo narażeni są Twoi odbiorcy.
orphaned_column_rate śledzi pola, które nie są już odczytywane przez żaden model ani pulpit nawigacyjny downstream. Kolumny te są często oznaką nieaktualnych zależności, zapomnianej logiki lub kontraktu, którego nikt już nie utrzymuje.
Metryka dryftu | Definicja | Obliczenie | Przykład | Właściciel |
|---|---|---|---|---|
schema_change_count | Liczba edycji strukturalnych na uruchomienie | Dodania + usunięcia + zmiany typów | Kolumna o zmienionej nazwie pojawia się w ładowaniu | Inżynier platformy danych |
backward_incompatible_change_rate | Odsetek edycji mogących uszkodzić odbiorców | Niezgodne zmiany / wszystkie zmiany | Zmiana typu obcina wartości downstream | Właściciel kodu |
drift_detection_latency_minutes | Czas od commita do alertu | Czas alertu minus czas zmiany | Migracja zostaje zauważona dopiero po awarii pulpitu nawigacyjnego | Właściciel potoku danych |
orphaned_column_rate | Pola nieużywane przez odbiorców downstream | Nieodczytywane kolumny / wszystkie kolumny | Pole pozostaje w tabeli, ale nic go nie czyta | Inżynier analityki |
Linie bazowe dla poszczególnych tabel mają tu kluczowe znaczenie. Dynamicznie zmieniająca się tabela zdarzeń nie powinna być oceniana według tych samych kryteriów co wolno zmieniająca się tabela referencyjna, ponieważ jedna z nich zawsze będzie generować szum, jeśli wymusisz na nich tę samą regułę. Kieruj krytyczne zmiany do właściciela kodu przed wdrożeniem (deploy), a nie po tym, jak pulpit nawigacyjny już przestał działać.
Monitory biznesowych KPI jako warstwa klasy decyzyjnej
Surowe metryki observability mówią o tym, co się zepsuło. Monitory biznesowych KPI mówią kierownictwu, co to oznacza. Ta warstwa znajduje się ponad świeżością, wolumenem, schematem, dystrybucją i pochodzeniem danych (lineage) i łączy te sygnały z efektami biznesowymi, takimi jak dokładność przychodów, zachowania zwrotów kosztów, odpływ klientów (churn) i realizacja zamówień.

Budowanie KPI na podstawie powiązanych zasobów
Monitor klasy decyzyjnej zaczyna się od zaufanej metryki biznesowej, a następnie śledzi tę metrykę wstecz do jej bazowych zasobów danych. Gdy znasz zależności, możesz przypisać metryki observability do każdego zasobu i sprawić, by zagregowany wskaźnik KPI dziedziczył te sygnały. Jeśli przychody z kasy (checkout) ulegają zmianie, nie patrzysz tylko na wykres przychodów. Sprawdzasz jednocześnie świeżość zdarzeń zamówień, anomalie wolumenu pozycji zamówienia oraz stabilność schematu katalogu produktów.
To jest różnica między zwykłym pulpitem nawigacyjnym a prawdziwym monitorem biznesowym. Zwykły wykres może świecić na zielono nawet wtedy, gdy brakuje jednego z wejść lub jest ono zniekształcone. Monitor klasy decyzyjnej szuka ścieżki awarii pod wskaźnikiem KPI i kieruje problem do zespołu odpowiedzialnego za dany proces biznesowy.
Dobry model własności jest prosty. Dział finansów lub operacyjny powinien być właścicielem definicji KPI, zespół platformy danych powinien odpowiadać za surowe sygnały observability, a inżynieria analityczna powinna utrzymywać mapę zależności. Zapobiega to krążeniu alertów między zespołami, z których każdy odpowiada tylko za część problemu.
digna to jedna z platform, która łączy monitorowanie biznesowe z timeliness, wykrywaniem anomalii, walidacją i śledzeniem schematów wewnątrz własnego środowiska klienta. Ważna jest tutaj nie sama marka, ale wzorzec, ponieważ wskaźnik KPI staje się operacyjny tylko wtedy, gdy leżące u jego podstaw sygnały są widoczne i powiązane z jasnym właścicielem.
Monitory KPI powinny być nieliczne, ponieważ każdy z nich wymaga przypisania ludzkiej decyzji.
Macierz szybkiego dostępu dla katalogu
Katalog referencyjny powinien mieścić się na jednym ekranie, gdy ktoś skanuje zgłoszenie o incydencie. Celem nie jest pokazanie każdej możliwej metryki, ale pomoc liderowi w szybkim uzyskaniu odpowiedzi na jedno pytanie: na co powinienem ustawić alert dla tego zasobu?
Poniższa macierz kompresuje powszechne kategorie do jednego widoku roboczego. Progi są punktami wyjścia, a nie uniwersalnymi prawdami, i powinny być dostosowywane dla każdego zasobu po ustaleniu linii bazowej rzeczywistego zachowania.
Kategoria metryki | Podstawowe obliczenie | Zalecany próg alertu | Typowy właściciel | Poziom ważności |
|---|---|---|---|---|
Świeżość |
| Bezwzględne naruszenie SLA w minutach | Inżynier platformy danych | Wysoki |
Anomalia wolumenu | Ruchoma średnia i odchylenie standardowe lub z-score | Odchylenie od linii bazowej oparte na rozkładzie | Inżynier analityki | Średni do wysokiego |
Liczba zmian schematu | Liczba dodań, usunięć, zmian typów na uruchomienie | Bezwzględna liczba krytycznych zmian | Właściciel kodu | Wysoki |
Dryft dystrybucji | PSI, test KS lub przesunięcie histogramu | Względna zmiana w stosunku do rozkładu bazowego | Lider ds. jakości danych | Średni |
Przerwanie pochodzenia danych | Brakująca zależność upstream lub downstream | Bezwzględne przerwanie w grafie zależności | Inżynier platformy | Wysoki |
Współczynnik wartości null | Wartości null podzielone przez wszystkie rekordy | Względny wzrost powyżej linii bazowej | Inżynier analityki | Średni |
Unikalność | Liczba unikalnych wartości podzielona przez liczbę wierszy | Bezwzględny lub względny spadek unikalności | Data steward | Średni |
Monitor biznesowych KPI | KPI wyprowadzony z wielu sygnałów | Odchylenie poza biznesowy margines tolerancji | Właściciel biznesowy | Krytyczny |
Jeśli chcesz zobaczyć tabelę systemową platformy, która odzwierciedla tego typu myślenie o katalogu, tabela systemowa metryk digna pokazuje, jak rodziny metryk mogą być zorganizowane do celów operacyjnych. Najlepsza macierz to taka, którą Twój zespół jest w stanie utrzymać podczas incydentu, a nie ta z największą liczbą wierszy.
Powiązania między kategoriami metryk
Opóźniony potok danych często zaczyna się od braku świeżości, a następnie ujawnia się jako anomalia wolumenu, ponieważ dotarło mniej wierszy niż zakładała linia bazowa. Traktuj tę parę jako jedną ścieżkę incydentu, a nie dwa niepowiązane alerty.

Świeżość do wolumenu, schemat do dystrybucji, pochodzenie do dryftu
Zmiana schematu i skok współczynnika wartości null często występują wspólnie po migracji API dostawcy. Jedna zmiana struktury danych może wywołać zarówno problem z brakującymi polami, jak i problem z kształtem wartości, dlatego alert schematu powinien być sprawdzony z monitorem dystrybucji przed zamknięciem zgłoszenia.
Przerwania pochodzenia danych mogą również wyzwalać alerty dryftu downstream, gdy jedno brakujące źródło wpływa na każdą zależną tabelę. Linie bazowe dla poszczególnych zasobów pozwalają na rzetelne porównanie, ponieważ tabela rozliczeń dziennych i strumień zdarzeń o wysokiej częstotliwości mogą być zdrowe, zachowując się przy tym zupełnie inaczej.
Zapisz te trzy pary jako powiązane kontrole w swoim narzędziu do alertów, aby drugi sygnał był sprawdzany automatycznie, gdy uruchomi się pierwszy.
Wybór najmniejszego zestawu metryk, który ma znaczenie
Zestaw metryk pomaga tylko wtedy, gdy wpływa na decyzję. Jeśli alert nie wskazuje właściciela ani prawdopodobnego rozwiązania, staje się szumem.
Zacznij od SLA świeżości dla każdego poziomu krytycznego, jednego wskaźnika anomalii dla wolumenów powiązanych z przychodami, liczby zmian schematu dla tabel, które mogą popsuć odbiorców downstream, oraz jednego monitora KPI na każdy główny proces biznesowy. Dla platformy płatniczej taki zestaw startowy może obejmować SLA świeżości dla tabeli transakcji, wskaźnik anomalii 3-sigma dla dziennego wolumenu rozliczeń, liczbę zmian schematu dla tabeli klientów oraz jeden monitor KPI dla wskaźnika zwrotów.
Wybieraj metryki na podstawie własności, historii incydentów i zakresu potencjalnych szkód (blast radius). Weryfikuj listę co kwartał, ponieważ zasoby się zmieniają, sposoby awarii ewoluują, a katalog powinien zmieniać się wraz z nimi.
Najczęściej zadawane pytania
Czym są wskaźniki data observability?
To pomiary w formie szeregów czasowych pobierane z zasobów danych i potoków, które je przenoszą. Nazwa taka jak null_rate_email_hourly mówi analitykowi znacznie więcej niż check_7, bo niesie już temat, miarę i rytm, zanim ktokolwiek otworzy definicję.
Czym różnią się od kontroli jakości danych?
Kontrola odpowiada na pytanie tak lub nie w danym momencie; wskaźnik jest trendowany, ma linię bazową i można na nim ustawić alert. Użyteczny test jest prosty: jeśli zespół uruchamia go tylko wtedy, gdy ktoś podejrzewa problem, to jest to test, a nie observability.
Jakie jest pięć kategorii wskaźników?
Świeżość, wolumen, schemat, rozkład i lineage. Każda ma inną sygnaturę awarii: świeżość dotyczy opóźnienia, a nie tego, czy zadanie się wykonało, wolumen sprawdza, czy liczba rekordów jest mniej więcej taka, jak oczekiwano, a rozkład patrzy na zachowanie wartości, a nie na same liczniki.
Po co zespołowi wspólny katalog wskaźników?
Aby zatrzymać dryf incydentów. Gdy lider danych, analityk i inżynier rozumieją tak samo określenie „spóźnione dane”, przestają tłumaczyć, a zaczynają naprawiać. Jeśli dwie osoby mogą się spierać, czy problem dotyczy świeżości, wolumenu czy schematu, katalog nie jest jeszcze dość precyzyjny.
Co powinien dokumentować każdy wpis katalogu?
Trzy rzeczy: definicję prostym językiem, metodę obliczenia oraz postawę alertową, czyli to, czy wskaźnik ostrzega, wzywa dyżurnego, czy tylko zasila analizę. To ostatnie pole chroni katalog przed zamienieniem się w nierozróżnialny szum.



