Czym jest plik Parquet i dlaczego napędza nowoczesną analitykę
|
8
min. czyt.

Apache Parquet to otwartoźródłowy, kolumnowy format plików dla danych analitycznych. Jego układ zaczyna się 4-bajtową liczbą magiczną PAR1, a kończy stopką przechowującą schemat, położenie row groups i statystyki. Dane leżą kolumnami wewnątrz row groups, column chunks i data pages, dzięki czemu silniki zapytań mogą odrzucić kolumny i pominąć nieistotne row groups, zanim rozpoczną kosztowne odczyty.
Jeśli zastanawiasz się, czym jest plik Parquet, prawdopodobnie mierzysz się z jedną z dwóch frustracji. Albo Twoje zapytania do hurtowni skanują znacznie więcej danych, niż powinny, albo Twoje jezioro zamieniło się w nieuporządkowaną mieszankę CSV, JSON i na wpół udokumentowanych eksportów, którym nikt do końca nie ufa. W obu przypadkach format pliku nie jest drobnym szczegółem implementacyjnym. Kształtuje koszt, szybkość oraz to, jak bezpiecznie zespoły niżej w łańcuchu mogą na nim budować.
Pomyśl o typowym przepływie analitycznym. Programistka BI potrzebuje przychodu według regionu i miesiąca. Surowy zbiór danych ma dziesiątki dodatkowych pól, zagnieżdżone atrybuty i historyczne partycje. Jeśli te dane leżą w wierszowych plikach tekstowych, silnik często musi przebrnąć przez wszystko, żeby odpowiedzieć na jedno wąskie pytanie. Parquet zmienił ten model operacyjny, stając się praktycznym formatem wymiany dla systemów analitycznych, zwłaszcza w jeziorach danych i nowoczesnych hurtowniach, ponieważ zaprojektowano go wokół odczytów selektywnych, a nie skanowania całych plików.
To wykracza poza wydajność. Decyzje o formacie wpływają także na niezawodność. Gdy pojawiają się zmiany schematu, gdy foldery partycji odbiegają od oczekiwań albo gdy statystyki przestają pomagać silnikowi pomijać nieaktualne zakresy, zespoły odczuwają to jako zepsute pulpity, kosztowne zadania i trudne do zdiagnozowania incydenty. Dlatego zespoły platform danych często traktują Parquet zarówno jako format przechowywania, jak i standard operacyjny.
Spis treści
Praca z Parquet w Spark, Presto, Pandas i partycjonowanych jeziorach
Zapewnianie wiarygodnych danych Parquet dzięki obserwowalności i kontrolom jakości
Wprowadzenie: czym naprawdę jest plik Parquet
Plik Parquet to format przechowywania zbudowany do pracy analitycznej, zwłaszcza gdy zespoły odpytują duże zbiory danych, ale za każdym razem potrzebują tylko kilku pól.
Zacznijmy od znajomego problemu hurtowni. Programistka BI otwiera zapytanie pulpitu o przychód według kanału i miesiąca. Dane źródłowe zawierają ustawienia kampanii, szczegóły urządzeń, cechy użytkowników, ładunki zdarzeń i kilka kolumn, których nikt do tego pytania nie potrzebuje. Jeśli te rekordy leżą w CSV lub JSON, silnik i tak musi zwykle przeczytać cały ten materiał, bo każdy wiersz trzyma wszystkie pola razem.
Parquet zmienia ten model operacyjny. Przechowuje dane kolumnami, więc silniki zapytań mogą skupić się na polach, do których odwołuje się zapytanie, zamiast przeciągać każdy atrybut przez ścieżkę odczytu. Dokumentacja Apache Parquet opisuje go jako otwartoźródłowy, kolumnowy format dla danych analitycznych, a struktura pliku obejmuje liczbę magiczną PAR1 oraz metadane stopki, takie jak informacje o schemacie i położenie row groups (dokumentacja formatu pliku Apache Parquet).
Ten wybór układu wpływa na więcej niż tylko szybkość.
W prawdziwym jeziorze danych decyzje o formacie widać na miesięcznym rachunku, w opóźnieniach pulpitów i w reagowaniu na incydenty. Format wspierający odczyty selektywne pomaga obniżyć koszty skanowania. Format z wbudowanym w plik schematem i metadanymi daje platformom więcej do walidowania, monitorowania i diagnozowania. Gdy producent dodaje kolumny, zmienia typy albo niespójnie zapisuje partycje, takie problemy łatwiej wykryć, jeśli format niesie mocniejszą informację strukturalną niż zwykły tekst.
Z tego powodu Parquet stał się standardem w jeziorach i hurtowniach. Daje Sparkowi, Trino, Hive, Pandas, DuckDB i chmurowym silnikom hurtowni wspólny format dopasowany do analitycznych wzorców dostępu. Dla inżynierów analityki oznacza to mniej kompromisów między interoperacyjnością a wydajnością. Dla zespołów platform oznacza, że Parquet to nie tylko rozszerzenie pliku. To decyzja operacyjna o kontroli kosztów, przycinaniu zapytań, stabilności schematu i o tym, jak bardzo zespoły niżej mogą ufać temu, co czytają.
Jak działa przechowywanie kolumnowe i dlaczego ma znaczenie
Większość nieporozumień wokół Parquet zaczyna się tutaj. Ludzie słyszą kolumnowy i zakładają, że oznacza to tylko „lepiej się kompresuje”. Kompresja to część historii, ale ważniejszy jest sposób fizycznego ułożenia danych.
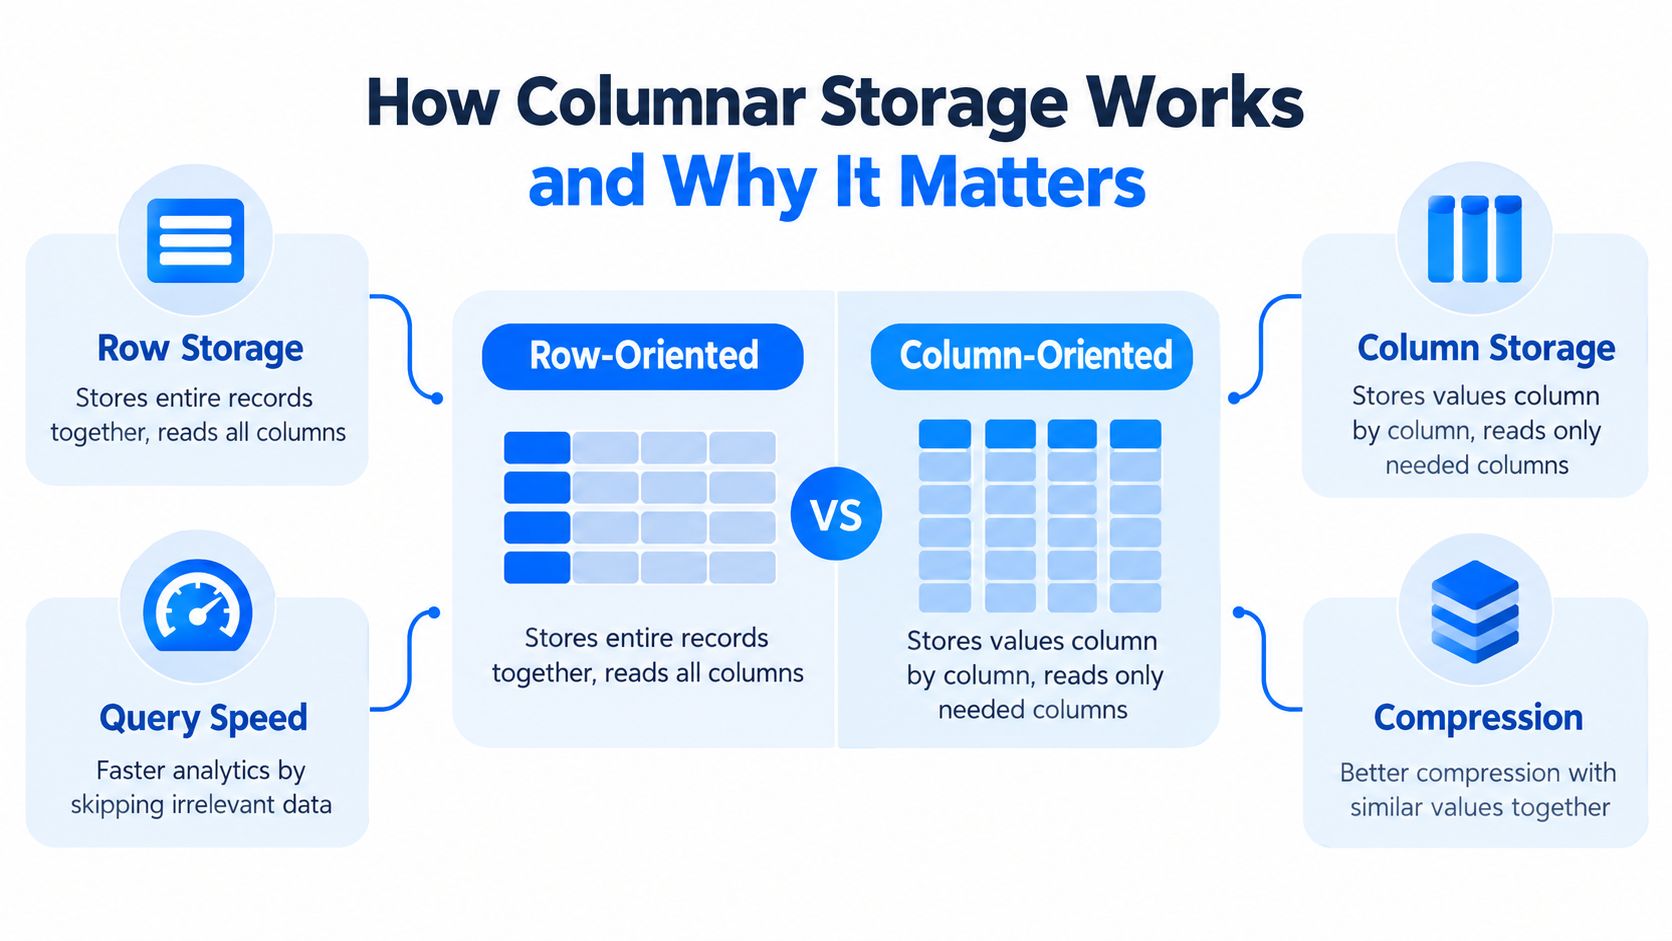
Wiersze są dla rekordów, kolumny dla pytań
Wyobraź sobie arkusz z kolumnami order_id, country, order_date i amount.
W formacie wierszowym przechowywanie wygląda jak spakowane rekordy:
zamówienie 1: wszystkie pola razem
zamówienie 2: wszystkie pola razem
zamówienie 3: wszystkie pola razem
W formacie kolumnowym przechowywanie grupuje wartości według pola:
wszystkie wartości
order_idrazemwszystkie wartości
countryrazemwszystkie wartości
order_daterazemwszystkie wartości
amountrazem
Brzmi abstrakcyjnie, dopóki nie zastosujesz zapytania. Jeśli Twoje narzędzie BI pyta o łączną kwotę według kraju, nie potrzebuje każdego pola w każdym rekordzie. Przy przechowywaniu kolumnowym silnik może ograniczyć się do istotnych kolumn.
Dlaczego korzystają na tym silniki analityczne
Zapytania analityczne często skanują wiele wierszy, ale odwołują się do stosunkowo niewielu kolumn. To dokładnie ten wzorzec dostępu, któremu sprzyja Parquet.
Praktyczny model myślowy:
Planista zapytań sprawdza żądane kolumny.
Silnik czyta wyłącznie te segmenty kolumn.
Nieistotne pola zostają na dysku lub w magazynie obiektowym.
Ten selektywny odczyt to jeden z powodów, dla których zespoły wcześnie poświęcają czas decyzjom o architekturze systemów danych. Układ przechowywania i silnik zapytań muszą współpracować, inaczej zapłacisz za skanowania, których nigdy nie chciałeś uruchomić.
Gdy ktoś mówi, że Parquet jest szybki, zwykle ma na myśli, że silnik unika pracy, zanim przeczyta większość pliku.
Dlaczego podobne wartości pomagają także kompresji
Przechowywanie kolumnowe grupuje również podobne typy danych i powtarzające się wartości. Kolumna country z wieloma powtarzającymi się kodami kompresuje się inaczej niż mieszany wiersz z przeplatanymi znacznikami czasu, liczbami dziesiętnymi, wartościami logicznymi i łańcuchami.
To ważne, bo systemy analityczne nie troszczą się wyłącznie o rozmiar na dysku. Mniejsze, bardziej jednorodne segmenty kolumn mogą obniżyć operacje wejścia-wyjścia i ułatwić silnikom przetwarzanie skanów. Przewaga nie sprowadza się więc do jednej rzeczy. Wynika z połączenia odczytów selektywnych z danymi, które z natury są przyjaźniejsze optymalizacji przechowywania.
Kieruj się tą regułą:
Wybieraj formaty wierszowe, gdy często musisz czytać lub zapisywać całe rekordy.
Wybieraj formaty kolumnowe, gdy agregujesz, filtrujesz i skanujesz kilka pól w wielu rekordach.
Dlatego Parquet pojawia się tak często w hurtowniach tematycznych, kuratorowanych warstwach jeziora i potokach bliskich hurtowni.
Wewnątrz pliku Parquet: od row groups do pages
Wielu wie, że Parquet jest kolumnowy, ale nie potrafi wyobrazić sobie wnętrza pliku. Właśnie tam strojenie wydajności robi się mgliste. Bez zrozumienia hierarchii trudno wyjaśnić, dlaczego jeden zbiór dobrze się przycina, a inny skanuje zbyt wiele.
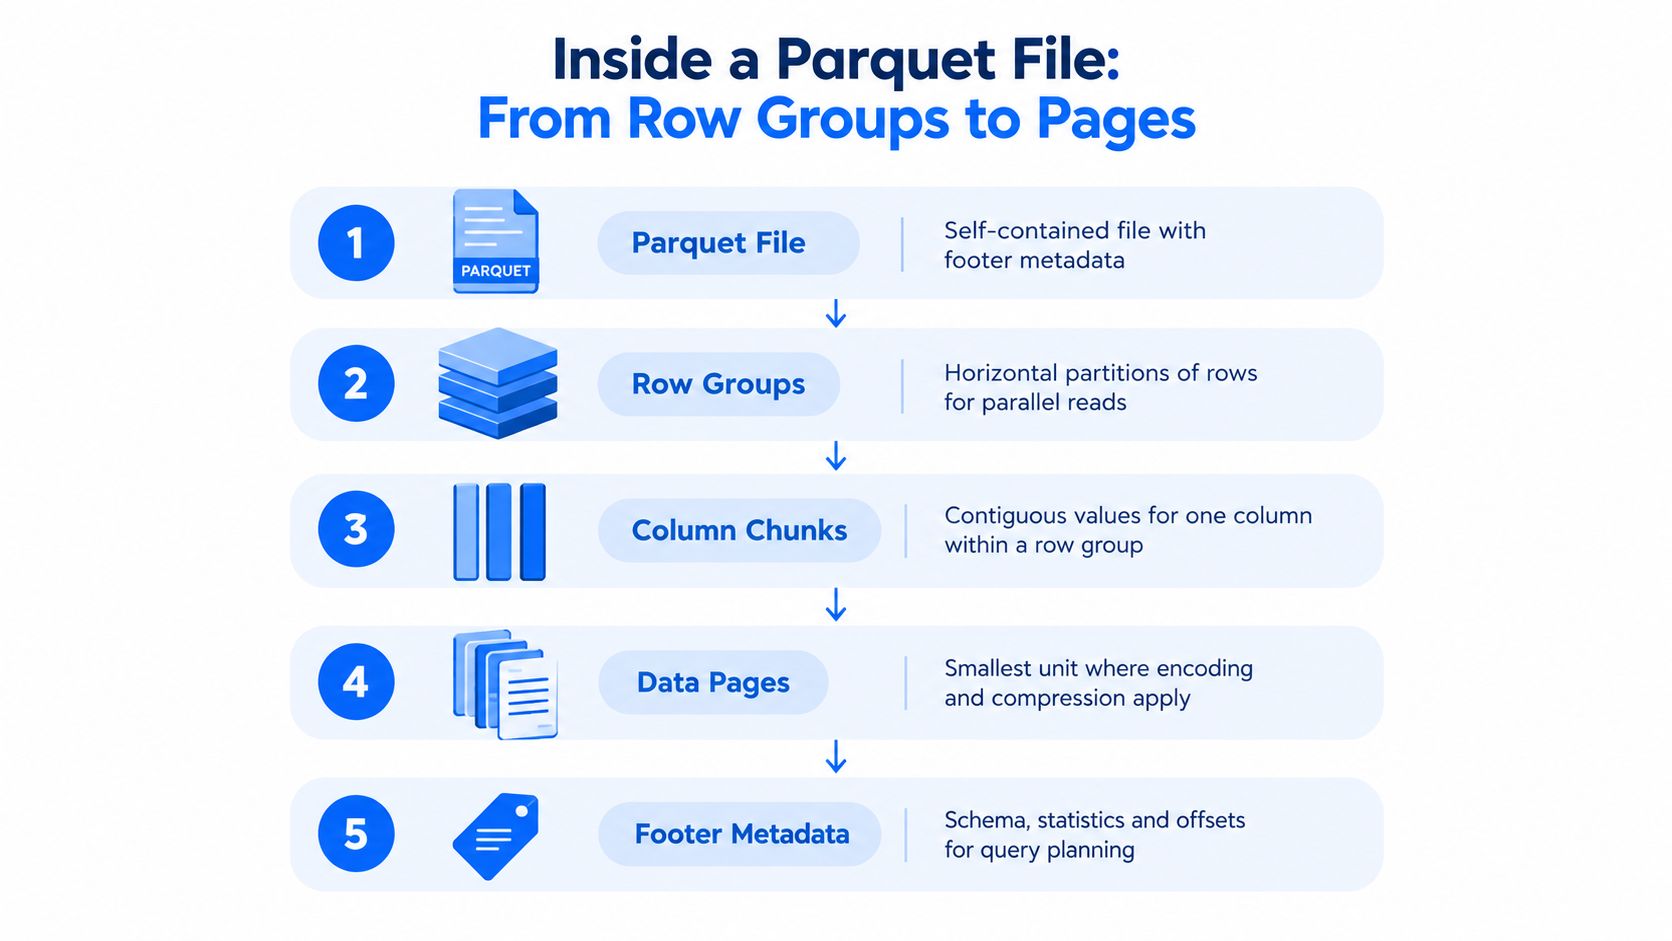
Zacznij od poziomu pliku
Plik Parquet jest samowystarczalny. Projekt Apache zaznacza, że format jest otwarty oraz że specyfikację formatu pliku i definicję Thrift należy czytać razem, aby zrozumieć działanie struktury (dokumentacja Apache Parquet).
Na wysokim poziomie plik zawiera:
Sekcje danych, które przechowują właściwe wartości kolumn
Stopkę, która opisuje zawartość
Przesunięcia i metadane, które pomagają czytającym szybko odnaleźć właściwe fragmenty
Ta stopka jest centrum sterowania. Podaje silnikowi schemat, położenie row groups oraz statystyki dostępne do zaplanowania odczytu.
Hierarchia wewnętrzna
Struktura Parquet jest uwarstwiona w bardzo określony sposób:
Row groups
To poziome partycje wierszy wewnątrz pliku. Row group zawiera ten sam zakres wierszy we wszystkich kolumnach.Column chunks
Wewnątrz każdej row group każda kolumna otrzymuje własny ciągły blok danych.Data pages
Wewnątrz każdego column chunk wartości przechowywane są w mniejszych jednostkach zwanych pages.
W środowiskach jeziorowych obfitujących w metadane ta hierarchia ściśle łączy się z zarządzaniem metadanymi. Im wyraźniej zespoły śledzą schematy, partycje i strukturę plików, tym łatwiej zdiagnozować zachowanie skanów i awarie związane ze schematem.
Dlaczego row groups mają znaczenie operacyjne
Row groups to więcej niż szczegół przechowywania. Wpływają na to, ile danych silnik zapytań może pominąć i jak da się zrównoleglić pracę.
Załóżmy, że zapytanie filtruje wąski zakres dat. Jeśli statystyki row group pokazują, że pewne grupy zawierają wyłącznie starsze daty, silnik może je pominąć zamiast skanować. To praktyczna wartość osadzonych metadanych: skracają odczyty, zanim rozpocznie się dekodowanie.
Zdrowy zbiór danych Parquet jest nie tylko poprawny. Jest zorganizowany tak, by silniki mogły szybko powiedzieć „nie” niepotrzebnym odczytom.
Co stopka mówi silnikowi
Stopka przechowuje metadane takie jak:
Informacje o schemacie
Położenie row groups
Statystyki, w tym min/max oraz liczbę wartości pustych
Te statystyki mają znaczenie operacyjne, bo pozwalają silnikom odrzucić nieistotne dane przed ich skanowaniem. To jeden z powodów, dla których Parquet stał się faktycznym formatem wymiany w analityce, jak opisuje przywołana wcześniej dokumentacja formatu pliku Apache Parquet.
Jeśli kiedykolwiek zastanawiałeś się, czemu jedna tabela wydaje się „żwawa” w Trino czy Sparku, a inna nie, odpowiedź często kryje się właśnie tutaj. Oba pliki mogą być Parquet, ale wewnętrzny układ, granice row groups i jakość metadanych potrafią dać bardzo różne zachowanie w czasie wykonania.
Kodowanie, kompresja i metadane napędzające wydajność
Plik Parquet oszczędza pieniądze i przyspiesza zapytania z trzech różnych powodów. Przechowuje wartości efektywnie dzięki kodowaniu, zmniejsza zakodowane bajty kompresją i daje silnikom zapytań metadane, dzięki którym w ogóle nie muszą czytać nieistotnych danych.
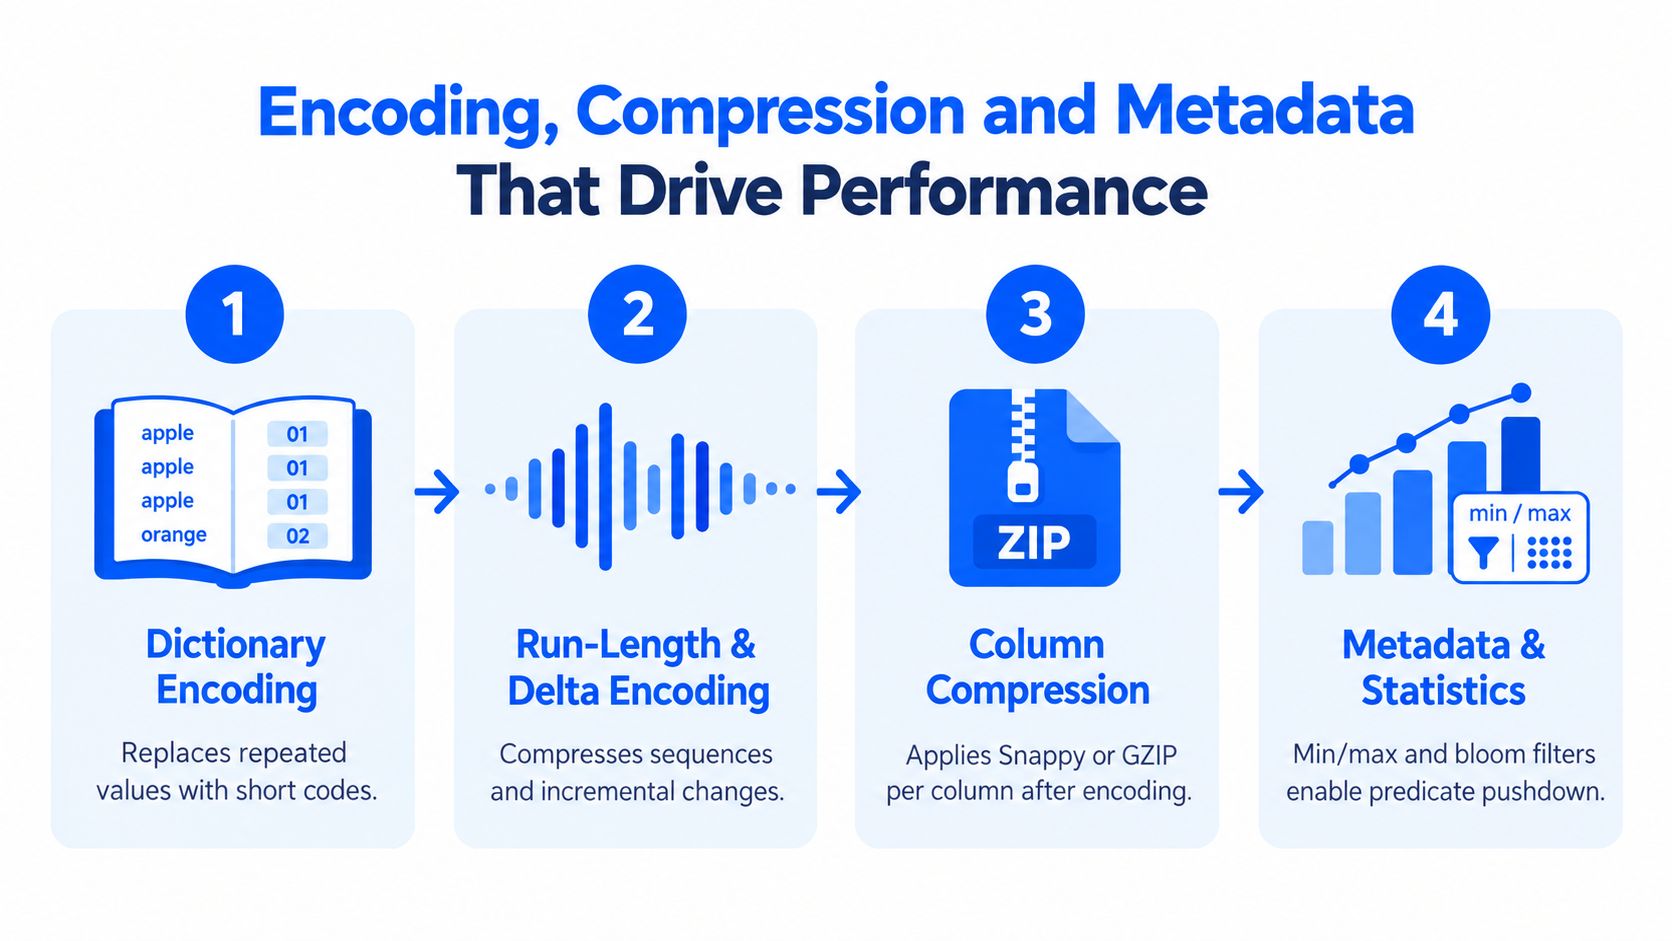
Kodowanie jest pierwsze
Kodowanie zmienia sposób reprezentacji wartości, zanim uruchomi się jakikolwiek kodek kompresji. Dokumentacja formatu Parquet wymienia kodowania takie jak słownikowe, run-length i delta jako element projektu pliku (specyfikacja kodowania Parquet).
W prostych słowach:
Kodowanie słownikowe zapisuje powtarzające się wartości jako krótkie odwołania zamiast powtarzać pełną wartość za każdym razem.
Kodowanie run-length zapisuje zwięźle długie serie tej samej wartości.
Kodowanie delta zapisuje różnice między sąsiednimi wartościami, co dobrze działa dla ciągów stopniowo rosnących lub malejących.
Programistka BI odczuje tę różnicę, nie oglądając bajtów wprost. Kolumna kraju z wieloma powtórzeniami albo kolumna znacznika czasu o przewidywalnych przyrostach daje Parquetowi wzorce, które przechowa znacznie wydajniej niż surowy tekst.
Kompresja zmniejsza zakodowane bajty
Gdy wartości są już zakodowane, Parquet może kompresować dane każdej kolumny osobno. To ważne, bo pojedyncza kolumna zwykle zawiera jeden typ danych i jeden rodzaj wzorca. Kolumna statusu zachowuje się inaczej niż kolumna ceny, a Parquet pozwala każdej kompresować się na własnych warunkach.
Dlatego „Parquet jest skompresowany” to tylko część historii. Kompresja zmniejsza przechowywanie i ruch sieciowy, ale to często kodowanie tworzy powtarzalność, którą kompresja może wykorzystać. W chmurowych platformach danych przekłada się to na niższy koszt przechowywania i mniej bajtów pobieranych podczas skanów.
Metadane napędzają największe decyzje wydajnościowe
To przy metadanych Parquet przestaje być formatem przechowywania, a staje się decyzją operacyjną.
Gdy analityk filtruje order_date >= '2026-01-01', silnik może pominąć duże fragmenty pliku, zanim zdekoduje choć jedną wartość. Może tak zrobić, bo Parquet przechowuje statystyki i szczegóły strukturalne pomagające wykluczyć row groups i pages, które nie mogą spełnić filtru. Mniej czytania oznacza szybsze pulpity, niższe koszty zapytań i bardziej przewidywalną wydajność przy współdzielonych obciążeniach.
Te same metadane wpływają również na niezawodność. Gdy szczegóły schematu dryfują, brakuje statystyk albo wartości partycji nie zgadzają się z zawartością plików, zespoły tracą jednocześnie szybkość i zaufanie. Przycinanie zapytań słabnie. Diagnostyka zwalnia. Kontrakty danych trudniej egzekwować.
Właśnie dlatego praca z metadanymi należy do rozmów o jakości danych, a nie tylko o przechowywaniu. Zespoły inwestujące w praktyki metadanych poprawiające jakość i efektywność danych zwykle zyskują dwie korzyści naraz: lepsze zachowanie skanów i wcześniejsze wykrywanie problemów ze schematem lub partycjami.
W jeziorach korporacyjnych dobrze zapisane pliki Parquet nie tylko tanio leżą w magazynie obiektowym. Pomagają silnikom oszczędzać pracę, zespołom dostrzegać dryf, a właścicielom platform utrzymać wydajność i niezawodność przed stopniową degradacją.
Parquet wobec CSV, JSON i ORC: kompromisy wyjaśnione
Parquet jest popularny, ale nie jest odpowiedzią na każde pytanie o przechowywanie. Zespoły wybierają lepiej, gdy porównują formaty według obciążenia, zamiast zakładać, że jeden format musi wygrywać wszędzie.
Zacznij od prostego rozróżnienia
CSV i JSON są często łatwiejsze na granicach wczytywania. Są czytelne, przenośne i znane niemal wszystkim. Ta wygoda potrafi jednak drogo kosztować, gdy te same pliki obsługują powtarzalne zapytania analityczne.
Parquet jest mocniejszy tam, gdzie czytający potrzebują selektywnego dostępu, typowanego schematu i wydajnych skanów. ORC również jest kolumnowy i często pojawia się w rozmowie w środowiskach mocno opartych na hurtowni. Praktyczny wybór zależy od Twoich narzędzi, wzorców zapisu i od tego, kto musi oglądać dane bezpośrednio.
Wybór między formatami wierszowymi a kolumnowymi
Format | Najlepszy do | Efektywność przechowywania | Wzorzec zapytań |
|---|---|---|---|
CSV | Proste eksporty, ręczna inspekcja, lekka wymiana | Niższa przy obciążeniach analitycznych | Odczyty zwykle obejmują pełną zawartość wiersza |
JSON | Elastyczna wymiana półstrukturalna i ładunki API | Często niższa dla analityki, bo struktura powtarza się w pliku | Dobry do wymiany między aplikacjami, mniej wydajny przy powtarzalnych skanach analitycznych |
Parquet | Analityczne zbiory danych, kuratorowane warstwy jeziora, przechowywanie przyjazne BI | Wysoka dla danych analitycznych, bo kolumny są przechowywane osobno i optymalizowane indywidualnie | Najlepszy, gdy zapytania czytają podzbiór kolumn w wielu wierszach |
ORC | Analityka kolumnowa w ekosystemach już na nim wystandaryzowanych | Wysoka przy obciążeniach analitycznych | Dobre dopasowanie do odczytów analitycznych, zwłaszcza tam, gdzie wsparcie ORC jest już ugruntowane |
Jak decydować w praktyce
Używaj Parquet, gdy spełnione są te warunki:
Twoje zapytania są selektywne: analitycy wielokrotnie pytają o kilka kolumn w szerokich zakresach dat.
Potrzebujesz mocniejszego zachowania schematu: typowane przechowywanie pomaga, gdy modele i pulpity niżej zależą od spójnych pól.
Koszt przechowywania ma znaczenie: mniejsze ślady analityczne mogą obniżyć narzut skanowania.
Zostań przy CSV lub JSON, gdy przeważają te warunki:
Ludzie muszą oglądać pliki bezpośrednio: do szybkiego rzutu oka tekst wciąż wygrywa.
Systemy źródłowe najpierw emitują surowe rekordy: strefy lądowania często pozostają wierszowe przed kuratelą.
Prostota zapisu liczy się bardziej niż optymalizacja odczytu: niektóre potoki chcą na brzegu najprostszego możliwego formatu eksportu.
ORC wchodzi do gry, gdy Twój stos i tak w tę stronę się przechyla. Jeśli Twoje silniki, standardy nadzoru lub konwencje platformy sprzyjają ORC, może to być lepszy wybór organizacyjny. Rzecz nie w tym, że Parquet bije wszystko. Chodzi o to, że Parquet często wygrywa, gdy zespoły analityczne optymalizują pod powtarzalne odczyty, przewidywalną obsługę schematu i szeroką zgodność ekosystemu.
Praca z Parquet w Spark, Presto, Pandas i partycjonowanych jeziorach
Format staje się użyteczny, gdy pasuje do narzędzi, których ludzie już używają. Parquet pasuje. Ekosystem Apache Parquet oraz Library of Congress opisują go jako szeroko wspierany w wielu językach programowania i narzędziach analitycznych, a projekt prowadzi formalną historię wersji w repozytorium parquet-format (repozytorium Apache parquet-format).
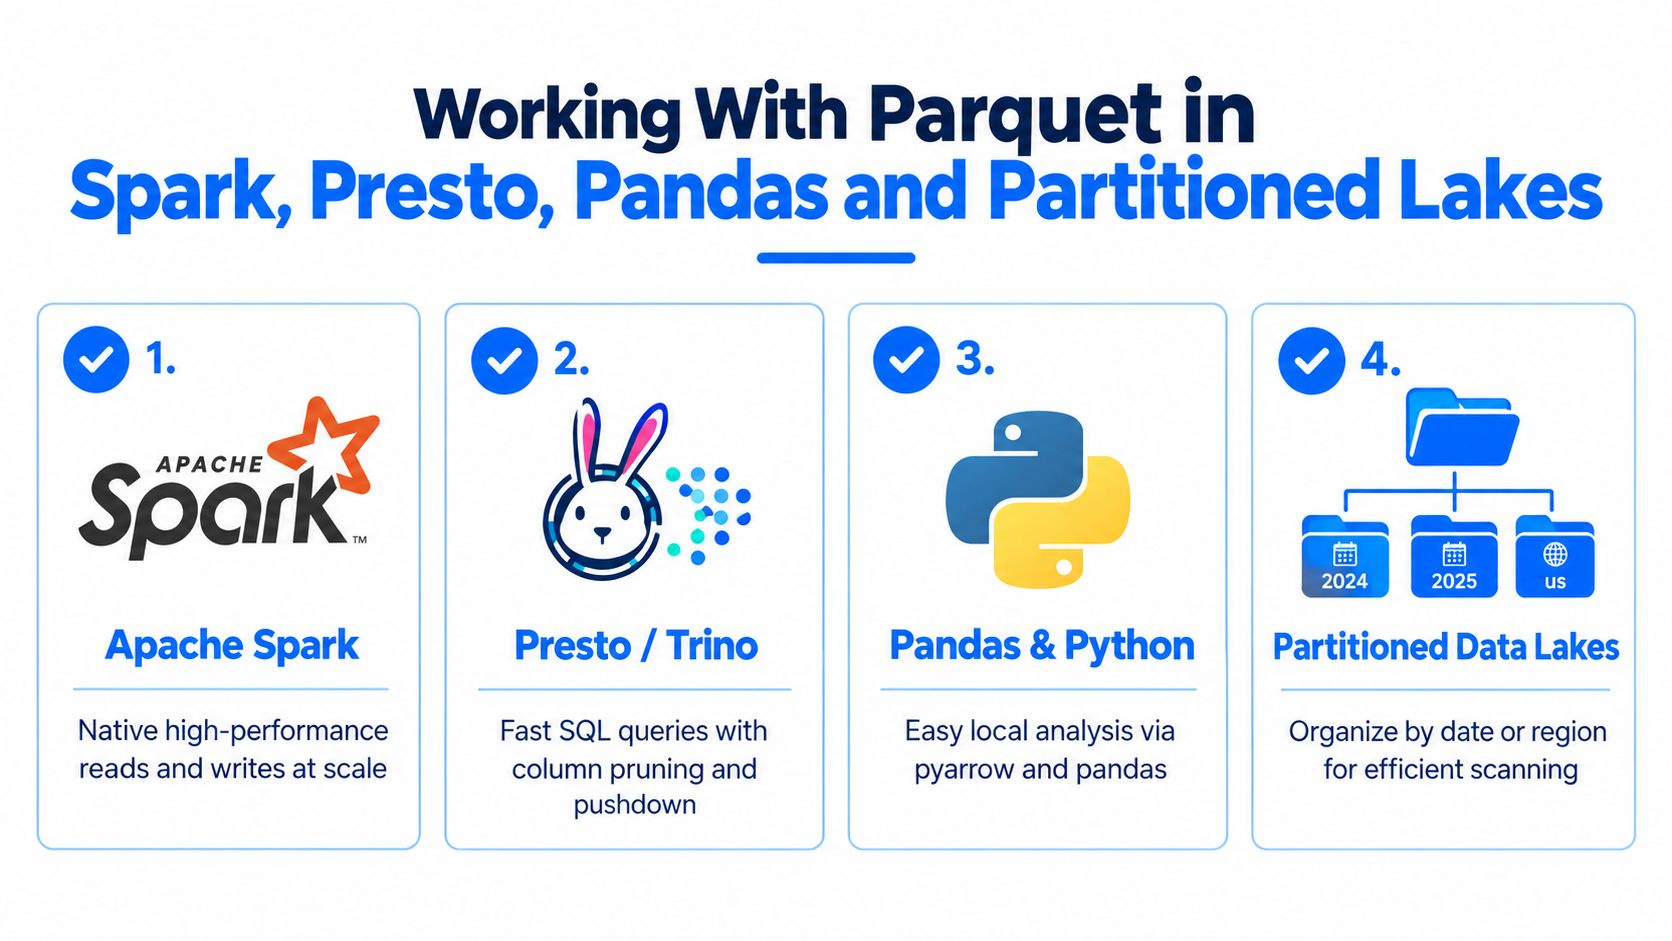
Jak to wygląda w prawdziwych potokach
W Sparku Parquet naturalnie pasuje do dużych rozproszonych odczytów i zapisów. W Presto lub Trino przycinanie kolumn i predicate pushdown są kluczowe dla szybkiego SQL nad danymi jeziora. W Pandas zespoły często czytają Parquet przez narzędzia oparte na Arrow, do analizy lokalnej i pracy deweloperskiej.
To szerokie wsparcie jest jednym z powodów, dla których Parquet stał się domyślnym wyborem dla współdzielonych zbiorów danych. Narzędzia nie potrzebują specjalnych, jednorazowych adapterów, żeby wziąć udział.
Dla zespołów prowadzących potoki typu lakehouse na Databricks obserwowalność platformy danych dla środowisk Databricks nabiera znaczenia, gdy rośnie liczba zbiorów i wolumen zadań. Problemy z układem plików, spóźnione partycje i niezgodności schematu ujawniają się najpierw jako szum operacyjny, a nie jako oczywiste błędy formatu.
Praktyczna lista kontrolna
Parquet działa najlepiej, gdy zespoły zarządzają zbiorem danych, a nie tylko pojedynczym plikiem.
Partycjonuj z umiarem: porządkuj dane według pól zgodnych z typowymi filtrami, jak data czy region, ale nie rozdrabniaj drzewa katalogów na maleńkie fragmenty.
Unikaj małych plików: zbyt wiele maleńkich plików Parquet potrafi zniweczyć zalety dobrego formatu, bo silniki tracą czas na otwieranie i planowanie wielu obiektów.
Traktuj ewolucję schematu ostrożnie: dodawanie kolumn zwykle da się opanować. Niezgodne zmiany typów to moment, w którym potoki i pulpity zaczynają się psuć.
Ujednolicaj wzorce zapisu: mieszane konwencje między producentami tworzą możliwe do uniknięcia tarcie dla czytających niżej.
Format pliku może być poprawny, a zbiór danych i tak trudny w eksploatacji. Większość bólu z Parquet bierze się z błędów układu, partycjonowania lub zarządzania schematem.
Jeden nawyk operacyjny, który się opłaca
Świadomie śledź dryf schematu. Jeśli jeden producent zapisuje customer_id jako łańcuch, a inny inaczej, problem nie zawsze objawi się nieudanym zapisem. Czasem wychodzi później jako mylące wartości puste, pominięte partycje albo model BI, który przestaje się kompilować.
Tu obserwowalność spotyka się ze znajomością formatu. Jedną z opcji używanych przez zespoły jest digna, która działa w środowisku klienta i potrafi monitorować zmiany schematu, Timeliness, anomalie i kontrole walidacyjne w zbiorach jeziora i hurtowni. W platformach mocno opartych na Parquet takie kontrole pomagają wychwycić przypadki, gdy pliki pozostają technicznie czytelne, ale operacyjnie niebezpieczne.
Zapewnianie wiarygodnych danych Parquet dzięki obserwowalności i kontrolom jakości
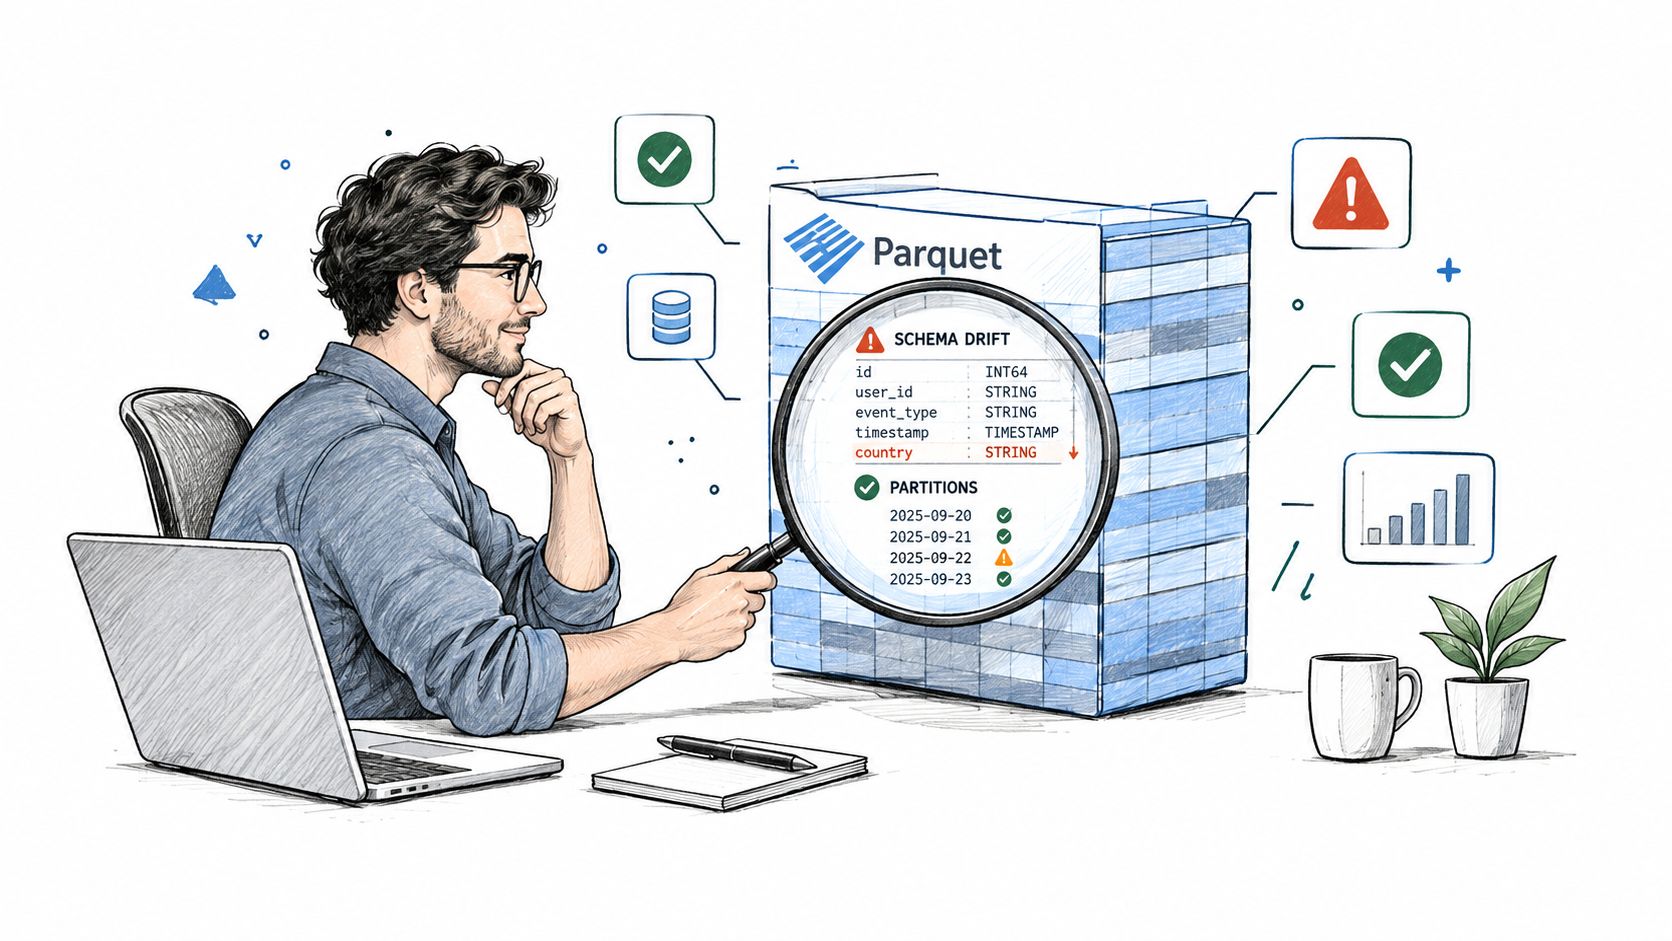
Plik Parquet może być całkowicie poprawny i mimo to spowodować zepsuty pulpit w poniedziałek rano. To ta część, której wiele zespołów uczy się boleśnie.
Gdzie naprawdę ujawniają się problemy z niezawodnością
Typowe tryby awarii nie są egzotyczne:
Producent dodaje lub usuwa kolumny, a transformacje niżej nie dostosowują się czysto.
Partycja dociera z opóźnieniem, więc wczorajszy pulpit wygląda na kompletny, choć nie jest.
Wartości danych się przesuwają, choć struktura pliku nadal wygląda dobrze.
Liczba plików eksploduje, a silniki spędzają więcej czasu na zarządzaniu obiektami niż na czytaniu użytecznych danych.
Żadnego z tych problemów nie rozwiąże stwierdzenie „używamy Parquet”. Format daje wydajne przechowywanie i użyteczne metadane. Nie gwarantuje, że producenci zapiszą spójne schematy ani że zadania dostarczą dane na czas.
Co monitorować wokół zbiorów danych Parquet
Niezawodna eksploatacja Parquet zwykle obejmuje kontrole w kilku kategoriach:
Śledzenie schematu: wykrywaj dodane, usunięte lub zmienione pola, zanim zawiodą czytający niżej.
Kontrole Timeliness: pilnuj, czy oczekiwane partycje lub ładowania docierają wtedy, gdy powinny.
Walidacja danych: potwierdzaj, że reguły biznesowe nadal obowiązują po transformacjach i przepisaniach.
Wykrywanie anomalii: zauważaj nietypowe przesunięcia w liczbie wierszy, wzorcach wartości pustych lub metrykach biznesowych.
Zespoły wdrażające praktyki obserwowalności danych wokół zbiorów jeziora wychwytują te problemy wcześniej, zwłaszcza gdy kontrole działają blisko danych, a nie dopiero po tym, jak raporty się popsują.
Poprawny format pliku nie równa się wiarygodnemu zbiorowi danych. Niezawodność bierze się z monitorowania zachowania, struktury i dostaw w czasie.
Jeśli tłumaczysz innym, czym jest plik Parquet, to właśnie ta dojrzała odpowiedź warta zapamiętania. Parquet to potężny format kolumnowy dla analityki. Jego row groups, column chunks, pages i metadane umożliwiają odczyty selektywne. Ale w skali korporacyjnej miarą sukcesu nie jest wyłącznie to, czy zapytania działają szybko. Jest nią to, czy zespoły mogą ufać danym, które te zapytania zwracają.
digna daje zespołom sposób na monitorowanie, we własnym środowisku, zachowania wokół zbiorów danych Parquet, w tym zmian schematu, Timeliness, anomalii i kontroli walidacyjnych w jeziorach, hurtowniach i potokach. Jeśli standaryzujesz się na Parquet i chcesz efektywności formatu bez martwych pól w obszarze niezawodności, odwiedź dignę.
Uruchamianie tych kontroli w sposób ciągły, zamiast wyrywkowego sprawdzania po awarii pulpitu, jest właśnie tym, do czego służy obserwowalność platformy danych.
Najczęściej zadawane pytania
Czym jest plik Parquet?
Apache Parquet to otwartoźródłowy, kolumnowy format plików zbudowany pod obciążenia analityczne. Każdy plik zaczyna się 4-bajtową liczbą magiczną PAR1, a kończy stopką zawierającą schemat, położenie row groups i statystyki kolumn, co pozwala silnikom zapytań pomijać dane, których nigdy nie muszą czytać.
Czym plik Parquet różni się od pliku CSV?
CSV przechowuje wartości wiersz po wierszu, więc silnik parsuje każde pole każdego wiersza, nawet gdy zapytanie dotyczy trzech kolumn. Parquet grupuje wartości każdej kolumny, dzięki czemu silniki czytają tylko to, o co poproszono. CSV pozostaje wygodniejszy na granicach wczytywania; Parquet zwraca się przy powtarzalnych zapytaniach analitycznych.
Czym są row groups, column chunks i pages w Parquet?
To trzy zagnieżdżone warstwy wewnątrz pliku. Row group to poziomy wycinek tabeli; wewnątrz niego wartości każdej kolumny leżą w column chunk; każdy chunk dzieli się na pages, jednostki, które Parquet faktycznie koduje i kompresuje. Rozmiar row group decyduje, ile zapytanie może pominąć.
Czy przewaga szybkości Parquet to tylko kompresja?
Kompresja to tylko jeden z trzech powodów. Kodowanie — słownikowe, run-length, delta — przebudowuje wartości, zanim zadziała jakikolwiek kodek, kompresja zmniejsza potem te zakodowane bajty w każdej kolumnie, a metadane stopki pozwalają silnikowi w ogóle nie otwierać nieistotnych row groups. Metadane zwykle oszczędzają więcej czasu niż bajty zaoszczędzone na dysku.
Jakie narzędzia potrafią czytać pliki Parquet?
Parquet jest wspierany przez Spark, Presto i Trino, przez Pandas za pośrednictwem narzędzi opartych na Arrow oraz przez większość silników bliskich hurtowni. Spark pasuje do dużych rozproszonych odczytów i zapisów, Presto i Trino opierają się na przycinaniu kolumn i predicate pushdown, a Pandas sprawdza się w analizie lokalnej. Śledź dryf schematu między producentami, bo niezgodne typy wychodzą później jako mylące wartości puste.



