Profilazione automatizzata dei dati per piattaforme affidabili
|
7
min di lettura

La dashboard si carica ancora. I job notturni sono terminati e nessuno ha segnalato errori. Poi un business analyst nota che una categoria di clienti familiare è quasi scomparsa dalla tabella sottostante. I vostri controlli sono verdi perché verificano se la pipeline è stata eseguita, non se i dati si comportano ancora come previsto.
Indice
Perché la profilazione manuale dei dati non regge su larga scala
Che cosa misura davvero la profilazione automatizzata dei dati
Avviare la profilazione automatizzata sulle tabelle critiche
Perché la profilazione manuale dei dati non regge su larga scala
Considerate il data warehouse di un ente previdenziale in cui gli ingegneri mantengono un'ampia raccolta di controlli scritti a mano. Alcuni validano i record delle prestazioni, altri verificano le date di consegna, altri ancora impongono ipotesi ereditate da sistemi dismessi. Si tratta di uno scenario operativo illustrativo, non di un caso cliente documentato.
Ogni controllo poteva avere senso quando è stato scritto. La difficoltà sta nel preservarne il significato mentre cambiano i sistemi sorgente, i requisiti di reporting e le responsabilità all'interno dei team.
Un ingegnere se ne va, ma il suo SQL resta. Arriva un nuovo feed e il team copia un set di regole esistente senza sapere quali ipotesi valgano. Gli analisti aggiungono controlli dopo ogni incidente, mentre i controlli obsoleti continuano a generare alert.
Coprire con regole non significa capire i dati
Un set di regole statico risponde a domande che qualcuno sapeva già porre. Non rivela necessariamente una categoria sconosciuta, una distribuzione cambiata o un campo il cui significato reale differisce dal nome.
I sintomi operativi sono riconoscibili:
Copertura parziale: Le tabelle importanti hanno controlli, ma questi coprono modalità di errore selezionate anziché il comportamento osservato della tabella.
Responsabilità poco chiara: Gli ingegneri trovano la regola, ma nessuno in grado di spiegarne lo scopo di business.
Alert fatigue: Chi esamina gli alert si imbatte ripetutamente in notifiche di scarso valore ed è sempre meno propenso ad approfondire la successiva.
Sono modi utili per inquadrare i problemi operativi dei dati: non come valori errati, ma come divari tra ciò che i team misurano e ciò di cui hanno bisogno gli utenti a valle.
Scoprire prima di prescrivere
La profilazione automatizzata dei dati parte da una domanda diversa: che cosa c'è davvero in questo dataset? Trasforma una tabella sconosciuta in un oggetto misurabile prima che analisti, strumenti statistici o modelli ne dipendano.
Questo non elimina le regole di business. Riduce però la quantità di SQL esplorativo che gli ingegneri devono scrivere prima di poter decidere quali regole siano giustificate.
Regola pratica: Mantenete i requisiti di business espliciti, ma non costringete gli ingegneri a prevedere ogni cambiamento osservabile prima che il monitoraggio possa iniziare.
Anche la scelta architetturale conta. Per i dati aziendali sensibili, il mio consiglio è di apprendere e mantenere queste misurazioni all'interno dell'ambiente del cliente. La scoperta non dovrebbe richiedere l'esportazione di record di produzione verso uno scanner ospitato.
Il risultato utile non è un inventario più ampio di controlli. È una baseline mantenuta nel tempo, un revisore responsabile ed evidenze che aiutano a distinguere un cambiamento significativo dalla variazione ordinaria.
Che cosa misura davvero la profilazione automatizzata dei dati
Partite da una tabella di warehouse sconosciuta. Potete leggerne lo schema, ma i tipi dichiarati non vi diranno se i campi sono popolati, se gli identificativi si ripetono o se i valori testuali seguono pattern coerenti.
L'articolo fondamentale Data Profiling Revisited, pubblicato nel 2013, descrive la profilazione come l'esame di caratteristiche dei dati quali tipi di colonna, conteggi dei valori null, conteggi dei valori distinti e pattern frequenti. Spiega inoltre come la profilazione supporti la verifica dei vincoli e la configurazione successiva di strumenti statistici o di data mining.
Apprendere la forma osservabile
Pensate a un profilo come alla planimetria di un edificio con il conteggio delle presenze. Descrive le stanze e dove si trovano le persone, ma non spiega perché siano entrate nell'edificio.
Allo stesso modo, un profilo può mostrare che una colonna di stato contiene valori sconosciuti. Non può stabilire se quei valori rappresentino una modifica di business approvata.

Un'ispezione iniziale dovrebbe stabilire:
Struttura: Quali colonne esistono e quali tipi di dati supportano i loro valori.
Popolamento: Dove mancano valori e quanti valori distinti compaiono.
Forma: Quali intervalli, formati ricorrenti e valori frequenti caratterizzano la tabella.
Queste misurazioni offrono agli ingegneri un punto di partenza per la scoperta. Un campo di testo simile a una data può meritare un'analisi più attenta; un identificativo cliente ripetuto di frequente può essere atteso nelle transazioni, ma sospetto in un'anagrafica clienti.
Conservare le evidenze, non solo un report
Le misurazioni fondamentali - completezza, unicità, conformità dei tipi, frequenza e distribuzione - valgono per database relazionali, warehouse, data lake e file analitici. La tecnologia di storage cambia il metodo di esecuzione, non le domande da porre.
Conservate il profilo risultante come riferimento per le osservazioni successive. Registrate la fonte e le condizioni in cui è stato prodotto, invece di conservare solo un grafico che nessuno potrà riprodurre in seguito.
Per i team che formalizzano questa tracciabilità, la guida di Fetchin alla provenienza dei dati è una risorsa complementare utile. La provenienza deve accompagnare l'output statistico, perché i revisori devono capire da dove provengono le evidenze.
Il limite pratico è importante: il comportamento osservato non è automaticamente un comportamento corretto. La profilazione fornisce evidenze per una decisione, non il permesso di trasformare ogni pattern comune in un requisito vincolante.
Tecniche di profilazione e metriche di qualità
Un profiler maturo deve fare più che contare i valori mancanti. In una valutazione sistematica di 13 strumenti di data quality, la profilazione di base era ampiamente supportata, mentre le funzionalità avanzate su dipendenze e più colonne comparivano solo in strumenti isolati, come descritto nella valutazione di Frontiers sugli strumenti di data quality.
Adattare le evidenze alla domanda
Organizzate la raccolta attorno a queste classi di evidenze:
Classe di evidenza | Calcoli utili e interpretazione |
|---|---|
Cardinalità di singole colonne | I conteggi di valori distinti e duplicati rivelano ripetizioni e possibile unicità. |
Distribuzioni dei valori | Quantili, istogrammi di frequenza e tassi di outlier descrivono concentrazione e dispersione. |
Tipi di dati e pattern | I tipi semantici dedotti e le regolarità di formato distinguono la rappresentazione di storage dal significato probabile. |
Domini | Gli insiemi di valori osservati suggeriscono valori ammessi candidati da sottoporre a revisione. |
Relazioni tra colonne e multicolonna | Chiavi candidate e dipendenze funzionali rivelano possibili vincoli di integrità. |
Includete esplicitamente i tassi di valori null e vuoti. Una stringa vuota e un null di database possono richiedere trattamenti diversi, quindi documentate ogni decisione di accorparli.

Bilanciare copertura e costo di scansione
Versionate le misurazioni per tabella, colonna, partizione e momento di osservazione. Altrimenti i revisori non potranno distinguere in modo affidabile uno spostamento persistente della distribuzione da un problema isolato di partizione.
Conteggi esatti dei valori distinti e test esaustivi delle dipendenze a coppie possono essere costosi su dataset di grandi dimensioni. Sketch approssimati, campioni stratificati e profili incrementali sono alternative ragionevoli, ma validate le approssimazioni rispetto a calcoli esatti sui dataset critici.
La scelta dovrebbe dipendere dalle conseguenze di un errore. La scoperta esplorativa tollera un'incertezza che un controllo di integrità regolamentare non può accettare.
La policy di gestione dei dati di Queensland Health include nel proprio perimetro di qualità accuratezza, validità, affidabilità, tempestività, pertinenza, completezza e unicità. Questa ampiezza è un utile correttivo nella scelta delle metriche di data quality: le statistiche facili da calcolare non dovrebbero definire l'intero programma.
Trasformare i risultati in controlli
Un dominio dedotto e approvato può diventare una regola di validazione. Una chiave candidata confermata può diventare un controllo di integrità, mentre una baseline di distribuzione può fornire input per l'anomaly detection.
La riconciliazione di business richiede comunque logica di dominio. Ad esempio, i team che abbinano i movimenti bancari alle registrazioni contabili tramite Charter AI affrontano un compito di abbinamento a livello di business, non un semplice conteggio di riferimenti di transazione distinti.
Mantenete chiara questa distinzione. La profilazione aiuta a capire che cosa meriti un controllo; i responsabili di business stabiliscono che cosa quel controllo debba significare.
Quando più profili creano più rumore
Raccogliere ogni statistica disponibile non migliora automaticamente le decisioni. Se nessuno sa spiegare quali deviazioni contino, gli ingegneri hanno automatizzato la produzione di notifiche anziché un monitoraggio affidabile.
Il comportamento normale può variare per giorno della settimana, fine mese, stagione, ciclo di rilascio o evento di business. Confrontare ogni caricamento con una media storica indifferenziata può far sembrare difettoso un cambiamento atteso.
Separare i dati mancanti da quelli errati
Il Data Quality Framework del governo britannico distingue la completezza dall'accuratezza. Un dataset può contenere tutti i record attesi e presentare comunque valori errati.
Misurate separatamente la presenza delle righe, i valori mancanti a livello di campo e la correttezza dei valori. Se una consegna non è terminata, un apparente problema di completezza può richiedere un'indagine sulla pipeline anziché una correzione dei record.
La variazione di una metrica è un'osservazione. Chiamarla difetto richiede contesto.
I risultati del 2025 raccolti in State of Enterprise Data and AI di Atlan illustrano questo problema di contesto: il 97% delle organizzazioni ha segnalato lacune su definizioni, qualità e fiducia, mentre il 52% ha citato timori legati alla sicurezza e all'accesso ai dati sensibili. La stessa fonte riporta che i dirigenti hanno valutato la maturità dei dati della propria organizzazione il 12% più alta rispetto ai professionisti operativi, mentre quasi il 90% dei professionisti dei dati faticava con scalabilità e complessità.
Questi risultati suggeriscono un atteggiamento operativo prudente: non date per scontato che misurazioni aggiuntive risolvano i disaccordi su significato o maturità.

Inserire tempo e impatto nel triage
Usate baseline sensibili al tempo e soglie adattive dove il comportamento atteso varia. Esaminate esplicitamente i falsi positivi, registrando se un alert ha portato a un difetto confermato, a una modifica di business accettata o a un'indagine con evidenze insufficienti.
La modellazione dell'arrivo previsto aiuta a distinguere finestre di osservazione incomplete da caricamenti completati. Un triage basato sulla lineage dovrebbe collegare la deviazione a ritardi di consegna, modifiche di schema e ai report o modelli a valle a rischio.
Presentate queste relazioni nelle dashboard di data quality, invece di mostrare un indicatore rosso senza spiegazione. Un revisore dovrebbe vedere che cosa è cambiato, chi ne è responsabile e quale azione è possibile.
Essere pronti per l'AI richiede più della normalità statistica. Senza definizioni semantiche, responsabilità e un percorso di correzione, un profilo tecnicamente dettagliato non garantisce dati di training od operativi affidabili.
Come scegliere la profilazione in-database
Per i carichi di lavoro aziendali sensibili, rendete l'esecuzione controllata dal cliente un requisito di progettazione. Decidete dove girano le query, quale identità le esegue e quali evidenze possono uscire, prima di confrontare le funzionalità dell'interfaccia.
Un sondaggio del 2025 sull'AI in azienda riportato da CIO Dive ha coinvolto 1.050 business leader e ha individuato vincoli di privacy e compliance, duplicati e integrazione inefficiente tra i principali problemi dei dati. Meno della metà riteneva raggiungibili i propri obiettivi di AI.
Dove dovrebbe girare la profilazione automatizzata
Domanda decisionale | In-database nell'ambiente del cliente | Scansione ospitata esternamente |
|---|---|---|
Dove vengono esaminati i valori? | All'interno del perimetro controllato del database. | Nell'ambiente di scansione ospitato, se i record vengono trasferiti lì. |
Che cosa può uscire? | Definire una policy esplicita per metriche calcolate e metadati. | Valutare record esportati, campioni conservati e metadati derivati. |
Quali permessi di accesso si applicano? | Usare un'identità di esecuzione dedicata con privilegi minimi. | Verificare i permessi del connettore e il modello di accesso del servizio ospitato. |
Come si gestisce il carico? | Pianificare le query in base alla capacità del database. | Considerare il carico di estrazione, il trasferimento e l'elaborazione esterna. |
Che cosa va sottoposto ad audit? | Esecuzione nel database e decisioni di profilazione. | Estrazione, accesso esterno, conservazione e decisioni di profilazione. |
Un control plane ospitato non è necessariamente uno scanner ospitato. Chiedete esplicitamente dove vengono elaborati i record, invece di affidarvi a un'etichetta di deployment.
Testare la vista autorizzata
Il lavoro può restare all'interno dell'ambiente di una banca, di un ospedale, di un operatore telco o di un ente pubblico? Quali metadati possono uscire e chi approva questa decisione?
Testate separatamente input cifrati, mascherati, tokenizzati e autorizzati a livello di riga. Una policy di tokenizzazione modificata o una vista di righe ristretta non deve essere classificata erroneamente come difetto dei dati sorgente; il profiler può descrivere solo la rappresentazione che la sua identità è autorizzata a osservare.
Richiedete evidenze di audit su ambito, identità, timestamp, versione della regola, decisione di accesso e storico delle correzioni. L'esecuzione in-database non elimina la necessità di controlli di accesso né di gestione delle risorse.
Un'opzione all'interno del vostro ambiente
L'elaborazione in-database di digna è un'opzione per questo modello di esecuzione. Controlli e calcolo delle metriche restano nel database del cliente, il deployment avviene in private cloud oppure on-premises e il fornitore non accede ai dati di produzione.
I suoi moduli coprono baseline di anomalie apprese senza costruire a mano ogni controllo, trend storici delle metriche, tempi di consegna attesi, validazione a livello di record e colonne aggiunte, rimosse o con tipo modificato. Il modulo iniziale include una dashboard condivisa, scheduler, catalogo, integrazioni e funzioni di collaborazione.
Il modello commerciale prevede una quota base più un costo per tabella attiva per modulo, senza tariffe per chiamate API, scansioni o volume di alert. Il fornitore indica i primi insight disponibili in meno di due ore; consideratela una promessa di onboarding da verificare in fase di valutazione rispetto alla vostra connettività, ai permessi e al carico di lavoro.
Workflow aziendali per profilazione e monitoraggio
Iniziate da un profilo di riferimento, non da un editor di regole vuoto. In uno studio peer-reviewed del 2022 sul monitoraggio tramite profili di riferimento, i ricercatori hanno implementato DQ-MeeRKat e lo hanno valutato su sei flussi di dati reali provenienti da dispositivi telematici.
Il metodo apprendeva automaticamente insiemi di statistiche di profilazione per modellare la qualità target. Supportava l'inizializzazione tramite monitoraggio continuo, senza richiedere agli esperti di dominio di scrivere in anticipo ogni regola.
Indirizzare ogni osservazione alla revisione giusta
Inizializzate il riferimento, chiedete a un esperto di dominio di valutarne l'adeguatezza e confrontate i caricamenti in arrivo con la versione approvata. Mantenete collegati il confronto e la risposta operativa.
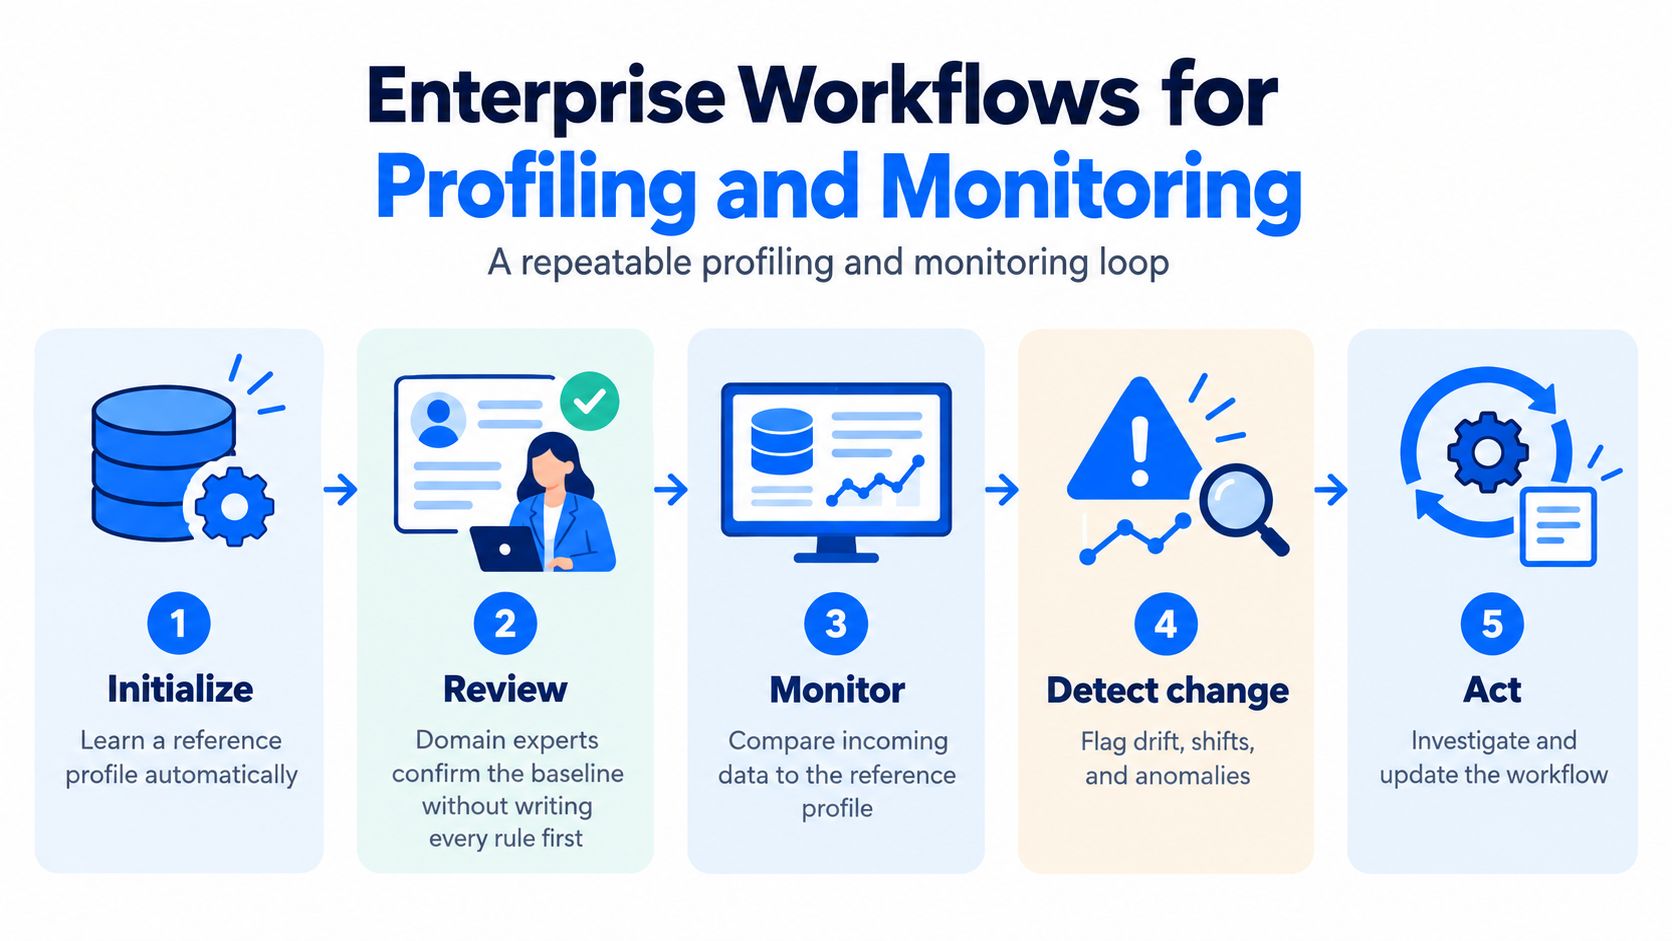
Usate passaggi di consegna distinti invece di inviare ogni osservazione alla stessa coda:
Deviazione della distribuzione: Assegnate una revisione delle anomalie per stabilire se è cambiato il business o se la pipeline ha introdotto un difetto.
Consegna mancante o anticipata: Indirizzate a una revisione della tempestività con il tempo di consegna atteso e l'evidenza dell'arrivo effettivo.
Sospetta violazione di una regola di business: Eseguite una validazione a livello di record per identificare i record interessati.
Colonne aggiunte, rimosse o con tipo modificato: Aprite una revisione dello schema prima che proseguano le trasformazioni dipendenti.
I requisiti di settore determinano l'escalation. Nei servizi finanziari date priorità ai feed di rischio e regolamentari rispetto al reporting; in sanità distinguete le esigenze di consegna cliniche da quelle operative.
I team telco dovrebbero collegare le deviazioni nei dati clienti ad alto volume ai ritardi della pipeline. I team del settore pubblico dovrebbero preservare decisioni tracciabili ed evidenze pronte per l'audit.
Mantenere visibile l'incertezza
I valori mancanti possono produrre false dipendenze funzionali. Una ricerca sulla scoperta automatizzata di schemi e dipendenze riporta inoltre una valutazione in cui gli schemi generati esatti e completi sono passati dal 60% al 72% quando il sistema restituiva i primi cinque candidati anziché un unico risultato.
Ciò supporta ipotesi ordinate, punteggi di confidenza e approvazione umana, non l'accettazione automatica della prima risposta che compare. I revisori devono vedere alternative plausibili quando nomi, tipi, chiavi o relazioni sono incerti.
Confine di approvazione: Lasciate che sia l'automazione a proporre l'interpretazione. Fate approvare i vincoli rilevanti a una persona responsabile.
Una piattaforma integrata può ospitare questo flusso senza diventare proprietaria del significato di business. Definite responsabilità di monitoraggio e reporting in modo che gli ingegneri gestiscano l'esecuzione, i responsabili di dominio valutino il significato e i revisori della governance possano ricostruire le decisioni.
Chiudete un incidente solo quando qualcuno ha registrato causa, azione e decisione sulla baseline. Una modifica di business accettata può giustificare l'aggiornamento del riferimento; un difetto della pipeline non dovrebbe essere assorbito nel comportamento normale.
Avviare la profilazione automatizzata sulle tabelle critiche
Scegliete una tabella critica il cui malfunzionamento comprometterebbe un report, un modello o un output regolamentare. Preferite una tabella con un responsabile di business identificabile e un ingegnere che ne conosca il percorso di consegna.
Mettete per iscritto la decisione che supporta e che cosa significherebbe un malfunzionamento. In questo modo i revisori hanno una base concreta per dare priorità ai risultati, invece di trattare ogni deviazione come ugualmente urgente.
Definire il primo perimetro operativo
Profilate la tabella sul posto e conservate le evidenze necessarie a ripetere l'ispezione. Tenete insieme snapshot, query sorgente o policy di campionamento, versione dell'algoritmo, livello di confidenza e decisione di approvazione.
Non portate direttamente in produzione una chiave, un tipo o una dipendenza a bassa confidenza. Chiedete al responsabile di spiegare se il vincolo proposto riflette un requisito o semplicemente un pattern del campione osservato.

Rendere la revisione ripetibile
Date al progetto pilota un accordo operativo snello ed esplicito:
Nominate i revisori: Assegnate il data engineer e il responsabile di business prima di attivare le notifiche.
Definite la risposta: Stabilite chi indaga su un'osservazione e chi può approvare una modifica della baseline.
Proteggete l'uso a valle: Decidete quali modifiche di schema richiedono una revisione prima che i job dipendenti utilizzino la tabella.
Conservate l'esito: Registrate se l'incidente era un problema di consegna, dati difettosi o una modifica accettata.
Confrontate ogni nuovo caricamento con il riferimento approvato. Distinguete l'arrivo in ritardo da un reale cambiamento della distribuzione e indagate sulle modifiche strutturali prima di considerarle innocue.
Esaminate insieme il primo incidente spiegabile. L'ingegnere dovrebbe poter mostrare che cosa è successo nella pipeline, e il responsabile di business descrivere la conseguenza per il processo che utilizza i dati.
Estendete la copertura modulo per modulo solo quando questo ciclo funziona. Una copertura maggiore è utile quando il team può indagare e agire, non solo quando può generare più osservazioni.
Per un rollout circoscritto, installate la piattaforma nel cloud, nella VPC o nel data center esistente, ispezionate la tabella selezionata ed esaminate anomalie, tempestività e stato dello schema nella dashboard condivisa. Mantenete questa revisione abbastanza ristretta da permettere al team di prendere e documentare una decisione.
digna offre per questo modello operativo apprendimento delle baseline all'interno del vostro ambiente, monitoraggio delle anomalie, controlli di tempestività, validazione dei record e tracciamento dello schema. Visitate digna per valutare la piattaforma su una tabella critica, poi esaminate i primi risultati con il vostro data engineer e il responsabile di business prima di estendere la copertura.
Una volta creato un profilo di riferimento, il passo successivo è mantenerlo aggiornato senza scrivere una regola per ogni colonna: il modulo Data Anomalies di digna apprende i volumi, le distribuzioni e i tassi di null normali di ogni tabella e segnala le deviazioni man mano che arrivano nuovi caricamenti, così la baseline diventa rilevamento continuo anziché un report una tantum.
Domande frequenti
Che cos'è la profilazione automatizzata dei dati?
La profilazione automatizzata dei dati misura in modo sistematico ciò che un dataset contiene davvero - tipi di colonna, valori null, valori distinti, pattern frequenti, intervalli e distribuzioni - prima che analisti o modelli ne dipendano. Il risultato è una baseline archiviata con cui confrontare i caricamenti successivi, non un report una tantum impossibile da riprodurre.
Perché le regole di data quality scritte a mano smettono di funzionare su larga scala?
Le regole statiche rispondono solo alle domande che qualcuno ha già pensato di porre. Quando cambiano fonti, report e responsabili, emergono copertura parziale, SQL che nessuno sa più spiegare dopo l'uscita dell'autore e alert fatigue causata da controlli obsoleti, mentre categorie nuove o distribuzioni spostate passano inosservate.
Quali metriche dovrebbe includere un profilo dei dati?
Un profilo utile copre completezza, unicità, conformità dei tipi, frequenza e distribuzione, oltre a tassi espliciti di valori null e vuoti, perché una stringa vuota e un null di database possono richiedere trattamenti diversi. I profiler maturi aggiungono domini, chiavi candidate e dipendenze funzionali, versionati per tabella, colonna, partizione e momento di osservazione.
Come si riducono i falsi allarmi della profilazione dei dati?
Usate baseline sensibili al tempo e soglie adattive, perché il comportamento normale varia per giorno della settimana, fine mese, stagione o ciclo di rilascio. Separate i dati mancanti da quelli errati, modellate l'arrivo previsto e registrate se ogni alert ha portato a un difetto confermato, a una modifica accettata o a un'indagine senza esito.
La profilazione dei dati deve girare nel database o in uno scanner ospitato?
Per i dati aziendali sensibili, la profilazione in-database nell'ambiente del cliente è la scelta più sicura. I valori restano entro il perimetro controllato, un'identità con privilegi minimi esegue le query e escono solo metriche calcolate secondo una policy esplicita; con uno scanner esterno occorre valutare record esportati, campioni conservati e permessi del connettore.


