Observability vs monitoring: una guida pratica alla scelta
|
7
min di lettura

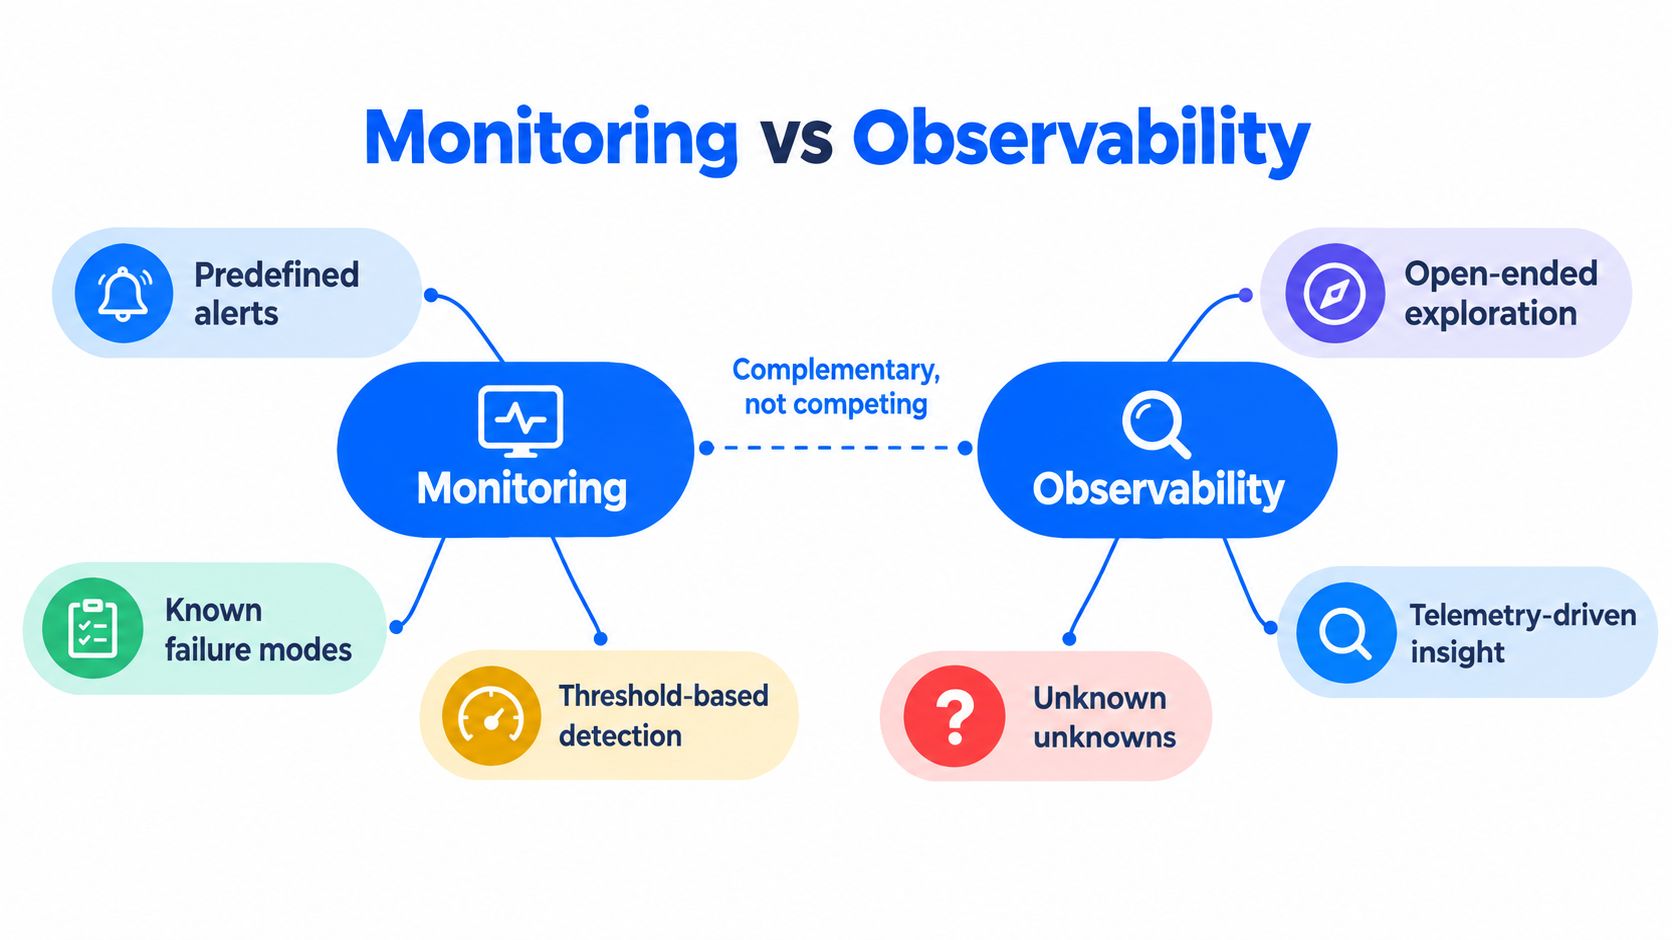
Il cattivo consiglio in questo dibattito è semplice: scegliete l'observability e mandate in pensione il monitoring. Sembra moderno, ma per i team dati reali è sbagliato. Il monitoring è il vostro livello di controllo, l'observability il vostro livello diagnostico, e la risposta giusta dipende da quanto costa sbagliare per ciascun carico di lavoro.
Punto decisionale | Monitoring | Observability |
|---|---|---|
Compito principale | Rilevare stati di errore noti | Spiegare guasti sconosciuti o multifattoriali |
Evidenze migliori | Soglie, alert, segnali stabili | Metriche, log, trace e contesto correlati |
Verificabilità | Alta quando i controlli sono espliciti | Più debole se sostituisce i controlli espliciti |
Profilo di costo | Più basso e più mirato | Più alto e più ampio |
Ideale per | Modi di guasto stabili e ben compresi | Guasti complessi, distribuiti o con ampio raggio d'impatto |
Indice
Perché il dibattito observability vs monitoring manca la vera domanda
Dove il rilevamento anomalie con AI e lo schema tracking ripagano davvero
Frammentazione degli strumenti e i veri ostacoli a una copertura unificata
Perché il dibattito observability vs monitoring manca la vera domanda
Di solito la discussione viene impostata come una corsa di cavalli, come se una disciplina dovesse sostituire l'altra. È un'impostazione superficiale. Monitoring e observability risolvono problemi diversi, e la sostituzione sbagliata crea punti ciechi invece di chiarezza.
Il monitoring è controllo esplicito. Definite il segnale, fissate il limite e ricevete un alert quando la realtà lo supera. L'observability è più ampia, perché consiste nel rendere lo stato interno deducibile dai dati emessi, così che gli ingegneri possano spiegare guasti mai visti e non solo confermare quelli previsti. La domanda pratica non è quale termine suoni più attuale, ma quale livello di profondità diagnostica giustifichi il carico di lavoro.
Questo conta perché sostituire i monitor con un'observability generica può indebolire la governance. Se rendete i controlli impliciti, li rendete più difficili da sottoporre ad audit. Per una piattaforma dati è uno scambio svantaggioso. Un caricamento mancante, uno schema rotto o una deriva dei KPI non hanno bisogno di eleganza filosofica: servono un responsabile esplicito, un alert e una traccia delle evidenze.
Regola pratica: mantenete monitor espliciti per i modi di guasto noti, poi aggiungete observability solo dove vi servono analisi della causa radice, correlazione o diagnosi esplorativa.
Il libro Site Reliability Engineering di Google ha formalizzato i quattro golden signal per i servizi rivolti agli utenti: latenza, traffico, errori e saturazione. Questa base regge ancora, perché offre ai team un livello di monitoring compatto per i problemi noti. Ma le piattaforme dati hanno bisogno di più della salute dei servizi. Servono anche freschezza, stabilità dello schema, validità dei record, andamento delle metriche di business e consumo dei carichi di lavoro.
Se state decidendo dove investire, smettete di chiedervi se l'observability sia migliore del monitoring. Chiedetevi quali evidenze vi servono quando un dataset, una pipeline o un report va storto, e quanto costa arrivare tardi, essere vaghi o sbagliare.
Cosa significano davvero monitoring e observability
Il monitoring è una funzione di rilevamento predefinita. I team scelgono indicatori come tasso di richieste, tasso di errore, latenza, utilizzo della CPU o stato di arrivo dei dati, poi ricevono un alert quando i valori superano una soglia o escono da un intervallo atteso. Risponde a una domanda circoscritta ma essenziale: una condizione nota è fuori dal suo limite?
L'observability è più ampia. Si chiede se potete dedurre lo stato interno di un sistema dai dati che emette. In pratica significa correlare metriche, log e trace, così che gli ingegneri possano indagare un guasto che non avevano previsto quando hanno scritto l'alert.
La base da cui dovrebbe partire la maggior parte dei team
La classica vista a livello di servizio conta ancora. Il modello SRE di Google vi offre una base minima di monitoring con latenza, traffico, errori e saturazione. Questi segnali sono utili perché impongono disciplina. Un alert di latenza dice che il servizio è lento, il traffico vi dice che la domanda è cambiata, gli errori vi dicono che le richieste sono fallite e la saturazione vi dice che una risorsa limitata è vicina al pieno utilizzo. Non serve altra teoria.
Per le piattaforme dati la corrispondenza è diretta, ma non identica. Sostituite la latenza del servizio con la freschezza e la puntualità di consegna. Sostituite il traffico con i modelli di carico e di consumo. Sostituite gli errori con job falliti, record non validi o trasformazioni rotte. Sostituite la saturazione con la pressione su data warehouse, cluster o pipeline.
Il monitoring vi dice che qualcosa ha superato una linea. L'observability vi aiuta a spiegare cosa è cambiato, dove è cambiato e cos'altro ha toccato.
Questa distinzione spiega perché i team dati si scottano quando considerano una dashboard verde come prova di correttezza. Una dashboard può essere disponibile ed essere comunque sbagliata dal punto di vista analitico, perché i dati sono obsoleti, incompleti, duplicati o modificati nella struttura. Se il vostro business dipende da quell'output, vi servono sia il controllo sia le evidenze.
Per un punto di partenza pratico, consultate l'approccio di digna alla data observability.
Obiettivi, telemetria e rilevamento rispetto a diagnosi
Il modo più pulito per separare queste discipline è confrontare a cosa servono, quali evidenze usano e fin dove vi portano. Il monitoring riguarda gli obiettivi di controllo. L'observability riguarda la diagnosi. Uno è costruito per limiti noti, l'altra per indagare in condizioni di incertezza.
Matrice decisionale
Criterio | Monitoring | Observability |
|---|---|---|
Obiettivo di controllo | Far rispettare limiti noti e aspettative di servizio | Spiegare il comportamento interno e i pattern di guasto emergenti |
Trigger tipico | Superamento di soglia, job mancante, regola fallita, consegna in ritardo | Correlazione insolita, cambio di comportamento, anomalia inspiegata |
Focus della telemetria | Metriche aggregate e alert | Metriche, log, trace correlati e contesto più ricco |
Domanda a cui risponde | Cosa è successo, e ha superato la tolleranza? | Cosa è cambiato, perché è cambiato e cos'altro potrebbe essere coinvolto? |
Modello di responsabilità | Responsabile operativo chiaro per i controlli noti | Diagnosi trasversale tra team di piattaforma, dati e applicazioni |
Traccia di audit | Solida quando i controlli sono espliciti | Più solida per le indagini che come evidenza formale di controllo |
Profilo di costo | Di solito più mirato ed economico da gestire | Più ampio, più costoso e più facile da sovradimensionare |
La suddivisione di base di OpenTelemetry è utile in questo caso. Le metriche sono misurazioni a runtime, i log sono registrazioni di eventi e le trace sono i percorsi delle richieste attraverso i servizi. Il punto centrale è la correlazione. Una metrica vi dice che la latenza è aumentata, una trace mostra quale percorso ha rallentato e i log spiegano l'evento che l'ha causato. Il materiale di IBM sull'observability lo dice in parole semplici: le metriche generano alert, le trace mostrano i percorsi di esecuzione e i log forniscono il contesto per la risoluzione.
Per i team dati questo significa che la telemetria non si sceglie seguendo la moda. La si sceglie in base al valore diagnostico. Se il problema è un job batch fallito, un monitor può bastare. Se un modello, un report o un workflow del cliente a valle è sbagliato, vi serve il contesto aggiuntivo per collegare il sintomo alla causa.
Le evidenze giuste per il compito giusto
Monitoring per i controlli: usatelo dove il modo di guasto è noto, il limite è stabile e le evidenze devono essere esplicite.
Observability per la diagnosi: usatela dove la causa è incerta, il grafo delle dipendenze è disordinato o potrebbero essere coinvolti più sistemi.
Entrambi insieme: usateli entrambi quando il costo di un errore è alto e il guasto potrebbe essere silenzioso.
Se cercate un'impostazione più operativa, partite dalle best practice di observability per i team dati. L'obiettivo non è raccogliere tutto. L'obiettivo è raccogliere abbastanza evidenze da rendere difendibile la decisione successiva.
Scenari di rilevamento in una piattaforma dati
Le definizioni astratte non smuovono i team. Gli incidenti sì. Il modo più semplice per distinguere il monitoring dall'observability è metterli alla prova con i guasti che le piattaforme dati producono.
Caricamento notturno fallito e consegna in ritardo
Un job batch fallito è il caso più semplice. Il monitoring dovrebbe intercettare l'esecuzione interrotta, la tabella mancante o l'arrivo in ritardo. L'alert dovrebbe essere diretto e azionabile. L'observability aggiunge valore solo se il guasto non è evidente, per esempio quando il job è terminato ma una dipendenza si è bloccata, una partizione non è arrivata o i dati sono arrivati dopo la chiusura della finestra di business.
È qui che conta il monitoraggio della puntualità. Se un feed regolamentare, un'estrazione finanziaria o uno snapshot operativo ha una scadenza, l'alert dovrebbe dire che i dati sono in ritardo. Il livello di observability dovrebbe mostrare se la sorgente ha tardato, se il trasferimento è rimasto indietro o se un passaggio a valle ha trattenuto il record.
Modifica silenziosa dello schema e rotture a valle
Un evento di schema drift è esattamente il caso in cui il monitoring da solo è debole. La pipeline può continuare a girare, ma il data contract è rotto. Il monitoring può intercettare una colonna mancante, un parsing fallito o la violazione di una regola, se avete già scritto il controllo. L'observability ha bisogno del contesto dello schema, della lineage e dei consumatori coinvolti, così da vedere cosa è cambiato e quale report o modello non è più affidabile.
Calo dei KPI e impatto sul business
Un calo nel reporting dei ricavi è un problema diverso. I dati possono essere ancora tecnicamente validi, ma il risultato di business si è spostato. Il monitoring può segnalare la deviazione del KPI se lo monitorate esplicitamente. L'observability è utile quando dovete collegare quel cambiamento a volumi, stagionalità, comportamento a monte o a uno spostamento del carico nei sistemi sorgente.
Esecuzione e analisi in-database
Il percorso diagnostico migliore spesso termina nel data warehouse o nel data lake stesso. Se calcolate i controlli in loco, riducete gli spostamenti e tenete le evidenze vicino ai dati. Per gli ambienti sensibili è una soluzione migliore che spargere copie dei record tra strumenti aggiuntivi.

Se lavorate con dataset ricchi di anomalie, i tipi di rilevamento delle anomalie sono la domanda successiva giusta. Ma non complicate troppo le tabelle di riferimento statiche o i feed di compliance append-only. Questi carichi di lavoro di solito hanno bisogno prima di un monitoring solido, non di esplorazioni sofisticate.
Stack di telemetria e quanto costano davvero
Gli strumenti sono il luogo in cui le buone intenzioni vanno a morire. I team di solito pensano di acquistare visibilità, poi scoprono di aver acquistato lavoro di configurazione, attrito di integrazione e un'altra coda di alert.
Il vero costo è l'attrito operativo
Nel sondaggio 2025 di Grafana Labs su 1.255 intervistati, la complessità era la principale preoccupazione legata all'observability, l'alert fatigue era il più grande ostacolo a una risposta più rapida agli incidenti e la spesa per l'observability era in media il 17% della spesa totale per l'infrastruttura di calcolo. Questo vi dice due cose. Primo, l'observability non è gratuita. Secondo, più telemetria non significa automaticamente una diagnosi più rapida. Può significare semplicemente più lavoro.
Gli standard aperti aiutano, ma non eliminano il carico. OpenTelemetry e gli stack di classe Prometheus rendono più facile spostare i dati e mantenere portabile la strumentazione. Non riducono magicamente il rumore degli alert, la configurazione delle pipeline di dati o il coordinamento necessario per trasformare i segnali in azioni.
Scegliete lo stack in base al valore delle evidenze
Tipo di stack | Uso ideale | Principale compromesso |
|---|---|---|
Monitoring basato sulle metriche | Servizi stabili, SLO noti, alert espliciti | Minore profondità diagnostica |
Metriche più log più trace | Sistemi distribuiti e indagini in più passaggi | Maggiore impegno di configurazione e correlazione |
Esecuzione in-database | Dati sensibili, carichi incentrati sul data warehouse, meno spostamento di dati | Meno flessibilità se vincolate troppo il modello |
Un approccio in-database cambia l'economia. Mantiene i dati dove sono, riduce gli spostamenti e si adatta agli ambienti in cui la governance conta quanto la velocità. Spesso è la risposta giusta per le piattaforme dati enterprise, perché la telemetria dovrebbe vivere vicino ai dati che descrive. Se dovete copiare mezzo data warehouse solo per misurarlo, probabilmente state facendo troppo.

Se volete una sola raccomandazione pratica, usate lo stack più economico che produca ancora una diagnosi difendibile per quel carico di lavoro. Tutto il resto è decorazione.
Dove il rilevamento anomalie con AI e lo schema tracking ripagano davvero
Il rilevamento anomalie con AI è utile quando le soglie statiche falliscono. Se un dataset presenta ricavi volatili, comportamenti dei consumatori irregolari, rumore dei sensori o eventi generati da macchine, i limiti fissi diventano strumenti grossolani. L'apprendimento di una baseline e il confronto continuo possono individuare deviazioni significative senza costringere i team a calibrare a mano ogni regola.
Usate il rilevamento statistico dove il comportamento cambia
È qui che il rilevamento anomalie basato su AI ripaga davvero. Aiuta quando la forma dei dati cambia nel tempo e il segnale conta più del numero esatto. Una soglia può dirvi che qualcosa è alto. Una baseline può dirvi che qualcosa è insolito.
È poco adatto a tabelle di riferimento statiche, chiavi deterministiche e feed di compliance append-only. Questi carichi di lavoro non hanno bisogno di ingegnosità. Hanno bisogno di controlli affidabili e di responsabilità chiare.
Adattate il controllo al dataset
Freschezza e puntualità: usate il monitoring degli arrivi dove al business interessa quando arrivano i dati, non solo se arrivano.
Schema tracking: usatelo ovunque i consumatori a valle dipendano da una struttura stabile.
Validazione dei record: usatela per far rispettare le regole di business, soprattutto dove contano le evidenze di audit.
Esecuzione in-database: usatela quando il vincolo è la sicurezza, la governance o lo spostamento dei dati.
L'errore pratico è trattare ogni dataset come se fosse ugualmente dinamico. Non lo è. Una tabella dimensionale a variazione lenta non merita lo stesso conto di observability di un feed transazionale ad alto volume o di un flusso di ricavi volatile.
Terrei anche lo schema tracking mentalmente separato dal rilevamento delle anomalie. Lo schema drift è strutturale. Il rilevamento delle anomalie è comportamentale. In un patrimonio dati serio vi servono entrambi, ma risolvono problemi diversi e non andrebbero giustificati con lo stesso argomento.
Se state decidendo dove investire, come l'AI rileva le anomalie nei dati delle pipeline è la prospettiva giusta. Usate l'intelligenza dove la variabilità è reale, non dove una regola fa il lavoro in modo pulito.
Frammentazione degli strumenti e i veri ostacoli a una copertura unificata
Se l'observability fosse solo un aggiornamento degli strumenti, la copertura unificata sarebbe già la norma. Non lo è. Un sondaggio CNCF 2026 su 407 professionisti ha rilevato che il 46,7% delle organizzazioni utilizzava due o tre strumenti di observability in parallelo, mentre solo il 7,4% era arrivato a un'unica esperienza di observability unificata. La configurazione di dashboard e alert era la principale difficoltà di setup, con il 54%.

Questo è il punto. La parte difficile non è acquistare un'altra piattaforma. È integrare la telemetria in un workflow che produca diagnosi azionabili invece di altre schede aperte. La complessità di integrazione e la configurazione delle pipeline di dati rallentano i team, perché ogni segnale in più crea lavoro per ingegneri, operatori e analisti.
Regola operativa: strumentate il minor numero di dataset al livello più profondo e lasciate gli altri sotto monitoring esplicito. Una copertura indiscriminata di solito crea solo alert fatigue e responsabilità deboli.
È anche per questo che la maturità dell'observability è un problema di workflow prima ancora che di strumenti. Se nessuno è responsabile del monitor, l'alert diventa rumore. Se nessuno sa spiegare il segnale, i dati diventano decorativi. Adattate la profondità della copertura alla criticità, non all'ottimismo.
Per un percorso di implementazione pratico, gli strumenti di data observability di digna si adattano al modello della profondità selettiva. Lo stack giusto è quello che il vostro team è in grado di gestire.
Un modello operativo ibrido e le implicazioni per settore
Il modello difendibile è ibrido. Il monitoring gestisce gli obiettivi di controllo, le evidenze di audit e le aspettative stabili sui livelli di servizio. L'observability gestisce la diagnosi esplorativa, la definizione delle baseline e i guasti emergenti. Non è un compromesso, è disciplina.
Questo conta soprattutto negli ambienti regolamentati o con ampio raggio d'impatto. Nei servizi finanziari servono controlli espliciti sui dati finanziari, di rischio, regolamentari e transazionali, perché le evidenze devono reggere davanti ad auditor e team operativi. Nella sanità contano affidabilità e tracciabilità, perché i dati clinici e operativi non possono derivare senza che nessuno se ne accorga. Nelle telecomunicazioni i comportamenti ad alto volume cambiano rapidamente, quindi servono un monitoring solido e abbastanza observability per spiegare picchi, problemi di consegna e consumi della piattaforma. Nel settore pubblico, evidenze pronte per l'audit e coerenza contano più di una copertura appariscente.
Una semplice policy operativa
Monitorate ciò che non deve fallire senza preavviso. Usate controlli espliciti per caricamenti mancanti, dati obsoleti, modifiche dello schema e violazioni delle regole di business.
Osservate ciò che non potete prevedere. Aggiungete telemetria più profonda dove il percorso del guasto è ambiguo, distribuito o costoso da districare.
Rivalutate ogni carico di lavoro. Se i dati cambiano più in fretta delle vostre soglie, spostate una parte maggiore di quel carico di lavoro verso l'observability.
L'errore peggiore è dare per scontato che una disciplina sia la versione matura dell'altra. Sono partner con compiti diversi. Il monitoring tiene accese le luci. L'observability spiega perché le luci hanno tremolato.
Per i team dati enterprise, questa è l'intera decisione. Assegnate ogni carico di lavoro alla disciplina adatta al suo costo di guasto, al suo onere di compliance e alla maturità della sua telemetria, poi rivedete la suddivisione man mano che il vostro stack evolve. Se cercate una piattaforma costruita esattamente su questa logica, visitate digna e scoprite come gestisce anomalie nei dati, puntualità, modifiche dello schema, validazione ed esecuzione in-database all'interno del vostro ambiente.
Gestire questa suddivisione ibrida è più semplice quando i controlli espliciti e le evidenze diagnostiche si trovano nello stesso luogo dei dati. La data platform observability di digna esegue rilevamento delle anomalie, validazione, controllo della puntualità e schema tracking all'interno del vostro database, così ogni carico di lavoro ottiene la profondità di cui ha bisogno senza copiare i record nell'ennesimo strumento.
Domande frequenti
Qual è la differenza tra observability e monitoring?
Il monitoring rileva stati di errore noti tramite soglie e alert predefiniti, mentre l'observability spiega guasti sconosciuti o multifattoriali correlando metriche, log e trace. Il monitoring è il livello di controllo, l'observability il livello diagnostico: per questo la maggior parte dei team dati ha bisogno di entrambi, senza che uno sostituisca l'altro.
L'observability deve sostituire il monitoring?
No. Sostituire monitor espliciti con un'observability generica rende i controlli impliciti e più difficili da sottoporre ad audit, uno scambio svantaggioso per una piattaforma dati. Mantenete monitor espliciti per i modi di guasto noti, come caricamenti mancanti, schemi rotti e deriva dei KPI, e aggiungete observability solo dove vi serve analizzare la causa radice.
Quali sono i quattro golden signal del monitoring?
Il libro Site Reliability Engineering di Google li indica come latenza, traffico, errori e saturazione. Su una piattaforma dati corrispondono a freschezza e puntualità di consegna, modelli di carico e consumo, job falliti o record non validi, e pressione su data warehouse, cluster o pipeline, a cui si aggiungono stabilità dello schema e andamento delle metriche di business.
Quanto costa l'observability rispetto al monitoring?
L'observability è più ampia e sensibilmente più costosa. Nel sondaggio 2025 di Grafana Labs su 1.255 intervistati, la spesa per l'observability era in media il 17% della spesa totale per l'infrastruttura di calcolo, e la complessità era la preoccupazione principale. Il monitoring è più mirato ed economico, quindi conviene lo stack più economico che offra ancora una diagnosi difendibile.
Quando usare il rilevamento anomalie con AI invece di soglie fisse?
Il rilevamento anomalie con AI conviene quando il comportamento dei dati si muove, ad esempio con ricavi volatili, consumi irregolari, rumore dei sensori o eventi generati da macchine, dove i limiti fissi diventano strumenti grossolani. È poco adatto a tabelle di riferimento statiche, chiavi deterministiche e feed di compliance append-only, che richiedono controlli basati su regole e responsabilità chiare.


