Gestione della qualità dei dati: che cos'è e come funziona
|
6
min di lettura

Ogni azienda funziona grazie ai dati, ma non ogni azienda può fidarsi dei propri dati. Una dashboard mostra numeri che non corrispondono al report del reparto finance. Un modello di machine learning si degrada perché i dati di input sono andati alla deriva il mese scorso. Nessuno se ne accorge finché un cliente non si lamenta o un auditor non pone una domanda a cui non sapete rispondere. È ciò che accade senza la gestione della qualità dei dati, ed è per questo che sempre più data team la integrano nelle proprie attività operative anziché trattarla come un progetto di pulizia una tantum.
Che cos'è, esattamente, la gestione della qualità dei dati? È la disciplina che consiste nel definire, misurare e mantenere l'accuratezza, la completezza, la coerenza e la tempestività dei dati lungo tutto il loro ciclo di vita. Non è un singolo strumento né un foglio di calcolo con regole di validazione. È un framework strutturato che combina processi, ownership e tecnologia per intercettare i problemi prima che raggiungano un report o un modello.
In questo articolo analizzeremo i componenti fondamentali di un framework di gestione della qualità dei dati, illustreremo i processi che mantengono i dati affidabili giorno dopo giorno e vedremo le best practice che distinguono i team che intercettano presto i problemi da quelli che li scoprono a proprie spese. Se gestite pipeline, warehouse o data lake su larga scala, queste sono le fondamenta di tutto ciò che costruite sui vostri dati.
Perché la gestione della qualità dei dati è importante per la vostra organizzazione
I dati errati non si annunciano. Si nascondono in una pipeline finché un report trimestrale non esce con la cifra dei ricavi sbagliata, o finché un modello AI addestrato su dati alla deriva non inizia a prendere decisioni che nessuno sa spiegare. La gestione della qualità dei dati è importante perché il costo per intercettare un problema cresce man mano che questo si sposta a valle. Una colonna mancante intercettata in fase di ingestion costa a un ingegnere dieci minuti. Lo stesso problema intercettato dopo che ha influenzato una presentazione al consiglio di amministrazione costa credibilità, e a volte molto di più.
Il costo reale dei dati errati
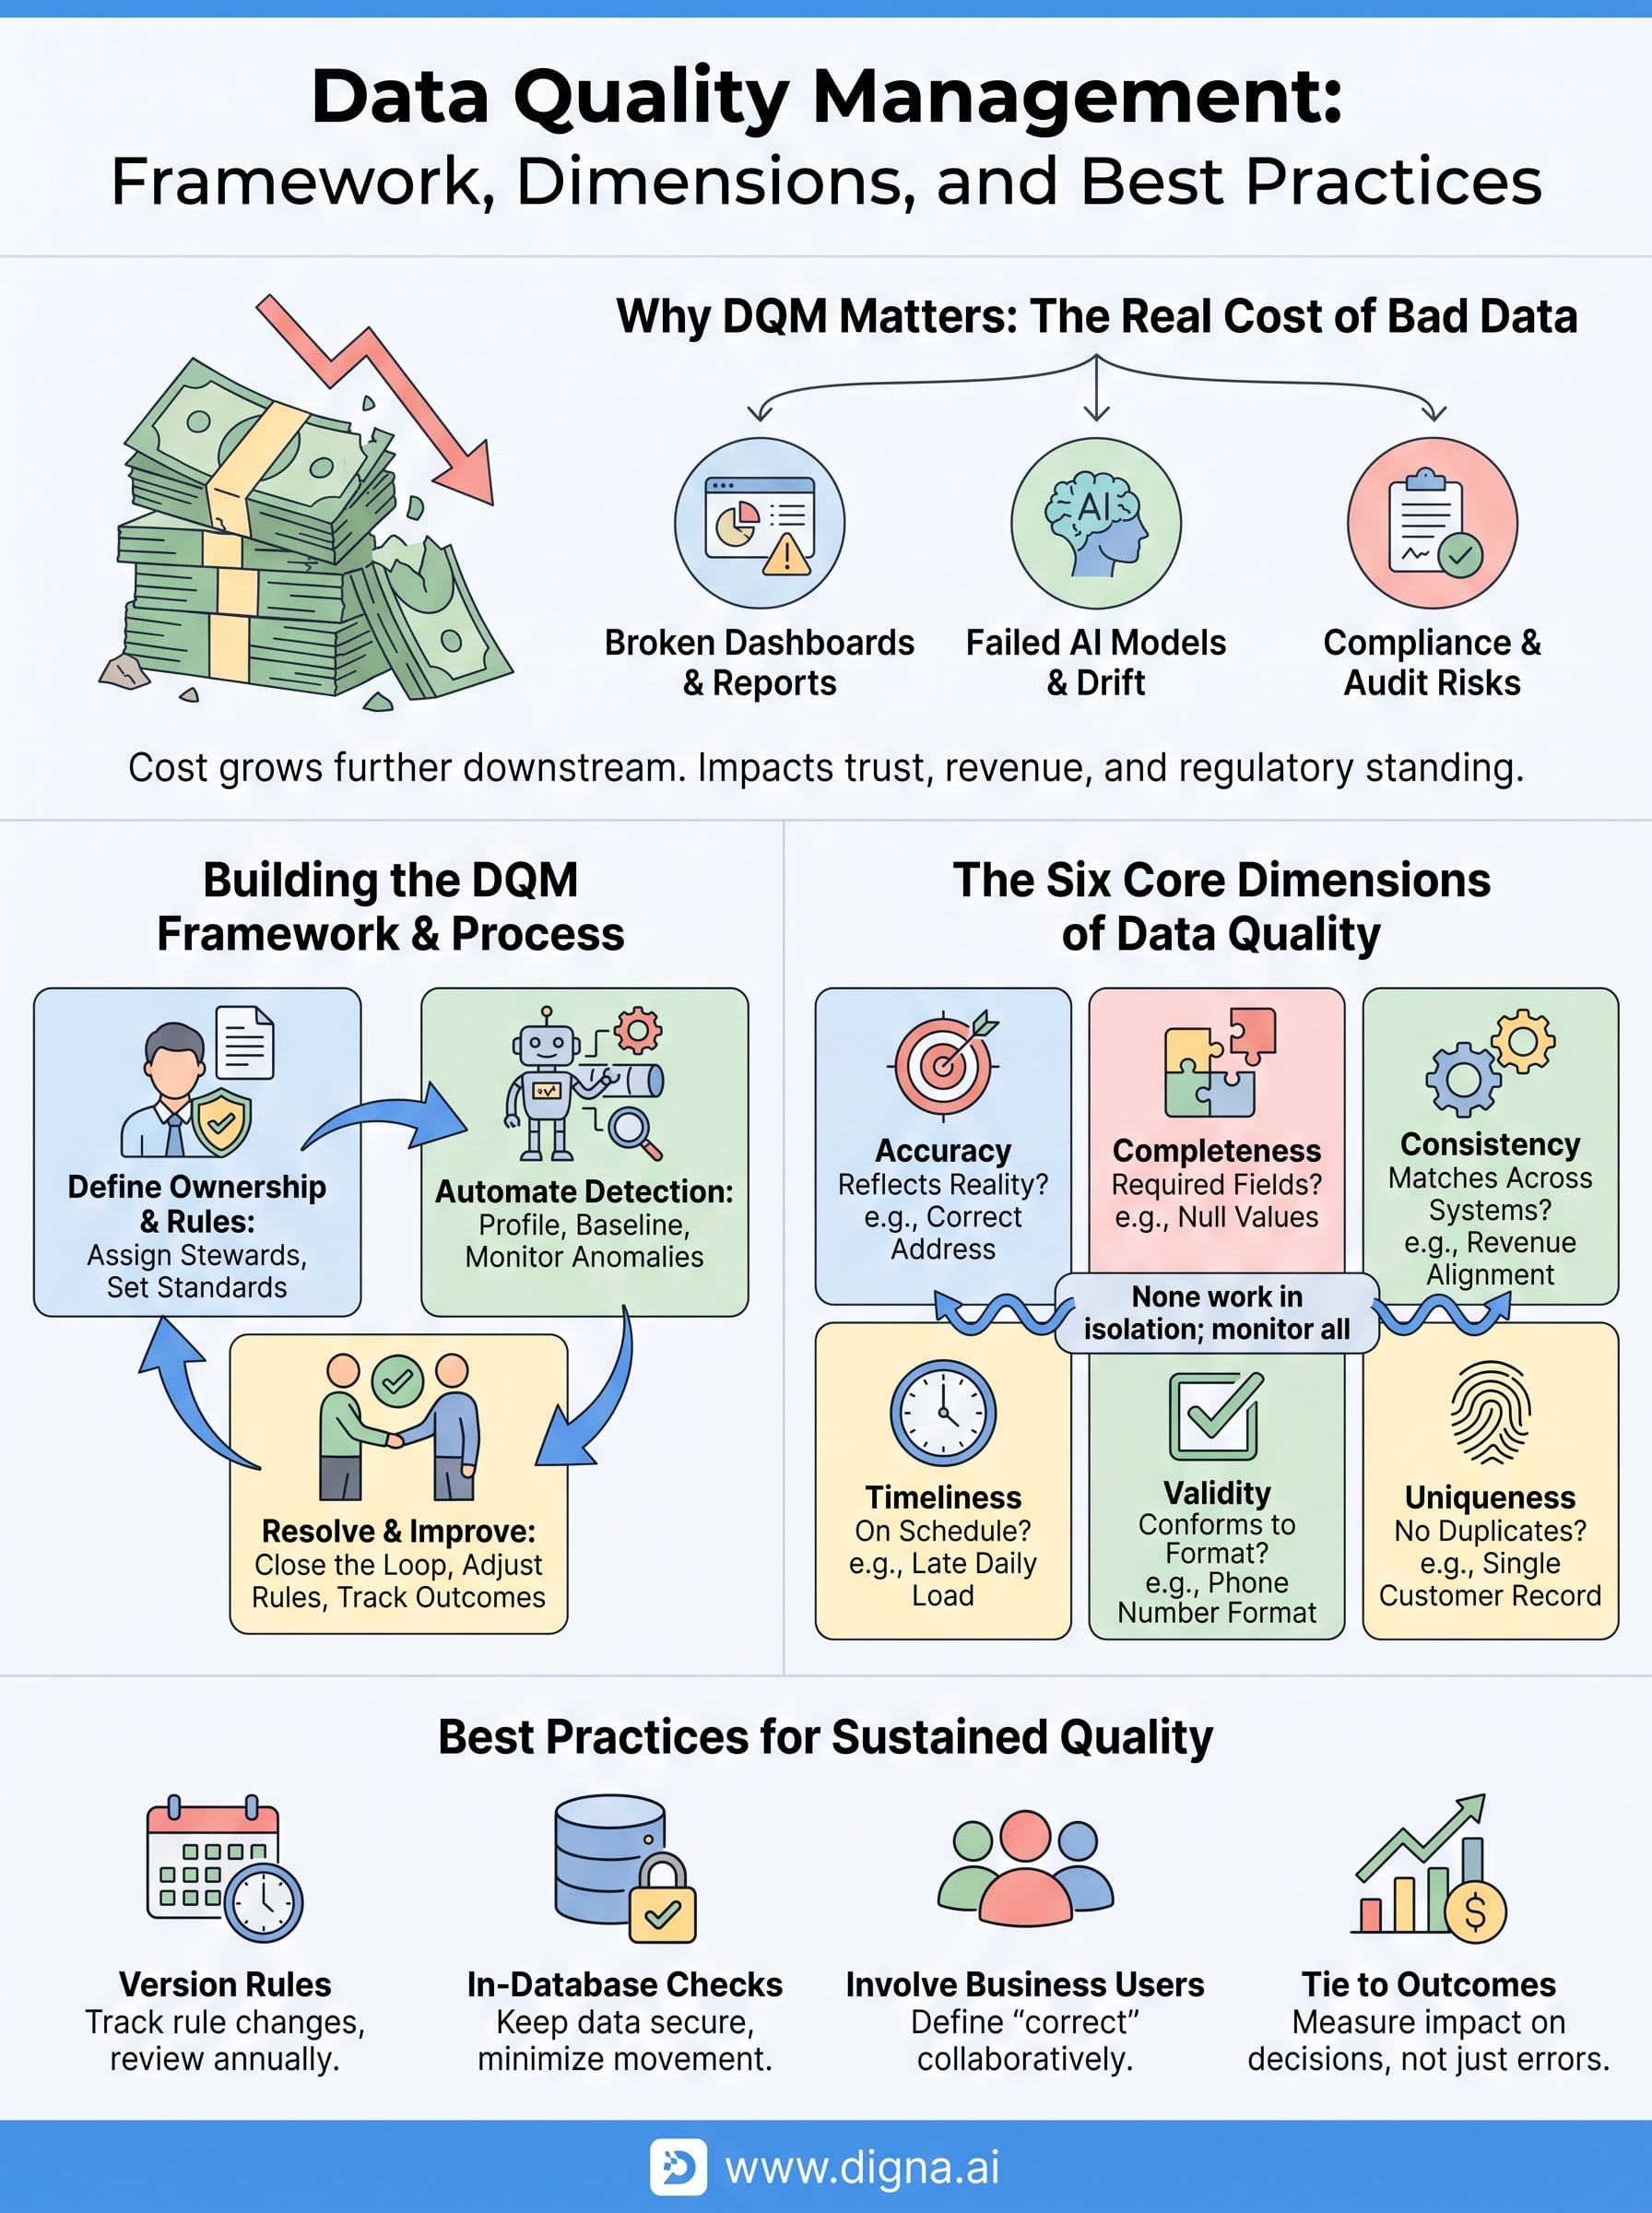
Gartner ha stimato che la scarsa qualità dei dati costa alle organizzazioni in media 12,9 milioni di dollari all'anno, una cifra che comprende lavoro sprecato, opportunità mancate ed errori veri e propri nel processo decisionale. E questo numero non coglie nemmeno il danno più lento: analisti che smettono di fidarsi delle dashboard, dirigenti che tornano a decidere d'istinto perché i numeri “non sembrano mai giusti” e team di ingegneria che bruciano ore a spegnere incendi invece di costruire. Le organizzazioni che gestiscono la qualità dei dati in modo sistematico intercettano questi problemi alla fonte invece di pagarli tre volte: una quando l'errore si verifica, una quando qualcuno lo scopre e una quando qualcuno deve spiegarlo.
Ogni dollaro speso per intercettare un errore nei dati alla fonte fa risparmiare molto di più che correggerlo dopo che ha raggiunto una decisione.
Dove si manifesta davvero la scarsa qualità dei dati
Il danno raramente resta confinato a un solo team. Ecco come di solito si propaga all'interno di un'organizzazione:
Dashboard rotte: i dirigenti perdono fiducia nel reporting dopo aver visto numeri contrastanti tra i vari reparti.
Modelli AI che falliscono: i sistemi di machine learning addestrati su dati incoerenti o incompleti vanno alla deriva in silenzio, producendo output che nessuno segnala finché le prestazioni non calano.
Esposizione in materia di compliance: i settori regolamentati rischiano sanzioni o audit non superati quando i record non corrispondono ai sistemi sorgente.
Spreco operativo: gli ingegneri passano ore a risalire all'origine di un numero errato invece di sviluppare nuove funzionalità.
Fiducia dei clienti: gli errori nella fatturazione, nei registri o nelle comunicazioni erodono la fiducia più rapidamente di quasi ogni altra cosa.
Poiché questi guasti raramente restano isolati, un problema in una pipeline può emergere silenziosamente in cinque report diversi prima che qualcuno ne risalga all'origine.
Pressione normativa e di compliance
Le organizzazioni dei settori finanziario, sanitario, delle telecomunicazioni e della pubblica amministrazione operano nel rispetto di normative che richiedono dati tracciabili e accurati. Quadri normativi come il GDPR in Europa impongono alle organizzazioni di dimostrare il controllo sui dati personali, compresa la loro accuratezza e le modalità di trattamento. Gli auditor non vogliono solo un report pulito: vogliono la prova di un processo ripetibile che intercetti gli errori prima che arrivino in una segnalazione o sulla scrivania di un'autorità di vigilanza. Senza quel processo, ogni audit diventa una corsa affannosa anziché una checklist.
Fiducia nell'AI e nelle decisioni automatizzate
Man mano che sempre più organizzazioni si affidano all'AI e a pipeline automatizzate per prendere decisioni su larga scala, la tolleranza verso dati di input errati si riduce. Un modello non conosce la differenza tra un trend reale e un errore di inserimento dati: impara semplicemente da ciò che riceve. I team che trascurano la gestione della qualità dei dati finiscono per fare debug del comportamento del modello quando il vero problema era una modifica dello schema tre pipeline più a monte. Integrare i controlli di qualità nella pipeline stessa, anziché confidare che un essere umano se ne accorga, è l'unico modo per evitare che i sistemi automatizzati prendano su larga scala decisioni sbagliate con assoluta sicurezza.
Le dimensioni fondamentali dei dati di alta qualità
La qualità non è un singolo attributo che si possiede o meno. È un insieme di dimensioni misurabili, e la gestione della qualità dei dati tratta ciascuna di esse come una metrica da monitorare, non come la vaga sensazione che “i dati sembrano a posto”. La maggior parte dei framework converge su sei dimensioni che coprono accuratezza, struttura e freschezza, e ognuna intercetta un tipo diverso di guasto.
Le sei dimensioni che i team misurano
Ecco come si articolano le dimensioni nella pratica, con il tipo di guasto che ciascuna è pensata per intercettare:
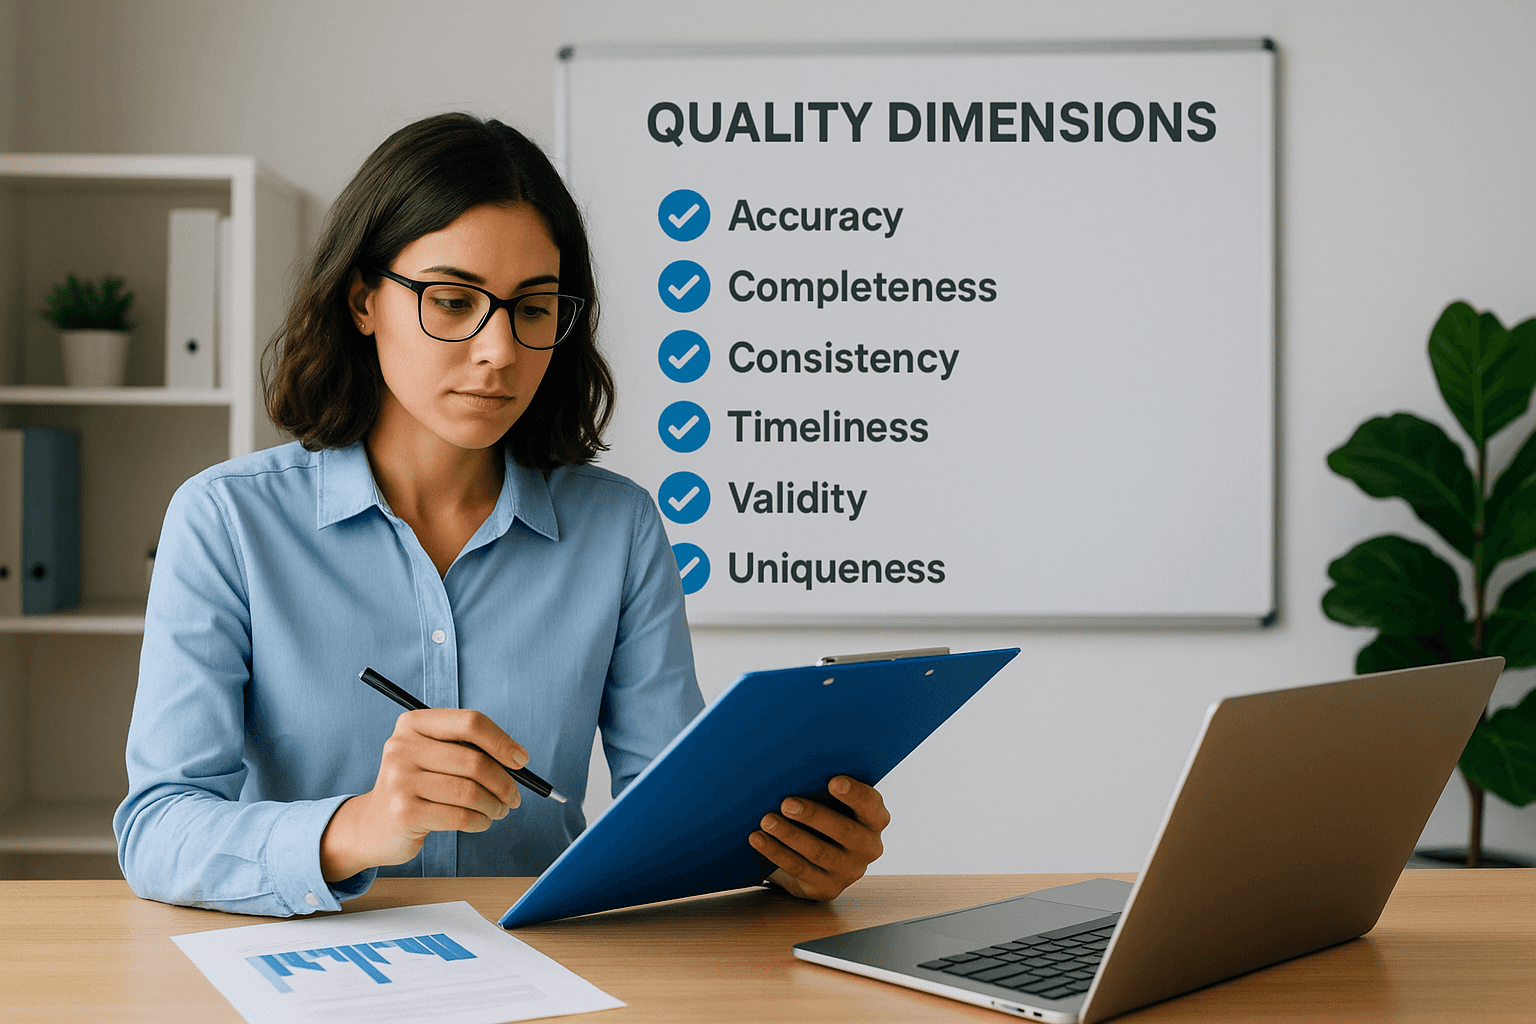
Dimensione | Che cosa misura | Esempio di guasto |
|---|---|---|
Accuratezza | Il valore riflette la realtà? | L'indirizzo del cliente corrisponde a un vecchio record, non a quello attuale |
Completezza | I campi obbligatori sono compilati? | Il 15% degli ordini arriva con una data di spedizione null |
Coerenza | I valori corrispondono tra i sistemi? | I ricavi nel warehouse non corrispondono a quelli dell'ERP sorgente |
Tempestività | I dati arrivano quando previsto? | Un caricamento giornaliero arriva con sei ore di ritardo, rompendo un report del mattino |
Validità | I dati rispettano i formati o le regole definiti? | Un campo numero di telefono contiene lettere |
Unicità | I record sono duplicati? | Lo stesso cliente compare tre volte con nomi leggermente diversi |
Perché nessuna singola dimensione racconta tutta la storia
Nessuna di queste dimensioni funziona in modo isolato. I dati possono essere perfettamente completi ed essere comunque sbagliati, con ogni campo compilato con un valore obsoleto. Possono essere tempestivi ed essere comunque non validi, arrivando puntuali ma nel formato sbagliato. Trattare le dimensioni separatamente è proprio il motivo per cui così tante iniziative sulla qualità si arenano: un team sistema la completezza, dichiara vittoria e tre mesi dopo viene colto alla sprovvista da un problema di coerenza che nessuno stava monitorando.
La qualità dei dati non è un unico punteggio: sono sei domande diverse che dovete continuare a porvi contemporaneamente.
Anche le modifiche allo schema meritano una menzione, perché rompono silenziosamente diverse dimensioni contemporaneamente. Una colonna eliminata a monte non danneggia solo la completezza: può corrompere silenziosamente anche i controlli di validità e coerenza che presupponevano la vecchia struttura. Ecco perché i framework di qualità dei dati maturi abbinano metriche a livello di dimensione al monitoraggio strutturale, intercettando la causa principale invece di inseguire i sintomi una dimensione alla volta.
Come costruire un processo di gestione della qualità dei dati
Costruire un processo di gestione della qualità dei dati parte da una decisione che la maggior parte dei team salta: qualcuno deve esserne responsabile. Senza un responsabile designato, i controlli di qualità diventano un progetto secondario che viene abbandonato non appena uno sprint si fa intenso. Un processo funzionante richiede quattro elementi che si rafforzano a vicenda: ownership chiara, regole definite, rilevamento automatizzato e un flusso di risoluzione che chiuda il ciclo anziché limitarsi a registrare il problema.
Definite ownership e regole prima di scrivere un solo controllo
Iniziate assegnando un data steward o un responsabile a ciascun dataset critico, una persona che sappia come deve apparire un dato “corretto” per quel dataset e che venga avvisata quando qualcosa si rompe. Abbinate questa ownership a regole di business documentate: quali campi sono obbligatori, quali intervalli sono validi, quali formati sono accettabili. Saltare questo passaggio è la scorciatoia più comune che i team prendono, ed è il motivo per cui così tanti programmi di qualità crollano entro un anno: nessuno si era messo d'accordo, fin dall'inizio, su che cosa significasse “buono”.
Un processo di qualità senza un responsabile designato è una checklist di cui nessuno risponde.
Automatizzate il rilevamento invece di affidarvi a revisioni manuali
I controlli manuali a campione intercettano ciò che qualcuno si ricorda di cercare, il che significa che si lasciano sfuggire tutto il resto. Il monitoraggio automatizzato, in particolare il rilevamento delle anomalie che apprende il comportamento normale dei dati, intercetta i guasti per i quali nessuno aveva pensato di scrivere una regola. Un'implementazione pratica segue di solito questo ordine:
Profilate i vostri dati per comprenderne volume, distribuzione e tassi di null attuali.
Stabilite regole di base per le dimensioni più importanti per il vostro business.
Aggiungete il rilevamento delle anomalie per segnalare le deviazioni che le sole regole non intercettano.
Monitorate le modifiche allo schema in modo continuo, perché i cambiamenti strutturali rompono più controlli contemporaneamente.
Chiudete il ciclo con un flusso di risoluzione
Rilevare un problema non serve a nulla se finisce in una dashboard che nessuno controlla. Ogni alert ha bisogno di una destinazione: un ticket, un canale Slack, un responsabile tenuto a rispondere entro un tempo stabilito. La risoluzione dovrebbe anche alimentare l'insieme delle regole: se la stessa anomalia continua a generare falsi allarmi, la soglia va regolata, non silenziata. I team che considerano facoltativo questo ciclo di feedback finiscono sommersi dall'alert fatigue nel giro di un trimestre.
Best practice e insidie comuni da evitare
Conoscere il framework è una cosa. Applicarlo senza cadere nelle stesse trappole in cui cadono tutti i team è un'altra. Il successo o il fallimento della gestione della qualità dei dati dipende meno dalla tecnologia che scegliete e più dalle abitudini che costruite attorno a essa. Le pratiche che seguono distinguono i team che mantengono alta la qualità per anni da quelli che sistemano le cose una volta e poi vedono la qualità deteriorarsi di nuovo in silenzio.
Pratiche che reggono davvero nel tempo
Versionare le regole di business è più importante di quanto la maggior parte dei team si aspetti, perché regole che avevano senso l'anno scorso spesso smettono di corrispondere alla realtà quando un sistema sorgente cambia. Trattate il vostro insieme di regole come trattate il codice: tracciate le modifiche, revisionate gli aggiornamenti e tornate indietro quando una nuova regola genera più falsi allarmi di quanti problemi intercetti. Abbinate questa disciplina a un monitoraggio eseguito nel database, così che i record sensibili non debbano mai lasciare il vostro ambiente solo per essere controllati, aspetto che conta soprattutto per i team dei settori finanziario, sanitario e della pubblica amministrazione soggetti a rigide regole di compliance.
Coinvolgete gli utenti di business, non solo gli ingegneri, quando definite che cosa significa “corretto” per un dataset.
Rivedete le soglie ogni trimestre, così che le regole restino allineate al comportamento reale dei dati anziché a ipotesi di un anno prima.
Documentate ogni eccezione, perché una regola che qualcuno ha disattivato in silenzio è una regola che nessuno controlla più.
Collegate le metriche di qualità ai risultati di business, come l'accuratezza dei report o le prestazioni dei modelli, e non solo al semplice conteggio degli errori.
Le regole che non vengono mai riviste diventano punti ciechi travestiti da misure di sicurezza.
Le insidie che vanificano silenziosamente un buon lavoro
L'alert fatigue è la modalità di fallimento più comune, e inizia in modo innocente: un team imposta regole troppo strette, viene sommerso da falsi positivi e inizia a ignorare del tutto il canale. Quando succede, un problema reale passa inosservato insieme al rumore. Correggere il tiro puntando sulla revisione manuale è altrettanto dannoso, perché non scala oltre una manciata di tabelle e logora gli analisti che effettuano i controlli.
Un'ownership a compartimenti stagni fa tanti danni quanto l'assenza totale di ownership. Quando cinque team sistemano ciascuno il proprio angolo di una pipeline senza parlarsi, la stessa anomalia viene “corretta” in cinque modi diversi, e nessuno di essi affronta la causa principale. Inseguire ogni dimensione con la stessa intensità è un'altra trappola: non tutti i campi richiedono lo stesso livello di attenzione, e trattare un campo di log a basso rischio come un record regolamentato spreca un'attenzione che dovrebbe essere rivolta ai dati che orientano davvero le decisioni.
Fare della qualità dei dati un'abitudine quotidiana
Una buona qualità dei dati non è un progetto che si porta a termine. È un'abitudine da integrare nel modo di lavorare dei vostri team, così come la code review è diventata un'abitudine dopo che i team si erano scottati con deployment difettosi. Le dimensioni, l'ownership e i flussi di lavoro descritti qui reggono solo se qualcuno continua a farli funzionare dopo che l'entusiasmo iniziale del lancio si è spento. La gestione della qualità dei dati funziona quando è noiosa: i controlli vengono eseguiti automaticamente, i responsabili vengono avvisati prima che un cliente se ne accorga e le regole vengono riviste prima che diventino punti ciechi.
Non dovete costruire tutto da zero né dedicare un team a sorvegliare le dashboard. Le piattaforme che combinano in un unico luogo rilevamento delle anomalie, tracciamento dello schema e validazione, eseguendoli direttamente all'interno del vostro database, vi portano dall'installazione a insight azionabili in poche ore anziché in mesi. Se siete pronti a smettere di spegnere incendi causati da dati errati e a iniziare a intercettarli alla fonte, scoprite come digna può aiutarvi.
Ognuna delle sei dimensioni richiede un controllo diverso, e trattarle come un unico punteggio è ciò che permette a un problema di coerenza di nascondersi dietro un successo sulla completezza: per i dettagli su come misurare ciascuna di esse, consultate le dimensioni della qualità dei dati.
Domande frequenti
Che cos'è la gestione della qualità dei dati?
È la disciplina che consiste nel definire, misurare e mantenere l'accuratezza, la completezza, la coerenza e la tempestività dei dati lungo tutto il loro ciclo di vita. Non è un singolo strumento né un foglio di calcolo con regole di validazione, ma un framework che combina processi, ownership e tecnologia per intercettare i problemi prima che raggiungano un report o un modello.
Quali sono le sei dimensioni della qualità dei dati?
Accuratezza, completezza, coerenza, tempestività, validità e unicità. Ognuna intercetta un guasto diverso: il 15% degli ordini che arriva con una data di spedizione null è un problema di completezza, mentre i ricavi del warehouse che non concordano con l'ERP sorgente sono un problema di coerenza. Sistemarne una e dichiarare vittoria è il modo in cui i programmi di qualità si arenano.
Come si costruisce un processo di gestione della qualità dei dati?
Quattro elementi si rafforzano a vicenda: un responsabile designato per ogni dataset critico, regole di business documentate, rilevamento automatizzato e un flusso di risoluzione. Profilate prima volume, distribuzione e tassi di null, stabilite regole di base per le dimensioni che contano, poi aggiungete il rilevamento delle anomalie e il monitoraggio continuo dello schema.
Perché i programmi di qualità dei dati falliscono?
L'alert fatigue è la modalità di fallimento più comune. Regole troppo strette sommergono il canale di falsi positivi finché nessuno lo legge più, e un problema reale passa inosservato insieme al rumore. Un'ownership a compartimenti stagni provoca danni analoghi, con cinque team che correggono la stessa anomalia in cinque modi diversi.
Quanto costa la scarsa qualità dei dati?
Gartner stima una media di 12,9 milioni di dollari all'anno per organizzazione, che comprende lavoro sprecato, opportunità mancate ed errori veri e propri nel processo decisionale. Il danno più lento è più difficile da quantificare: analisti che smettono di fidarsi delle dashboard e ingegneri che passano il loro tempo a spegnere incendi invece di costruire.


