Come costruire un data quality framework solido per il 2026
|
6
min di lettura
Una dashboard che ieri sembrava a posto oggi è improvvisamente sbagliata. Il fatturato è raddoppiato in una regione, in un'altra mancano i conteggi dei clienti e nessuna pipeline ha segnalato un errore. Oppure il vostro modello continua a girare, a restituire punteggi e a superare i controlli infrastrutturali, ma gli utenti a valle capiscono che qualcosa non va. Sono gli incidenti più difficili, perché il sistema è “su” mentre la fiducia è già crollata.
È qui che un data quality framework smette di essere un esercizio di documentazione e diventa infrastruttura operativa. Offre agli ingegneri un modo per definire che cosa significhi “dati buoni”, verificarlo in modo continuo e intercettare i guasti silenziosi prima che i record errati si diffondano in report, modelli e decisioni. La parte con cui molte organizzazioni faticano ancora non è la definizione, ma l'implementazione. In particolare, come eseguire controlli di qualità moderni, rilevamento delle anomalie e monitoraggio della tempestività in modo sicuro e all'interno degli ambienti dati esistenti.
Indice
Perché i vostri dati falliscono e come può aiutare un framework
La maggior parte degli incidenti dovuti a dati errati non inizia con un'interruzione clamorosa. Inizia con qualcosa di piccolo. Un sistema sorgente cambia il formato di un campo. Un batch arriva in ritardo. Un nuovo processo a monte inizia a riempire di valori vuoti un campo prima facoltativo. Nulla va in crash, quindi nessuno controlla finché il CFO non chiede perché un report per il consiglio di amministrazione è cambiato o finché un analista non passa mezza giornata a riconciliare numeri che prima coincidevano.
Ecco perché il lavoro reattivo sulla data quality non funziona. I team aspettano una lamentela su una dashboard, poi cercano nei log, confrontano tabelle e correggono i sintomi. Una settimana dopo, lo stesso tipo di problema si ripresenta altrove, perché nessuno ha definito responsabilità, soglie o controlli a livello di pipeline.
Un framework funzionante cambia il modello operativo. Invece di trattare la qualità come un audit a posteriori, i team definiscono che cosa deve essere vero prima che i dati possano essere considerati affidabili in produzione. Significa decidere quali dataset sono critici, quali dimensioni contano per ciascuno, chi è responsabile degli standard e che cosa deve succedere quando un controllo fallisce.
I dati errati raramente sono una sola tabella rotta. Di solito sono un unico difetto silenzioso ripetuto in tutti i sistemi a valle.
In pratica, il primo risultato è la fiducia. Gli ingegneri smettono di discutere se un problema sia “reale”. Gli analisti smettono di inserire logica difensiva in ogni query. I team di ML smettono di tirare a indovinare se il calo delle prestazioni dipenda dal drift delle feature, da input obsoleti o da record malformati. Il framework offre a tutti lo stesso piano di controllo.
La novità di oggi riguarda l'architettura. Molti team sanno descrivere un framework sulla carta, ma si affidano ancora a strumenti basati sull'estrazione che copiano i dati nell'ambiente di qualcun altro per profilazione e monitoraggio. Questo crea attriti per i carichi di lavoro regolamentati e gli ambienti privati. Un modello operativo più sicuro mantiene l'elaborazione dove i dati risiedono già e invia verso l'esterno avvisi e metriche, non i dati stessi. I team alle prese con rollout che falliscono ripetutamente riconoscono spesso lo stesso schema strutturale descritto in perché i progetti di data quality falliscono e come correggere il modello operativo.
I pilastri di un data quality framework moderno
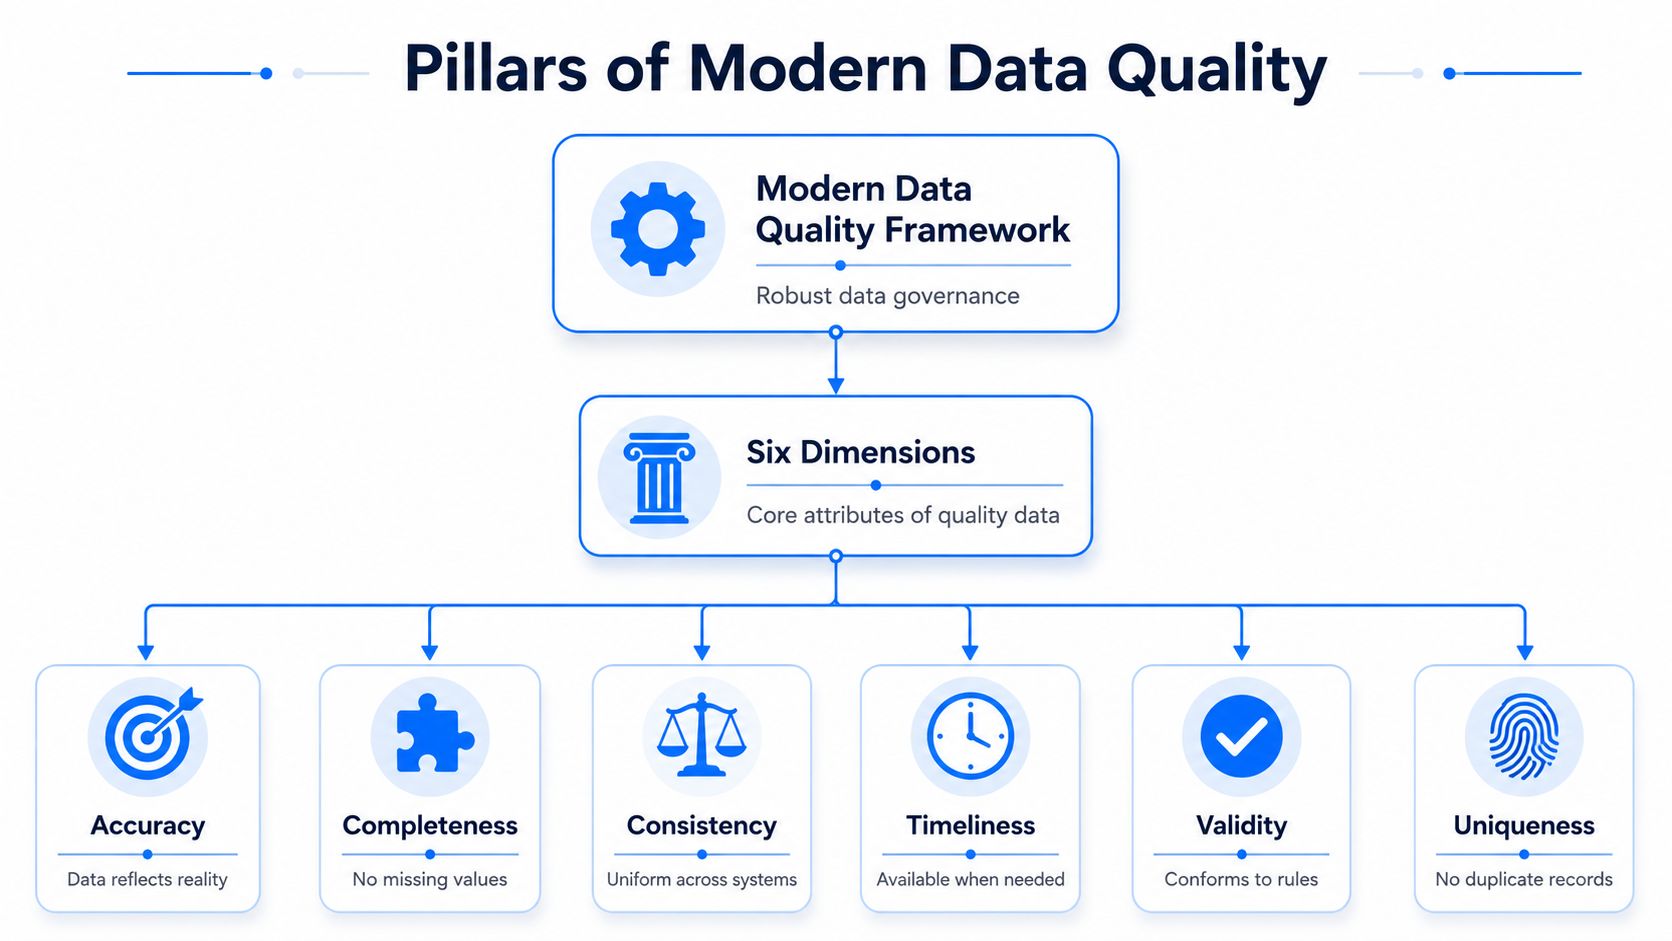
Un data quality framework moderno definisce che cosa deve essere vero perché un dataset sia considerato affidabile in produzione, quindi applica queste regole dove i dati risiedono già. Le fondamenta sono stabili: accuratezza, completezza, coerenza, tempestività, validità e unicità. In uno stack moderno cambia l'esecuzione. Invece di esportare i dati verso un servizio esterno per la profilazione, i team possono eseguire i controlli all'interno del data warehouse, del lakehouse o del database, mantenere in loco i record sensibili e inviare all'esterno metriche, avvisi e segnali di remediation.
Sei dimensioni fondamentali
L'accuratezza misura se un valore corrisponde allo stato reale che rappresenta. Un cliente indicato come attivo dopo la chiusura del conto è un dato inaccurato, anche se il campo è compilato e formattato correttamente.
La completezza verifica se i dati richiesti sono presenti. ID, timestamp o valori di categoria mancanti spesso rompono join a valle, logiche di reporting e feature dei modelli prima che qualcuno si accorga del problema alla sorgente.
La coerenza verifica se la stessa entità ha lo stesso significato in sistemi e tabelle diversi. Se finanza e operations assegnano codici prodotto diversi allo stesso articolo, la riconciliazione si trasforma in una pulizia manuale.
La tempestività misura se i dati arrivano entro la finestra richiesta dal processo di business. Un dataset può essere strutturalmente pulito e fallire comunque il caso d'uso se arriva troppo tardi per la risposta alle frodi, per le decisioni operative o per il reporting direzionale.
La validità verifica se i valori rispettano i formati, gli intervalli e le regole di business attesi. Date fuori dagli intervalli consentiti, identificativi malformati e codici regolamentati non conformi alle policy falliscono tutti il test di validità.
L'unicità conferma che i record compaiano una sola volta quando devono comparire una sola volta. Clienti, sinistri o ordini duplicati distorcono rapidamente conteggi, fatturato e metriche di rischio.
Queste dimensioni sono standard, ma i dettagli di implementazione no. Il lavoro pratico consiste nello scegliere quali dimensioni contano di più per ciascun dataset ed esprimerle come controlli che possano essere eseguiti in sicurezza all'interno del vostro ambiente. Per i team che costruiscono questa mappatura, questa guida alle dimensioni della data quality e a come misurarle su larga scala è un riferimento utile.
Perché le soglie vanno nelle pipeline
Le dimensioni diventano utili solo quando sono misurabili. Ogni dataset ha bisogno di soglie legate all'uso di business, alla sensibilità dei dati e al costo di un guasto. Una tabella finanziaria può tollerare pochissimi valori mancanti ma accettare un aggiornamento più lento. Uno stream di eventi operativi può accettare qualche record in ritardo, ma non dati obsoleti oltre una breve finestra.
Gli esempi rendono concreto il concetto di qualità. Completezza può significare mantenere il tasso di valori nulli sotto una soglia concordata per una tabella di reporting. Tempestività può significare imporre obiettivi di freschezza per un feed di monitoraggio. Validità può significare verificare che i valori restino entro intervalli contrattuali o normativi prima che i dati vengano pubblicati a valle.
Il compromesso è semplice. Soglie strette intercettano prima più problemi, ma possono anche bloccare le pipeline per difetti con scarso impatto sul business. Soglie larghe riducono il rumore operativo, ma lasciano diffondere il degrado silenzioso. I buoni team non inseguono dati perfetti. Fissano tolleranze proporzionate al rischio della decisione da prendere.
Che cosa funziona in pratica:
Collegate ogni controllo a un caso d'uso di business. Un'anagrafica clienti, un feature store e una tabella di clickstream non dovrebbero condividere gli stessi standard.
Definite soglie numeriche o basate su regole. “Abbastanza buono” non si può far rispettare.
Eseguite i controlli nel punto di trasformazione e di pubblicazione. È lì che tendono a entrare schema drift, inflazione dei join e valori non validi.
Monitorate i trend insieme ai fallimenti. L'erosione lenta spesso si manifesta prima di una violazione netta della soglia.
Mantenete l'esecuzione in-database quando i dati sono sensibili. Così si riduce l'esposizione in termini di sicurezza, si evitano costi di copia aggiuntivi e ci si adatta meglio agli ambienti regolamentati.
Regola pratica: se un team non sa indicare la soglia, il responsabile e l'azione per un controllo fallito, lo standard non è pronto per la produzione.
Questo modello operativo cambia anche le scelte sugli strumenti. I team che valutano piattaforme per governance, rischio e reporting cercano spesso lo stesso schema che si ritrova nella leadership di prodotto senior nella compliance Web3: i controlli sono utili solo quando si adattano all'ambiente che devono proteggere, non quando richiedono che i dati ne escano.
Data governance e ruoli chiave nel vostro framework
Gli strumenti non salveranno un framework con responsabilità vaghe. Quando nessuno è responsabile di un dataset, gli ingegneri finiscono per prendere decisioni di business in SQL e i team di business danno per scontato che l'engineering “sappia già” che cosa siano dati accettabili.
Chi è responsabile di cosa
Tre ruoli contano più di tutti.
I data owner decidono che cosa significhi qualità per un dominio. Approvano le soglie accettabili, definiscono l'impatto sul business e decidono se un'eccezione è tollerabile o rischiosa.
I data steward traducono le policy in standard operativi. Definiscono valori validi, logiche di riferimento, convenzioni di denominazione e priorità di triage dei problemi, con il relativo contesto di business.
I data custodian o ingegneri implementano i controlli. Inseriscono i controlli nelle pipeline, configurano gli avvisi, gestiscono le esecuzioni fallite e fanno sì che i segnali di qualità siano visibili là dove si lavora.
Questa separazione evita un errore frequente: policy scritte dai team di governance che non arrivano mai all'esecuzione, oppure controlli tecnici scritti dagli ingegneri che non riflettono le reali regole di business. Un ottimo riferimento per questa divisione dei compiti sono le responsabilità del data owner nella governance operativa.
Dove la governance si inceppa
Di solito la governance fallisce in uno di questi quattro punti:
Punto di rottura | Come si manifesta | Risultato |
|---|---|---|
Responsabilità non definite | Ognuno presume che qualcun altro abbia approvato lo standard | Lunghe discussioni durante gli incidenti |
Policy senza implementazione | Le regole vivono in slide o voci di catalogo | Nessuna applicazione |
Engineering senza contesto di business | Controlli tecnicamente impeccabili ma irrilevanti sul piano operativo | Rumore e rischi non rilevati |
Nessuna visibilità condivisa | Ogni team vede una versione diversa del problema | Remediation lenta |
Non è solo un problema di dati. I prodotti digitali regolamentati hanno la stessa esigenza di responsabilità ben definite tra prodotto, rischio e reporting. Se volete un esempio concreto di come queste competenze vengono descritte in un altro ambito, la descrizione del ruolo di leadership di prodotto senior nella compliance Web3 è un utile termine di paragone. Le responsabilità corrispondono da vicino a ciò di cui hanno bisogno i programmi sui dati maturi: accountability chiara, mentalità orientata al rischio e coordinamento operativo.
Un modello di governance pratico è semplice. Lo steward definisce il “tipo di cliente valido”. L'ingegnere implementa la regola. L'owner decide se una violazione blocca la pubblicazione, genera un avviso o attiva un'escalation. Se una sola persona è costretta a svolgere tutti e tre i compiti, il framework non scalerà.
Automatizzare la qualità con monitoraggio e validazione
Il lavoro manuale sulla data quality non fallisce perché i team sono disattenti. Fallisce perché le regole statiche non riescono a stare al passo con sistemi vivi. Arrivano nuove sorgenti, la stagionalità cambia, l'utilizzo dei prodotti si sposta e le pipeline evolvono. Un approccio basato solo su regole finisce per diventare una fragile fabbrica di avvisi.
Il monitoraggio trova ciò che le regole non vedono
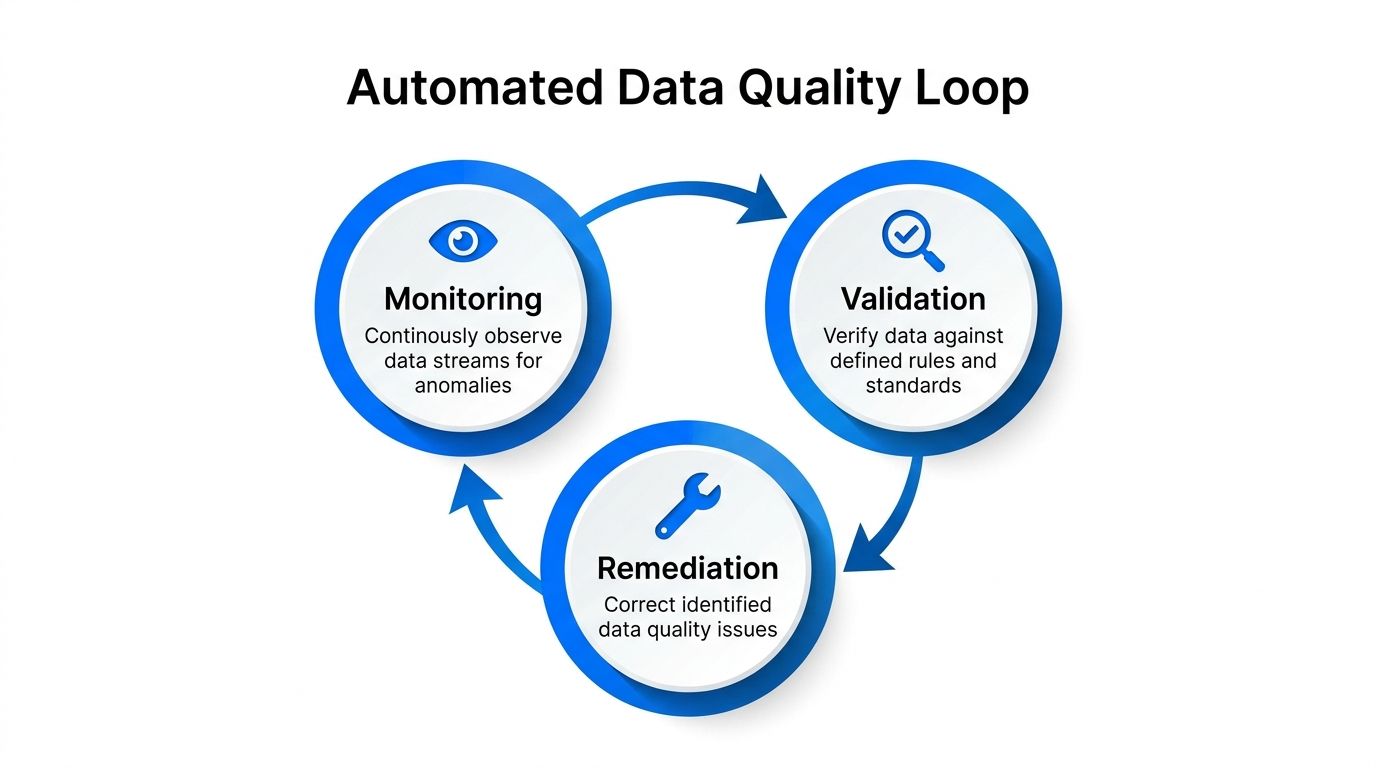
Il monitoraggio dovrebbe rispondere a una domanda di base: questo dataset si comporta ancora come al solito?
È qui che il rilevamento delle anomalie si guadagna il suo posto. Secondo la spiegazione di digna sulle tecniche di rilevamento delle anomalie basate sull'AI, i sistemi di anomaly detection basati sull'AI sostituiscono le soglie statiche basate su regole con soglie adattive che apprendono automaticamente stagionalità e trend, riducendo in modo significativo i falsi positivi e cogliendo le anomalie reali senza richiedere competenze di ML o codice Python. Questo è importante perché le soglie fisse spesso sbagliano in entrambe le direzioni: non vedono il drift reale e scattano per variazioni attese.
La panoramica di FirstEigen sul rilevamento delle anomalie per la data quality descrive bene l'aspetto operativo: l'anomaly detection usa machine learning e AI per monitorare in modo continuo i flussi di dati, individuando outlier che si discostano dai pattern di alta qualità e che spesso sono errori, eventi inattesi o opportunità, contribuendo a mantenere accuratezza, completezza e affidabilità in tempo reale.
La validazione applica ciò che il business sa già
Il monitoraggio gestisce le incognite sconosciute. La validazione gestisce ciò che è noto e certo.
Se lo stato di un sinistro deve appartenere a un elenco approvato, validatelo. Se un identificativo regolamentato deve rispettare un formato definito, validatelo. Se un record non deve mai essere duplicato su una chiave di business composta, validatelo. Questi sono controlli espliciti e non dovrebbero dipendere dall'apprendimento di pattern.
Un ciclo pratico di solito comprende:
Monitoraggio adattivo per variazioni di volume, distribuzione, freschezza e pattern di cambiamento insoliti.
Validazione deterministica per regole a livello di record, campi obbligatori, valori ammessi e vincoli contrattuali.
Logica di escalation, in modo che il team giusto riceva l'avviso con la giusta severità.
Workflow di root cause che ricolleghi un avviso a un job, a una modifica dello schema, a una sorgente a monte o a un rilascio di codice.
La descrizione di Oracle del rilevamento delle anomalie basato sull'AI coglie il cambiamento più ampio: il processo passa da regole statistiche statiche a un modello flessibile addestrato sui dati per creare una baseline del comportamento normale, e questo modello si adatta man mano che vengono elaborati più dati.
La remediation chiude il ciclo
Nessun framework è automatizzato se gli avvisi muoiono in una coda. La remediation richiede responsabilità chiare e playbook di risposta. Quando arriva un'anomalia, qualcuno deve sapere se bloccare la pubblicazione a valle, mettere i dati in quarantena, rieseguire la pipeline o accettare un'eccezione documentata.
Un controllo senza un percorso di risposta è solo strumentazione.
Questo è anche il punto giusto per citare un'opzione di implementazione moderna. digna combina rilevamento delle anomalie, monitoraggio della tempestività, tracciamento dello schema e validazione a livello di record, eseguendo le analisi all'interno dell'ambiente del cliente. Questo modello si adatta ai team che hanno bisogno sia di un monitoraggio in stile observability sia di controlli di qualità applicabili, senza inviare all'esterno i dati di produzione.
Pattern di implementazione moderni per la data quality
Le organizzazioni non hanno bisogno di altra teoria. Hanno bisogno di un'architettura che funzioni con vincoli reali di sicurezza, latenza e operatività.
Pattern uno: esecuzione in-database
Il pattern di implementazione più solido oggi è l'esecuzione in-database. Il cambiamento importante riguarda il luogo in cui avviene l'elaborazione. Invece di estrarre i dati in una piattaforma del fornitore per profilazione e rilevamento delle anomalie, la piattaforma invia l'elaborazione al data warehouse, al data lake o all'ambiente privato in cui i dati risiedono già.
Questo pattern conta per tre motivi:
Sicurezza. I record sensibili restano nell'ambiente controllato.
Prestazioni. Si evitano spostamenti inutili e storage duplicato.
Adattamento operativo. I team su private cloud e on-premises possono adottare un monitoraggio moderno senza riprogettare l'accesso ai dati.
La direzione architetturale sta diventando più visibile nelle discussioni più lungimiranti. Il riferimento PMC sulla validazione localizzata e sull'esecuzione sui dati residenti descrive una tendenza emergente tra il 2025 e il 2026 verso l'esecuzione in-database, in cui i modelli di AI vengono eseguiti direttamente sui dati residenti per rilevare anomalie come variazioni di distribuzione o modifiche dello schema senza estrazione. Osserva inoltre che questo ambito resta poco presidiato, perché raramente i fornitori spiegano il cambiamento con sufficiente chiarezza da permettere agli ingegneri di implementarlo con sicurezza.
Pattern due: separare il monitoraggio adattivo dai controlli espliciti
I team ottengono risultati migliori quando separano due compiti che spesso vengono confusi.
Usate metodi adattivi per il rilevamento basato sul comportamento. Rientrano qui distribuzioni che cambiano, cali di volume, picchi sospetti, stagionalità in evoluzione o partizioni in ritardo.
Usate controlli espliciti per le regole contrattuali e di business. Rientrano qui limiti sui valori nulli, appartenenza a enum, controlli referenziali, intervalli di valori normativi e prevenzione dei duplicati.
Quando un team cerca di risolvere entrambi i problemi solo con regole statiche, la manutenzione cresce rapidamente. Quando cerca di risolverli entrambi solo con il rilevamento delle anomalie, perde le garanzie rigide di cui il business ha ancora bisogno.
Pattern tre: osservare struttura e arrivo, non solo i valori
Un data quality framework moderno dovrebbe monitorare più del contenuto delle righe.
Le modifiche dello schema possono rompere la logica a valle senza essere rilevate subito. Colonne aggiunte, colonne rimosse, cambi di tipo e campi rinominati spesso superano i controlli di salute dell'infrastruttura, per poi rompere trasformazioni o logiche di BI in un secondo momento. Lo stesso vale per i problemi di tempestività. Una tabella può essere valida e completa quando finalmente arriva, ma comunque troppo tardi per il caso d'uso.
Un blueprint di implementazione pratico è semplice:
Calcolate le metriche nella piattaforma in cui risiedono i dati sulle tabelle prioritarie.
Apprendete le baseline del comportamento normale sui segnali selezionati.
Tracciate schema e tempestività insieme alla qualità del contenuto.
Esponete solo metriche, avvisi e diagnostica all'interfaccia operativa.
Questo design offre ai team di engineering i vantaggi di un monitoraggio moderno basato sull'AI senza accettare i costi di sicurezza e di spostamento dei dati degli strumenti basati sull'estrazione.
Definire SLA e SLO di data quality significativi
Lunedì, ore 8:05: la dashboard è verde, la pipeline è terminata e il business ha comunque preso la decisione sbagliata perché i dati sono arrivati con quaranta minuti di ritardo. È questo il divario che SLA e SLO devono colmare. Dovrebbero definire che cosa sia un fallimento per il business, non solo che cosa sia passato nella pipeline.
Uno SLA è la promessa fatta a un consumatore dei dati. Uno SLO è l'obiettivo interno che lascia al team un margine sufficiente per mantenere quella promessa. Un KPI misura se il programma migliora nel tempo.
I team si mettono nei guai quando scrivono obiettivi facili da riportare e difficili da usare. “Disponibilità” suona bene finché una tabella è presente ma obsoleta. “Completezza” suona bene finché ogni campo obbligatorio viene compilato dopo che la finestra decisionale è già passata. Per i carichi di lavoro di AI e analytics, queste lacune contano, perché la qualità dipende dal fatto che i dati fossero adatti alla decisione nel momento in cui sono stati usati.
Definite gli SLO partendo dal punto di consumo e procedendo a ritroso. Iniziate dal report, dal modello, dal workflow o dall'impegno verso il cliente. Poi definite la condizione di qualità che deve valere per quel caso d'uso. Una segnalazione regolamentare e una pipeline di fraud scoring non dovrebbero condividere lo stesso obiettivo di tempestività. La prima può tollerare ritardi e quasi nessun errore di validità. La seconda può tollerare piccole lacune, ma non dati in ritardo.
È anche qui che conta la disciplina di implementazione. In uno stack moderno, il modo migliore per far rispettare questi obiettivi è valutarli dove i dati risiedono già, esponendo poi ai team che ne hanno bisogno solo risultati, eccezioni e dettagli di audit. Si evita così di copiare dati sensibili in un altro servizio solo per misurare se hanno rispettato un contratto.
Esempi di SLO di data quality per dimensione
Un modo pratico per definire gli obiettivi è collegare ciascuno di essi a una decisione operativa e a un responsabile. Questa guida su come misurare l'affidabilità dei dati in condizioni operative reali è un riferimento utile per trasformare obiettivi di qualità generici in soglie misurabili.
Dimensione | Esempio di SLO | Impatto sul business |
|---|---|---|
Accuratezza | I valori di riferimento critici devono corrispondere alla logica della sorgente approvata prima della pubblicazione | Evita decisioni basate su fatti errati |
Completezza | Gli identificativi obbligatori nei dataset di reporting finanziario devono restare sotto la soglia di valori nulli accettata per il caso d'uso di reporting | Mantiene i report utilizzabili e verificabili |
Coerenza | Le entità di business condivise devono usare definizioni allineate in tutti i sistemi di reporting | Riduce il lavoro di riconciliazione |
Tempestività | Gli input per gli analytics in tempo reale devono essere aggiornati entro 15 minuti dall'aggiornamento della sorgente, per i casi d'uso che dipendono da dati attuali | Protegge le decisioni sensibili ai tempi |
Validità | I valori soggetti a regole normative o contrattuali devono rispettare intervalli e formati definiti | Riduce il rischio di compliance e di elaborazione a valle |
Unicità | Le chiavi di business che rappresentano una singola entità devono restare prive di duplicati entro la tolleranza accettata per il dominio | Evita doppi conteggi e confusione sulle identità |
I buoni SLO hanno anche una logica di risposta alle spalle. Chi viene allertato. Quale violazione blocca la pubblicazione. Quale violazione genera un avviso ma consente l'uso a valle. Senza tutto questo, durante un incidente i team finiscono per discutere della severità invece di agire sulla base di un contratto concordato in anticipo.
Il test è semplice. Uno SLO utile dice all'ingegnere di turno che cosa fare dopo e dice al consumatore dei dati quale rischio sta accettando.
Una roadmap a fasi per implementare il vostro framework
Un rollout di solito fallisce la prima volta che un team cerca di applicare tutte le regole a tutte le tabelle contemporaneamente. La strada pratica è più stretta. Iniziate dai dati che possono rompere un report, ritardare un workflow verso i clienti o innescare una decisione operativa sbagliata. Dimostrate che il framework funziona sotto la pressione della produzione, poi estendetelo.
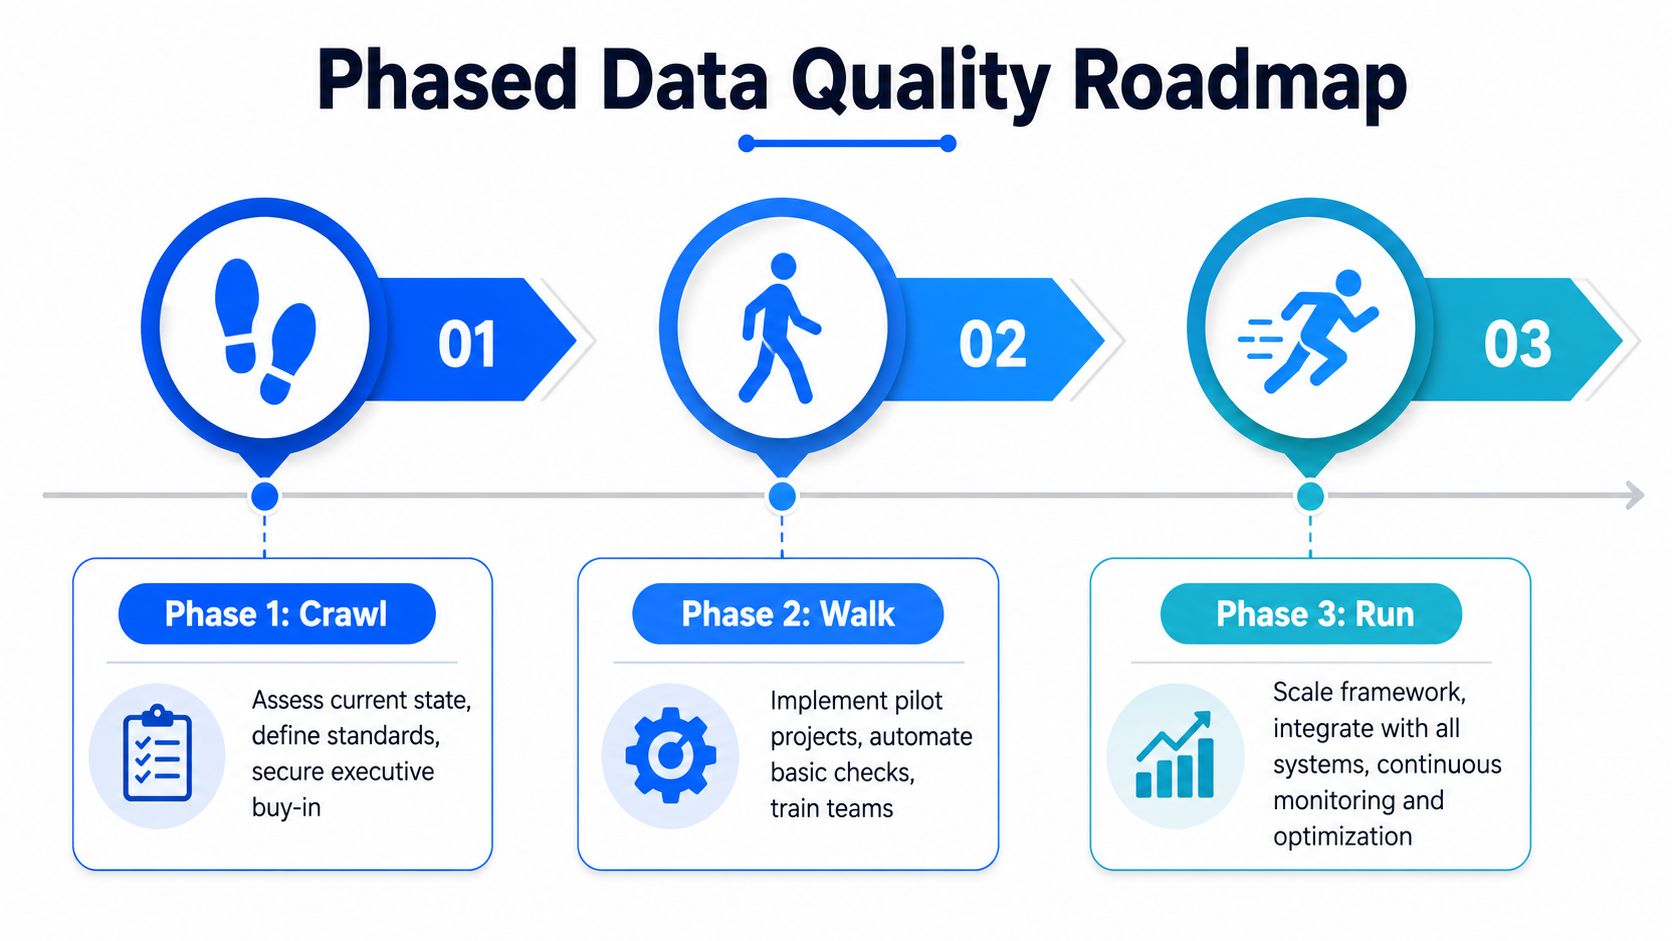
Fase 1: gattonare
Iniziate con uno o due dataset critici legati a un processo di business reale. Questo perimetro è importante. Un ambito ridotto rende più facile individuare il data owner, definire soglie accettabili e capire se gli avvisi portano ad azioni concrete o creano solo rumore.
Usate questa fase per rispondere ad alcune domande operative. Quali controlli vanno nel data warehouse o nel lakehouse, dove i dati risiedono già? Quali fallimenti devono bloccare la pubblicazione? Chi esamina una violazione durante l'orario di lavoro e chi viene allertato fuori orario? Un framework diventa utile quando queste decisioni vengono prese presto.
Concentratevi su un breve elenco di controlli che fanno emergere rapidamente i rischi:
Controlli di tempestività per caricamenti pianificati, finestre di freschezza e arrivi mancati
Controlli di completezza sui campi obbligatori che modelli o report a valle non possono tollerare come nulli
Regole di validità per attributi critici per il business, come codici di stato, date e valori regolamentati
Mantenete l'esecuzione vicina ai dati fin dal primo giorno. Eseguire i controlli in-database evita di copiare record sensibili in un altro servizio, riduce gli attriti di configurazione con i team di sicurezza e mantiene l'elaborazione allineata alla piattaforma che i vostri ingegneri già gestiscono.
Fase 2: camminare
Estendete il framework dopo che il pilota produce avvisi di cui le persone si fidano e su cui agiscono. In questa fase l'obiettivo non è un'ampia copertura, ma un funzionamento ripetibile su più pipeline, team e cicli di rilascio.
È in questa fase che il processo si consolida o va in pezzi. I data owner approvano le soglie. Gli steward affinano le regole di business rimaste troppo vaghe nel pilota. Gli ingegneri collegano la validazione all'orchestrazione, alle pipeline di CI e alle fasi di pubblicazione, così che i controlli di qualità vengano eseguiti come parte della delivery e non come una revisione separata. Le dashboard aiutano, ma i percorsi di risposta contano più della parte visiva.
Anche il pattern di implementazione inizia a contare di più. Gli scanner esterni possono funzionare per dati campionati o replicati, ma aggiungono spostamenti di dati, lavoro sui permessi e un ulteriore luogo in cui conservare informazioni sensibili. L'esecuzione in-database evita questo compromesso. I team possono eseguire rilevamento delle anomalie, controlli dello schema e validazione basata su regole dove si trovano già i dati governati, il che di solito semplifica la revisione di sicurezza e accelera la remediation.
Fase 3: correre
Ora è il momento di ottimizzare.
Le regole statiche contano ancora, ma non bastano più quando i volumi crescono e il comportamento delle sorgenti cambia. Aggiungete un monitoraggio adattivo per variazioni di distribuzione, dati in ritardo, schema drift e pattern che superano le soglie esistenti senza violare una regola semplice. Esaminate i falsi positivi con la stessa disciplina che applicate agli incidenti reali. Un sistema rumoroso viene ignorato. Uno silenzioso fallisce in modi più costosi.
Questa è anche la fase in cui i team collegano la qualità all'economia dell'engineering. Alcuni controlli vanno in fase di ingestion, perché intercettano i record errati prima che si diffondano. Altri vanno prima della pubblicazione, perché al business interessa solo l'output curato. I buoni framework usano entrambi. La collocazione giusta dipende da dove un guasto è più economico da rilevare, più facile da spiegare e più sicuro da contenere.
Quando la roadmap funziona, la qualità smette di essere un progetto collaterale. Diventa parte del modo in cui la piattaforma distribuisce i dati in sicurezza.
Se il vostro team vuole implementare un data quality framework moderno senza spostare dati sensibili in un ambiente esterno, digna è un'opzione da valutare. Supporta rilevamento delle anomalie, validazione, monitoraggio della tempestività e tracciamento dello schema con esecuzione in-database in ambienti controllati dal cliente.
Per vedere come dimensioni, validazione e monitoraggio di questo framework si integrano in un'unica configurazione in-database, approfondite la gestione della data quality con digna.
Domande frequenti
Quali sono le sei dimensioni di un data quality framework?
Sono accuratezza, completezza, coerenza, tempestività, validità e unicità. Un cliente indicato come attivo dopo la chiusura del conto viola l'accuratezza, mentre sinistri o ordini duplicati violano l'unicità. Il lavoro pratico consiste nello scegliere quali dimensioni contano per ciascun dataset ed esprimerle come controlli eseguiti in sicurezza all'interno del vostro ambiente.
Chi è responsabile della data quality in un data quality framework?
La responsabilità è condivisa da tre ruoli. I data owner decidono che cosa significhi qualità, approvano le soglie e valutano le eccezioni. I data steward traducono le policy in standard, come valori validi e convenzioni di denominazione. I data custodian o ingegneri implementano i controlli nelle pipeline e configurano gli avvisi. Se una sola persona svolge tutti e tre i compiti, il framework non scalerà.
Qual è la differenza tra monitoraggio della data quality e validazione dei dati?
Il monitoraggio gestisce le incognite sconosciute chiedendosi se un dataset si comporta ancora come al solito, usando baseline adattive per volume, distribuzione e freschezza. La validazione gestisce ciò che è noto: regole esplicite a livello di record, per esempio che lo stato di un sinistro appartenga a un elenco approvato o che una chiave di business composta non abbia duplicati. Un framework ha bisogno di entrambi.
Come si definiscono gli SLO di data quality?
Si procede a ritroso dal punto di consumo: il report, il modello, il workflow o l'impegno verso il cliente. Uno SLA è la promessa fatta a un consumatore e lo SLO è l'obiettivo interno che lascia un margine per mantenerla. Un esempio richiede che gli input per gli analytics in tempo reale si aggiornino entro 15 minuti da un aggiornamento della sorgente.
Come si implementa un data quality framework passo dopo passo?
Seguite una roadmap in tre fasi: gattonare, camminare, correre. Gattonate con uno o due dataset critici e controlli di tempestività, completezza e validità. Camminate collegando la validazione all'orchestrazione, alle pipeline di CI e alle fasi di pubblicazione, una volta che gli avvisi sono affidabili. Correte aggiungendo un monitoraggio adattivo per variazioni di distribuzione, dati in ritardo e schema drift, ed esaminando i falsi positivi.


