Piattaforma di data quality: gli elementi essenziali per gli stack dati enterprise
|
6
min di lettura

La presentazione per il consiglio di amministrazione sembra a posto finché non si apre la dashboard finanziaria e metà dei numeri non corrisponde al data warehouse. Il team BI si mette a inseguire una modifica di schema fantasma, i data engineer scavano tra i caricamenti in ritardo e il management chiede perché il report “affidabile” di ieri ora sembri inattendibile. È in quel momento che una piattaforma di data quality smette di essere un optional e diventa parte del modello operativo, perché i dati corrotti non restano in un solo punto: si propagano nei report, nei modelli e nelle decisioni.
Una buona piattaforma offre ai team un modo per accorgersi presto dei problemi, dimostrare che cosa è cambiato e impedire che il caos si propaghi a valle. In Europa questa pressione cresce sia nel settore pubblico sia in quello privato, dai controlli sui metadati negli open data ai requisiti di private cloud nei settori regolamentati. Se vi è mai capitato di dover spiegare perché una dashboard è cambiata durante la notte, sapete già perché questo è importante. Per un punto di partenza sintetico, leggete che cosa si intende in pratica per data quality.
Introduzione alla piattaforma di data quality
Il modo più semplice per capire una piattaforma di data quality è pensare a una linea di produzione con punti di ispezione. Le materie prime entrano, a ogni fase vengono effettuati controlli e qualsiasi elemento piegato, mancante o fuori specifica viene segnalato prima di lasciare la fabbrica. Le pipeline di dati funzionano allo stesso modo, solo che il “prodotto” è un report, l'input di un modello o una segnalazione regolamentare.
Quando la pipeline è in salute, i team si muovono rapidamente perché si fidano di ciò che vedono. Quando non lo è, ogni utilizzatore diventa un investigatore. La finanza mette in dubbio la contabilità, gli analisti mettono in dubbio la dashboard e gli ingegneri mettono in dubbio il job di ingestion, anche quando il problema di fondo è un file in ritardo, un campo rinominato o un record duplicato.
Ecco perché questa categoria si colloca oggi tra data engineering, governance, observability e analytics. Non si tratta solo di intercettare valori errati. Si tratta di preservare la fiducia lungo tutta la catena, dal sistema sorgente al data warehouse fino al livello di BI, così che il business possa agire senza rimettere in discussione ogni grafico.
Regola pratica: se una tabella corrotta può arrivare in un report per il CdA prima che qualcuno se ne accorga, il vostro monitoraggio è troppo superficiale.
Una piattaforma solida vi offre un modo ripetibile per rilevare, spiegare e gestire i problemi di qualità. Dovrebbe aiutarvi a mantenere i dati in movimento, tenere informati gli utenti e preservare gli audit trail quando qualcosa cambia. Per approfondire il concetto di base, la panoramica interna sulle dimensioni della data quality aiuta a collegare l'idea di qualità ai segnali che potete misurare.
Comprendere i concetti chiave
Un modello mentale utile parte da tre livelli. Primo, la piattaforma osserva i dati stessi. Secondo, osserva la forma dei dati, cioè campi, tipi, intestazioni e metadati. Terzo, osserva il comportamento nel tempo, ad esempio se un feed è arrivato quando doveva e se una metrica si è allontanata dal suo andamento abituale.
I metadati sono l'etichetta sulla scatola
Se l'etichetta è sbagliata, anche un contenuto perfetto può creare confusione. Ecco perché l'igiene dei metadati è così importante negli open data pubblici e nei cataloghi aziendali. L'Unione Europea sta migliorando la qualità dei metadati degli open data attraverso lo strumento MQA, una dashboard strutturata introdotta da data.europa.eu per valutare la conformità a DCAT-AP, la leggibilità automatica e la chiarezza delle licenze nei portali di dati nazionali e regionali.
Questo è importante perché spesso i metadati vengono trattati come lavoro amministrativo, per poi chiedersi perché gli utenti a valle non riescano a trovare il dataset, a fidarsene o a riutilizzarlo. Nella pratica, la qualità dei metadati è il primo filtro per la reperibilità e la governance. Se il portale non riesce a descrivere l'asset in modo chiaro, il resto della pipeline parte su basi deboli.
La qualità è più della correttezza
A volte gli ingegneri riducono la qualità alla distinzione tra righe valide e non valide, ma così perdono di vista il quadro operativo. Una riga può essere tecnicamente valida e tuttavia arrivare troppo tardi, duplicare il feed di ieri o rompere una dashboard a causa di una modifica di schema inattesa. Una piattaforma deve sorvegliare tutte queste condizioni, non solo i valori malformati.
Ecco perché l'observability rientra nella definizione. Un sistema che verifica un solo set di regole è come un ispettore di fabbrica che misura la dimensione dei bulloni ma ignora se i pezzi sono arrivati in tempo o se il progetto è cambiato. Un buon strumento di qualità combina la validazione statica con la consapevolezza delle tendenze e i controlli sulle consegne, così i team possono vedere sia i guasti evidenti sia le derive più sottili.
Le piattaforme più utili aiutano anche gli utenti a ricostruire cause ed effetti. Non si limitano a dire “qualcosa è cambiato”. Mostrano se il cambiamento è nuovo, ricorrente o parte di una tendenza più lunga, ed è questo che trasforma alert rumorosi in un supporto alle decisioni. Per una spiegazione correlata di come i team misurano la qualità sulle diverse dimensioni, leggete la visione delle dimensioni della data quality dal punto di vista della piattaforma.
Le funzionalità chiave
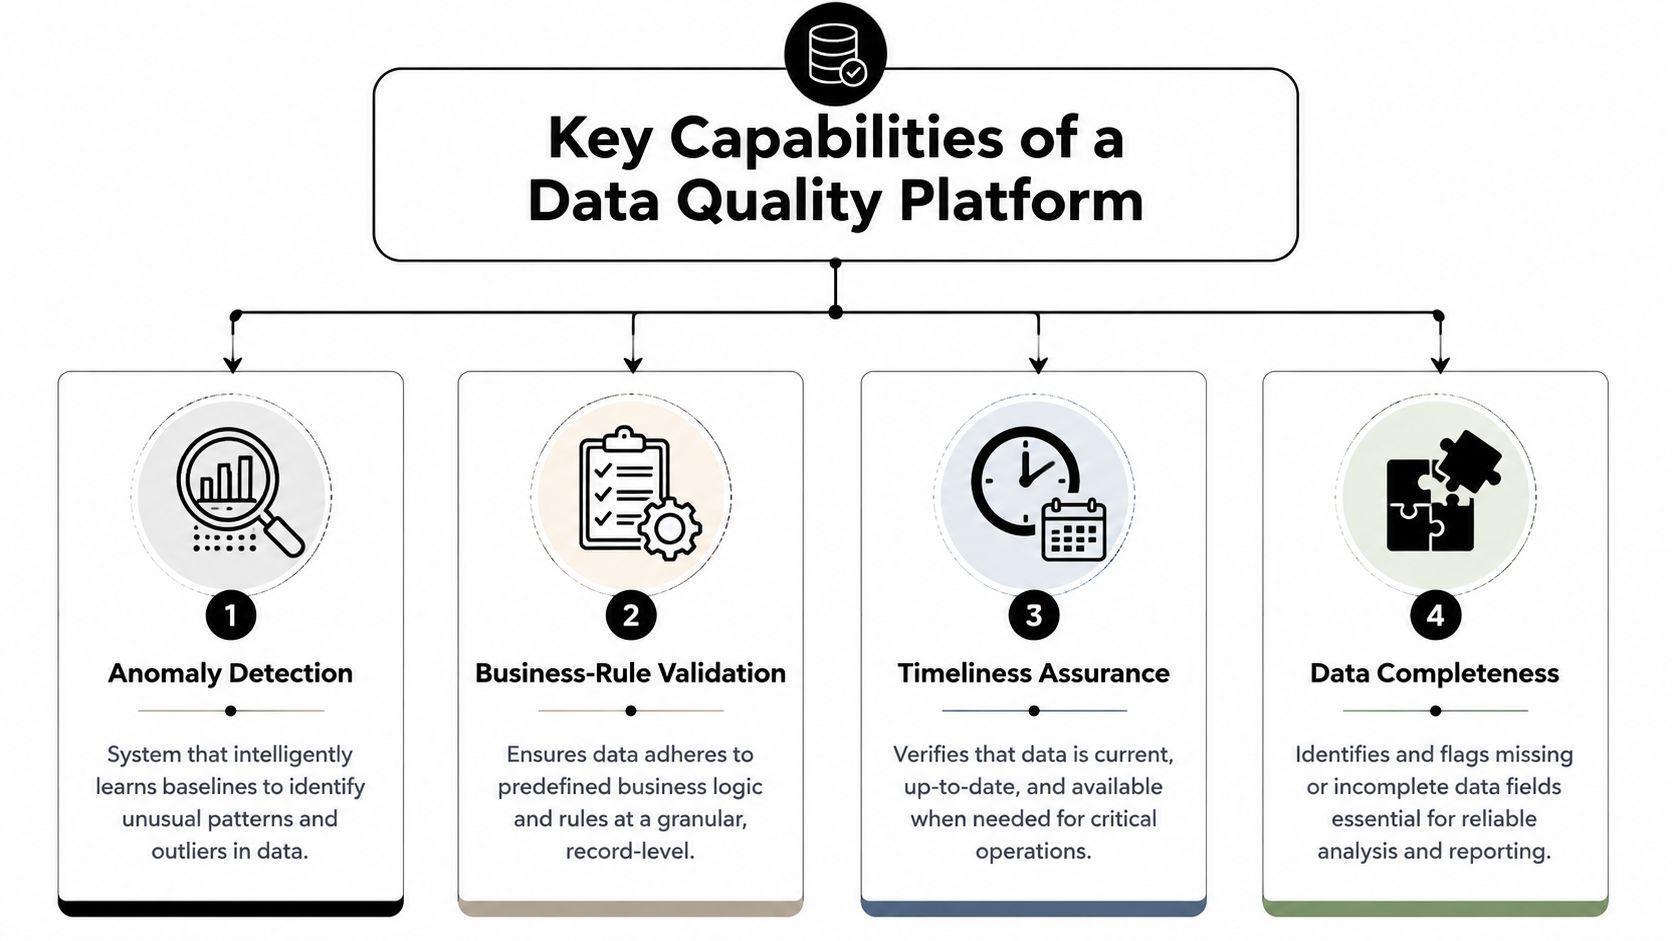
Una piattaforma seria di solito si guadagna il proprio posto grazie a quattro funzionalità, ciascuna delle quali risolve una diversa modalità di guasto. Se le confondete, vi ritrovate con lacune che sembrano piccole in una demo e costose in produzione.
Anomaly detection che apprende il comportamento normale
Gli strumenti di anomaly detection più efficaci non si basano solo su soglie rigide. Secondo la spiegazione tecnica di digna, Data Anomalies apprende automaticamente la baseline comportamentale di ogni dataset monitorato e segnala le deviazioni non appena si presentano. Questo conta quando i vostri dati sono stagionali, irregolari o influenzati da cicli di business che renderebbero rumorose le regole statiche.
digna afferma inoltre che il suo modulo Data Anomalies rileva modifiche inattese nella qualità dei dati e nei KPI di business o operativi senza soglie o regole manuali, e calcola e monitora metriche come Sum, Min e i conteggi dei valori su ogni colonna e su tre tipi di dati. In parole semplici, la piattaforma non aspetta che siate voi a dirle ogni volta che aspetto abbia esattamente un dato “errato”.
Validazione delle regole di business a livello di record
La piattaforma consente ai team di passare da un monitoraggio ampio a un'applicazione concreta delle regole. Se un record cliente deve includere un codice regione, o una fattura deve soddisfare una condizione di policy prima di arrivare alla finanza, la piattaforma deve verificare quella regola riga per riga. È così che i team regolamentati mantengono una logica coerente tra i domini senza dipendere dalla revisione manuale.
Monitoraggio della tempestività e delle pianificazioni di consegna
I dati in ritardo possono essere dannosi quanto i dati errati. Un feed che arriva dopo la scadenza del report crea un falso senso di completezza, e la dashboard sembra comunque “pulita” anche se non è aggiornata. La piattaforma giusta sorveglia i pattern di arrivo e il rispetto delle pianificazioni, così gli utenti sanno se la pipeline è aggiornata.
Tracciamento dello schema drift e segnali di completezza
Lo schema drift si manifesta quando i campi vengono aggiunti, rimossi o rimodellati in modi che rompono i sistemi a valle. La completezza, invece, intercetta le parti mancanti che rendono inaffidabile l'analisi anche quando la tabella viene comunque caricata. Il miglior monitoraggio fa emergere entrambi gli aspetti, perché sviluppatori BI e ML engineer hanno bisogno di avvisi diversi dalla stessa pipeline.
Secondo la panoramica della piattaforma digna, il sistema calcola automaticamente le metriche dei dati in-database, apprende le baseline, analizza le tendenze, monitora le pianificazioni di arrivo, calcola l'orario di consegna atteso e segnala lo schema drift da un'unica interfaccia, mantenendo l'analisi all'interno del database del cliente. Per uno sguardo più da vicino ai flussi di monitoraggio, consultate la panoramica degli strumenti di monitoraggio di digna.
L'alert fatigue di solito significa che la piattaforma controlla i sintomi, non i pattern. Se lo stesso team ignora ogni messaggio, il problema è probabilmente nella progettazione dei controlli, non nelle persone che li ricevono.
Confronto tra pattern architetturali
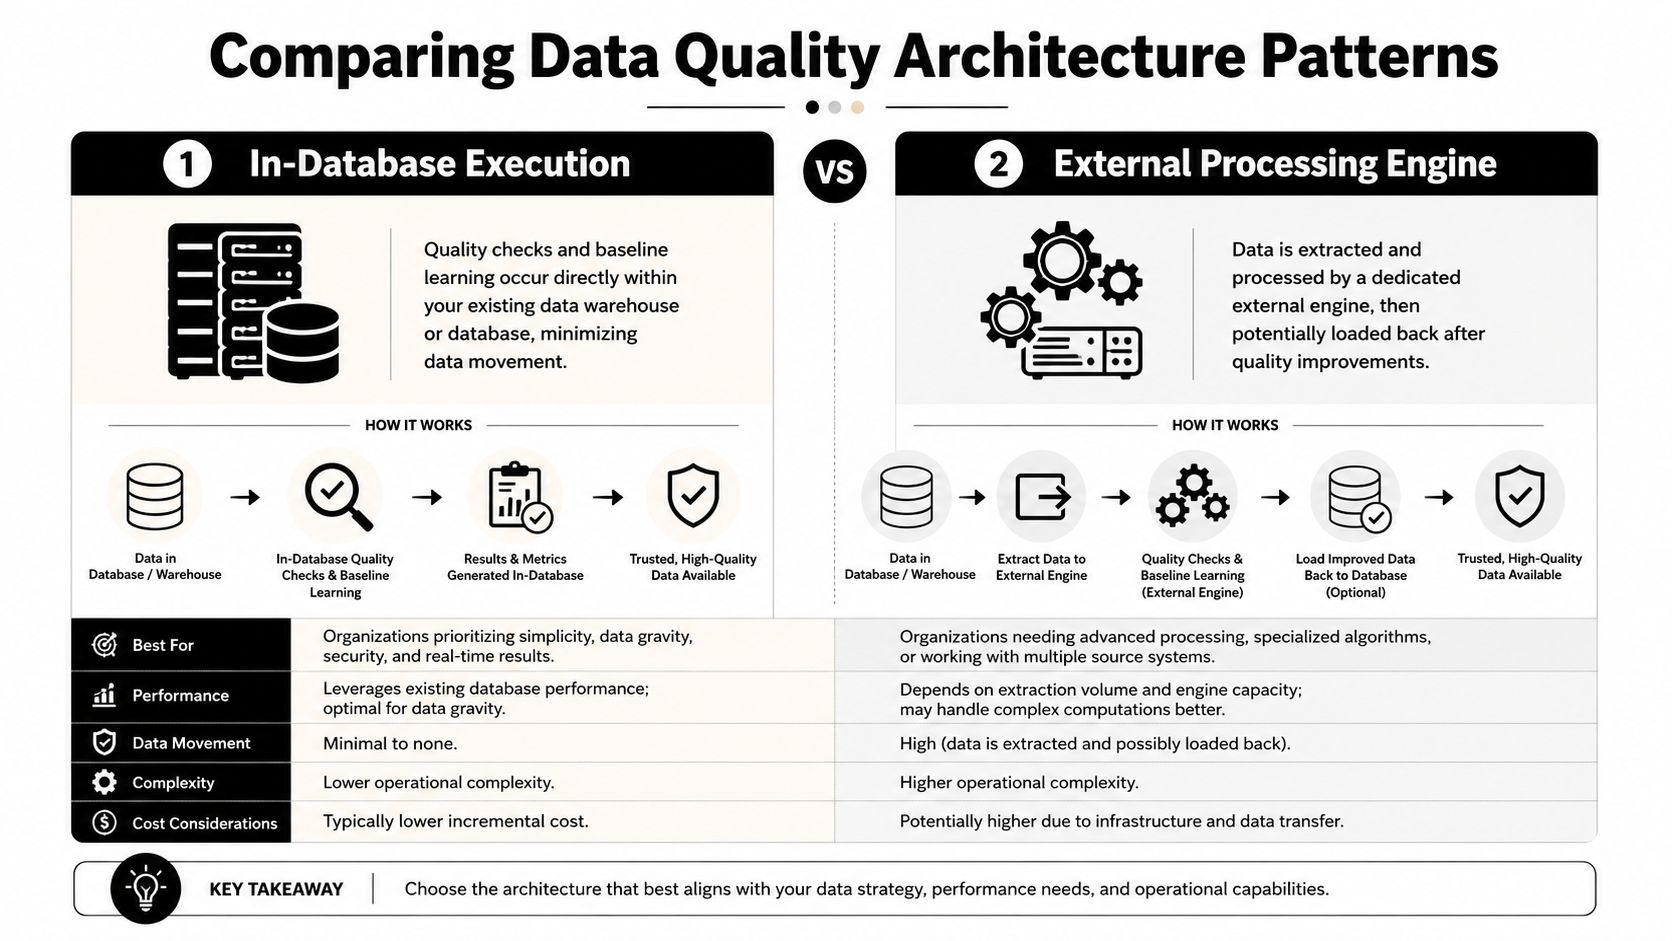
L'architettura cambia tutto. Due piattaforme possono promettere controlli simili e poi comportarsi in modo molto diverso quando si confrontano con volumi di dati reali, controlli di sicurezza e vincoli operativi.
Esecuzione in-database
In questo modello, i controlli e l'apprendimento delle baseline avvengono dove i dati risiedono già. Questo riduce gli spostamenti, limita le copie duplicate e mantiene l'analisi all'interno dell'ambiente del cliente. Ha molto senso anche quando i team tengono alla residenza dei dati, all'isolamento delle prestazioni e a un controllo più stretto su chi può vedere i dati di produzione.
La panoramica della piattaforma digna afferma che l'analisi resta all'interno del database del cliente e che la piattaforma è progettata per data warehouse, data lake e pipeline enterprise. Afferma inoltre che il sistema calcola le metriche in-database, esattamente il tipo di architettura che attrae i team che vogliono evitare estrazioni superflue. Per un approfondimento architetturale, vale la pena leggere la pagina sulle piattaforme di data quality in-database.
Motori di elaborazione esterni
Un motore esterno estrae i dati, li elabora altrove e spesso rimanda indietro i risultati. Può funzionare bene in alcuni stack, soprattutto quando l'ecosistema circostante prevede già livelli di calcolo separati. Il compromesso, però, è evidente: lo spostamento dei dati introduce più punti in cui controllo degli accessi, latenza e interazione con il fornitore possono diventare criticità.
Come valutare il compromesso
Se la vostra organizzazione privilegia il massimo isolamento, meno copie e un controllo più stretto, l'esecuzione in-database è di solito più facile da giustificare. Se il vostro team preferisce un livello di elaborazione separato e non si preoccupa degli spostamenti aggiuntivi, un motore esterno può comunque andare bene, ma richiede un esame più attento sotto il profilo della privacy e delle operations.
Gli acquirenti europei tengono spesso a questa distinzione per un buon motivo. Il dibattito di mercato sugli strumenti di data quality è ancora fortemente orientato ai flussi di lavoro SaaS, mentre una panoramica delle recensioni Gartner sulle soluzioni di augmented data quality evidenzia la persistente necessità di deployment in private cloud e on-premises nei contesti regolamentati. La questione architetturale non è astratta. Incide su chi può accedere ai dati, su dove avviene l'elaborazione e su quante prove potete fornire agli auditor.
Scegliere la piattaforma giusta

La selezione funziona meglio quando si separa la “bella demo” dalla domanda “sopravvivrà alla settimana dell'audit?”. Una piattaforma può mostrare dashboard accattivanti, ma la vera prova è se si adatta ai vostri vincoli operativi, soprattutto in Europa, dove privacy, residenza dei dati e governance contano spesso quanto il numero di funzionalità.
Partite dai controlli che corrispondono al vostro rischio
Se il vostro problema principale sono i feed interrotti, date priorità al monitoraggio della tempestività e delle consegne. Se i vostri team di finanza o reporting hanno bisogno di prove che le righe corrispondano ancora dopo le trasformazioni, date priorità alla riconciliazione e alla validazione a livello di record. Questa lacuna è importante perché, come osservato nella sezione precedente, molti strumenti parlano di anomaly detection e schema drift ma non rispondono alla questione della prova a livello di riga tra sorgente, data warehouse e livello di BI.
Poi verificate l'architettura rispetto alle vostre policy
Un secondo aspetto poco trattato è il deployment nel rispetto della privacy in ambienti controllati. Gli acquirenti sul mercato spagnolo chiedono spesso se una piattaforma possa funzionare in private cloud o on-premises senza accesso da parte del fornitore, soprattutto nei settori regolamentati, ma la maggior parte dei contenuti pubblici sulle piattaforme di data quality è ancora incentrata su flussi di lavoro in stile SaaS e su alert generici. Se il vostro team di sicurezza richiede l'assenza di esfiltrazione dei dati o controlli rigorosi sulla residenza, questo criterio deve stare in cima alla shortlist, non relegato a una nota a piè di pagina.
Usate una checklist pratica per i fornitori
Esecuzione in-database: verificate che la piattaforma possa eseguire i controlli dove risiedono i vostri dati, perché questo riduce gli spostamenti superflui.
Scalabilità e prestazioni: chiedete come si comporta quando le pipeline crescono o quando molti controlli vengono eseguiti contemporaneamente.
Capacità di integrazione: verificate che si inserisca nel vostro stack di data warehouse, data lake, BI e orchestrazione senza soluzioni di ripiego macchinose.
Esperienza utente: assicuratevi che sia i data steward sia gli ingegneri possano utilizzarla senza un'assistenza continua.
Rapporto costo-efficacia: confrontate l'intero onere operativo, non solo i costi di licenza.
Supporto del fornitore e community: verificate la qualità della documentazione, i tempi di risposta e se rischiate di dover risolvere da soli i casi limite.
La documentazione di digna afferma che la piattaforma funziona interamente on-premises o in private cloud, non richiede la scrittura di regole e monitora continuamente la qualità delle consegne con un rilevamento basato sull'AI degli errori silenziosi nei dati, come record mancanti, duplicati o corrotti. Questo la rende una candidata per i team che vogliono deployment controllato e monitoraggio operativo nello stesso sistema, anche se va comunque valutata insieme ad altre opzioni della stessa categoria. Per un criterio di confronto più ampio, questa panoramica comparativa delle piattaforme può aiutarvi a strutturare i colloqui con i fornitori.
Esempi concreti
Una banca europea di medie dimensioni che si prepara a un audit regolamentare scopre spesso che il suo sistema di core banking e la sua piattaforma di wealth management non descrivono allo stesso modo la stessa relazione con il cliente. Un sistema può mostrare un conto come attivo mentre un altro riporta ancora uno stato di chiusura obsoleto, oppure i saldi possono quadrare a livello di report ma non a livello di singolo record. Una piattaforma di data quality con controlli di riconciliazione consente al team di confrontare questi record tra i diversi silos prima che la discrepanza arrivi nella documentazione per l'audit, dove anche una piccola incoerenza può sollevare domande da parte dei revisori di compliance e rallentare l'approvazione. L'aspetto utile non è solo che i numeri sembrino corretti, ma che le righe sottostanti possano essere tracciate dalla sorgente al report senza derive silenziose.
Un operatore di telecomunicazioni di solito si imbatte in uno schema diverso. Gli eventi di utilizzo dei clienti possono passare dagli switch di rete a un archivio di fatturazione e poi a un data warehouse di customer analytics, e un solo batch in ritardo può far sembrare guasta una giornata del tutto normale. Se la piattaforma rileva un calo improvviso dei call detail record o un picco di righe di utilizzo duplicate, il team può distinguere un arrivo in ritardo da un vero errore di elaborazione e intervenire prima che inizino ad accumularsi le contestazioni sulle fatture. Questo tipo di monitoraggio funziona meglio quando i controlli di tempestività e l'anomaly detection vengono letti insieme, come due spie sullo stesso pannello di controllo anziché come allarmi separati.
Un ente pubblico spesso tiene ai confini di controllo più che alla velocità. Può avere la necessità di validare i dati dei cittadini, le modifiche agli schemi e i campi mancanti mantenendo i dati di produzione all'interno del proprio ambiente, soprattutto dove le norme sulla privacy e le approvazioni interne limitano fin dove i record possono spostarsi. In questo contesto l'esecuzione in-database è interessante perché i controlli vengono eseguiti accanto ai dati, invece di copiare righe sensibili in un processo separato controllato da un fornitore. Per le aziende europee, questo stile di deployment conta quando l'obiettivo è soddisfare i requisiti di controllo senza rinunciare a un monitoraggio concreto sul dataset in produzione.
Le implementazioni più riuscite di solito combinano riconciliazione a livello di record, controllo su dove avviene l'elaborazione e una visione chiara di chi deve difendere il risultato. Questa combinazione conta più di qualsiasi singola funzionalità riportata in una scheda prodotto.
Conclusioni e prossimi passi
Una piattaforma di data quality è, in sostanza, un livello di fiducia. Protegge le pipeline dai guasti silenziosi, aiuta i team a dimostrare che cosa è cambiato e dà agli utenti di business un motivo per credere alla dashboard che hanno davanti. Le scelte fondamentali sono semplici una volta distinte: anomaly detection o validazione tramite regole, tempestività o schema drift, esecuzione in-database o elaborazione esterna.
Il passo successivo è mettere alla prova la piattaforma in condizioni reali, non sulle slide. Prendete un feed interrotto, un report critico e un dataset regolamentato, poi verificate se la piattaforma riesce a rilevare il problema, a spiegarlo con chiarezza e a mantenere i dati all'interno dell'ambiente previsto dal vostro team di sicurezza. Se non ci riesce, non è pronta per stare al centro del vostro stack.
Un buon progetto pilota impone anche un allineamento tra ingegneri, governance e stakeholder di business. Devono concordare che cosa significhi “qualità”, chi riceve gli alert e quali prove sono necessarie prima che una metrica torni a essere considerata affidabile. Una volta definito questo, la piattaforma smette di essere l'ennesimo strumento e diventa parte del modo in cui la vostra organizzazione mantiene le promesse fatte a clienti, auditor e decisori.
Prenotate una demo per scoprire come digna riunisce monitoraggio della data quality, validazione e observability in un'unica piattaforma, riducendo la proliferazione di strumenti e migliorando al tempo stesso copertura ed efficacia.
Se la prova a livello di riga tra sorgente, data warehouse e livello di BI è la lacuna della vostra shortlist, scoprite come digna Data Validation applica le regole di business a livello di record.
Domande frequenti
Che cos'è una piattaforma di data quality?
Una piattaforma di data quality è un livello di fiducia che sorveglia i dati lungo una pipeline, come i punti di ispezione su una linea di produzione. Controlla i dati stessi, la loro forma (campi, tipi, metadati) e il loro comportamento nel tempo, così file in ritardo, campi rinominati o record duplicati vengono intercettati prima di arrivare nei report.
Quali funzionalità dovrebbe avere una piattaforma di data quality?
Cercate quattro funzionalità principali, ciascuna dedicata a una diversa modalità di guasto: anomaly detection che apprende il comportamento normale, validazione delle regole di business a livello di record, monitoraggio della tempestività e delle pianificazioni di consegna, e tracciamento dello schema drift con segnali di completezza. Confonderle lascia lacune che sembrano piccole in una demo ma diventano costose in produzione.
Qual è la differenza tra elaborazione della data quality in-database ed esterna?
L'esecuzione in-database esegue i controlli e l'apprendimento delle baseline dove i dati risiedono già, riducendo spostamenti e copie duplicate. I motori esterni estraggono i dati, li elaborano altrove e rimandano indietro i risultati, aggiungendo punti in cui controllo degli accessi, latenza e interazione con il fornitore possono creare problemi. I team regolamentati di solito trovano l'esecuzione in-database più facile da giustificare.
Come si sceglie la piattaforma di data quality giusta?
Si parte dai controlli che corrispondono al proprio rischio: monitoraggio della tempestività per i feed interrotti, riconciliazione e validazione a livello di record per il reporting finanziario. Poi si verifica l'architettura rispetto alle policy di sicurezza, ad esempio on-premises o private cloud senza esfiltrazione dei dati. La checklist dell'articolo copre anche scalabilità, integrazioni, esperienza utente, costo totale e supporto del fornitore.
Come si dovrebbe condurre un progetto pilota per una piattaforma di data quality?
Mettetela alla prova in condizioni reali anziché sulle slide: prendete un feed interrotto, un report critico e un dataset regolamentato. Verificate se la piattaforma rileva il problema, lo spiega con chiarezza e mantiene i dati all'interno del vostro ambiente. Un progetto pilota obbliga inoltre ingegneri, governance e stakeholder di business a concordare che cosa significhi qualità.


