Strumenti di data quality enterprise: guida alla scelta 2026
|
7
min di lettura

Probabilmente anche il vostro team vive oggi lo stesso schema. Il data warehouse sembra in salute, le dashboard sono verdi e la presentazione per il board esce puntuale. Poi una previsione sbaglia clamorosamente perché una tabella a monte ha smesso di aggiornarsi, una modifica di schema è passata inosservata oppure una regola di business è fallita, senza che nessuno se ne accorgesse finché il reparto finance non ha chiesto perché i numeri non tornano più.
È questo il compito degli strumenti di data quality. Non esistono per decorare il modern data stack con l'ennesima dashboard. Esistono per intercettare i guasti silenziosi che minano la fiducia quando i dati sono già arrivati a dirigenti, analisti, clienti o sistemi di AI. Il mercato cresce rapidamente perché il problema non è più opzionale. Il mercato globale degli strumenti di data quality valeva 2,78 miliardi di dollari nel 2025 e dovrebbe raggiungere 7,39 miliardi di dollari entro il 2031, con un CAGR del 17,7%, secondo l'analisi di Mordor Intelligence sul mercato degli strumenti di data quality.
La maggior parte delle guide all'acquisto trascura ancora la decisione che conta davvero. Confrontano funzionalità, loghi e screenshot, ma non impongono una scelta chiara sull'architettura né sul fatto che qualità e observability debbano vivere in strumenti separati. Sono proprio queste le decisioni che determinano accuratezza, costi operativi, postura di sicurezza e quanto rumore il vostro team tollererà prima di iniziare a ignorare gli alert. Se state affrontando le conseguenze di una scarsa qualità dei dati, questa distinzione conta più dell'ennesima checklist di funzionalità generiche.
Indice
Perché vi serve una piattaforma unificata di qualità e observability
Un framework pratico per valutare gli strumenti di data quality
Quando i dati buoni diventano cattivi
Un trimestre negativo inizia spesso con un piccolo evento tecnico. Un sistema sorgente cambia il tipo di un campo. Un batch in ritardo arriva dopo che la logica di reporting è già stata eseguita. Una regola di deduplicazione smette di abbinare i record perché il formato in ingresso è cambiato. Nessuno di questi guasti appare drammatico il primo giorno. Il danno emerge più tardi, quando una previsione per il board, un report sui ricavi o un estratto per la compliance si rivelano sbagliati.
Ecco perché la vecchia definizione di qualità dei dati, ovvero accuratezza, completezza, coerenza e validità, da sola non basta. In pratica, le aziende hanno bisogno di sistemi in grado di rilevare i guasti silenziosi prima che siano gli utenti di business a fare da livello di monitoraggio. La differenza tra “abbiamo dei test” e “ci fidiamo dei nostri dati” sta nel fatto che qualcuno intercetti i problemi prima che dashboard e modelli li assorbano.
Lo schema di fallimento della presentazione al board
Il guasto più comune non è un'interruzione catastrofica. È un numero plausibile con un significato sbagliato. Ieri la freshness sembrava a posto. Il volume sembrava normale. Tecnicamente la pipeline è stata completata. Ma un insieme di record si è duplicato, una regola di business è andata alla deriva oppure una sorgente ha smesso di popolare in modo coerente un campo chiave.
È proprio qui che molti team restano intrappolati. Acquistano strumenti che segnalano i guasti visibili ma non colgono il data drift a basso rumore. Il risultato è un sistema che vi dice quando una tabella è sparita, ma non quando una tabella è ancora lì e sottilmente errata.
I buoni sistemi di dati non si limitano a rispondere a “il job è stato eseguito?”. Rispondono a “il business può fidarsi di ciò che è arrivato?”
Un modo utile di pensare agli strumenti di data quality è considerarli il sistema immunitario della piattaforma dati. Un sistema immunitario sano non aspetta il collasso di un organo. Rileva presto i segnali insoliti, indirizza il problema al responsabile giusto e impedisce che un danno locale diventi sistemico.
Perché gli elenchi di funzionalità non bastano
Moltissimi strumenti sanno profilare un dataset, eseguire asserzioni o inviare alert. Questo però non risolve le domande più difficili:
Dove avviene l'elaborazione? Dentro il database, al di fuori, oppure solo sui metadati.
Che cosa viene validato? Il comportamento della pipeline, le regole di business a livello di record, o entrambi.
Chi riceve la notifica? Platform engineer, data steward di dominio, analisti, oppure nessuno di utile.
Quanto è ampio il punto cieco? Soprattutto quando lo strumento evita di ispezionare direttamente i record.
Sono queste decisioni a stabilire se uno strumento vi aiuterà durante un incidente reale o produrrà soltanto un'altra scheda nello stack.
A cosa servono davvero gli strumenti di data quality
Molti team descrivono gli strumenti di data quality elencandone le funzioni: profilazione, validazione, pulizia, matching, monitoraggio. È corretto, ma non spiega perché siano importanti. In pratica, questi strumenti esistono per rendere ispezionabile la vostra supply chain dei dati.
Pensate a una linea di produzione. Non volete soltanto un'ispezione finale dopo la spedizione del prodotto. Volete controlli sulle materie prime, controlli durante l'assemblaggio, controlli sui tempi e controlli che verifichino se i prodotti finiti rispettano ancora le specifiche originali. Gli strumenti di data quality svolgono lo stesso ruolo lungo ingestion, trasformazione, archiviazione, analytics e utilizzo a valle da parte dell'AI.
Ispezionano molto più degli errori
Alcuni strumenti agiscono come ispettori strutturali: sorvegliano schemi, tipi e pattern delle righe. Altri agiscono come ispettori di processo: monitorano tempestività, freshness e deriva operativa. Le piattaforme più solide agiscono anche come investigatori forensi, aiutando i team a ricondurre una dashboard errata a un caricamento a monte in ritardo o a una trasformazione non funzionante.
Ecco perché lo scopo non è semplicemente “trovare le righe sbagliate”. Lo scopo è costruire fiducia alla velocità che il business oggi si aspetta.
Un modello mentale pratico è questo:
Controlli delle fondamenta: schema tracking, tipi di colonna, pattern dei valori null e deriva strutturale.
Controlli dei materiali: regole di validità, controlli di intervallo, integrità referenziale, duplicati e logica di business.
Controlli di consegna: freshness, orari di arrivo attesi e aggiornamenti in ritardo o mancanti.
Controlli di comportamento: rilevamento delle anomalie su trend, distribuzioni e pattern di utilizzo.
Se lavorate con sistemi di clienti, ricavi o marketing, i problemi di identità sono spesso al centro dei guasti di qualità. Per questo molti team hanno bisogno anche di workflow per ottimizzare i dati di marketing tramite l'identità prima ancora che gli analytics inizino a consumare quei record.
Il vero risultato è la fiducia
Il miglior risultato degli strumenti di data quality non è un numero di difetti più basso sulla carta. È la fiducia operativa. Gli analisti smettono di rivalidare a mano ogni metrica. Il reparto finance si fida delle riconciliazioni alimentate dalle sorgenti. I team di machine learning dedicano meno tempo al debug degli input di training. I responsabili della governance ottengono prove che i controlli funzionano, invece di darlo per scontato.
Regola pratica: se gli utenti di business continuano a chiedere “qual è il numero giusto?” dopo che i vostri controlli sono stati superati, i vostri strumenti stanno misurando l'attività, non la fiducia.
C'è un altro aspetto che i team sottovalutano. Gli strumenti di data quality cambiano la velocità decisionale. Quando le persone si fidano dei record sottostanti e della tempestività della pipeline, si muovono più rapidamente perché non hanno bisogno di un ciclo parallelo di revisione manuale.
Cosa non sono
Non sostituiscono la ownership. Non sono uno strato magico che ripara sistemi sorgente deboli. Non servono a nulla se ogni alert finisce in una casella condivisa di cui nessuno è responsabile.
Una piattaforma solida supporta un modello operativo disciplinato:
La piattaforma rileva il problema.
L'alert include contesto sufficiente per diagnosticarlo.
Raggiunge la persona in grado di risolverlo.
La correzione alimenta controlli migliori.
Senza questo ciclo non avete qualità dei dati. Avete strumentazione.
Le sei capacità chiave delle piattaforme moderne
Le piattaforme moderne richiedono una copertura più ampia rispetto alle suite di data quality tradizionali. Devono proteggere contemporaneamente dashboard, input dell'AI e workflow regolamentati. Ciò significa combinare il rilevamento tecnico con l'instradamento operativo e l'applicazione delle regole di business.
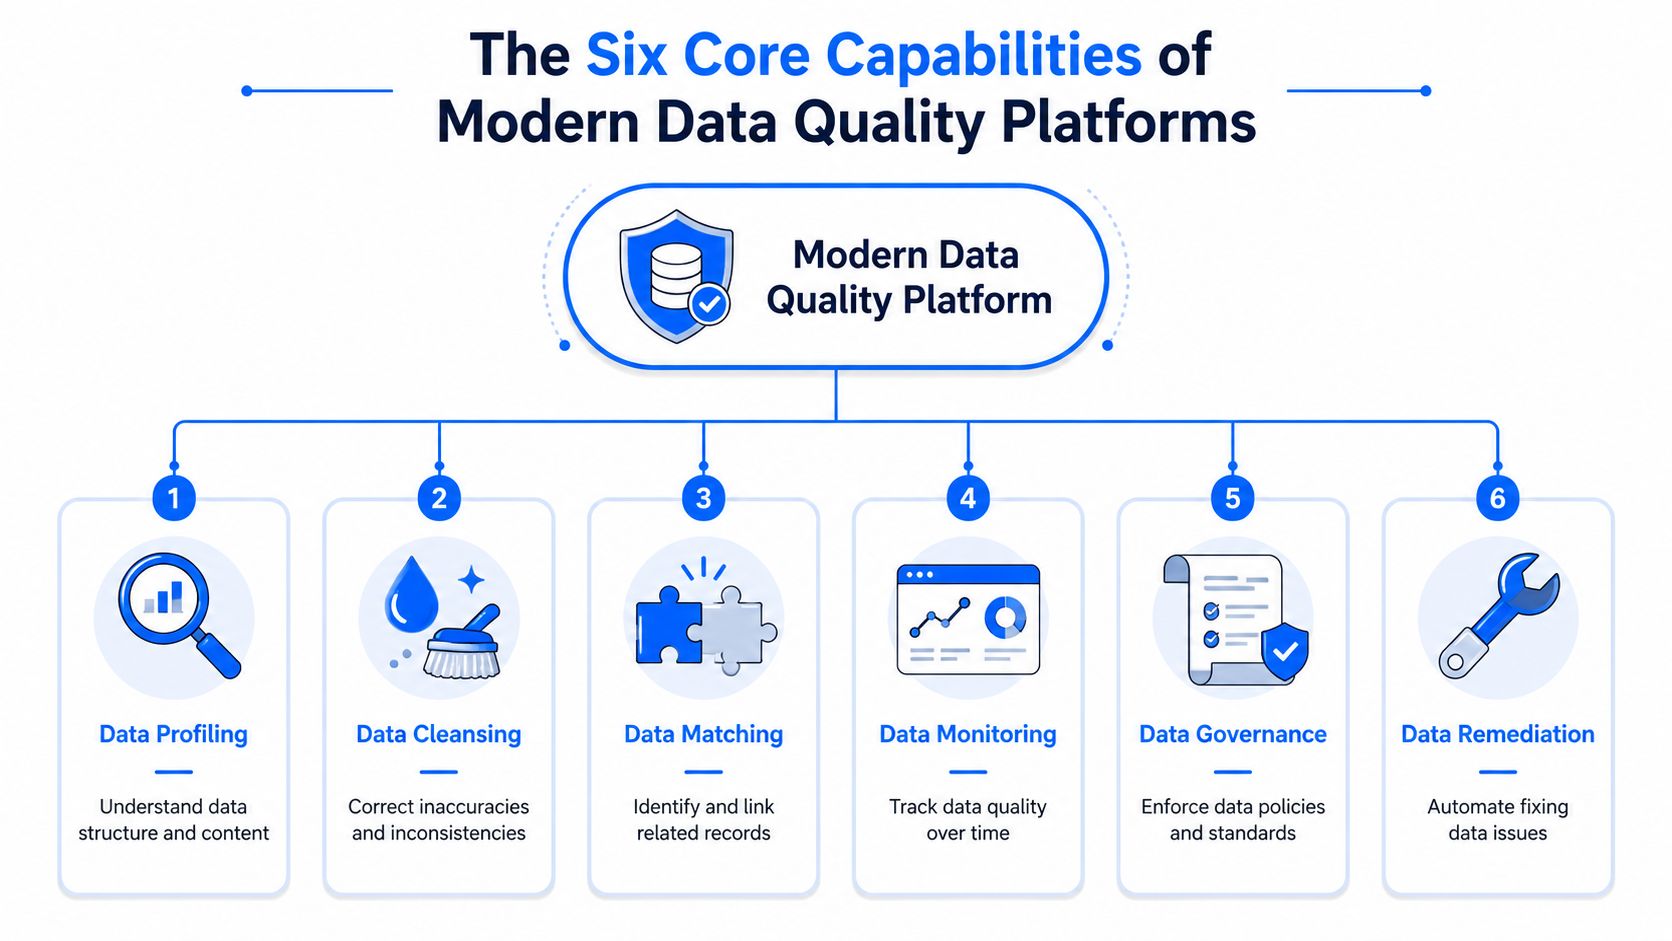
Dai controlli alla copertura
Le sei capacità che contano di più nella pratica non sono funzionalità isolate. Formano una rete di sicurezza.
Capacità | Cosa protegge | Perché interessa ai team |
|---|---|---|
Rilevamento delle anomalie basato sull'AI | Le incognite sconosciute in metriche e comportamenti | Individua cambiamenti insoliti che le regole statiche non colgono |
Validazione a livello di record | Logica di business e requisiti di audit | Intercetta difetti a livello di riga che superano comunque i controlli di salute della pipeline |
Monitoraggio della tempestività | Consegne di dati in ritardo o mancanti | Previene report obsoleti e confusione a valle |
Tracciamento delle modifiche di schema | Compatibilità strutturale | Impedisce che trasformazioni e report vadano silenziosamente alla deriva |
Esecuzione in-database | Sicurezza, controllo dei costi e precisione | Mantiene l'analisi vicino ai dati ed evita spostamenti inutili |
Observability unificata | Contesto operativo e di business insieme | Collega gli eventi della pipeline ai risultati in termini di fiducia nei dati |
L'AI è importante perché le soglie statiche invecchiano male. La stagionalità cambia. I cicli di business si spostano. Il lancio di nuovi prodotti distorce le baseline precedenti. Secondo Fortune Business Insights sul mercato degli strumenti di data quality, la pressione normativa di GDPR e CCPA è un importante motore di adozione e il 78% dei responsabili della data governance considera ormai essenziale il rilevamento delle anomalie basato sull'AI per la audit readiness e la compliance.
Perché queste capacità contano insieme
Una piattaforma dotata solo di una o due di queste capacità tende a fallire in modi prevedibili.
Uno strumento che sorveglia solo la freshness può dirvi che una tabella è arrivata in orario senza accorgersi che al suo interno i record duplicati sono esplosi. Uno strumento che valida solo le regole di business può intercettare valori non validi ma non notare una pipeline in ritardo che ha lasciato al suo posto lo snapshot di ieri. Uno schema tracker privo di rilevamento delle anomalie non si accorgerà della deriva dei valori mentre la struttura resta tecnicamente invariata.
Per questo cerco una protezione a più livelli anziché moduli isolati. I buoni sistemi rispondono contemporaneamente a diverse classi di domande:
I dati sono arrivati quando dovevano?
La struttura è cambiata?
I record rispettano ancora le regole di business?
Distribuzioni e trend si comportano ancora normalmente?
Il team può analizzare i pattern nel tempo?
Il responsabile giusto può intervenire rapidamente?
Per i team che vogliono rendere tutto questo concreto, queste metriche di data quality sono utili perché spostano le discussioni sulla qualità dal linguaggio astratto della governance a segnali operativi misurabili.
Le regole statiche intercettano i modi di guasto noti. Le piattaforme moderne devono anche rilevare i problemi per cui nessuno ha scritto una regola.
C'è anche un punto pratico di implementazione che vale la pena dire chiaramente. Se il rilevamento delle anomalie genera rumore, gli ingegneri smettono di fidarsi degli alert. I sistemi adattivi sono importanti perché imparano nel tempo i pattern normali. I dati verificati di mercato e dei vendor vanno entrambi in questa direzione: dal rilevamento delle anomalie basato sull'AI che diventa centrale per la compliance ai motori adattivi che superano gli approcci di forecasting generici nell'identificazione delle anomalie.
La decisione architetturale critica: in-database vs esterno
La maggior parte degli acquirenti dedica troppo tempo agli screenshot dell'interfaccia e troppo poco all'architettura. È il contrario di ciò che servirebbe. L'architettura determina dove vengono elaborati i dati, quale livello di precisione è possibile, quali controlli di sicurezza si applicano e quanta visibilità a livello di record la piattaforma può realisticamente offrire.
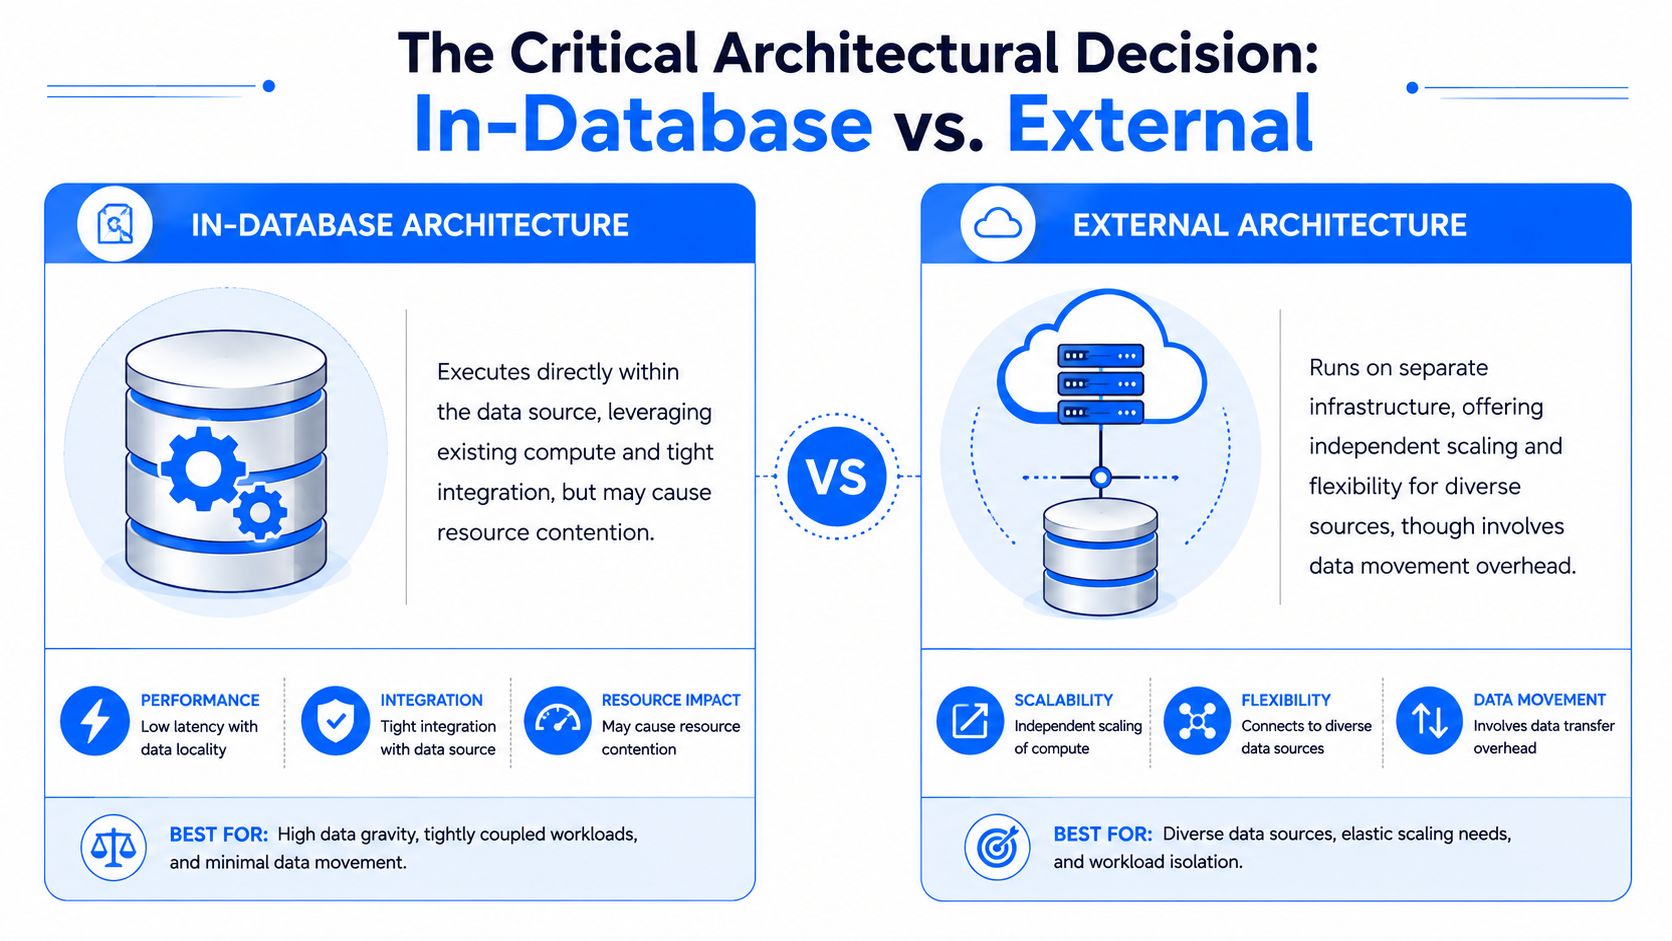
Due modi di ispezionare lo stesso sistema
Esistono due approcci principali.
L'esecuzione in-database esegue controlli, calcolo delle metriche e apprendimento delle baseline là dove i dati risiedono già. Il data warehouse o il database svolge il lavoro e la piattaforma orchestra e interpreta i risultati.
Gli approcci esterni eseguono la logica di qualità al di fuori della piattaforma dati. In alcuni casi spostano i dati in un altro sistema per l'analisi. In altri ispezionano principalmente metadati, lineage, log delle query, segnali di freshness o statistiche aggregate, anziché effettuare calcoli direttamente sui record.
L'analogia più semplice è l'ispezione di un edificio. Gli strumenti in-database ispezionano le stanze, l'impianto elettrico e le tubature reali all'interno dell'edificio. Gli strumenti basati solo sui metadati spesso ispezionano le planimetrie, le bollette e i registri degli ascensori. Il secondo approccio può essere utile, ma non vi dice se dietro una parete si sta diffondendo la muffa.
Dove l'approccio basato solo sui metadati cede
È questo il punto cieco architetturale che molti team scoprono troppo tardi. Gli approcci basati solo sui metadati possono non cogliere una sottile deriva a livello di record nelle pipeline complesse, una debolezza cruciale per i settori finanziario e sanitario, dove l'accuratezza a livello di record è fondamentale, come illustrato nell'analisi di Monte Carlo su quando servono gli strumenti di data quality.
Questo è importante perché molti guasti di business non sono guasti dei metadati. La tabella esiste ancora. Il job è stato eseguito. Il volume sembra ancora plausibile. Ma i record al suo interno sono sbagliati in modi che solo un'ispezione a livello di riga può intercettare.
Ecco il compromesso pratico:
Architettura | Punti di forza | Punti deboli |
|---|---|---|
In-database | Mantiene i dati nell'ambiente del cliente, consente un'ispezione più profonda dei record, si allinea bene ai controlli di private cloud e on-premise | Deve essere progettata con attenzione per evitare un carico inutile sul data warehouse |
Esterna, metadata-first | Spesso più rapida da implementare per un ampio monitoraggio operativo, può ridurre le query dirette sui record | Può non cogliere derive di basso livello e violazioni delle regole di business all'interno di tabelle apparentemente sane |
Questo non significa che il monitoraggio esterno sia inutile. Significa che i team dovrebbero smettere di fingere che risponda a ogni domanda sulla qualità.
Cosa chiedere direttamente ai vendor
Quando valutate l'architettura, fate domande dirette:
Dove viene eseguito il calcolo delle metriche?
Ispezionate direttamente i record o deducete i problemi soprattutto dai segnali dei metadati?
La piattaforma può funzionare in private cloud o on-premise senza che il vendor acceda ai dati di produzione?
Cosa succede quando mi serve una validazione delle regole di business a livello di riga su dati regolamentati?
Come distinguete un rilevamento delle anomalie utile dal rumore degli alert?
Uno strumento come digna è rilevante in questa categoria perché esegue le analisi all'interno del database del cliente, supporta rilevamento delle anomalie, validazione, monitoraggio della tempestività e schema tracking, ed è progettato per ambienti controllati dal cliente, come deployment in private cloud o on-premise.
Se il vostro team sta valutando i compromessi tra postura di sicurezza e risorse di calcolo, questo approfondimento sull'esecuzione della data quality in-database rispetto alle pipeline esterne è la giusta linea di indagine.
La scelta architetturale non è un dettaglio di deployment. Cambia ciò che lo strumento può effettivamente sapere.
In generale preferisco l'esecuzione in-database per le aziende che gestiscono dataset regolamentati, di alto valore o sensibili dal punto di vista operativo. Preserva il perimetro di sicurezza, riduce gli spostamenti inutili e dà alla piattaforma accesso diretto ai record che contano. Gli approcci esterni e basati sui metadati hanno ancora un ruolo, soprattutto per un'ampia copertura di observability, ma vanno scelti con piena consapevolezza dei punti ciechi che creano.
Perché vi serve una piattaforma unificata di qualità e observability
Il mercato tratta spesso data quality e data observability come categorie separate. Nell'operatività, questa separazione crea attrito. Uno strumento vi dice che un dataset è arrivato in ritardo. Un altro vi dice che un campo ha violato una regola di business. Un terzo contiene il contesto di lineage o di ownership. Il vostro team diventa il livello di integrazione.
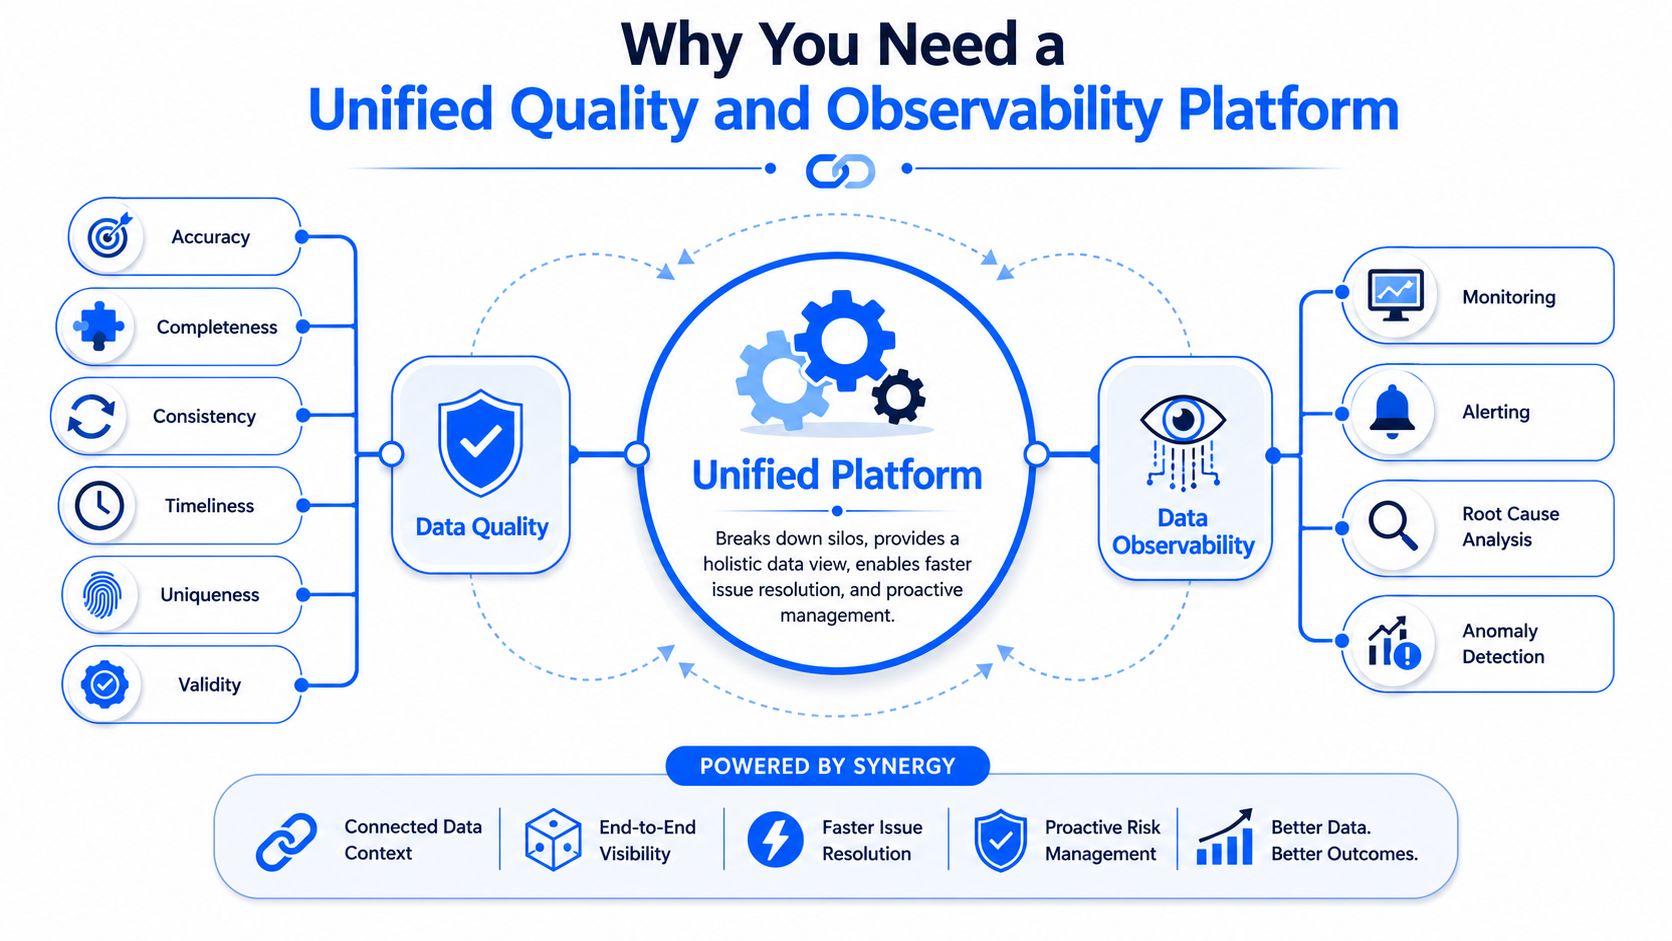
La salute operativa non è la correttezza dei record
L'observability risponde a domande come:
La pipeline viene eseguita in orario?
Il volume delle righe è cambiato inaspettatamente?
Lo schema è cambiato?
Quale asset a monte è collegato a questa dashboard?
La qualità risponde a domande diverse:
I valori sono validi?
I record chiave sono duplicati?
Una regola di business è stata violata?
Questo dataset può soddisfare i requisiti di audit o di reporting?
I team hanno bisogno di entrambe. Le indicazioni di IBM e le analisi recenti puntano alla stessa realtà operativa. Il 68% dei team dati utilizza ormai due o più strumenti sovrapposti per observability e qualità, con conseguente affaticamento da integrazione e inefficienza dei costi, secondo il tutorial di IBM sui pilastri della qualità dei dati.
Questo numero corrisponde a ciò che molti team di piattaforma già percepiscono. Ogni incidente inizia con un salto da uno strumento all'altro. Si controlla prima l'observability, poi i risultati della validazione, poi il lineage, poi il ticketing, poi i log del data warehouse, e infine si chiede a un responsabile di dominio se oggi i dati dovrebbero davvero avere questo aspetto.
Cosa cambia in pratica con l'unificazione
Una piattaforma unificata cambia la gestione degli incidenti perché comprime il contesto.
Invece di sistemi separati, il team ottiene un'unica vista operativa:
La pipeline è arrivata in ritardo.
La tabella interessata alimentava tre report critici per il business.
I tassi di superamento della validazione sono calati su un campo chiave.
Una modifica di schema si è verificata nello stesso percorso a monte.
L'alert viene instradato al responsabile con prove sufficienti per intervenire.
Non è solo una questione di comodità. È un modello operativo diverso.
Strumenti separati possono monitorare sintomi separati. Una piattaforma unificata vi aiuta a comprendere un unico incidente.
C'è anche un aspetto di governance. Ai team di compliance non interessa se un guasto riguardasse l'“observability” o la “qualità”. Interessa sapere se esistevano dei controlli, se il problema è stato rilevato e se qualcuno lo ha risolto con una responsabilità tracciabile.
Un approccio unificato è particolarmente prezioso dove l'accesso del vendor ai dati è limitato o dove l'applicazione delle regole di business deve affiancare il monitoraggio operativo in un unico ambiente. Per questo il dibattito non dovrebbe essere impostato come “observability o qualità”. Dovrebbe essere impostato sulla capacità della piattaforma di collegare tempestività, comportamento dello schema, segnali di anomalia e validazione a livello di record, senza costringere i team a correlarli manualmente.
Se state ancora definendo il confine tra le due categorie, questo confronto tra data observability e data quality è utile perché si concentra sulle differenze operative anziché sul branding dei vendor.
Un framework pratico per valutare gli strumenti di data quality
La maggior parte delle valutazioni fallisce perché assegna punteggi alle funzionalità, non ai risultati. Un team assegna punti a dashboard, connettori e librerie di regole, poi scopre in produzione che la piattaforma inonda Slack di rumore o non è in grado di gestire la forma effettiva dei dati che contano.
L'approccio migliore è valutare gli strumenti rispetto alle condizioni operative in cui il vostro team lavora ogni giorno.
Secondo le indicazioni di Atlan sui migliori strumenti di data quality, una piattaforma ad alte prestazioni deve ottenere un punteggio elevato su sei criteri di valutazione: intelligenza di rilevamento, velocità di risoluzione, integrazione efficiente nello stack, capacità di apprendimento adattivo, scalabilità enterprise e instradamento azionabile.
Sei domande che rivelano il valore reale di una piattaforma
Usate questi sei criteri come domande dirette nella proof of concept.
Intelligenza di rilevamento
Lo strumento è in grado di individuare i problemi prima che gli utenti li segnalino?
È il primo test. Una piattaforma che si limita a confermare i guasti evidenti non riduce granché il rischio. Dovrebbe rilevare comportamenti insoliti, derive di basso livello e cambiamenti che non corrispondono ai pattern precedenti. Se dovete spiegare questo concetto agli stakeholder di business, è simile al modo in cui i team commerciali usano i sistemi per comprendere la sales intelligence per la crescita dei ricavi. L'attività grezza conta meno del fatto che la piattaforma identifichi il segnale significativo abbastanza presto da poter agire.
Velocità di risoluzione
Quanto rapidamente si può passare dall'alert alla causa principale?
Un buon alert include il contesto: quale tabella è cambiata, quale regola è fallita, quale asset a valle è a rischio e chi è responsabile del problema. Se l'alert dice solo “anomalia rilevata”, il team deve ancora ricostruire a mano la storia dell'incidente.
Integrazione fluida nello stack
Si inserisce nel vostro stack senza sforzi eroici?
La compatibilità nativa con strumenti come Snowflake, Databricks e dbt è importante perché le integrazioni fragili creano punti ciechi. Se la piattaforma non riesce a vivere in modo naturale nel vostro ecosistema, la vostra copertura operativa resterà sempre indietro rispetto ai cambiamenti architetturali.
Come condurre una proof of concept che abbia senso
Non fate una demo su un dataset giocattolo. Usate un dominio con conseguenze operative reali. Ricavi, finance, identità dei clienti, reporting di compliance o una tabella di input per un'AI rivolta ai clienti sono buoni candidati.
Valutate la piattaforma in condizioni reali:
Capacità di apprendimento adattivo: la qualità degli alert migliora man mano che la piattaforma apprende i pattern normali, oppure la taratura resta manuale per sempre?
Scalabilità enterprise: può ispezionare dataset grandi, rumorosi e critici per il business senza perdere utilità?
Instradamento azionabile: il problema raggiunge il responsabile giusto, con dettagli sufficienti per risolverlo?
Una semplice matrice di valutazione aiuta:
Criterio | Segnale debole | Segnale forte |
|---|---|---|
Intelligenza di rilevamento | Individua solo i guasti evidenti | Rileva anomalie sottili prima dei reclami degli utenti |
Velocità di risoluzione | L'alert manca di contesto | L'alert indica causa, impatto e responsabile |
Integrazione | Richiede lavoro personalizzato per lo stack principale | Si collega in modo naturale a data warehouse e strumenti di pipeline |
Apprendimento adattivo | Dominano le soglie statiche | Baseline e qualità degli alert migliorano nel tempo |
Scalabilità | Crolla con volumi o complessità elevati | Resta utilizzabile su dataset di scala enterprise |
Instradamento | Casella condivisa, rumore generico | Instradato al team responsabile con le relative prove |
Una proof of concept dovrebbe prevedere almeno una simulazione di incidente reale. Se lo strumento fa bella figura solo in una demo sul percorso ideale, non lo avete messo alla prova.
Nelle slide i vendor sembrano spesso simili. Si differenziano rapidamente quando chiedete loro di rilevare una deriva sottile, validare una logica di business reale e supportare l'azione all'interno del vostro effettivo ambiente operativo.
La vostra roadmap di adozione enterprise e la checklist
Un rollout di successo di solito parte più in piccolo di quanto i team si aspettino, ma con una disciplina più rigorosa. Non iniziate da tutti i domini. Iniziate da un dominio in cui i dati di scarsa qualità hanno già conseguenze di business visibili.
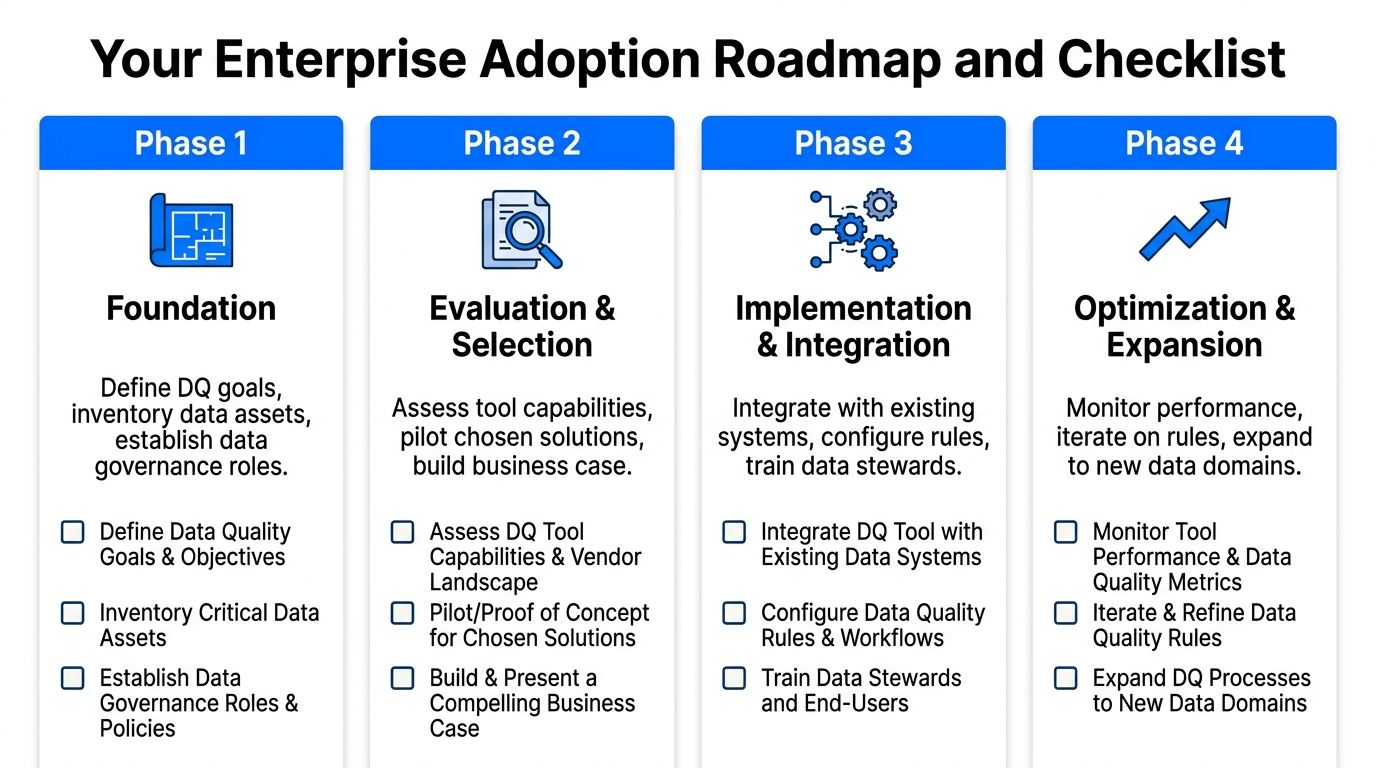
Rollout fase per fase
Fase 1: progetto pilota
Scegliete un dataset ad alto impatto con un perimetro gestibile. Reporting dei ricavi, risoluzione dell'identità dei clienti o una dashboard operativa critica di solito funzionano bene. Definite che aspetto ha un fallimento prima che il pilota inizi, inclusi arrivi in ritardo, schema drift, record non validi e alert non risolti.
Fase 2: selezione dello strumento
Conducete una proof of concept strutturata utilizzando i sei criteri di valutazione. Obbligate i vendor a mostrare come rilevano, instradano e spiegano un problema reale. Se sicurezza o governance sono importanti, verificate presto i vincoli di deployment invece di trattarli come un dettaglio successivo alla selezione.
Fase 3: rollout su larga scala
Estendete la copertura ai domini critici quando il pilota ha dimostrato la propria utilità. Collegate gli alert ai workflow di engineering e di stewardship. Standardizzate la ownership in modo che gli incidenti non si blocchino nei canali condivisi.
Fase 4: governance ed enablement
Create regole operative durature. Definite chi è responsabile di quali dataset, quali regole di business contano di più, come vengono gestite le eccezioni e come i team esaminano i pattern ricorrenti degli incidenti. Mettete analisti e team di dominio in condizione di verificare lo stato della qualità senza aspettare che i platform engineer interpretino ogni segnale.
Checklist dei vendor per la selezione finale
Portate questa checklist negli incontri con i vendor e nelle revisioni di procurement:
Adeguatezza architetturale: lo strumento viene eseguito dove il vostro modello di sicurezza e compliance lo richiede?
Modello di accesso ai dati: il vendor ha bisogno di accedere ai dati di produzione, oppure la piattaforma può operare interamente all'interno del vostro ambiente?
Copertura a livello di record: può validare le regole di business all'interno dei dati, e non solo sui metadati che li circondano?
Copertura operativa: può monitorare tempestività, modifiche di schema e comportamento anomalo in un unico workflow?
Adeguatezza dell'integrazione: si collega in modo pulito al vostro ecosistema di data warehouse, data lake e pipeline?
Modello di ownership: gli alert possono essere instradati alla persona in grado di risolvere il problema?
Controllo del rumore: lo strumento si adatta nel tempo, oppure il vostro team dovrà sorvegliare manualmente le soglie?
Verificabilità: potete dimostrare che cosa è fallito, quando è fallito e come è stato risolto il problema?
Un buon piano di adozione trasforma la data quality da esercizio periodico di pulizia in una normale disciplina operativa. È allora che la piattaforma inizia a ripagarsi.
Se il vostro team desidera un unico sistema che combini rilevamento delle anomalie, validazione a livello di record, monitoraggio della tempestività e schema tracking senza spostare i dati al di fuori del vostro ambiente, vale la pena valutare digna insieme alle altre piattaforme della vostra shortlist. Il suo approccio in-database è particolarmente rilevante per le aziende che necessitano di deployment in private cloud o on-premise, di un forte controllo sull'accesso ai dati di produzione e di un'unica interfaccia sia per la data quality sia per l'observability.
Per vedere all'opera la prima capacità di quell'elenco, scoprite come digna Data Anomalies apprende i pattern normali per far emergere le derive che le regole statiche non colgono.
Domande frequenti
A cosa servono gli strumenti di data quality?
Gli strumenti di data quality rendono ispezionabile la supply chain dei dati, così che i guasti silenziosi vengano intercettati prima che dashboard, dirigenti o sistemi di AI li assorbano. L'articolo raggruppa il loro lavoro in controlli delle fondamenta come lo schema tracking, controlli dei materiali come le regole di validità, controlli di consegna sulla freshness e controlli di comportamento basati sul rilevamento delle anomalie.
Quali capacità dovrebbe avere uno strumento di data quality enterprise?
L'articolo ne indica sei: rilevamento delle anomalie basato sull'AI, validazione a livello di record, monitoraggio della tempestività, tracciamento delle modifiche di schema, esecuzione in-database e observability unificata. Funzionano come una rete di sicurezza, perché uno strumento che sorveglia solo la freshness può segnalare una tabella arrivata in orario senza accorgersi che al suo interno i record duplicati sono esplosi.
È meglio un monitoraggio della data quality in-database o basato solo sui metadati?
Per dati regolamentati o di alto valore, l'esecuzione in-database è di solito più solida perché ispeziona i record reali all'interno del vostro ambiente. Gli strumenti basati solo sui metadati si implementano spesso più rapidamente per un ampio monitoraggio operativo ma, come osserva l'analisi di Monte Carlo citata nell'articolo, possono non cogliere una sottile deriva a livello di record, una debolezza cruciale in ambito finanziario e sanitario.
Come si conduce una proof of concept per gli strumenti di data quality?
Effettuate il test su un dominio con conseguenze reali, come ricavi, finance o identità dei clienti, mai su un dataset giocattolo. Valutate intelligenza di rilevamento, velocità di risoluzione, integrazione, apprendimento adattivo, scalabilità e instradamento azionabile, e includete almeno una simulazione di incidente reale, perché gli strumenti che brillano nelle demo sul percorso ideale spesso falliscono proprio lì.
Quanto è grande il mercato degli strumenti di data quality?
Mordor Intelligence, citata nell'articolo, ha stimato il mercato globale degli strumenti di data quality in 2,78 miliardi di dollari nel 2025 e prevede 7,39 miliardi di dollari entro il 2031, con un CAGR del 17,7 per cento. Fortune Business Insights aggiunge che la pressione normativa di GDPR e CCPA è un importante motore di adozione.


