Padroneggiare la certificazione della qualità dei dati nel 2026
|
6
min di lettura

Un report deve essere consegnato tra un'ora. La finanza vede un dato di fatturato nella dashboard, le operations ne vedono un altro in un foglio di calcolo e il data team viene trascinato nel solito circolo di thread su Slack, query SQL improvvisate e spiegazioni imbarazzate. In quel momento nessuno chiede altra filosofia sulla governance. Si pone una domanda più semplice: ci si può fidare di questo dataset, adesso?
È qui che la certificazione della qualità dei dati diventa utile. Non come titolo per una persona, né come vago documento di policy, ma come modo pratico per certificare che un dataset, una tabella, un feed o una pipeline soddisfi condizioni di qualità definite e continui a soddisfarle nel tempo. Per i team di analytics e di ML questo cambiamento conta. Trasforma il “pensiamo che vada bene” in “lo abbiamo testato rispetto a standard precisi, abbiamo assegnato le responsabilità e possiamo dimostrarne lo stato”.
Indice
Perché i vostri dati hanno bisogno di un bollino di freschezza certificata
Dai dati di cui non ci si fida a decisioni prese con sicurezza
Perché i vostri dati hanno bisogno di un bollino di freschezza certificata
Un dataset di solito perde la fiducia prima di guastarsi del tutto. Il report continua a essere generato. La dashboard continua a caricarsi. Ma qualcuno nota una regione mancante, un aggiornamento in ritardo o un numero di clienti che non quadra con un altro sistema. Quando gli utenti di business iniziano a dubitare dei dati, ogni decisione rallenta.

La certificazione della qualità dei dati è la disciplina che inquadra questa fiducia in un processo di approvazione formale. In pratica, un team definisce i requisiti di qualità per un asset di dati, lo testa rispetto a quei requisiti, registra il risultato e continua a monitorarlo dopo il rilascio. Lo scopo non è la burocrazia. Lo scopo è smettere di discutere se i dati sembrano affidabili e iniziare a dimostrare se rispettano gli standard concordati.
Le ragioni economiche sono già solide. Secondo una ricerca di Gartner, la scarsa qualità dei dati costa alle organizzazioni in media 12,9 milioni di dollari all'anno, come riportato nell'analisi di settore di Integrate.io. Questo costo si manifesta in riconciliazioni, decisioni ritardate, esperienze cliente compromesse ed esposizione in termini di compliance.
Cosa cambia la certificazione nel lavoro quotidiano
Senza certificazione, i team lavorano spesso in modo reattivo. Scoprono i problemi dopo che uno stakeholder li ha segnalati. Correggono le regole in una pipeline ma lasciano intatte modalità di guasto simili altrove. Si affidano a conoscenze non documentate, che svaniscono non appena l'unico ingegnere che conosce le stranezze va in ferie.
Con la certificazione, i team creano un livello di controllo ripetibile attorno agli asset critici:
Per le dashboard: certificate freshness, completezza e logica di calcolo approvata prima del reporting direzionale.
Per le pipeline operative: certificate stabilità dello schema, tempi di consegna e tolleranza ai null prima che i dati arrivino a valle.
Per le feature di ML: certificate la validità degli input e i campi sensibili alla deriva prima che i job di training o inferenza ne dipendano.
Regola pratica: se un dataset influisce su fatturato, compliance, comunicazione con i clienti o comportamento dei modelli, ha bisogno di criteri di certificazione espliciti.
Cosa non è la certificazione
Non è un distintivo da ottenere una volta per tutte.
Non è nemmeno la stessa cosa che certificare una persona o acquistare uno strumento per la qualità dei dati. Una persona può conoscere i metodi di qualità e lavorare comunque in un ambiente in cui nessuna pipeline è formalmente validata. Uno strumento può rilevare anomalie e lasciare comunque indefinite le responsabilità. La certificazione funziona solo quando standard, controlli e accountability esistono tutti insieme.
Ecco perché i programmi di certificazione della qualità dei dati più solidi si concentrano sugli asset stessi. Rispondono a domande concrete. Cosa deve essere vero, esattamente, perché questo dataset sia considerato affidabile? Chi lo approva? Cosa succede quando deriva? Con quale rapidità va risolto il problema? Queste risposte creano il “bollino di freschezza” che interessa agli stakeholder.
Progettare criteri e governance della certificazione
La maggior parte dei tentativi di certificazione falliti inizia con l'acquisto di uno strumento o con un memo di policy. Entrambi sono al contrario. Il primo compito è definire cosa significa “certificato” per ciascun asset di dati in termini di business, e poi tradurre questa definizione in controlli applicabili.
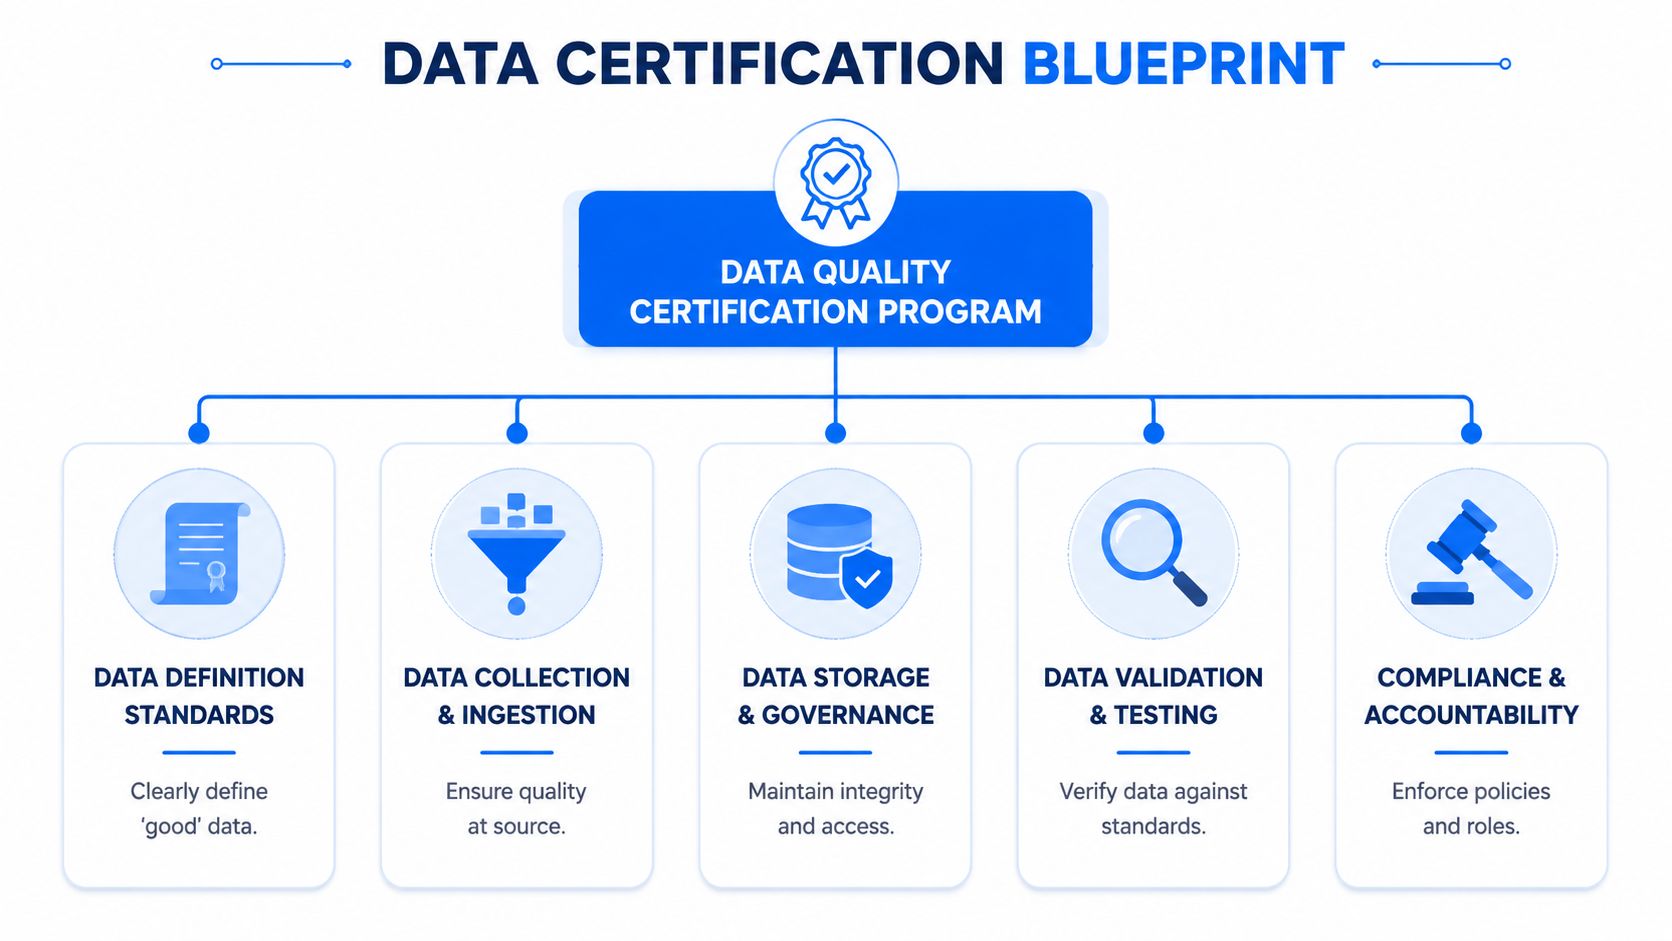
La sequenza operativa è consolidata. La metodologia standard descritta da 6sigma.us segue un framework in quattro fasi: data profiling, standardizzazione, validazione e pulizia dei dati. L'ordine conta, perché i team non possono applicare standard che non hanno prima osservato e definito.
Partite da criteri adatti allo scopo
In pratica, di solito contano soprattutto cinque dimensioni. La formulazione può variare, la sostanza no.
Dimensione | Cosa significa nella certificazione | Esempio pratico |
|---|---|---|
Accuratezza | I valori corrispondono a una realtà di business affidabile | L'importo fatturato coincide con quello del sistema di riferimento |
Completezza | I campi e i record obbligatori sono presenti | Ogni ordine ha un ID cliente e una data dell'ordine |
Tempestività | I dati arrivano quando servono al business | La tabella delle vendite giornaliere viene aggiornata prima del reporting del mattino |
Coerenza | Lo stesso concetto coincide tra i diversi sistemi | I codici paese corrispondono tra CRM e fatturazione |
Validità | I valori rispettano formati e regole definiti | Lo stato del contratto contiene solo valori ammessi |
Non definite queste dimensioni al livello di uno slogan aziendale. Definitele a livello di dataset e di caso d'uso. Una tabella dell'assistenza clienti e un data mart finanziario per il management possono essere entrambi “di alta qualità” pur avendo aspettative di tempestività molto diverse. La certificazione fallisce quando i team fingono che un'unica soglia universale vada bene per ogni pipeline.
Assegnate le responsabilità prima di automatizzare
I controlli di qualità senza un responsabile diventano rumore. Qualcuno deve decidere lo standard, qualcuno deve monitorare le eccezioni e qualcuno deve approvare la correzione quando emergono dei compromessi.
Una suddivisione pratica della governance è la seguente:
Data owner: responsabile della definizione di qualità in termini di business e dell'accettazione del rischio quando gli standard non sono rispettati.
Data steward: traduce le aspettative di business in regole utilizzabili, smista i problemi e ne guida la risoluzione.
Team di piattaforma o di engineering: implementa i controlli nelle pipeline, l'alerting, la lineage e l'infrastruttura di monitoraggio.
Consumatori: analisti, responsabili finanziari, manager delle operations o team di ML che confermano se l'asset resta adatto all'uso.
La qualità si rompe più in fretta quando la responsabilità è collettiva in teoria e assente nella pratica.
Molti team tendono a complicare troppo la governance. Non serve un consiglio gigantesco per certificare una tabella dei fatti di vendita. Servono un responsabile designato, uno steward che conosca la logica dei campi e un percorso di engineering per applicare lo standard. Se il vostro modello operativo complessivo è ancora in fase di definizione, una risorsa pratica per strutturare i controlli è questo framework di sicurezza dei dati per le PMI, soprattutto per i team che devono allineare le aspettative di qualità con accesso, gestione e accountability.
Trasformate la policy in un modello operativo
Una volta definiti dimensioni e responsabili, documentate ogni asset certificabile in forma compatta. Ho visto che funziona meglio un breve registro piuttosto che un pesante pacchetto di policy.
Includete:
Perimetro dell'asset
Identificate la tabella, la pipeline o il set di feature da certificare.Campi critici e condizioni di guasto
Elencate le colonne, i join, le finestre temporali e le dipendenze rilevanti.Regole di qualità
Registrate sia i controlli tecnici sia quelli di business. Fate in modo che siano testabili.Percorso di approvazione
Indicate chi concede la certificazione e chi riceve una notifica in caso di guasto.Cadenza di revisione
Stabilite quando i criteri devono essere rivalutati dopo modifiche al business o allo schema.
I team che hanno bisogno di uno schema di partenza possono adattare un modello formale di data quality framework a questo registro di certificazione a livello di asset. L'importante non è il template. È che ogni asset certificato abbia criteri documentati, collegati a un responsabile e a un controllo nella pipeline.
Implementare test e validazione automatizzati
I controlli manuali a campione sembrano responsabili finché volume, velocità e cambiamento non ne rivelano la fragilità. Un analista esamina qualche riga. Un ingegnere esegue una query di validazione prima del rilascio. Uno steward rivede una scorecard mensile. Poi uno schema cambia il martedì sera, un caricamento a monte arriva in ritardo e nessuno vede il problema finché non si rompe un report a valle.

L'automazione è la linea di demarcazione tra un programma di certificazione che sopravvive e uno che si trasforma in burocrazia di facciata.
I controlli manuali cedono sotto il carico di lavoro reale
La validazione manuale ha il suo spazio durante la fase esplorativa e la root cause analysis. Come controllo permanente è debole. Le persone si stancano, la logica di business cambia e le checklist mantenute a mano raramente tengono il passo delle pipeline moderne.
I punti deboli sono prevedibili:
Lacune di copertura: chi revisiona controlla i campi ovvi ma non coglie gli effetti di interazione tra tabelle.
Ritardo temporale: i dati possono degradarsi per ore o giorni prima che qualcuno se ne accorga.
Deriva delle regole: i controlli scritti per un processo precedente diventano gradualmente obsoleti.
Applicazione incoerente: un team valida con rigore, un altro si affida alla memoria.
Ecco perché la certificazione deve includere controlli eseguiti automaticamente all'interno delle pipeline o direttamente sui dati archiviati. Se una regola conta, deve essere eseguita in modo automatico e ripetuto.
Usate test basati su regole e test basati sul comportamento
Una certificazione solida combina due approcci, invece di costringere l'uno a sostituire l'altro.
La validazione basata su regole è la più adatta ai requisiti di business espliciti. Usatela quando sapete esattamente cosa deve o non deve accadere. Ne sono esempi i set di codici ammessi, i campi obbligatori, le relazioni valide tra date e le asserzioni a livello di record come “gli ordini dei clienti premium non possono essere pari a zero”.
Il monitoraggio basato sul comportamento è più indicato per i guasti che non avete previsto. Questo include la deriva silenziosa, pattern di volume insoliti, distribuzioni che si spostano e anomalie temporali. Questi problemi spesso superano i controlli di schema e i semplici test sulle regole, pur danneggiando dashboard e modelli.
Un modo utile di vederla:
Approccio | Ideale per | Punto debole |
|---|---|---|
Controlli basati su regole | Logica di business nota e controlli di compliance | Fragili quando le regole si moltiplicano e i processi cambiano |
Anomaly detection | Deviazioni sconosciute e comportamenti assimilabili a una deriva | Richiede buone baseline e una revisione umana per il contesto |
Questa seconda categoria conta più di quanto molti team ammettano. L'anomaly detection basata sull'AI di digna può eliminare la necessità di manutenzione manuale delle regole. Un deployment enterprise di 12 mesi ha sostituito migliaia di regole tradizionali di qualità dei dati mantenendo un monitoraggio affidabile, grazie all'apprendimento del comportamento normale dei dati e all'adattamento automatico ai cambiamenti, secondo questo resoconto del deployment.
Cosa automatizzare per primo
Non cercate di certificare tutto in un'unica ondata. Partite dagli asset che causano più danni a valle quando si guastano. Nella maggior parte degli ambienti si tratta di tabelle per il reporting direzionale, dimensioni condivise, flussi di eventi principali, dataset di input dei modelli ed estrazioni per le autorità di vigilanza.
Una sequenza di rollout pratica è la seguente:
Prima i controlli di schema e strutturali
Intercettate colonne mancanti, cambi di tipo e presupposti sulle tabelle non più validi. Hanno un impatto elevato e sono relativamente semplici.Poi il monitoraggio di freshness e arrivo
Se i dati sono in ritardo, ogni discussione sulla “qualità” a valle diventa fuorviante.Quindi la validazione dei campi critici
Concentratevi su null, valori ammessi, chiavi sensibili ai duplicati e soglie critiche per il business.Infine il monitoraggio di distribuzioni e trend
Aggiungete l'anomaly detection per intercettare la deriva e i cambiamenti di comportamento sottili che le regole rigide non individuano.
Un dataset certificato deve fallire subito quando la struttura si rompe e avvisare presto quando il comportamento cambia.
Per i team che costruiscono questo livello, una risorsa complementare pratica è questa guida agli strumenti di verifica della validità per la qualità dei dati moderna. La chiave è trattare la validazione come una policy eseguibile. Non documentazione. Non intenzioni. Policy eseguibile.
Monitorare i KPI e gestire i Service Level Agreement
Un dataset non è “certificato” perché ha superato i controlli una volta. Resta certificato solo se il team può vederne lo stato in modo continuo, misurare se rispetta le aspettative e intervenire quando esce dall'intervallo concordato.

Il monitoraggio non riguarda solo i grafici. È il livello operativo che dice a engineering, governance e stakeholder di business se l'asset certificato si comporta ancora come promesso.
Scegliete KPI che cambiano i comportamenti
Un lungo catalogo di metriche non serve se nessuno riesce a collegarlo a un'azione. I migliori KPI di certificazione sono mirati, hanno un responsabile e sono collegati a un percorso di risposta.
Esempi che funzionano bene:
Stato di certificazione per asset
Il dataset supera attualmente tutti i controlli richiesti, è in revisione o è sospeso dall'uso?Rispetto della freshness
L'asset arriva entro la finestra di reporting o operativa richiesta?Tasso di superamento delle regole critiche
Le validazioni di business a priorità più alta vanno a buon fine in modo costante?Incidenti di qualità aperti
Quanti problemi irrisolti riguardano in questo momento asset certificati?Tempo di presa in carico e risoluzione
I guasti vengono affrontati abbastanza rapidamente da proteggere l'uso a valle?
Questi KPI diventano più utili se aggregati per dominio, responsabile e processo di business. La finanza non ha bisogno di ogni eccezione a livello di riga. Ha bisogno di sapere se il feed certificato della contabilità generale è adatto al reporting oggi.
Scrivete SLA comprensibili per gli utenti di business
Un service level agreement deve descrivere l'impegno in un linguaggio semplice. Se il consumatore non capisce l'impegno, lo SLA non governerà i comportamenti reali.
Uno SLA solido per i dati certificati di solito risponde a quattro domande:
Elemento dello SLA | Cosa definire |
|---|---|
Perimetro | A quale dataset, tabella o feed si applica l'impegno |
Aspettativa | Quale condizione di qualità deve essere rispettata |
Misurazione | Come il team determina la conformità |
Risposta | Cosa succede quando l'impegno non viene rispettato |
È la stessa logica che i team legali e di procurement applicano quando monitorano obblighi e prestazioni nei contratti. Se cercate un punto di riferimento interfunzionale, questi spunti per i team legali sulle metriche contrattuali sono utili perché mostrano come una progettazione chiara dei KPI supporti l'accountability, non solo il reporting.
Rendete il monitoraggio operativo, non cerimoniale
L'architettura del monitoraggio conta. Se il livello di observability richiede estrazioni continue di dati, gestioni separate delle eccezioni o l'accesso del fornitore ai dati di produzione, molti team regolamentati rallenteranno o bloccheranno il deployment.
Ecco perché l'architettura stessa diventa parte del modello operativo della certificazione. digna esegue tutto il calcolo delle metriche e l'apprendimento delle baseline direttamente all'interno del database del cliente. Questa architettura di “esecuzione in-database” garantisce che i dati restino nel loro ambiente, riducendo al minimo gli spostamenti e consentendo un monitoraggio efficiente su larga scala, come descritto sul sito della piattaforma digna.
Questa scelta progettuale risolve un problema pratico. Gli ingegneri ottengono metriche continue e baseline apprese là dove i dati risiedono già. I team di sicurezza evitano spostamenti inutili. Gli utenti di business ottengono comunque viste in dashboard e tracciamento dello stato, senza trasformare il monitoraggio in un progetto separato di esportazione dei dati.
La migliore configurazione di monitoraggio riduce le discussioni. Tutti vedono gli stessi segnali di salute, le stesse eccezioni e lo stesso percorso di responsabilità.
Mantenere verificabilità e miglioramento continuo
Un programma di certificazione diventa credibile quando sa rispondere a domande scomode mesi dopo. Perché questo dataset era considerato approvato lo scorso trimestre? Quale regola è fallita prima di quell'incidente di reporting? Chi ha accettato l'eccezione? Quando è stata introdotta la modifica allo schema? Se queste risposte dipendono dalla memoria o da ticket sparsi, la certificazione non è duratura.
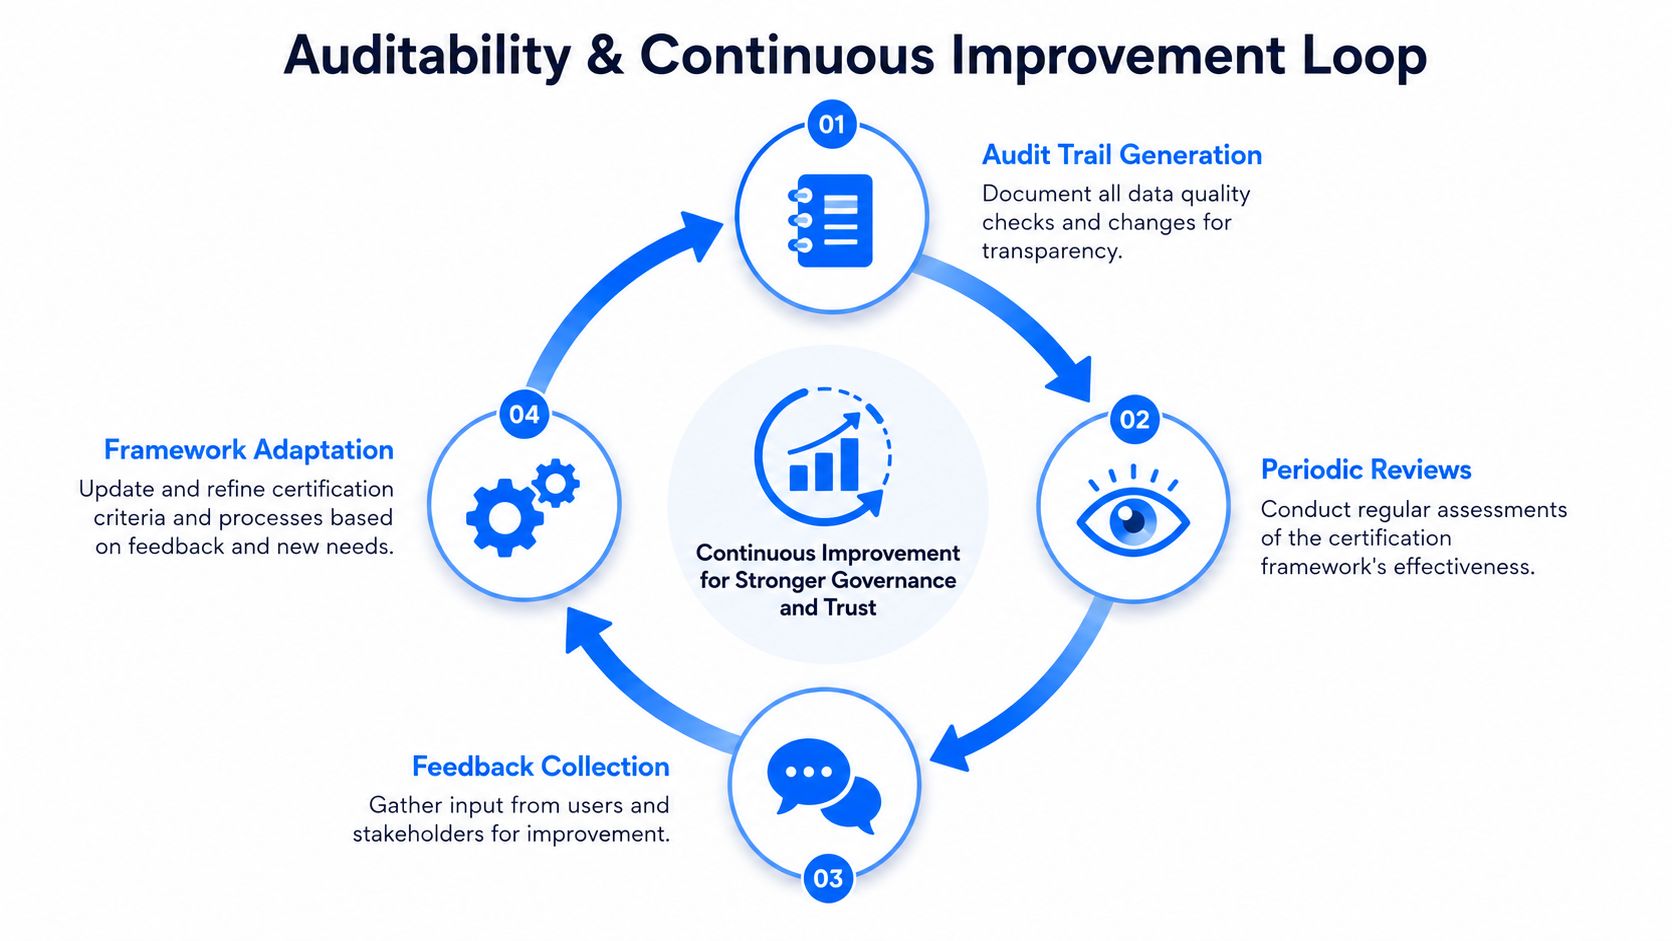
Gli audit trail fanno parte della certificazione stessa
La verificabilità non è un beneficio collaterale. È il livello di prova della certificazione della qualità dei dati.
Come minimo, conservate lo storico di:
Definizioni dei controlli e del momento in cui sono cambiate
Risultati di esecuzione di validazioni, controlli sulle anomalie e monitoraggio della freshness
Incidenti e note di triage collegati agli asset coinvolti
Approvazioni, deroghe ed eccezioni concesse da responsabili designati
Modifiche a schema e pipeline che potrebbero alterare lo stato di certificazione
Questo conta soprattutto negli ambienti regolamentati, ma è altrettanto prezioso nelle attività interne. Lo storico degli audit permette ai team di distinguere un incidente isolato a monte da una lacuna ricorrente nei controlli. Evita anche il problema comune per cui ogni nuovo problema viene trattato come se nessuno lo avesse mai visto prima.
La certificazione statica fallisce nei sistemi in produzione
Il modello classico di certificazione tratta la qualità come un evento puntuale. Un dataset supera una revisione, viene contrassegnato come approvato e l'organizzazione passa oltre. Questo modello non regge in ambienti con pipeline attive, schemi in evoluzione e workload di ML.
Il segnale d'allarme più chiaro arriva dai sistemi di AI. Dati controcorrente indicano che il 65% dei guasti di qualità dei dati nei modelli di AI si verifica dopo la certificazione iniziale, a causa di modifiche allo schema o di ritardi nella tempestività, secondo l'analisi di DataKitchen sulla certificazione. È la realtà operativa che molti team già percepiscono. I guasti pericolosi spesso si verificano dopo il lancio, non prima.
Il modello giusto è quindi la certificazione continua. L'asset resta certificato solo finché i suoi controlli, la freshness e i presupposti strutturali continuano a essere rispettati. Lo stato di certificazione deve poter cambiare automaticamente quando cambiano le evidenze.
Costruite un ciclo di feedback che cambi davvero i controlli
Il miglioramento continuo funziona solo quando gli utenti possono reimmettere segnali nel sistema e quei segnali portano a controlli rivisti. Altrimenti, il “ciclo di feedback” diventa solo il nome di una riunione.
Uno schema utile è semplice:
Raccogliete le segnalazioni vicino al punto d'uso
Analisti, ML engineer e utenti di business devono poter segnalare rapidamente i dati sospetti.Fate il triage in base all'impatto sul business
Separate i problemi estetici dai guasti che incidono su decisioni, automazione o compliance.Risalite alla causa principale
Stabilite se il problema deriva dall'inserimento alla sorgente, dalla logica di trasformazione, da una modifica allo schema o dai tempi.Aggiornate il livello di certificazione
Aggiungete, rivedete o ritirate regole e soglie in base a ciò che il problema ha rivelato.Registrate quanto appreso
Conservate la motivazione insieme all'asset, così il prossimo responsabile non ripeterà la stessa discussione.
I buoni programmi di certificazione non inseguono la perfezione. Migliorano ogni volta che i dati sorprendono il team.
È qui che sta il vantaggio di molti team maturi rispetto a quelli semplicemente conformi. Non trattano gli incidenti come difetti isolati. Li usano per rafforzare il framework di certificazione stesso.
Dai dati di cui non ci si fida a decisioni prese con sicurezza
L'importanza della qualità dei dati è ben nota, quindi non servono ulteriori promemoria. Serve invece un metodo praticabile per dimostrare che una pipeline, un dataset o un set di feature è abbastanza affidabile da poter essere usato. È ciò che offre una certificazione della qualità dei dati efficace.
Lo schema è semplice. Definite la qualità in termini che il business possa difendere. Assegnate le responsabilità prima che emergano i problemi. Trasformate le regole in controlli automatizzati. Monitorate lo stato di salute in modo continuo. Conservate un audit trail. Adattate i controlli quando l'uso reale rivela delle lacune. Niente di tutto questo è affascinante, ma è ciò che fa uscire un'organizzazione dalla gestione reattiva delle emergenze.
Il risultato è la sicurezza nelle decisioni. Gli analisti smettono di accompagnare ogni presentazione con riserve sulla freshness. I data engineer smettono di portarsi dietro rischi operativi nascosti in controlli non documentati. I team di governance smettono di affidarsi a policy che nessuno riesce ad applicare in produzione. I team di ML hanno maggiori possibilità di intercettare deriva e rotture strutturali prima che i modelli producano output fuorvianti.
In questo lavoro si nasconde anche un cambiamento strategico. I dati certificati spostano la conversazione da “possiamo fidarci dei numeri?” a “cosa dobbiamo fare adesso?”. È un vantaggio operativo notevole. Accorcia i cicli di riconciliazione, offre ai responsabili un percorso di risposta chiaro e consente ai leader di trattare gli asset di dati più come prodotti gestiti che come output sperati.
Un approccio moderno conta perché il vecchio modello di certificazione statica non si adatta a warehouse, lake e pipeline di AI in produzione. I dati cambiano troppo in fretta. Gli schemi evolvono. I problemi di freshness si propagano rapidamente a valle. La certificazione deve funzionare come un sistema di controllo vivo, non come un rituale trimestrale.
Questo livello di fiducia è raggiungibile. Richiede disciplina ingegneristica, una governance che nomini responsabili reali e un monitoraggio che resti vicino ai dati invece di scivolare in un teatro di revisioni manuali.
Se state costruendo un livello di certificazione pratico per warehouse, lake e pipeline di produzione, vale la pena valutare digna. Combina anomaly detection, validazione, monitoraggio della tempestività, schema tracking ed esecuzione in-database in una piattaforma pensata per i team che hanno bisogno di garanzie continue senza spostare i dati di produzione fuori dal proprio ambiente.
Per trasformare regole sui campi critici, come ID cliente obbligatori o valori di stato ammessi, in controlli di certificazione eseguibili a livello di record, scoprite come li gestisce digna Data Validation.
Domande frequenti
Che cos'è la certificazione della qualità dei dati?
La certificazione della qualità dei dati è un processo formale che conferma che un dataset, una tabella, un feed o una pipeline soddisfa condizioni di qualità definite e continua a soddisfarle. Un team definisce i requisiti per l'asset, lo testa rispetto a essi, registra il risultato e prosegue il monitoraggio dopo il rilascio. Certifica asset di dati, non persone.
Quali criteri deve soddisfare un dataset certificato?
La maggior parte dei programmi usa cinque dimensioni: accuratezza, completezza, tempestività, coerenza e validità. Ciascuna va definita a livello di dataset e di caso d'uso, non come slogan aziendale. La completezza può significare che ogni ordine ha un ID cliente e una data dell'ordine, mentre la tempestività può significare che la tabella delle vendite giornaliere si aggiorna prima del reporting del mattino.
Chi dovrebbe essere responsabile della certificazione della qualità dei dati?
La responsabilità è suddivisa tra quattro ruoli. Il data owner definisce la qualità in termini di business e accetta il rischio, il data steward trasforma le aspettative in regole e smista i problemi, il team di piattaforma implementa controlli e alerting, e i consumatori, come analisti o team di ML, confermano che l'asset resta adatto all'uso.
Quali controlli di qualità dei dati conviene automatizzare per primi?
I controlli di schema e strutturali vengono per primi, perché colonne mancanti e cambi di tipo hanno un impatto elevato e sono semplici da intercettare. Seguono il monitoraggio di freshness e arrivo, poi la validazione dei campi critici per null, valori ammessi e chiavi sensibili ai duplicati. Il monitoraggio di distribuzioni e trend con l'anomaly detection viene per ultimo, per intercettare la deriva sottile.
Perché la certificazione dei dati una tantum fallisce?
Le pipeline in produzione continuano a cambiare dopo l'approvazione. L'articolo cita dati di DataKitchen secondo cui il 65% dei guasti di qualità dei dati nei modelli di AI si verifica dopo la certificazione iniziale, a causa di modifiche allo schema o di ritardi nella tempestività. La soluzione è la certificazione continua, in cui lo stato cambia automaticamente non appena controlli, freshness o presupposti strutturali smettono di essere rispettati.


