Monitoraggio della qualità dei dati: come implementarlo con successo nel 2026
|
7
min di lettura

Ieri la vostra dashboard sembrava a posto. Stamattina i ricavi sono in calo, la conversione è ferma e tra venti minuti inizia una riunione con il management. Nessuno ha modificato la logica di BI. Nessuno ha rilasciato una modifica visibile alla pipeline. Poi qualcuno nota un caricamento upstream in ritardo, una colonna rinominata o uno spostamento nella distribuzione sfuggito ai pochi controlli scritti a mano. I numeri erano sbagliati molto prima che qualcuno se ne accorgesse.
È questo il problema centrale del monitoraggio della qualità dei dati. La maggior parte dei guasti non sono interruzioni clamorose. Sono errori silenziosi che lasciano i report obsoleti, i modelli mal calibrati e i team a discutere su quale metrica sia affidabile. Il costo non è solo la pulizia tecnica. È la fiducia persa, le decisioni rimandate e le continue emergenze che sottraggono tempo al vero lavoro di ingegneria.
I team che vogliono meno sorprese hanno bisogno di un monitoraggio che vada più a fondo delle regole superficiali. Servono controlli che vengano eseguiti dove risiedono i dati, che seguano il comportamento nel tempo e che intercettino le derive prima che raggiungano le dashboard, le revisioni finanziarie o i sistemi di ML in produzione.
Indice
I costi nascosti dei guasti silenziosi dei dati
Lunedì, ore 8:05: la dashboard dei ricavi si apre puntuale e ogni riquadro si carica. Alle 10:30 il commerciale discute con la finanza perché il valore settimanale della pipeline di vendita è sceso senza alcun motivo di business. La pipeline non ha fallito. Hanno fallito i dati.
Questo schema è costoso perché brucia tempo in tutta l'azienda prima che qualcuno riesca a isolare la causa. Un batch in ritardo può lasciare al loro posto i numeri di ieri mentre il data warehouse sembra ancora in salute. Un cambio di tipo da INT a VARCHAR può lasciare attiva l'ingestion ma rompere più avanti nella catena i join sui record dei clienti. Una feature table può continuare a superare i controlli sui null anche quando una distribuzione dei valori spostata degrada l'output del modello.
I guasti silenziosi si propagano nei processi decisionali. I manager approvano piani basati su metriche obsolete. La finanza chiude i conti su sistemi non allineati. I team operativi riordinano le scorte sulla base di segnali di domanda distorti. Quando l'ingegneria viene coinvolta, il problema immediato non è più la tabella errata. È la perdita di fiducia in ogni metrica a valle che l'ha utilizzata.
La scarsa qualità dei dati ha un costo reale per il business. Gartner ha stimato che le organizzazioni perdono in media 12,9 milioni di dollari l'anno a causa di essa. Il numero è importante, ma nella pratica conta di più lo schema operativo. I team passano più tempo a discutere se un numero sia utilizzabile che ad agire su di esso.
I guasti silenziosi richiedono più disciplina di quelli evidenti. Una pipeline interrotta fa scattare un incidente. Una pipeline funzionante con dati sbagliati continua ad alimentare report, modelli e workflow finché qualcuno non nota che il risultato di business non torna.
Negli ambienti enterprise, le modalità di guasto ricorrenti sono di solito specifiche:
Un caricamento termina dopo l'orario di chiusura del reporting: Airflow segna il job in verde alle 6:12, ma la dashboard del management è stata aggiornata alle 6:00 usando fact table incomplete.
Una chiave di join cambia forma senza generare errori:
user_idarriva come stringa con zeri iniziali, l'SQL a valle lo converte in modo incoerente e il reporting sulle conversioni crolla perché i join smettono di corrispondere.Una metrica resta entro soglie statiche mentre il suo comportamento cambia: il tasso di rimborso rimane tra l'1 e il 3 percento, ma in una regione raddoppia all'improvviso e si perde nella media globale.
I dati di riferimento si aggiornano in un sistema ma non in un altro: la fatturazione riflette la nuova gerarchia di prodotto, il CRM no, e il reporting per segmento divide lo stesso cliente tra categorie in conflitto.
Un valore predefinito maschera dati upstream mancanti: dopo un bug di parsing, uno stream di eventi inizia a riempire
country_codeconUS, così i controlli di completezza passano mentre l'analisi regionale diventa pura finzione.
Sono proprio questi i guasti che i vecchi set di regole non vedono. Conteggi delle righe, controlli sui null e asserzioni sullo schema hanno ancora valore, ma raramente intercettano dati tecnicamente validi e operativamente sbagliati. Su larga scala, l'approccio più sicuro è un monitoraggio più profondo all'interno del data warehouse, dove i team possono confrontare freschezza, distribuzioni, relazioni e coerenza tra sistemi vicino ai dati stessi.
Se le contestazioni sulle dashboard si ripetono, se gli output dei modelli derivano senza modifiche al codice o se i thread sugli incidenti finiscono sempre con «la pipeline è andata a buon fine», il divario di monitoraggio sta già costando al business. Per una visione lato business delle conseguenze, leggete questa analisi sull'impatto della scarsa qualità dei dati sulle decisioni aziendali.
Che cosa significa monitorare la qualità dei dati nel 2026
Una pipeline termina alle 5:00. Ogni task è verde. Alle 9:30 la finanza mette in dubbio i ricavi, il prodotto vede oscillazioni di conversione impossibili e il team dati è bloccato a dimostrare che i job sono stati effettivamente eseguiti. È questo il divario che il monitoraggio della qualità dei dati deve colmare nel 2026.
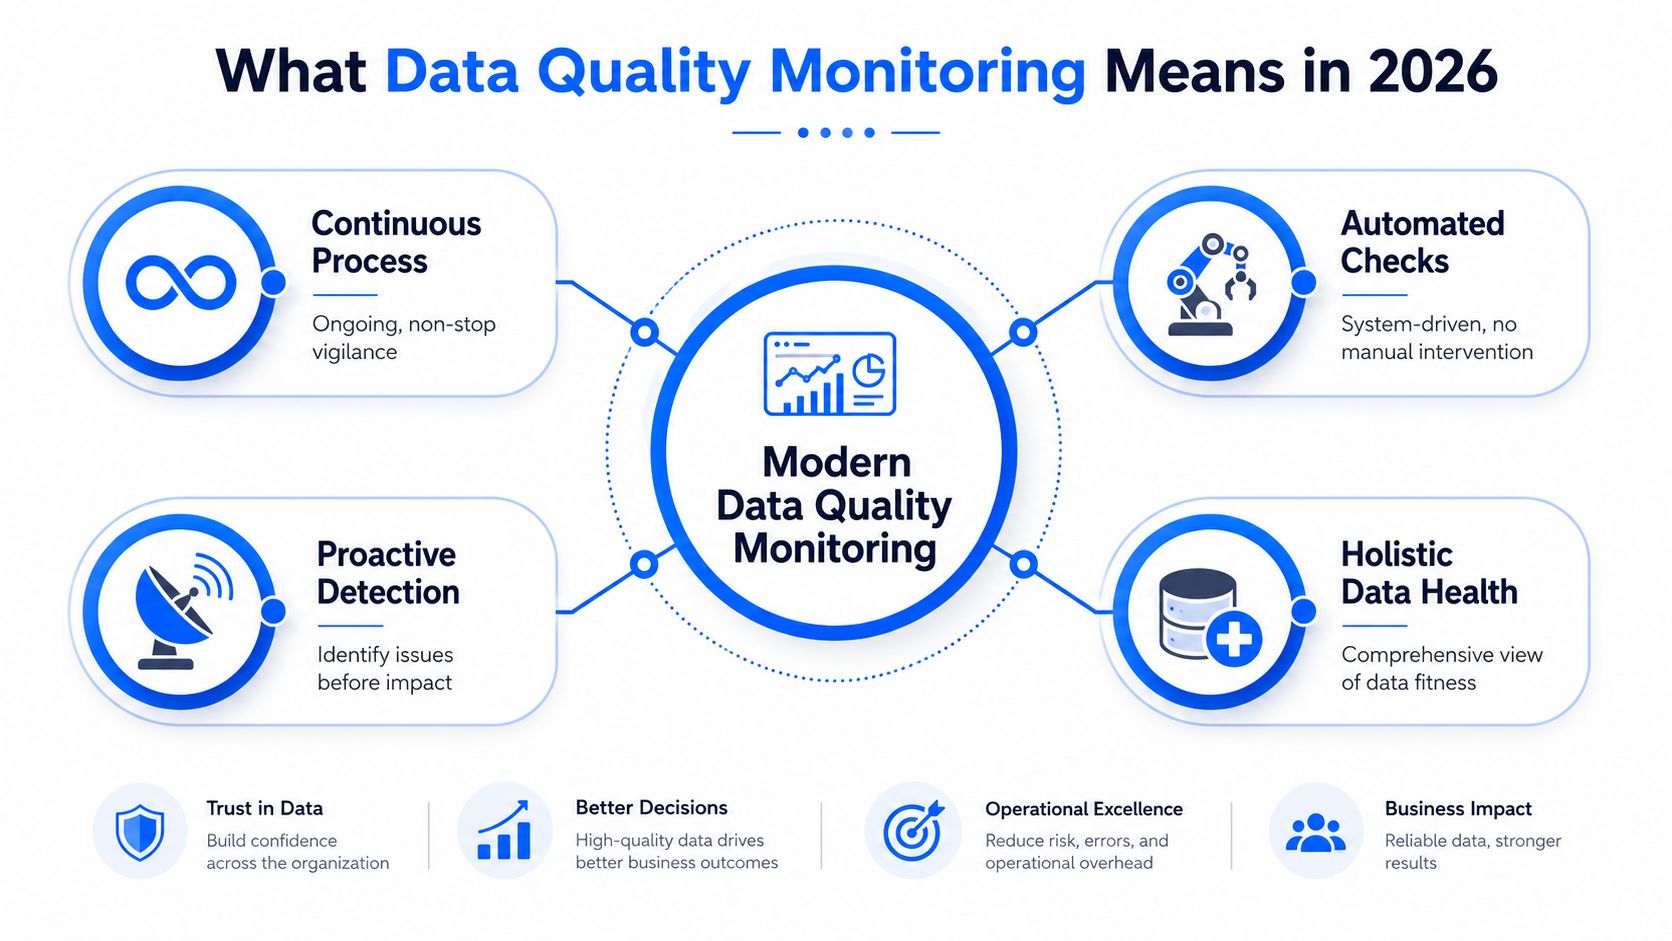
Oggi il monitoraggio della qualità dei dati funziona come un sistema di controllo continuo per pipeline, tabelle, modelli e asset critici per il business. Il compito non è solo confermare che i dati siano arrivati. Il compito è confermare che i dati si comportino ancora come il business si aspetta, nel punto in cui vengono utilizzati.
Dalla validazione occasionale al controllo continuo
I programmi più datati trattavano la qualità come un insieme di controlli fissi collegati a una pipeline. Test sui null, valori ammessi, conteggi delle righe e asserzioni sullo schema hanno ancora il loro posto nello stack. Intercettano rapidamente i guasti evidenti. Non intercettano però la categoria di guasti più costosa, in cui i dati sono tecnicamente validi ma operativamente sbagliati.
Questa distinzione conta ancora di più su scala enterprise. Una tabella può caricarsi puntualmente ed essere comunque errata perché una sorgente ha cambiato la logica di business, una regione ha smesso di inviare eventi o un servizio upstream ha iniziato a riempire un campo con un valore predefinito che supera ogni test di completezza. Il data warehouse è di solito il posto migliore per rilevare questo tipo di deriva, perché contiene lo storico, le relazioni tra tabelle e il contesto di business.
Il monitoraggio moderno combina di solito quattro livelli:
Monitoraggio comportamentale: seguire i pattern normali di volume, freschezza, distribuzioni e stagionalità.
Monitoraggio strutturale: intercettare schema drift, cambi di tipo, interruzioni della lineage e guasti nelle dipendenze.
Monitoraggio operativo: sorvegliare schedulazioni, dati in arrivo tardivo, tentativi ripetuti e caricamenti parziali.
Validazione di business: applicare la logica legata a contratti, policy, controlli finanziari o metriche rivolte ai clienti.
I team devono anche tracciare una linea chiara tra qualità e observability. La qualità risponde alla domanda: «Questi dati sono affidabili per questo caso d'uso?». L'observability risponde a: «Vediamo abbastanza del sistema da rilevare, localizzare e spiegare rapidamente un problema?». La differenza conta nella scelta degli strumenti e nella definizione delle responsabilità. Un riferimento utile è questo confronto tra data observability e data quality.
Perché i team stanno cambiando approccio
Il vecchio modello operativo fallisce in modi prevedibili. Gli analisti scoprono un problema durante la revisione di una dashboard. Gli ingegneri rilanciano un job. La metrica torna normale. Nessuno corregge il segnale debole che avrebbe dovuto far scattare un alert sei ore prima.
Vedo lo stesso schema in grandi ambienti con centinaia di data product. La pulizia manuale può risolvere un problema isolato. Le regole statiche possono proteggere vincoli noti. Nessuno dei due approcci scala bene quando i team gestiscono input in streaming, feed di fornitori, modelli semantici, sincronizzazioni reverse ETL e feature di ML che dipendono tutti dalle stesse entità principali.
Approccio | Cosa fa bene | Dove si rompe |
|---|---|---|
Pulizia manuale | Utile per incidenti isolati | Troppo tardiva per l'analisi operativa |
Regole statiche | Valide per vincoli espliciti | Fragili quando il comportamento dei dati evolve |
Controlli sulle dashboard | Visibili agli analisti | Ignorano il contesto upstream della pipeline |
Monitoraggio continuo | Intercetta i problemi prima | Richiede disciplina nella progettazione |
Il compromesso è reale. Il monitoraggio continuo richiede lavoro di configurazione, responsabilità chiare e un accordo su cosa significhi «normale» per ogni dataset critico. Ma questo costo è inferiore a quello di triage ripetuti degli incidenti, di continue spiegazioni al management e di team che prendono decisioni su dati degradati senza accorgersene.
Questo vale ben oltre le grandi aziende. Anche i team più piccoli che costruiscono il loro primo stack di reporting incontrano lo stesso schema di guasto non appena alcune dashboard diventano input operativi. I founder e i primi analisti assunti che affrontano il tema della data analytics per le startup si scontrano con il problema prima del previsto, perché una sola sorgente difettosa può colpire contemporaneamente finanza, crescita e reporting clienti.
Come si riconosce un buon monitoraggio
Un buon monitoraggio funziona in modo automatico, vicino ai dati e con un contesto sufficiente a spiegare cosa è cambiato. Dà priorità agli asset in base all'impatto sul business invece di cercare di sorvegliare tutto allo stesso modo. Inoltre instrada gli alert verso il team che può intervenire, con evidenze sufficienti a ridurre i tempi di indagine.
In pratica, i team maturi smettono di chiedersi: «La tabella si è caricata?». Si chiedono: «Si è caricata in tempo, con le relazioni, le distribuzioni e il significato di business attesi per questo workflow?». È questo lo standard nel 2026. Qualsiasi cosa di meno lascia troppo spazio ai guasti silenziosi per raggiungere il business.
Le metriche fondamentali che contano davvero
Non servono più metriche; serve invece concentrarsi su quelle legate alle domande di business. Se una metrica non aiuta un ingegnere o un responsabile analytics a decidere se i dati sono sicuri da usare, è solo rumore.
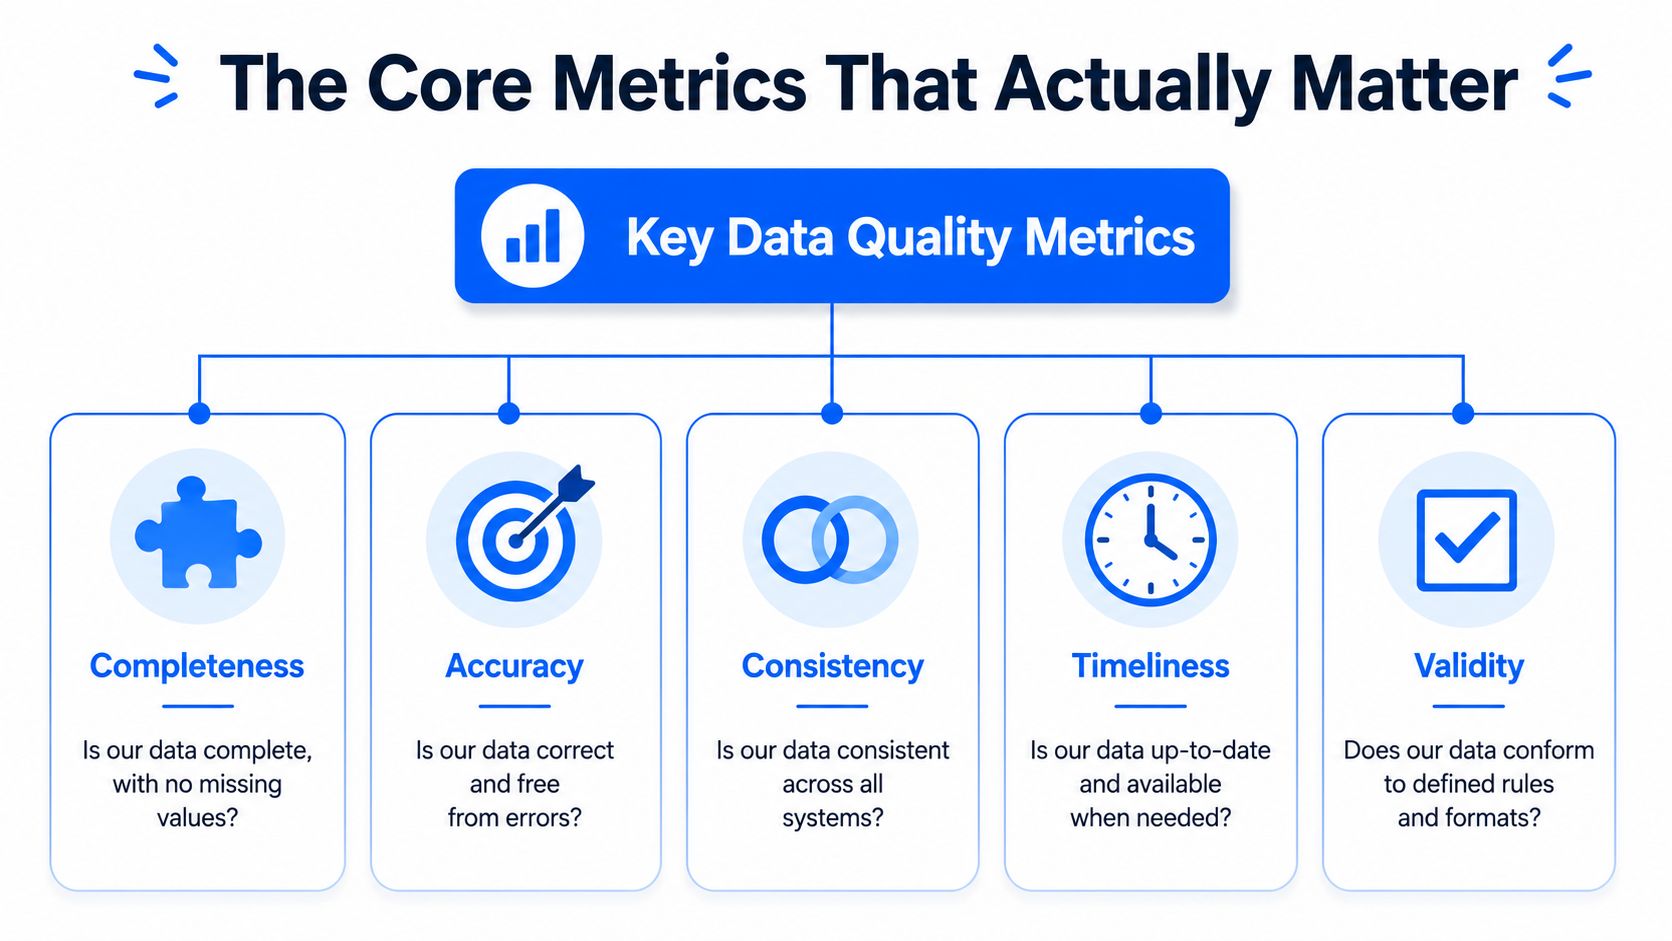
Il framework più utile parte da cinque domande. I dati sono completi? Sono accurati? Sono coerenti tra i sistemi? Sono puntuali? Rispettano la struttura e il formato attesi?
Completezza e accuratezza
La completezza verifica che i dati richiesti siano presenti. Righe mancanti, picchi di null e record compilati solo in parte sono spesso i primi sintomi visibili di un caricamento difettoso. Ciò conta soprattutto nelle pipeline di reporting, dove le metriche a valle presuppongono un'ampia copertura.
L'accuratezza verifica che i valori riflettano la realtà. Un timestamp può essere presente ed essere comunque sbagliato. Un segmento cliente può essere compilato ed essere comunque classificato in modo errato. L'accuratezza è più difficile della completezza perché spesso dipende dal contesto di business, dai dati di riferimento o dal confronto tra sistemi.
Quando si applica un monitoraggio rigoroso, le metriche di qualità dei dati possono raggiungere in media il 99,9% di completezza, il 99,8% di accuratezza e il 96,3% di tempestività, ed è per questo che restano pilastri fondamentali di un framework di monitoraggio efficace, secondo Congruence Market Insights.
Per i team più piccoli che costruiscono le loro prime basi di analytics, questa guida pratica alla data analytics per le startup è utile perché inquadra l'affidabilità dei dati in base all'uso reale da parte del business invece che in termini teorici astratti.
Coerenza e validità
La coerenza è il punto in cui molti programmi di data warehouse inciampano. I ricavi nel reporting di finanza, vendite e prodotto possono provenire tutti dalla stessa azienda ma differire comunque perché la logica di trasformazione, gli orari di chiusura o i sistemi sorgente non sono allineati. Monitorare la coerenza significa verificare che i sistemi correlati raccontino la stessa storia.
La validità è più circoscritta e spesso più facile da automatizzare. Il valore rispetta le aspettative di tipo, intervallo, formato o regola di business? Pensate ai formati di data, alle enumerazioni ammesse, a quantità negative impossibili o a ID malformati.
Un modo sintetico per inquadrare questi due aspetti:
Metrica | Domanda di business | Guasto tipico |
|---|---|---|
Coerenza | I sistemi concordano? | Definizioni o join in conflitto |
Validità | Il record rispetta le regole? | Formato, tipo o vincolo errato |
Tempestività e integrità dello schema
Oggi la tempestività conta di più perché moltissime decisioni dipendono da dati quasi in tempo reale. Una tabella che arriva con due ore di ritardo può superare la maggior parte dei controlli a livello di record ed essere comunque inutile per una riunione di pianificazione o per un workflow di alerting. La freschezza non è solo una metrica operativa. È una metrica di affidabilità del business.
L'integrità dello schema merita la stessa attenzione. Una colonna rinominata, un tipo modificato o un campo riordinato possono contaminare in modo subdolo le trasformazioni a valle. I team spesso monitorano in modo aggressivo i valori mancanti e investono poco nella deriva strutturale, un errore negli ambienti soggetti a frequenti cambiamenti.
Se monitorate solo il contenuto e ignorate la struttura, vi sfuggiranno alcuni dei guasti più costosi.
Per molti team, una scorecard pratica consiste nel seguire queste metriche con diversi livelli di criticità. Se un data mart finanziario destinato al management richiede un'accuratezza quasi perfetta e consegne puntuali, trattatelo in modo diverso da un dataset esplorativo a basso rischio. Ecco perché un framework chiaro per le metriche di qualità dei dati conta più di un lungo elenco di controlli generici.
Metodi di rilevamento: AI contro regole manuali
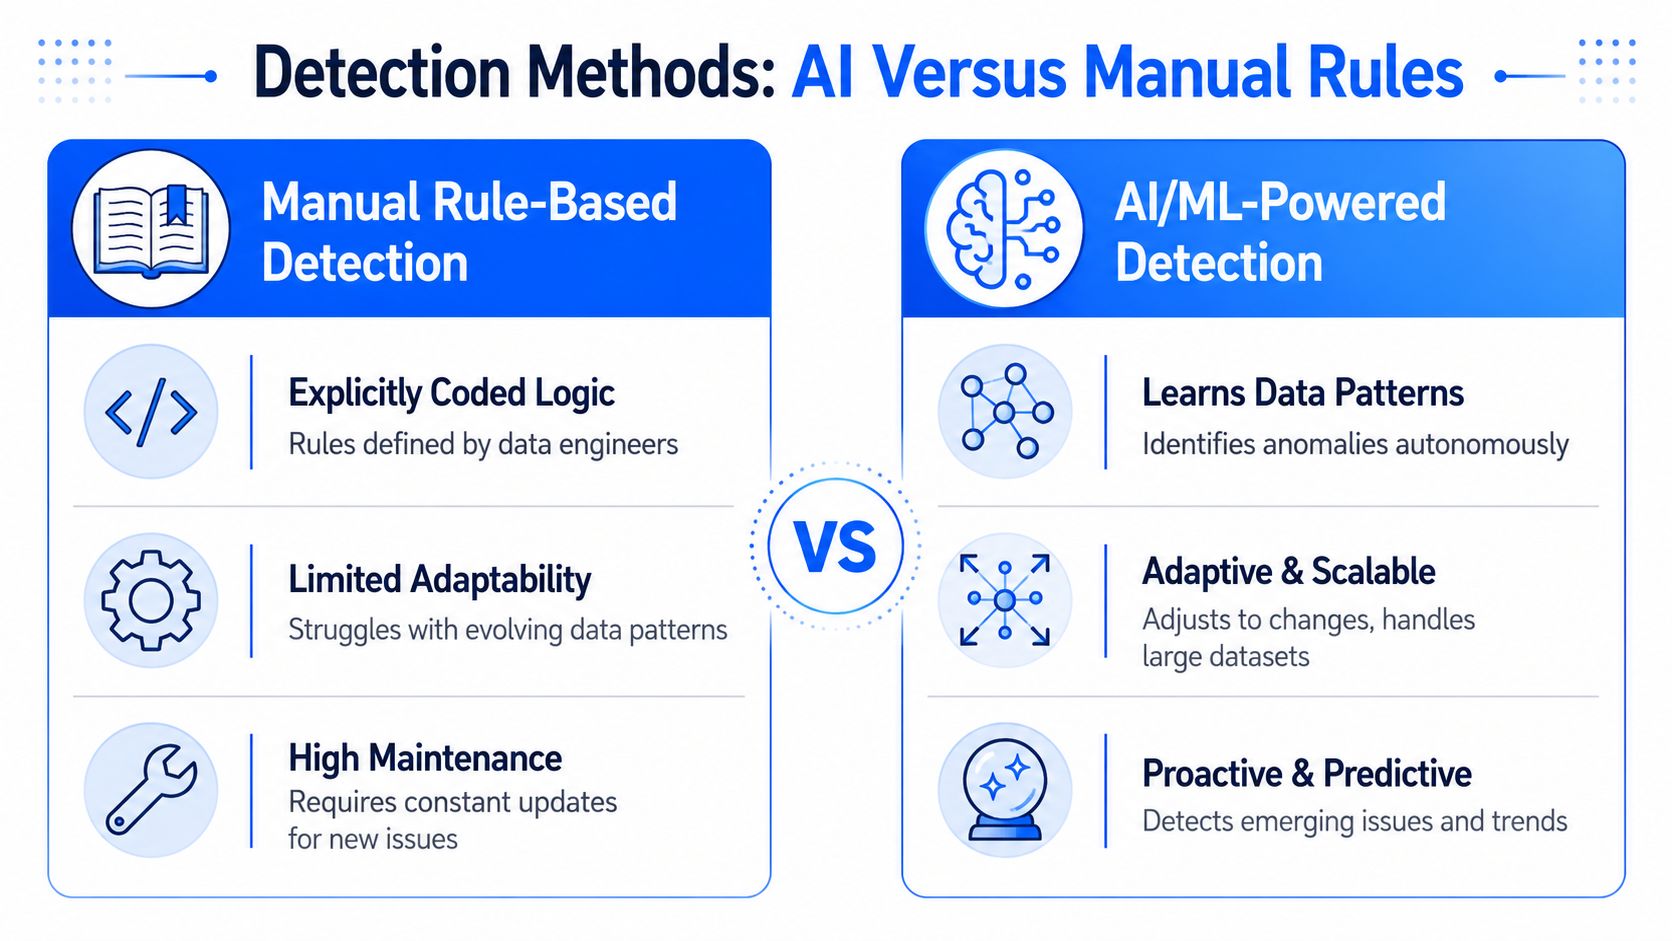
La maggior parte dei team dati parte dalle regole manuali perché sono familiari. Si scrive SQL per controlli sui null, intervalli ammessi, unicità e conteggi delle righe. Li si inserisce in test dbt, task di Airflow, procedure del data warehouse o job Python personalizzati. Per un po' funziona.
Poi la piattaforma cresce. Arrivano nuove sorgenti. Gli schemi cambiano più spesso. L'uso si estende dalla BI all'analisi operativa e al ML. A quel punto il catalogo delle regole diventa un peso da mantenere e il team inizia a reagire a lacune che non erano state codificate in anticipo.
Cosa fanno ancora bene le regole manuali
Il rilevamento basato su regole resta lo strumento giusto per i vincoli di business espliciti. Se lo stato di un ordine deve appartenere a un insieme noto, una regola deve imporlo. Se un campo di compliance è obbligatorio, usate una regola. Se la data di un pagamento non può precedere la creazione del contratto, codificate direttamente questa logica.
Le regole manuali danno il meglio quando il team sa rispondere chiaramente a due domande:
Che cosa deve essere vero, esattamente?
Quale azione deve seguire se non lo è?
Questa chiarezza è preziosa. Il problema è la copertura. Le regole statiche intercettano solo ciò che gli ingegneri hanno previsto e si sono presi il tempo di codificare.
Dove i controlli statici non bastano più
I set di regole faticano con baseline che cambiano. Un conteggio di righe normale per un lunedì può essere sospetto di venerdì. Una distribuzione delle conversioni può spostarsi abbastanza lentamente da non superare alcuna soglia rigida, ma abbastanza nettamente da influire su attribuzione o previsioni. I controlli statici richiedono inoltre frequenti aggiornamenti delle soglie, soprattutto quando cambiano la stagionalità del business o il comportamento delle sorgenti.
È qui che il rilevamento delle anomalie basato su AI fa la differenza. A differenza dei sistemi tradizionali basati su regole, che richiedono frequenti aggiornamenti delle soglie, il rilevamento delle anomalie basato su AI si adatta automaticamente a nuovi pattern e tendenze dei dati, facendo emergere minacce sottili che i sistemi statici non vedono, senza dipendere da regole predefinite, come descritto nella spiegazione di Plixer sul rilevamento delle anomalie basato su AI.
Un'utile panoramica di questo compromesso più ampio è questo confronto tra qualità dei dati basata su AI e metodi tradizionali.
Ecco la differenza pratica:
Tipo di rilevamento | Ideale per | Punto debole |
|---|---|---|
Regole manuali | Vincoli noti e logica di audit | Non vede gli imprevisti sconosciuti |
Rilevamento delle anomalie con AI | Deviazioni dai pattern e derive | Richiede buone baseline e un workflow di revisione |
Il punto successivo è più facile da capire nella pratica:
Come funziona in pratica il rilevamento basato su AI
Un buon workflow di gestione delle anomalie non sostituisce il giudizio degli ingegneri. Cambia il modo in cui gli ingegneri impiegano il loro tempo. Invece di aggiornare manualmente centinaia di soglie fragili, il sistema apprende i pattern normali sulle tabelle configurate, profila continuamente i dati in arrivo e confronta il nuovo comportamento con le baseline apprese. Gli ingegneri esaminano quindi le deviazioni significative invece di mantenere un gigantesco inventario di regole.
Questo approccio è più efficace se abbinato a una preelaborazione e a un'indagine disciplinate. I team hanno comunque bisogno di input puliti, di una gestione dei valori mancanti e di una progettazione sensata delle feature prima di scegliere il comportamento del modello o di calibrarne la sensibilità. Serve anche un percorso di risposta per ciò che accade dopo il rilevamento.
L'AI deve individuare i cambiamenti sospetti. Sono comunque gli ingegneri a decidere se quel cambiamento è atteso, dannoso o un segnale per aggiornare le ipotesi.
Negli ambienti maturi, lo schema più solido è quello ibrido. Usate le regole per la logica di business rigida e la compliance. Usate il rilevamento delle anomalie per derive, rotture di trend, distribuzioni insolite e guasti silenziosi delle pipeline che nessuno aveva specificato esplicitamente in anticipo.
Scelte architetturali: in-database o basato su ETL
Dove viene eseguito il monitoraggio conta quanto ciò che controlla. Molti team lo trattano come un dettaglio implementativo. Non lo è. L'architettura determina latenza, postura di sicurezza, costi operativi e la rapidità con cui il team può indagare sulle anomalie disponendo del contesto completo.
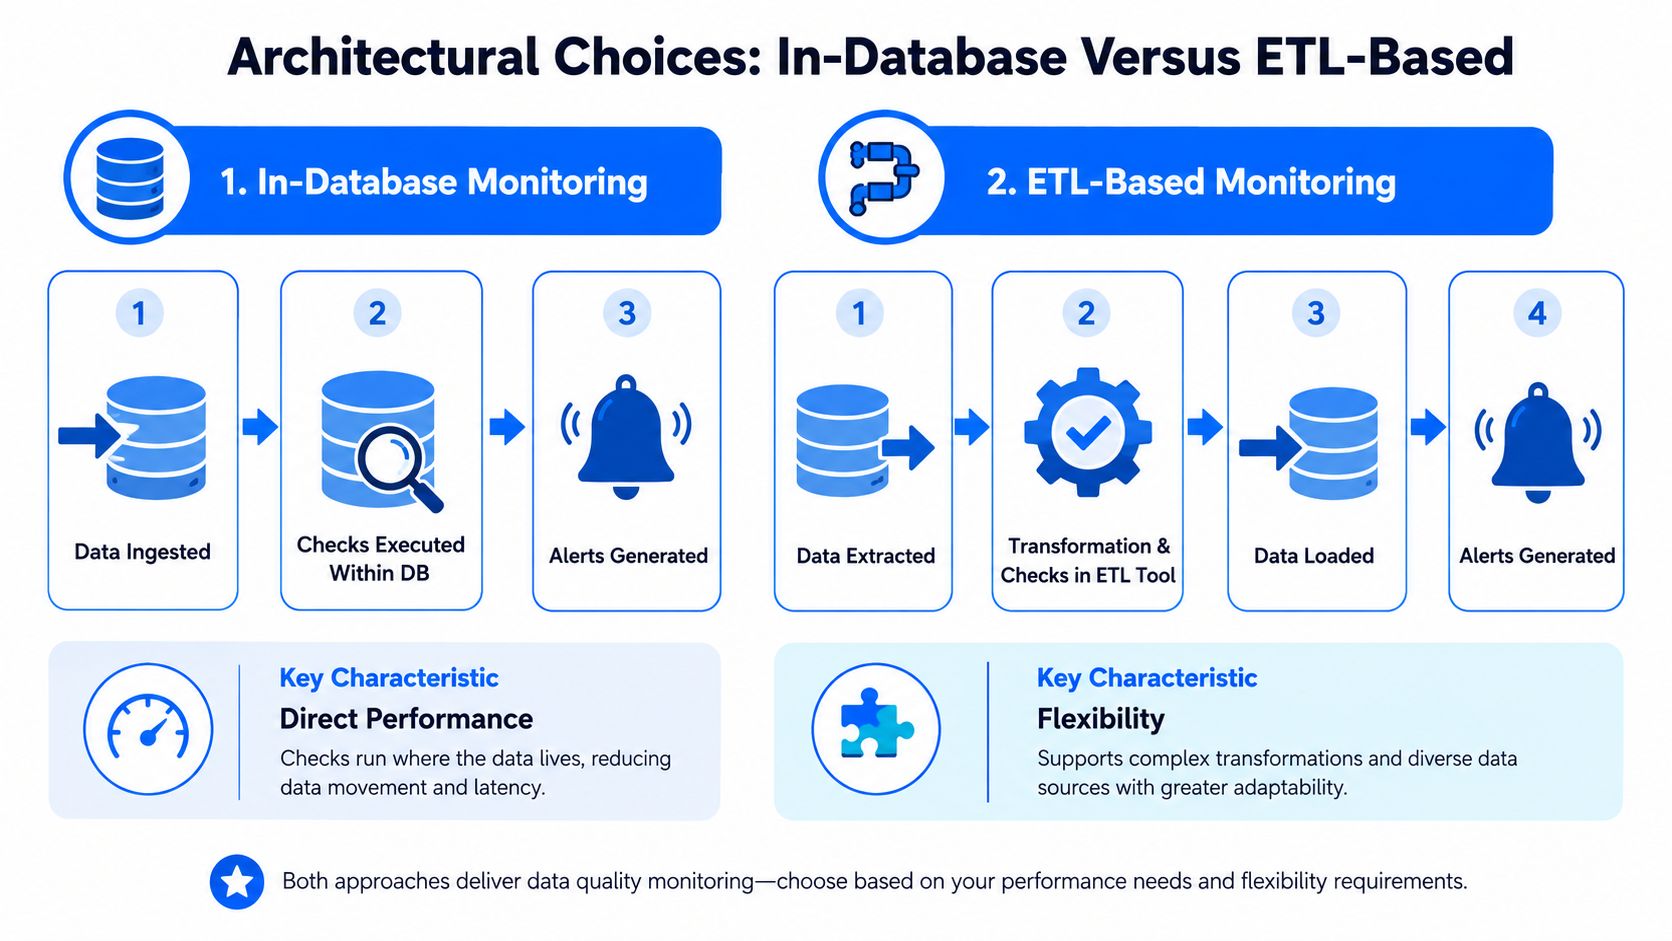
I due schemi più comuni sono semplici. Un approccio estrae i dati in un ambiente separato per l'analisi della qualità. L'altro esegue la logica di monitoraggio all'interno del data warehouse o del database in cui i dati risiedono già.
Perché il monitoraggio basato su ETL crea attriti
Il monitoraggio esterno può sembrare allettante all'inizio. I team dispongono già di strumenti ETL, quindi aggiungere lì i controlli sembra comodo. Può anche offrire flessibilità per codice personalizzato o un'orchestrazione centralizzata. Ma i costi nascosti emergono presto.
Spostare i dati all'esterno per ispezionarli introduce un ulteriore percorso da proteggere, un ulteriore runtime da gestire e un ulteriore punto in cui le tempistiche possono discostarsi dal sistema di produzione. Più copie e passaggi intermedi si aggiungono, più diventa difficile rispondere a domande semplici come quale versione dei dati sia stata controllata e quando.
Alcuni problemi ricorrenti del monitoraggio basato su ETL:
Overhead dovuto allo spostamento dei dati: estrarre i dati per i controlli aggiunge latenza e complessità infrastrutturale.
Esposizione in termini di sicurezza: più spostamenti significano una superficie più ampia per controllo degli accessi e governance.
Distanza nel debugging: gli ingegneri indagano in un ambiente mentre il problema è nato in un altro.
Lacune di freschezza: i controlli possono essere eseguiti su dati copiati invece che sullo stato attuale consumato dagli utenti di business.
Perché il monitoraggio in-database è più adatto alle operazioni enterprise
Il monitoraggio in-database sposta il calcolo nel data warehouse o nel database controllato dal cliente. Questo cambia il modello operativo in modo utile. I dati restano dove sono. Le baseline possono essere apprese vicino alla sorgente. Tempestività, comportamento dello schema e controlli statistici possono essere valutati sui dati che alimentano report e modelli.
Ciò conta soprattutto negli ambienti regolamentati o su larga scala. I team in private cloud e on-premises spesso non possono accettare un modello che dipende dall'accesso del fornitore ai dati di produzione. E non possono nemmeno permettersi lunghe catene di spostamenti solo per calcolare metriche di observability.
Il vantaggio di cui si parla poco è la correlazione. Analisi recenti indicano che l'85% degli strumenti di qualità dei dati monitora le modifiche allo schema, mentre meno del 20% correla efficacemente i ritardi di schedulazione in tempo reale con le baseline delle metriche calcolate in-database, il che evidenzia una lacuna che le architetture in-database sono particolarmente adatte a colmare, secondo Frontiers in Big Data.
Questa lacuna è importante perché molti guasti in ambito enterprise non riguardano solo valori malformati. Sono combinazioni di tempistiche, modifiche strutturali e derive comportamentali che si verificano insieme.
Una chiave di lettura pratica per decidere
Se dovete scegliere un'architettura, valutatela in base a domande operative piuttosto che a checklist di funzionalità.
Domanda decisionale | Monitoraggio in-database | Monitoraggio basato su ETL |
|---|---|---|
Dove restano i dati? | Nell'ambiente del cliente | Spesso copiati o parcheggiati all'esterno |
Quanto rapidamente i controlli riflettono lo stato attuale? | Più vicino al tempo reale | Dipende dalle tempistiche di estrazione |
Quanto è semplice la root cause analysis? | Più vicina al contesto della sorgente | Suddivisa tra più sistemi |
Quanto si adatta a una governance rigorosa? | Ottima compatibilità | Spesso richiede più verifiche |
La migliore architettura di monitoraggio è quella che riduce al minimo la distanza tra il problema e le evidenze.
C'è anche un aspetto pratico legato al personale. I team già sotto pressione non dovrebbero passare il loro tempo a mantenere un secondo stack di analytics solo per osservare il primo. Mantenere il monitoraggio all'interno del data warehouse riduce la proliferazione dei sistemi e ancora le indagini alla stessa piattaforma dati che gli ingegneri usano già.
Cosa funziona sul campo
Per data warehouse su scala enterprise e pipeline complesse, le implementazioni più solide condividono di solito alcune caratteristiche:
Calcolano le metriche dove risiedono i dati. Questo riduce gli spostamenti e mantiene i controlli allineati alla realtà della produzione.
Combinano monitoraggio strutturale e comportamentale. I soli controlli sullo schema non intercettano le derive di schedulazione. I soli controlli di freschezza non intercettano i cambi di tipo.
Supportano l'apprendimento delle baseline nel tempo. Le istantanee statiche servono a poco quando i pattern di utilizzo evolvono.
Rispettano i vincoli di private cloud o on-premises. I requisiti di sicurezza non sono una questione secondaria negli ambienti finanziari, sanitari, delle telecomunicazioni o della pubblica amministrazione.
I team che ignorano queste scelte finiscono spesso con un monitoraggio frammentato. Uno strumento sorveglia i job. Un altro ispeziona le trasformazioni. Un terzo gestisce la validazione. Gli incidenti richiedono allora di ricucire a mano timestamp, alert e screenshot. Questa non è observability. È archeologia manuale.
Un runbook pratico per risolvere i problemi dei dati
Il monitoraggio diventa utile quando cambia il modo in cui il team risponde ai guasti più comuni. I runbook migliori sono brevi, specifici e legati all'impatto sul business. Indicano agli ingegneri cosa sorvegliare, quale segnale conta e quale azione deve seguire.
Report obsoleti e dati in ritardo
Prima il problema. Una dashboard si aggiorna secondo la schedulazione, ma la sorgente sottostante è arrivata in ritardo. Il report sembra aggiornato perché il livello di BI è stato renderizzato correttamente. Il business vede numeri vecchi e dà per scontato che siano freschi.
Il runbook dovrebbe concentrarsi sul monitoraggio della tempestività e degli arrivi attesi:
Seguite i pattern di consegna: non basatevi solo sul successo del job. Monitorate quando i dati arrivano di solito e generate un alert in caso di ritardi anomali.
Verificate che il livello a valle sia pronto: una tabella può aggiornarsi mentre i data mart dipendenti restano obsoleti.
Effettuate l'escalation in base alla criticità per il business: reporting per il management, chiusura contabile e alerting operativo non dovrebbero condividere le stesse soglie di alert dell'analisi esplorativa.
Il risultato desiderato non è solo un alert. È un punto di controllo decisionale. Se il controllo di freschezza fallisce, la dashboard deve essere considerata non affidabile finché il caricamento non è stato verificato.
Drift dei modelli ML e modifiche allo schema
I sistemi di ML falliscono in modo impercettibile quando le distribuzioni o le strutture degli input si spostano. Le feature possono restare compilate pur assumendo un comportamento diverso dalle ipotesi di addestramento. Un campo rinominato può inoltre rompere le trasformazioni a monte del modello senza causare un'evidente interruzione dell'applicazione.
Un runbook pratico usa insieme tre livelli:
Tipo di guasto | Segnale di monitoraggio | Risposta |
|---|---|---|
Aggiornamenti tardivi delle feature | Deviazione della tempestività | Sospendere lo scoring o gli input di riaddestramento |
Deriva della distribuzione | Anomalia statistica | Esaminare il comportamento delle feature e il registro delle modifiche alla sorgente |
Mancata corrispondenza dello schema | Alert di modifica strutturale | Bloccare il consumo a valle fino alla mappatura |
L'obiettivo non è intercettare ogni stranezza. È fermare il degrado silenzioso prima che le previsioni influenzino prezzi, ranking, verifiche antifrode o operazioni.
Compliance ed evidenze per gli audit
I casi d'uso di compliance richiedono qualcosa di diverso dagli alert sulle anomalie. Richiedono evidenze che possano essere esaminate e difese. Di solito ciò significa una validazione a livello di record legata a regole esplicite, oltre a un modo per tradurre i risultati statistici in un linguaggio di governance utilizzabile anche da chi non lavora nell'ingegneria.
Uno studio IDC rivela che il 70% delle aziende fatica a validare i risultati dell'AI per gli audit normativi, ed è proprio per questo che i team hanno bisogno di runbook che traducano le anomalie in evidenze di compliance strutturate, come discusso in questa analisi pubblicata dal NIH.
Questo livello di traduzione è importante. Un ingegnere può interpretare una deviazione come un outlier o un evento di deriva. Un auditor vuole sapere se l'integrità, la completezza o la coerenza sono state compromesse, quali controlli sono scattati e chi ha esaminato il problema.
Costruite il vostro runbook in modo che un'anomalia possa diventare un record di incidente, non solo un grafico su una schermata di monitoraggio.
Un runbook di compliance solido include di solito:
Regole di validazione esplicite: usate controlli deterministici per la logica obbligatoria delle policy.
Mappatura della gravità: collegate le anomalie a categorie di governance comprensibili per gli stakeholder.
Note di indagine: registrate cosa è cambiato, dove è stato rilevato e se gli output a valle sono stati compromessi.
Criteri di chiusura: definite quali evidenze risolvono l'incidente e cosa richiede una correzione.
Portare il runbook nelle operazioni quotidiane
I team che traggono valore dal monitoraggio della qualità dei dati non inseguono una copertura perfetta. Partono dai punti in cui i dati errati creano un rischio immediato per il business. Report per il management, pipeline dei ricavi, feature table di ML, dataset regolamentati. Poi vi associano rilevamento, responsabilità e risposta.
È questa la differenza tra un programma di monitoraggio e una raccolta di controlli. Il primo cambia il modo in cui l'organizzazione gestisce l'incertezza. La seconda produce solo alert.
Se il vostro team ha bisogno di un monitoraggio della qualità dei dati che funzioni all'interno del vostro ambiente e copra in un unico posto anomalie, tempestività, validazione e modifiche allo schema, date un'occhiata a digna. È pensato per i team dati enterprise che vogliono un rilevamento più precoce, meno proliferazione di strumenti e un percorso più chiaro dal segnale all'azione.
Per vedere in pratica il runbook sui report obsoleti, guardate come digna Timeliness monitora l'arrivo atteso dei dati all'interno del vostro ambiente, così i caricamenti in ritardo vengono intercettati prima di raggiungere una dashboard.
Domande frequenti
Che cos'è il monitoraggio della qualità dei dati?
Il monitoraggio della qualità dei dati è un sistema di controllo continuo che verifica se i dati si comportano ancora come il business si aspetta nel punto in cui vengono utilizzati, non solo se sono arrivati. L'articolo descrive quattro livelli: monitoraggio comportamentale di volumi e distribuzioni, monitoraggio strutturale dello schema drift, monitoraggio operativo delle schedulazioni e validazione di business.
Quali metriche di qualità dei dati conviene monitorare?
Partite da cinque domande: i dati sono completi, accurati, coerenti tra i sistemi, puntuali e strutturalmente validi? Citando Congruence Market Insights, l'articolo osserva che un monitoraggio rigoroso può raggiungere in media il 99,9 percento di completezza, il 99,8 percento di accuratezza e il 96,3 percento di tempestività. Seguitele in base alla criticità, applicando lo standard più severo ai data mart finanziari destinati al management.
Conviene usare il rilevamento delle anomalie con AI o regole manuali di qualità dei dati?
Usate entrambi. Le regole manuali restano la scelta giusta per i vincoli espliciti, come uno stato dell'ordine appartenente a un insieme noto o una data di pagamento che non può precedere la creazione del contratto. Il rilevamento delle anomalie con AI apprende le baseline e intercetta derive, rotture di trend e distribuzioni insolite che nessuno aveva codificato, ed è per questo che l'articolo raccomanda un approccio ibrido.
Perché il monitoraggio in-database è migliore di quello basato su ETL?
Il monitoraggio in-database calcola le metriche dove risiedono i dati, evitando la latenza, l'esposizione in termini di sicurezza, la distanza nel debugging e le lacune di freschezza dovute all'estrazione dei dati per i controlli. L'articolo cita Frontiers in Big Data: l'85 percento degli strumenti monitora le modifiche allo schema, ma meno del 20 percento correla i ritardi di schedulazione con le baseline delle metriche in-database.
Come si rilevano i report obsoleti causati da dati in ritardo?
Monitorate quando i dati arrivano di solito e generate un alert in caso di ritardi anomali, invece di fidarvi del successo del job. Nell'esempio dell'articolo, Airflow segna un caricamento in verde alle 6:12, ma la dashboard del management si è aggiornata alle 6:00. Verificate che i data mart a valle siano pronti, effettuate l'escalation in base alla criticità per il business e considerate la dashboard non affidabile finché non è stata verificata.


