Metriche di qualità dei dati: la guida completa per il 2026
|
7
min di lettura
Alle 8:00 una dashboard sembrava a posto. Alle 9:15 la finanza metteva in dubbio il dato sui ricavi, le operations inseguivano un problema su una spedizione e il team dati cercava di capire se il problema fosse nato nell'ingestion, nella trasformazione o in un sistema sorgente che durante la notte aveva cambiato struttura.
È lì che di solito si trovano le organizzazioni quando iniziano a prendere sul serio la qualità dei dati. Non nel momento della teoria, ma in quello del guasto. Un campo indirizzo mancante blocca l'evasione di un ordine. Un record cliente duplicato gonfia un KPI. Una tabella obsoleta alimenta un modello che ieri era accurato e oggi è inaffidabile.
Le metriche di qualità dei dati sono il modo per smettere di discutere d'istinto e iniziare a operare sulla base di evidenze. Trasformano la sensazione che “qualcosa non torna” in segnali misurabili, controlli ripetibili e workflow di gestione degli incidenti di cui le persone possono fidarsi.
Indice
Perché le metriche di qualità dei dati sono irrinunciabili nel 2026
Cosa cambiano le metriche nella pratica
Le sei dimensioni fondamentali della qualità dei dati
Accuratezza
Completezza
Coerenza
Tempestività
Validità
Unicità
Come calcolare le metriche fondamentali di qualità dei dati
Partite da un contratto della metrica
Formule SQL che i team usano davvero
Le soglie appartengono ai casi d'uso, non alle tabelle
Dalle metriche grezze a insight azionabili
Soglie di cui le persone si fidano
Alert che non insegnano ai team a ignorarli
Campionamento e baseline in ambienti disordinati
Rendere operativa la qualità dei dati: un esempio di dashboard di KPI
Cosa mostra la dashboard a colpo d'occhio
Cosa ne fa ciascun team
Sfide avanzate a cui le metriche standard non rispondono
Micro-errori nascosti dentro medie positive
Perché un punteggio unico è più difficile di quanto sembri
Come le piattaforme di data observability automatizzano le metriche di qualità
Perché le metriche di qualità dei dati sono irrinunciabili nel 2026
Di solito i team scoprono di aver bisogno di metriche di qualità dei dati dopo un incidente evitabile. Un report per il consiglio di amministrazione è sbagliato. Una tabella di feature di machine learning è obsoleta. Una modifica dello schema arriva senza preavviso e la logica a valle continua a girare come se nulla fosse.
Il problema non sono solo i dati di cattiva qualità. Il problema sono i dati di cattiva qualità senza strumenti di misura.
Secondo la raccolta di statistiche sulla qualità dei dati di Monte Carlo, Gartner prevede che il 30% delle organizzazioni non riuscirà a portare a termine con successo le iniziative data-driven a causa della scarsa qualità dei dati, mentre il 41% delle organizzazioni fatica a gestire oltre 1.000 fonti di dati. A questa scala, il controllo manuale smette di essere una disciplina e diventa un pio desiderio.
Cosa cambiano le metriche nella pratica
Un team maturo non si chiede: “Questo dataset è buono?”. Si pone domande più circoscritte e operative:
I dati sono abbastanza freschi per la decisione che supportano?
I campi obbligatori sono arrivati per il caricamento corrente?
I record sono conformi alle regole di business e di formato?
Una sorgente ha cambiato struttura senza un rilascio coordinato?
Il problema è locale o sistemico tra domini e pipeline?
Sono queste domande a trasformare la qualità dei dati da linguaggio di governance a lavoro di engineering.
Regola pratica: se non riuscite ad associare una metrica a una modalità di guasto, non avete ancora una strategia di monitoraggio. Avete una policy.
È anche per questo che il lavoro sulla qualità dei dati inizia a sovrapporsi alla telemetria operativa. I team che stanno già padroneggiando la gestione centralizzata dei log di solito si adattano più rapidamente, perché conoscono già baseline, rumore degli alert, correlazione degli eventi e ownership degli incidenti. Le metriche sui dati richiedono lo stesso modello operativo.
Un buon sistema non insegue la perfezione. Misura ciò che conta, al livello giusto, con soglie legate alle conseguenze per il business.
Le sei dimensioni fondamentali della qualità dei dati
Il vocabolario standard conta ancora. Accuratezza, completezza, coerenza, tempestività, validità e unicità sono le sei dimensioni più usate nella pratica e sono in linea con l'impostazione ISO/IEC 25012:2008 riassunta in questa rassegna.
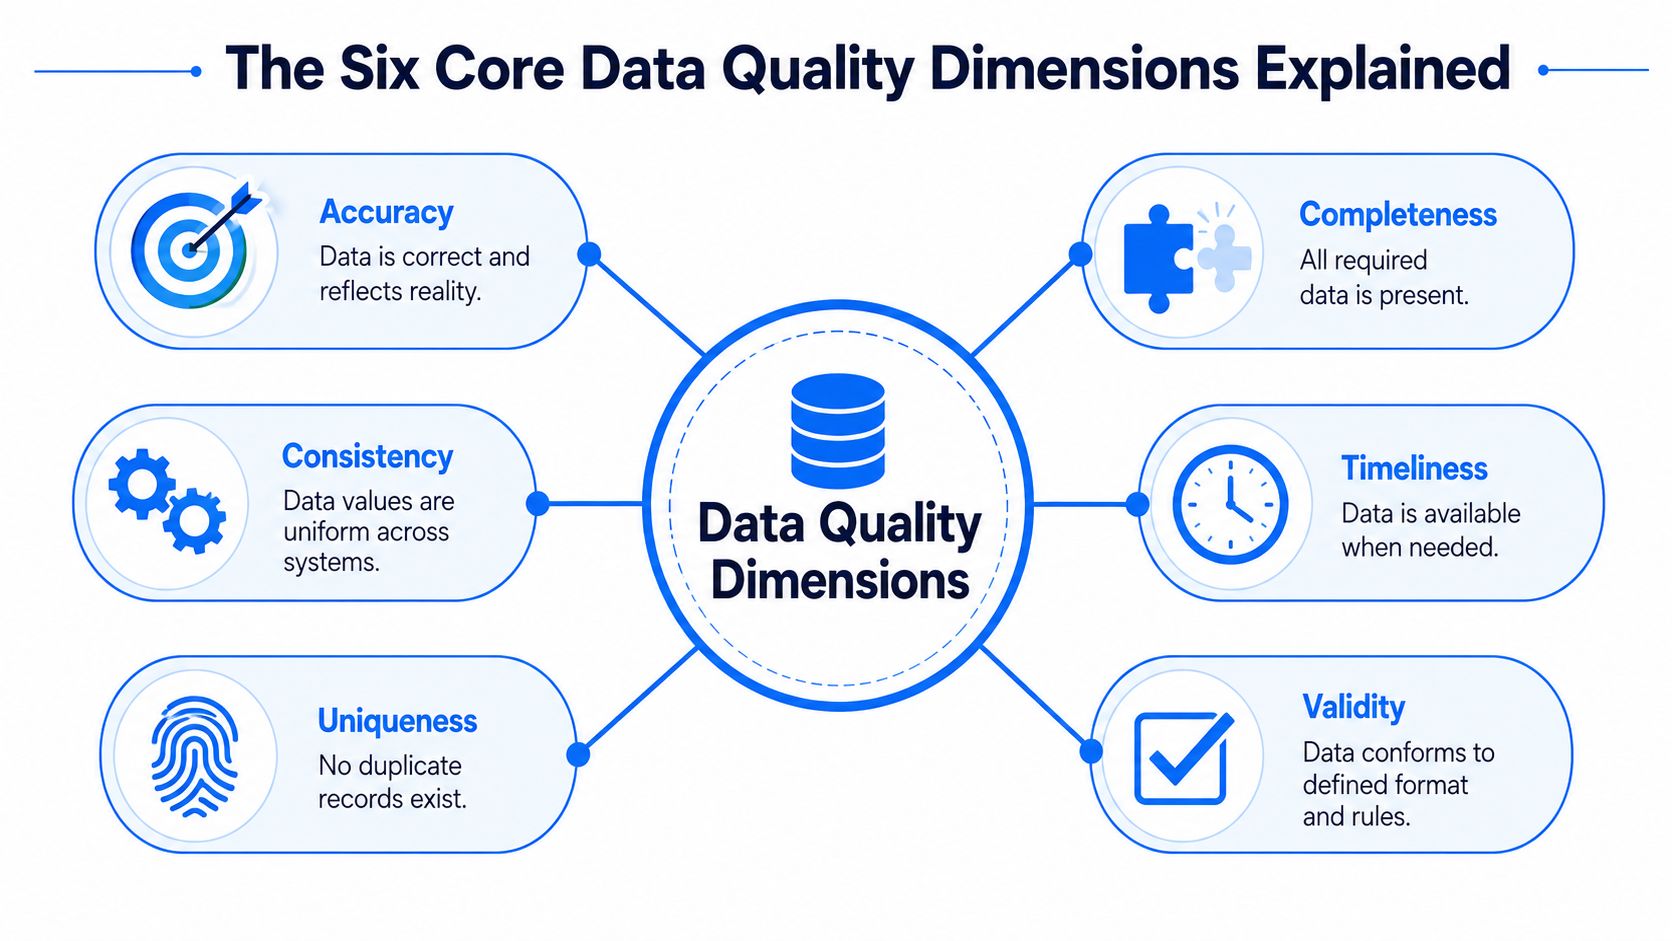
Se volete un riferimento complementare sui dettagli di implementazione, è utile questa guida sulle dimensioni della qualità dei dati e su come misurarle su larga scala. L'aspetto importante, però, è associare ogni dimensione a una domanda di business.
Accuratezza
L'accuratezza verifica se i dati riflettono la realtà che dichiarano di descrivere.
Un indirizzo cliente può essere completo, valido nel formato e comunque sbagliato. Il prezzo di un prodotto può essere presente in tutte le tabelle a valle e tuttavia non corrispondere alla fonte approvata. Gli errori di accuratezza sono costosi perché spesso hanno un aspetto strutturalmente sano.
Domanda di business: possiamo fidarci che questo valore rappresenti la realtà?
Completezza
La completezza misura se i dati obbligatori sono presenti.
È la dimensione con cui i team si scontrano per prima, perché i valori nulli sono facili da contare e da spiegare. Se un ordine non ha un indirizzo di spedizione, il magazzino non può spedirlo. Se a una cartella clinica manca un attributo obbligatorio, i workflow di cura e gli audit trail si interrompono rapidamente.
Domanda di business: abbiamo tutti i campi necessari per eseguire il processo?
Coerenza
La coerenza verifica se lo stesso fatto resta allineato tra sistemi e trasformazioni.
Molti problemi aziendali si nascondono in situazioni come questa. La piattaforma di fatturazione dice che un cliente è attivo. Il CRM dice che è inattivo. Il warehouse unisce entrambi ed espone il valore arrivato per ultimo. Nessuno di questi record è tecnicamente nullo o non valido, ma il business non può agire con sicurezza su stati contraddittori.
Domanda di business: la stessa entità significa la stessa cosa ovunque?
Gran parte della “confusione negli analytics” è in realtà un problema di coerenza travestito da questione semantica.
Tempestività
La tempestività riguarda il fatto che i dati arrivino quando servono per il loro utilizzo.
Una tabella dei ricavi giornalieri che arriva a mezzogiorno può andare bene per la pianificazione mensile ed essere inaccettabile per un briefing operativo delle 8:30. La tempestività dipende sempre dal contesto. I dati in ritardo diventano dati sbagliati quando mancano la finestra decisionale.
Domanda di business: i dati erano disponibili entro la finestra temporale richiesta dal processo?
Validità
La validità verifica se i valori sono conformi a regole, domini e formati.
Una colonna di date potrebbe contenere testo. Una colonna di stato potrebbe includere valori al di fuori dell'insieme approvato. Un record può rispettare la tipizzazione dello schema e violare comunque la logica di business, ad esempio con una data di fine precedente alla data di inizio.
Domanda di business: questo record rispetta le regole che abbiamo concordato?
Unicità
L'unicità verifica se i record compaiono una sola volta dove dovrebbero comparire una sola volta.
Clienti, fatture o transazioni duplicati causano rapidamente problemi visibili. I conteggi si gonfiano, i join moltiplicano le righe e i team finiscono per discutere se il problema sia nella sorgente o nel modello. I controlli di unicità dovrebbero esistere sia a livello di chiave tecnica sia a livello di entità di business, perché non tutti i duplicati condividono lo stesso identificativo.
Domanda di business: stiamo contando una cosa una volta sola o più volte?
Ecco la scorciatoia operativa che uso:
Dimensione | Principale modalità di guasto | Sintomo tipico per il business |
|---|---|---|
Accuratezza | Valore errato | Decisione sbagliata o azione scorretta |
Completezza | Valore mancante | Workflow interrotto o lacuna negli audit |
Coerenza | Valore contraddittorio | Contestazioni sui KPI tra team |
Tempestività | Valore in ritardo | Dashboard obsolete e azioni ritardate |
Validità | Valore che viola le regole | Processo fallito o record rifiutato |
Unicità | Valore duplicato | Conteggi gonfiati e join rumorosi |
Come calcolare le metriche fondamentali di qualità dei dati
Le definizioni servono solo se riuscite a trasformarle in controlli ripetibili. Il punto di partenza più affidabile è calcolare un piccolo insieme di metriche nel warehouse, salvare i risultati in una tabella di metriche e seguirne l'andamento nel tempo.
Partite da un contratto della metrica
Prima di scrivere SQL, definite quattro elementi per ogni metrica:
Perimetro del dataset. Quale tabella, partizione o dominio di business state misurando?
Logica. Che cosa conta esattamente come superato o fallito?
Owner. Chi gestisce il triage dell'alert quando la metrica si muove?
Impatto sul business. Che cosa si rompe se questa metrica esce dalla tolleranza?
Senza questo contratto, i team finiscono per discutere dopo l'alert, non prima.
Una semplice tabella di metriche ha spesso questo aspetto:
column_name | scopo |
|---|---|
metric_date | quando è stato eseguito il controllo |
dataset_name | tabella o modello misurato |
metric_name | completeness, duplicate_rate, freshness_lag |
metric_value | risultato numerico |
threshold_status | pass, warn, fail |
dimension | completezza, validità, tempestività, ecc. |
Formule SQL che i team usano davvero
La completezza è il punto di partenza più semplice. Nel materiale di Alation, la completezza è definita come la percentuale di valori non nulli nei campi obbligatori rispetto al numero totale di righe, e i dati di benchmark nella sanità e nella finanza mostrano che i dataset con completezza inferiore al 97% generano il 40% di rilievi di conformità normativa in più in quei settori, secondo l'articolo di Alation sulle metriche di qualità dei dati.
Una formula di base è:
Completezza = (valori obbligatori non nulli / righe totali) * 100
Esempio:
Con più colonne obbligatorie, non fate la media alla cieca. Calcolate ogni campo separatamente e calcolate anche un punteggio di completezza a livello di record se il workflow richiede che tutti i campi siano presenti.
L'unicità si misura di solito come quota di righe che non violano una chiave attesa.
Unicità = 1 - (righe duplicate / righe totali)
Se l'entità di business può duplicarsi con ID tecnici diversi, aggiungete in seguito un matching fuzzy o basato su regole. Iniziate prima dai duplicati esatti.
La validità richiede regole esplicite. Non affidatevi ai soli tipi dello schema.
Per i modelli sanitari o di ricerca, i team hanno spesso bisogno di librerie di regole specifiche per dominio. In quel contesto, OMOPHub per la validazione dei dati OMOP è un riferimento pertinente, perché si concentra su workflow di validazione strutturati anziché su consigli generici di qualità.
La tempestività spesso si esprime meglio come ritardo che come percentuale.
Se vi serve un pattern di progettazione delle regole di validità che vada oltre gli snippet SQL, questa introduzione a che cosa significa la validazione dei dati nei sistemi operativi è un buon complemento.
Le soglie appartengono ai casi d'uso, non alle tabelle
L'errore comune è fissare una soglia per dimensione e applicarla ovunque. Fallisce rapidamente.
Una tabella di identità dei clienti merita regole di completezza più severe di un archivio storico di clickstream. Un set di feature per un modello di rischio può tollerare dati di arricchimento arrivati in ritardo, ma non modifiche dello schema. Un'estrazione finanziaria può accettare una piccola variazione nel numero di righe, ma non un singolo codice di entità legale non valido.
Misurate la stessa dimensione in modo diverso quando il costo del guasto è diverso. Non è incoerenza. È progettazione responsabile.
Il warehouse dovrebbe calcolare la metrica. Il processo di business dovrebbe determinare la soglia.
Dalle metriche grezze a insight azionabili
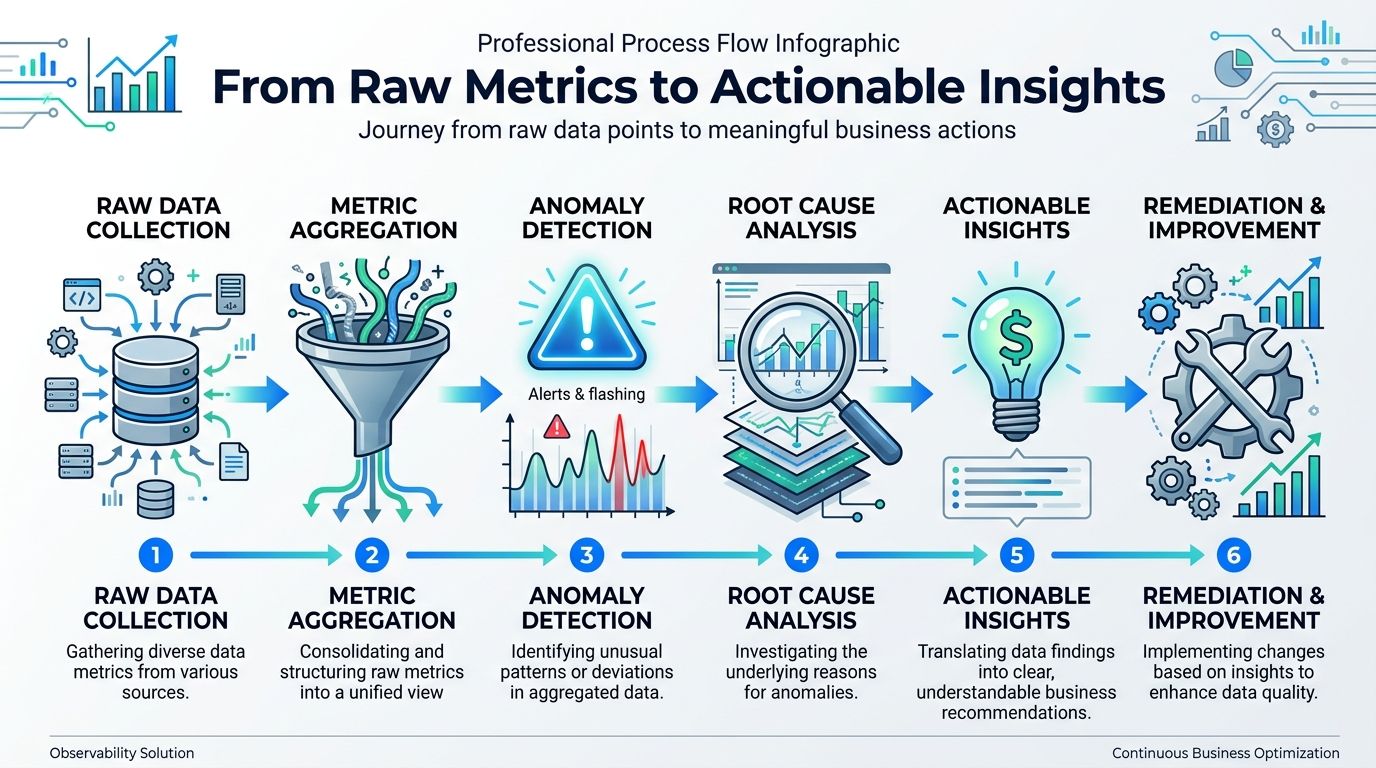
Una metrica da sola è solo un numero in una tabella. I team hanno bisogno di una logica di interpretazione intorno a essa: soglie, rilevamento delle anomalie, instradamento e abbastanza contesto per capire se il problema è estetico o operativo.
Soglie di cui le persone si fidano
Le soglie statiche funzionano bene quando la regola è chiara e assoluta. Campi obbligatori, enumerazioni ammesse e controlli di unicità delle chiavi di solito rientrano in questo modello.
Le soglie dinamiche aiutano quando la metrica è naturalmente variabile. Il numero di righe cambia con la stagionalità. I pattern di freschezza variano in base alla pianificazione. Gli spostamenti nella distribuzione possono essere normali in alcuni giorni e sospetti in altri.
Una suddivisione pratica è questa:
Usate soglie statiche per regole di business e campi sensibili ai fini della compliance.
Usate baseline apprese per volume, freschezza e anomalie comportamentali.
Usate controlli di trend quando il deterioramento conta più di una singola esecuzione andata male.
Alert che non insegnano ai team a ignorarli
Gli alert falliscono quando ogni deviazione fa scattare una chiamata a qualcuno.
I buoni alert sulla qualità dei dati includono il contesto fin dalla prima volta che scattano. L'owner dovrebbe vedere il dataset, la metrica che fallisce, il trend recente, la probabile modifica a monte e quali dashboard, modelli o processi operativi dipendono da quell'asset. Se l'alert dice soltanto “la completezza è calata”, chi risponde deve comunque fare a mano il triage di base.
Ho visto una regola semplice funzionare bene nei team maturi:
Tipo di alert | Quando usarlo | Risposta attesa |
|---|---|---|
Errore bloccante | Violazione di una regola con impatto immediato sul business | Aprire un incidente e, se necessario, bloccare l'uso a valle |
Avviso | Degrado senza ancora un chiaro rischio per le decisioni | Indagare in orario lavorativo |
Osservazione del trend | Deterioramento lento | Aggiungere al backlog e rivedere con l'owner |
Il modo più rapido per perdere fiducia in un sistema di monitoraggio è inviare alert tecnici privi di contesto operativo.
Campionamento e baseline in ambienti disordinati
Non tutte le tabelle meritano la stessa profondità di monitoraggio. Alcune sono critiche, altre intermedie, altre usa e getta.
Per una copertura ampia, partite da segnali poco costosi. Numero di righe, freschezza, pattern dei valori nulli, modifiche dello schema e controlli sui duplicati fanno emergere gran parte dei guasti reali. Aggiungete la validazione a livello di record dove la logica di business è rigorosa. Campionate quando il costo conta, ma fatelo in modo intenzionale. Ad esempio, validate i caricamenti completi sui dataset gold e profilate sezioni rappresentative sui modelli di livello inferiore.
Le baseline basate sull'IA aiutano soprattutto quando l'ambiente è troppo rumoroso per limiti regolati a mano. È particolarmente utile nelle organizzazioni con molte sorgenti e pattern di aggiornamento irregolari. Lo scopo non è eliminare il giudizio umano, ma riservare l'attenzione delle persone alle deviazioni che appaiono sostanzialmente diverse dal comportamento normale del sistema.
Rendere operativa la qualità dei dati: un esempio di dashboard di KPI
Una buona dashboard non è una galleria di grafici. È una superficie di lavoro per la risposta agli incidenti, l'analisi dei trend e l'ownership.
Aprite la pagina con un riepilogo dello stato di salute che risponda subito a tre domande: che cosa sta fallendo ora, che cosa sta peggiorando e che cosa ha bisogno di un owner oggi.
Cosa mostra la dashboard a colpo d'occhio
La prima riga presenta di solito la vista operativa:
Incidenti aperti per gravità, così gli ingegneri di turno sanno da dove partire
Stato di freschezza per dataset critico, per far emergere caricamenti in ritardo o mancanti
Feed delle modifiche dello schema per colonne aggiunte, rimosse o con tipo modificato
Metriche in maggiore peggioramento in una recente finestra di analisi
Poi aggiungete la vista per gli analisti. Le linee di trend di completezza, tasso di duplicati, errori di validità e ritardo di freschezza aiutano i team a distinguere il rumore occasionale da un declino persistente. Anche le classifiche sono utili. Una vista delle “tabelle più instabili” spesso favorisce una prioritizzazione migliore di un lungo registro dei problemi.
Una metrica merita un trattamento speciale: il data downtime. Secondo l'analisi di Monte Carlo sulle metriche di qualità dei dati, le organizzazioni che monitorano il data downtime rilevano che il 68% degli incidenti deriva da una deriva silenziosa dello schema o da violazioni della freschezza, e che tali incidenti possono causare una riduzione del 15-25% dell'accuratezza dei modelli a valle entro 48 ore. Ecco perché la dashboard dovrebbe mostrare non solo se un controllo è fallito, ma anche da quanto tempo il dataset interessato non è affidabile.
Cosa ne fa ciascun team
I data engineer hanno bisogno di una sezione tecnica. A loro interessano controlli falliti, durata degli incidenti, lineage e probabili cause a monte.
Gli analytics engineer e gli sviluppatori BI hanno bisogno di una sezione semantica. Vogliono sapere se un modello affidabile soddisfa ancora le aspettative delle regole di business e se le dashboard vadano annotate, sospese o ricostruite.
I responsabili della governance e del business hanno bisogno di una sezione sul rischio. Vogliono sapere quali domini falliscono ripetutamente, quali controlli sono deboli e se i problemi vengono risolti nei tempi concordati.
Una breve presentazione del prodotto aiuta a rendere concreto questo modello operativo:
Le migliori dashboard di KPI non si fermano al rosso e al verde. Mostrano trend, raggio d'impatto e owner. È questo che trasforma il monitoraggio in un sistema che le persone usano davvero sotto pressione, non solo durante le demo.
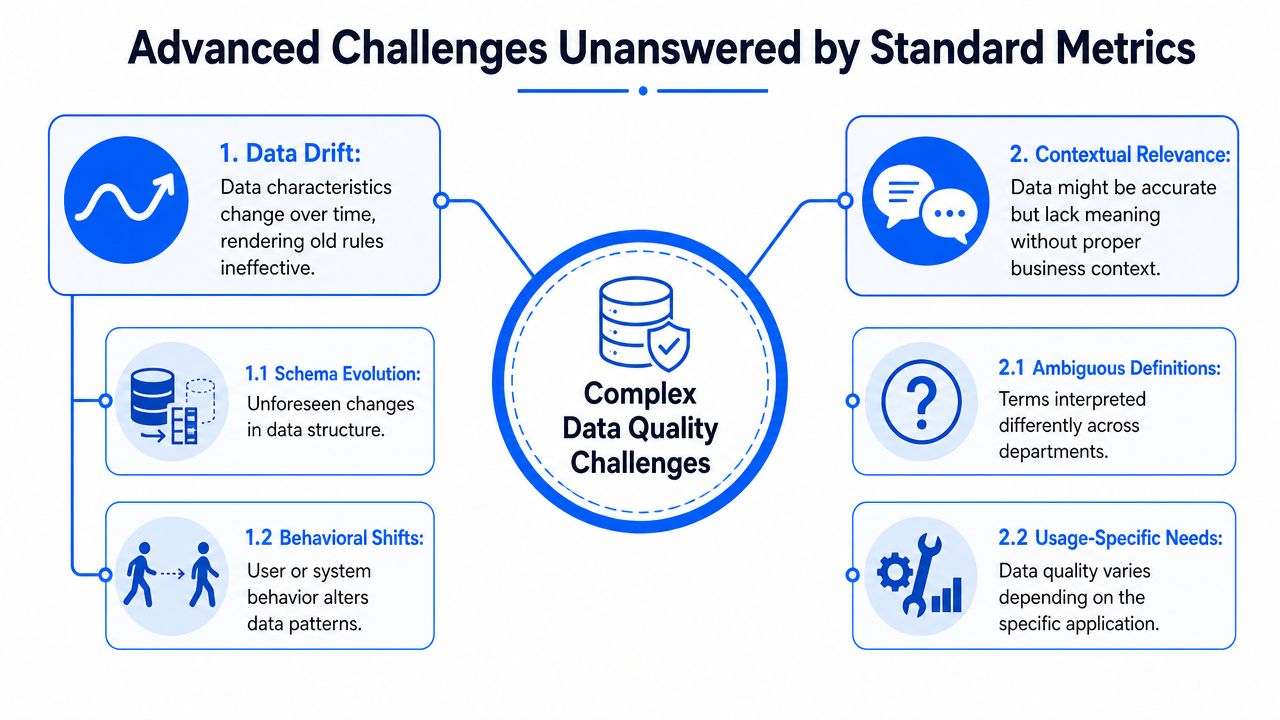
Sfide avanzate a cui le metriche standard non rispondono
La maggior parte delle guide si ferma alle sei dimensioni. In produzione è proprio lì che iniziano le domande più difficili.
Micro-errori nascosti dentro medie positive
Le metriche aggregate possono sembrare sane mentre un piccolo difetto causa danni sproporzionati.
Poche righe errate in una tabella clienti possono instradare in modo sbagliato ordini di alto valore. Un piccolo insieme di record malformati può compromettere una feature a valle usata da un modello. Completezza, validità e unicità complessive possono comunque apparire accettabili, perché il punteggio aggregato diluisce l'impatto.
Il problema emerge anche nelle discussioni tra professionisti. Un thread di data engineering sugli errori a micro-impatto descrive quanto sia difficile quantificare l'impatto di difetti che riguardano solo poche righe ma che provocano comunque gravi guasti a valle.
La soluzione non è un'altra media. Sono la segmentazione e controlli che tengono conto dell'impatto.
Usate pattern come questi:
Monitoraggio dei campi critici per le colonne il cui errore blocca un workflow, anche se sono coinvolte solo poche righe
Metriche per segmento per regione, canale, linea di prodotto o fascia di clientela, così che un guasto locale non scompaia dentro un tasso di superamento globale
Validazione sensibile al percorso che verifica i record con maggiore probabilità di finire in percorsi regolamentati, finanziari o critici per i modelli
Metriche sui sintomi di business come transazioni rifiutate, record non collegabili tramite join o record bloccati nell'evasione degli ordini
Una metrica dovrebbe riflettere il costo dell'errore, non solo il numero di righe errate.
Perché un punteggio unico è più difficile di quanto sembri
I leader chiedono spesso un unico numero. È una richiesta ragionevole: vogliono trend, confronto e prioritizzazione senza dover leggere dieci grafici.
Il problema è la ponderazione.
Una tabella di marketing in ritardo e una riga di pagamento duplicata non dovrebbero contribuire allo stesso modo a un punteggio unico. Un problema di completezza in un archivio di riferimento non comporta lo stesso rischio di un problema di validità in un dominio di identità dei clienti. Anche i pesi statici invecchiano male. I processi di business cambiano, gli input dei modelli evolvono e ciò che prima era un avviso può diventare un blocco.
Per questo un Data Quality Score utile deve essere contestuale. Ha bisogno di pesi specifici per dominio, moltiplicatori dell'impatto sul business e ricalibrazioni periodiche. Dovrebbe inoltre separare lo stato di salute descrittivo dal rischio predittivo. Altrimenti si ottiene un numero curato che piace al management ma dice ben poco a chi opera.
Un modello pratico consiste nell'assegnare punteggi su tre livelli:
Livello | A cosa risponde |
|---|---|
Punteggio per metrica | Questo specifico controllo è stato superato, è peggiorato o è fallito |
Punteggio per dataset | Questo asset è sicuro per l'uso previsto |
Punteggio di rischio per dominio | Quale area di business presenta la maggiore esposizione operativa |
Non risolverà comunque ogni caso. Ma evita l'errore peggiore, cioè fingere che un unico punteggio universale possa rappresentare ugualmente bene ogni caso d'uso.
Come le piattaforme di data observability automatizzano le metriche di qualità
I controlli SQL manuali sono un ottimo punto di partenza. Non bastano più quando si ha a che fare con molte sorgenti, schemi in evoluzione e team che hanno bisogno di un monitoraggio continuo invece di una revisione settimanale.
È qui che le piattaforme di data observability si guadagnano il loro posto. Automatizzano la raccolta delle metriche, stabiliscono una baseline del comportamento normale, rilevano anomalie, monitorano la freschezza e instradano i problemi con abbastanza contesto per un triage rapido. Riducono inoltre l'onere di manutenzione dovuto a set di regole costruiti a mano e sparsi tra job Airflow, test dbt, procedure del warehouse e patch nel livello di BI.
Le piattaforme più solide combinano più modalità di controllo:
Validazione basata su regole per la logica di business essenziale
Rilevamento delle anomalie per derive che nessuno ha modellato esplicitamente
Monitoraggio della tempestività per arrivi in ritardo o mancanti
Tracciamento dello schema per modifiche strutturali che compromettono inaspettatamente le ipotesi a valle
Analytics storiche per individuare un deterioramento lento
Se state valutando questa categoria, un utile punto di partenza è questo approfondimento sul perché la data observability è cruciale per la gestione moderna dei dati. Un esempio nel settore è digna, che combina calcolo delle metriche nel database, rilevamento delle anomalie, monitoraggio della tempestività, validazione a livello di record e tracciamento dello schema in ambienti controllati dal cliente.
L'obiettivo pratico non è avere più dashboard. È avere meno sorprese, un'analisi delle cause più rapida e un'ownership più chiara quando i dati smettono di essere affidabili.
Se il vostro team sta cercando di passare da controlli ad hoc a una pratica di qualità dei dati monitorata e operativa, vale la pena valutare digna. È pensata per i team che hanno bisogno di rilevamento delle anomalie, validazione, monitoraggio della tempestività e tracciamento dello schema senza spostare i dati di produzione al di fuori del proprio ambiente.
Se il ritardo di freschezza è la prima metrica che volete automatizzare, digna Timeliness apprende i pattern di arrivo attesi e segnala i caricamenti in ritardo o mancanti.
Domande frequenti
Quali sono le sei dimensioni della qualità dei dati?
Le sei dimensioni più utilizzate sono accuratezza, completezza, coerenza, tempestività, validità e unicità, in linea con l'impostazione della norma ISO/IEC 25012:2008. L'articolo associa ciascuna a una domanda di business; la completezza, ad esempio, chiede se siano presenti tutti i campi necessari per eseguire il processo.
Come si calcola la completezza dei dati?
La completezza è la percentuale di valori non nulli nei campi obbligatori rispetto al numero totale di righe: (valori obbligatori non nulli / righe totali) * 100. I dati di benchmark di Alation citati nell'articolo mostrano che nella sanità e nella finanza i dataset con completezza inferiore al 97% generano il 40% di rilievi di conformità normativa in più.
Come si misura la tempestività dei dati in SQL?
Spesso la tempestività si esprime meglio come ritardo che come percentuale. La query dell'articolo prende max(load_timestamp) dalla tabella e lo sottrae da current_timestamp per ottenere freshness_lag. Se quel ritardo sia accettabile dipende dalla finestra decisionale, ad esempio un briefing operativo delle 8:30.
Le soglie di qualità dei dati devono essere statiche o dinamiche?
Usatele entrambe, a seconda della metrica. Le soglie statiche si adattano a regole chiare come campi obbligatori, enumerazioni ammesse e unicità delle chiavi. Le baseline apprese sono adatte a metriche naturalmente variabili come numero di righe, freschezza e anomalie comportamentali, mentre i controlli di trend contano quando un deterioramento lento è più rischioso di una singola esecuzione andata male.
Perché è difficile costruire un unico punteggio di qualità dei dati?
La difficoltà sta nella ponderazione: una tabella di marketing in ritardo e una riga di pagamento duplicata non dovrebbero pesare allo stesso modo. L'articolo raccomanda invece di assegnare punteggi su tre livelli, un punteggio per metrica, uno per dataset e uno di rischio per dominio, con pesi specifici per dominio e una ricalibrazione periodica.


