Che cos'è la qualità dei dati: guida essenziale per il 2026
|
6
min di lettura

La vostra dashboard dice che il fatturato è in linea con il piano. Le vendite dicono che la pipeline sembra debole. Il marketing ha appena lanciato una grande campagna basata su un segmento "ad alta intenzione" e poi scopre che metà del pubblico se n'era già andata, che alcuni record erano duplicati e che campi firmografici chiave non erano aggiornati. Nessuno contesta che l'SQL sia stato eseguito correttamente. Il problema è che i dati non erano adatti alla decisione.
Di solito è in quel momento che ci si inizia a chiedere che cosa sia la qualità dei dati. Non in astratto, ma nel senso molto pratico di capire perché un report sembrava a posto, perché il modello è stato addestrato con successo e perché il business ha comunque ottenuto la risposta sbagliata.
Nei team reali, la qualità dei dati non è un tema secondario riservato al gruppo di piattaforma. Sta alla base di previsioni finanziarie, operazioni con i clienti, output dell'AI, dashboard direzionali e verifiche di compliance. Se i dati sottostanti sono errati, incompleti, in ritardo, strutturalmente incoerenti o scollegati dal contesto di business, ogni strumento a valle diventa meno affidabile. Anche un modello operativo solido nel marketing dipende dalle basi, ed è per questo che conta una buona guida per le marketing operations B2B. Una buona esecuzione parte da fondamenta di dati affidabili.
Indice
La qualità dei dati è più di semplici dati "puliti"
Molti team riducono ancora la qualità dei dati a "dati puliti". L'espressione sembra corretta finché non si pone una domanda più difficile: puliti per fare che cosa?
Un indirizzo cliente può essere scritto correttamente ed essere comunque inutile per la logistica se mancano i numeri interni. Una tabella finanziaria può essere coerente al suo interno ed essere comunque inadatta al reporting direzionale se l'aggiornamento arriva dopo che il materiale per il consiglio di amministrazione è già stato chiuso. Una tabella di feature può sembrare completa e rompere comunque un workflow di ML se la struttura è cambiata in un modo che i consumatori a valle non si aspettavano.
Per questo la definizione migliore è idoneità allo scopo (fitness for purpose). La qualità dei dati è il grado in cui i dati sono accurati, completi, validi, coerenti, tempestivi, unici e utilizzabili per la decisione o il processo che supportano. Lo stesso dataset può essere di alta qualità per un compito e di scarsa qualità per un altro.
I buoni dati non sono quelli con il minor numero di errori visibili. Sono quelli che supportano in modo affidabile l'azione che qualcuno deve compiere.
Questa distinzione è importante perché cambia il modo di lavorare dei team. Se trattate la qualità come un progetto di pulizia, vi concentrate su difetti isolati. Se la trattate come idoneità allo scopo, vi concentrate sull'impatto a valle. Vi chiedete se una pipeline supporta la pianificazione, se una dashboard supporta le decisioni e se l'input di un modello resta strutturalmente affidabile nel tempo.
La realtà operativa è più confusa di quanto ammettano la maggior parte delle definizioni. I dati cambiano mentre sono in movimento. Le sorgenti evolvono. I significati di business derivano. Nuovi team consumano vecchie tabelle in modi che l'owner originale non aveva mai previsto. Quindi la domanda giusta non è se i dati siano puliti in un senso universale. La domanda giusta è se ci si possa fidare dei dati per questo caso d'uso, per questo team, in questo momento.
Le sette dimensioni fondamentali della qualità dei dati
I team di solito hanno bisogno di un linguaggio comune prima di poter risolvere qualsiasi cosa. Senza di esso, un gruppo dice "i dati sono sbagliati", un altro dice "la pipeline è passata" e nessuno sta parlando della stessa modalità di guasto.
Le sette dimensioni che seguono sono il vocabolario pratico che rende la qualità un tema discutibile.
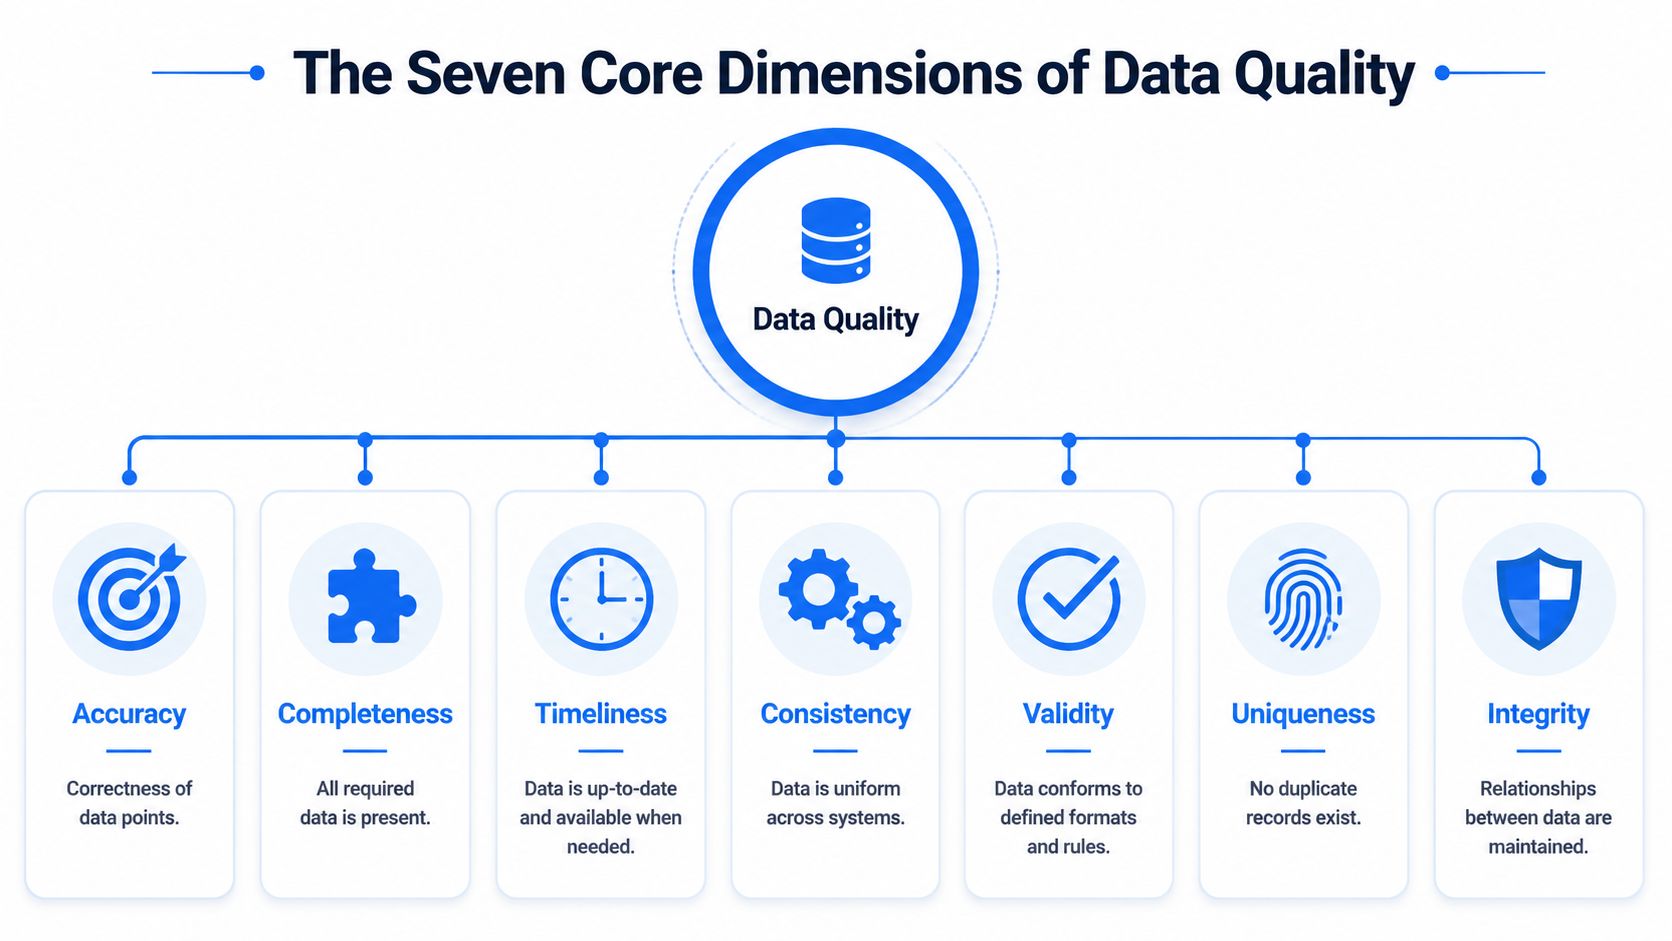
Accuratezza significa che i valori corrispondono alla realtà
L'accuratezza è la dimensione più intuitiva. I dati devono riflettere la cosa reale che dichiarano di descrivere.
Pensate a una mappa. Una mappa è utile solo se le strade si trovano dove la mappa dice che sono. Nei sistemi aziendali, questo significa che l'indirizzo del cliente è aggiornato, il valore del contratto è corretto e il timestamp dell'evento riflette il momento in cui l'evento si è verificato.
Quando l'accuratezza viene meno, il danno è immediato. Gli ordini finiscono alla destinazione sbagliata. Il fatturato viene attribuito all'account sbagliato. La logica di segmentazione colpisce le persone sbagliate.
Completezza e tempestività determinano l'utilità
La completezza significa avere i pezzi che servono. È l'analogia del puzzle: bastano pochi pezzi mancanti per rendere illeggibile l'intera immagine.
Un record di vendita senza regione, owner o data di chiusura può esistere, ma non supporterà le previsioni. Un dataset di sinistri senza i campi di stato chiave non supporterà il triage operativo. Nell'analytics, i dati mancanti si nascondono spesso all'interno di caricamenti "riusciti", ed è per questo che i team non se ne accorgono finché una metrica non inizia a sembrare strana.
La tempestività è la freschezza. I prodotti freschi restano prodotti anche dopo una settimana in magazzino, ma non sono più utili per il servizio della cena. Con i dati funziona allo stesso modo.
Un KPI direzionale giornaliero può tollerare un certo ritardo. Il monitoraggio delle frodi no. Le decisioni sul personale dell'assistenza clienti nemmeno. La tempestività non è un unico standard: dipende dal processo. Ciò che conta è che l'arrivo previsto e la disponibilità effettiva corrispondano alle esigenze di chi consuma i dati.
Regola pratica: ogni dataset critico dovrebbe avere un'aspettativa di freschezza esplicita, legata a una decisione di business e non a una schedulazione arbitraria.
Coerenza, validità, unicità e lineage mantengono allineati i sistemi
La coerenza significa che lo stesso concetto si comporta allo stesso modo in tutti i sistemi. Se la finanza definisce un "cliente attivo" in un modo e la product analytics in un altro, il problema non è estetico. Crea attriti operativi e discussioni su quale numero sia quello vero.
La validità significa che i dati sono conformi alle regole che avete stabilito. Le date devono essere date reali. I codici paese devono seguire il formato previsto. I valori di stato devono appartenere a un insieme approvato. La validità è di solito il punto da cui partono i team perché è facile da codificare, ma superare i controlli di formato non garantisce l'utilità per il business.
L'unicità significa che i record che dovrebbero essere unici restano tali. Le righe cliente duplicate gonfiano i conteggi, frammentano lo storico e provocano imbarazzanti errori operativi. È uno dei modi più rapidi per perdere la fiducia nei sistemi CRM, di fatturazione e di marketing.
La lineage vi dice da dove provengono i dati, che cosa li ha modificati e chi ne dipende. A rigore, la lineage è diversa dalle sei dimensioni fondamentali comunemente misurate nelle scorecard, ma nella pratica è essenziale perché non si può correggere ciò che non si può tracciare. Quando una metrica cambia inaspettatamente, la lineage è il modo in cui un team capisce se il problema è nato nell'ingestione, nella trasformazione, nell'arricchimento o nella modellazione semantica a valle.
Ecco un modo sintetico di pensare alle sette dimensioni:
Dimensione | Test semplice | Guasto tipico |
|---|---|---|
Accuratezza | Il valore è vero? | Stato cliente errato |
Completezza | Manca qualcosa di obbligatorio? | Null nei campi chiave |
Tempestività | È arrivato quando serviva? | Dashboard non aggiornata |
Coerenza | La definizione corrisponde a quella usata altrove? | KPI in conflitto |
Validità | Rispetta le regole? | Codici o formati non validi |
Unicità | Il record è duplicato? | Entità contate due volte |
Lineage | Possiamo tracciare la sorgente e le modifiche? | Analisi delle cause profonde lenta |
Per i team che operano su larga scala, la qualità diventa una disciplina misurabile anziché un'aspirazione vaga. La panoramica di AtScale sulla qualità dei dati osserva che le organizzazioni che raggiungono oltre il 98% su sei dimensioni fondamentali (accuratezza, completezza, coerenza, validità, unicità, tempestività) riducono gli incidenti nelle pipeline del 65% e tagliano i costi di remediation di 2,5 milioni di dollari all'anno nei data warehouse su larga scala.
Il reale impatto sul business dei dati di scarsa qualità
La parte costosa della scarsa qualità dei dati non è la riga errata. È la decisione presa sulla sua base, il tempo speso a discuterne e lo scompiglio operativo che ne consegue.
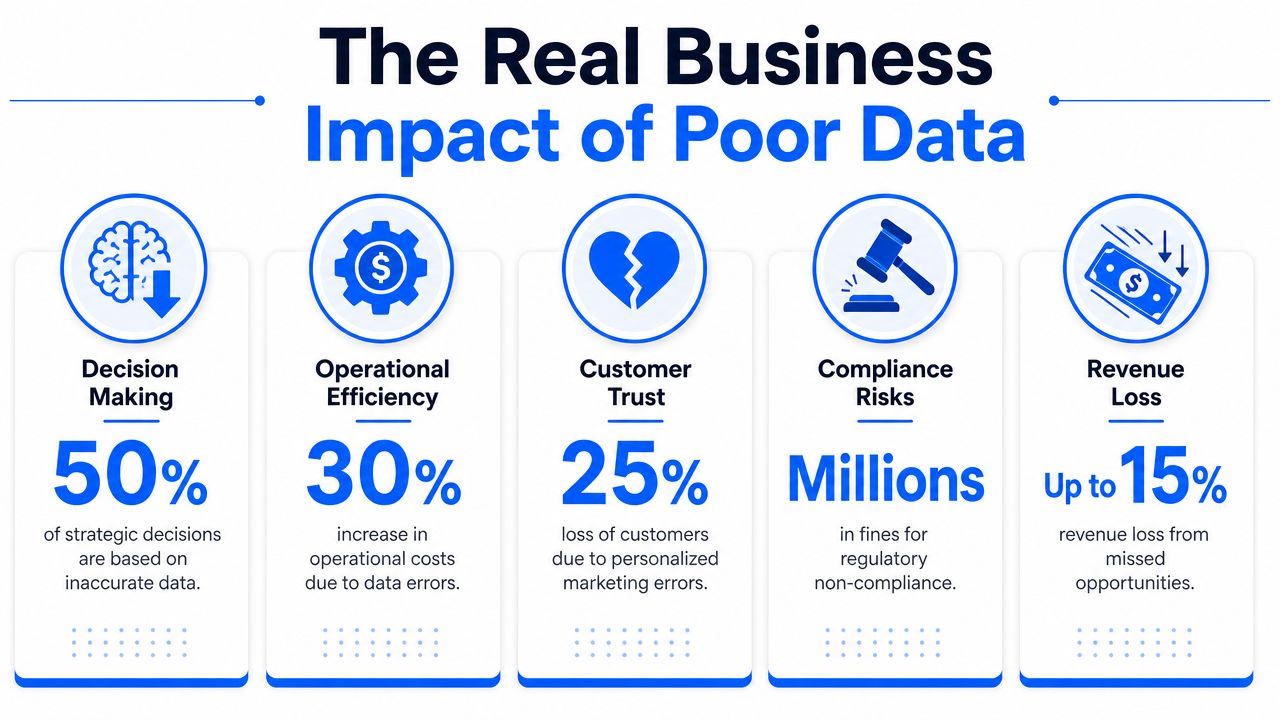
I dati scadenti compromettono le decisioni prima dei sistemi
La maggior parte dei sistemi non si guasta in modo evidente quando la qualità peggiora. La pipeline continua a girare. La dashboard continua a essere visualizzata. Il modello continua a produrre output. È questo che rende pericolosa la qualità dei dati: spesso fallisce senza che nessuno se ne accorga, dentro la logica di business anziché nell'infrastruttura.
L'esposizione finanziaria non è teorica. L'analisi di Dataversity sul costo dei dati scadenti afferma che la scarsa qualità dei dati costa alle organizzazioni in media 12,9 milioni di dollari all'anno. La stessa fonte osserva inoltre che il 77% dei responsabili IT dichiara di non fidarsi dei propri dati.
Questo problema di fiducia è di solito il primo sintomo che i dirigenti riconoscono. I team iniziano a tenere fogli di calcolo paralleli. Gli analisti ricostruiscono le metriche in modo indipendente. Le riunioni della leadership passano dal prendere decisioni al riconciliare numeri. Quando la fiducia cala, l'azienda non diventa meno data-driven in teoria. Lo diventa nella pratica.
L'erosione della fiducia è un problema operativo
La scarsa qualità blocca anche le iniziative più recenti, in particolare l'AI. L'annuncio della ricerca 2024 di Precisely riporta che il 64% degli intervistati a livello globale ha indicato la qualità dei dati come la principale sfida di integrità dei dati nel 2024, rispetto al 50% del 2023. Il dato è in linea con ciò che i team di ingegneria osservano sul campo. I sistemi di AI non "correggono" fondamenta di dati deboli. Le amplificano.
Una dashboard non aggiornata cambia una riunione. Input errati di un modello cambiano il comportamento dei prodotti, le previsioni, le valutazioni del rischio e le interazioni con i clienti. Per questo il lavoro sulla qualità non dovrebbe essere presentato come una pulizia di back-office. Protegge le revenue operations, l'accuratezza della pianificazione, l'esperienza del cliente e l'affidabilità dei modelli.
Alcuni pattern si ripresentano di continuo:
Perdite di fatturato: vendite e marketing si rivolgono agli account sbagliati, escludono il pubblico sbagliato o classificano male le opportunità.
Spreco operativo: ingegneri e analisti spendono cicli a validare output che avrebbero dovuto essere affidabili per definizione.
Esposizione in termini di compliance: record incoerenti e validazioni deboli rendono più difficile difendere gli audit trail.
Attrito con i clienti: record duplicati o non aggiornati portano a contatti ripetuti, aspettative di servizio disattese e personalizzazione compromessa.
Freno per il management: i dirigenti rimandano le azioni perché non si fidano dei numeri che hanno davanti.
Se un'azienda non sa dire se un KPI si è mosso perché è cambiata la realtà o perché è cambiata la pipeline, non ha un problema di reporting. Ha un problema di controllo.
Questo è il business case in termini semplici. La qualità dei dati determina se i sistemi producono fiducia o confusione.
Cause comuni del degrado della qualità dei dati
La qualità dei dati raramente crolla a causa di un unico incidente clamoroso. Si degrada con il lavoro di tutti i giorni. Viene aggiunto un nuovo campo. Un'integrazione cambia comportamento. Un modulo accetta input spazzatura. Un team adotta una metrica senza allineare la definizione con gli owner a monte.

Inserimento manuale e controlli deboli
L'inserimento manuale continua a rompere molti stack per il resto moderni. I commerciali digitano valori liberi in campi che avrebbero dovuto essere standardizzati. I team di assistenza saltano gli attributi obbligatori quando sono sotto pressione. I team operativi importano fogli di calcolo con nomi e formati di data incoerenti.
Non tutti i problemi nascono da malafede o negligenza. A volte è il workflow stesso a favorire input errati. Se il modulo è progettato male o le regole di business non sono chiare, le persone improvvisano. Il risultato è di solito un misto di problemi di validità, completezza e coerenza.
C'è uno stretto parallelo anche nei sistemi rivolti ai clienti. Una validazione front-end debole lascia entrare nei database operativi spam, invii malformati e record spazzatura, ed è per questo che risorse pratiche come questa guida per sviluppatori frontend su come bloccare lo spam contano anche al di là della sicurezza. I dati in ingresso di bassa qualità si trasformano in lavoro di pulizia a valle.
Pipeline, integrazioni e cambiamenti strutturali silenziosi
Il degrado causato dai sistemi è più difficile da gestire perché spesso sembra tutto a posto finché un consumatore non ne nota l'impatto. I job ETL possono caricare con successo dati parziali. Le API possono cambiare la forma delle risposte. Le trasformazioni possono continuare a girare mentre campi semanticamente importanti cambiano sotto di esse.
La categoria più pericolosa è il drift strutturale. La discussione di Sifflet su qualità dei dati e modifiche dello schema evidenzia una relazione critica: le modifiche dello schema non monitorate, come l'aggiunta di una nuova colonna, causano il 30% dei guasti dei modelli di AI in produzione introducendo feature drift.
Questa modalità di guasto è importante perché spesso aggira i controlli tradizionali. Una pipeline può continuare a produrre righe. Gli unit test possono continuare a passare. Ma il significato o la disposizione dei dati sono cambiati in un modo che la logica a valle non era stata progettata per gestire.
Le lacune di ownership trasformano problemi isolati in problemi sistemici
Alcuni guasti di qualità non sono affatto tecnici. Sono fallimenti della governance con sintomi tecnici.
Esempi comuni includono:
Nessun owner chiaro: nessuno è responsabile di definire la qualità accettabile o di approvare le modifiche dello schema.
Standard a silos: reparti diversi creano definizioni diverse per lo stesso concetto di business.
Gestione del cambiamento debole: i produttori modificano le tabelle senza avvisare i consumatori a valle.
Attrito con i sistemi legacy: i sistemi più vecchi esportano formati che le pipeline più recenti interpretano in modo incoerente.
Quando la ownership è sfumata, la remediation diventa lenta e politica. I team discutono di colpe invece di ripristinare la fiducia. Negli ambienti maturi, gli incidenti di qualità vengono gestiti come gli incidenti di prodotto o di affidabilità: c'è un owner, un percorso di escalation e un modello di risoluzione documentato.
Dalla misurazione alla padronanza: le best practice moderne
Il vecchio modello della qualità dei dati era semplice. Scrivere molte regole. Eseguirle secondo una schedulazione. Inviare alert quando si supera una soglia. Questo approccio ha ancora un suo spazio, soprattutto per la logica di business esplicita, ma smette rapidamente di scalare.
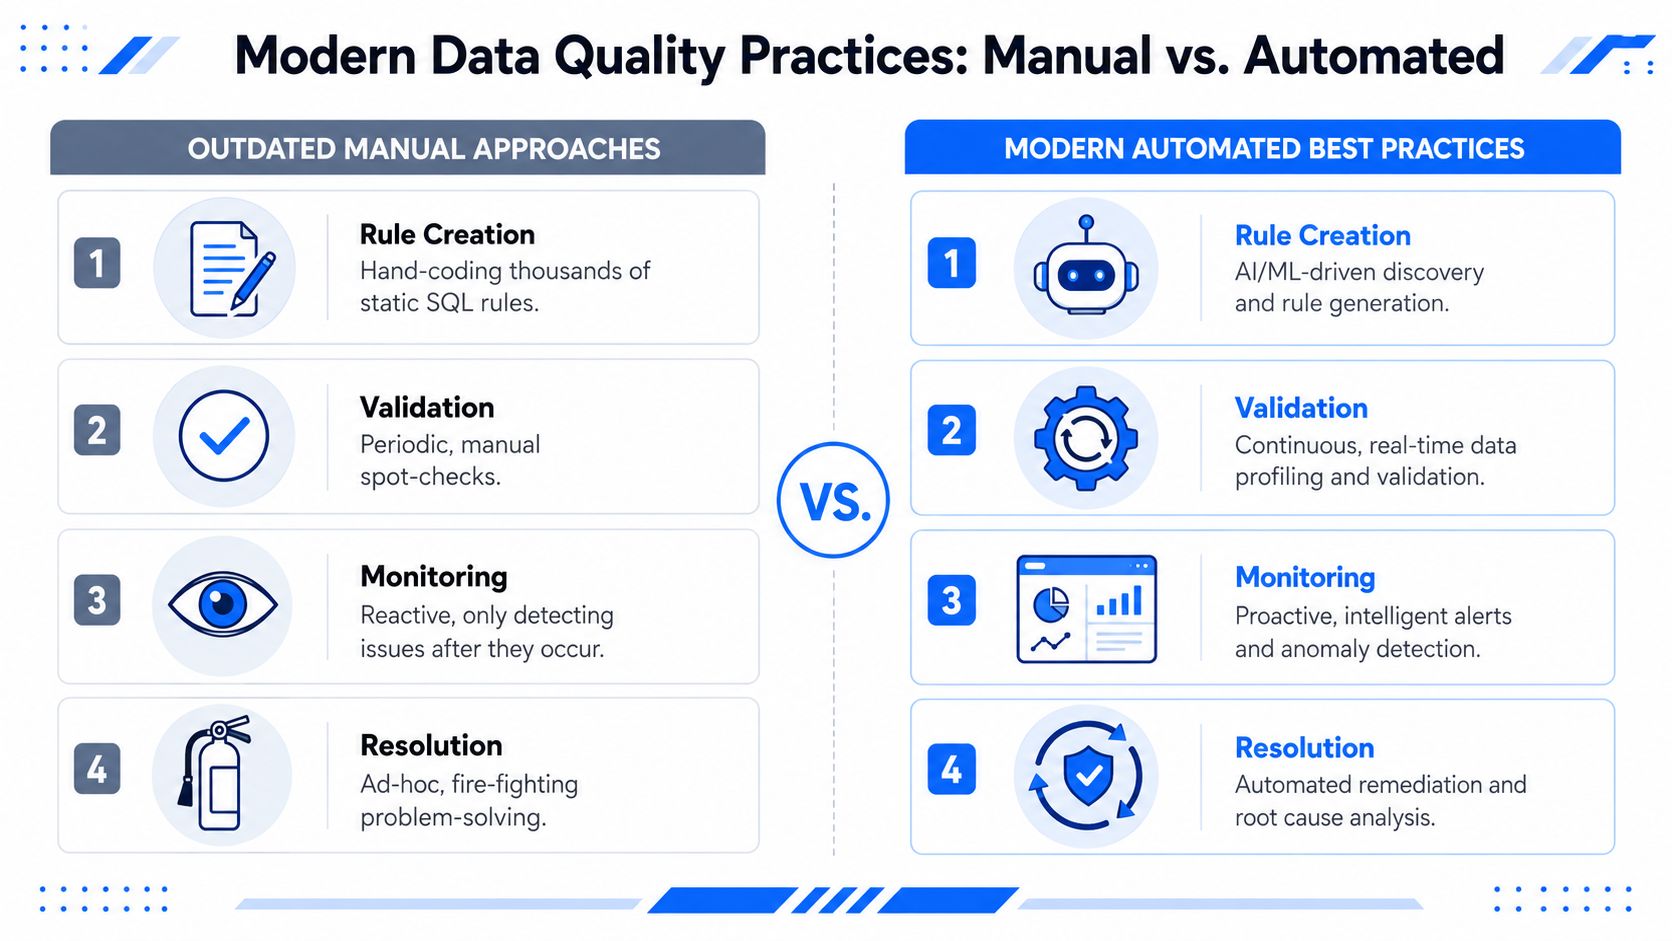
Perché le regole statiche smettono di scalare
Le regole statiche sono efficaci per aspettative note e stabili. Sono molto più deboli di fronte a comportamenti in evoluzione, drift tra tabelle e anomalie temporanee che contano a livello operativo ma non rientrano in un'asserzione scritta a mano.
È qui che molti team bruciano tempo. L'analisi di Amplitude sulla scarsa qualità dei dati riporta che l'82% dei problemi sui dati viene rilevato solo dopo aver colpito le dashboard a valle, eppure il 60% di questi problemi si corregge da solo nel giro di pochi minuti. La stessa fonte aggiunge che i team che si affidano a soglie statiche sprecano 15-20 ore a settimana nel triage di questi alert che si risolvono da soli.
È il costo nascosto dei problemi di qualità transitori. Non tutte le anomalie sono veri incidenti. Alcune sono brevi ritardi, comportamenti di retry, partizioni che arrivano in ritardo o blocchi temporanei delle sorgenti che si risolvono senza intervento. Ma se il vostro sistema di monitoraggio non sa distinguere il rumore transitorio da un degrado significativo, gli ingegneri devono comunque esaminarli. Con il tempo questo genera alert fatigue, risposte più lente ai guasti reali e minore fiducia nel livello di monitoraggio stesso.
Che cosa aggiunge l'osservabilità moderna
La pratica moderna combina validazione e osservabilità. La validazione verifica se i dati sono conformi alle aspettative dichiarate. L'osservabilità monitora come i dati si comportano nel tempo, inclusi freschezza, volume, schema, distribuzioni e variazioni insolite che non erano state codificate manualmente in anticipo.
Questo cambia il modello operativo in diversi modi:
Profilazione automatizzata: i sistemi apprendono che aspetto ha la normalità per colonne, tabelle e pattern di caricamento.
Rilevamento dinamico delle anomalie: gli alert sono guidati dai cambiamenti di comportamento, non solo da soglie fisse nel codice.
Monitoraggio della freschezza: i team sanno quando i dati sono in ritardo rispetto alle schedulazioni apprese e alle aspettative dei consumatori.
Tracciamento dello schema: i cambiamenti strutturali emergono prima che rompano report o modelli.
Supporto all'analisi delle cause: lineage e segnali storici aiutano i team a capire se il problema è nato a monte o a valle.
Le piattaforme basate su AI sono utili in questo contesto perché riducono la manutenzione manuale delle regole e si adattano ai pattern che cambiano. La descrizione della piattaforma di Ataccama descrive qualitativamente questo cambiamento attraverso profilazione automatizzata, generazione di regole e rilevamento delle anomalie. I team che vogliono un framework pratico per decidere che cosa monitorare possono partire da un insieme chiaro di metriche di qualità dei dati.
L'obiettivo non sono dati perfetti. L'obiettivo è un sistema che mantenga alta la fiducia gestendo il cambiamento senza una costante sorveglianza umana.
Una configurazione matura mantiene comunque regole di validazione rigide per i requisiti contrattuali o normativi. Ma smette di fingere che le sole asserzioni statiche possano coprire una piattaforma dati viva.
Costruire una cultura di data governance e remediation
La tecnologia intercetta i problemi. La governance decide che cosa significano, chi ne è owner e come risponde il business.
La governance deve chiarire, non rallentare
Molti team sentono la parola "governance" e si aspettano comitati, code di ticket e consegne bloccate. Una governance utile fa l'opposto: riduce l'ambiguità.
Un modello di governance funzionante risponde a un breve elenco di domande operative:
Domanda | Che cosa decide un team maturo |
|---|---|
Chi è owner del dataset? | Un produttore nominativo e uno stakeholder di business nominativo |
Quale qualità conta di più? | Le dimensioni legate all'uso effettivo |
Quali modifiche richiedono una review? | Schema, semantica, SLA e aggiornamenti delle regole critiche |
Come vengono gestite le escalation degli incidenti? | Livelli di gravità e percorsi di instradamento chiari |
Quali evidenze sostengono la fiducia? | Test, lineage, storico del monitoraggio e regole di approvazione |
I data contract offrono una soluzione. Rendono esplicite le aspettative dei produttori e danno ai consumatori a valle qualcosa di più solido del sapere tribale. Per i team che implementano questo pattern, questo articolo sul perché i data contract sono importanti e come implementarli è un riferimento utile.
Anche le buone decisioni architetturali riducono in seguito le difficoltà di governance. Naming, scelte di normalizzazione, strategia delle chiavi e progettazione delle relazioni influiscono tutti su quanto i dati si comportano bene nel tempo. Per questo, alcuni spunti pratici sull'architettura dei database sono direttamente rilevanti per il lavoro sulla qualità.
La remediation ha bisogno di pattern espliciti
Quando viene rilevato un problema, i team hanno bisogno di una gestione ripetibile anziché dell'improvvisazione. I pattern abituali sono semplici:
Metterlo in quarantena: tenere i record sospetti fuori dal consumo a valle quando usarli sarebbe più rischioso che ritardarli.
Arricchirlo: riparare valori mancanti o malformati quando esiste una fonte di verità affidabile.
Scartarlo: rifiutare i record che non superano controlli critici di validità o integrità.
Farlo passare con un avviso: lasciare passare i problemi non critici contrassegnando opportunamente gli output a valle.
Fare escalation a monte: rimandare il problema al sistema che produce i dati quando il consumatore non può dedurne in sicurezza l'intento.
Il cambiamento culturale più forte è semplice. La qualità dei dati diventa una responsabilità operativa condivisa anziché una coda di pulizia gestita solo dai data engineer.
Strumenti e architettura moderni per la qualità dei dati
Gli stack moderni hanno bisogno di strumenti che diano per scontato che il cambiamento sia la norma. I dati arrivano da sistemi SaaS, applicazioni operative, job batch, stream, reverse ETL, feed dei partner, notebook, semantic layer e pipeline di feature di ML. In un ambiente simile, la qualità non può basarsi su script isolati e alert sparsi.
Il cambiamento architetturale di cui i team hanno davvero bisogno
La tendenza architetturale va verso piattaforme unificate che combinano validazione, osservabilità e contesto operativo. Il motivo è pratico: distribuire queste responsabilità su troppi strumenti crea punti ciechi.
Una configurazione moderna dovrebbe supportare diverse capacità contemporaneamente. Dovrebbe monitorare in modo continuo freschezza, anomalie di volume, modifiche dello schema e violazioni delle regole. Dovrebbe inoltre fornire ai team lineage e contesto storico sufficienti per capire se un alert è un problema di business, un problema di pipeline o una fluttuazione temporanea.
Questo è particolarmente importante per i workflow di AI e ML. La panoramica di Semarchy sulla qualità dei dati afferma che il 73% dei guasti dei modelli di AI deriva da modifiche dello schema non rilevate o da variazioni nella distribuzione delle feature che si verificano inosservate durante l'ingestione dei dati, e osserva anche che le modifiche dello schema compromettono il 40% dei modelli di ML in produzione. Non sono guasti che una checklist di QA sulle dashboard intercetterà in modo affidabile.
Perché contano osservabilità e controlli di qualità unificati
Oggi un'architettura di piattaforma solida tende a includere:
Esecuzione nel database: metriche e controlli girano dove i dati risiedono già, a vantaggio di privacy, prestazioni e semplicità operativa.
Baseline comportamentali: il sistema apprende i pattern normali di volume, distribuzione e tempistica.
Consapevolezza dello schema: i cambiamenti strutturali vengono monitorati come eventi di primo piano.
Applicazione delle regole di business: i team hanno ancora bisogno di una validazione deterministica per finanza, compliance e requisiti contrattuali.
Visibilità condivisa: ingegneri, analisti e stakeholder di business hanno bisogno dello stesso contesto sugli incidenti, non di viste scollegate.
Un esempio di questo modello è digna, che combina rilevamento delle anomalie, monitoraggio della tempestività, validazione a livello di record, tracciamento dello schema e analytics storiche, eseguendo tutto all'interno dell'ambiente del cliente anziché spostare fuori i dati di produzione. Questo è importante nei contesti private cloud e on-prem, dove governance, privacy e residenza dei dati sono essenziali. Per i team che vogliono capire il confine tra queste categorie, è utile questa spiegazione su data observability e qualità dei dati a confronto.
Lo standard pratico per il 2026 non è una gigantesca libreria di controlli fragili. È un'architettura resiliente in grado di apprendere i pattern, far emergere le deviazioni significative, preservare la privacy e applicare comunque regole di business esplicite dove necessario.
Che cos'è dunque la qualità dei dati, nella forma che conta a livello operativo? È la capacità continua di mantenere i dati affidabili per il lavoro che supportano. Non una volta sola. In modo continuo.
Se il vostro team deve fare i conti con report non aggiornati, alert rumorosi, schema drift silenzioso o scarsa fiducia nelle analisi a valle, vale la pena valutare digna. È costruita per la qualità dei dati e l'osservabilità moderne, con esecuzione nel database, rilevamento delle anomalie, monitoraggio della tempestività, validazione e tracciamento dello schema pensati per gli ambienti enterprise.
Per vedere concretamente come validazione, rilevamento delle anomalie, tempestività e tracciamento dello schema si combinano in un unico modello operativo, consultate la gestione della qualità dei dati con digna.
Domande frequenti
Che cos'è la qualità dei dati?
La qualità dei dati è l'idoneità allo scopo: il grado in cui i dati sono accurati, completi, validi, coerenti, tempestivi, unici e utilizzabili per la decisione o il processo che supportano. Lo stesso dataset può essere di alta qualità per un compito e scadente per un altro, come una tabella finanziaria che arriva dopo la chiusura del materiale per il consiglio di amministrazione.
Quali sono le dimensioni della qualità dei dati?
L'articolo ne usa sette: accuratezza, completezza, tempestività, coerenza, validità, unicità e lineage. Ognuna ha un test semplice, ad esempio chiedersi se un valore è vero per l'accuratezza o se un record è duplicato per l'unicità. La lineage è esterna alle sei dimensioni delle scorecard, ma è essenziale per l'analisi delle cause profonde.
Quanto costa a un'azienda la scarsa qualità dei dati?
Secondo i dati di Dataversity citati nell'articolo, la scarsa qualità dei dati costa alle organizzazioni in media 12,9 milioni di dollari all'anno e il 77% dei responsabili IT dichiara di non fidarsi dei propri dati. I costi maggiori derivano dalle decisioni prese su dati errati e dalle ore spese a riconciliare i numeri.
Che cosa causa il peggioramento della qualità dei dati nel tempo?
Il degrado deriva di solito dal lavoro quotidiano, non da un singolo incidente clamoroso. Le cause tipiche includono l'inserimento manuale libero e una validazione debole dei moduli, integrazioni che cambiano la forma delle risposte, schema drift silenzioso e ownership poco chiara. I dati di Sifflet citati nell'articolo indicano che le modifiche dello schema non monitorate causano il 30% dei guasti dei modelli di AI in produzione.
Perché le regole statiche sulla qualità dei dati non bastano?
Le regole statiche intercettano solo aspettative note e stabili. I dati di Amplitude riportati nell'articolo mostrano che l'82% dei problemi sui dati viene rilevato solo dopo aver colpito le dashboard e che i team che si affidano a soglie statiche sprecano 15-20 ore a settimana nel triage di alert che si risolvono da soli. La pratica moderna aggiunge baseline apprese, rilevamento dinamico delle anomalie, monitoraggio della freschezza e tracciamento dello schema.


