Perfilado automatizado de datos para plataformas fiables
|
7
minuto de lectura

El dashboard sigue cargando. Los procesos nocturnos han terminado y nadie ha informado de ningún error. Entonces, un analista de negocio advierte que una categoría de clientes habitual casi ha desaparecido de la tabla subyacente. Sus controles están en verde porque comprueban si el pipeline se ejecutó, no si los datos siguen comportándose como se espera.
Índice
Por qué el perfilado manual de datos falla a escala
Piense en un data warehouse de la seguridad social en el que los ingenieros mantienen una gran colección de controles escritos a mano. Unos validan registros de prestaciones, otros comprueban fechas de entrega y otros imponen supuestos heredados de sistemas ya retirados. Se trata de un patrón operativo ilustrativo, no de un caso de cliente documentado.
Cada control pudo tener sentido cuando alguien lo escribió. La dificultad está en preservar su significado a medida que cambian los sistemas de origen, los requisitos de reporting y la titularidad de los equipos.
Un ingeniero se marcha, pero su SQL se queda. Llega un nuevo feed y el equipo copia un conjunto de reglas existente sin saber qué supuestos se aplican. Los analistas añaden controles tras cada incidente, mientras los controles obsoletos siguen generando alertas.
Cobertura de reglas no es comprensión de los datos
Un conjunto estático de reglas responde a preguntas que alguien ya sabía plantear. No revela necesariamente una categoría desconocida, una distribución que ha cambiado o un campo cuyo significado real difiere de su nombre.
Los síntomas operativos son reconocibles:
Cobertura parcial: Las tablas importantes tienen controles, pero estos cubren modos de fallo concretos en lugar del comportamiento observado de la tabla.
Responsabilidad difusa: Los ingenieros pueden localizar la regla, pero no a nadie capaz de explicar su propósito de negocio.
Fatiga de alertas: Los revisores reciben una y otra vez notificaciones de poco valor y es menos probable que investiguen la siguiente.
Son formas útiles de enfocar los problemas operativos de datos: no como valores erróneos, sino como brechas entre lo que miden los equipos y lo que necesitan los usuarios posteriores.
Descubrir antes de prescribir
El perfilado automatizado de datos parte de otra pregunta: ¿qué hay realmente en este conjunto de datos? Convierte una tabla desconocida en un objeto medible antes de que analistas, herramientas estadísticas o modelos dependan de ella.
Eso no elimina las reglas de negocio. Reduce la cantidad de SQL exploratorio que los ingenieros deben escribir antes de decidir qué reglas están justificadas.
Regla práctica: Mantenga los requisitos de negocio explícitos, pero no obligue a los ingenieros a anticipar cada cambio observable antes de que pueda empezar la monitorización.
La decisión de arquitectura también importa. Para datos empresariales sensibles, mi recomendación es aprender y mantener esas mediciones dentro del entorno del cliente. El descubrimiento no debería exigir exportar registros de producción a un escáner alojado.
El resultado útil no es un inventario mayor de controles. Es una línea base mantenida, un revisor responsable y evidencias que ayuden a distinguir un cambio significativo de la variación rutinaria.
Qué mide realmente el perfilado automatizado de datos
Empiece por una tabla desconocida del warehouse. Puede leer su esquema, pero los tipos declarados no le dirán si los campos están poblados, si los identificadores se repiten o si los valores de texto siguen patrones coherentes.
El artículo de referencia Data Profiling Revisited, publicado en 2013, describe el perfilado como el examen de características de los datos como tipos de columna, recuentos de nulos, recuentos de valores distintos y patrones frecuentes. También explica cómo el perfilado respalda la verificación de restricciones y la configuración posterior de herramientas estadísticas o de minería de datos.
Aprender la forma observable
Piense en un perfil como el plano de un edificio y el recuento de su ocupación. Describe las salas y dónde está la gente, pero no explica por qué entró en el edificio.
Del mismo modo, un perfil puede mostrar que una columna de estado contiene valores desconocidos. No puede establecer si esos valores representan un cambio de negocio aprobado.

Una inspección inicial debería establecer:
Estructura: Qué columnas existen y qué tipos de datos admiten sus valores.
Población: Dónde faltan valores y cuántos valores distintos aparecen.
Forma: Qué rangos, formatos repetidos y valores frecuentes caracterizan la tabla.
Estas mediciones dan a los ingenieros un punto de partida para el descubrimiento. Un campo de texto con aspecto de fecha puede merecer una inspección más detallada; un identificador de cliente muy repetido puede ser esperable en transacciones, pero sospechoso en un maestro de clientes.
Guardar evidencias, no solo un informe
Las mediciones básicas - completitud, unicidad, conformidad de tipos, frecuencia y distribución - se aplican a bases de datos relacionales, warehouses, data lakes y archivos analíticos. La tecnología de almacenamiento cambia el método de ejecución, no las preguntas que se plantean.
Conserve el perfil resultante como referencia para observaciones posteriores. Registre el origen y las condiciones en que se generó, en lugar de guardar solo un gráfico que nadie podrá reproducir después.
Para los equipos que formalizan esa trazabilidad, la guía de Fetchin sobre la procedencia de los datos es un recurso complementario útil. La procedencia debe acompañar al resultado estadístico porque los revisores necesitan saber de dónde procede la evidencia.
El límite práctico es importante: el comportamiento observado no es automáticamente un comportamiento correcto. El perfilado aporta evidencias para una decisión, no permiso para convertir cada patrón habitual en un requisito obligatorio.
Técnicas de perfilado y métricas de calidad
Un perfilador maduro necesita algo más que un contador de valores ausentes. En una evaluación sistemática de 13 herramientas de calidad de datos, el perfilado básico estaba ampliamente soportado, mientras que las capacidades avanzadas de dependencias y multicolumna solo aparecían en herramientas aisladas, según describe la evaluación de Frontiers sobre herramientas de calidad de datos.
Ajustar la evidencia a la pregunta
Organice la recopilación en torno a estas clases de evidencia:
Clase de evidencia | Cálculos útiles e interpretación |
|---|---|
Cardinalidades de una sola columna | Los recuentos de valores distintos y duplicados revelan repeticiones y posible unicidad. |
Distribuciones de valores | Cuantiles, histogramas de frecuencia y tasas de valores atípicos describen la concentración y la dispersión. |
Tipos de datos y patrones | Los tipos semánticos inferidos y las regularidades de formato distinguen la representación de almacenamiento del significado probable. |
Dominios | Los conjuntos de valores observados sugieren valores permitidos candidatos para su revisión. |
Relaciones entre columnas y multicolumna | Las claves candidatas y las dependencias funcionales revelan posibles restricciones de integridad. |
Incluya explícitamente las tasas de nulos y vacíos. Una cadena vacía y un nulo de base de datos pueden requerir un tratamiento distinto, así que documente cualquier decisión de fusionarlos.

Equilibrar cobertura y coste de escaneo
Versione las mediciones por tabla, columna, partición y momento de observación. De lo contrario, los revisores no podrán distinguir con fiabilidad un cambio persistente de distribución de un problema aislado en una partición.
Los recuentos exactos de valores distintos y las pruebas exhaustivas de dependencias por pares pueden ser costosos en grandes conjuntos de datos. Los sketches aproximados, las muestras estratificadas y los perfiles incrementales son alternativas razonables, pero conviene validar las aproximaciones frente a cálculos exactos en los conjuntos de datos críticos.
La elección debe responder a la consecuencia del error. El descubrimiento exploratorio tolera una incertidumbre que un control de integridad regulatorio no admite.
La política de gestión de datos de Queensland Health incluye exactitud, validez, fiabilidad, puntualidad, relevancia, completitud y unicidad en su ámbito de calidad. Esa amplitud es un correctivo útil al seleccionar métricas de calidad de datos: las estadísticas fáciles de calcular no deberían definir todo el programa.
Convertir hallazgos en controles
Un dominio inferido y aprobado puede convertirse en una regla de validación. Una clave candidata confirmada puede convertirse en un control de integridad, mientras que una línea base de distribución puede alimentar la detección de anomalías.
La conciliación de negocio sigue requiriendo lógica de dominio. Por ejemplo, los equipos que cuadran movimientos bancarios con registros contables mediante Charter AI abordan una tarea de emparejamiento de negocio, no un simple recuento de referencias de transacción distintas.
Mantenga clara esa distinción. El perfilado ayuda a identificar qué merece un control; los responsables de negocio determinan qué debe significar ese control.
Cuando más perfiles generan más ruido
Recopilar todas las estadísticas disponibles no mejora automáticamente las decisiones. Si nadie puede explicar qué desviaciones importan, los ingenieros han automatizado la producción de notificaciones, no una monitorización fiable.
El comportamiento normal puede variar según el día de la semana, el cierre de mes, la temporada, el ciclo de versiones o un evento de negocio. Comparar cada carga con una media histórica indiferenciada puede hacer que un cambio esperado parezca un defecto.
Separar datos ausentes de datos erróneos
El marco de calidad de datos del Gobierno del Reino Unido distingue la completitud de la exactitud. Un conjunto de datos puede contener todos los registros esperados y aun así contener valores incorrectos.
Mida por separado la presencia de filas, la ausencia de valores a nivel de campo y la corrección de los valores. Si una entrega no ha terminado, un aparente problema de completitud puede requerir investigar el pipeline en lugar de corregir registros.
Un cambio en una métrica es una observación. Llamarlo defecto requiere contexto.
Los resultados de 2025 recogidos en State of Enterprise Data and AI de Atlan ilustran ese problema de contexto: el 97 % de las organizaciones declaró carencias en definiciones, calidad y confianza, mientras que el 52 % citó preocupaciones de seguridad y de acceso a datos sensibles. La misma fuente indica que los directivos valoraron la madurez de datos de su organización un 12 % más alta que los profesionales, mientras que casi el 90 % de los profesionales de datos tenía dificultades con la escala y la complejidad.
Estos resultados respaldan una postura operativa prudente: no dé por hecho que más mediciones resuelven los desacuerdos sobre significado o preparación.

Incorporar tiempo e impacto al triaje
Utilice líneas base sensibles al tiempo y umbrales adaptativos donde el comportamiento esperado varíe. Revise los falsos positivos de forma explícita y registre si una alerta llevó a un defecto confirmado, a un cambio de negocio aceptado o a una investigación sin evidencia suficiente.
Modelar la llegada esperada ayuda a distinguir ventanas de observación incompletas de cargas finalizadas. Un triaje basado en el linaje debería relacionar la desviación con retrasos de entrega, cambios de esquema y los informes o modelos posteriores en riesgo.
Presente esas relaciones en dashboards de calidad de datos, en lugar de mostrar un indicador rojo sin explicación. Un revisor debería ver qué ha cambiado, quién es el responsable y qué acción está disponible.
La preparación para la IA requiere algo más que normalidad estadística. Sin definiciones semánticas, responsables y una vía de corrección, un perfil técnicamente detallado no garantiza datos fiables para entrenamiento u operación.
Cómo elegir el perfilado dentro de la base de datos
Para cargas de trabajo empresariales sensibles, convierta la ejecución controlada por el cliente en un requisito de diseño. Decida dónde se ejecutan las consultas, qué identidad las ejecuta y qué evidencias pueden salir antes de comparar funciones de la interfaz.
Una encuesta de 2025 sobre IA empresarial publicada por CIO Dive abarcó a 1050 líderes empresariales e identificó las restricciones de privacidad y cumplimiento, los duplicados y la integración ineficiente entre los principales problemas de datos. Menos de la mitad creía alcanzables sus objetivos de IA.
Dónde debería ejecutarse el perfilado automatizado
Pregunta de decisión | Dentro de la base de datos, en el entorno del cliente | Escaneo alojado externamente |
|---|---|---|
¿Dónde se examinan los valores? | Dentro del perímetro controlado de la base de datos. | En el entorno de escaneo alojado, si los registros se transfieren allí. |
¿Qué puede salir? | Definir una política explícita para métricas calculadas y metadatos. | Evaluar registros exportados, muestras retenidas y metadatos derivados. |
¿Qué acceso se aplica? | Usar una identidad de ejecución dedicada y con privilegios mínimos. | Revisar los permisos del conector y el modelo de acceso del servicio alojado. |
¿Cómo se gestiona la carga? | Programar las consultas según la capacidad de la base de datos. | Tener en cuenta la carga de extracción, la transferencia y el procesamiento externo. |
¿Qué debe auditarse? | La ejecución en la base de datos y las decisiones de perfilado. | Extracción, acceso externo, retención y decisiones de perfilado. |
Un plano de control alojado no es necesariamente un escáner alojado. Pregunte específicamente dónde se procesan los registros en lugar de fiarse de una etiqueta de despliegue.
Probar la vista autorizada
¿Puede el trabajo permanecer dentro del entorno de un banco, un hospital, una operadora de telecomunicaciones o un organismo público? ¿Qué metadatos pueden salir y quién aprueba esa decisión?
Pruebe por separado las entradas cifradas, enmascaradas, tokenizadas y autorizadas a nivel de fila. Un cambio en la política de tokenización o una vista de filas restringida no debe clasificarse erróneamente como un defecto de los datos de origen; el perfilador solo puede describir la representación que su identidad está autorizada a observar.
Exija evidencias de auditoría sobre alcance, identidad, marca de tiempo, versión de la regla, decisión de acceso e historial de corrección. La ejecución dentro de la base de datos no elimina la necesidad de controles de acceso ni de gestión de recursos.
Una opción dentro del propio entorno
El procesamiento dentro de la base de datos de digna es una opción para este patrón de ejecución. Los controles y el cálculo de métricas permanecen en la base de datos del cliente, el despliegue es en nube privada u on-premises y el proveedor no accede a los datos de producción.
Sus módulos cubren líneas base de anomalías aprendidas sin crear cada control a mano, tendencias históricas de métricas, tiempos de entrega esperados, validación a nivel de registro y columnas añadidas, eliminadas o con tipo modificado. El módulo inicial incluye un dashboard compartido, planificador, catálogo, integraciones y colaboración.
El modelo comercial consiste en una cuota base más un cargo por tabla activa y módulo, sin tarifas por llamadas a la API, escaneos o volumen de alertas. El proveedor afirma que los primeros resultados están disponibles en menos de dos horas; trátelo como una promesa de onboarding que debe verificar durante la evaluación frente a su conectividad, permisos y carga de trabajo.
Flujos de trabajo empresariales para perfilado y monitorización
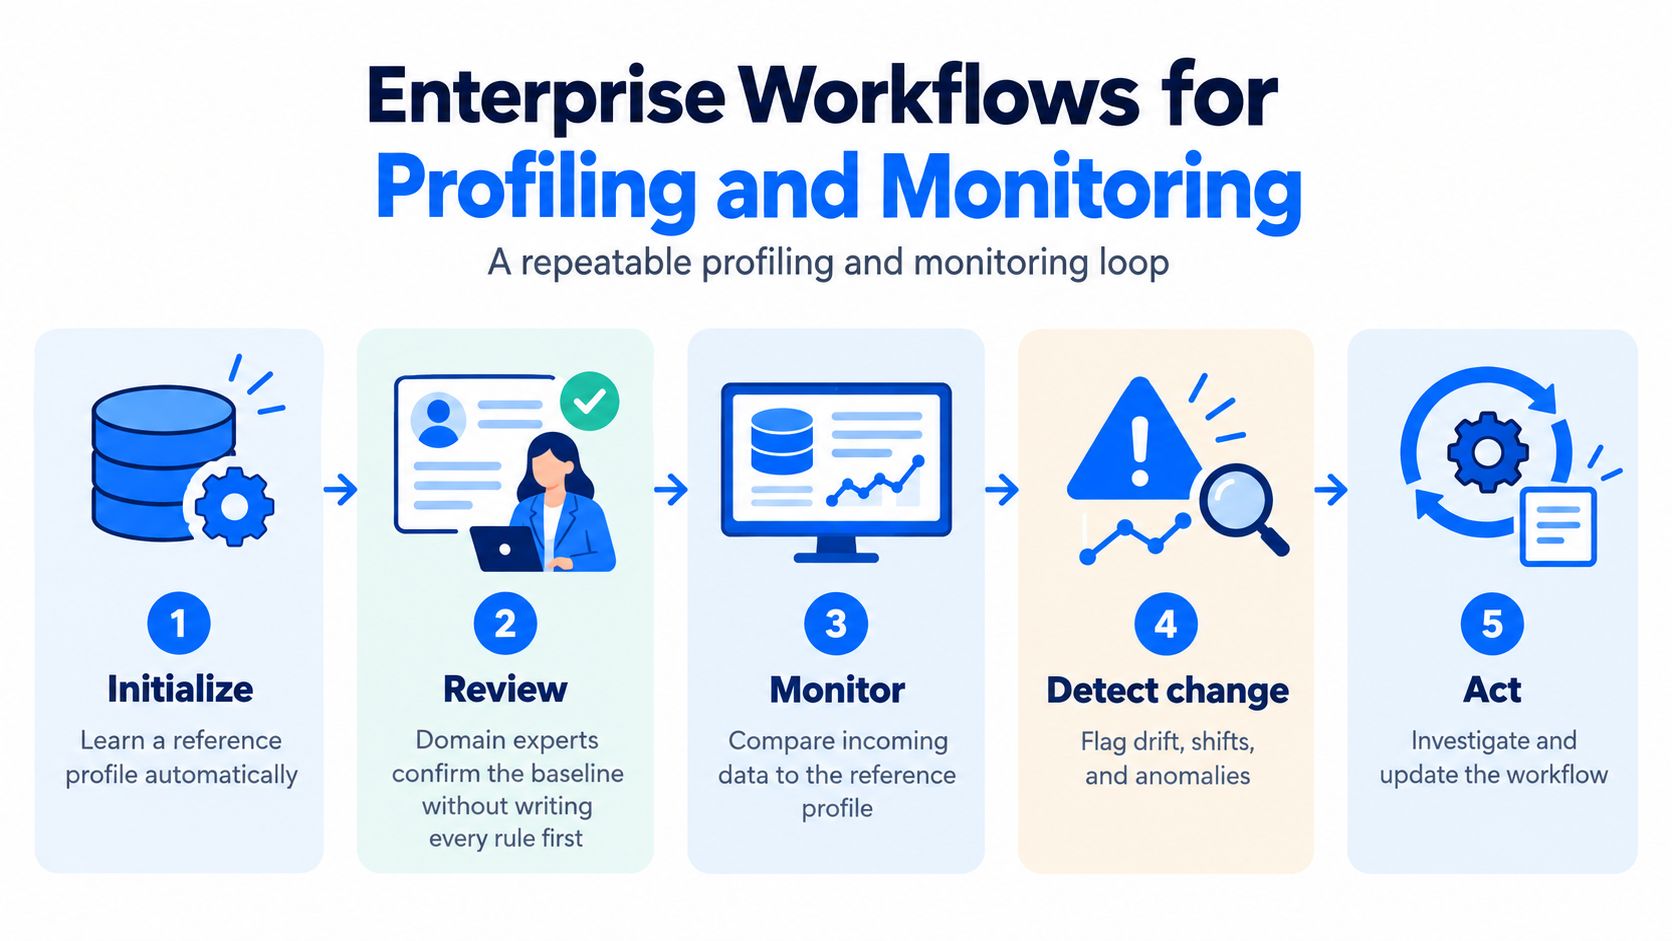
Empiece con un perfil de referencia, no con un editor de reglas vacío. En un estudio revisado por pares de 2022 sobre monitorización con perfiles de referencia, los investigadores implementaron DQ-MeeRKat y lo evaluaron con seis flujos de datos reales de dispositivos telemáticos.
El método aprendía automáticamente conjuntos de estadísticas de perfilado para modelar la calidad objetivo. Permitía la inicialización mediante monitorización continua sin exigir que expertos del dominio escribieran de antemano cada regla.
Dirigir cada observación a la revisión adecuada
Inicialice la referencia, pida a un experto del dominio que evalúe su idoneidad y compare las cargas entrantes con la versión aprobada. Mantenga conectadas la comparación y la respuesta operativa.
Utilice traspasos diferenciados en lugar de enviar todas las observaciones a la misma cola:
Desviación de distribución: Asigne una revisión de anomalías para determinar si cambió el negocio o si el pipeline introdujo un defecto.
Entrega ausente o anticipada: Derive a una revisión de puntualidad con el tiempo de entrega esperado y la evidencia de llegada real.
Posible incumplimiento de una regla de negocio: Ejecute una validación a nivel de registro para identificar los registros afectados.
Columnas añadidas, eliminadas o con tipo modificado: Abra una revisión de esquema antes de que continúen las transformaciones dependientes.
Los requisitos del sector determinan la escalada. En servicios financieros, priorice los feeds de riesgo y regulatorios antes que el reporting; en el sector sanitario, distinga entre necesidades de entrega clínicas y operativas.
Los equipos de telecomunicaciones deberían relacionar las desviaciones en datos de clientes de gran volumen con los retrasos del pipeline. Los equipos del sector público deberían conservar decisiones trazables y evidencias listas para auditoría.
Mantener visible la incertidumbre
Los valores ausentes pueden producir dependencias funcionales falsas. La investigación sobre descubrimiento automatizado de esquemas y dependencias también recoge una evaluación en la que los esquemas generados exactos y completos aumentaron del 60 % al 72 % cuando el sistema devolvía los cinco mejores candidatos en lugar de un único resultado.
Eso respalda hipótesis jerarquizadas, puntuaciones de confianza y aprobación humana, no la aceptación automática de la primera respuesta que aparezca. Los revisores necesitan ver alternativas plausibles cuando nombres, tipos, claves o relaciones son inciertos.
Límite de aprobación: Deje que la automatización proponga la interpretación. Haga que una persona responsable apruebe las restricciones relevantes.
Una plataforma integrada puede albergar este flujo sin convertirse en propietaria del significado de negocio. Establezca responsabilidades de monitorización y reporting para que los ingenieros se ocupen de la ejecución, los responsables de dominio valoren el significado y los revisores de gobierno puedan reconstruir las decisiones.
Cierre un incidente solo cuando alguien haya registrado la causa, la acción y la decisión sobre la línea base. Un cambio de negocio aceptado puede justificar la actualización de la referencia; un defecto del pipeline no debería absorberse como comportamiento normal.
Empezar el perfilado automatizado en tablas críticas
Elija una tabla crítica cuyo fallo rompería un informe, un modelo o una salida regulatoria. Prefiera una tabla con un responsable de negocio identificable y un ingeniero que conozca su ruta de entrega.
Anote la decisión que respalda y lo que significaría un fallo. Eso da a los revisores una base concreta para priorizar los hallazgos en lugar de tratar cada desviación como igual de urgente.
Definir el primer perímetro operativo
Perfile la tabla in situ y conserve las evidencias necesarias para repetir la inspección. Mantenga juntos la instantánea, la consulta de origen o la política de muestreo, la versión del algoritmo, la confianza y la decisión de aprobación.
No lleve directamente a producción una clave, un tipo o una dependencia de baja confianza. Pida al responsable que explique si la restricción propuesta refleja un requisito o simplemente un patrón de la muestra observada.

Hacer que la revisión sea repetible
Dé al piloto un acuerdo operativo pequeño y explícito:
Nombrar a los revisores: Asigne al data engineer y al responsable de negocio antes de activar las notificaciones.
Definir la respuesta: Especifique quién investiga una observación y quién puede aprobar un cambio de línea base.
Proteger el uso posterior: Decida qué cambios de esquema requieren revisión antes de que los procesos dependientes consuman la tabla.
Conservar el resultado: Registre si el incidente fue un problema de entrega, datos defectuosos o un cambio aceptado.
Compare cada nueva carga con la referencia aprobada. Separe la llegada tardía de un cambio real de distribución e investigue los cambios estructurales antes de considerarlos inocuos.
Revisen juntos el primer incidente explicable. El ingeniero debería poder mostrar qué ocurrió en el pipeline, y el responsable de negocio describir la consecuencia para el proceso consumidor.
Amplíe módulo a módulo solo cuando ese ciclo funcione. Más cobertura es útil cuando el equipo puede investigar y actuar, no solo cuando puede generar más observaciones.
Para un despliegue acotado, instale la plataforma en la nube, VPC o centro de datos existente, inspeccione la tabla seleccionada y revise anomalías, puntualidad y estado del esquema en el dashboard compartido. Mantenga esa revisión lo bastante acotada como para que el equipo pueda tomar y documentar una decisión.
digna ofrece aprendizaje de líneas base dentro de su entorno, monitorización de anomalías, controles de puntualidad, validación de registros y seguimiento de esquemas para este modelo operativo. Visite digna para evaluar la plataforma en una tabla crítica y revise después los primeros resultados con su data engineer y su responsable de negocio antes de ampliar la cobertura.
Una vez que existe un perfil de referencia, el siguiente paso es mantenerlo actualizado sin escribir una regla para cada columna: el módulo Data Anomalies de digna aprende los volúmenes, distribuciones y tasas de nulos normales de cada tabla y señala las desviaciones a medida que llegan nuevas cargas, de modo que la línea base se convierte en detección continua y no en un informe puntual.
Preguntas frecuentes
¿Qué es el perfilado automatizado de datos?
El perfilado automatizado de datos mide de forma sistemática lo que contiene realmente un conjunto de datos - tipos de columna, nulos, valores distintos, patrones frecuentes, rangos y distribuciones - antes de que analistas o modelos dependan de él. El resultado es una línea base almacenada con la que se comparan las cargas posteriores, no un informe puntual imposible de reproducir.
¿Por qué dejan de funcionar a escala las reglas de calidad de datos escritas a mano?
Las reglas estáticas solo responden a preguntas que alguien ya pensó en hacer. Cuando cambian las fuentes, los informes y los responsables, aparecen cobertura parcial, SQL que nadie sabe explicar tras la marcha de su autor y fatiga de alertas por controles obsoletos, mientras categorías nuevas o distribuciones desplazadas pasan desapercibidas.
¿Qué métricas debe incluir un perfil de datos?
Un perfil útil abarca completitud, unicidad, conformidad de tipos, frecuencia y distribución, además de tasas explícitas de nulos y vacíos, ya que una cadena vacía y un nulo de base de datos pueden requerir un tratamiento distinto. Los perfiladores maduros añaden dominios, claves candidatas y dependencias funcionales, versionados por tabla, columna, partición y momento de observación.
¿Cómo se reducen las falsas alertas del perfilado de datos?
Con líneas base sensibles al tiempo y umbrales adaptativos, porque el comportamiento normal varía según el día de la semana, el cierre de mes, la temporada o el ciclo de versiones. Conviene separar datos ausentes de datos erróneos, modelar la llegada esperada y registrar si cada alerta fue un defecto confirmado, un cambio aceptado o una investigación sin conclusión.
¿El perfilado de datos debe ejecutarse dentro de la base de datos o en un escáner alojado?
Para datos empresariales sensibles, el perfilado dentro de la base de datos, en el entorno del cliente, es la opción más segura. Los valores no salen del perímetro controlado, una identidad con privilegios mínimos ejecuta las consultas y solo salen métricas calculadas según una política explícita; un escáner externo obliga a evaluar registros exportados, muestras retenidas y permisos del conector.


