Observabilidad vs monitorización: una guía práctica para decidir
|
7
minuto de lectura

El mal consejo en este debate es sencillo: elegir la observabilidad y retirar la monitorización. Suena moderno, pero es un error para los equipos de datos reales. La monitorización es su capa de control, la observabilidad es su capa de diagnóstico, y la respuesta correcta depende de lo que cuesta equivocarse en cada carga de trabajo.
Punto de decisión | Monitorización | Observabilidad |
|---|---|---|
Función principal | Detectar estados de fallo conocidos | Explicar fallos desconocidos o multifactoriales |
Mejor evidencia | Umbrales, alertas, señales estables | Métricas, logs, trazas y contexto correlacionados |
Auditabilidad | Alta cuando los controles son explícitos | Menor si sustituye a los controles explícitos |
Perfil de coste | Más bajo y más acotado | Más alto y más amplio |
Encaje ideal | Modos de fallo estables y bien conocidos | Fallos complejos, distribuidos o de gran alcance |
Índice de contenidos
Por qué el debate entre observabilidad y monitorización pasa por alto la verdadera pregunta
Qué significan realmente la monitorización y la observabilidad
Dónde compensan la detección de anomalías con IA y el seguimiento de esquemas
La fragmentación de herramientas y los verdaderos obstáculos para una cobertura unificada
Por qué el debate entre observabilidad y monitorización pasa por alto la verdadera pregunta
La discusión suele plantearse como una carrera de caballos, como si una disciplina tuviera que sustituir a la otra. Ese planteamiento es perezoso. La monitorización y la observabilidad resuelven problemas distintos, y una sustitución equivocada crea puntos ciegos en lugar de claridad.
La monitorización es control explícito. Se define la señal, se fija el límite y se genera una alerta cuando la realidad lo supera. La observabilidad es más amplia, porque consiste en que el estado interno pueda deducirse de los datos emitidos, de modo que los ingenieros puedan explicar fallos desconocidos y no solo confirmar los previstos. La pregunta práctica no es qué término suena más actual, sino qué nivel de profundidad diagnóstica justifica cada carga de trabajo.
Esto importa porque sustituir monitores por una observabilidad amplia puede debilitar la gobernanza. Si los controles se vuelven implícitos, resultan más difíciles de auditar. Para una plataforma de datos, es un mal intercambio. Una carga ausente, un esquema roto o una deriva de KPI no necesitan elegancia filosófica: necesitan un responsable explícito, una alerta y un rastro de evidencias.
Regla práctica: mantenga monitores explícitos para los modos de fallo conocidos y añada observabilidad solo donde necesite profundidad de causa raíz, correlación o diagnóstico exploratorio.
El libro Site Reliability Engineering de Google formalizó las cuatro señales doradas para los servicios orientados al usuario: latencia, tráfico, errores y saturación. Esa base sigue siendo válida porque ofrece a los equipos una capa de monitorización compacta para los problemas conocidos. Pero las plataformas de datos necesitan algo más que la salud del servicio. También necesitan frescura, estabilidad del esquema, validez de los registros, comportamiento de las métricas de negocio y consumo de las cargas de trabajo.
Si está decidiendo dónde invertir, deje de preguntarse si la observabilidad es mejor que la monitorización. Pregúntese qué evidencia necesita cuando un dataset, un pipeline o un informe falla, y cuánto cuesta llegar tarde, ser impreciso o equivocarse.
Qué significan realmente la monitorización y la observabilidad
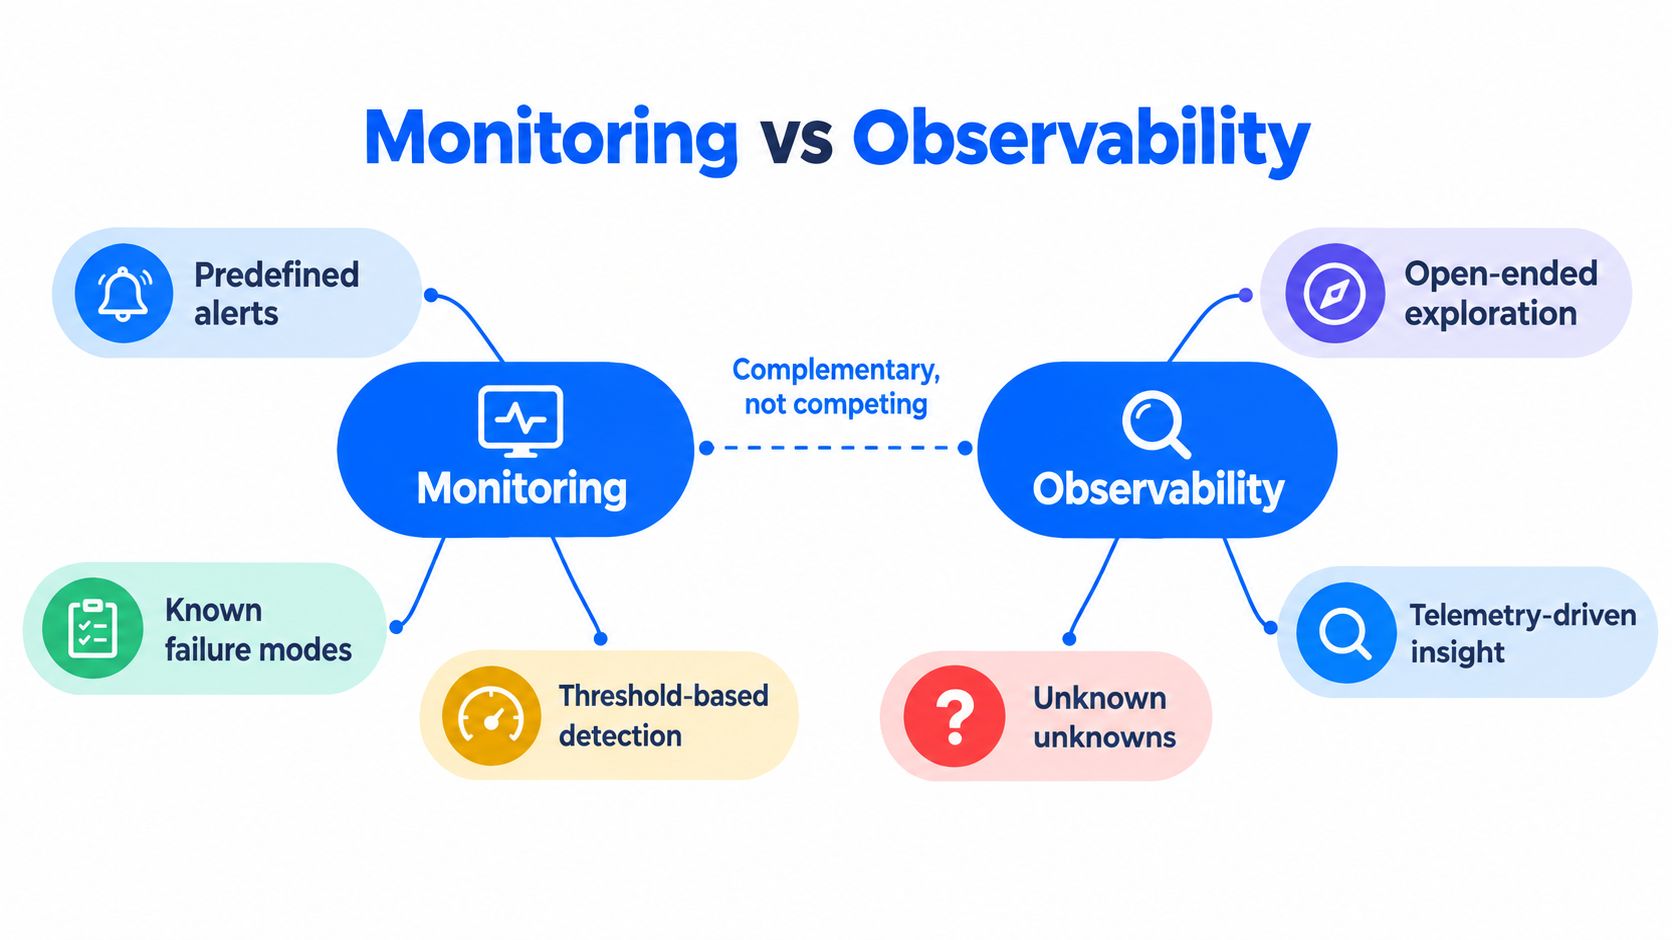
La monitorización es una función de detección predefinida. Los equipos eligen indicadores como la tasa de peticiones, la tasa de errores, la latencia, el uso de CPU o el estado de llegada de los datos, y generan una alerta cuando los valores superan un umbral o salen de un rango esperado. Responde a una pregunta acotada pero esencial: ¿está una condición conocida fuera de su límite?
La observabilidad es más amplia. Plantea si es posible deducir el estado interno de un sistema a partir de los datos que emite. En la práctica, eso significa correlacionar métricas, logs y trazas para que los ingenieros puedan investigar un fallo que no previeron al escribir la alerta.
La base de partida para la mayoría de los equipos
La visión clásica a nivel de servicio sigue siendo relevante. El modelo SRE de Google ofrece una base mínima de monitorización con latencia, tráfico, errores y saturación. Estas señales son útiles porque imponen disciplina. Una alerta de latencia indica que el servicio va lento, el tráfico indica que la demanda ha cambiado, los errores indican que las peticiones han fallado y la saturación indica que un recurso limitado está cerca de su uso máximo. No hace falta más teología que esa.
En las plataformas de datos, la correspondencia es directa, pero no idéntica. Sustituya la latencia del servicio por la frescura y la puntualidad de la entrega. Sustituya el tráfico por los patrones de carga y consumo. Sustituya los errores por jobs fallidos, registros no válidos o transformaciones rotas. Sustituya la saturación por la presión sobre el warehouse, el clúster o el pipeline.
La monitorización le dice que algo ha cruzado una línea. La observabilidad le ayuda a explicar qué cambió, dónde cambió y a qué más afectó.
Esa diferencia explica por qué los equipos de datos salen escaldados cuando toman un dashboard en verde como prueba de que todo es correcto. Un dashboard puede estar disponible y seguir siendo analíticamente erróneo porque los datos están desactualizados, incompletos, duplicados o han cambiado de estructura. Si su negocio depende del resultado, necesita tanto el control como la evidencia.
Como punto de partida práctico, consulte el enfoque de data observability de digna.
Objetivos, telemetría y detección frente a diagnóstico
La forma más clara de separar estas disciplinas es comparar para qué sirven, qué evidencia utilizan y hasta dónde llevan. La monitorización se centra en objetivos de control. La observabilidad se centra en el diagnóstico. Una está pensada para límites conocidos; la otra, para investigar en condiciones de incertidumbre.
Matriz de decisión
Criterio | Monitorización | Observabilidad |
|---|---|---|
Objetivo de control | Hacer cumplir límites conocidos y expectativas de servicio | Explicar el comportamiento interno y los patrones de fallo emergentes |
Disparador típico | Umbral superado, job ausente, regla fallida, entrega tardía | Correlación inusual, cambio de comportamiento, anomalía sin explicación |
Foco de la telemetría | Métricas agregadas y alertas | Métricas, logs, trazas y contexto más rico correlacionados |
Pregunta que responde | ¿Qué ha pasado y se ha superado la tolerancia? | ¿Qué ha cambiado, por qué ha cambiado y qué más puede verse afectado? |
Patrón de responsabilidad | Responsable operativo claro para las comprobaciones conocidas | Diagnóstico transversal entre los equipos de plataforma, datos y aplicaciones |
Rastro de auditoría | Sólido cuando los controles son explícitos | Más sólido para investigar que como evidencia formal de control |
Perfil de coste | Normalmente más acotado y más barato de operar | Más amplio, más caro y más fácil de sobredimensionar |
La división básica de OpenTelemetry resulta útil aquí. Las métricas son mediciones en tiempo de ejecución, los logs son registros de eventos y las trazas son los recorridos de las peticiones a través de los servicios. La correlación es lo esencial. Una métrica indica que la latencia ha subido, una traza muestra qué ruta se ralentizó y los logs explican el evento que lo provocó. El material de IBM sobre observabilidad lo expresa con la misma sencillez: las métricas alertan, las trazas muestran las rutas de ejecución y los logs aportan el contexto para resolver.
Para los equipos de datos, esto significa que la telemetría no se elige por moda, sino por su valor diagnóstico. Si el problema es un job batch fallido, un monitor puede ser suficiente. Si un modelo, un informe o un flujo de trabajo de cliente aguas abajo es incorrecto, se necesita el contexto adicional para conectar el síntoma con la causa.
La evidencia adecuada para cada tarea
Monitorización para los controles: úsela donde el modo de fallo es conocido, el límite es estable y la evidencia debe ser explícita.
Observabilidad para el diagnóstico: úsela donde la causa es incierta, el grafo de dependencias es complejo o pueden estar implicados varios sistemas.
Ambas a la vez: utilice las dos cuando equivocarse sale caro y el fallo podría pasar desapercibido.
Si busca un enfoque más operativo, empiece por las buenas prácticas de observabilidad para equipos de datos. No se trata de recopilarlo todo, sino de reunir la evidencia suficiente para que la siguiente decisión sea defendible.
Escenarios de detección en una plataforma de datos
Las definiciones abstractas no mueven a los equipos. Los incidentes, sí. La forma más fácil de distinguir la monitorización de la observabilidad es ponerlas a prueba frente a los fallos que producen las plataformas de datos.
Carga nocturna fallida y entrega con retraso
Un job batch fallido es el caso más sencillo. La monitorización debería detectar la ejecución rota, la tabla ausente o la llegada tardía. La alerta debe ser directa y accionable. La observabilidad solo aporta valor si el fallo no es evidente, por ejemplo cuando el job terminó pero una dependencia se atascó, una partición no llegó o los datos llegaron después de que se cerrara la ventana de negocio.
Ahí es donde importa el seguimiento de la puntualidad. Si un feed regulatorio, un extracto financiero o una instantánea operativa tienen una fecha límite, la alerta debe indicar que los datos llegan tarde. La capa de observabilidad debe mostrar si el origen se retrasó, si la transferencia fue lenta o si un paso posterior retuvo el registro.
Cambio de esquema silencioso y roturas aguas abajo
Un evento de deriva de esquema es justo donde la monitorización por sí sola se queda corta. El pipeline puede seguir ejecutándose, pero el contrato de datos está roto. La monitorización puede detectar una columna ausente, un error de parseo o una infracción de una regla si la comprobación ya está escrita. La observabilidad necesita contexto del esquema, linaje y consumidores afectados para ver qué cambió y qué informe o modelo ha dejado de ser fiable.
Caída de KPI e impacto en el negocio
Una caída en los informes de ingresos es un problema distinto. Los datos pueden seguir siendo técnicamente válidos, pero el resultado de negocio ha cambiado. La monitorización puede señalar la desviación del KPI si se sigue de forma explícita. La observabilidad resulta útil cuando hay que relacionar ese cambio con el volumen, la estacionalidad, el comportamiento aguas arriba o un cambio de carga en los sistemas de origen.
Ejecución y análisis dentro de la base de datos
El mejor camino de diagnóstico suele terminar en el propio warehouse o data lake. Si las comprobaciones se calculan in situ, se reduce el movimiento de datos y la evidencia se mantiene cerca de los datos. Es una opción más adecuada para entornos sensibles que esparcir copias de los registros por herramientas adicionales.

Si trabaja con datasets con muchas anomalías, los tipos de detección de anomalías son la siguiente pregunta lógica. Pero no complique en exceso las tablas de referencia estáticas ni los feeds de cumplimiento append-only. Esas cargas de trabajo suelen necesitar primero una monitorización firme, no una exploración sofisticada.
Stacks de telemetría y lo que cuestan realmente
Las herramientas son el lugar donde mueren las buenas intenciones. Los equipos suelen creer que están comprando visibilidad y luego descubren que han comprado trabajo de configuración, lastre de integración y otra cola de alertas.
El coste real es la fricción operativa
En la encuesta de 2025 de Grafana Labs con 1.255 participantes, la complejidad fue la principal preocupación en materia de observabilidad, la fatiga de alertas fue el mayor obstáculo para responder más rápido a los incidentes y el gasto en observabilidad promedió el 17 % del gasto total en infraestructura de cómputo. Esto indica dos cosas. Primero, la observabilidad no es gratuita. Segundo, más telemetría no significa automáticamente un diagnóstico más rápido. Puede significar simplemente más trabajo.
Los estándares abiertos ayudan, pero no eliminan la carga. OpenTelemetry y los stacks del tipo Prometheus facilitan mover los datos y mantener la instrumentación portable. No reducen por arte de magia el ruido de alertas, la configuración de los pipelines de datos ni la coordinación necesaria para convertir las señales en acciones.
Elegir el stack por el valor de la evidencia
Patrón de stack | Mejor uso | Principal contrapartida |
|---|---|---|
Monitorización centrada en métricas | Servicios estables, SLO conocidos, alertas explícitas | Menor profundidad diagnóstica |
Métricas más logs más trazas | Sistemas distribuidos e investigaciones de varios pasos | Mayor esfuerzo de configuración y correlación |
Ejecución dentro de la base de datos | Datos sensibles, cargas centradas en el warehouse, menor movimiento de datos | Menos flexibilidad si se restringe en exceso el modelo |
Un enfoque dentro de la base de datos cambia la economía. Mantiene los datos en su sitio, reduce el movimiento y encaja en entornos donde la gobernanza importa tanto como la velocidad. Suele ser la respuesta correcta para las plataformas de datos empresariales, porque la telemetría debe estar cerca de los datos que describe. Si tiene que copiar medio warehouse solo para medirlo, probablemente está haciendo demasiado.

Si quiere una recomendación práctica, utilice el stack más económico que aún ofrezca un diagnóstico defendible para la carga de trabajo. Todo lo demás es decoración.
Dónde compensan la detección de anomalías con IA y el seguimiento de esquemas
La detección de anomalías con IA es útil cuando los umbrales estáticos fallan. Si un dataset tiene ingresos volátiles, un comportamiento de consumo errático, ruido de sensores o eventos generados por máquinas, los límites fijos se convierten en instrumentos toscos. El aprendizaje de líneas base y la comparación continua pueden detectar desviaciones significativas sin obligar a los equipos a ajustar a mano cada regla.
Detección estadística donde el comportamiento cambia
Aquí es donde la detección de anomalías basada en IA demuestra su valor. Ayuda cuando la forma de los datos cambia con el tiempo y la señal importa más que la cifra exacta. Un umbral puede decirle que algo está alto. Una línea base puede decirle que algo es inusual.
Encaja mal en tablas de referencia estáticas, claves deterministas y feeds de cumplimiento append-only. Esas cargas de trabajo no necesitan ingenio. Necesitan comprobaciones fiables y responsables claros.
Adaptar el control a cada dataset
Frescura y puntualidad: utilice la monitorización de llegada donde al negocio le importa cuándo llegan los datos, no solo si llegan.
Seguimiento de esquemas: úselo siempre que los consumidores aguas abajo dependan de que la estructura se mantenga estable.
Validación de registros: úsela para hacer cumplir reglas de negocio, sobre todo cuando la evidencia de auditoría es importante.
Ejecución dentro de la base de datos: úsela cuando la seguridad, la gobernanza o el movimiento de datos sean la limitación.
El error práctico es tratar todos los datasets como si fueran igual de dinámicos. No lo son. Una tabla de dimensión de cambio lento no merece la misma factura de observabilidad que un feed transaccional de gran volumen o un flujo de ingresos volátil.
También conviene separar mentalmente el seguimiento de esquemas de la detección de anomalías. La deriva de esquema es estructural. La detección de anomalías es de comportamiento. En un entorno de datos serio se necesitan ambas, pero resuelven problemas distintos y no deberían justificarse con el mismo argumento.
Si está decidiendo dónde invertir, cómo detecta la IA anomalías de datos en los pipelines es el enfoque adecuado. Utilice la inteligencia donde la variabilidad es real, no donde una regla puede hacer el trabajo limpiamente.
La fragmentación de herramientas y los verdaderos obstáculos para una cobertura unificada
Si la observabilidad fuera solo una mejora de herramientas, la cobertura unificada ya sería lo habitual. No lo es. Una encuesta de la CNCF de 2026 con 407 profesionales reveló que el 46,7 % de las organizaciones utilizaba dos o tres herramientas de observabilidad en paralelo, mientras que solo el 7,4 % había alcanzado una experiencia de observabilidad única y unificada. La configuración de dashboards y alertas fue el principal reto de implantación, con un 54 %.

Esa es la cuestión. Lo difícil no es comprar otra plataforma, sino integrar la telemetría en un flujo de trabajo que produzca diagnósticos accionables en lugar de más pestañas. La complejidad de integración y la configuración de los pipelines de datos frenan a los equipos, porque cada señal adicional genera trabajo para ingenieros, operadores y analistas.
Regla operativa: instrumente el menor número de datasets al nivel más profundo y mantenga el resto con monitorización explícita. Una cobertura indiscriminada suele generar fatiga de alertas y responsabilidades difusas.
Por eso la madurez de la observabilidad es un problema de flujo de trabajo antes que de herramientas. Si nadie es responsable del monitor, la alerta se convierte en ruido. Si nadie sabe explicar la señal, los datos se vuelven decorativos. Ajuste la profundidad de la cobertura a la criticidad, no al optimismo.
Para una implantación práctica, las herramientas de data observability de digna encajan con el modelo de profundidad selectiva. El stack adecuado es el que su equipo puede operar.
Un modelo operativo híbrido e implicaciones por sector
El modelo defendible es híbrido. La monitorización se encarga de los objetivos de control, la evidencia de auditoría y las expectativas estables de nivel de servicio. La observabilidad se encarga del diagnóstico exploratorio, la definición de líneas base y los fallos emergentes. No es un compromiso, es disciplina.
Esto importa sobre todo en entornos regulados o de gran alcance. En los servicios financieros se necesitan comprobaciones explícitas para los datos financieros, de riesgo, regulatorios y transaccionales, porque la evidencia tiene que sostenerse ante auditores y equipos de operaciones. En el sector sanitario, la fiabilidad y la trazabilidad son clave porque los datos clínicos y operativos no pueden desviarse sin que nadie lo note. En las telecomunicaciones, el comportamiento de gran volumen cambia rápido, por lo que se necesita una monitorización sólida y la observabilidad suficiente para explicar picos, problemas de entrega y consumo de la plataforma. En el sector público, la evidencia lista para auditoría y la coherencia importan más que una cobertura vistosa.
Una política operativa sencilla
Monitorice lo que no puede fallar sin aviso. Utilice controles explícitos para cargas ausentes, datos desactualizados, cambios de esquema e infracciones de reglas de negocio.
Observe lo que no puede predecir. Añada telemetría más profunda donde la ruta del fallo sea ambigua, distribuida o costosa de desentrañar.
Reevalúe cada carga de trabajo. Si los datos cambian más rápido que sus umbrales, traslade una mayor parte de esa carga a la observabilidad.
El peor error es suponer que una disciplina es la versión madura de la otra. Son socias con funciones distintas. La monitorización mantiene las luces encendidas. La observabilidad explica por qué parpadearon.
Para los equipos de datos empresariales, esa es toda la decisión. Asigne cada carga de trabajo a la disciplina que se corresponda con su coste de fallo, su carga de cumplimiento normativo y su madurez de telemetría, y revise el reparto a medida que evolucione su stack. Si busca una plataforma construida exactamente en torno a esa lógica, visite digna y descubra cómo gestiona las anomalías de datos, la puntualidad, los cambios de esquema, la validación y la ejecución dentro de la base de datos en su propio entorno.
Aplicar ese reparto híbrido es más sencillo cuando los controles explícitos y la evidencia de diagnóstico están en el mismo lugar que los datos. La observabilidad de plataformas de datos de digna ejecuta la detección de anomalías, la validación, el control de puntualidad y el seguimiento de esquemas dentro de su propia base de datos, de modo que cada carga de trabajo obtiene la profundidad que necesita sin copiar registros en otra herramienta más.
Preguntas frecuentes
¿Cuál es la diferencia entre observabilidad y monitorización?
La monitorización detecta estados de fallo conocidos mediante umbrales y alertas predefinidos, mientras que la observabilidad explica fallos desconocidos o multifactoriales correlacionando métricas, logs y trazas. La monitorización es la capa de control y la observabilidad la capa de diagnóstico, por eso la mayoría de los equipos de datos necesitan ambas en lugar de sustituir una por otra.
¿Debe la observabilidad sustituir a la monitorización?
No. Cambiar monitores explícitos por una observabilidad amplia vuelve implícitos los controles y los hace más difíciles de auditar, un mal intercambio para una plataforma de datos. Conviene mantener monitores explícitos para modos de fallo conocidos, como cargas ausentes, esquemas rotos y deriva de KPI, y añadir observabilidad solo donde se necesite profundidad de causa raíz o correlación.
¿Cuáles son las cuatro señales doradas de la monitorización?
El libro Site Reliability Engineering de Google las define como latencia, tráfico, errores y saturación. En una plataforma de datos equivalen a frescura y puntualidad de entrega, patrones de carga y consumo, jobs fallidos o registros no válidos, y presión sobre el warehouse, el clúster o el pipeline, además de estabilidad del esquema y comportamiento de las métricas de negocio.
¿Cuánto cuesta la observabilidad frente a la monitorización?
La observabilidad es más amplia y bastante más cara. En la encuesta de Grafana Labs de 2025 con 1.255 participantes, el gasto en observabilidad promedió el 17 % del gasto total en infraestructura de cómputo, y la complejidad fue la principal preocupación. La monitorización es más acotada y barata, así que lo práctico es usar el stack más económico que aún ofrezca un diagnóstico defendible.
¿Cuándo conviene usar detección de anomalías con IA en lugar de umbrales fijos?
La detección de anomalías con IA compensa cuando el comportamiento de los datos se mueve, por ejemplo con ingresos volátiles, consumo errático, ruido de sensores o eventos generados por máquinas, donde los límites fijos se vuelven instrumentos toscos. Encaja mal en tablas de referencia estáticas, claves deterministas y feeds de cumplimiento append-only, que necesitan comprobaciones basadas en reglas y responsables claros.


