Referenzielle Integrität in Gesundheitsdaten: Dosen ohne Produkt
|
6
min. Lesezeit

In den Krankenhaus-Demodaten von digna verabreichte das Pflegepersonal einer Krankenhausgruppe am 22. April 2026 82 Dosen eines neuen Medikaments. Der Apothekenbericht für diesen Tag zeigte null. Nichts schlug fehl. Die Dosen waren erfasst, aber das Produkt stand noch nicht im Produktstamm der Apotheke, also verwarf jeder Bericht, der Dosen mit Produkten verknüpfte, diese Zeilen. Referenzielle Integrität in Gesundheitsdaten bedeutet, dass jeder Datensatz, der auf einen anderen verweist – etwa eine Dosis auf ein Produkt, ein Laborbefund auf einen Auftrag oder ein Fall auf einen Patienten –, auf eine Zeile zeigt, die tatsächlich existiert.
Dieser Beitrag folgt diesem Fall: wie die Lücke entstand, wie eine Prüfung der referenziellen Integrität in digna sie aufdeckte und was das Team daraufhin tat. Danach weitet er den Blick auf die Beziehungen in Krankenhaus- und Kostenträgerdaten, die dieselbe Prüfung verdienen.
Das allgemeine Konzept verwaister Datensätze behandelt der Grundlagenartikel Finden Ihre Daten noch ihre Eltern? Referenzielle Integrität verstehen. Dieser Beitrag bleibt im Krankenhaus.
Das Wichtigste in Kürze
Eine verwaiste Dosis ist nicht falsch, sondern unsichtbar: Der Inner Join entfernt sie, sodass Berichte zu niedrige Zahlen liefern, ohne einen Fehler auszulösen.
In der Demo der Danubia Kliniken verwiesen am 22. April 82 von 4.326 Medikamentenverabreichungen auf ein Produkt, das im Produktstamm der Apotheke fehlte.
Eine Regel für referenzielle Integrität in digna Data Validation besteht aus wenigen Feldern, ohne SQL, und liefert die fehlgeschlagenen Datensätze mit Krankenhaus, Station und Produktcode.
Die Korrektur liegt meist in den Stammdaten: Produkt anlegen, Inspektion erneut ausführen, und der Bericht korrigiert sich von selbst.
Die Prüfungen laufen in der eigenen Datenbank des Krankenhauses. Patientendaten verlassen nie dessen Infrastruktur.
Inhaltsverzeichnis
Was geschah am 22. April bei den Danubia Kliniken?
Warum schlug technisch nichts fehl?
Wie hat digna das fehlende Produkt entdeckt?
Was macht das Team als Nächstes?
Welche referenziellen Beziehungen zählen in Krankenhaus- und Kostenträgerdaten?
Warum bricht die referenzielle Integrität im Gesundheitswesen so oft?
Wo laufen die Prüfungen, und verlassen Patientendaten das Krankenhaus?
Wie fangen Sie an?
Was geschah am 22. April bei den Danubia Kliniken?
Ein neues Produkt, Coavira 2.5 mg mit dem Produktcode 3858646, erreichte die Stationen, bevor es den Produktstamm der Apotheke erreichte. Das Pflegepersonal dokumentierte am 22. April 2026 82 Verabreichungen. Da der Stamm keine passende Zeile enthielt, zählte jeder Bericht, der Verabreichungen mit Produkten verknüpfte, null Dosen Coavira, während die Verabreichungsdaten 82 zeigten.
Die Danubia Kliniken sind eine fiktive österreichische Krankenhausgruppe, und alle Zahlen in diesem Beitrag stammen aus den Demodaten von digna. Die Screenshots sind echte digna-Ansichten.
Der Ablauf ist alltäglich. Ein Produkt wird bestellt, geliefert und verabreicht. Der Stammsatz, der es benennt und bepreist, wird von einem anderen Team nach einem anderen Zeitplan gepflegt. In der Demo wird die Verabreichungstabelle hospital_medication_administrations aus den Stationssystemen geladen, und den Produktstamm hospital_medications pflegt die Apotheke. Einen Tag oder eine Woche lang stimmen die beiden nicht überein.
Wem fällt das auf? Meist nicht dem Datenteam. Eine Stationsleiterin vergleicht einen Verbrauchsbericht mit dem, was nachweislich verabreicht wurde, oder eine Apothekerin sieht den Bestand sinken, ohne dass ein passender Verbrauch erscheint. Bis dahin sind die falschen Zahlen schon tagelang im Umlauf.
Warum schlug technisch nichts fehl?
Nichts schlug fehl, weil kein einzelner Ladevorgang falsch war. Die Verabreichungen wurden geladen, der Stamm wurde geladen, und die Berichtsabfrage lief. Der Fehler liegt in der Beziehung zwischen zwei Tabellen, und ein Inner Join löst eine gebrochene Beziehung auf, indem er die Zeile stillschweigend entfernt, statt einen Fehler auszulösen.
Eine vereinfachte Version des täglichen Verbrauchsberichts sieht so aus:
Coavira 2.5 mg erscheint im Ergebnis überhaupt nicht. Ein darauf gefiltertes Dashboard zeigt 0. Die 82 Zeilen stehen weiterhin in der Verabreichungstabelle, aber keine Abfrage, die über den Stamm geht, wird sie je sehen.
Datenbank-Constraints fangen das selten ab. Klinische Quellsysteme setzen ihre eigenen Schlüssel womöglich durch, doch in einem Krankenhaus-Data-Warehouse stammen der eMAR-Extrakt und der Apothekenstamm meist aus verschiedenen Systemen, und deklarierte Fremdschlüssel werden oft nicht übernommen oder nicht durchgesetzt. Die Prüfung muss also auf den Daten laufen, sobald sie ankommen. Die verwaisten Datensätze von Hand zu finden, ist eine einzige Abfrage:
Die Abfrage ist einfach. Schwierig ist, sie für jede Beziehung bei jedem Ladevorgang auszuführen und das Ergebnis zu sehen, bevor der Bericht verschickt wird. Der Schwesterbeitrag „Verwaiste Datensätze: mit SQL finden und fernhalten“ behandelt die SQL-Muster, einschließlich zusammengesetzter Schlüssel und NULL-Behandlung, ausführlicher.
Wie hat digna das fehlende Produkt entdeckt?
Eine Regel für referenzielle Integrität auf der Datenquelle der Verabreichungen prüfte bei jeder Inspektion jeden product_code gegen den Produktstamm der Apotheke. Am 22. April bestanden 4.244 von 4.326 Zeilen und 82 schlugen fehl, sodass der Status der Regel im Dashboard auf Failed sprang – und die fehlgeschlagenen Dosen nur einen Klick entfernt waren.
Die Regel
Die Regel gehört zu digna Data Validation, das drei Arten von Regeln kennt: Rule, Uniqueness und Referential Integrity. Die Einrichtung dieser Regel umfasste sechs Schritte:
Wählen Sie in Configuration die Datenquelle
hospital_medication_administrations, öffnen Sie den Tab Data Validation und klicken Sie auf Add Rule. Der Dialog Add Data Validation Rule öffnet sich.Geben Sie Name und Description (Beschreibung) ein:
hc_product_in_master, „Jedes verabreichte Produkt existiert im Produktstamm der Apotheke“.Setzen Sie Type auf Referential Integrity.
Wählen Sie unter Attributes die Spalte
product_codedieser Datenquelle.Wählen Sie unter must exist in die Data Source
hospital_medicationsund deren Attributesproduct_code.Setzen Sie Threshold Mode (Schwellenwertmodus) auf Absolute, Info threshold auf 0 und Warn threshold auf 1, sodass bereits eine einzige verwaiste Dosis den Status Uncertain auslöst und zwei oder mehr die Prüfung fehlschlagen lassen. Speichern.

Die Regel: product_code der Verabreichungen muss in hospital_medications.product_code existieren.
Kein SQL zu schreiben. Ab diesem Zeitpunkt läuft die Regel bei jeder Inspektion der Datenquelle mit, ob geplant oder auf Abruf. Das Video Referenzielle Integrität in digna: in unter einer Minute eingerichtet zeigt dieselbe Einrichtung in Echtzeit, und der Beitrag zur Einrichtung einer Prüfung der referenziellen Integrität geht jedes Feld durch, einschließlich zusammengesetzter Schlüssel.
Das Ergebnis
Die Inspektion für den 22. April bewertete 4.326 Verabreichungen. 4.244 fanden ihr Produkt im Stamm, 82 nicht. Bei einem Warn threshold von 1 bedeutet das den Status Failed im Dashboard, neben den anderen Prüfungen des Tages.
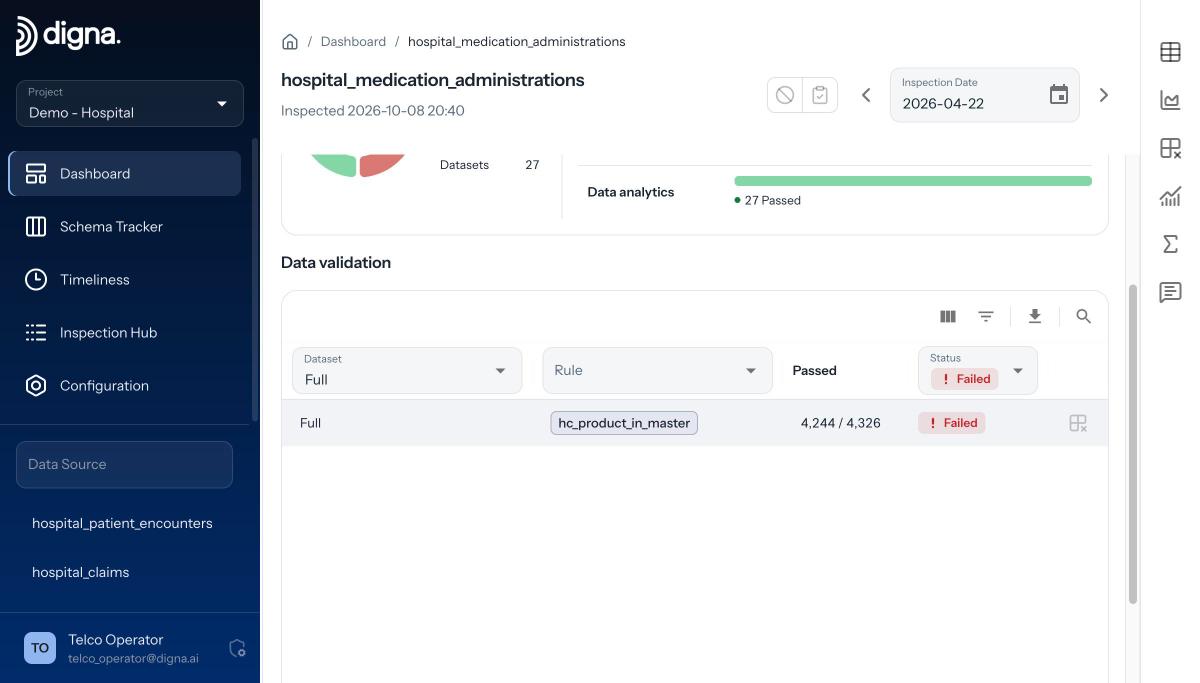
Das Dashboard am 22. April: hc_product_in_master, 4.244 von 4.326 bestanden, Status Failed.
Eine Anzahl reicht, um zu wissen, dass etwas nicht stimmt. Sie reicht nicht, um zu wissen, was zu tun ist. Dafür brauchen Sie die Zeilen.
Die fehlgeschlagenen Datensätze
digna liefert die fehlgeschlagenen Datensätze selbst: dieselbe Prüfung mit negierter Bestehensbedingung, ausgeführt in der Quelldatenbank. Filtern Sie in der Ansicht Invalid Records nach Failed und wählen Sie die Prüfung Full - hc_product_in_master. Jede Zeile ist eine Dosis, die ins Leere zeigt, mit Krankenhaus, Station, Abteilung, product_code 3858646 und medication_name Coavira 2.5 mg.

Invalid Records: jede fehlgeschlagene Dosis mit Krankenhaus, Station, Abteilung und Produktcode.
Diese Liste beantwortet die Fragen, die sonst eine Woche lang per E-Mail hin und her gehen: welches Produkt, welche Stationen, wie viele Dosen. Sie lässt sich für diejenigen exportieren, die für die Korrektur zuständig sind.
Was macht das Team als Nächstes?
Das Team korrigiert die Stammdaten, nicht die Dosen. Die Verabreichungen sind korrekt: Das Pflegepersonal hat Coavira 2.5 mg verabreicht und dokumentiert. Gefehlt hat die Produktzeile, die Abhilfe besteht also darin, sie im Produktstamm der Apotheke anzulegen, die Inspektion erneut auszuführen und die Berichte die Dosen übernehmen zu lassen.
Die fehlgeschlagenen Datensätze lesen und das Muster bestätigen. Derselbe Produktcode 3858646 in jeder fehlgeschlagenen Zeile deutet auf einen fehlenden Stammeintrag hin, nicht auf einen Tippfehler in einem Stationssystem.
Das Team benachrichtigen, dem der Produktstamm gehört – hier die Apotheke – und die exportierten Datensätze anhängen.
Die Apotheke legt Coavira 2.5 mg in
hospital_medicationsan.Die Inspektion der Datenquelle der Verabreichungen auf Abruf erneut ausführen. Sobald jeder Produktcode aufgelöst wird, besteht die Regel wieder, und die Dosen erscheinen in den Berichten.
Den Verbrauchsbericht aktualisieren. Die 82 Dosen erscheinen, den richtigen Krankenhäusern und Stationen zugeordnet.
Hätten die fehlgeschlagenen Datensätze Dutzende verschiedener Codes auf einer einzigen Station gezeigt, wäre die Ursache eine andere gewesen, vielleicht ein Mapping-Problem in einer Schnittstelle, und damit auch die Zuständigkeit. Die Datensätze zeigen Ihnen, welcher Fall vorliegt. Das ist der Hauptgrund, sich Zeilen statt Zählwerte anzusehen.
Teams, die eine kurze Verzögerung zwischen erster Verwendung und Stammeintrag akzeptieren, können die Schwellenwerte erhöhen oder den Threshold Mode auf Relative umstellen. Bei Medikationsdaten hält Danubia sie streng.
Welche referenziellen Beziehungen zählen in Krankenhaus- und Kostenträgerdaten?
Prüfenswert sind die Beziehungen, von denen Berichte und Abrechnung abhängen: Dosen zu Produkten, Fälle zu Patienten, Laborbefunde zu Aufträgen und Fällen, Bettenbelegung zu Stationen sowie Abrechnungsfälle zu Kostenträgern und Versicherungsverträgen. Jede dieser Beziehungen entfernt Zeilen aus einem Join, ohne Fehler, wenn sie bricht, und jede hat einen anderen Verantwortlichen.
Kind-Datensatz | Muss existieren in | Was bricht, wenn er verwaist ist |
|---|---|---|
Medikamentenverabreichung (Dosis) | Produktstamm der Apotheke | Verbrauchs-, Bestands- und Kostenberichte zählen zu wenig; ein neues Produkt wirkt ungenutzt |
Apothekenbestellung | Produktstamm; Station | Bestellungen lassen sich weder nach Produkt gruppieren noch einer Kostenstelle belasten |
Patientenfall | Patientenstamm | Fallzahlen und Wiederaufnahmeanalysen verlieren Aufenthalte; patientenbezogene Sichten sind unvollständig |
Laborbefund | Laborauftrag; Fall | Befunde lassen sich weder der anfordernden Abteilung noch dem Aufenthalt zuordnen; Berichte zu Durchlaufzeiten erfassen sie nicht |
Bettenbelegung | Station (Krankenhaus + Stationscode) | Die Belegung pro Station und Abteilung wird zu niedrig ausgewiesen; Kapazitäts-Dashboards sind falsch |
Abrechnungsfall | Kostenträger; Versicherungsvertrag | Abrechnungsfälle lassen sich keinem Kostenträger zuordnen; Forderungen und Abstimmung pro Kostenträger stimmen nicht |
Abrechnungsposition | Fall | Abgerechnete Leistungen ohne passenden Aufenthalt; Rückfragen des Kostenträgers, die niemand schnell beantworten kann |
Zwei Details sind in Krankenhausdaten wichtig. Erstens zusammengesetzte Schlüssel: Ein Stationscode ist oft nur innerhalb eines Krankenhauses eindeutig, die Bettenbelegung sollte also auf Krankenhaus und Station gemeinsam geprüft werden. In digna wählen Sie auf beiden Seiten mehrere Spalten in derselben Reihenfolge, und geprüft wird die Kombination. Zweitens NULL-Werte: Referenzprüfungen überspringen leere Fremdschlüssel, eine Dosis ganz ohne Produktcode schlägt also nicht fehl. Wenn jede Verabreichung einen Produktcode tragen muss, ergänzen Sie eine separate Regel vom Typ Rule, product_code IS NOT NULL.
Referenzielle Integrität ist eine Ebene der Validierung klinischer Daten. Wertebereiche, Plausibilitätsprüfungen und Kodierregeln sind eine weitere; Validierung von Gesundheitsdaten: klinische und regulatorische Regeln im großen Maßstab behandelt diese.
Warum bricht die referenzielle Integrität im Gesundheitswesen so oft?
Die referenzielle Integrität bricht im Gesundheitswesen oft, weil Eltern- und Kind-Datensätze verschiedenen Abteilungen gehören, in verschiedenen Systemen liegen und nach verschiedenen Zeitplänen geladen werden. Die Apotheke pflegt die Produkte, die Patientenaufnahme die Patienten, das Laborsystem hält die Aufträge, die Haustechnik verwaltet die Stationen und die Finanzabteilung die Kostenträger. Jede Seite ist für sich korrekt; für die Joins dazwischen ist niemand zuständig.
Stammdaten haben viele Verantwortliche. Ein Produkt, eine Station oder ein Kostenträger wird von der Abteilung angelegt, die sich darum kümmert, über deren eigenen Prozess. Die Systeme, die darauf verweisen, erfahren erst später davon.
Systeme laden nach unterschiedlichen Zeitplänen. Die Stationsdokumentation kommt womöglich mehrmals am Tag, während ein Stamm nächtlich oder nach einem Änderungsantrag aktualisiert wird. Jede Lücke zwischen beiden erzeugt verwaiste Datensätze, auch wenn beide Seiten am Ende korrekt sind.
Codes ändern sich. Produkte werden ersetzt, Stationen zusammengelegt oder umbenannt, Kostenträger ändern ihre Codes, Laborkataloge werden überarbeitet. Historische Datensätze tragen weiterhin die alten Codes, und ein Stamm, der nur aktuelle Codes führt, macht sie zu Waisen.
Standorte werden zusammengeführt. Wenn eine Krankenhausgruppe neue Standorte in ein gemeinsames Reporting aufnimmt, treffen Codelisten, die nie füreinander gedacht waren, im selben Join aufeinander.
Der Eltern-Datensatz liegt in einer anderen Datenbank. Der Produktstamm sitzt vielleicht im Apothekensystem und die Verabreichungen im klinischen Data Warehouse. Seit Release 2026.01 prüft digna die referenzielle Integrität über verschiedene Datenbankverbindungen im selben Projekt hinweg, ohne eine der beiden Tabellen zu replizieren.
Nichts davon deutet auf ein schlecht geführtes Krankenhaus hin. Es ist der Normalzustand eines Krankenhaus-Data-Warehouse, das aus vielen Systemen gespeist wird. Der Unterschied liegt darin, ob Sie die Lücke an dem Tag finden, an dem sie entsteht, oder in der Woche, in der sich jemand beschwert.
Wo laufen die Prüfungen, und verlassen Patientendaten das Krankenhaus?
Die Prüfungen laufen in der eigenen Datenbank des Krankenhauses, und Patientendaten verlassen nie dessen Infrastruktur. digna läuft on-premises oder in der Private Cloud des Krankenhauses. Es sendet SQL an die Quelle, erhält Zählwerte und ruft die fehlgeschlagenen Zeilen nur ab, wenn Sie danach fragen. Keine Tabelle wird hinauskopiert, und das digna-Team sieht Ihre Daten nie.
Bei klinischen Daten ist das eine Voraussetzung, kein Detail. Medikations-, Labor- und Falldaten bleiben dort, wo Ihre Sicherheits- und Datenschutzteams sie bereits verwalten.
Seit Release 2026.06 können Regeln auch als Code vorliegen: Das Python SDK (pip install digna-sdk) verwaltet Projekte, Inspektionen und Regeln aus CI/CD heraus, und Validierungsregeln lassen sich aus der Testumgebung exportieren und in die Produktion importieren.
Wie fangen Sie an?
Wählen Sie die eine Beziehung, deren Ausfall am meisten schmerzen würde, meist Dosen zu Produkten oder Abrechnungsfälle zu Kostenträgern, und legen Sie dafür eine Regel für referenzielle Integrität an. Das sind nur wenige Felder. Dann folgt die nächste. Nach einigen Inspektionen wissen Sie, welchen Ihrer Joins Sie vertrauen können und welche unbemerkt Zeilen verlieren.
Wenn Sie die Prüfungen der Danubia Kliniken in Aktion sehen und über Ihre eigenen Krankenhaus- oder Kostenträgerdaten sprechen möchten, buchen Sie eine Demo mit dem digna-Team.
Häufig gestellte Fragen
Was ist referenzielle Integrität in Gesundheitsdaten?
Sie bedeutet, dass jeder Datensatz, der auf einen anderen verweist, auf eine existierende Zeile zeigt: eine Dosis auf ein Produkt im Apothekenstamm, ein Laborbefund auf seinen Auftrag, ein Fall auf einen Patienten. Fehlt der Eltern-Datensatz, verwerfen Joins die Kind-Zeile, und Berichte zählen zu wenig, ohne dass ein Fehler auftritt.
Warum verschwinden Medikamentendosen aus Krankenhausberichten?
Meist, weil das Produkt im Produktstamm der Apotheke fehlt. Berichte verknüpfen Verabreichungen mit Produkten, und ein Inner Join entfernt Dosen ohne passendes Produkt stillschweigend. In der Demo der Danubia Kliniken erschienen 82 Dosen eines neuen Produkts in jedem Bericht, der über den Stamm lief, als null.
Wie prüft man eMAR-Daten gegen den Produktstamm der Apotheke?
Legen Sie in digna Data Validation auf der Datenquelle der Verabreichungen eine Referential-Integrity-Regel an: Wählen Sie product_code als Attribut und unter must exist in den Produktstamm und dessen product_code. Jede Inspektion meldet bestandene und fehlgeschlagene Zeilen und listet jede verwaiste Dosis auf.
Verlassen Patientendaten das Krankenhaus, wenn digna diese Prüfungen ausführt?
Nein. digna läuft on-premises oder in der Private Cloud des Krankenhauses, und jede Prüfung wird in der Quelldatenbank ausgeführt. digna sendet SQL und erhält Zählwerte, dazu die fehlgeschlagenen Zeilen, wenn Sie sie öffnen. Keine Tabelle wird hinauskopiert, und das digna-Team sieht Ihre Daten nie.
Welche Tabellen in einem Krankenhaus-Data-Warehouse brauchen Prüfungen der referenziellen Integrität?
Beginnen Sie mit den Joins, auf die sich Berichte und Abrechnung stützen: Medikamentenverabreichungen zum Produktstamm, Fälle zu Patienten, Laborbefunde zu Aufträgen und Fällen, Bettenbelegung zu Stationen über Krankenhaus und Stationscode sowie Abrechnungsfälle zu Kostenträgern und Versicherungsverträgen. Jede Beziehung hat einen anderen Verantwortlichen, der zu benachrichtigen ist.


