Was ist ein Remediation-Plan?
|
6
min. Lesezeit

Sie starren auf ein Dashboard, das falsch aussieht, und der Zeitpunkt könnte kaum schlechter sein. Vielleicht stimmt eine Umsatztabelle nach einer Quelländerung nicht mehr, ein regulatorischer Feed kam zu spät, oder ein Modell-Score ist so weit abgedriftet, dass der Fachverantwortliche das Vertrauen verliert. In diesem Moment geht es nicht nur darum, was kaputt ist, sondern darum, welche Reaktion standhält, wenn jemand fragt, ob das Problem behoben, eingedämmt und voraussichtlich nicht wiederkehrend ist.
Ein schneller Rerun oder Patch bringt das Rauschen für heute zum Schweigen. Ein Remediation-Plan macht aus dieser Reaktion einen kontrollierten Prozess mit einem Verantwortlichen, Nachweisen und einem klaren Maßstab für den Abschluss. Wenn bei Ihnen schon einmal ein Ticket als erledigt markiert wurde, während der nachgelagerte Bericht weiterhin verdächtig aussah, liegt dieses Thema vermutlich schon auf Ihrem Schreibtisch.
Inhaltsverzeichnis
Wenn ein Daten-Incident einen echten Plan erzwingt
Der Montag beginnt mit einer Nachricht in Slack, nicht mit einem ordentlichen Incident-Bericht. Das Finanz-Dashboard ist schon wieder falsch, der Warehouse-Load ist durchgelaufen, und trotzdem lassen sich die Zahlen nicht mit dem Quellsystem abgleichen. Jemand schlägt vor, die Pipeline neu zu starten, jemand anderes will die Transformation patchen, und der Fachverantwortliche möchte einfach, dass sich der Bericht nicht mehr stündlich ändert.
Genau hier scheitern informelle Ticket-Workflows meist. Ein Rerun kann der richtige erste Schritt sein, dämmt aber nur das Symptom ein. Er sagt Ihnen nicht, ob die Ursache eine Schemaänderung, ein fehlerhaftes Mapping, eine fehlende Abhängigkeit oder eine Validierungsregel war, die es nie gegeben hat.
Ein echter Plan beginnt damit, die vorübergehende Reaktion von der dauerhaften Korrektur zu trennen. Er behandelt den Incident als Workflow mit Nachweisen, nicht als einmalige Aufgabe mit einem Statusfeld. Für Teams, die bereits Issue-Seiten wie digna data quality issues pflegen, ist der Wechsel in der Theorie einfach und in der Praxis schwer: Der Eintrag muss sich von „etwas ist fehlgeschlagen“ zu „dieser Fehler ist verstanden, zugewiesen, korrigiert und verifiziert“ entwickeln.
Ein Ticket kann Aktivität festhalten. Ein Remediation-Plan muss ein gesunkenes Risiko belegen.
Diese Unterscheidung ist wichtig, weil Vertrauen auf einem Abschluss beruht, der sich verteidigen lässt. Wird die Pipeline repariert, aber niemand prüft die nachgelagerte Aktualisierung, ist der Plan nicht abgeschlossen, sondern nur leiser geworden. Der Rest des Artikels legt einen strengeren Maßstab an, einen, der zur Arbeitsweise erfahrener Datenteams passt, wenn der Druck real ist.
Die Kerndefinition hinter jedem Remediation-Plan
Ein Remediation-Plan ist eine kontrollierte, evidenzbasierte Abfolge von Maßnahmen, die die Ursache einer erkannten Abweichung beseitigt, den betroffenen Prozess oder die Daten wiederherstellt, ein erneutes Auftreten verhindert und belegt, dass die Korrektur gewirkt hat. Diese Definition ist wichtig, weil sie Sie zwingt, vier verschiedene Fragen zu stellen statt nur einer. Was ist passiert, was war die Ursache, was haben wir geändert, und woher wissen wir, dass es behoben bleibt?
Denken Sie an ein undichtes Rohr. Sie können den Boden wischen, die Verbindung festziehen, die Leitung prüfen und dann eine Zeit lang beobachten, ob weiteres Wasser austritt. Das Wischen ist die Eindämmung, das Festziehen die Korrektur, die Prüfung die Verifizierung und das Beobachten der Abschluss mit Gewissheit. In der Datenarbeit gilt dieselbe Abfolge, wenn ein fehlerhafter Load, eine veraltete Partition oder ein defektes Schema das Reporting beeinträchtigt.

Die vier Phasen, die die Arbeit ehrlich halten
Eindämmung begrenzt weiteren Schaden. Das kann bedeuten, eine beschädigte Tabelle einzufrieren, die Veröffentlichung an BI-Nutzer zu stoppen oder Anwender auf einen letzten bekannten fehlerfreien Snapshot umzuleiten, während das Team untersucht.
Dauerhafte Korrektur beseitigt die zugrunde liegende Ursache. In einer Datenplattform kann das ein SQL-Fix sein, eine Änderung am Quell-Mapping, eine Aktualisierung des Schemavertrags oder eine fehlende Orchestrierungsabhängigkeit.
Verifizierung belegt, dass die Korrektur hält. Hier prüfen Sie Zeilenzahlen, Geschäftsregeln, Schemakompatibilität und nachgelagerte Aktualisierungen, statt darauf zu vertrauen, dass die Änderung allein genügt.
Abschluss erfolgt erst, wenn die Nachweise vorliegen und der Verantwortliche freigibt. Alles davor ist reine administrative Bequemlichkeit.
Die saubere Trennung ist wichtig, weil Remediation weder dasselbe ist wie Incident Response noch wie Routinewartung. Incident Response stoppt die Blutung. Wartung hält Systeme gesund. Remediation liegt dazwischen: Etwas ist bereits fehlgeschlagen, und das Team muss zeigen, dass der Fehler behoben wurde.
Für umfassendere Betriebsmodelle der Datenqualität passt digna data quality management ganz natürlich zu diesem Gedanken, denn das Qualitätsmanagement liefert den Kontext für Erkennung und Kontrolle, während der Remediation-Plan den korrigierenden Workflow abdeckt.
Die Schlüsselelemente eines funktionierenden Plans
Ein Plan zerfällt schnell, wenn er zu vage ist, um ihn umzusetzen. „Tabelle reparieren“ klingt nach Handeln, aber niemand weiß, wem die Aufgabe gehört, was sich geändert hat oder wann die Korrektur als erledigt gilt. Ein funktionierender Plan muss genug Kontext enthalten, damit ein anderer Engineer ihn ohne Rätselraten übernehmen kann.
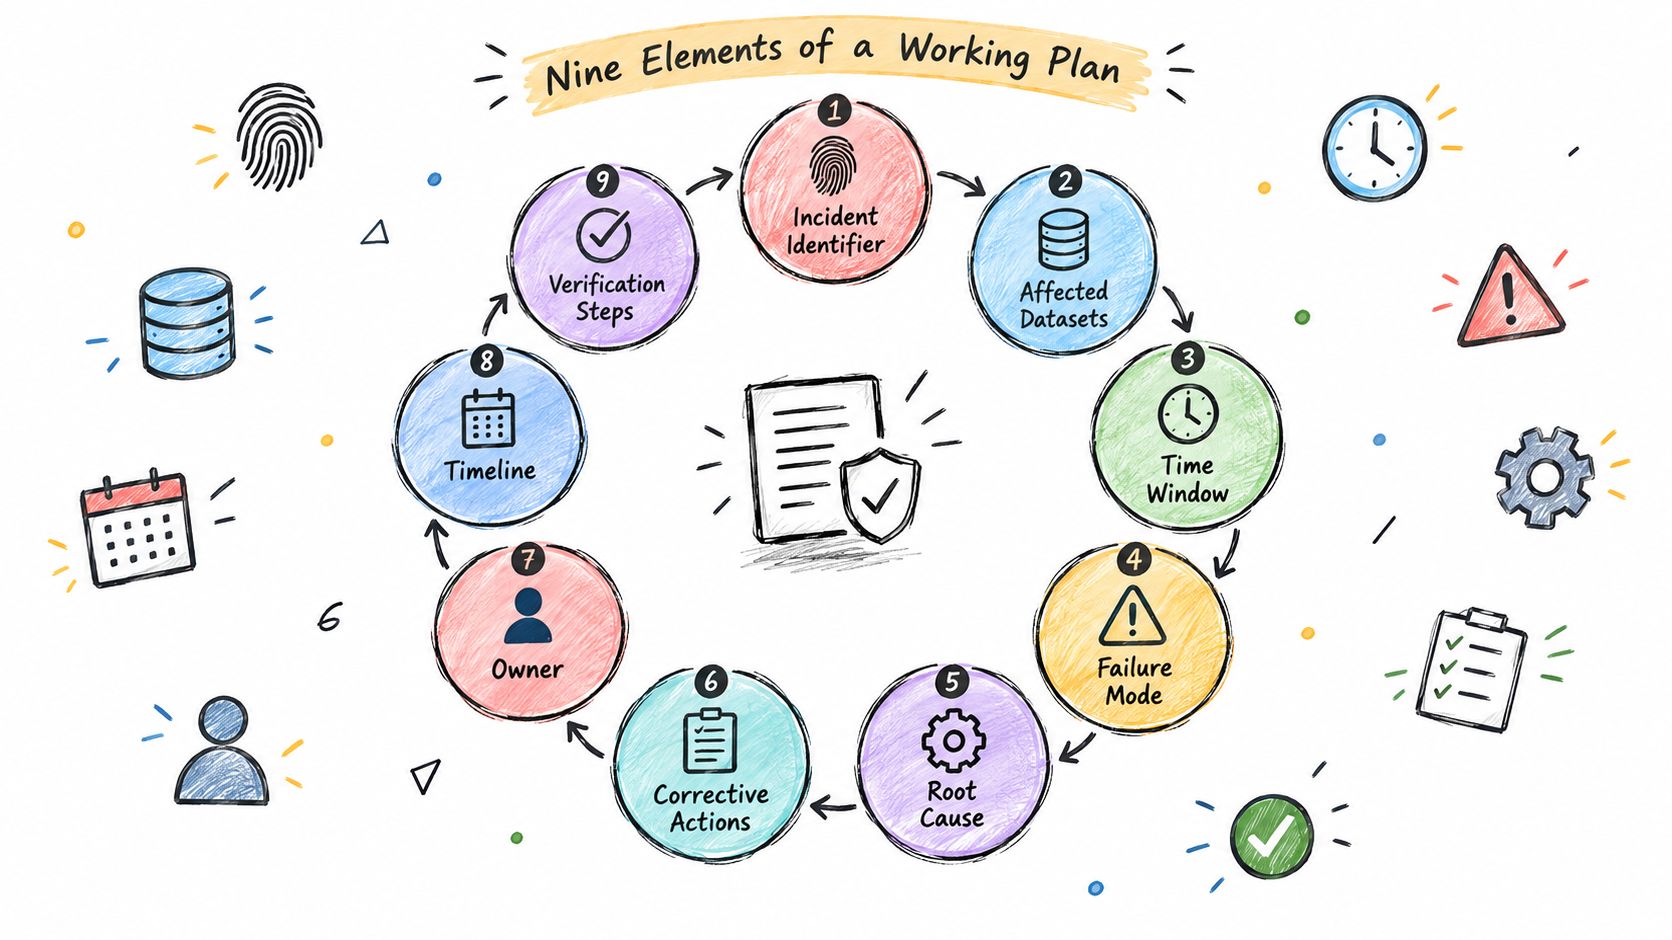
Die Felder, die Mehrdeutigkeit verhindern
Incident-ID. Sie gibt dem Problem eine stabile Referenz, sodass Logs, Chat-Threads und Tickets auf dasselbe Ereignis verweisen.
Betroffene Datensätze und Zeitfenster. Ohne diese Angabe korrigieren Sie die falsche Partition, übersehen eine nachgelagerte Abhängigkeit oder überkorrigieren historische Daten, die gar nicht betroffen waren.
Fehlerbild. Benennen Sie die Art des Problems, etwa verspätete Lieferung, defektes Schema, ungültige Werte oder schleichender Metrik-Drift.
Geschäftliche Auswirkung. Halten Sie fest, worauf sich der Fehler ausgewirkt hat, denn eine fehlerhafte interne Kennzahl und ein verspäteter regulatorischer Feed haben nicht dieselbe Dringlichkeit.
Ursachenhypothese. Dokumentieren Sie, was das Team für die Ursache hält, auch wenn diese Hypothese noch geprüft wird.
Verantwortlicher. Eine verantwortliche Person, keine Warteschlange von Teams.
Priorität. Sie bestimmt die Reihenfolge, wenn mehrere Pläne offen sind.
Abhängigkeiten. Benennen Sie, was zuerst geschehen muss, etwa Korrekturen im Vorsystem, Zugriffsfreigaben oder die Abstimmung eines Backfills.
Rollback-Methode. Wenn die Korrektur die Lage verschlimmert, braucht das Team einen sicheren Weg zurück.
Zieltermin. Fristen machen Zielkonflikte sichtbar.
Abnahmekriterien. Das ist das Tor. Wenn Sie sie nicht definieren können, können Sie den Abschluss nicht belegen.
Praxisregel: Wenn ein Plan nicht sagt, wie Sie den Erfolg verifizieren, ist er noch kein Remediation-Plan, sondern eine To-do-Liste.
Zwei Punkte fehlen in der Praxis häufig, und beide sind teuer. Ein fehlender Verantwortlicher führt zu Verschleppung, weil alle annehmen, dass sich jemand anderes kümmert. Ein fehlendes Abnahmekriterium führt zu Scheinabschlüssen, weil das Ticket geschlossen werden kann, obwohl das Problem in den Daten weiter besteht.
Für einen sauberen Workflow ist digna's data quality issue management process relevant, denn der Plan muss Übergaben überstehen, nicht nur die erste Triage.
Mehrere offene Pläne priorisieren und in Phasen gliedern
Teams haben selten nur eine offene Remediation. Meist sind es mehrere, und einige konkurrieren um dieselben Personen, dasselbe Release-Fenster und dieselbe Aufmerksamkeit der Führungsebene. Nach Ticketalter zu sortieren ist einfach, aber eine schwache Methode, um zu entscheiden, was zuerst behoben wird.
Priorisierungskriterien für konkurrierende Remediation-Pläne | Warum es wichtig ist | Starkes Signal für Dringlichkeit |
|---|---|---|
Geschäftliche Auswirkung | Betrifft Umsatz, Reporting, Kundenvertrauen oder Entscheidungsqualität | Zentrales Management-Reporting ist falsch oder nicht verfügbar |
Regulatorisches Risiko | Erzeugt Audit-, Compliance- oder Meldungsrisiken | Ein vorgeschriebener Feed oder eine Kontrolle ist verspätet oder unzuverlässig |
Kritikalität der Daten | Manche Datensätze versorgen viele nachgelagerte Nutzer | Breit wiederverwendete Quelldaten sind betroffen |
Wiederholungswahrscheinlichkeit | Eine Korrektur, die nicht hält, erzeugt wiederkehrende Incidents | Derselbe Fehler taucht immer wieder auf |
Anzahl der Abhängigkeiten | Mehr Abhängigkeiten bedeuten meist einen größeren Wirkungsradius | Mehrere Pipelines oder Teams hängen von dem Problem ab |
Zeit bis zum Schaden | Manche Probleme verschlimmern sich schnell | Die Daten werden innerhalb des nächsten Zyklus unbrauchbar |
Warum Phasen zählen, wenn der schnelle Fix nicht reicht
Ein temporärer Patch kann den Betrieb heute wiederherstellen und die Ursache trotzdem unberührt lassen. Deshalb brauchen Eindämmung, dauerhafte Korrektur und Verifizierung eine getrennte Behandlung. Wird ein verspäteter Feed manuell umgeleitet, hat das Team das Geschäft vielleicht am Laufen gehalten, doch die eigentliche Lücke besteht weiter, bis die Automatisierung oder die Quelle im Vorsystem repariert ist.
Schwieriger wird es, wenn sofortige Eindämmung und dauerhafte Korrektur kollidieren. Vielleicht könnten Sie Events schnell erneut einspielen, doch wenn das geschieht, bevor der Schemavertrag korrigiert ist, kann ein zweiter Fehler entstehen. In diesem Fall sagt ein guter Plan Nein zum schnellsten Workaround und Ja zu der Reihenfolge, die das Risiko senkt.
Ein administrativer Abschluss beweist keine Remediation. Das leisten nur validierte Nachweise.
Diese Unterscheidung ist auf Datenplattformen wichtig, weil die Arbeit lange vollständig aussehen kann, bevor das Risiko verschwunden ist. Ein Dashboard aktualisiert sich vielleicht, eine Pipeline schlägt nicht mehr fehl, und ein Ticket wird geschlossen. Wurden die Ergebnisse aber nicht abgeglichen, ist der Plan praktisch noch offen.
Wenn Stakeholder fragen, warum ein Problem vor einem anderen steht, erklären Sie den Zielkonflikt in geschäftlichen Begriffen, nicht mit Ticketzahlen. Priorisieren Sie den Befund, der Ihnen früher schaden, sich weiter ausbreiten oder eine Kontrolle verletzen kann, bevor Sie das kosmetische Problem angehen, das nur unordentlich aussieht.
Zwei Playbooks für typische Datenqualitätsfehler
Ein guter Plan wird in dem Moment real, in dem Sie ihn auf einen tatsächlichen Fehler anwenden können. Die Details variieren, die Abfolge bleibt gleich: erkennen, eindämmen, korrigieren, validieren und dann belegen, dass die Korrektur lange genug gehalten hat, um ihr zu vertrauen.
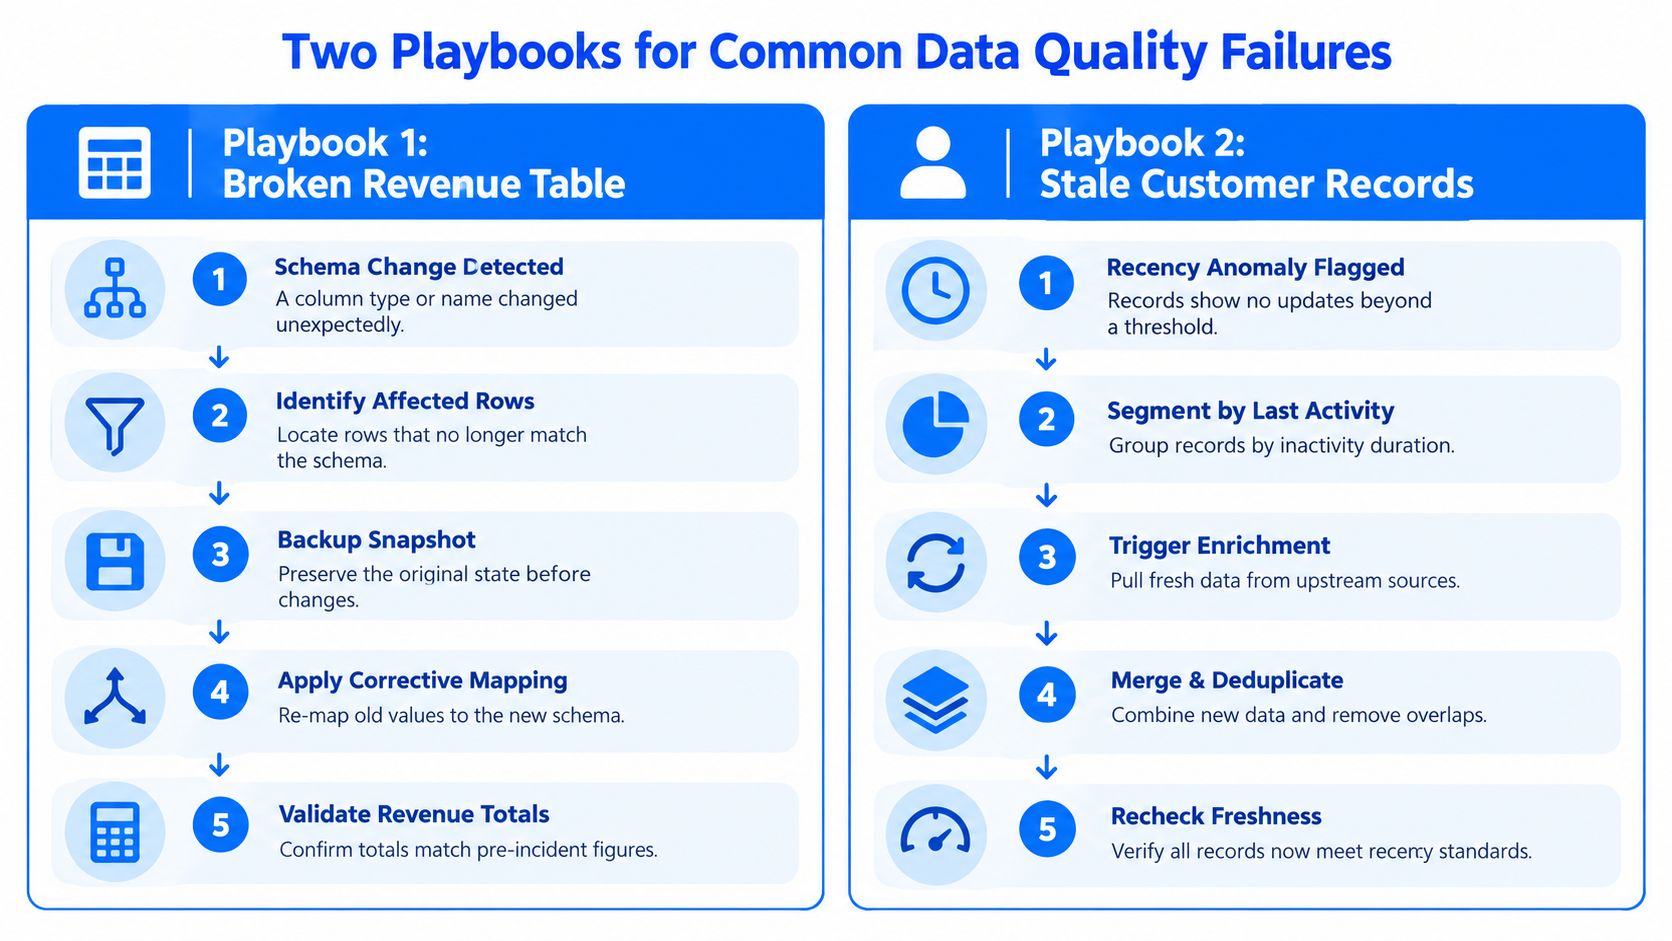
Playbook 1: fehlerhafte Umsatztabelle
Ein Quellsystem ändert über Nacht einen Spaltentyp, und die Umsatztabelle lädt plötzlich unvollständige oder ungültige Werte. Zuerst begrenzt das Team den Wirkungsradius, indem es die nachgelagerte Veröffentlichung stoppt oder die fehlerhafte Partition einfriert. Dann isoliert es die betroffenen Zeilen, sichert den ursprünglichen Zustand und korrigiert das Mapping, damit das neue Schema richtig verarbeitet wird.
Danach folgt die Validierung. Das Team prüft, ob die Umsatzsummen mit der maßgeblichen Quelle übereinstimmen, ob die reparierten Datensätze sauber laden und ob nachgelagerte Aktualisierungen ohne manuelles Eingreifen gelingen. Der Abschluss erfolgt erst, wenn diese Prüfungen bestanden sind und der Verantwortliche freigibt.
digna data completeness checks sind hier relevant, weil eine unvollständige Lieferung oder ein teilweiser Backfill eine Tabelle repariert aussehen lassen kann, obwohl noch Datensätze fehlen.
Playbook 2: veraltete Kundendatensätze
Ein schleichender Verlust an Aktualität bei Kundendaten löst nicht immer einen lauten Fehler aus. Das Modell läuft weiter, doch die Eingangsdaten werden älter und weniger vertrauenswürdig. In diesem Fall wird zuerst die Aktualitätsanomalie markiert, dann werden die betroffenen Datensätze nach Inaktivitätsdauer segmentiert, damit das Team sieht, wie weit das Problem reicht.
Danach stößt der Verantwortliche eine Anreicherung aus den Vorsystemen an, führt die neuen Informationen zusammen und entfernt Duplikate. Der letzte Schritt ist nicht bloß „der Job ist durchgelaufen“, sondern eine erneute Prüfung, die bestätigt, dass die Datensätze den Aktualitätsstandard jetzt erfüllen und das nachgelagerte Modell die korrigierten Eingaben erhält.
Wie Abschlussnachweise aussehen sollten
Fehlerhafte Umsatztabelle: abgeglichene Summen, saubere Backfills, keine kritischen Validierungsfehler und erfolgreiche nachgelagerte Aktualisierungen.
Veraltete Kundendatensätze: wiederhergestellte Aktualität, abgeschlossene Deduplizierung und überwachte Läufe, die zeigen, dass das Problem im nächsten Zyklus nicht zurückgekehrt ist.
Der Unterschied zwischen einem geschlossenen Ticket und einem abgeschlossenen Plan ist einfach. Ein Ticket sagt, dass jemand daran gearbeitet hat. Ein Plan sagt, dass die Ergebnisse wieder verlässlich sind.
Wie digna Nachweise in einen Remediation-Plan einspeist
Ein Remediation-Plan wird deutlich stärker, wenn das Incident-Signal bereits strukturierte Nachweise mitbringt. Das heißt nicht, dass die Plattform das Problem für Sie abschließt, sondern dass der Plan mit besseren Inputs und weniger Rätselraten startet. Der Verantwortliche verbringt weniger Zeit damit, das Geschehene zu rekonstruieren, und mehr Zeit mit der Entscheidung, was zu tun ist.
Welche Inputs wohin gehören
Data Anomalies und Timeliness speisen die frühen Felder des Plans. Sie helfen zu erkennen, was sich wann geändert hat und ob es sich um eine Verzögerung, einen fehlenden Load oder ein ungewöhnliches Muster handelt, das untersucht werden muss.
Schema Tracker stützt die Ursachenhypothese. Wurde eine Spalte hinzugefügt, entfernt oder in ihrem Typ geändert, kann der Plan auf die exakte strukturelle Änderung verweisen, statt aus nachgelagerten Symptomen zu raten.
Data Validation hilft, Abnahmekriterien zu definieren. Muss vor dem Abschluss eine Geschäftsregel auf Datensatzebene erfüllt sein, kann der Plan ausdrücklich auf diese Regel verweisen, statt sich auf einen prüfenden Blick aufs Dashboard zu verlassen.
Business Monitoring und Data Platform Observability machen das Signal überhaupt erst sichtbar. Sie zeigen, ob die Geschäftskennzahl, das Workload-Verhalten oder der Plattformzustand den erwarteten Bereich verlassen hat, was dem Verantwortlichen einen saubereren Ausgangspunkt für den Incident-Eintrag gibt.
Für Teams, die digna data quality observability nutzen, liegt der praktische Wert in der Nachweiskette. Der Plan kann betroffene Datensätze, erwartete Lieferfenster, Schemaänderungen, Validierungsergebnisse und historischen Kontext enthalten, ohne dass dieser Kontext mühsam aus verstreuten Logs rekonstruiert werden muss.
Was sich ändert, wenn die Nachweise vorliegen
Verantwortliche entscheiden schneller, weil das Fehlerbild klarer ist.
Abnahmekriterien werden schärfer, weil sie an Validierung und beobachtetes Verhalten gekoppelt sind.
Eskalation wird sauberer, weil der Plan zeigt, ob das Problem lokal, systemisch oder wiederkehrend ist.
Audit-Prüfungen werden einfacher, weil der Eintrag die Nachweise hinter der Korrektur enthält, nicht nur die ergriffene Maßnahme.
Remediation ist dann kein informeller Workflow mehr, sondern ein prüfbarer. Die Nachweise ersetzen kein Urteilsvermögen, machen das Urteil aber belastbar.
Einen Plan richtig abschließen und häufige Irrtümer
Ein geschlossenes Ticket ist nicht dasselbe wie eine abgeschlossene Remediation. Teams geraten in Schwierigkeiten, wenn sie Handeln als Beweis betrachten, denn Handeln ist nur der Anfang. Die entscheidende Frage ist, ob die Daten, der Prozess und die nachgelagerten Nutzer nach der Korrektur stabil sind.
Was ein echter Abschluss voraussetzt
Ein Plan sollte erst geschlossen werden, wenn die Abnahmekriterien erfüllt, die Nachweise archiviert und die Freigabe des Verantwortlichen dokumentiert sind. War der Incident so ernst, dass eine Eindämmung nötig war, sollte auch ein Monitoring nach dem Abschluss eingerichtet sein. Dieses Monitoring ist das Sicherheitsnetz, das Ihnen sagt, ob der Fehler verschwunden bleibt.
Häufige Irrtümer treten in drei Formen auf. Erstens werden Reruns als Korrekturen behandelt, obwohl sie nur ein Eindämmungsschritt sind. Zweitens gelten Schema-Patches als dauerhafte Korrekturen, auch wenn niemand die nachgelagerte Kompatibilität geprüft hat. Drittens verzichten Teams auf ein Wirksamkeitsmonitoring und nehmen an, dass ausbleibende Alarme bedeuten, das Problem sei verschwunden.
Wenn Sie nicht erklären können, wie die Korrektur verifiziert wurde, haben Sie keinen Abschluss, sondern Optimismus.
Eine bessere Prüfung stellt ein paar kurze Fragen, bevor jemand den Plan als erledigt markiert. Hat die Korrektur die Ursache behoben und nicht nur das Symptom? Haben sich die Daten im betroffenen Zeitfenster erholt? Haben die nachgelagerten Nutzer erfolgreich validiert? Ist das Problem über die folgenden Läufe hinweg ruhig geblieben, nicht nur beim ersten Lauf nach der Änderung?
Dieser Maßstab schützt das Team vor vorschnellen Abschlüssen und gibt der Führung eine bessere Antwort auf die Frage, ob die Arbeit das Risiko gesenkt hat. Außerdem entsteht eine bessere Übergabe zum nächsten Problem, weil das Muster der Nachweise Teil dessen wird, wie die Organisation lernt. Das nächste sinnvolle Thema sind Abnahmekriterien für Datenqualitäts-Incidents, denn genau dort scheitern viele Pläne noch im letzten Schritt.
digna hilft Datenteams, Incidents in evidenzbasierte Remediation-Arbeit zu verwandeln, mit Monitoring, Validierung, Timeliness und Schema-Tracking, die klarere Pläne und sauberere Abschlüsse ermöglichen. Wenn Sie von informeller Ticketbearbeitung zu einem kontrollierten Workflow wechseln möchten, besuchen Sie digna und sehen Sie, wie die Plattform diesen Prozess in Ihrer eigenen Umgebung unterstützt.
Abnahmekriterien sichern einen Abschluss nur dann ab, wenn sie als ausführbare Prüfungen existieren. Wie Sie daraus Regeln machen, die an echten Datensätzen bestehen oder scheitern, lesen Sie im Leitfaden so gestalten Sie Datenvalidierungsregeln.
Häufig gestellte Fragen
Was ist ein Remediation-Plan im Datenqualitätsmanagement?
Ein Remediation-Plan ist eine kontrollierte, evidenzbasierte Abfolge von Maßnahmen, die die Ursache einer erkannten Abweichung beseitigt, die betroffenen Daten oder Prozesse wiederherstellt, ein erneutes Auftreten verhindert und belegt, dass die Korrektur wirkt. Anders als ein Ticket, das nur Aktivität festhält, muss er zeigen, dass das Risiko tatsächlich gesunken ist.
Welche Phasen hat ein Remediation-Plan?
Es gibt vier: Eindämmung, dauerhafte Korrektur, Verifizierung und Abschluss. Die Eindämmung begrenzt den Schaden, etwa durch das Einfrieren einer beschädigten Tabelle. Die Korrektur beseitigt die Ursache, zum Beispiel per SQL- oder Mapping-Fix. Die Verifizierung prüft Zeilenzahlen, Regeln und nachgelagerte Aktualisierungen, der Abschluss folgt erst mit Nachweisen und Freigabe des Verantwortlichen.
Was gehört in einen Remediation-Plan?
Mindestens eine Incident-ID, betroffene Datensätze und Zeitfenster, Fehlerbild, geschäftliche Auswirkung, Ursachenhypothese, ein einzelner Verantwortlicher, Priorität, Abhängigkeiten, eine Rollback-Methode, ein Zieltermin und Abnahmekriterien. Verantwortlicher und Abnahmekriterien fehlen in der Praxis am häufigsten, was zu Verschleppung und Scheinabschlüssen führt.
Wie priorisiert man mehrere offene Remediation-Pläne?
Nach Risiko statt nach Ticketalter. Bewerten Sie geschäftliche Auswirkung, regulatorisches Risiko, Kritikalität der Daten, Wiederholungswahrscheinlichkeit, Anzahl der Abhängigkeiten und Zeit bis zum Schaden. Beheben Sie zuerst das Problem, das früher schadet, weiter streut oder eine Kontrolle verletzt, und erst danach, was nur unordentlich aussieht.
Wann darf ein Remediation-Plan geschlossen werden?
Erst wenn die Abnahmekriterien erfüllt, die Nachweise archiviert und die Freigabe des Verantwortlichen dokumentiert sind. Ein erneuter Lauf ist Eindämmung, keine Korrektur, und fehlende Alarme beweisen für sich genommen nichts. Bei schweren Incidents braucht es daher auch ein Monitoring nach dem Abschluss über mehrere folgende Läufe.


