Datenvalidierungsregeln: Ein praktischer Entwurfsleitfaden
|
5
min. Lesezeit

Sie merken, dass eine Data Pipeline in Schwierigkeiten steckt, wenn das Dashboard technisch gesehen betriebsbereit ist, die Zahlen technisch gesehen vorhanden sind und das Unternehmen trotzdem keiner einzigen Zeile auf dem Bildschirm vertrauen kann. Ein einziger falscher Referenzwert, ein fehlendes Feld oder ein Datensatz, der durch eine zu lockere Prüfung rutscht, reicht aus, um eine Freitagsprüfung in eine Archäologiestunde zu verwandeln. Das ist meistens der Moment, in dem den Verantwortlichen klar wird, dass nicht der Bericht das Problem ist, sondern das Fehlen von Datenvalidierungsregeln, die wie echter Produktionscode entworfen, getestet und unter Governance gestellt wurden.
Die Validierung funktioniert am besten, wenn Sie aufhören, sie wie eine lästige Pflichtaufgabe zu behandeln, und anfangen, sie als Vertrag zu betrachten. Eurostats Formulierung ist unmissverständlich: Wenn eine Wertekombination nicht in der akzeptierten Menge enthalten ist, schlägt sie fehl. Die Regel muss eindeutig definiert und dokumentiert sein, damit Produzenten und Konsumenten das gleiche Verständnis der angewendeten Prüfung teilen. Dies ist eine weitaus sauberere Basis für die Revisionssicherheit und Data Governance als ein vager Best-Effort-Filter (Eurostat-Leitfaden zur Datenvalidierung). Wenn Sie dieselbe Idee in einem praktischen Produktkontext betrachten möchten, macht diese Übersicht zur Datenvalidierung den Lebenszyklus konkreter, ohne die betriebliche Realität zu beschönigen.
Warum Ihre Daten Sie heimlich anlügen
Die schlimmsten Datenfehler kündigen sich selten von selbst an. Ein Bericht wird geladen, das Diagramm wird gerendert, und jeder geht davon aus, dass die Zahlen „schon ungefähr stimmen“ – bis bei einem Meeting eine Ausnahme auftaucht und jemand erklären muss, warum die gestrigen Zahlen nicht mit dem heutigen Export übereinstimmen. Manuelle Stichproben sind für diese Art von Problemen nicht skalierbar, da sich die fehlerhaften Zeilen meist in den normal aussehenden Zeilen verstecken.
Validierung ist ein Pakt, kein Filter
Deshalb ist eine Validierung auf Datensatzebene so wichtig. Sie verwandelt eine vage Erwartung in eine gemeinsame Regel und gibt Entwicklungs- und Businessteams dieselbe Sprache für Fehler. Eurostat definiert Datenvalidierung als die Prüfung, ob eine Kombination von Werten zu einer akzeptierten Menge gehört. Nach den Leitlinien müssen die Regeln klar und eindeutig definiert, dokumentiert und zweckmäßig sein, damit jeder das Ergebnis auf die gleiche Weise interpretieren kann (Eurostat-Leitfaden zur Datenvalidierung).
Eine fehlgeschlagene Validierung sollte Ihnen sagen, welche Geschäftsregel verletzt wurde, und nicht nur, dass die Zeile die Datenbank verärgert hat.
Diese Unterscheidung verändert die Arbeitsweise von Teams. Ein fehlerhafter Datensatz ist nicht mehr nur „schmutzige Daten“, sondern der Beweis dafür, dass eine geschäftliche Einschränkung, eine Schemaannahme oder eine Berichtspflicht verletzt wurde. Dies ist der Kernwert von Datenvalidierungsregeln: Sie schaffen messbare Kontrollpunkte, anstatt Qualität zu einem unverbindlichen Versprechen zu machen.
Der betriebliche Gewinn ist Vorhersehbarkeit. Wenn die Regeln einheitlich dokumentiert und durchgesetzt werden, wissen die Datenproduzenten, was sie senden müssen, und die Konsumenten wissen, welchen Daten sie vertrauen dürfen. Wenn Sie jemals erlebt haben, wie eine Pipeline monatelang „fast reibungslos“ lief, bevor ein versteckter Grenzfall ein Dashboard sprengte, wissen Sie bereits, warum sich diese Disziplin auszahlt.
Die Anatomie von Validierungsregeln auf Datensatzebene
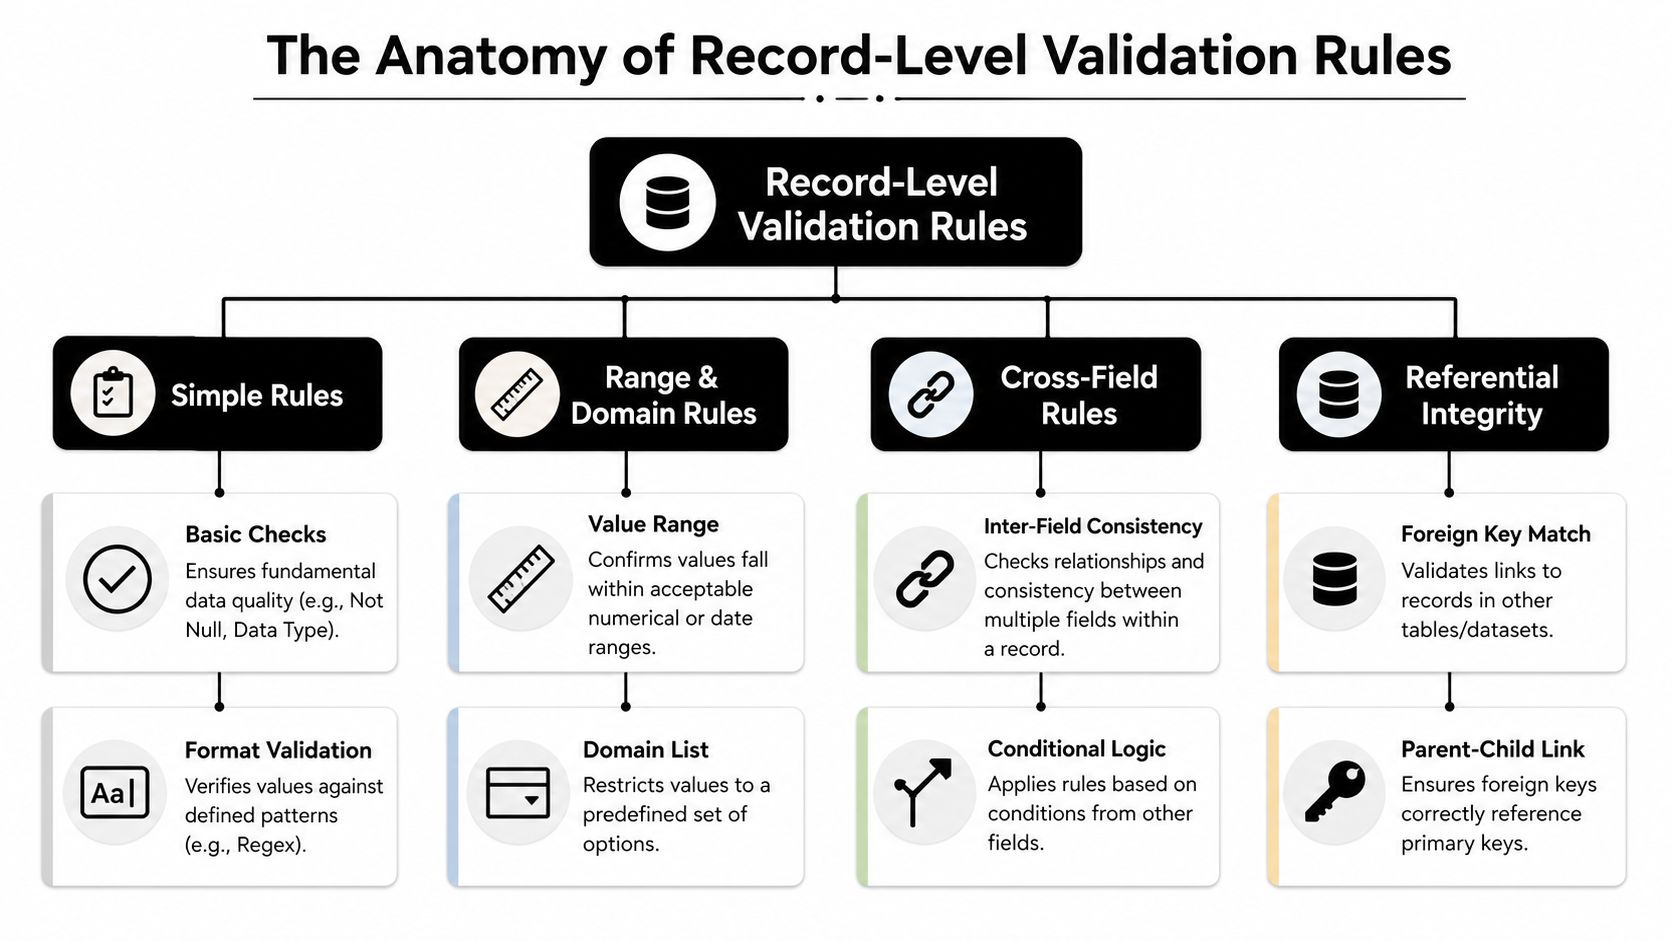
Bevor Sie Code schreiben, benötigen Sie eine Übersicht über die Regelkategorien, die Sie verwenden werden. Der Standard-Workflow unterteilt Prüfungen in Formatvalidierung, Bereichsprüfungen, Schemavalidierung und feldübergreifende Validierung. Dies ist ein nützlicher Ausgangspunkt, da er Sie dazu zwingt, Syntaxprobleme von Problemen der Geschäftslogik zu trennen (Atlans Datenvalidierungs-Workflow). Diese Trennung sorgt dafür, dass Ihr Framework verständlich bleibt, was wichtiger ist, als technisch anspruchsvoll zu klingen.
Beginnen Sie mit den einfachen Prüfungen
Die einfachsten Regeln sind meist die ersten, die Sie implementieren sollten. Null-Werte-Prüfung, Datentyp und Formatvalidierung fangen die Fehler ab, die sich leicht zurückweisen und später nur mühsam beheben lassen. Wenn eine E-Mail nicht dem erwarteten Muster entspricht oder ein Datum im falschen Format ankommt, hat es keinen Wert, diesen Datensatz weiterzuleiten, nur weil der Rest der Zeile in Ordnung aussieht.
Fügen Sie als Nächstes numerische und Domänen-Constraints hinzu
Bei Bereichsprüfungen fängt die Validierung an, sich eher wie eine Geschäftsrichtlinie als wie bloße Feldpflege anzufühlen. Ein Preis sollte positiv sein, ein Rabatt sollte den Preis nicht übersteigen und ein Altersfeld sollte in einem akzeptablen Bereich liegen, wenn die Geschäftsdomäne dies erfordert. Für Arbeitsabläufe in der Tierpflege ist dieselbe Logik nützlich, wenn Sie konforme Aufzeichnungen zur Tiergesundheit sicherstellen, da ein fehlendes oder fehlerhaftes Feld die Verantwortlichkeitskette unterbrechen kann, selbst wenn der Datensatz „geladen“ wird.
Vergessen Sie nicht die Beziehungen zwischen den Feldern
Die feldübergreifende Validierung ist der Bereich, in dem man sich am leichtesten die Finger verbrennt. Ein Lieferland kann nicht isoliert betrachtet werden, wenn ein anderes Feld eine länderspezifische Kennung enthalten soll, und ein Status-Flag ergibt oft nur Sinn, wenn es mit einem passenden Datum oder Code verknüpft ist. Diese Regeln sind schwieriger zu schreiben als Prüfungen für einzelne Felder, aber sie fangen auch die subtilen Widersprüche ab, die andernfalls Berichte intern konsistent erscheinen lassen, obwohl sie falsch sind.
Praktische Regel: Wenn ein Feld nur im Kontext Sinn ergibt, validieren Sie es im Kontext.
Die referenzielle Integrität steht direkt neben der feldübergreifenden Logik, auch wenn sie sich eher datenbankspezifisch als geschäftsspezifisch anfühlt. Ein Fremdschlüssel, der nicht auf eine echte übergeordnete Zeile verweist, ist immer noch ein geschäftlicher Fehler, nicht nur ein Speicherproblem. Aus diesem Grund enthalten domänenspezifische Validierungsregelwerke oft explizite Prüfungen wie positive Preise, keine negativen Beobachtungen und eindeutige Beobachtungen, die alle als maschinell überprüfbare Bedingungen geschrieben sind, damit die automatisierte Qualitätssicherung für Entwickler interpretierbar bleibt (SNStatComp Domain Validation Rules).
Sie können auch eine plattformorientierte Sichtweise dieser Anatomie verwenden, wenn Sie ein breiteres Unternehmensmuster benötigen. Das Modell auf Datensatzebene in dignas Enterprise-Validierungsansatz ist gerade deshalb nützlich, weil es diese Regelkategorien auf die Ausführung innerhalb der Datenbank überträgt, anstatt sie als abstrakte Richtliniennotizen zu belassen.
Von der Logik zum Code
Theorie ist erst dann wichtig, wenn die Regel eine fehlerhafte Bestellung abweisen kann, ohne die Verarbeitung korrekter Bestellungen zu erschweren. Angenommen, Sie validieren einen eingehenden orders-Datensatz mit order_id, customer_id, price, discount, shipping_country und nif. Sie möchten, dass der Code so lesbar ist, dass der nächste Entwickler die Geschäftsregeln nicht erst aus einem Haufen von Nebeneffekten rekonstruieren muss.
Machen Sie die Regel in SQL offensichtlich
Ein sauberer CHECK-Constraint ist nach wie vor der beste erste Ansatz für einfache Feldlogik.
Das liefert Ihnen ein klares Fehlerverhalten für die offensichtlichen Fälle. Zudem bleibt die Regel nah am Datenmodell, was wichtig ist, da eine im Anwendungscode versteckte Validierungsregel leicht in Vergessenheit gerät und schwer zu überprüfen ist.
Nutzen Sie feldübergreifende Logik, wenn eine Spalte von einer anderen abhängt
Einige Regeln gehören nicht in einen einfachen CHECK, da sie bedingtes Verhalten erfordern. In diesem Fall ist ein CASE-Ausdruck oder eine Trigger-Logik übersichtlicher, als zu versuchen, die gesamte Geschäftsregel in ein einziges Prädikat zu quetschen.
Dieses Muster macht die Regel explizit. Wenn das Lieferland Spanien ist, benötigt der Datensatz die erwartete Kennung. Wenn diese fehlt, erhalten Sie direkt ein Fehlersignal anstelle einer kryptischen, nachgelagerten Ausnahme.
Testen Sie Eindeutigkeit und referenzielle Integrität mit Abfragen
Eindeutigkeitsprüfungen sind leichter zu warten, wenn sie als direkte Diagnosen statt als komplexer prozeduraler Code geschrieben werden.
Und die referenzielle Integrität lässt sich genauso direkt prüfen.
Diese Abfragen sind im bestmöglichen Sinne unspektakulär. Sie zeigen Ihnen genau, was fehlgeschlagen ist. Deshalb werden domänenspezifische Validierungsregeln oft als explizite Prüfungen auf Datensatzebene implementiert – wie positive Preise, keine negativen Beobachtungen und eindeutige Beobachtungen –, die alle im großen Stil ausgeführt werden können und für Entwickler interpretierbar bleiben (SNStatComp Domain Validation Rules).
Wenn Sie ein Plattform-Beispiel für diesen Stil sehen möchten, ist dignas Diskussion zur manuellen Regelpflege lesenswert, da die entscheidende Frage nicht ist, ob die Regel existiert, sondern wie sicher sie im Laufe der Zeit gewartet werden kann.
Sorgen Sie für nützliche Fehlermeldungen
Eine schlechte Regel mit einer vagen Meldung erzeugt nur zusätzliche Arbeit. „Validierung fehlgeschlagen“ hilft niemandem, während „shipping_country=ES erfordert nif“ dem Analysten und dem Entwickler denselben Ausgangspunkt für die Fehlerbehebung bietet. In der Praxis ist die Meldung Teil der Regel, nicht nur Verzierung.
Mehr als nur ein Testlauf: Intelligentere Teststrategien
Eine Validierungsregel, die nicht getestet wurde, ist nur eine Theorie mit einem Produktionsbudget. Behandeln Sie sie wie Anwendungscode, denn genau das ist sie, sobald sie Daten blockieren, Alarme auslösen oder Compliance-Workflows füttern kann. Die Kosten von Fehlern sind hier enorm, da eine fehlerhafte Validierungsregel gute Daten abweisen oder – noch schlimmer – fehlerhafte Daten ungeprüft durchwinken kann.
Testen Sie die Regel in Schichten
Ein praktischer Ansatz fängt klein an. Unit-Tests verwenden eine kleine Auswahl kuratierter Datensätze – einige gültig, andere ungültig –, sodass jede Regel isoliert überprüft werden kann. Hier fangen Sie die offensichtlichen Fehler ab: den falschen Schwellenwert, die invertierte Null-Prüfung oder die Regel, die versehentlich legitime Grenzfälle markiert.
Integrationstests gehören in die Pipeline selbst. Sie zeigen Ihnen, wie sich die Regeln verhalten, wenn Bereitstellung, Transformation und Laden im Spiel sind – denn dort verhält sich eine eigentlich saubere Logik oft chaotisch. Regressionstests schützen dann das bestehende Verhalten bei Regeländerungen, damit Sie nicht eine Validierung „reparieren“ und versehentlich drei andere beschädigen.
Trennen Sie Fehler auf Dateiebene von Fehlern auf Datensatzebene
Das nützlichste Betriebsmuster, das ich bisher gesehen habe, ist das im EU-Transaktionsberichterstattungssystem verwendete. Hier weisen Syntaxregeln auf Schemaebene die gesamte Datei ab, während Inhaltsregeln nur die ungültigen Transaktionen zurückweisen. Diese Aufteilung verringert die Auswirkungen von Fehlern und vermeidet unnötige erneute Übermittlungen (ESMA MiFIR transaction reporting validation rules).
Lassen Sie nicht eine ganze Charge unter einer einzigen fehlerhaften Zeile leiden, es sei denn, die Struktur selbst ist beschädigt.
Das Prinzip ist einfach formuliert, wird aber überraschend oft ignoriert. Wenn die Datei fehlerhaft ist, stoppen Sie frühzeitig. Wenn nur eine Transaktion die Geschäftslogik verletzt, isolieren oder markieren Sie den Datensatz und lassen Sie den Rest fortfahren, sofern Ihre Prozesse und Compliance-Anforderungen dies zulassen.
Für die Ursachenanalyse kann dieser Leitfaden zur Analyse von Datenproblemen mit KI Teams dabei helfen, von „irgendetwas ist fehlgeschlagen“ zu „dieses spezifische Muster hat es verursacht“ überzugehen, ohne jeden Vorfall manuell untersuchen zu müssen.
Eine einfache Testmatrix
Gültiger Standardfall (Happy Path): Die Bestellung sollte jede Regel bestehen.
Bekannter fehlerhafter Datensatz: Die Bestellung sollte bei genau einer benannten Regel fehlschlagen.
Grenzfall: Die Regel sollte sich am Grenzwert korrekt verhalten.
Regressionsstichprobe: Ein zuvor akzeptierter Datensatz sollte auch nach einer Regeländerung akzeptiert bleiben.
Das reicht völlig aus, um die Qualität der Regeln zu sichern, ohne das Gesamtsystem zu überladen. Wenn Sie nicht erklären können, warum ein Test existiert, brauchen Sie ihn wahrscheinlich nicht.
Regeln ohne Kopfschmerzen bereitstellen und verwalten
Das Schreiben von Regeln ist der einfache Teil. Mit ihnen zu leben ist der Punkt, an dem die eigentliche Designarbeit beginnt, da jede Änderung der Geschäftsrichtlinien die Gefahr birgt, alte Annahmen zu verletzen. Ein Validierungs-Framework, das nicht versioniert, erklärt und sicher erneut ausgeführt werden kann, wird irgendwann zu etwas, das niemand mehr anfassen möchte.
Wählen Sie Ihr Bereitstellungsmuster ganz bewusst
Der Strikte Gatekeeper blockiert fehlerhafte Datensätze, bevor sie in nachgelagerte Systeme gelangen. Das ist die richtige Wahl für Pipelines mit hohem Vertrauensanspruch, regulierte Berichterstattung und alles, was Chaos verursachen würde, wenn sich ungültige Daten weiter verbreiten.
Der Aufmerksame Monitor lässt die Daten durch, markiert oder isoliert jedoch Fehler oder leitet sie zur Überprüfung weiter. Das ist nützlich, wenn die Verfügbarkeit wichtiger ist als die sofortige Zurückweisung, oder wenn Sie das Problem erst einmal beobachten möchten, bevor Sie die Kontrollen verschärfen.
Keines der beiden Muster ist universell richtig. Gatekeeping bietet Ihnen eine strengere Kontrolle, während Monitoring Ihnen Flexibilität und Transparenz verschafft. Die meisten reifen Teams nutzen letztendlich beide Ansätze, da nicht jeder Datensatz das gleiche Maß an Hürden erfordert.
Gestalten Sie den Lebenszyklus von Regeln explizit
Eine Regel sollte eine Version, eine Änderungsnotiz und einen klaren Eigentümer haben. Sie benötigt außerdem Protokolle, die zeigen, wann sie ausgeführt wurde, was sie bewertet hat und wie sie fehlgeschlagen oder bestanden ist. Nur so lassen sich Audits unterstützen, ohne dass jeder Vorfall zu einer Detektivarbeit wird. Eurostats Leitfaden ist auch hier nützlich, da er besagt, dass die Regeln und sogar ihre Fehlermeldungen dokumentiert sein sollten, damit jeder Fehler auf die gleiche Weise interpretiert wird (Eurostat-Prinzipien).
Das große Problem bei der Wartung ist die schleichende Veränderung von Regeln (Rule Drift). Geschäftsrichtlinien ändern sich, Quellsysteme entwickeln sich weiter, und was einst ein sinnvoller Schwellenwert war, kann sich in ein Ärgernis oder einen blinden Fleck verwandeln. Der Validierungs-Workflow von ArcGIS ist eine gute Erinnerung daran, dass Validierung dynamisch und nicht statisch ist. Regeln müssen nach Bearbeitungen oft bewertet, überprüft und neu bewertet werden, insbesondere wenn sich Schemata und Berichtsbedingungen im Laufe der Zeit ändern (ArcGIS Validierungs-Attributregeln).
Wo eine Plattform den Schmerz lindern kann
Eine Plattform kann helfen, wenn die Menge an Regeln, Systemen und Ausnahmen über Tabellenkalkulationen und Ad-hoc-Skripte hinauswächst. Eine Option ist digna, eine Plattform, die auf deterministische geschäftliche und technische Validierungslogik mit In-Database-Regelausführung und vollständigen Audittrails setzt. So laufen die Prüfungen dort ab, wo die Daten liegen, und die Belege werden für Compliance- und regulatorische Prüfungen aufbewahrt (Einführung in die digna-Plattform).
Das ist wichtig, da eine Validierung nur dann nützlich ist, wenn die Beteiligten sowohl dem Ergebnis als auch dem Prozess vertrauen können. Eine gute Benutzeroberfläche ist praktisch, aber der tiefer liegende Gewinn liegt in der Rückverfolgbarkeit: der Fähigkeit zu beantworten, wer was geändert hat, was fehlgeschlagen ist und warum mit dem Datensatz so verfahren wurde, wie es geschehen ist.
Wenn Sie auch Optionen für Observability und die Durchsetzung von Regeln vergleichen, ist der Schutz Ihrer Forschungsdaten eine nützliche Lektüre, da der Fokus dort auf der Integrität und nicht nur auf der Alarmierung liegt.
Das Endziel: Validierung als Säule des Datenvertrauens
Eine gute Regel beginnt als geschäftliche Anforderung, wird zu Code, wird getestet und existiert schließlich als überwachter Produktionswert mit einem Eigentümer und einem Audit-Trail. Dieser Lebenszyklus macht den Unterschied zwischen stichprobenartigen Prüfungen und einer echten Governance-Haltung aus. Sobald das Unternehmen Validierung als System und nicht als Provisorium begreift, lässt sich Vertrauen leichter gewinnen und verteidigen.
Die erfolgreichsten Teams fragen nicht mehr, ob sie Daten validieren sollten, sondern wo jede Regel hingehört, wie sie versioniert ist und was passiert, wenn sie fehlschlägt. Dieser Wandel macht Data Engineers zu Hütern der Integrität statt zu Aufräumtrupps. Wenn Sie einen allgemeineren, kulturellen Rahmen benötigen, verknüpft dieser Leitfaden zum Aufbau von Datenqualitätsgewohnheiten die technischen Kontrollen auf nützliche Weise mit der täglichen Eigenverantwortung.
Das Endziel sind keine perfekten Daten, denn die gibt es nicht. Das Endziel sind vorhersehbare Daten, sichtbare Ausnahmen und ein Prozess, der die Wahrheit schnell genug ans Licht bringt, damit Analysten, Auditoren und Betreiber darauf reagieren können. Sobald diese Komponenten etabliert sind, ist die Validierung kein lästiger Overhead mehr, sondern einer der stillen Gründe, warum Ihre Analysen, Compliance und Automatisierungen funktionieren.
Ein CTA für digna.
Wie sich diese Regeln auf Datensatzebene direkt in der Datenbank ausführen lassen, mit einem Audit-Trail darüber, was fehlgeschlagen ist und warum, zeigt digna Data Validation.
Häufig gestellte Fragen
Welche Hauptarten von Datenvalidierungsregeln gibt es?
Der Artikel gliedert Regeln in Formatvalidierung, Bereichsprüfungen, Schemavalidierung und feldübergreifende Validierung, ergänzt um referenzielle Integrität. Beginnen Sie mit einfachen Null-, Typ- und Formatprüfungen, ergänzen Sie numerische und fachliche Einschränkungen wie positive Preise und schreiben Sie dann feldübergreifende Regeln für Felder, die nur im Kontext Sinn ergeben.
Wie schreibt man eine Datenvalidierungsregel in SQL?
Für einfache Feldlogik verwenden Sie einen CHECK-Constraint in der Tabellendefinition, etwa CHECK (price > 0) oder CHECK (discount <= price). Bedingte Regeln passen besser in einen CASE-Ausdruck, der zum Beispiel eine Bestellung als fehlerhaft markiert, wenn shipping_country = 'ES' und nif IS NULL ist, sodass die Geschäftsregel explizit bleibt.
Wie testet man Datenvalidierungsregeln?
Testen Sie sie wie Anwendungscode in Schichten: Unit-Tests mit kleinen, kuratierten Mengen gültiger und ungültiger Datensätze, Integrationstests in der Pipeline und Regressionstests bei jeder Regeländerung. Eine einfache Matrix deckt einen Happy Path, einen bekannten fehlerhaften Datensatz, einen Grenzfall und eine Regressionsstichprobe ab.
Sollte ein Validierungsfehler die gesamte Datei ablehnen?
Nur wenn die Struktur selbst defekt ist. Nach der Praxis der EU-Transaktionsmeldungen unter MiFIR führen Syntaxfehler auf Schemaebene zur Ablehnung der gesamten Datei, während Verstöße gegen Inhaltsregeln nur die ungültigen Transaktionen ablehnen. Diese Trennung hält den Wirkungsradius klein und vermeidet unnötige erneute Einreichungen.
Was ist der Unterschied zwischen Gatekeeper- und Monitor-Validierung?
Der Strict Gatekeeper blockiert fehlerhafte Datensätze, bevor sie nachgelagerte Systeme erreichen, und eignet sich für regulierte Berichte und Pipelines mit hohem Vertrauensanspruch. Der Observant Monitor lässt Daten durch, markiert Fehler jedoch, stellt sie unter Quarantäne oder leitet sie zur Prüfung weiter. Die meisten reifen Teams nutzen beide Muster.



