Aggregierte Daten definieren: Methoden, Beispiele und Fallstricke
|
7
min. Lesezeit

Aggregierte Daten sind Informationen, die entstehen, wenn einzelne Datensätze in Kategorien gruppiert und ihre Werte zu Kennzahlen wie Anzahlen, Summen, Durchschnitten oder Raten zusammengefasst werden. Das klingt einfach, doch der Rat „Bauen Sie einfach ein Dashboard“ sorgt für die meisten Probleme, denn Aggregation verändert sowohl die Bedeutung als auch das Risikoprofil der zugrunde liegenden Datensätze.
Inhaltsverzeichnis
Warum aggregierte Daten für Analytics und Observability wichtig sind
Datenschutz- und Offenlegungsrisiken in aggregierten Ergebnissen
Ein durchgerechnetes Beispiel: von Rohdaten zum vertrauenswürdigen Aggregat
Was aggregierte Daten wirklich bedeuten
Aggregierte Daten sind zusammenfassende Informationen, die aus Datensätzen auf niedrigerer Ebene abgeleitet werden, keine eigene Datenart, die für sich allein entsteht. Das Denkmodell hat zwei Seiten: Auf der einen stehen einzelne Ereignisse, Transaktionen oder Beobachtungen, auf der anderen Summen, Durchschnitte oder Raten auf Gruppenebene, die viele Zeilen zu wenigen Ergebnissen verdichten.
Ein anschauliches Beispiel ist eine Datenbank mit 1 Million einzelner Kundentransaktionen, die zu 12 Monatssummen pro Markt zusammengefasst werden. Die einzelnen Käufe sind dann nicht mehr sichtbar, dafür lassen sich Märkte vergleichen, Saisonalität verfolgen und grobe Muster viel schneller erkennen. Das Australian Bureau of Statistics beschreibt Aggregation als das Gruppieren von Informationen in Kategorien und das Zusammenfassen der Werte innerhalb dieser Kategorien, oft in Tabellenform. Deshalb spricht man auch von tabellarischen Daten oder Makrodaten ABS glossary.

Die Arbeitsdefinition, die sich in der Praxis bewährt
Betrachten Sie Aggregation als Transformation, die auf Rohbeobachtungen angewendet wird. Aus einer Kundentransaktion wird ein monatlicher Umsatz, aus einem Strom von Telemetrie-Ereignissen eine stündliche Fehleranzahl und aus einer Haushaltszählung eine Tabelle mit Bevölkerungsmerkmalen. Das ist der Grundgedanke: viele Datensätze auf wenige Zusammenfassungen reduzieren.
Faustregel aus der Praxis: Wenn das Ergebnis eine Frage über eine Gruppe beantworten kann, aber keine über eine einzelne Person, ist es aggregiert. Lässt sich das Ergebnis ohne zusätzlichen Kontext noch auf einen einzelnen Datensatz zurückführen, behandeln Sie es als Datenschutz- und Offenlegungsrisiko.
Diese Unterscheidung ist wichtig, weil dasselbe Ergebnis für das Reporting nützlich und trotzdem so sensibel sein kann, dass es Kontrollen braucht. Wenn Sie eine zweite Quelle für die Terminologie suchen, während Sie überlegen, wie Anbieter diesen Bereich beschreiben, ist die Sammlung pricing data research von Wine Labs ein nützlicher Bezugspunkt dafür, wie strukturierte Zusammenfassungen in der Marktforschung dargestellt werden.
Die wichtigsten Aggregationsmethoden erklärt
Aggregation wird einfacher, sobald man sie nicht mehr als eine einzige Sache betrachtet. In der Praxis greifen Teams auf eine kleine Auswahl an Funktionen zurück, und jede beantwortet eine andere Frage zu denselben zugrunde liegenden Zeilen.
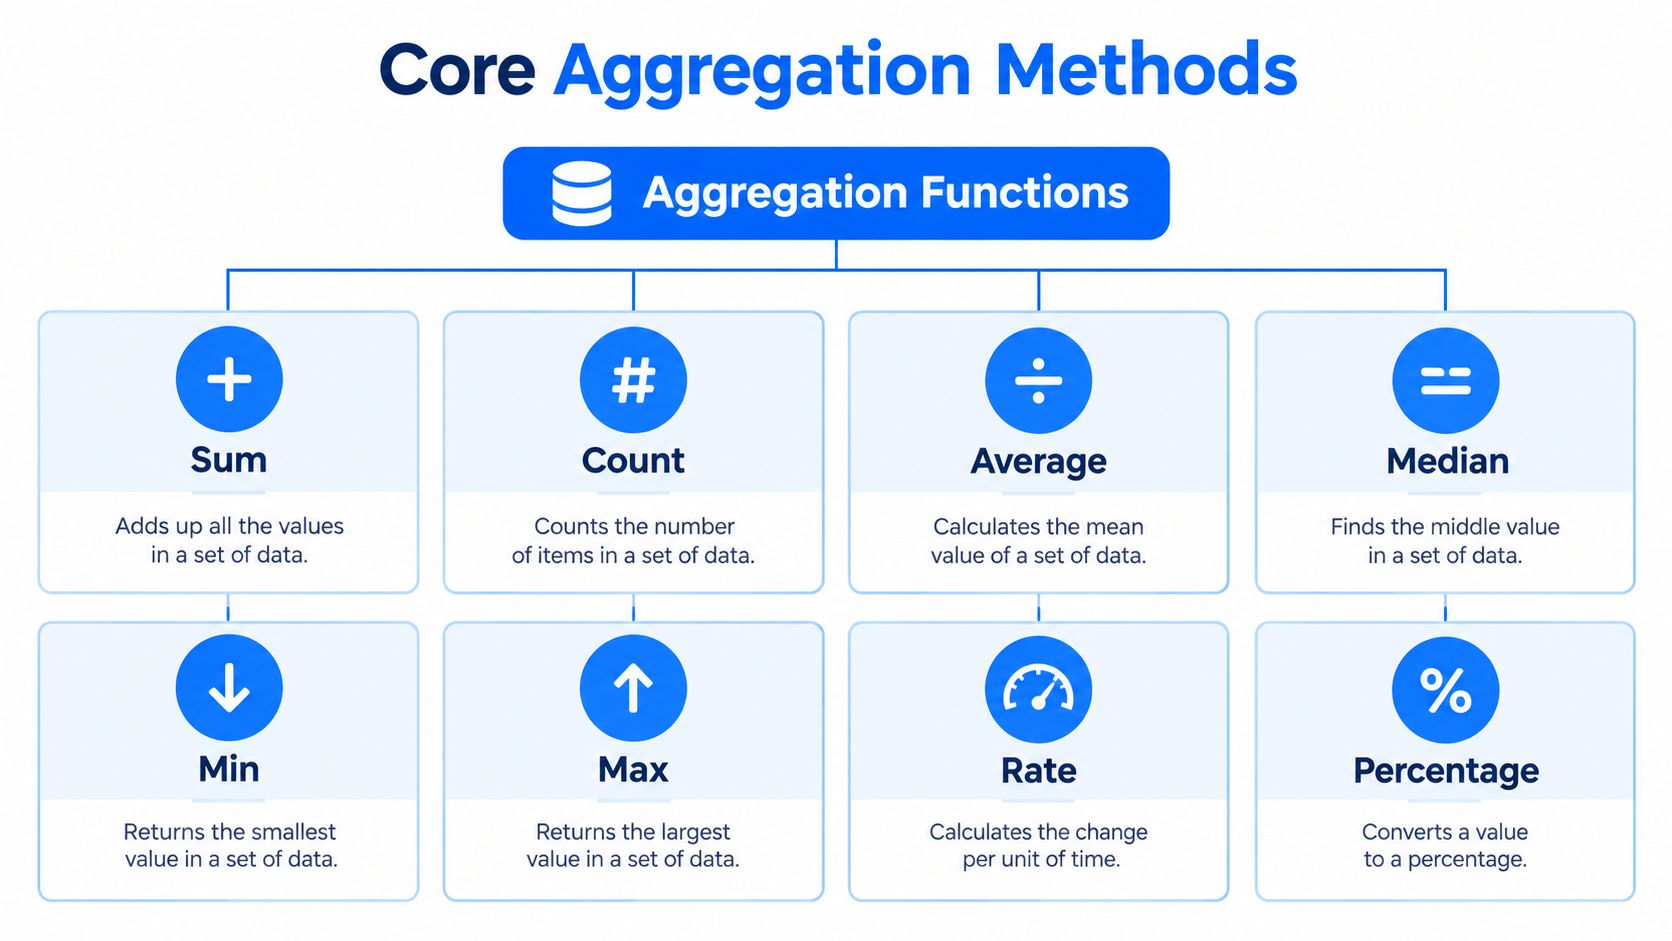
Die wichtigsten Funktionen und was sie bewahren
Summe addiert Werte. Haben fünf Bestellungen einen Wert von 20, 30, 10, 40 und 50, beträgt die Summe 150. Sie ist die richtige Wahl, wenn es um Volumen, Umsatz, verkaufte Einheiten oder die gesamte aufgewendete Zeit geht.
Anzahl gibt an, wie viele Datensätze in der Gruppe liegen. Sie bewahrt das Aktivitätsvolumen, aber nicht die Größe der Werte, und eignet sich daher für Transaktionen, Tickets, Nutzer oder Ereignisse, wenn die Frage „Wie viele?“ lautet.
Durchschnitt liefert das arithmetische Mittel. Er hilft, wenn Sie einen typischen Wert suchen, kann aber irreführen, wenn einige große Ausreißer das Ergebnis von dem wegziehen, wie die meisten Zeilen aussehen.
Median liefert den mittleren Wert nach dem Sortieren. Verwenden Sie ihn bei schiefen Verteilungen, weil er Extremwerten besser standhält als der Durchschnitt.
Minimum und Maximum behalten den kleinsten und den größten Wert. Sie sind nützlich für Bereichsprüfungen, verwerfen aber alles dazwischen.
Raten und Prozentwerte brauchen Disziplin beim Nenner
Eine Rate ist ein Verhältnis, etwa Conversions geteilt durch Besucher. Ein Prozentwert drückt dieselbe Idee auf einer Skala von 100 aus. Beide sind nur aussagekräftig, wenn der Nenner stabil und klar definiert ist.
Ein häufiger Fehler ist es, Prozentwerte über Gruppen mit ungleichen Nennern zu mitteln. Dadurch zählt eine kleine Gruppe genauso viel wie eine große, was das Ergebnis verzerrt. Lautet die Frage „Welcher Anteil des gesamten Traffics hat konvertiert?“, muss der Nenner der gesamte Traffic sein und nicht ein Durchschnitt monatlicher Conversion-Raten.
Faustregel: Verwenden Sie die einfachste Funktion, die die zu treffende Entscheidung bewahrt, und nicht mehr. Geht es in der fachlichen Frage um Größenordnung, nehmen Sie Summe oder Anzahl. Geht es um typisches Verhalten, ziehen Sie bei schiefen Daten den Median dem Durchschnitt vor.
Rollups, Zeitfenster und zeitbasierte Aggregationen
Durch die Zeitdimension wird Aggregation zu einer gesteuerten Entscheidung und nicht nur zu einer Berechnung. Dieselbe Kauftabelle kann Tagesumsätze, Wochensummen, Zahlen für den Monatsabschluss oder eine rollierende Trendlinie liefern, und jede Variante beantwortet eine andere operative Frage.
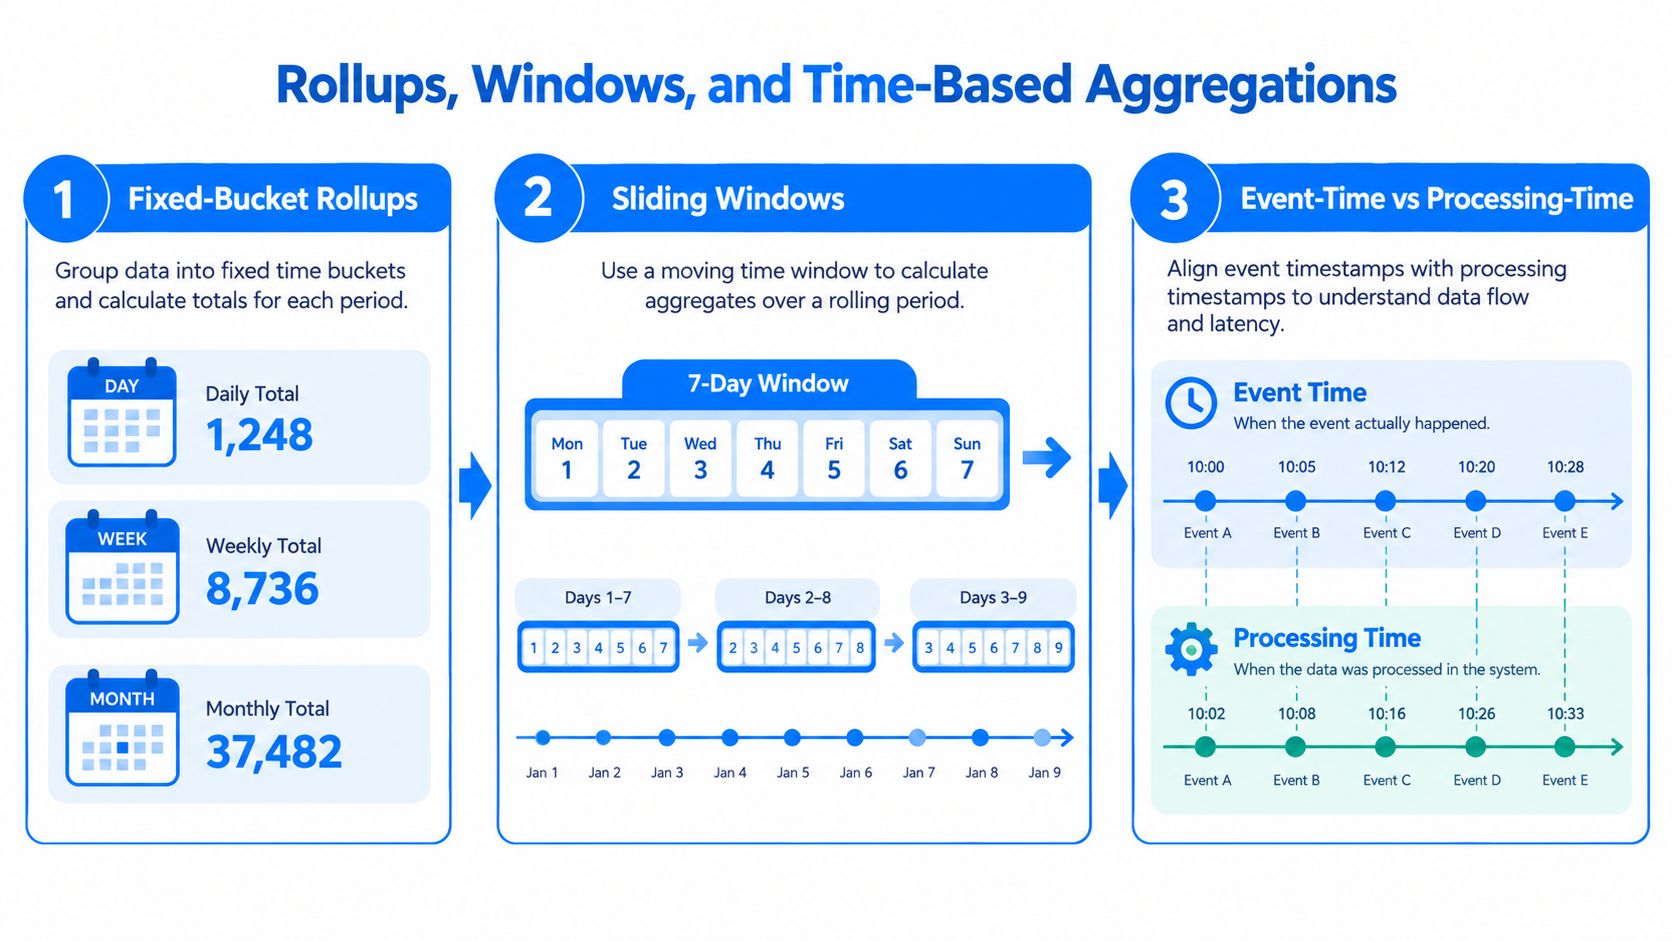
Feste Intervalle und rollierende Sichten
Ein Rollup mit festen Intervallen gruppiert Datensätze in Kalenderperioden wie Tag, Woche oder Monat. Möchte ein Vertriebsteam den monatlichen Umsatz nach Region sehen, ist der Monat die Intervallgrenze, und jede Bestellung landet anhand ihres Datums in genau einem Intervall. Das macht wiederkehrende Berichte leicht vergleichbar, bedeutet aber auch, dass die Stichtagsregel explizit sein muss.
Ein gleitendes Fenster verschiebt das Intervall laufend. Ein rollierender 7-Tage-Durchschnitt glättet das tägliche Rauschen und zeigt den Trend, den eine einzelne Tagessumme verbergen würde. Der Nachteil: Jeder neue Tag verändert das Ergebnis, sodass sich die Zahl von gestern verschieben kann, wenn verspätete Datensätze eintreffen.
Ereigniszeit und Verarbeitungszeit sind nicht dasselbe
Die Ereigniszeit ist der Zeitpunkt, an dem der Verkauf, der Klick oder der Sensormesswert tatsächlich stattfand. Die Verarbeitungszeit ist der Zeitpunkt, an dem Ihr System ihn empfangen hat. Treffen Lieferungen verspätet ein, bleibt ein Dashboard nach Ereigniszeit nah an der Realität, während ein Dashboard nach Verarbeitungszeit zu früh vollständig wirken und sich später noch ändern kann.
Deshalb bringen verspätet eintreffende Daten naive Dashboards aus dem Tritt, und deshalb kombinieren Teams Rollups mit types of anomaly detection, um Aggregate zu erkennen, die von ihrer Baseline abweichen. Die Rohdaten können korrekt sein und das Aggregat für das gewählte Berichtsfenster trotzdem falsch.
Für Engineering-Teams, die solche Rollups in SQL-Engines und Pipeline-Jobs verarbeiten, hält in-database processing die Logik nah an den Daten und vermeidet unnötige Datenbewegungen.
Wo Aggregation in modernen Datensystemen stattfindet
Aggregation taucht überall dort auf, wo nachgelagerte Nutzer schnellere oder einfachere Antworten brauchen, als Rohdatensätze liefern können. Die Speicherschicht ändert sich, das Muster bleibt gleich: Datensätze gruppieren, zusammenfassen und in einer nutzbaren Form bereitstellen.

Die üblichen Orte für Rollups
Operative Datenbanken speisen oft Echtzeit-Dashboards, vor allem wenn ein Team Einblick in Service-Level aus laufenden Transaktionen haben möchte. Die typische Schwachstelle ist der Aktualitätsdruck, denn aufwendige Rollups können genau das System verlangsamen, das gleichzeitig den Anwendungs-Traffic bedienen soll.
Data Warehouses enthalten meist dimensionale Modelle und vorberechnete Faktentabellen. Dort liegt häufig das Reporting für Finanzen, Vertrieb und Geschäftsleitung, doch Warehouse-Rollups können aus dem Takt mit den Quelltabellen geraten, wenn die Aktualisierungslogik unvollständig oder die Partitionierung uneinheitlich ist.
Data Lakes und Lakehouses unterstützen Batch- und Streaming-Pipelines und sind dadurch flexibel für gemischte Workloads. Der Preis ist Komplexität, denn Streaming-Fenster können verspätete Ereignisse verlieren und Batch-Jobs Probleme bis zum nächsten Lauf verbergen.
Den Ort nach der Fragestellung wählen
Observability-Plattformen nutzen Metrik-Rollups für Alerting und Trendanalysen, weil Alerts schnelle Zusammenfassungen statt roher Logs brauchen. Wenn Sie Architekturhinweise für das Design eines modernen Stacks suchen, ist der Überblick modern data architecture approaches von Ekipa eine hilfreiche Referenz dafür, wie diese Schichten üblicherweise zusammenspielen.
Läuft die Aggregation nah an Produktivsystemen, ist die Form der Abfrage genauso wichtig wie die Mathematik. Ein schnelles Dashboard mit der falschen Gruppierung kann gefährlicher sein als ein langsames, das erkennbar unvollständig ist.
Warum aggregierte Daten für Analytics und Observability wichtig sind
Dashboards, Management-Reporting, regulatorische Meldungen und Machine-Learning-Features hängen alle von aggregierten Sichten ab. Ein einziges schwaches Aggregat kann Fehler also in alle nachgelagerten Systeme tragen, selbst wenn die Rohdaten in der Quelle intakt sind.
Der Observability-Aspekt ist genauso wichtig. Eine ungewöhnliche Summe oder Rate ist oft der erste Hinweis darauf, dass sich vorgelagert etwas geändert hat, sei es ein fehlerhafter Join, eine fehlende Partition, ein verspäteter Feed oder eine Schemaänderung. Aggregierte Metriken machen solche Signale schnell sichtbar, und deshalb überwachen Teams sie zuerst.
Was Aggregation verbirgt, wenn der Kontext fehlt
Eine Summe kann eine schrumpfende Grundgesamtheit verdecken. Ein Durchschnitt kann einen langen Ausläufer verbergen. Eine Rate kann stabil wirken, während sich der Nenner ändert. Deshalb tragen gute Aggregate neben der Zahl auch Metadaten mit sich, darunter Datensatzanzahlen, Abdeckung und die Gruppierungsdimensionen, die das Ergebnis geprägt haben.
Für Teams, die Monitoring-Sichten aufbauen, lautet die Frage nicht nur „Wie hoch ist die Metrik?“, sondern auch „Welche Datensätze sind eingeflossen, was wurde ausgeschlossen und was hat sich seit dem letzten Mal geändert?“ Die Antwort entscheidet darüber, ob die Zahl vertrauenswürdig oder nur aufgeräumt ist.
Wenn Sie bereits mit Monitoring-Stacks arbeiten, ist die Seite what is data observability eine praktische Ergänzung zu diesem Gedanken, weil sie Metriken als etwas behandelt, das man prüft, und nicht nur anzeigt.
Datenschutz- und Offenlegungsrisiken in aggregierten Ergebnissen
Aggregation verbessert den Datenschutz in vielen Fällen, ist aber nicht gleichbedeutend mit Anonymität. NIST definiert aggregierte Informationen als Daten, die über mehrere Personen hinweg erhoben werden, um Vergleiche anzustellen oder Muster zu erkennen, und warnt zugleich, dass das Zusammentragen von Daten zusätzliche Risiken schaffen kann, weil die Gesamtheit der Daten ein vollständigeres Bild ergeben oder eine De-Anonymisierung ermöglichen kann NIST aggregated information.
Warum kleine Gruppen weiterhin Risiken bergen
Regeln zur Offenlegungskontrolle gibt es, weil kleine Zellen immer noch auf Personen oder Organisationen zurückverweisen können. Leitlinien der türkischen amtlichen Statistik behandeln eine aggregierte Tabellenzelle als vertraulich, wenn sie weniger als 3 statistische Einheiten enthält, und kennzeichnen außerdem Dominanzfälle, in denen eine Einheit mehr als 80 % des Zellenwerts beiträgt oder zwei Einheiten mehr als 90 % NIST data aggregation. Die britische Care Quality Commission nennt zudem die Faustregel, Gruppen von 10 oder weniger zu vermeiden und Gruppen von 5 oder weniger nur in besonders risikoarmen Situationen zu verwenden CQC anonymisation guidance.
Das sind keine allgemeingültigen sicheren Häfen. Das Risiko hängt weiterhin von Geografie, zeitlicher Granularität, externem Wissen und davon ab, was ein entschlossener Betrachter durch das Kombinieren von Sichten ableiten kann.
Die Kontrollen, die in den Freigabeprozess gehören
Generalisierung erweitert eine enge Kategorie zu einer breiteren, etwa Bundesland statt Landkreis. Unterdrückung blendet den Wert vollständig aus, wenn eine Zelle zu klein ist. Perturbation verändert den veröffentlichten Wert, um das Offenlegungsrisiko zu senken, ohne die gesamte Metrik zu verwerfen. In der Praxis wirken diese Kontrollen zusammen und nicht isoliert.
Ein häufiger Fehler ist die Annahme, ein Dashboard sei sicher, weil es keine Namen mehr zeigt. Enge Filter können das Identifizierungsrisiko sehr schnell wiederherstellen, besonders nach Geografie, Zeitraum oder Kundensegment. Wenn Nutzer zu tief hineinzoomen dürfen, verhält sich das Aggregat irgendwann nicht mehr wie eine Gruppe, sondern wie eine verkleidete Einzelzeile.
Customer data protection guidance ist hier relevant, weil Datenschutzkontrollen nur funktionieren, wenn sie am konkreten Veröffentlichungskontext gemessen werden und nicht allein am Etikett „aggregiert“.
Validierung und Datenqualität
Ein Aggregat kann mathematisch korrekt und trotzdem irreführend sein. Deshalb brauchen aggregierte Ergebnisse eigene Qualitätsprüfungen und nicht nur ein Bestanden oder Nicht bestanden für die Quellzeilen.
Die Prüfungen, die die häufigsten Fehler erkennen
Durchschnitte können das Simpson-Paradoxon verbergen, bei dem sich ein Trend umkehrt, sobald man nach einer relevanten Dimension aufteilt. Ein KPI kann im Rollup gesund aussehen, während sich darunter eine Region oder ein Segment verschlechtert. Das ist kein Rechenfehler, sondern ein Gruppierungsfehler.
Die praktischen Leitplanken sind überschaubar:
Mindestgruppengröße: Stellen Sie sicher, dass jede veröffentlichte Gruppe groß genug ist, um sowohl das Offenlegungsrisiko als auch verrauschte Schlussfolgerungen zu verringern.
Stabilität des Nenners: Prüfen Sie, ob sich die Grundgesamtheit hinter einer Rate so verändert hat, dass Vergleiche schief werden.
Umgang mit Nullwerten: Legen Sie fest, ob fehlende Werte ausgeschlossen, imputiert oder als null behandelt werden, bevor das Rollup läuft.
Umgang mit Duplikaten: Entfernen oder markieren Sie doppelte Datensätze, bevor sie Summen aufblähen.
Verspätet eintreffende Daten: Gleichen Sie Ereigniszeit und Verarbeitungszeit ab, damit das Dashboard nicht zu früh vorgibt, endgültig zu sein.
Lineage: Erhalten Sie den Weg vom Aggregat zurück zu den Quelldatensätzen und zur Gruppierungslogik.
Signale, die eine Untersuchung auslösen sollten
Schrumpft die aggregierte Grundgesamtheit plötzlich, wird sie stark konzentriert oder ändern sich ihre Dimensionen so, dass das Offenlegungsrisiko steigt, sollte jemand die Pipeline sofort prüfen. Das sind keine kosmetischen Änderungen. Meist bedeuten sie, dass sich die Definition, der Quell-Feed oder der Veröffentlichungskontext verschoben hat.
Für Qualitäts- und Regelprüfungen ist data validation rules, checks, and continuous data quality ein passendes Begleitthema, denn der Zweck der Validierung ist, das Aggregat vertrauenswürdig zu machen und nicht nur zu berechnen.
Faustregel aus der Praxis: Fragen Sie erst dann, ob die Metrik „stimmt“, wenn Sie geprüft haben, ob Gruppe, Nenner und Lineage noch das bedeuten, was Sie annehmen.
Ein durchgerechnetes Beispiel: von Rohdaten zum vertrauenswürdigen Aggregat
Ausgangspunkt ist ein Strom von Kaufereignissen. Jeder Datensatz enthält einen Zeitstempel, eine Region, einen Bestellwert und einen Versandstatus. Das erste Aggregat ist einfach: Die Bestellwerte werden summiert und die Bestellungen nach Tag und Region gezählt, um Tagesumsatz und Bestellvolumen zu erhalten.
Den Trend aufbauen, ohne den Entscheidungskontext zu verlieren
Als Nächstes kommt ein rollierender 7-Tage-Durchschnitt auf die Tagessummen. Er glättet Wochenendschwankungen und gibt dem Team eine ruhigere Trendlinie für die operative Besprechung. Trifft eine verspätete Lieferung nach dem Tagesabschluss ein, sollte die Ereigniszeit-Version des Aggregats neu berechnet werden, während die Verarbeitungszeit-Sicht als Audit-Trail dafür bestehen bleiben kann, wann das System davon erfahren hat.
Danach folgt die Datenschutzentscheidung. Hat eine Region zu wenige Bestellungen oder trägt ein einzelner Händler fast alles in dieser Region bei, sollte das Team die Geografie zusammenfassen oder die Zelle unterdrücken, statt eine fragile Zahl zu veröffentlichen. So bleibt das Dashboard nützlich, ohne dass sich eine Person oder ein Anbieter leichter erschließen lässt.
Das Aggregat als überwachtes Asset behandeln
Sobald die Metrik live ist, wird sie Teil der Observability. Fällt der tägliche Gesamtumsatz stark, die Anzahl der Bestellungen aber nicht, ist das ein Signal, Preise, Erstattungen oder fehlende Werte zu prüfen. Ändert sich die Grundgesamtheit hinter der Metrik plötzlich, sollte das Team die Filterlogik untersuchen, bevor irgendjemand dem Diagramm vertraut.
Die Aussage des Beispiels ist einfach. Aggregation ist nicht der letzte Schritt. Sie ist der Punkt, an dem Korrektheit, Datenschutz und operatives Vertrauen zusammentreffen.
Kurzreferenz für die Arbeit mit aggregierten Daten
Definition: Aggregierte Daten sind Informationen auf Gruppenebene, die entstehen, wenn einzelne Datensätze zu Zusammenfassungen wie Anzahlen, Summen, Durchschnitten, Raten oder Verteilungen kombiniert werden.
Gängige Funktionen:
Summe für Volumen. Anzahl für die Häufigkeit von Datensätzen. Durchschnitt für typische Werte. Median für schiefe Verteilungen. Minimum und Maximum für Bereichsprüfungen. Rate und Prozentwert für Verhältnisse, mit sorgfältig definiertem Nenner.
Datenschutz-Schwellenwerte zum Merken:
Auch kleine Gruppen können Informationen preisgeben. Achten Sie bei der Bewertung des Veröffentlichungsrisikos auf weniger als 3 Einheiten, Dominanzmuster über 80 % oder 90 % und Gruppen mit geringer Fallzahl um 10 oder weniger.
Validierungsprüfungen, die dauerhaft bleiben sollten:
Mindestgruppengröße, Stabilität des Nenners, Umgang mit Nullwerten, Umgang mit Duplikaten, Umgang mit verspätet eintreffenden Daten und Lineage zurück zu den Quelldatensätzen.
Operative Denkweise:
Aggregation ist eine gesteuerte Transformation, keine Garantie für Datenschutz und keine Garantie für Qualität.
digna hilft Teams, die Daten hinter diesen Aggregaten zu überwachen und nicht nur das Dashboard darüber. Wenn Sie Anomalieerkennung, Validierung, Überwachung der Datenaktualität, Schema-Monitoring und In-Database-Ausführung in Ihrer eigenen Umgebung brauchen, besuchen Sie digna und sehen Sie, wie es in Ihren Data Stack passt.
Einen Katalog der Volumen-, Aktualitäts- und Verteilungsmetriken, mit denen solche Aggregate dauerhaft vertrauenswürdig bleiben, finden Sie unter Data-Observability-Metriken.
Häufig gestellte Fragen
Was sind aggregierte Daten?
Aggregierte Daten sind zusammenfassende Informationen auf Gruppenebene, die entstehen, wenn einzelne Datensätze zu Anzahlen, Summen, Durchschnitten, Raten oder Verteilungen kombiniert werden. So lassen sich etwa 1 Million Kundentransaktionen zu 12 Monatssummen pro Markt verdichten, mit denen Sie Märkte vergleichen und Saisonalität erkennen, ohne jeden einzelnen Kauf zu betrachten.
Welche Aggregationsfunktionen sind am gebräuchlichsten?
Summe, Anzahl, Durchschnitt, Median, Minimum, Maximum, Rate und Prozentwert decken den Großteil des Reportings ab. Jede bewahrt etwas anderes: Die Summe erhält das Volumen, die Anzahl die Aktivität, der Median hält Ausreißern in schiefen Daten stand, Minimum und Maximum unterstützen Bereichsprüfungen. Raten und Prozentwerte sind nur bei stabilem, klar definiertem Nenner aussagekräftig.
Sind aggregierte Daten anonym?
Nicht automatisch. Aggregation senkt das Datenschutzrisiko, doch kleine oder von Einzelnen dominierte Gruppen können weiterhin auf Personen oder Organisationen verweisen. Manche Leitlinien der amtlichen Statistik behandeln eine Zelle als vertraulich, wenn sie weniger als 3 Einheiten enthält oder eine Einheit mehr als 80 % ihres Werts beiträgt. Dann können Unterdrückung oder Generalisierung nötig sein.
Warum sollte man Prozentwerte nicht über Gruppen mitteln?
Wer Prozentwerte aus unterschiedlich großen Gruppen mittelt, gewichtet eine kleine Gruppe genauso stark wie eine große und verzerrt damit das Ergebnis. Wenn Sie wissen möchten, welcher Anteil des gesamten Traffics konvertiert hat, teilen Sie die gesamten Conversions durch den gesamten Traffic, statt monatliche Conversion-Raten zu mitteln.
Wie validiert man aggregierte Daten?
Prüfen Sie das Aggregat selbst und nicht nur die Quellzeilen: Mindestgruppengröße, Stabilität des Nenners, Umgang mit Nullwerten und Duplikaten, verspätet eintreffende Daten und Lineage zurück zu den Quelldatensätzen. Überwachen Sie es danach laufend. Sinkt der Tagesumsatz stark, während die Bestellanzahl stabil bleibt, prüfen Sie Preise, Erstattungen oder fehlende Werte.


