Was ist eine Datenstrategie und wie baut man eine, die funktioniert
|
6
min. Lesezeit

Man spürt die Lücke, bevor sie jemand ausspricht. Im Management-Deck steht, das Unternehmen werde datengetrieben, das Plattformbudget ist bewilligt, und trotzdem kehren dieselben Fragen immer wieder: Welches Dashboard stimmt, wem gehört dieser Datensatz, und warum ist der Report schon wieder veraltet? Genau dann merken die meisten, dass das Problem nicht fehlende Tools sind, sondern ein fehlendes Betriebsmodell.
Eine brauchbare Antwort auf die Frage was ist eine Datenstrategie ist leicht auszusprechen und schwer gut umzusetzen. Es ist der koordinierte Ansatz, mit dem ein Unternehmen Daten im Sinne seiner Geschäftsziele steuert, verwaltet, teilt, schützt und Wert aus ihnen schöpft. In der Praxis heißt das: festlegen, wer Daten nutzen darf, unter welchen Bedingungen, mit welchen Qualitäts- und Sicherheitskontrollen und wie diese Daten zwischen Teams und Systemen fließen.
Inhaltsverzeichnis
Warum die meisten Datenstrategien scheitern, bevor sie beginnen
Wie Observability und Qualitätskontrollen Strategie in den Betrieb bringen
Warum die meisten Datenstrategien scheitern, bevor sie beginnen
Das Scheitern beginnt meist im Sitzungssaal, nicht in der Pipeline. Jemand präsentiert ein poliertes Foliendeck mit Zielen, Architekturkästen und ein paar beruhigenden Sätzen über Transformation. Einen Monat später ist das Finanz-Dashboard veraltet, das Produktteam hat seine eigene Definition von Umsatz, und der Data Engineer kann immer noch nicht sagen, wem der kritische Datensatz gehört, der nach einer Schemaänderung kaputtgegangen ist.
Deshalb darf eine Datenstrategie nicht wie eine Roadmap für Tools behandelt werden. Sie muss als Betriebsmodell funktionieren, das Geschäftsprioritäten mit Verantwortung, Standards, Qualitätsmessung, Lifecycle-Kontrollen, Metadaten und verlässlicher Bereitstellung verknüpft. Wenn niemand weiß, wer entscheidet, sobald Daten eine Teamgrenze überschreiten, fehlt der Strategie bereits das Rückgrat.
Die Geschichte der EU-Datenpolitik zeigt das deutlich. Die Europäische Datenstrategie behandelte Datenverfügbarkeit und Vertrauen als wirtschaftliche Infrastruktur und nicht bloß als IT-Thema, und in einer öffentlichen Konsultation stimmten 97,2 % von 806 Teilnehmenden zu, dass die EU eine übergreifende Datenstrategie braucht, während 91,5 % die politische Richtung unterstützten (Europäische Datenstrategie und Ergebnisse der Konsultation). Das ist ein Governance-Signal, kein Tooling-Signal.
Faustregel: Wenn Ihre Strategie nicht sagt, wem ein Datensatz gehört, wie Qualität gemessen wird und was passiert, wenn die Regeln versagen, ist sie noch keine Strategie.
Die stärkste Definition ist die, nach der Teams handeln können: Eine Datenstrategie verbindet Geschäftsergebnisse mit dem Verhalten der Daten. Sie definiert, welche Daten zählen, wie sie sich verhalten sollen und welche Nachweise belegen, dass sie es noch tun. Ein deutliches Warnsignal liefern Organisationen, die immer wieder datenreiche, aber informationsarme Umgebungen aufbauen, denn genau das passiert, wenn Strategie beim Anspruch stehen bleibt und nie bei der Verantwortung ankommt.
Die Kernbausteine einer modernen Datenstrategie
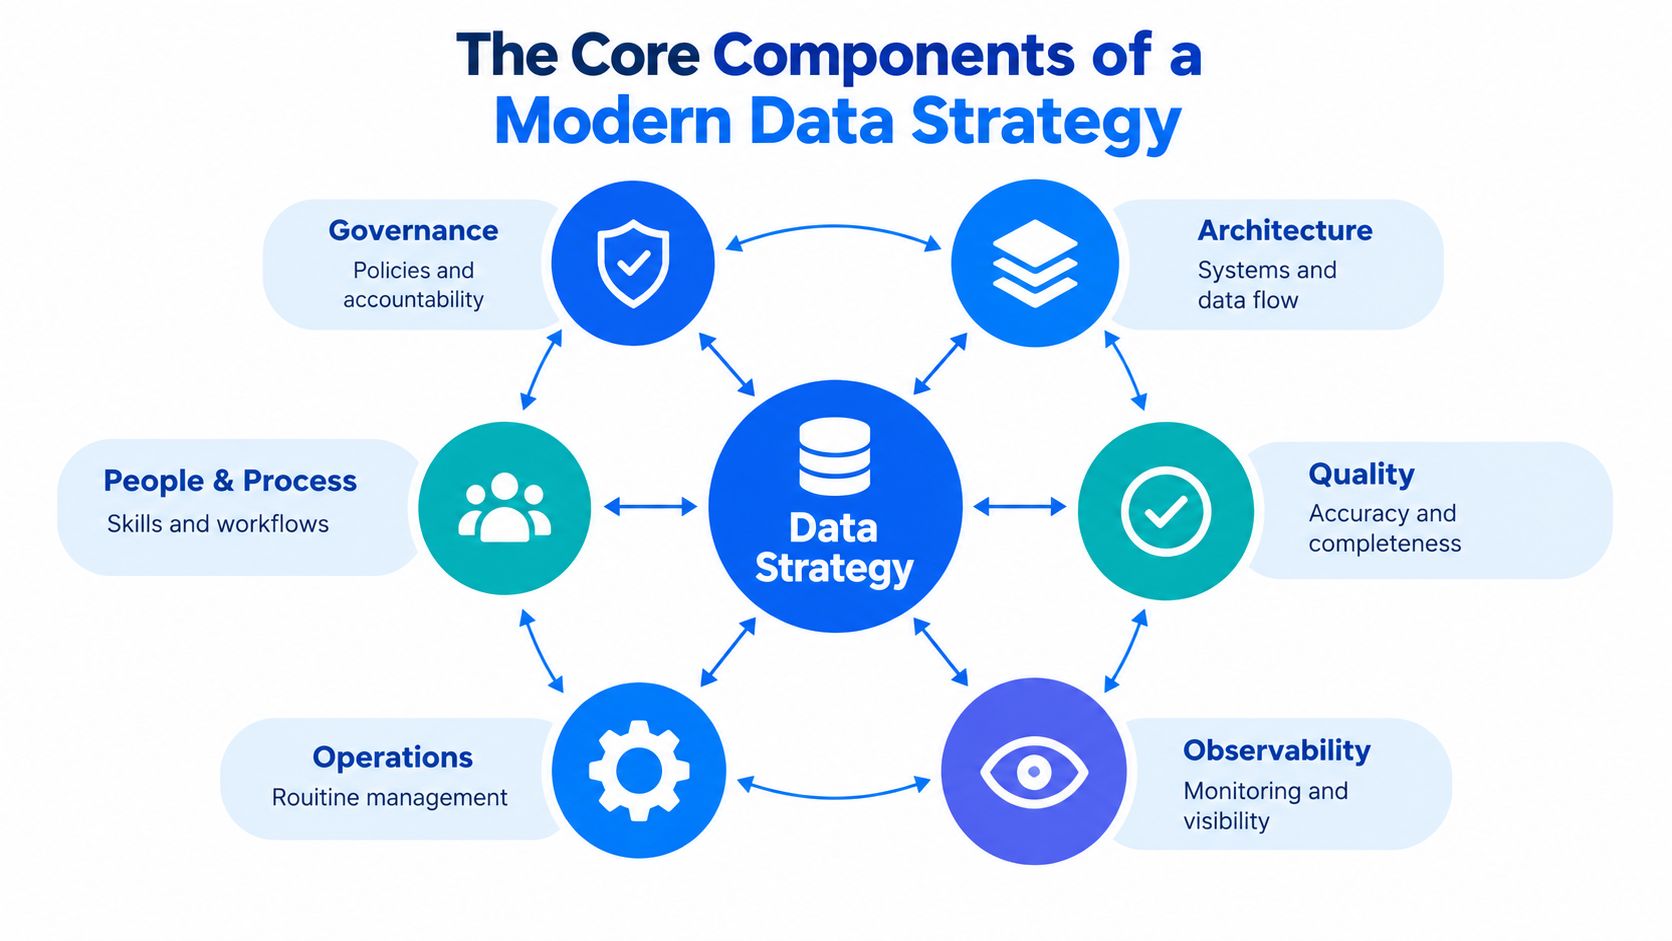
Denken Sie an eine Stadt. Straßen, Ampeln, Prüfstellen, Bebauungspläne, Wartungstrupps und Bewohner haben unterschiedliche Aufgaben, doch die Stadt funktioniert nur, wenn sich diese Teile gegenseitig stützen. Eine moderne Datenstrategie funktioniert genauso, denn Governance, Architektur, Qualität, Observability, Betrieb sowie Menschen und Prozesse müssen zusammenpassen.
Governance und Architektur legen die Verkehrsregeln fest
Governance ist der Bebauungsplan. Sie definiert Entscheidungsrechte, Verantwortlichkeiten und Richtlinien, damit das Unternehmen weiß, wer Zugriffe genehmigen darf, wem der Datensatz gehört und welche Bedingungen gelten. Architektur ist das Straßennetz. Sie legt fest, wo Daten liegen, wie sie sich bewegen und wie auf sie zugegriffen wird, über Warehouses, Lakes, operative Systeme und KI-Pipelines hinweg.
Das ist wichtig, weil eine Strategie ohne Architektur zu einem Richtliniendokument ohne Ziel wird. Eine Strategie ohne Governance wird zu einem Haufen Infrastrukturentscheidungen ohne Verantwortlichen und ohne Eskalationsweg. Beide brauchen einander.
Qualität, Observability und Betrieb machen das System nutzbar
Qualität ist der Prüfstandard. Sie legt für jeden Datensatz fest, was „gut“ bedeutet, und die Qualitätssicht des NIST hilft hier, weil sie Genauigkeit, Bias, Aktualität, Vollständigkeit, Relevanz und Konsistenz als eigenständige Faktoren behandelt und nicht als einen generischen Score (NIST quality factors and control context.pdf)). Observability ist das Verkehrsleitsystem: Sie zeigt, was gerade passiert, und macht Abweichungen früh sichtbar. Der Betrieb ist der Wartungstrupp: Er macht aus Richtlinien wiederholbare Arbeit.
Auf der Ebene von Menschen und Prozessen entscheidet sich, ob Strategien Bestand haben oder versanden. Sie brauchen benannte Verantwortliche, klare Anreize, Eskalationswege und genug gemeinsame Sprache, damit Analysten, Engineers und Fachbereiche über denselben Datensatz sprechen können, ohne aneinander vorbeizureden. Auch eine konkrete Referenz wie Datensystemarchitektur funktioniert nur, wenn diese menschlichen Regeln ebenfalls ausdrücklich festgelegt sind.
Wenn Verantwortung unklar ist, beginnen Teams lokal zu kompensieren. So erstellt eine Gruppe ihre eigene Definition, eine zweite baut einen Workaround und eine dritte vertraut den Zahlen gar nicht mehr.
Verbreitete Irrtümer, die Datenstrategien untergraben
Ein Datenteam kauft ein Lakehouse, ein Governance-Tool oder eine KI-Plattform und nennt das Strategie. Gekauft hat es in Wahrheit Kapazität, keine Verantwortung.
Eine moderne Plattform kann Daten gut speichern, bewegen und verarbeiten und trotzdem offenlassen, wer für Qualität verantwortlich ist, wer Wiederverwendung freigibt und wie Fehler eskaliert werden. Die Definition des MIT CISR kommt der Wahrheit näher: Datenstrategie ist ein integriertes Konzept dafür, wie Daten die Geschäftsstrategie ermöglichen und prägen. Das Geschäftsergebnis kommt also zuerst, nicht die Plattformwahl.
Kennzahlen bilden eine dritte Falle. Grüne Kacheln auf einem Monitoring-Bildschirm beweisen nicht, dass ein Datensatz für einen bestimmten Anwendungsfall vertrauenswürdig ist. Sie zeigen nur, dass eine schmale Auswahl von Prüfungen zu einem bestimmten Zeitpunkt bestanden wurde.
Ein einmaliges Bereinigungsprojekt erzeugt einen vierten Irrtum. Ein Datensatz kann am Freitag sauber und am Montag kaputt sein, wenn sich ein Quellsystem ändert, eine Lieferung zu spät kommt oder ein Feld ohne Vorwarnung umgewidmet wird.
Der hartnäckigste Fehler ist, Bereinigung mit Kontrolle zu verwechseln. Starke Datenstrategien verteilen Verantwortung, identifizieren die wichtigsten Datensätze, legen fest, wie jeder gemessen wird, und bewahren Nachweise, dass die Kontrollen noch greifen. Ohne dieses Betriebsmodell landen Teams immer wieder in denselben Feuerwehreinsätzen, mit denselben Leuten, denselben Erklärungen und denselben ungelösten Fehlern auf Datensatzebene.
So bauen Sie eine Datenstrategie, die wirklich funktioniert
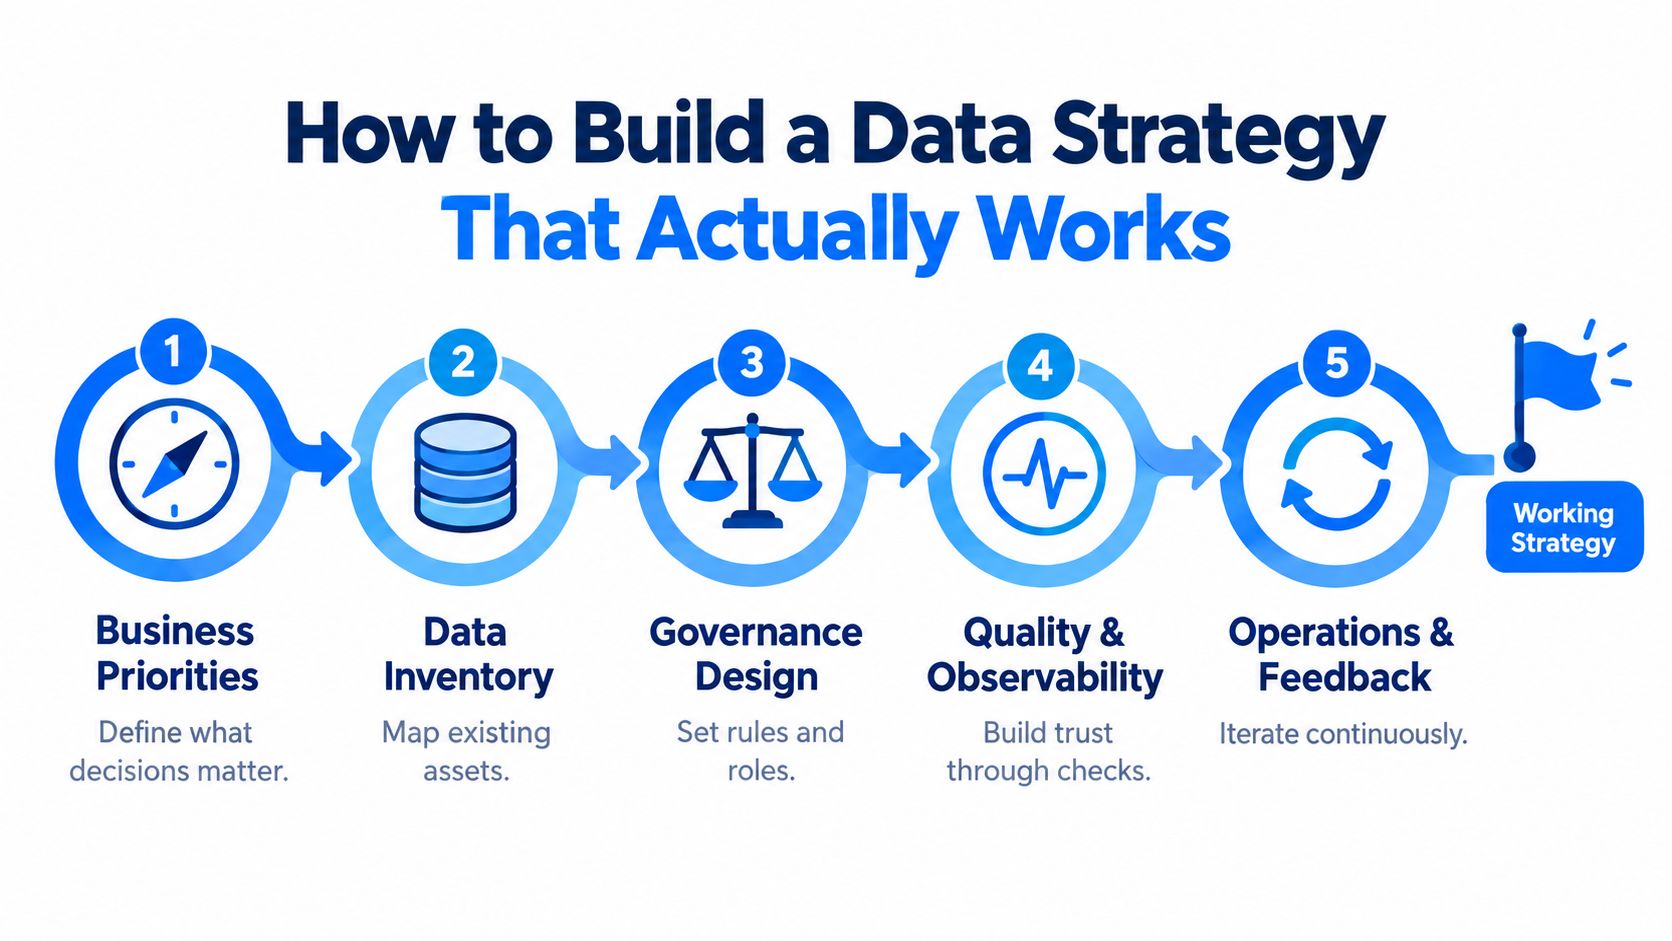
Eine brauchbare Datenstrategie beginnt mit einer Geschäftsentscheidung, nicht mit einem Verzeichnis von Assets. Fragen Sie, welche Entscheidungen das Unternehmen besser, schneller oder mit weniger Risiko treffen will, denn diese Entscheidungen zeigen, welche Datensätze Aufmerksamkeit verdienen. Wenn das Team die Entscheidungen nicht benennen kann, kann es auch die Daten nicht priorisieren.
Grenzen Sie den Umfang dann auf ein kleines Portfolio kritischer Datensätze ein. Die Verantwortung sollte bei der Führungskraft liegen, die für das jeweilige Geschäftsergebnis geradesteht, und das Betriebsmodell sollte die benötigten Daten, die akzeptable Qualität, bekannte Lücken und die nötigen Ressourcen dokumentieren. Diese Genauigkeit hält Teams davon ab, alles steuern zu wollen, und lenkt den Aufwand dorthin, wo Fehler echte Geschäftskosten verursachen.
Halten Sie für jeden kritischen Datensatz die Grundlagen in klarer Sprache fest:
Benannter Verantwortlicher: die Person, die für das Geschäftsergebnis geradesteht.
Vorgesehene Nutzer: die Teams, die sich auf den Datensatz verlassen.
Serviceerwartungen: was „verfügbar“ und „nutzbar“ für diesen Anwendungsfall bedeuten.
Qualitätsdimensionen: welche Regeln hier zählen.
Lieferzeitpunkt: wann die Daten ankommen müssen, um nützlich zu bleiben.
Schemakontrollen: welche strukturellen Änderungen eine Prüfung auslösen sollen.
Machen Sie aus dieser Liste dann ein gelebtes Betriebsmodell. Plattformteam, Governance-Verantwortliche und Fachbereiche sollten auf dieselbe Auswahl strategischer Datensätze schauen, statt über abstrakte Unternehmensstandards zu debattieren, die niemand pflegen kann. Eine Strategie wirkt, wenn sie tägliche Entscheidungen prägt, nicht nur Meeting-Folien.
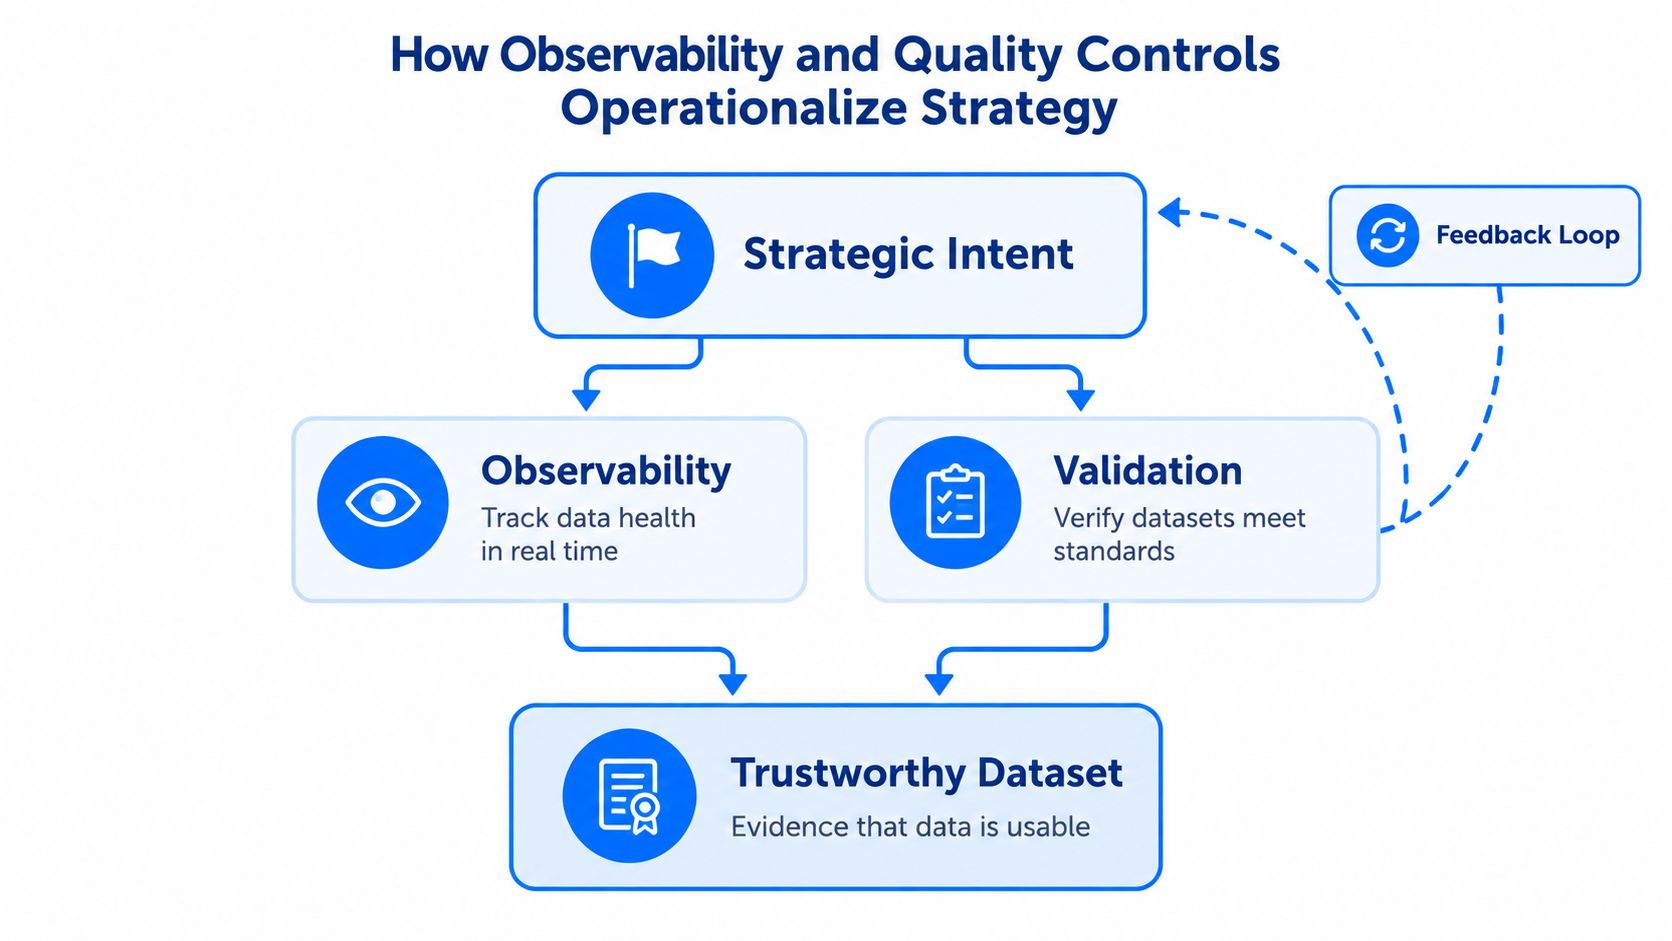
Ein praktisches Beispiel hilft. digna überwacht das Verhalten von Daten, validiert Datensätze, prüft die Pünktlichkeit von Lieferungen und erkennt Schemaänderungen in der eigenen Umgebung des Kunden. Das Tool ist zweitrangig. Entscheidend ist der Kreislauf zwischen Richtlinie und Nachweis: Die Nachweise müssen in die Strategie-Reviews zurückfließen, damit Führungskräfte sehen, ob Kontrollen wirken oder nur dokumentiert sind.
Warum KI-Readiness den Einsatz erhöht
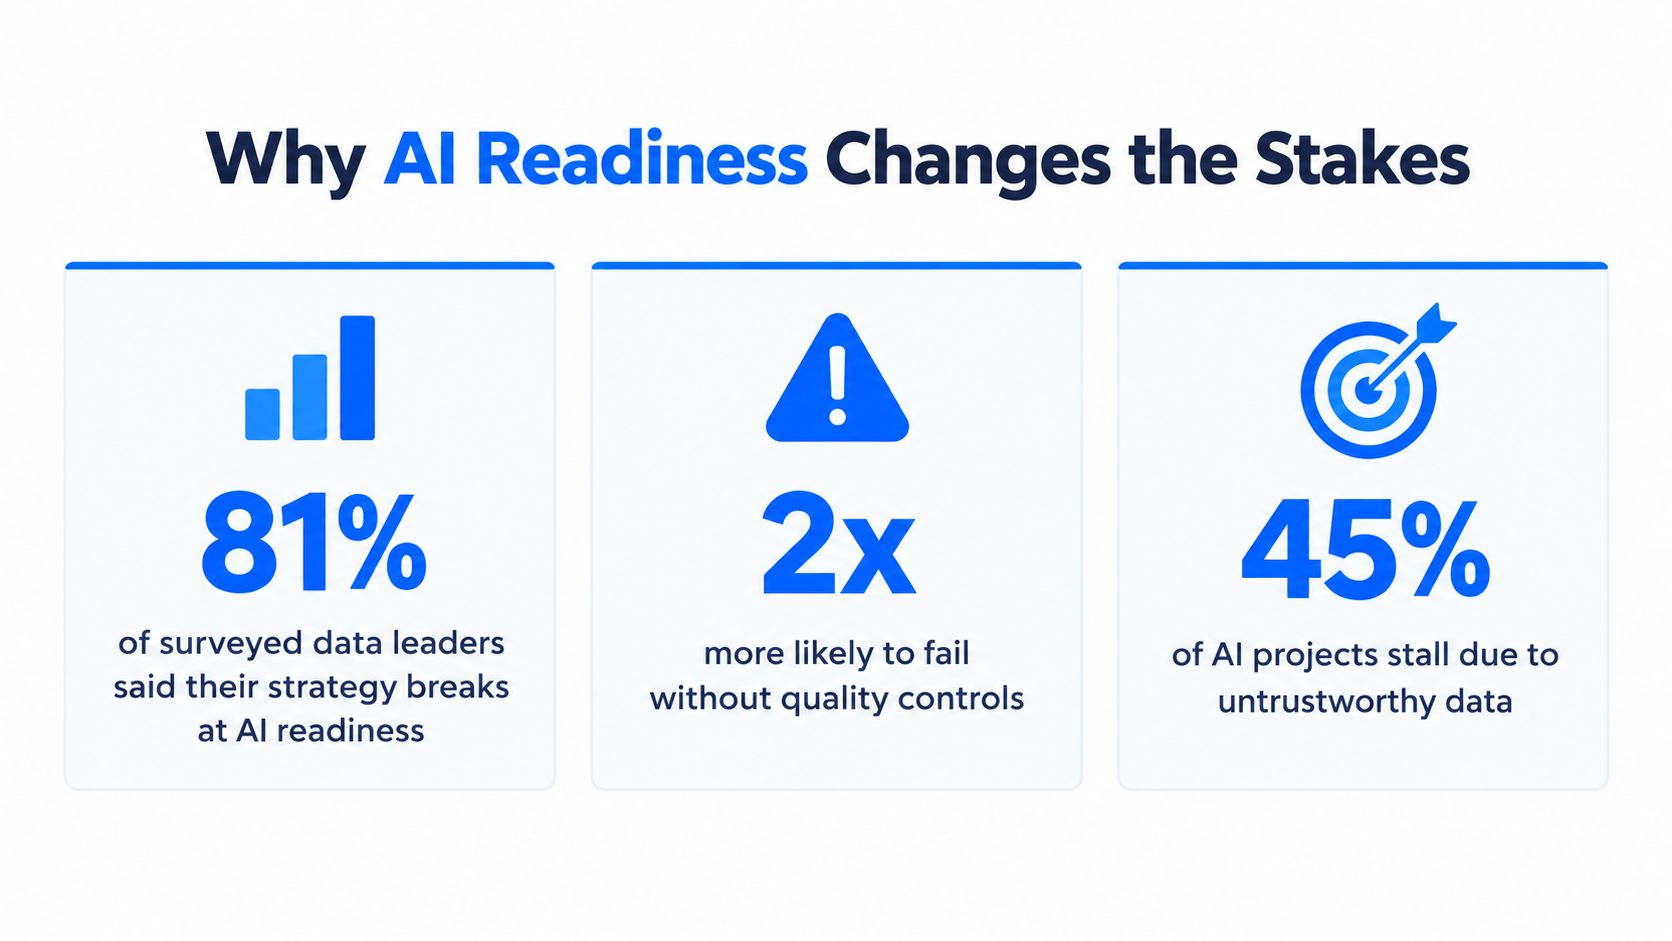
KI legt eine schwache Strategie schneller offen als das Reporting. IBM stellte fest, dass 81 % der befragten Datenverantwortlichen ihre Datenstrategie als integriert in Technologie-Roadmap und Infrastrukturinvestitionen sahen, aber nur 26 % zuversichtlich waren, dass ihre Daten neue KI-gestützte Umsatzquellen tragen können (IBM research on AI readiness and strategy). Diese Lücke ist die Warnung. Eine Verzahnung mit der Roadmap bedeutet nicht, dass die Daten bereit für KI sind.
Laut einer separaten Erhebung von KPMG sahen 62 % der Organisationen unzureichende Data Governance als die größte Datenhürde für KI-Initiativen (KPMG zu Data Governance und KI). Das spricht nicht für ein weiteres Plattformprojekt. Es spricht für einen anderen Maßstab: Jeder KI-Anwendungsfall braucht Nachweise, dass der zugrunde liegende Datensatz vollständig, korrekt, aktuell, strukturell stabil, freigegeben und dokumentiert ist.
KI-Readiness ist eine Frage der Datensätze, kein Plattform-Slogan
Eine Plattform kann modern sein und einen KI-Anwendungsfall trotzdem scheitern lassen, wenn die Eingangsdaten inkonsistent oder schlecht gesteuert sind. Die Zertifizierung muss auf Datensatzebene erfolgen, für ein konkretes Ergebnis. Ein Betrugsmodell, ein Kundenservice-Assistent und ein Forecasting-Workflow brauchen jeweils andere Nachweise, selbst wenn sie auf demselben Stack laufen.
Damit verschiebt sich die Frage von „Haben wir eine KI-Plattform?“ zu „Können wir laufend nachweisen, dass dieser Datensatz für diesen Anwendungsfall taugt?“ Bei einem Datensatz zählen vielleicht vor allem Aktualität und Lineage. Bei einem anderen entscheiden Validierungsregeln und Schemastabilität darüber, ob man dem Modell vertrauen kann. Strategie wird erst real, wenn diese Unterschiede ausdrücklich benannt sind.
Nützlicher Test: Wenn Ihr KI-Team nicht auf die genauen Prüfungen zeigen kann, die einen Datensatz zweckdienlich halten, soll das Modell Nachweisen vertrauen, die es nicht hat.
KI-fähige Daten sollten als kontrolliertes Asset behandelt werden, nicht als statisches Etikett. Tools wie digna helfen, das Verhalten auf Datensatzebene zu überwachen, also dort, wo über Readiness entschieden wird.
Wie Observability und Qualitätskontrollen Strategie in den Betrieb bringen
Eine Strategie wird real, wenn jemand die Nachweise vorlegen kann. Observability und Validierung sind die Nachweisebene: Sie machen Richtlinien als Verhalten von Datensätzen sichtbar. Ohne sie hofft die Führung nur, dass die Kontrollen funktionieren. Mit ihnen sehen Führungskräfte, ob ein Datensatz gesund ist, driftet, verspätet oder kaputt ist.
Vier Kontrollen leisten den Großteil der Arbeit
Anomalieerkennung lernt das normale Muster eines Datensatzes und meldet ungewöhnliches Verhalten, ohne dass Engineers für jeden Sonderfall eine Regel von Hand schreiben müssen. Monitoring der Pünktlichkeit prüft erwartete Lieferzeiten, damit fehlende, zu frühe und verspätete Ladungen nicht verborgen bleiben, bis sich ein Nutzer beschwert. Datenvalidierung setzt Geschäftsregeln auf Datensatzebene durch, genau das, was Sie brauchen, wenn Prüfbarkeit zählt. Schema-Tracking erkennt hinzugefügte und entfernte Spalten sowie geänderte Datentypen, bevor sie nachgelagerte Nutzer lahmlegen.
Auch die europäische Datenregulierung macht das schwerer zu ignorieren. Der Data Governance Act trat am 23. Juni 2022 in Kraft und gilt nach einer Übergangsfrist von 15 Monaten seit September 2023, während der EU Data Act am 11. Januar 2024 in Kraft trat und seit dem 12. September 2025 gilt (EU-Datenregeln und Fristen). Damit werden Zugang, Strukturen für den Datenaustausch, Verantwortung und Nachweise Teil des Betriebsmodells und keine optionalen Extras.
Ein gutes Beispiel ist ein kritischer Finanzdatensatz. Eine Schemaänderung fügt ein Feld hinzu, ein nachgelagerter Report schlägt fehl, eine verspätete Lieferung lässt eine aufsichtsrechtliche Meldung veralten, und eine ungewöhnliche Bewegung in einer Schlüsselkennzahl bleibt tagelang unbemerkt. Ein einheitliches Observability-Setup hätte jedes dieser Probleme früher sichtbar gemacht, Verantwortung zugewiesen und die Spur bewahrt, die nötig ist, um das Geschehen zu erklären.
Für Teams, die diese Kontrollebene in der Praxis brauchen, ist Data Observability die Disziplin, die Alerting, Validierung und Verantwortung in einem Kreislauf verbindet.
Messen, ob die Strategie funktioniert
Eine Strategie ohne Messung ist nur eine Wunschliste. Die richtigen KPIs verbinden Nachweise auf Datensatzebene mit Geschäftsergebnissen, und zwar in Ebenen, damit Führungskräfte erkennen, ob ein Problem technischer, organisatorischer oder finanzieller Natur ist.
Ebene | Beispiel-KPIs | Was sie belegen |
|---|---|---|
Datenzuverlässigkeit | Termintreue der Lieferungen, Lösungszeit für Anomalien, Vorlaufzeit bei der Erkennung von Schemaänderungen | Die Kontrollen erkennen Probleme früh genug, um etwas zu bewirken |
Vertrauen und Nutzung | Vertrauen der Stakeholder, Dashboard-Nutzung, weniger spontane Bereinigungsanfragen | Die Menschen verlassen sich auf die Daten, statt sie manuell nachzubauen |
Risiko und Compliance | Verfügbarkeit von Audit-Nachweisen, Pünktlichkeit aufsichtsrechtlicher Meldungen, Zertifizierungsquote der Modell-Inputs | Die Strategie unterstützt Aufsicht und belastbare Entscheidungen |
Geschäftsergebnisse | Zuverlässigkeit des Reportings, geringere Kosten durch Vorfälle, KI-Readiness der Use Cases | Die Strategie verbessert die Arbeit, die dem Unternehmen wirklich wichtig ist |
Das beste Kennzahlendesign ist spezifisch für den Datensatz und seinen Anwendungsfall. Ein Modell-Input braucht andere Nachweise als eine aufsichtsrechtliche Meldung, und ein kundenseitiges Dashboard andere als ein Monatsabschluss in der Finanzabteilung. Deshalb sollte das Kennzahlenset nah am Portfolio der kritischen Datensätze liegen und nicht in einer generischen Scorecard, die ordentlich aussieht, aber wenig aussagt.
Wenn Sie Zuverlässigkeitskennzahlen in diesem Zusammenhang praktisch angehen wollen, vermittelt wie man Zuverlässigkeit misst die richtige Disziplin, auch wenn sich Ihr Tool-Stack später ändert.
Alles zusammengeführt und wo Sie anfangen
Eine funktionierende Datenstrategie ist ein Betriebsmodell, das auf Verantwortung, Nachweisen und Feedback beruht. Sie verbindet Geschäftsprioritäten mit kritischen Datensätzen, benennt verantwortliche Owner, dokumentiert Erwartungen an Qualität und Aktualität und belegt durch laufende Prüfungen, dass die Kontrollen noch greifen.

Beginnen Sie mit den drei entscheidungskritischsten Datensätzen Ihres Unternehmens. Benennen Sie die Verantwortlichen, schreiben Sie die aktuellen Erwartungen auf und richten Sie grundlegende Observability und Validierung ein, damit Führungskräfte Nachweise sehen und keine Folien. Wenn sich dieser Prozess schwer anfühlt, ist genau das der Punkt: Strategie zählt nur, wenn sie verändert, wie Daten im Alltag betrieben werden.
Wenn Sie Ihre Datenstrategie praktisch in ein Betriebsmodell überführen wollen, gibt digna Teams die Möglichkeit, das Verhalten von Daten zu überwachen, Datensätze zu validieren, die Pünktlichkeit von Lieferungen zu prüfen und Schemaänderungen in der eigenen Umgebung zu erkennen. Besuchen Sie digna und sehen Sie, wie diese Nachweisebene Ihre kritischen Datensätze, Ihre KI-Readiness und Ihre Governance stützen kann, ohne aus der Strategie ein weiteres Foliendeck zu machen.
Welche Felder innerhalb dieser kritischen Datensätze zuerst die strengsten Kontrollen verdienen, erfahren Sie in unserem Leitfaden zu Critical Data Elements.
Häufig gestellte Fragen
Was ist eine Datenstrategie?
Eine Datenstrategie ist der koordinierte Ansatz, mit dem ein Unternehmen Daten im Sinne seiner Geschäftsziele steuert, verwaltet, teilt, schützt und nutzbar macht. Konkret legt sie fest, wer Daten nutzen darf, unter welchen Qualitäts- und Sicherheitskontrollen und wie Daten zwischen Teams und Systemen fließen.
Warum scheitern die meisten Datenstrategien?
Meist, weil sie als Tool-Roadmap statt als Betriebsmodell behandelt werden. Ein glänzendes Foliendeck listet Ziele und Architektur auf, doch niemand verantwortet die kritischen Datensätze, Qualität wird nie gemessen und es gibt keinen Eskalationsweg, wenn eine Schemaänderung oder eine verspätete Lieferung einen Report lahmlegt.
Welche Kernbausteine hat eine Datenstrategie?
Sechs Teile müssen zusammenpassen: Governance, Architektur, Qualität, Observability, Betrieb sowie Menschen und Prozesse. Governance regelt Entscheidungsrechte, Architektur legt fest, wo Daten liegen und wie sie fließen, Qualität definiert, was gut heißt, Observability macht Abweichungen sichtbar, der Betrieb macht Richtlinien zur Routine und benannte Verantwortliche sorgen für Dauerhaftigkeit.
Wie beginnt man mit dem Aufbau einer Datenstrategie?
Starten Sie mit den Geschäftsentscheidungen, die besser werden sollen, und wählen Sie dann ein kleines Portfolio kritischer Datensätze, idealerweise die drei entscheidungsrelevantesten. Halten Sie für jeden Verantwortlichen, Nutzer, Serviceerwartungen, Qualitätsdimensionen, Lieferzeitpunkt und Schemakontrollen fest und ergänzen Sie grundlegende Observability und Validierung.
Wie misst man, ob eine Datenstrategie funktioniert?
Mit KPIs auf vier Ebenen: Datenzuverlässigkeit, Vertrauen und Nutzung, Risiko und Compliance sowie Geschäftsergebnisse. Beispiele sind Termintreue der Lieferungen, Lösungszeit für Anomalien, weniger spontane Bereinigungsanfragen, verfügbare Audit-Nachweise und KI-Readiness von Use Cases, jeweils bezogen auf konkrete kritische Datensätze statt auf eine generische Scorecard.


